Plik robots.txt to krótki plik tekstowy w katalogu głównym serwisu, który mówi robotom wyszukiwarek, których adresów nie powinny odwiedzać. Dobrze napisany porządkuje ruch robotów, a źle napisany potrafi jedną linijką odciąć od Google całą stronę. Poniżej opisujemy budowę pliku od pierwszego wiersza, gotowe układy dla strony firmowej i sklepu oraz sposób sprawdzenia, czy żadna ważna podstrona nie została zablokowana.
Czym jest plik robots.txt i do czego naprawdę służy
Plik robots.txt to zbiór próśb kierowanych do automatycznych programów odwiedzających stronę, czyli robotów. Właściciel serwisu zapisuje w nim, do których adresów roboty mogą zaglądać, a które powinny omijać. Zasady zapisu opisuje standard internetowy o nazwie Robots Exclusion Protocol, opublikowany jako dokument RFC 9309, a Google stosuje go z kilkoma własnymi doprecyzowaniami.
Plik tekstowy umieszczony w katalogu głównym serwisu, w którym właściciel wskazuje robotom, jakich adresów nie powinny pobierać. Jest prośbą, a nie zabezpieczeniem.
Według wprowadzenia do pliku robots.txt w dokumentacji Google plik służy przede wszystkim do zarządzania ruchem robotów: chroni serwer przed nadmiarem żądań i pozwala ograniczyć odwiedzanie stron nieistotnych albo bardzo do siebie podobnych. Nie jest natomiast sposobem na ukrycie strony przed wyszukiwarką. To rozróżnienie jest najważniejszą rzeczą, jaką warto wynieść z lektury, ponieważ właśnie z niego bierze się większość pomyłek.
Warto od razu odróżnić dwa pojęcia, które w rozmowach często się zlewają. Skanowanie oznacza pobranie strony przez robota, a indeksowanie oznacza zapisanie jej w bazie wyszukiwarki, z której powstają wyniki. Robots.txt steruje wyłącznie pierwszą z tych czynności. Standard RFC 9309 mówi o tym wprost: reguły z pliku nie są formą autoryzacji dostępu. Uczciwe roboty, w tym Googlebot, stosują się do nich, ale nikt nie jest do tego technicznie zmuszony. Co więcej, plik jest publiczny, więc każdy może przeczytać listę katalogów, które właściciel chciał schować.
Czy każda strona potrzebuje tego pliku
Nie każda. Brak pliku jest sytuacją prawidłową i oznacza, że roboty mogą odwiedzać wszystkie adresy. Pomoc Search Console opisuje to wprost przy stanie „Nie pobrano - nie znaleziono (404)”. Mała strona hydraulika z Łodzi, która ma kilkanaście podstron i żadnych filtrów ani wyszukiwarki, może działać bez pliku albo z plikiem w najprostszej postaci. Inaczej wygląda sklep z Poznania z tysiącami kombinacji filtrów - tam robots.txt staje się jednym z podstawowych narzędzi porządkowania serwisu.
Dokumentacja Google zaleca przy tym umiar: plik warto tworzyć i zmieniać wtedy, gdy jest to rzeczywiście potrzebne. Każda dodatkowa reguła to kolejne miejsce, w którym można się pomylić, a skutki pomyłki bywają widoczne dopiero po kilku tygodniach, gdy z wyników znikają kolejne podstrony.
Gdzie musi leżeć plik robots.txt
Plik musi znajdować się w katalogu głównym serwisu i być dostępny pod adresem zakończonym na /robots.txt, na przykład https://www.example.com/robots.txt. Roboty nie szukają go w podkatalogach, więc plik wgrany do folderu /blog/ albo /pliki/ nie ma żadnego znaczenia. Nazwa składa się z małych liter, a serwis może mieć tylko jeden taki plik.
Drugą zasadą, o której łatwo zapomnieć, jest zakres obowiązywania. Zgodnie z opisem tego, jak Google interpretuje specyfikację pliku robots.txt, reguły dotyczą wyłącznie tego protokołu, hosta i numeru portu, pod którymi plik został udostępniony. W praktyce oznacza to, że plik pod adresem https://www.example.com/robots.txt nie obowiązuje ani dla https://example.com/, ani dla https://sklep.example.com/. Każda subdomena potrzebuje własnego pliku. Kancelaria z Krakowa, która prowadzi stronę główną w jednej subdomenie, a blog w drugiej, ma więc dwa niezależne pliki do pilnowania.
Format, kodowanie i rozmiar
Plik powinien być zwykłym tekstem w kodowaniu UTF-8. Dokumentacja Google dotycząca tworzenia i przesyłania pliku robots.txt radzi używać prostego edytora tekstu, a nie procesora tekstu, ponieważ ten drugi potrafi zapisać plik we własnym formacie albo dodać znaki, z którymi roboty mają kłopot. Google odczytuje pierwsze 500 kibibajtów pliku, a treść powyżej tego limitu pomija. W zwykłym serwisie firmowym plik ma kilkanaście lub kilkadziesiąt wierszy, więc limit staje się istotny dopiero wtedy, gdy ktoś próbuje wypisać w nim tysiące pojedynczych adresów. To znak, że reguły należy uogólnić.
Co się dzieje, gdy serwer nie zwraca pliku
Zachowanie robota zależy od kodu odpowiedzi serwera, i to bardziej, niż się zwykle zakłada. Poniższa tabela zbiera to, co Google opisuje w swojej dokumentacji.
| Odpowiedź serwera | Jak postępuje Google | Co to oznacza dla właściciela strony |
|---|---|---|
| Kod z grupy 2xx (powodzenie) | Odczytuje plik i stosuje reguły. | Sytuacja prawidłowa. |
| Kod z grupy 3xx (przekierowanie) | Podąża za co najmniej pięcioma przekierowaniami, potem przerywa i traktuje plik jak nieistniejący. | Przekierowania pliku warto ograniczyć do jednego, na przykład z wersji bez www na wersję z www. |
| Kod z grupy 4xx, poza 429 | Zachowuje się tak, jakby pliku nie było, czyli przyjmuje brak ograniczeń. | Błąd 404 nie blokuje strony, ale też niczego nie porządkuje. |
| Kod z grupy 5xx (błąd serwera) | Przez pierwsze 12 godzin wstrzymuje skanowanie serwisu, potem do 30 dni korzysta z ostatniej zapamiętanej poprawnej wersji. | Awaria serwera przy pobieraniu pliku może zatrzymać odwiedziny robota w całym serwisie. |
Standard RFC 9309 jest w przypadku błędów serwera jeszcze bardziej stanowczy: robot ma wtedy założyć pełny zakaz. Dlatego plik robots.txt, który z powodu błędu w konfiguracji zwraca kod 500 albo 503, jest groźniejszy niż plik, którego w ogóle nie ma. Google przechowuje pobraną wersję pliku zwykle do 24 godzin, co wyjaśnia, dlaczego poprawka nie zawsze działa natychmiast.
Jak działają grupy User-agent
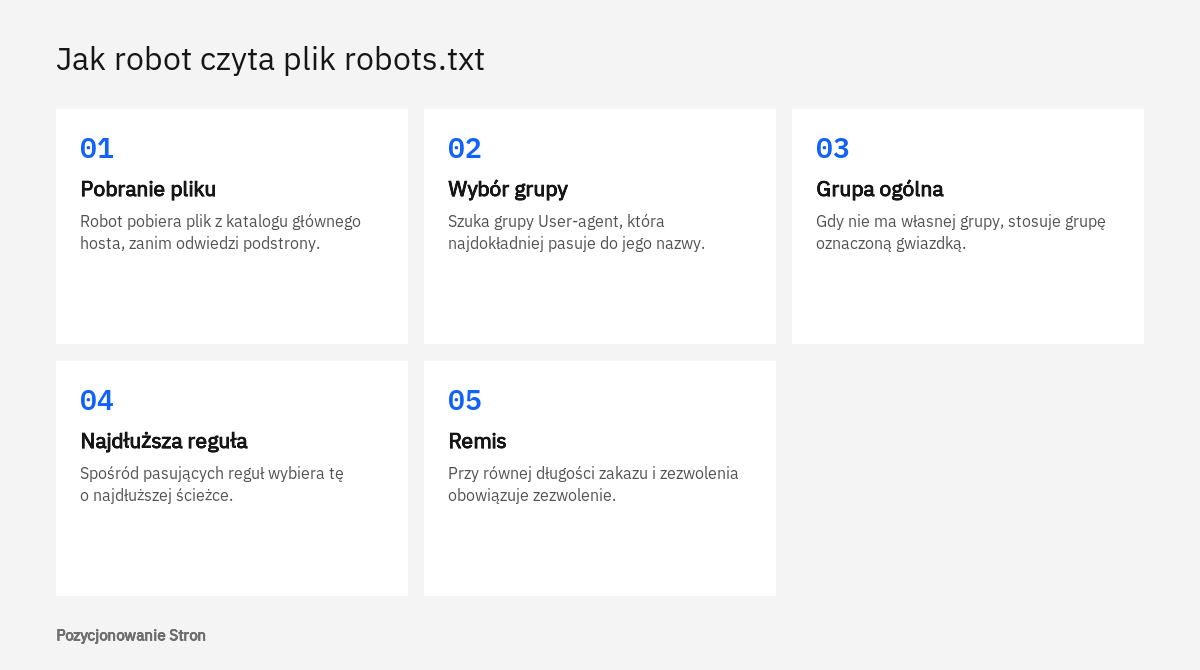
Plik składa się z grup, a każda grupa zaczyna się od wiersza User-agent, czyli nazwy robota, do którego kierowane są reguły. Pod nim znajdują się wiersze Disallow (zakaz) i Allow (zezwolenie). Gwiazdka w miejscu nazwy oznacza wszystkie roboty, które nie mają własnej grupy. Google obsługuje cztery pola: user-agent, allow, disallow oraz sitemap, czyli adres mapy witryny. Pozostałe wiersze pomija.
# Grupa dla wszystkich robotów bez własnej grupy
User-agent: *
Disallow: /koszyk/
Disallow: /szukaj/

# Grupa tylko dla robota Google
User-agent: Googlebot
Disallow: /szukaj/

Sitemap: https://www.example.com/sitemap.xml
W tym przykładzie kryje się pułapka, na którą trafiamy podczas audytów bardzo często. Robot stosuje wyłącznie jedną grupę - tę, która najdokładniej odpowiada jego nazwie. Dokumentacja Google podaje, że grupy przeznaczone dla konkretnego robota nie są łączone z grupą oznaczoną gwiazdką. Googlebot w powyższym pliku przeczyta więc tylko swoją grupę i katalog /koszyk/ pozostanie dla niego otwarty, mimo że w grupie ogólnej jest zakazany. Kto dopisuje osobną grupę dla jednego robota, powinien powtórzyć w niej wszystkie reguły, które mają go dotyczyć.
Kilka dalszych zasad pomaga uniknąć nieporozumień. Kolejność grup w pliku nie ma znaczenia. Jeśli ta sama nazwa robota pojawia się w kilku grupach, Google łączy je w jedną. Kilka wierszy User-agent zapisanych jeden pod drugim tworzy wspólną grupę z tymi samymi regułami. Nazwa robota nie rozróżnia wielkości liter, natomiast ścieżki w regułach już tak. Dopasowanie nazwy jest dokładne: robot przedstawiający się jako googlebot-news nie skorzysta z grupy zapisanej dla innej nazwy, jeśli ma własną albo pasuje do niego dopiero grupa ogólna.
Wiersz Sitemap stoi poza grupami i nie jest przypisany do żadnego robota. Wymaga pełnego adresu z protokołem i nazwą hosta, a w jednym pliku może być ich kilka. Znak # rozpoczyna komentarz, który roboty pomijają - warto z niego korzystać, żeby osoba zaglądająca do pliku za rok wiedziała, po co dana reguła powstała.
Reguły Allow i Disallow: jak robot dopasowuje ścieżki
Reguła działa na zasadzie początku adresu: robot porównuje ścieżkę z reguły z początkiem ścieżki odwiedzanego adresu, znak po znaku. Zapis Disallow: /oferta obejmuje więc nie tylko podstronę /oferta, ale także /oferta/, /oferta-specjalna i /oferta.html. To pierwsze źródło przypadkowych blokad: brak ukośnika na końcu reguły zmienia jej zasięg z jednego katalogu na wszystkie adresy zaczynające się od tych samych liter.
Ścieżka w regule musi zaczynać się od ukośnika, a reguły bez ścieżki Google pomija. Wielkość liter ma znaczenie, więc zakaz dla /Katalog/ nie dotyczy adresu /katalog/. Wszystko, czego plik nie zakazuje, jest dozwolone - nie trzeba wypisywać zezwoleń dla zwykłych podstron.
Gwiazdka i znak dolara
Google obsługuje dwa znaki specjalne. Gwiazdka zastępuje dowolny ciąg znaków, także pusty, a znak dolara oznacza koniec adresu. Dzięki nim jedną regułą można objąć całą rodzinę adresów, na przykład wszystkie adresy z określonym parametrem. Oba znaki opisuje też standard RFC 9309, ale nie każdy robot musi je rozumieć tak samo, dlatego dokumentacja Google przypomina, że różne roboty mogą interpretować składnię odmiennie.
| Reguła | Obejmuje | Nie obejmuje |
|---|---|---|
| /fish | /fish, /fish.html, /fishheads | /Fish.asp, /catfish, /desert/fish |
| /fish/ | wszystko wewnątrz katalogu /fish/ | /fish, /fish.html |
| /*.php | /index.php, /folder/filename.php?parameters | / (strona główna) |
| /*.php$ | /filename.php | /filename.php?parameters |
| /fish*.php | /fish.php, /fishheads/catfish.php?parameters | /Fish.PHP |
Która reguła wygrywa przy sprzeczności
Gdy do jednego adresu pasuje kilka reguł, robot wybiera najbardziej szczegółową, czyli tę o najdłuższej ścieżce. Kolejność wierszy w grupie nie ma tu znaczenia. Jeżeli zakaz i zezwolenie są równie szczegółowe, Google stosuje regułę mniej restrykcyjną, a więc zezwolenie. Tak samo rozstrzyga to standard RFC 9309.
User-agent: *
Disallow: /wp-admin/
Allow: /wp-admin/admin-ajax.php
W tym układzie cały katalog panelu administracyjnego jest zamknięty, ale jeden plik pozostaje dostępny, ponieważ reguła zezwalająca ma dłuższą ścieżkę niż zakaz. Ta sama zasada potrafi jednak zaskoczyć. Dokumentacja Google podaje przykład, w którym zezwolenie dla /page przegrywa z zakazem /*.htm przy adresie /page.htm, bo zakaz jest dłuższy. Przy regułach z gwiazdką warto więc każdorazowo przetestować kilka prawdziwych adresów, zamiast ufać intuicji.
Co wpisać w pliku typowego serwisu firmowego
W typowym serwisie firmowym plik powinien być krótki: grupa dla wszystkich robotów, zakaz dla zaplecza technicznego i wewnętrznej wyszukiwarki oraz adres mapy witryny. Strona usługowa z ofertą, realizacjami, blogiem i kontaktem nie ma zwykle niczego, co wymagałoby rozbudowanych reguł, a każda zbędna linijka zwiększa ryzyko pomyłki.
Wiele firm korzysta z WordPressa, który zachowuje się tu w szczególny sposób. Jeśli na serwerze nie ma fizycznego pliku, system sam generuje jego treść. Z dokumentacji funkcji do_robots() wynika, że domyślna treść to grupa dla wszystkich robotów z zakazem dla katalogu panelu administracyjnego i zezwoleniem dla pliku admin-ajax.php, a wtyczki mogą tę treść zmieniać. Stąd biorą się sytuacje, w których właściciel szuka pliku przez klienta FTP i go nie znajduje, choć w przeglądarce adres /robots.txt działa. Gdy w katalogu głównym pojawi się fizyczny plik, to on jest wysyłany robotom.
User-agent: *
# Zaplecze systemu
Disallow: /wp-admin/
Allow: /wp-admin/admin-ajax.php
# Wyniki wewnętrznej wyszukiwarki
Disallow: /*?s=
Disallow: /search/

Sitemap: https://www.example.com/sitemap.xml
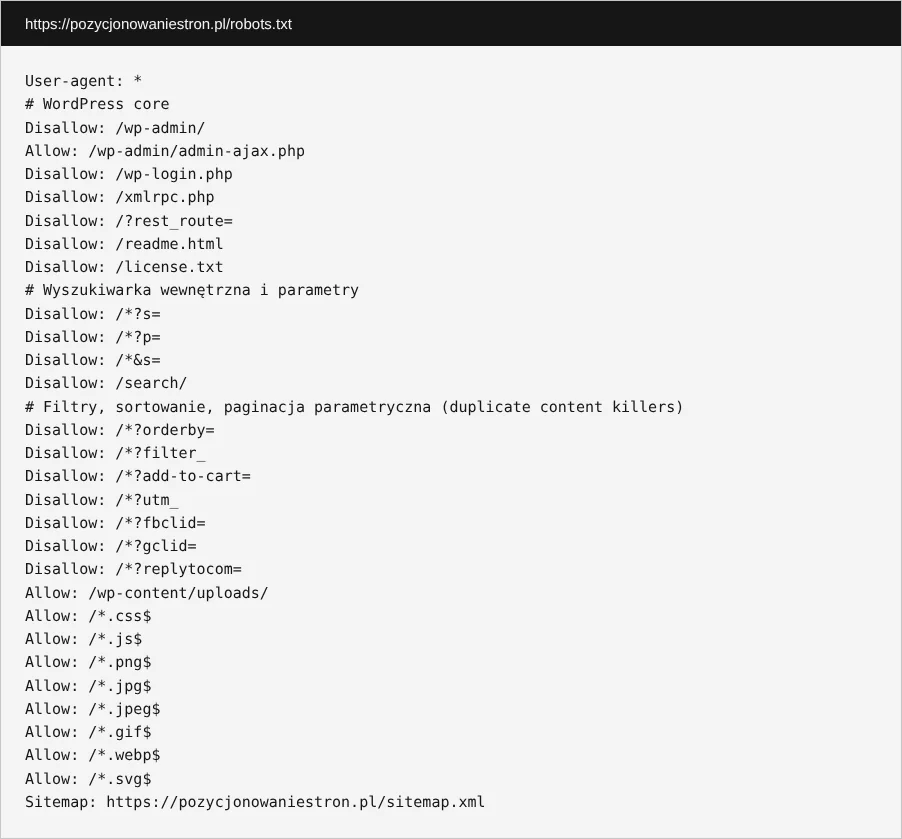
Przykład należy traktować jako punkt wyjścia, a nie wzór do przepisania. Adresy wyszukiwarki, mapy witryny i zaplecza zależą od konfiguracji konkretnej strony, dlatego przed zapisaniem pliku warto sprawdzić, jak rzeczywiście wyglądają adresy w Państwa serwisie. Jako ilustrację pokazujemy własny plik naszej agencji - jest publiczny, jak każdy plik robots.txt.
Czego w serwisie firmowym nie należy blokować
Nie należy zamykać plików, których Google potrzebuje, żeby zobaczyć stronę tak, jak widzi ją klient. Dokumentacja Google wymienia tu skrypty, arkusze stylów i obrazy: można je blokować tylko wtedy, gdy ich brak nie zmienia w istotny sposób wyglądu i treści strony. W starszych plikach spotykamy zakazy dla całych katalogów z motywem i wtyczkami. Skutek jest taki, że robot pobiera sam kod HTML bez układu i części treści, a ocena strony opiera się na niepełnym obrazie.
Nie ma też powodu, by zakazywać dostępu do katalogu z przesłanymi zdjęciami, jeżeli firma chce być widoczna w wyszukiwarce grafik. Według dokumentacji Google zablokowanie plików multimedialnych w robots.txt może wykluczyć je z wyników wyszukiwania. Dla firmy remontowej czy studia mebli na wymiar zdjęcia realizacji są często ważnym źródłem odwiedzin, o czym piszemy szerzej we wpisie Obrazy na stronie a SEO.
Ostatnia rzecz to podstrony, które właściciel chce ukryć: regulamin w starej wersji, stronę z podziękowaniem po wysłaniu formularza, wewnętrzny cennik dla partnerów. Wpisanie ich do robots.txt wydaje się naturalne, ale nie spełnia celu, a przy okazji publicznie wskazuje ich adresy. Właściwe sposoby opisujemy niżej, w części o tym, czego plik nie potrafi.
Plik robots.txt jest jednym z wielu elementów, które sprawdzamy w ramach usługi SEO techniczne, razem z mapą witryny, przekierowaniami i znacznikami kanonicznymi, ponieważ dopiero zestawienie tych ustawień pokazuje, co roboty faktycznie widzą.
Jeśli chcą Państwo zamówić SEO techniczne, zachęcamy do kontaktu: tel. 222 500 844 lub mailowo: biuro@pozycjonowaniestron.pl
Co wpisać w pliku sklepu internetowego
W sklepie plik robots.txt powinien przede wszystkim zamykać adresy, które powstają z filtrów, sortowania i czynności zakupowych, a pozostawiać otwarte kategorie i karty produktów. Liczba możliwych adresów rośnie w sklepie lawinowo: każde połączenie koloru, rozmiaru i sposobu sortowania tworzy nowy adres z prawie tą samą listą produktów.
Google opisuje ten problem w dokumentacji poświęconej zarządzaniu adresami URL nawigacji fasetowej, czyli filtrowania listy produktów według cech. Filtry oparte na parametrach potrafią stworzyć praktycznie nieskończoną przestrzeń adresów. Robot nie wie z góry, które z nich są wartościowe, więc odwiedza ich bardzo wiele, obciąża serwer i później trafia na nowe produkty.
User-agent: *
# Czynności zakupowe i konto klienta
Disallow: /koszyk/
Disallow: /zamowienie/
Disallow: /moje-konto/
Disallow: /*?add-to-cart=
# Sortowanie i filtry w parametrach
Disallow: /*?*orderby=
Disallow: /*?*filter_
# Wyszukiwarka sklepu
Disallow: /*?s=

Sitemap: https://www.example.com/sitemap.xml
Zapis z dwiema gwiazdkami, na przykład /*?*orderby=, pochodzi z przykładu w dokumentacji Google i obejmuje parametr niezależnie od tego, czy stoi w adresie jako pierwszy, czy po innych parametrach. Reguła /*?orderby= objęłaby tylko pierwszy przypadek.
Nazwy z przykładu są umowne. WooCommerce, PrestaShop i Shopify budują adresy koszyka, konta i filtrów inaczej. Zanim powstanie jakakolwiek reguła, warto przejść sklep jak klient: włączyć filtr, zmienić sortowanie, dodać produkt do koszyka i za każdym razem zapisać adres z paska przeglądarki.
Filtry, które mają zostać otwarte
Nie wszystkie strony z filtrami są zbędne. Sklep z Poznania sprzedający obuwie może chcieć, aby strona z butami w konkretnym kolorze była widoczna w Google, bo klienci tak właśnie szukają. Taką stronę lepiej zbudować jako stałą podkategorię z własnym, czytelnym adresem, a parametry pozostawić zamknięte. O tym, które kategorie i filtry warto rozwijać, piszemy we wpisie Pozycjonowanie sklepu internetowego: kategorie, produkty i filtry, a całość prac nad sklepem opisuje usługa pozycjonowanie sklepów.
Czego plik robots.txt nie potrafi
Plik robots.txt nie usuwa stron z wyników wyszukiwania i nie chroni treści przed dostępem. Zakazuje jedynie pobierania strony przez roboty, które zechcą się do zakazu zastosować. Adres zablokowanej strony nadal może trafić do indeksu, jeśli prowadzą do niego linki z innych stron. W wynikach pojawia się wtedy sam adres, bez opisu, ponieważ Google nie zna treści.
W Search Console widać to w raporcie Indeksowanie stron pod dwiema nazwami. Stan „URL zablokowany przez plik robots.txt” oznacza, że reguła uniemożliwia robotowi dostęp do strony. Stan „Strona zindeksowana, ale zablokowana przez plik robots.txt” jest ostrzeżeniem: strona mimo zakazu znalazła się w indeksie. Pomoc Search Console dotycząca raportu Indeksowanie stron podaje w obu przypadkach to samo zalecenie. Jeśli strona ma być widoczna, należy ją odblokować. Jeśli ma zniknąć z wyników, należy usunąć zakaz z robots.txt i zastosować noindex.
Dlaczego zakaz i noindex nie działają razem
Znacznik noindex to polecenie umieszczone w kodzie strony albo w nagłówku odpowiedzi serwera, które mówi wyszukiwarce, by nie pokazywała strony w wynikach. Robot musi jednak stronę pobrać, żeby to polecenie przeczytać. Dokumentacja Google o blokowaniu indeksowania za pomocą tagu noindex stwierdza wprost, że strona z tym znacznikiem nie może być zablokowana w robots.txt, bo inaczej robot nigdy nie zobaczy polecenia.
<meta name="robots" content="noindex">

X-Robots-Tag: noindex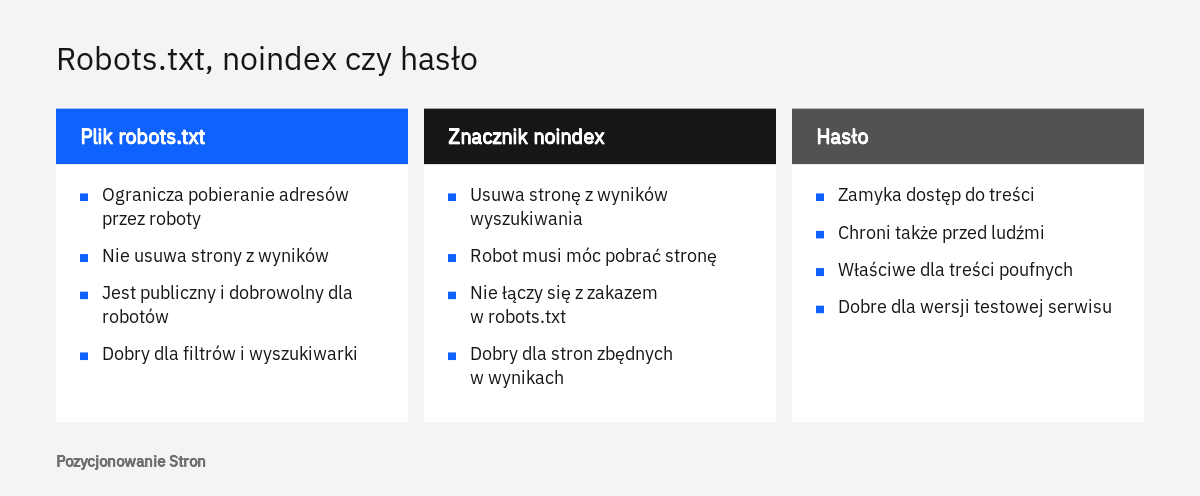
Nagłówek X-Robots-Tag przydaje się przy plikach bez kodu HTML, na przykład dokumentach PDF. Treści naprawdę poufne, takie jak cenniki dla partnerów czy wersja testowa serwisu, powinny być zabezpieczone hasłem. Google musi też ponownie odwiedzić stronę, żeby zauważyć nowy znacznik, co według dokumentacji może potrwać nawet kilka miesięcy. Stany z raportu omawiamy szerzej we wpisie Dlaczego Google nie indeksuje strony.
Najczęstsze pomyłki po wdrożeniu nowej strony
Najgroźniejszą pomyłką jest przeniesienie na działającą stronę pliku z wersji testowej, w którym stoi zakaz dla całego serwisu. Podczas budowy strony wykonawca słusznie zamyka wersję roboczą przed robotami. W dniu uruchomienia pliki są kopiowane w całości i zakaz przechodzi razem z nimi. Strona wygląda poprawnie, formularze działają, nikt nie zagląda pod adres /robots.txt, a po kilku tygodniach firma zauważa, że telefon dzwoni rzadziej.
User-agent: *
Disallow: /
W WordPressie podobny skutek daje pole w ustawieniach czytania, które prosi wyszukiwarki o nieindeksowanie witryny. Według dokumentacji ekranu ustawień czytania od wersji 5.3 zaznaczenie tego pola dodaje do każdej strony znacznik noindex z dopiskiem nofollow, a w starszych wersjach zmieniało treść generowanego pliku robots.txt na pełny zakaz. Samo sprawdzenie pliku tego nie wykaże, dlatego po wdrożeniu trzeba obejrzeć oba miejsca.
Pozostałe pomyłki są mniej widowiskowe, ale spotykamy je regularnie. Należy do nich zakaz bez końcowego ukośnika: kancelaria z Krakowa, chcąc zamknąć katalog /pra/ z materiałami roboczymi, zapisałaby regułę /pra i zablokowała przy okazji podstrony /prawo-pracy/ oraz /prawo-rodzinne/. Zdarza się też zamknięcie katalogów ze stylami i skryptami, osobna grupa dla Googlebota, przez którą robot przestaje widzieć zakazy z grupy ogólnej, a także adres mapy witryny wskazujący starą domenę.
Po zmianie domeny plik trzeba sprawdzić osobno pod każdym adresem, ponieważ obowiązuje tylko dla hosta, na którym leży. Stare adresy nie powinny być zablokowane: robot musi móc je odwiedzić, żeby zobaczyć przekierowania do nowych. Porządek prac opisujemy we wpisie Migracja strony a SEO, a w usłudze migracja domeny i hostingu kontrola pliku jest jednym z pierwszych punktów po uruchomieniu.
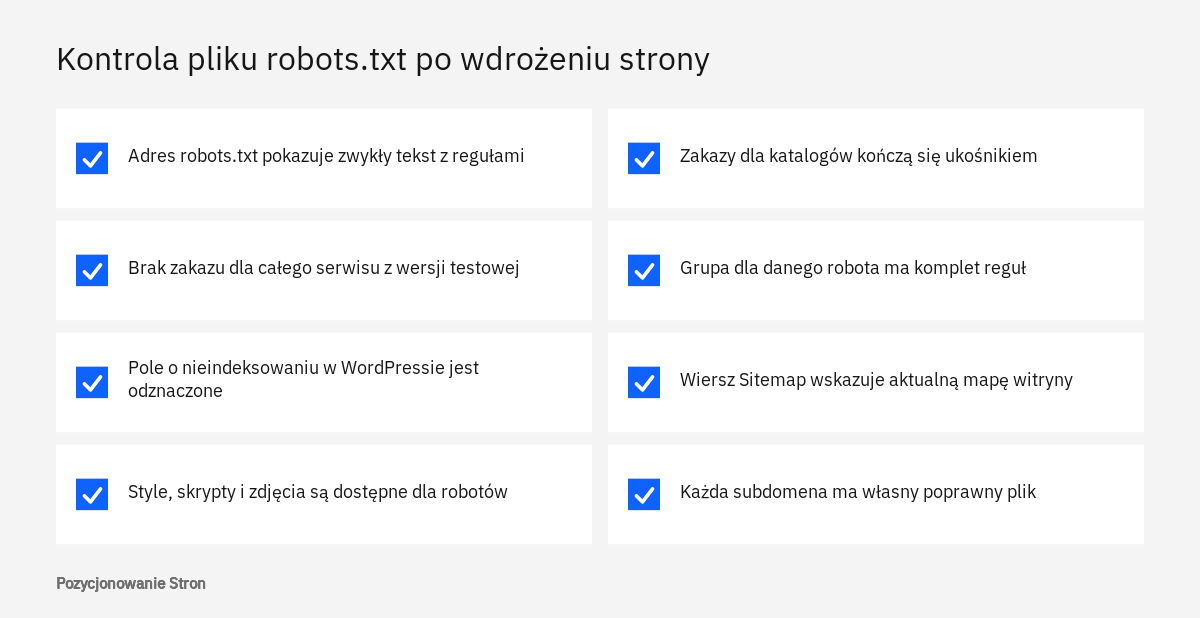
- Adres /robots.txt otwiera się w przeglądarce i pokazuje zwykły tekst, a nie stronę błędu.
- W pliku nie ma zakazu dla całego serwisu pozostawionego po wersji testowej.
- W WordPressie pole z prośbą o nieindeksowanie witryny jest odznaczone.
- Katalogi ze stylami, skryptami i zdjęciami są dostępne dla robotów.
- Każdy zakaz dla katalogu kończy się ukośnikiem, chyba że szerszy zasięg jest zamierzony.
- Grupa dla konkretnego robota zawiera wszystkie reguły, które mają go dotyczyć.
- Wiersz Sitemap zawiera pełny, aktualny adres mapy witryny.
- Strony, które mają zniknąć z wyników, mają znacznik noindex i nie są zablokowane w pliku.
Jak przetestować plik robots.txt przed zmianą i po niej
Plik testuje się w trzech miejscach: w przeglądarce, w raporcie dotyczącym pliku robots.txt w Search Console oraz w narzędziu do sprawdzania adresów URL. Pierwsze potwierdza, że plik istnieje i jest publiczny, drugie pokazuje, jaką wersję pobrało Google i czy znalazło w niej błędy, trzecie odpowiada na pytanie najważniejsze: czy konkretna podstrona jest dla robota otwarta.
Zaczynamy od wpisania adresu pliku w oknie prywatnym przeglądarki, tak jak radzi dokumentacja Google. Na ekranie powinien pojawić się czysty tekst z regułami. Jeśli zamiast niego wyświetla się strona błędu, strona logowania albo strona główna serwisu, serwer nie udostępnia pliku poprawnie i trzeba to wyjaśnić z administratorem lub firmą hostingową.
Raport dotyczący pliku robots.txt w Search Console
Raport znajduje się w ustawieniach usługi w Search Console i jest dostępny dla usług domenowych oraz usług z prefiksem adresu URL bez ścieżki. Zgodnie z opisem raportu w pomocy Search Console pokazuje on pliki znalezione dla 20 najważniejszych hostów w usłudze. Przy każdym pliku widać ścieżkę, stan pobierania, czas ostatniego sprawdzenia, rozmiar oraz liczbę problemów. Stan „Pobrano” oznacza, że Google odczytało plik. Stan „Nie pobrano - nie znaleziono (404)” mówi, że pliku nie ma, co samo w sobie nie jest błędem. Stan „Nie pobrano - dowolny inny powód” wymaga wyjaśnienia, bo zwykle stoi za nim kłopot z serwerem.
Kolumna z problemami pokazuje wiersze, których Google nie zrozumiało. Wiersze z błędami są pomijane, a reszta pliku działa, więc literówka w słowie Disallow nie psuje całości, ale sprawia, że jedna reguła po cichu przestaje obowiązywać. Po kliknięciu pliku na liście można otworzyć zakładkę „Wersje” i obejrzeć jego treść z ostatnich 30 dni. To bardzo przydatne przy szukaniu przyczyny spadku: widać, kiedy plik się zmienił i co w nim wtedy stało.
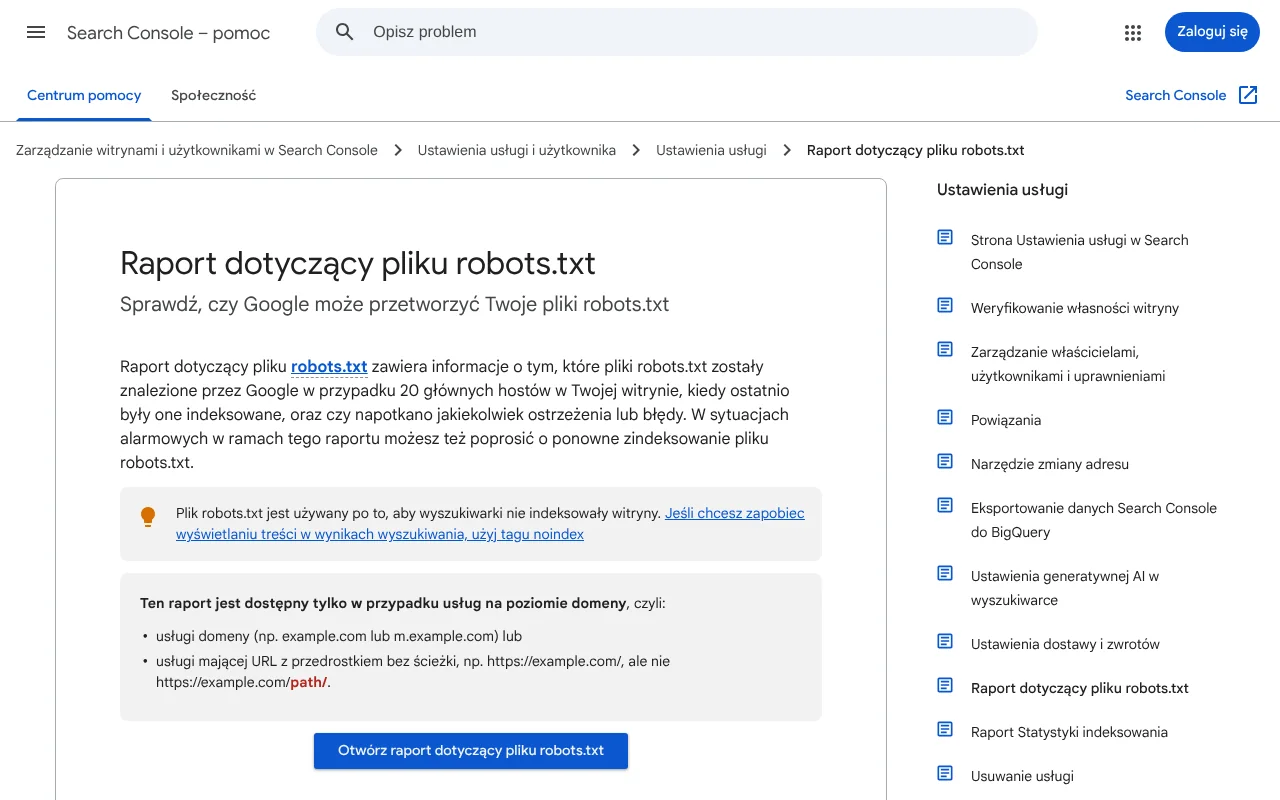
Po poprawce nie trzeba czekać na samoczynne odświeżenie, które według dokumentacji o aktualizowaniu pliku robots.txt następuje co 24 godziny. W menu z dodatkowymi ustawieniami przy pliku znajduje się opcja prośby o ponowne zindeksowanie. Google zaleca używać jej po naprawieniu błędu lub ważnej zmianie reguł i zastrzega, że prośba nie gwarantuje natychmiastowego pobrania.
Test pojedynczego adresu
Czy dana podstrona jest zablokowana, sprawdza się w narzędziu do sprawdzania adresów URL, do którego prowadzi pole wyszukiwania na górze Search Console. Po wpisaniu adresu należy rozwinąć sekcję Indeksowanie stron i odnaleźć pole „Czy skanowanie jest dozwolone”. Wartość „Nie” oznacza, że reguła w robots.txt zamyka adres przed robotem. Pomoc narzędzia do sprawdzania adresów URL przestrzega, by nie mylić tego pola z sąsiednim polem „Czy indeksowanie jest dozwolone”, które dotyczy znacznika noindex.
Wynik pokazuje stan z ostatniej wizyty robota, a nie stan bieżący. Po zmianie pliku należy więc użyć przycisku testu wersji opublikowanej w prawym górnym rogu wyniku. Te same pola pojawią się wtedy w sekcji dotyczącej dostępności, a przy zablokowanym adresie pole „Pobranie strony” pokaże niepowodzenie.
- Lista adresów kontrolnych
Przed zmianą warto spisać kilkanaście adresów: stronę główną, najważniejsze usługi lub kategorie, kilka produktów, wpis z bloga oraz po jednym adresie z każdej grupy, która ma zostać zamknięta.
- Kopia obecnego pliku
Treść działającego pliku należy zapisać na dysku, aby w razie pomyłki przywrócić ją w kilka minut.
- Wgranie nowej wersji i prośba o ponowne pobranie
Po wgraniu pliku do katalogu głównego otwieramy go w przeglądarce, a następnie w raporcie Search Console zgłaszamy prośbę o ponowne zindeksowanie.
- Test adresów z listy
Każdy adres z listy przechodzi test wersji opublikowanej. Ważne podstrony powinny mieć dozwolone skanowanie, a adresy przeznaczone do zamknięcia - niedozwolone.
- Kontrola po kilku tygodniach
W raporcie Indeksowanie stron należy przejrzeć listę adresów ze stanem dotyczącym blokady przez robots.txt i upewnić się, że nie ma na niej nic, co powinno być widoczne.
Osoby techniczne mogą dodatkowo testować plik na własnym komputerze, jeszcze przed publikacją. Google udostępnia w tym celu otwartą bibliotekę, tę samą, z której korzysta wyszukiwarka, o czym informuje dokumentacja dotycząca tworzenia pliku.
Kiedy warto poprosić o pomoc
Samodzielna edycja jest bezpieczna, gdy plik ma kilka prostych reguł, a serwis kilkadziesiąt podstron. Wsparcie specjalisty przydaje się w trzech sytuacjach: gdy sklep ma rozbudowane filtry i trzeba zdecydować, które wzorce adresów zamknąć, gdy serwis działa w kilku subdomenach lub wersjach językowych oraz gdy po wdrożeniu nowej strony ruch z Google wyraźnie spadł i trzeba szybko ustalić przyczynę. W tym ostatnim przypadku robots.txt jest jednym z pierwszych miejsc, do których zaglądamy, ale rzadko jedynym - pełny obraz daje dopiero audyt SEO, który zestawia plik z mapą witryny, przekierowaniami i stanem indeksu. Nie obiecujemy przy tym konkretnych pozycji, ponieważ poprawny plik jedynie usuwa przeszkodę i nie zastępuje pracy nad treścią i ofertą.
Jeśli chcą Państwo zamówić SEO techniczne, zachęcamy do kontaktu: tel. 222 500 844 lub mailowo: biuro@pozycjonowaniestron.pl
Najczęstsze pytania
Czy brak pliku robots.txt szkodzi stronie?
Nie. Gdy serwer odpowiada kodem 404, Google przyjmuje, że nie ma żadnych ograniczeń, i może odwiedzać wszystkie adresy. Plik staje się potrzebny dopiero wtedy, gdy w serwisie są adresy, których roboty nie powinny pobierać, na przykład wyniki filtrów lub wyszukiwarki.
Czy zakaz w robots.txt usunie stronę z Google?
Nie. Zakaz powstrzymuje robota przed pobraniem strony, ale jej adres może pozostać w wynikach, jeśli prowadzą do niego linki. Aby strona zniknęła z wyników, trzeba zdjąć zakaz i dodać znacznik noindex albo zabezpieczyć treść hasłem.
Po jakim czasie Google zauważa zmianę w pliku?
Google przechowuje pobraną wersję pliku zwykle do 24 godzin i w tym rytmie ją odświeża. Proces można przyspieszyć prośbą o ponowne zindeksowanie w raporcie dotyczącym pliku robots.txt w Search Console. Skutki zmiany dla poszczególnych podstron widać później, w miarę kolejnych wizyt robota.
Czy plik robots.txt z głównej domeny działa także w subdomenie?
Nie. Reguły obowiązują tylko dla protokołu, hosta i portu, pod którymi plik jest dostępny. Sklep lub blog w osobnej subdomenie potrzebuje własnego pliku w swoim katalogu głównym.
Czy w robots.txt można ustawić opóźnienie dla robota Google?
Nie. Wiersz crawl-delay nie należy do pól obsługiwanych przez Google, więc robot tej wyszukiwarki go pomija. Google obsługuje cztery pola: user-agent, allow, disallow oraz sitemap.
Czy trzeba dopisywać Allow dla każdej ważnej podstrony?
Nie ma takiej potrzeby. Wszystko, czego plik nie zakazuje, jest dla robotów dozwolone. Reguła Allow służy do robienia wyjątków, czyli otwarcia jednego pliku lub podkatalogu wewnątrz zamkniętego katalogu.
Dlaczego nie widać pliku na serwerze, skoro otwiera się w przeglądarce?
W WordPressie treść pliku jest generowana przez system, jeśli w katalogu głównym nie ma pliku fizycznego. Treść tę mogą zmieniać wtyczki. Po wgraniu własnego pliku do katalogu głównego to on jest wysyłany robotom.
Źródła
- Plik robots.txt - wprowadzenie, Google Search Central
- Tworzenie i przesyłanie pliku robots.txt, Google for Developers
- Jak Google interpretuje specyfikację pliku robots.txt, Google for Developers
- Aktualizowanie pliku robots.txt, Google for Developers
- RFC 9309: Robots Exclusion Protocol, RFC Editor
- Raport dotyczący pliku robots.txt, Pomoc Search Console
- Narzędzie do sprawdzania adresów URL, Pomoc Search Console
- Raport Indeksowanie stron, Pomoc Search Console
- Blokowanie indeksowania przez wyszukiwarki za pomocą tagu noindex, Google Search Central
- Zarządzanie indeksowaniem adresów URL nawigacji fasetowej, Google for Developers
- do_robots() - Function, Developer.WordPress.org
- Settings Reading screen, WordPress.org
Stan wiedzy: październik 2026. Funkcje wyszukiwarek i asystentów AI zmieniają się szybko, dlatego wpis aktualizujemy po większych zmianach.