ChatGPT Search to funkcja, dzięki której ChatGPT nie odpowiada wyłącznie z pamięci modelu, lecz zadaje pytania wyszukiwarkom, pobiera strony i podaje linki do źródeł. O tym, czy strona firmy może się w takiej odpowiedzi znaleźć, decydują trzy osobne roboty, każdy z innym zadaniem. Poniżej opisujemy, jak ten mechanizm działa według dokumentacji wydawcy, co widać w logach serwera i w Analytics oraz jakie decyzje warto podjąć na własnej stronie.
Kiedy ChatGPT sięga do sieci, a kiedy odpowiada z pamięci modelu
ChatGPT przeszukuje sieć w dwóch sytuacjach: gdy sam uzna, że pytanie wymaga aktualnych informacji, oraz gdy użytkownik włączy wyszukiwanie ręcznie. W każdym innym przypadku odpowiedź powstaje z wiedzy, którą model nabył podczas trenowania, bez otwierania jakiejkolwiek strony. Tak opisuje to strona pomocy ChatGPT poświęcona wyszukiwaniu w sieci.
Ta różnica ma dla właściciela firmy duże znaczenie. Odpowiedź z pamięci modelu opiera się na tym, co o danej branży, usłudze lub marce było dostępne w materiałach treningowych. Nie ma w niej przypisów, a dzisiejsza zmiana na stronie nie wpłynie na nią ani jutro, ani za tydzień. Odpowiedź z wyszukiwaniem powstaje na bieżąco: asystent pobiera wyniki, czyta fragmenty stron i wskazuje, skąd wziął informacje. Tylko w tym drugim trybie strona firmy może zostać zacytowana i tylko wtedy użytkownik dostaje link, w który może kliknąć.
Wiedza zapisana w modelu językowym w trakcie trenowania. Model korzysta z niej bez łączenia się z siecią, dlatego nie obejmuje ona najnowszych zmian i nie pozwala wskazać konkretnego źródła.
Wyszukiwanie automatyczne i ręczne
Według strony pomocy ChatGPT może uruchomić wyszukiwanie samodzielnie, jeśli pytanie zyska na aktualnych informacjach. Użytkownik może też wymusić wyszukiwanie: wskazując opcję wyszukiwania na liście narzędzi przy polu wiadomości, wpisując ukośnik i wskazując wyszukiwanie albo prosząc o ponowne wygenerowanie odpowiedzi z wynikami z sieci. Wyszukiwanie jest dostępne we wszystkich planach, także dla osób niezalogowanych, w granicach limitów danego planu.
W praktyce oznacza to, że to samo pytanie zadane przez dwie osoby może dać odpowiedź z linkami albo bez nich. Pytanie o hydraulika w Łodzi dostępnego w weekend niemal zawsze wymaga aktualnych danych, więc asystent sięgnie do sieci. Pytanie o to, czym różni się kocioł kondensacyjny od tradycyjnego, często zostanie obsłużone z pamięci modelu, bo odpowiedź nie zmienia się z dnia na dzień. To nasza obserwacja z codziennej pracy, a nie reguła zapisana w dokumentacji: wydawca nie publikuje listy tematów, przy których wyszukiwanie włącza się na pewno.
Jak pytanie użytkownika zamienia się w zapytania do wyszukiwarek
ChatGPT nie wysyła do wyszukiwarki pytania w takim brzmieniu, w jakim wpisał je użytkownik. Strona pomocy podaje, że przy korzystaniu z partnerów wyszukiwania asystent zwykle przepisuje pytanie na jedno lub kilka ukierunkowanych zapytań, a po przejrzeniu pierwszych wyników może wysłać kolejne. Długa, opisowa prośba zamienia się w kilka krótkich fraz, bardzo podobnych do tych, które ludzie od lat wpisują w wyszukiwarkę.
Przykład podany przez wydawcę dobrze to pokazuje: prośba o restauracje w pobliżu zostaje zamieniona na zapytanie o najlepsze restauracje w konkretnym mieście, ustalonym na podstawie przybliżonej lokalizacji. Analogicznie pytanie „szukam kancelarii, która pomoże mi przy podziale majątku po rozwodzie, najlepiej w centrum Krakowa” może zostać rozbite na frazy w rodzaju „kancelaria podział majątku Kraków” i „adwokat rozwody Kraków centrum”. Ten drugi przykład jest naszą ilustracją mechanizmu, a nie zapisem rzeczywistych zapytań.
Skąd pochodzą wyniki
Wydawca informuje, że ChatGPT korzysta z własnego robota wyszukiwania oraz, w części przypadków, z zewnętrznych dostawców wyszukiwania. We wpisie zapowiadającym ChatGPT Search mowa jest także o treściach dostarczanych bezpośrednio przez partnerów, między innymi wydawców prasowych, oraz o danych o pogodzie, kursach akcji, sporcie i mapach. Pełna lista dostawców nie jest podana na stronie pomocy, dlatego nie należy zakładać, że wyniki pochodzą z jednej, konkretnej wyszukiwarki.
Dla firmy wniosek jest praktyczny. Strona, której nie ma w indeksach klasycznych wyszukiwarek, ma małe szanse pojawić się w odpowiedzi asystenta, bo frazy powstałe z przepisania pytania trafiają właśnie do wyszukiwarek. Dlatego pozycjonowanie stron i widoczność w odpowiedziach AI nie są dwoma osobnymi światami. Szerzej opisujemy to we wpisie o tym, jak trafić do odpowiedzi ChatGPT, Gemini, Perplexity, Copilota i Claude.
Lokalizacja i zapamiętane informacje
Na kształt zapytań wpływają dwie rzeczy, o których użytkownik często nie myśli. Pierwszą jest przybliżona lokalizacja ustalana na podstawie adresu IP: według strony pomocy ChatGPT może ją wykorzystać do wyników lokalnych i przekazać ogólną lokalizację dostawcom wyszukiwania, natomiast samego adresu IP ani danych konta im nie przekazuje. Dokładna lokalizacja urządzenia jest opcjonalna i domyślnie wyłączona. Drugą jest funkcja pamięci: jeśli jest włączona, asystent może użyć zapisanych wcześniej informacji o użytkowniku przy przepisywaniu zapytania. Osoba, która kiedyś wspomniała o diecie wegańskiej, dostanie zapytanie o restauracje wegańskie, choć w bieżącej rozmowie o tym nie napisała.
Z tego powodu dwie osoby zadające identyczne pytanie mogą otrzymać różne źródła. Firmie lokalnej zależy więc na tym, by jej dane adresowe były w sieci spójne. Piszemy o tym osobno we wpisie o lokalnej firmie w odpowiedziach AI.
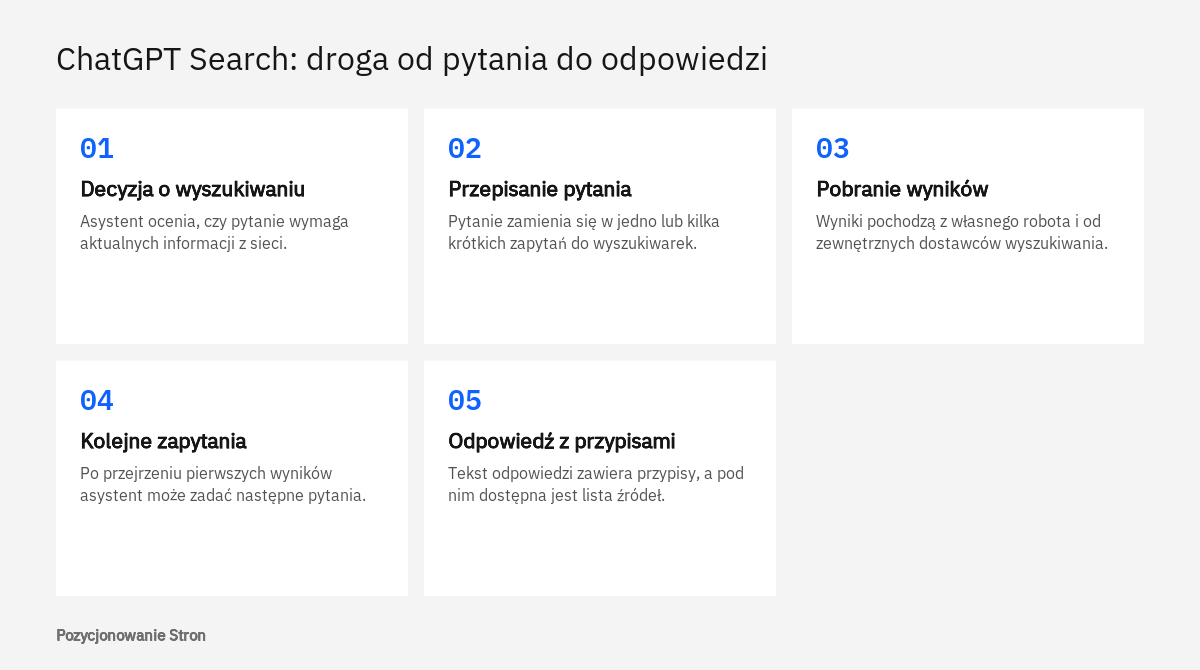
Cała droga od pytania do odpowiedzi składa się zatem z kilku etapów: decyzji o wyszukiwaniu, przepisania pytania, pobrania wyników, przeczytania wybranych stron i napisania odpowiedzi z przypisami. Na każdym z tych etapów strona firmy może odpaść: bo nie ma jej w wynikach, bo robot nie ma do niej dostępu albo bo nie zawiera jasnej odpowiedzi na pytanie.
Jakie roboty pobierają strony i czym się różnią
Wydawca ChatGPT opisuje w dokumentacji trzy roboty, które mają znaczenie dla widoczności strony: OAI-SearchBot, GPTBot i ChatGPT-User. Każdy ma inne zadanie i każdy przedstawia się serwerowi inną nazwą, zwaną nagłówkiem User-Agent, czyli podpisem programu pobierającego stronę. Czwarty robot, OAI-AdsBot, dotyczy wyłącznie reklam. Opis wszystkich znajduje się na stronie z przeglądem robotów wydawcy.
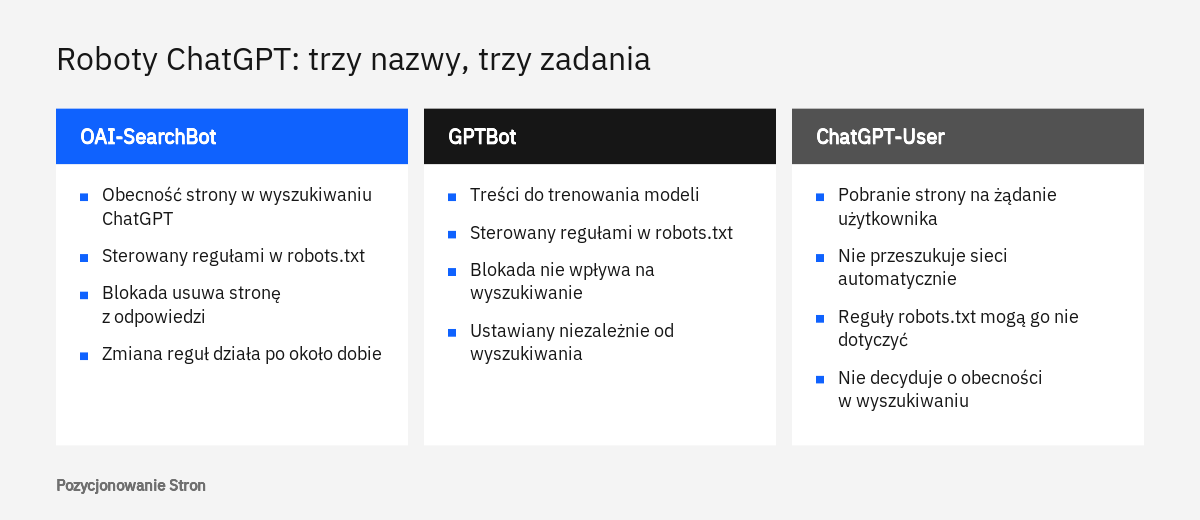
OAI-SearchBot służy do tego, by strony mogły pojawiać się w wynikach wyszukiwania ChatGPT. To on decyduje o obecności w odpowiedziach z przypisami. GPTBot pobiera treści, które mogą zostać użyte do trenowania modeli, a więc wpływa na pamięć modelu, nie na bieżące wyszukiwanie. ChatGPT-User działa wtedy, gdy użytkownik lub przygotowany przez kogoś asystent, tak zwany Custom GPT, wykona czynność wymagającą otwarcia strony, na przykład poprosi o streszczenie podanego adresu. Dokumentacja podkreśla, że ten ostatni nie służy do automatycznego przeszukiwania sieci.
| Robot | Do czego służy | Co daje jego zablokowanie | Stosunek do robots.txt |
|---|---|---|---|
| OAI-SearchBot | Udostępnianie stron w wyszukiwaniu ChatGPT | Strona nie pojawia się w odpowiedziach, może pozostać jako link nawigacyjny | Sterowany regułami w robots.txt |
| GPTBot | Zbieranie treści, które mogą posłużyć do trenowania modeli | Sygnał, że treści nie należy używać do trenowania | Sterowany regułami w robots.txt |
| ChatGPT-User | Pobranie strony na żądanie użytkownika w trakcie rozmowy | Nie wpływa na obecność w wyszukiwaniu | Reguły mogą nie mieć zastosowania, bo czynność inicjuje człowiek |
| OAI-AdsBot | Kontrola bezpieczeństwa stron docelowych zgłoszonych jako reklamy | Dotyczy wyłącznie reklamodawców | Odwiedza tylko strony zgłoszone w reklamach |
Niezależne ustawienia dla wyszukiwania i trenowania
Najważniejsza informacja z dokumentacji brzmi tak: ustawienia dla OAI-SearchBot i GPTBot są od siebie niezależne. Właściciel strony może pozwolić pierwszemu na dostęp, aby pojawiać się w wyszukiwaniu, i jednocześnie zabronić drugiemu, aby wyłączyć treści z trenowania. Jeżeli strona zezwala obu robotom, wydawca może wykorzystać wyniki jednego pobrania do obu celów, co ogranicza liczbę odwiedzin serwera.
Dokumentacja wskazuje też, że ChatGPT-User nie służy do ustalania, czy treść może pojawić się w wyszukiwaniu. Do wyłączenia strony z wyszukiwania służy wyłącznie OAI-SearchBot. Robot reklamowy OAI-AdsBot odwiedza tylko strony zgłoszone jako reklamy, a zebrane przez niego dane nie są używane do trenowania modeli.
Porównanie robotów innych asystentów, w tym ClaudeBot, PerplexityBot i Google-Extended, znajduje się w naszym wpisie o robotach AI i pliku robots.txt.
Jak sterować dostępem robotów: robots.txt i noindex
Dostępem OAI-SearchBot i GPTBot steruje się w pliku robots.txt, czyli w pliku tekstowym umieszczonym w głównym katalogu domeny. Wystarczy osobna grupa reguł dla każdego robota. Poniższy przykład przedstawia najczęściej wybierany układ: strona chce być widoczna w odpowiedziach ChatGPT, ale nie zgadza się na użycie treści do trenowania modeli.
User-agent: OAI-SearchBot
Allow: /

User-agent: GPTBot
Disallow: /

User-agent: *
Disallow: /koszyk/
Disallow: /panel-klienta/
Dokumentacja o robotach podaje, że po zmianie pliku robots.txt systemy wydawcy potrzebują około 24 godzin, aby uwzględnić nowe ustawienia w wyszukiwaniu. Efektu nie należy więc oceniać w dniu wdrożenia. Wydawca zaleca też, aby zapora serwera przepuszczała żądania z opublikowanych przez niego zakresów adresów IP. Ma to znaczenie przy hostingach i usługach ochronnych, które domyślnie odrzucają ruch automatyczny: reguła w robots.txt zezwala na dostęp, a zapora i tak zwraca robotowi błąd.
Blokada nie zawsze oznacza zniknięcie adresu
Zablokowanie OAI-SearchBot powoduje, że strona nie jest pokazywana w odpowiedziach wyszukiwania ChatGPT, jednak według dokumentacji nadal może pojawić się jako link nawigacyjny. Strona z pytaniami i odpowiedziami dla wydawców wyjaśnia to dokładniej: jeśli adres zablokowanej strony zostanie poznany od zewnętrznego dostawcy wyszukiwania lub w trakcie pobierania innych stron, może zostać pokazany sam link z tytułem, bez streszczenia i fragmentów treści.
Aby do tego nie dopuścić, wydawca wskazuje znacznik meta noindex. Jest tu jednak warunek, o którym łatwo zapomnieć: robot musi mieć możliwość pobrania strony, żeby ten znacznik odczytać. Strona zablokowana w robots.txt i jednocześnie oznaczona jako noindex pozostaje dla robota nieprzeczytana, więc znacznik nie zadziała. Podobną uwagę o wzajemnym wykluczaniu się reguł zawiera wprowadzenie Google do pliku robots.txt, które przypomina też, że plik ten służy do zarządzania ruchem robotów, a nie do ukrywania stron.
<meta name="robots" content="noindex">Jak wyglądają przypisy i linki w odpowiedzi ChatGPT
Odpowiedź przygotowana z użyciem wyszukiwania może zawierać przypisy umieszczone bezpośrednio w tekście, a pod nią przycisk ze źródłami. Wskazanie przypisu otwiera stronę źródłową, a w wersji na komputer po najechaniu kursorem wyświetla się jej podgląd. Przycisk ze źródłami pokazuje, według strony pomocy, zarówno źródła zacytowane, jak i inne powiązane linki. Wpis zapowiadający funkcję opisuje, że po jego użyciu otwiera się boczny panel z listą odnośników.
Z punktu widzenia firmy są to dwa różne poziomy obecności. Przypis w treści oznacza, że asystent oparł na danej stronie konkretne zdanie odpowiedzi i użytkownik widzi jej nazwę tuż przy nim. Pozycja na liście powiązanych linków oznacza, że strona została uznana za pasującą do tematu, ale nie posłużyła do zbudowania żadnego zdania. Trzecią możliwością jest opisany wcześniej link nawigacyjny, czyli sam adres z tytułem. Grafiki w odpowiedzi również prowadzą do stron, z których pochodzą, a w aplikacjach mobilnych przy pytaniach o miejsca może pojawić się mapa.
Warto przy tym odróżnić dwie rzeczy o podobnej nazwie. Wyszukiwanie w bocznym panelu aplikacji przeszukuje dotychczasowe rozmowy, projekty i pliki użytkownika, a nie sieć. Nie ma ono żadnego związku z widocznością stron firmowych.
Regularne zapisywanie takich odpowiedzi w stałym zestawie pytań opisujemy we wpisie o mierzeniu widoczności marki w odpowiedziach AI. Jeżeli w przypisach pojawiają się nieaktualne informacje o firmie, ich źródłem jest zwykle stara podstrona, dawny wpis w katalogu albo niepoprawione dane na profilach w mediach społecznościowych. Asystent ich nie wymyśla, lecz powtarza to, co znalazł.
Jeśli chcą Państwo zamówić pozycjonowanie AI, zachęcamy do kontaktu: tel. 222 500 844 lub mailowo: biuro@pozycjonowaniestron.pl
Co widać w logach serwera
W logach serwera każda wizyta robota zostawia wiersz z adresem IP, czasem, pobranym adresem, kodem odpowiedzi i nagłówkiem User-Agent. To jedyne miejsce, w którym widać, czy roboty ChatGPT faktycznie docierają do strony i co od niej dostają. Google Analytics ich nie pokaże, bo rejestruje wizyty ludzi w przeglądarce, a nie pobrania wykonywane przez programy.
Logi są dostępne w panelu hostingu, zwykle w dziale poświęconym statystykom lub plikom dziennika, pod nazwą logi dostępu. Wystarczy pobrać plik z ostatnich dni i wyszukać w nim trzy nazwy: OAI-SearchBot, GPTBot oraz ChatGPT-User. Dokumentacja podaje pełne brzmienie nagłówków, którymi roboty się przedstawiają. Numery wersji w tych nagłówkach zmieniają się z czasem, dlatego w wyszukiwaniu lepiej posługiwać się samą nazwą robota.
Mozilla/5.0 (Macintosh; Intel Mac OS X 10_15_7) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/131.0.0.0 Safari/537.36; compatible; OAI-SearchBot/1.4; +https://openai.com/searchbot

Mozilla/5.0 AppleWebKit/537.36 (KHTML, like Gecko); compatible; GPTBot/1.4; +https://openai.com/gptbot

Mozilla/5.0 AppleWebKit/537.36 (KHTML, like Gecko); compatible; ChatGPT-User/1.0; +https://openai.com/bot
Jak czytać te wpisy
Wizyty OAI-SearchBot świadczą o tym, że strona jest pobierana na potrzeby wyszukiwania. Wizyty ChatGPT-User pojawiają się wtedy, gdy ktoś w rozmowie wykonał czynność wymagającą otwarcia konkretnego adresu. Dla sklepu z Poznania szczególnie cenne jest zestawienie, które podstrony są w ten sposób otwierane: jeśli są to karty produktów i strona z kosztami dostawy, to właśnie o te informacje ludzie pytają asystenta. Wizyty GPTBot dotyczą trenowania i nie mówią nic o bieżących odpowiedziach.
Drugą rzeczą do odczytania jest kod odpowiedzi serwera. Kod 200 oznacza, że robot otrzymał stronę. Kody z grupy 403 i 429 oznaczają odmowę lub ograniczenie liczby żądań i najczęściej są skutkiem ustawień zapory albo usługi ochronnej, a nie pliku robots.txt. Kody z grupy 500 wskazują na błąd po stronie serwera. Dokumentacja wspomina też o szczególe ułatwiającym analizę: przy pobieraniu samego pliku robots.txt robot OAI-SearchBot może dodać do nagłówka oznaczenie „robots.txt”, dzięki czemu takie żądania da się odróżnić nawet w logach, które nie zapisują ścieżki.
Nagłówek User-Agent może wpisać dowolny program, więc sama nazwa nie jest dowodem tożsamości. Wydawca publikuje listy adresów IP dla każdego robota osobno, w plikach searchbot.json, gptbot.json i chatgpt-user.json we własnej domenie. Porównanie adresu z logu z taką listą pozwala odróżnić prawdziwego robota od programu, który jedynie się pod niego podszywa. Analizę logów i ustawień zapory wykonujemy w ramach SEO technicznego, zwykle razem z kontrolą tego, jak stronę pobiera robot Google.
Jak znaleźć wejścia z ChatGPT w Google Analytics
Wejścia z ChatGPT można odnaleźć w Google Analytics po źródle chatgpt.com. Strona z pytaniami i odpowiedziami dla wydawców podaje, że ChatGPT automatycznie dopisuje do adresów odsyłających parametr utm_source=chatgpt.com, a serwisy, które zezwalają na dostęp robotowi OAI-SearchBot, mogą śledzić ten ruch w narzędziach analitycznych. Parametr utm to dopisek w adresie, z którego Analytics odczytuje, skąd przyszedł odwiedzający.
W usłudze Google Analytics 4 należy otworzyć Raporty, następnie dział Pozyskanie i raport Pozyskiwanie ruchu. Jak opisuje pomoc Analytics, raport ten pokazuje, skąd pochodzą nowi i powracający użytkownicy, a jego domyślnym wymiarem jest „Sesja - domyślne grupowanie kanałów”. Nad tabelą trzeba zmienić wymiar na „Sesja - źródło/medium” albo „Sesja - źródło”, po czym w polu wyszukiwania nad tabelą wpisać słowo chatgpt. W tabeli pozostaną wiersze z tym źródłem wraz z liczbą sesji, czasem zaangażowania i kluczowymi zdarzeniami.
Odczytując ten raport, warto mieć na uwadze dwa ograniczenia. Raport pokazuje wyłącznie kliknięcia, czyli sytuacje, w których ktoś przeszedł z odpowiedzi na stronę. Nie pokazuje, ile razy firma została w odpowiedzi wymieniona bez kliknięcia. Z naszej praktyki wynika też, że część wejść trafia do Analytics bez parametru, na przykład wtedy, gdy użytkownik skopiuje adres i wklei go w nowym oknie. Taka wizyta zostanie zapisana jako wejście bezpośrednie. Liczby z raportu należy więc traktować jako dolną granicę, a nie pełny obraz.
Druga pożyteczna czynność to sprawdzenie stron docelowych. W tym samym raporcie można dołożyć drugi wymiar, „Strona docelowa + ciąg zapytania”, używając znaku plusa obok nazwy wymiaru. Widać wtedy, na które podstrony trafiają osoby z ChatGPT. U kancelarii z Krakowa będą to często wpisy odpowiadające na konkretne pytania, a nie strona główna. Stałe zestawienia tego rodzaju przygotowujemy w ramach analityki i raportowania SEO.
Jak ChatGPT wybiera źródła i co z tego wynika dla strony firmy
Wydawca nie opublikował listy czynników, według których ChatGPT wybiera źródła do odpowiedzi. Dokumentacja mówi jedynie, że w wyszukiwaniu może pojawić się każda publiczna strona, a warunkiem uwzględnienia treści w streszczeniach i fragmentach jest nieblokowanie robota OAI-SearchBot. Wszystko ponad to jest wnioskowaniem z opisanego mechanizmu i z obserwacji, dlatego należy ostrożnie podchodzić do zapewnień o „czynnikach rankingowych ChatGPT”.
Z samego mechanizmu wynika jednak kilka rzeczy pewnych. Skoro pytanie jest przepisywane na zapytania do wyszukiwarek, strona musi być w nich zaindeksowana i widoczna na frazy, które z takiego przepisania powstają. Skoro robot musi pobrać treść, serwer nie może mu odmawiać. Skoro asystent buduje odpowiedź z fragmentów, potrzebuje zdań, które wprost odpowiadają na pytanie: ile trwa usługa, co obejmuje, gdzie jest świadczona, jakie są warunki. Strona hydraulika z Łodzi, na której obszar działania i godziny dyżurów zapisano zwykłym tekstem, daje asystentowi gotowy materiał. Strona, na której te same informacje są wyłącznie na grafice, takiego materiału nie daje.
Z naszych obserwacji wynika ponadto, że asystent chętnie sięga po strony, które zawierają konkret: zakres usługi, warunki, porównanie rozwiązań, odpowiedzi na częste pytania. Pomaga też porządek w nagłówkach i dane strukturalne schema.org, choć dokumentacja wydawcy ChatGPT nie wymienia ich jako warunku. Podobne zależności dotyczą odpowiedzi generowanych przez Google, o czym piszemy we wpisie o AI Overviews.
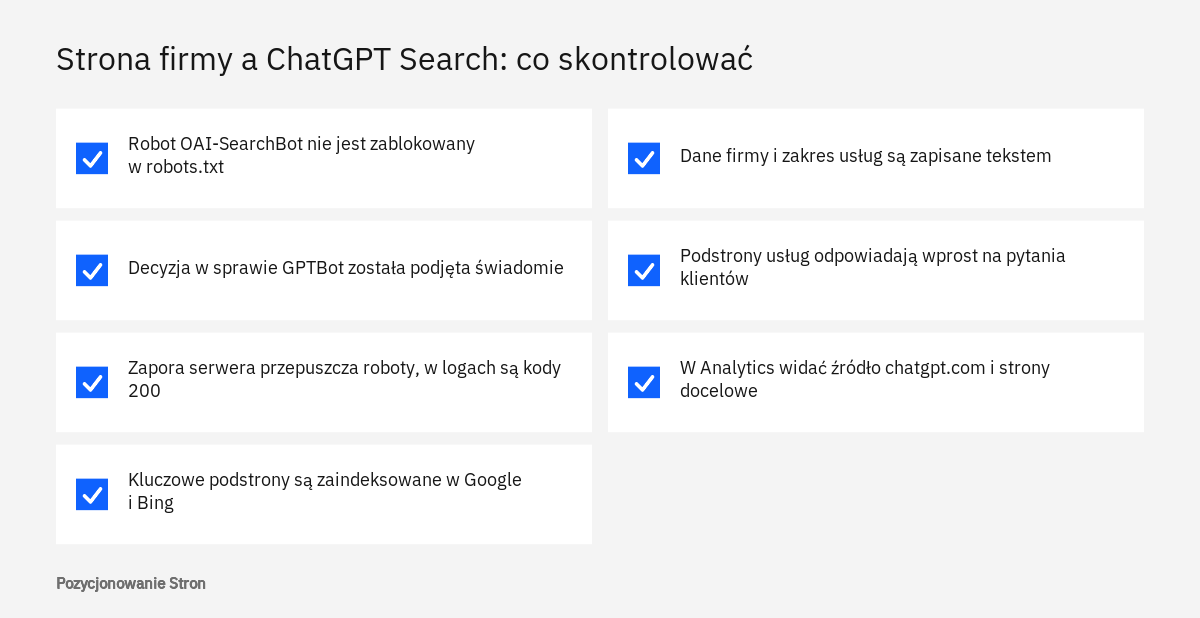
- Plik robots.txt nie blokuje robota OAI-SearchBot, a decyzja w sprawie GPTBot została podjęta świadomie.
- Zapora serwera i usługa ochronna przepuszczają żądania z opublikowanych zakresów adresów IP, co potwierdzają kody 200 w logach.
- Najważniejsze podstrony są zaindeksowane w Google i Bing.
- Nazwa firmy, adres, telefon, godziny i zakres usług są zapisane tekstem, a nie tylko na grafikach.
- Każda podstrona usługi odpowiada wprost na pytania, które klienci zadają przed zakupem.
- Dane firmy są takie same na stronie, w Profilu Firmy w Google i w mediach społecznościowych.
- W Google Analytics widać źródło chatgpt.com i wiadomo, na które podstrony prowadzi.
Typowe pomyłki i sytuacje, w których potrzebna jest pomoc
Najczęstszą pomyłką jest zablokowanie wszystkich robotów AI jedną regułą, z myślą o ochronie treści przed trenowaniem. Skutkiem ubocznym bywa zniknięcie strony z odpowiedzi ChatGPT, ponieważ razem z GPTBot zablokowany zostaje OAI-SearchBot. Zdarza się to zwłaszcza po włączeniu gotowej opcji blokowania robotów AI we wtyczce albo w panelu usługi ochronnej, bez sprawdzenia, które roboty obejmuje.
Druga pomyłka to mylenie robotów. Liczne wizyty GPTBot w logach nie oznaczają, że firma jest polecana w odpowiedziach, a brak wizyt ChatGPT-User nie oznacza, że strona jest niedostępna. Trzecia dotyczy łączenia blokady w robots.txt ze znacznikiem noindex na tej samej podstronie: robot nie odczyta znacznika, a adres może nadal pojawiać się jako link z tytułem. Czwarta to ocenianie zmian zbyt wcześnie, przed upływem doby potrzebnej na uwzględnienie nowego pliku robots.txt. Piąta to wyciąganie wniosków z jednej odpowiedzi asystenta, choć kolejna próba może wskazać inne źródła.
Pomoc specjalisty przydaje się wtedy, gdy logi pokazują odmowy mimo poprawnego pliku robots.txt, gdy strona jest dobrze widoczna w Google, a w odpowiedziach ChatGPT nie pojawia się wcale, gdy asystent powtarza o firmie nieaktualne lub krzywdzące informacje oraz gdy serwis jest duży i każda zmiana reguł dotyka tysięcy adresów. W takich przypadkach zaczynamy od audytu SEO obejmującego logi, ustawienia zapory i treść kluczowych podstron, a dalsze działania prowadzimy w ramach usługi pozycjonowanie AI. Nie obiecujemy przy tym obecności w konkretnej odpowiedzi, ponieważ o doborze źródeł decyduje asystent.
Jeśli chcą Państwo zamówić pozycjonowanie AI, zachęcamy do kontaktu: tel. 222 500 844 lub mailowo: biuro@pozycjonowaniestron.pl
Najczęstsze pytania
Czy ChatGPT zawsze przeszukuje sieć, zanim odpowie?
Nie. Według strony pomocy wyszukiwanie uruchamia się automatycznie, gdy pytanie wymaga aktualnych informacji, albo na życzenie użytkownika. W pozostałych przypadkach odpowiedź powstaje z wiedzy zapisanej w modelu i nie zawiera przypisów.
Czy zablokowanie GPTBot usunie stronę z odpowiedzi ChatGPT?
Nie. GPTBot dotyczy trenowania modeli, a za obecność w wyszukiwaniu odpowiada OAI-SearchBot. Dokumentacja wprost dopuszcza układ, w którym pierwszy robot jest zablokowany, a drugi ma dostęp.
Jak szybko działa zmiana w pliku robots.txt?
Wydawca podaje, że jego systemy potrzebują około 24 godzin od aktualizacji pliku, aby uwzględnić zmianę w wyszukiwaniu. Efektów nie należy więc oceniać tego samego dnia. Samo odblokowanie robota nie oznacza też, że strona od razu zacznie być cytowana.
Czy ChatGPT-User przestrzega pliku robots.txt?
Dokumentacja zaznacza, że ten robot działa na żądanie użytkownika, a nie przeszukuje sieci automatycznie, dlatego reguły robots.txt mogą nie mieć do niego zastosowania. Nie wpływa on również na to, czy strona pojawia się w wyszukiwaniu ChatGPT.
Dlaczego w Analytics nie widać robotów ChatGPT?
Google Analytics rejestruje wizyty ludzi w przeglądarce, a roboty pobierają strony bez uruchamiania kodu pomiarowego. Ich aktywność widać w logach serwera. W Analytics widoczne są natomiast kliknięcia użytkowników z odpowiedzi, oznaczone źródłem chatgpt.com.
Czy trzeba zgłaszać stronę do ChatGPT?
Dokumentacja o robotach nie opisuje formularza zgłoszeniowego ani przesyłania mapy witryny. Wydawca podaje, że w wyszukiwaniu może pojawić się każda publiczna strona, a warunkiem uwzględnienia treści jest dostęp dla robota OAI-SearchBot.
Czy da się zapłacić za miejsce w przypisach?
W dokumentach, które przeanalizowaliśmy, nie ma mowy o płatnym umieszczaniu stron w przypisach. Dokumentacja opisuje osobnego robota do kontroli stron docelowych reklam, co dotyczy reklam, a nie doboru źródeł odpowiedzi.
Źródła
- Overview of OpenAI Crawlers, OpenAI
- Searching the web with ChatGPT, OpenAI Help Center
- Publishers and Developers - FAQ, OpenAI Help Center
- Introducing ChatGPT search, OpenAI
- [GA4] Raport Pozyskiwanie ruchu, Pomoc Google Analytics
- Plik robots.txt - wprowadzenie i przewodnik, Centrum wyszukiwarki Google
Stan wiedzy: październik 2026. Funkcje wyszukiwarek i asystentów AI zmieniają się szybko, dlatego wpis aktualizujemy po większych zmianach.