Kanibalizacja słów kluczowych to sytuacja, w której dwie lub więcej podstron tej samej witryny odpowiada na to samo zapytanie i wzajemnie odbiera sobie widoczność. Najprościej wykryć ją w raporcie Skuteczność w Search Console: wystarczy zawęzić dane do jednej frazy i sprawdzić, ile adresów zbiera na nią wyświetlenia. Poniżej opisujemy, jak odróżnić problem od sytuacji zupełnie naturalnej, skąd biorą się konkurujące podstrony i w jakiej kolejności je porządkować.
Czym jest kanibalizacja słów kluczowych
Kanibalizacja słów kluczowych oznacza, że w jednej witrynie istnieje kilka podstron, które starają się odpowiedzieć na to samo pytanie użytkownika, przez co wyszukiwarka nie ma jasności, którą z nich pokazać. Zamiast jednej mocnej podstrony firma ma dwie lub trzy przeciętne, a każda z nich zbiera tylko część wyświetleń i kliknięć.
Warto od razu zaznaczyć, że jest to pojęcie z praktyki pozycjonowania, a nie termin z dokumentacji Google. Dokumentacja Google Search Central opisuje zjawisko pokrewne, czyli duplikaty i wybór strony kanonicznej. Są to dwie różne sprawy, choć często występują razem i bywają mylone.
Adres, który Google uznaje za najbardziej reprezentatywny spośród stron o takiej samej lub bardzo podobnej treści i który zwykle pokazuje w wynikach wyszukiwania.
Duplikat a kanibalizacja - na czym polega różnica
Duplikat to ta sama lub prawie ta sama treść dostępna pod kilkoma adresami, na przykład lista produktów posortowana po cenie albo wersja strony z dopisanym parametrem. Według dokumentacji Google o wyborze strony kanonicznej wyszukiwarka grupuje takie strony, wybiera jedną jako kanoniczną i to ją zazwyczaj wyświetla. Pozostałe adresy są skanowane rzadziej.
Kanibalizacja w ścisłym sensie dotyczy podstron, które duplikatami nie są. Mają inny tekst, inne nagłówki, często inną datę powstania, ale opisują ten sam temat z tej samej perspektywy. Google indeksuje je osobno i przy każdym zapytaniu musi zdecydować, która lepiej pasuje. Jeśli różnice między nimi są niewielkie, decyzja bywa zmienna.
To rozróżnienie ma znaczenie praktyczne, ponieważ każdy z przypadków naprawia się inaczej. Przy duplikatach wystarczy zazwyczaj uporządkować sygnały techniczne. Przy podstronach konkurujących treścią trzeba podjąć decyzję redakcyjną: połączyć teksty, rozdzielić ich tematy albo jeden z nich usunąć.
Jak to wygląda w zwykłej firmie
Hydraulik z Łodzi ma na stronie zakładkę z opisem usługi udrażniania rur. Kilka lat wcześniej opublikował też wpis blogowy o tym, jak wygląda udrażnianie kanalizacji, a jeszcze później dodał osobną podstronę z pogotowiem kanalizacyjnym. Wszystkie trzy adresy mają w tytule niemal te same słowa i wszystkie odpowiadają osobie, która po prostu szuka fachowca do zatkanej rury. Żaden z nich nie jest wyraźnie najlepszy, więc w wynikach pojawia się raz jeden, raz drugi, a linki wewnętrzne i zewnętrzne rozkładają się na trzy miejsca zamiast wzmacniać jedno.
Kiedy kanibalizacja szkodzi, a kiedy dwa adresy na jedną frazę to nic złego
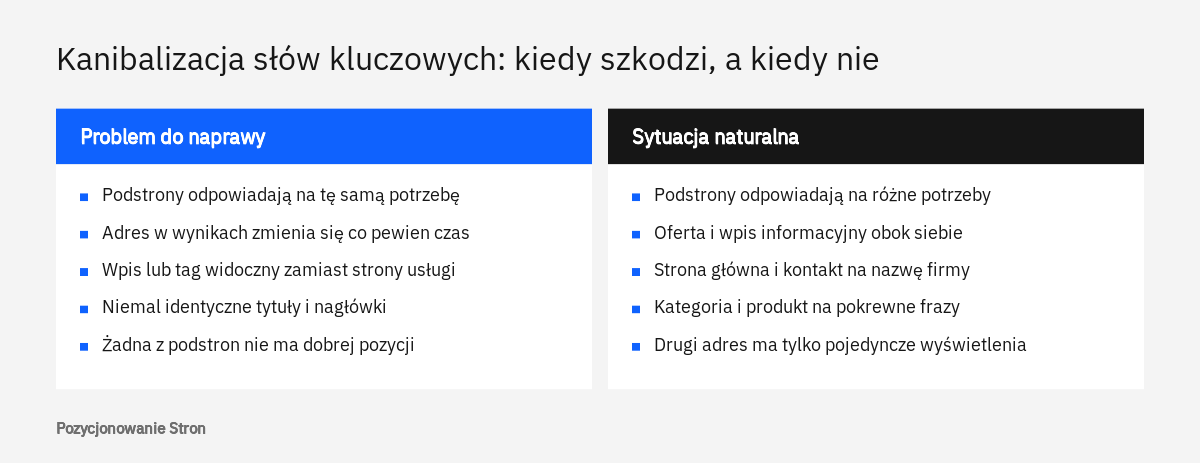
Kanibalizacja szkodzi wtedy, gdy kilka podstron odpowiada na tę samą intencję, czyli na tę samą potrzebę osoby szukającej, a w wynikach pojawia się nie ta, na której firmie najbardziej zależy. Sam fakt, że dwa adresy z witryny zbierają wyświetlenia na jedno zapytanie, nie jest jeszcze powodem do zmian.
Google opisuje w zestawieniu swoich systemów rankingowych tak zwany system różnorodności witryn. Dba on o to, aby jedna witryna nie zdominowała najważniejszych wyników, i domyślnie pozwala wyświetlać w nich maksymalnie 2 strony z tej samej witryny, a przy szczególnie istotnych zapytaniach nawet więcej. Wynika z tego prosta rzecz: dwa wyniki z jednej domeny na jedną frazę są sytuacją przewidzianą przez samą wyszukiwarkę. Jeśli oba stoją wysoko i oba są klikane, witryna zajmuje po prostu więcej miejsca w wynikach.
Sytuacje, których nie trzeba naprawiać
Nie ma powodu do zmian, gdy podstrony odpowiadają na różne potrzeby, mimo że dzielą część słów. Kancelaria z Krakowa może mieć podstronę usługi dotyczącej rozwodów oraz wpis wyjaśniający, jakie dokumenty przygotować przed złożeniem pozwu. Obie będą się pojawiać na zapytania ze słowem rozwód, ale pierwsza odpowiada komuś, kto szuka prawnika, a druga komuś, kto dopiero zbiera informacje. Podobnie nie jest problemem, gdy na nazwę firmy wyświetla się strona główna i strona kontaktowa, ani gdy na ogólną frazę pojawia się kategoria sklepu, a na bardziej szczegółową konkretny produkt.
Nie warto też reagować na pojedyncze wyświetlenia. Raport Skuteczność pokazuje każdy adres, który choć raz pojawił się w wynikach dla danego zapytania. Podstrona z kilkoma wyświetleniami na odległej pozycji nie odbiera niczego podstronie, która zbiera ich setki.
Sygnały, że problem jest realny
Na realny problem wskazuje kilka obserwacji naraz. Po pierwsze, dla ważnej frazy sprzedażowej w wynikach pojawia się wpis blogowy lub archiwum tagu zamiast strony usługi czy kategorii. Po drugie, adres wyświetlany na daną frazę zmienia się co pewien czas, a wraz z nim skacze średnia pozycja. Po trzecie, żadna z konkurujących podstron nie zajmuje dobrej pozycji, choć każda z osobna jest poprawnie przygotowana. Po czwarte, podstrony mają niemal identyczne tytuły i nagłówki, więc nawet człowiekowi trudno powiedzieć, czym się różnią.
Jak wykryć kanibalizację w raporcie Skuteczność w Search Console
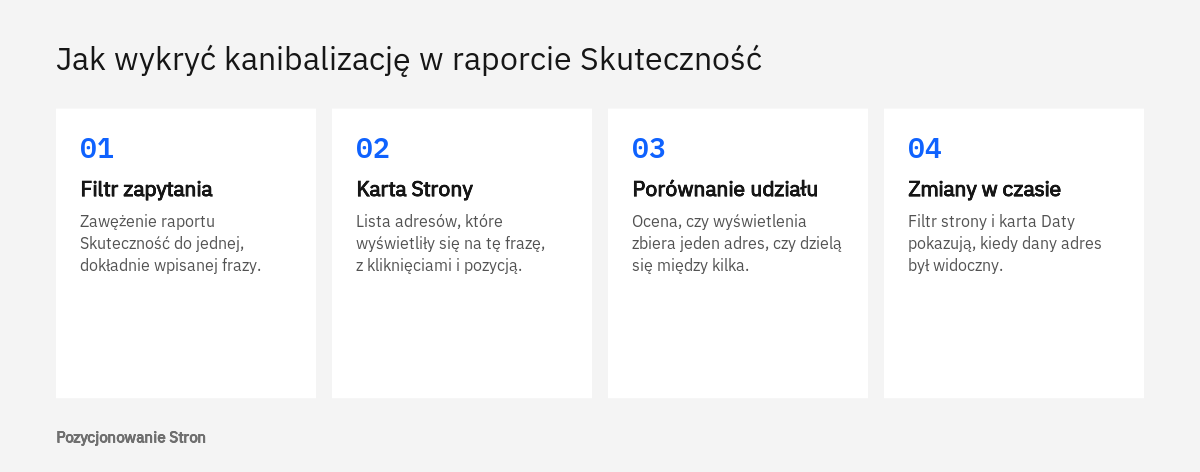
Kanibalizację wykrywa się, zawężając raport Skuteczność do jednego zapytania i przechodząc na kartę Strony, która pokazuje wszystkie adresy zbierające wyświetlenia na tę frazę. Search Console, czyli narzędzie Google dla właścicieli witryn, jest dostępne bez opłat i pokazuje dane pochodzące bezpośrednio z wyszukiwarki, dlatego od niego zaczynamy każdą diagnozę.
Raport znajduje się w menu Search Console pod nazwą Skuteczność, w części dotyczącej wyników wyszukiwania. Jak opisuje pomoc Search Console, nad tabelą widoczne są karty: Zapytania, Strony, Kraje, Urządzenia, Wygląd w wyszukiwarce i Daty, a domyślnie raport obejmuje ostatnie 3 miesiące. Dane zawęża się w pasku filtrowania u góry raportu.
Filtr zapytania i karta Strony
Diagnozę warto zacząć od listy fraz, które mają dla firmy największe znaczenie: nazw usług, kategorii produktów, połączeń usługi z miastem. Dla każdej z nich wykonuje się te same czynności.
- Ustawienie filtra zapytania
W pasku filtrowania należy dodać filtr zapytania i wpisać badaną frazę. Najlepiej wybrać dopasowanie dokładne, aby nie mieszać danych z frazami pokrewnymi. Wielkość liter nie ma w tym filtrze znaczenia.
- Przejście na kartę Strony
Po zastosowaniu filtra tabela na karcie Strony pokazuje adresy, które wyświetliły się na to zapytanie, wraz z kliknięciami, wyświetleniami, współczynnikiem klikalności i średnią pozycją każdego z nich.
- Porównanie udziału adresów
Jeśli jeden adres zbiera zdecydowaną większość wyświetleń, a pozostałe pojawiają się sporadycznie, sytuacja jest zdrowa. Jeśli wyświetlenia dzielą się między dwa lub trzy adresy w zbliżonych proporcjach, warto przyjrzeć się im bliżej.
- Sprawdzenie zmian w czasie
Dodanie drugiego filtra, tym razem strony, i obserwacja wykresu albo karty Daty pokazuje, w których dniach dany adres pojawiał się na tę frazę. Naprzemienne okresy widoczności dwóch adresów to typowy obraz kanibalizacji.
Jak czytać te dane, żeby nie wyciągnąć błędnych wniosków
Dane w raporcie mają kilka właściwości, które łatwo przeoczyć. Według pomocy Search Console wykres oraz tabela zapytań agregują dane według usługi, czyli całej witryny, natomiast tabela na karcie Strony agreguje je według strony. Gdy na jedno zapytanie wyświetlą się 2 wyniki z tej samej witryny, wykres policzy to jako 1 wyświetlenie, a karta Strony pokaże wyświetlenie przy każdym adresie osobno. Suma z tabeli stron może więc być wyższa niż liczba na wykresie i nie jest to błąd.
Druga właściwość dotyczy duplikatów. Pomoc Search Console wyjaśnia, że kliknięcia są przypisywane do kanonicznego adresu URL, a nie do duplikatu. Oznacza to, że jeśli na karcie Strony widać dwa różne adresy, Google traktuje je jako dwie odrębne strony, a nie jako kopie. Trzecia sprawa to kompletność: raport pokazuje tylko najważniejsze wiersze danych, a część zapytań jest pomijana ze względu na prywatność użytkowników, dlatego przy bardzo rzadkich frazach danych może po prostu nie być.
Średnia pozycja również wymaga ostrożności. W tabeli dotyczy ona konkretnego wiersza, na wykresie zaś najwyższego wyniku z całej witryny. Adres, który wyświetlił się kilka razy na wysokiej pozycji, może mieć lepszą średnią niż adres widoczny codziennie nieco niżej. Dlatego pozycję zawsze czytamy razem z liczbą wyświetleń.
Skąd bierze się kanibalizacja: najczęstsze źródła
Kanibalizacja prawie nigdy nie jest skutkiem jednej decyzji. Narasta latami, gdy witryna rośnie bez planu: dochodzą nowe wpisy, nowe kategorie i nowe podstrony, a nikt nie sprawdza, czy podobny temat nie został już opisany. Poniżej opisujemy źródła, które spotykamy najczęściej.
Stare wpisy blogowe
Blog prowadzony od wielu lat zwykle zawiera kilka tekstów o tym samym. Gabinet stomatologiczny z Bydgoszczy mógł opisać wybielanie zębów trzy razy: raz ogólnie, raz przy okazji nowej metody i raz w formie odpowiedzi na pytania pacjentów. Każdy wpis powstał w dobrej wierze, ale dziś wszystkie trzy konkurują ze stroną usługi. Dodatkowym kłopotem jest to, że starsze teksty bywają nieaktualne, a wciąż zbierają część wyświetleń.
Kategorie i tagi
W systemach takich jak WordPress każda kategoria i każdy tag tworzy osobną stronę archiwum z listą wpisów. Jeśli tag nazywa się tak samo jak usługa albo jak kategoria, powstaje kolejny adres na tę samą frazę, tyle że pozbawiony własnej treści. Zdarza się, że witryna ma kategorię o nazwie pozycjonowanie, tag o tej samej nazwie i stronę usługi z tym samym słowem w tytule. Trzy adresy, jeden temat.
Strony miast
Firmy działające w wielu miejscowościach tworzą podstrony lokalne z jednego wzoru, zmieniając w nich tylko nazwę miasta. Jeśli reszta treści jest identyczna, podstrony zaczynają konkurować ze sobą i ze stroną ogólną usługi, a wyszukiwarka może uznać je za bardzo podobne. Każda taka podstrona powinna zawierać informacje prawdziwe tylko dla danej miejscowości: obszar dojazdu, adres oddziału, przykłady realizacji, lokalne uwarunkowania. Szerzej opisujemy to przy okazji pozycjonowania lokalnego.
Filtry w sklepie
Sklep z Poznania sprzedający obuwie ma kategorię butów zimowych, a do tego filtry koloru, rozmiaru i marki. Każda kombinacja filtrów może tworzyć osobny adres. Google w dokumentacji dotyczącej nawigacji fasetowej, czyli właśnie filtrowania list, zwraca uwagę, że roboty uzyskują wtedy dostęp do bardzo dużej liczby adresów i mają mniej czasu na skanowanie nowych, przydatnych stron. Z punktu widzenia kanibalizacji kłopot jest inny: filtrowana lista bywa niemal identyczna z kategorią lub z inną, ręcznie utworzoną kategorią o tej samej nazwie. Więcej o porządkowaniu struktury sklepu piszemy we wpisie o pozycjonowaniu sklepu internetowego.
Wersje z parametrami i inne warianty adresu
Ta sama treść może być dostępna pod adresem z parametrem sortowania, z identyfikatorem kampanii, z ukośnikiem na końcu i bez niego, z przedrostkiem www i bez niego, przez HTTP i przez HTTPS. Google wymienia wśród typowych powodów powstawania duplikatów między innymi warianty protokołu, funkcje sortowania i filtrowania oraz przypadkowo dostępne wersje demonstracyjne witryny. To są duplikaty w ścisłym znaczeniu, więc na karcie Strony zwykle ich nie widać, ale rozpraszają sygnały i utrudniają analizę.
| Źródło | Jak je rozpoznać | Najczęstsze rozwiązanie |
|---|---|---|
| Stare wpisy blogowe | Kilka tekstów o tym samym temacie, podobne tytuły, część nieaktualna | Scalenie w jeden tekst i przekierowanie 301 ze starych adresów |
| Kategorie i tagi | Archiwum tagu widoczne na frazę usługi lub kategorii | Ograniczenie liczby tagów, usunięcie zbędnych z przekierowaniem |
| Strony miast | Podstrony różniące się tylko nazwą miejscowości | Dopisanie treści lokalnej albo połączenie podstron |
| Filtry w sklepie | Adresy z parametrami filtrów powielające kategorię | rel=canonical do kategorii lub ograniczenie skanowania filtrów |
| Warianty adresu | Ta sama treść pod kilkoma adresami | Przekierowanie 301 na jedną wersję i spójne linki wewnętrzne |
Jak Google wybiera stronę kanoniczną i grupuje duplikaty
Google grupuje strony o takiej samej lub bardzo podobnej głównej treści, a następnie wybiera z grupy jeden adres, który na podstawie zebranych sygnałów uznaje za najbardziej kompletny i przydatny. Ten adres staje się stroną kanoniczną: jest skanowany najczęściej i służy jako główne źródło oceny treści i jakości. Pozostałe adresy z grupy są odwiedzane rzadziej.
Dokumentacja wymienia czynniki, które wpływają na ten wybór: to, czy strona jest wyświetlana przez HTTP czy HTTPS, przekierowania, obecność adresu w mapie witryny oraz adnotacje rel=canonical. Właściciel witryny może więc wskazać swoją preferencję, ale Google zastrzega, że jest to wskazówka, a nie reguła, i z różnych powodów może wybrać inny adres.
W osobnym dokumencie o określaniu kanonicznego adresu URL Google porządkuje te metody według siły. Przekierowanie jest wyraźnym sygnałem, że kanoniczny ma być adres docelowy. Adnotacja rel=canonical także jest wyraźnym sygnałem. Mapa witryny to sygnał słaby. Metody się sumują, więc zastosowanie co najmniej dwóch zwiększa szansę, że w wynikach pojawi się adres preferowany przez właściciela. Jednocześnie wskazanie adresu kanonicznego nie jest obowiązkowe: gdy go zabraknie, Google wybierze wersję samodzielnie.
Gdzie sprawdzić, co wybrał Google
Wybór wyszukiwarki widać w narzędziu do sprawdzania adresów URL w Search Console. Po wpisaniu adresu narzędzie pokazuje dwa pola: adres kanoniczny określony przez użytkownika oraz adres kanoniczny wybrany przez Google. Jeśli się różnią, wyszukiwarka uznała badaną stronę za kopię innej. Według pomocy Search Console narzędzie opiera się na danych z ostatniego skanowania, a nie na bieżącej wersji strony, dlatego świeżo wprowadzonej zmiany może jeszcze nie pokazywać.
Szerszy obraz daje raport Indeksowanie stron. Wśród powodów, dla których adresy nie trafiły do indeksu, znajdują się między innymi stany: duplikat, w którym użytkownik nie oznaczył strony kanonicznej, duplikat, w którym wyszukiwarka wybrała inną stronę kanoniczną niż użytkownik, oraz alternatywna strona zawierająca prawidłowy tag strony kanonicznej. Pierwsze dwa warto przejrzeć pod kątem ważnych podstron. Trzeci oznacza, że wszystko działa zgodnie z zamierzeniem i nie wymaga działań.
Co z tego wynika dla kanibalizacji
Z opisu Google płyną dwa praktyczne wnioski. Pierwszy: jeśli dwie podstrony są do siebie zbyt podobne, wyszukiwarka może połączyć je w jedną grupę i pokazywać tylko jedną, niekoniecznie tę, na której firmie zależy. Drugi: skoro rel=canonical jest wskazówką dla stron o takiej samej lub bardzo podobnej treści, nie należy oczekiwać, że rozwiąże konflikt dwóch zupełnie różnych tekstów. Pomoc Search Console mówi wprost, że jeśli strona wskazana przez użytkownika nie jest podobna do bieżącej, Google jej nie wybierze. Dla podstron różnych, ale konkurujących tematem, właściwym narzędziem jest scalenie albo wyraźne rozdzielenie treści.
Jeśli chcą Państwo zamówić audyt SEO, zachęcamy do kontaktu: tel. 222 500 844 lub mailowo: biuro@pozycjonowaniestron.pl
Sposoby naprawy: scalenie, przekierowanie 301, rel=canonical i zmiana intencji
Kanibalizację naprawia się, doprowadzając do sytuacji, w której na każdą ważną potrzebę użytkownika odpowiada jedna, wyraźnie najlepsza podstrona. Do wyboru jest kilka metod i zwykle stosuje się je łącznie. O doborze decyduje to, czy konkurujące podstrony są kopiami, czy odrębnymi tekstami, oraz czy obie są firmie potrzebne.
Scalenie treści i przekierowanie 301
Gdy dwa teksty opisują to samo i żaden nie musi istnieć osobno, najlepszym wyjściem jest połączenie ich w jeden pełniejszy materiał pod adresem, który ma lepsze wyniki, i przekierowanie drugiego adresu. Z tekstu przeznaczonego do usunięcia przenosi się wszystko, co wartościowe: akapity, których brakuje w wersji docelowej, przykłady, odpowiedzi na pytania. Dopiero potem ustawia się przekierowanie.
Przekierowanie musi być stałe. Jak wyjaśnia dokumentacja Google o przekierowaniach, przy przekierowaniu stałym, czyli z kodem 301 lub 308, wyszukiwarka traktuje adres docelowy jako kanoniczny i to jego pokazuje w wynikach. Przekierowanie tymczasowe, na przykład 302, takiego sygnału nie daje, a w wynikach pozostaje zwykle adres źródłowy. Google zaleca przekierowania wykonywane po stronie serwera, a rozwiązania oparte na JavaScript tylko wtedy, gdy innej możliwości nie ma.
Przekierowanie powinno prowadzić na podstronę o tym samym temacie. Kierowanie wszystkich usuwanych wpisów na stronę główną jest wygodne, ale użytkownik, który kliknął wynik o konkretnym zagadnieniu, trafia wtedy w miejsce, które na jego pytanie nie odpowiada.
Znacznik rel=canonical
Znacznik rel=canonical sprawdza się wtedy, gdy obie wersje muszą pozostać dostępne dla użytkowników, a treść jest taka sama lub bardzo podobna. Typowy przykład to lista produktów z filtrem lub sortowaniem, która powinna wskazywać na adres kategorii. Google podaje kilka zasad poprawnego wdrożenia: znacznik działa tylko w sekcji head dokumentu, zalecane są pełne adresy zamiast ścieżek względnych, strona kanoniczna powinna wskazywać samą siebie, a różne metody nie mogą wskazywać różnych adresów, na przykład jednego w mapie witryny i innego w znaczniku.
W WordPressie i podobnych systemach adres kanoniczny ustawia się zwykle w ustawieniach dotyczących wyszukiwarek, bez edycji kodu. Po zmianie warto zajrzeć do źródła strony i upewnić się, że znacznik faktycznie wskazuje zamierzony adres, ponieważ Google wymienia błędne ustawienia systemu lub wtyczek wśród typowych przyczyn nieoczekiwanego wyboru strony kanonicznej.
Zmiana intencji podstrony
Jeśli obie podstrony są potrzebne, trzeba sprawić, by odpowiadały na różne pytania. Strona usługi powinna mówić o ofercie: zakresie, przebiegu współpracy, obszarze działania. Wpis blogowy powinien odpowiadać na pytanie informacyjne, na przykład jak przygotować się do usługi albo jak rozpoznać, że jest potrzebna. Zmiana obejmuje tytuł, nagłówki i samą treść, a nie tylko podmianę jednego słowa. Zasady przygotowywania takich tekstów opisujemy we wpisie o tym, jak pisać treści SEO.
Google podaje przy tym istotną informację o czasie: strony mogą pozostawać w jednej grupie duplikatów przez maksymalnie 2 tygodnie nawet po poprawieniu treści, a rozdzielają się zwykle szybciej, gdy nowa treść wyraźnie i istotnie różni się od pozostałych. Kosmetyczne zmiany nie wystarczą.
Linkowanie wewnętrzne
Linki wewnątrz witryny powinny konsekwentnie prowadzić do podstrony, która ma być widoczna na daną frazę. Google zaleca wprost, aby linki w witrynie kierowały do adresu uznawanego za kanoniczny, a nie do jego duplikatów, ponieważ spójność pomaga wyszukiwarce zrozumieć preferencje właściciela. W praktyce oznacza to przejrzenie menu, stopki, wpisów blogowych i opisów kategorii oraz poprawienie odnośników, które prowadzą do wersji słabszej, przekierowanej albo opatrzonej parametrem. Tekst odnośnika powinien jasno mówić, co znajduje się na stronie docelowej, a ta sama nazwa usługi nie powinna raz prowadzić do strony oferty, a raz do wpisu.
Noindex: do czego służy i kiedy go nie używać
Znacznik noindex usuwa stronę z wyników wyszukiwania Google i nie jest narzędziem do rozstrzygania, która z dwóch podobnych podstron ma być widoczna. Google odradza używanie go do kierowania wyborem strony kanonicznej w obrębie jednej witryny, ponieważ całkowicie wyłącza stronę z wyszukiwarki, i jako właściwe rozwiązanie wskazuje rel=canonical.
Różnica jest zasadnicza. Przekierowanie i rel=canonical mówią wyszukiwarce, że dwa adresy należy traktować jako jedną treść i który z nich jest główny. Noindex mówi jedynie, że danej strony ma w wynikach nie być. Podstrona, która miała własne wyświetlenia i kliknięcia, po prostu z nich znika, a niczego nie przekazuje wersji, która zostaje.
Kiedy noindex ma uzasadnienie
Noindex jest dobrym wyborem dla stron, które muszą istnieć dla użytkowników, ale nie mają czego szukać w wynikach: wyników wewnętrznej wyszukiwarki, archiwów tagów bez własnej treści, stron podziękowania po wysłaniu formularza. W takich przypadkach nie chodzi o wskazanie lepszej wersji, tylko o świadome wyłączenie adresu z wyszukiwarki.
Noindex a blokada w pliku robots.txt
Według dokumentacji Google o blokowaniu indeksowania znacznik zadziała tylko wtedy, gdy robot może stronę odczytać. Jeśli adres jest jednocześnie zablokowany w pliku robots.txt, robot nie zobaczy reguły noindex, a strona może nadal pojawiać się w wynikach, na przykład dzięki linkom z innych stron. Z tego samego powodu Google zaznacza, że plik robots.txt nie służy do wyboru strony kanonicznej, a narzędzie do usuwania adresów ukrywa w wyszukiwarce wszystkie wersje adresu, więc również się do tego nie nadaje.
Kolejność prac i sposób sprawdzenia efektu
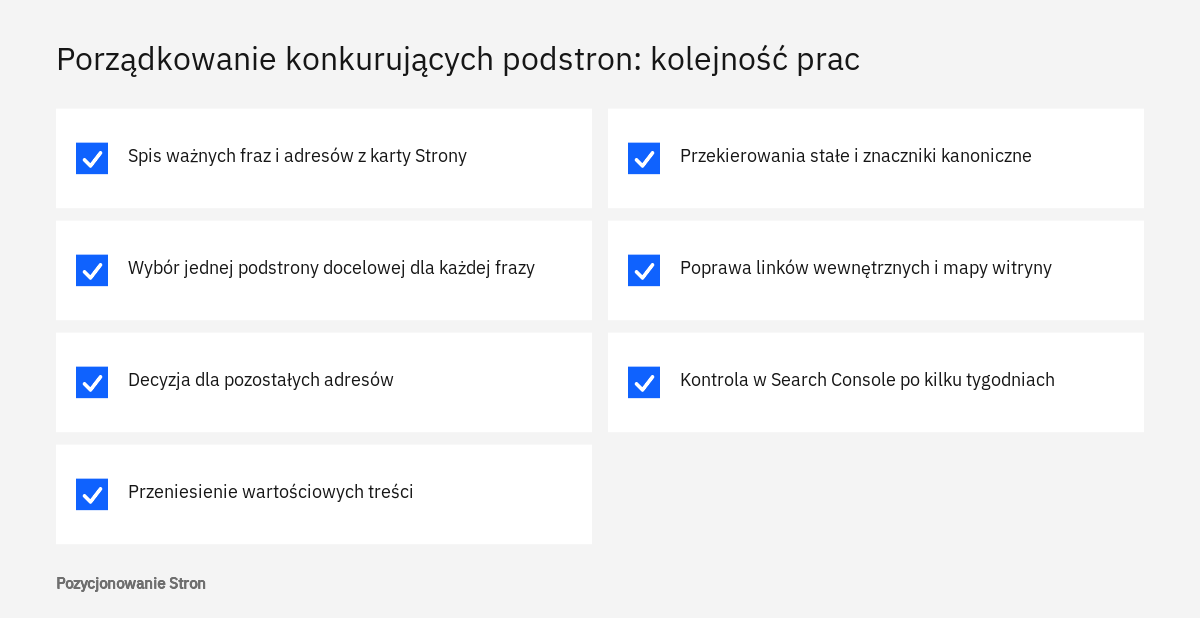
Porządkowanie zaczyna się od listy fraz i przypisanych do nich podstron, a kończy ponownym sprawdzeniem tych samych fraz w raporcie Skuteczność. Kolejność ma znaczenie, ponieważ przekierowanie ustawione przed przeniesieniem treści albo przed poprawą linków wewnętrznych tworzy nowe problemy zamiast usuwać stare.
- Spis fraz i adresów
Dla każdej ważnej frazy zapisujemy adresy widoczne na karcie Strony wraz z liczbą wyświetleń i kliknięć. Powstaje prosta tabela: fraza, adresy, które na nią odpowiadają, oraz adres, który powinien na nią odpowiadać.
- Wybór podstrony docelowej
Dla każdej frazy wskazujemy jedną podstronę główną. Zwykle jest to strona usługi lub kategoria, a przy frazach informacyjnych najlepszy wpis. Bierzemy pod uwagę dotychczasowe wyniki, jakość treści oraz to, czy do adresu prowadzą linki z innych witryn.
- Decyzja dla pozostałych adresów
Każdy pozostały adres otrzymuje jedną z decyzji: scalenie i przekierowanie, rel=canonical, zmiana tematu albo pozostawienie bez zmian, jeśli odpowiada na inną potrzebę.
- Przeniesienie treści i wdrożenie zmian
Najpierw uzupełniamy podstronę docelową o wartościowe fragmenty, potem ustawiamy przekierowania stałe i znaczniki kanoniczne.
- Poprawa linków i mapy witryny
Linki wewnętrzne kierujemy bezpośrednio na adresy docelowe, a z mapy witryny usuwamy adresy przekierowane i niekanoniczne.
- Kontrola w Search Console
Dla najważniejszych adresów korzystamy z narzędzia do sprawdzania adresów URL, a po kilku tygodniach wracamy do raportu Skuteczność.
Jak sprawdzić, czy porządki zadziałały
Pierwszą kontrolę można wykonać od razu po wdrożeniu. Narzędzie do sprawdzania adresów URL pozwala przetestować wersję opublikowaną strony, czyli tę, którą Google pobrałby w danej chwili, oraz zgłosić prośbę o zindeksowanie. Pomoc Search Console zaznacza jednak, że test wersji opublikowanej nie sprawdza wyboru strony kanonicznej, a prośby podlegają dziennemu limitowi, więc warto stosować je tylko dla najważniejszych adresów. Indeksowanie trwa zwykle około dnia, czasem dłużej, i nie jest gwarantowane.
Właściwy efekt widać dopiero w danych. Po kilku tygodniach należy ponownie ustawić filtr zapytania i otworzyć kartę Strony. Dobry obraz to jeden adres zbierający niemal wszystkie wyświetlenia na daną frazę oraz adresy przekierowane, które stopniowo znikają z tabeli. W raporcie Indeksowanie stron przekierowane adresy przechodzą do stanu opisanego jako strona zawierająca przekierowanie, co jest zachowaniem prawidłowym, a nie błędem.
Zmiana pozycji nie musi nastąpić od razu ani w każdym przypadku. Uporządkowanie podstron usuwa przeszkodę, ale o miejscu w wynikach decyduje wiele innych czynników, w tym jakość treści i działania konkurencji. Dlatego nie składamy obietnic co do konkretnych pozycji, a efekt oceniamy po tym, czy na daną frazę wyświetla się właściwa podstrona i jak zmieniają się jej wyświetlenia oraz kliknięcia. Taka analiza jest stałym elementem analityki i raportowania SEO.
Typowe błędy przy porządkowaniu konkurujących podstron
Najczęstszym błędem jest usuwanie podstron bez sprawdzenia, czy rzeczywiście szkodzą. Zdarza się, że właściciel witryny usuwa wszystkie wpisy zawierające nazwę usługi, a wraz z nimi traci wejścia z zapytań informacyjnych, które ze stroną oferty w ogóle nie konkurowały. Każdą decyzję należy oprzeć na danych z karty Strony, a nie na samym podobieństwie tytułów.
Drugi błąd to usunięcie adresu bez przekierowania. Użytkownik, który trafi na taki adres z wyników lub z linku na innej stronie, zobaczy komunikat o braku strony, a wszystko, co dany adres wypracował, przepada. Trzeci błąd to przekierowanie tymczasowe zamiast stałego. Jak wynika z dokumentacji Google, tylko przekierowanie stałe jest sygnałem, że adres docelowy ma być kanoniczny.
Często spotykamy także sprzeczne sygnały: znacznik kanoniczny wskazuje jeden adres, mapa witryny zawiera drugi, a menu prowadzi do trzeciego. Google odradza wskazywanie różnych adresów kanonicznych różnymi metodami. Podobny skutek ma łączenie znacznika noindex z blokadą w pliku robots.txt, o czym była mowa wyżej.
Osobną grupą pomyłek jest stosowanie rel=canonical między podstronami o różnej treści, na przykład ze wszystkich stron miast na stronę ogólną usługi. Skoro znacznik dotyczy stron takich samych lub bardzo podobnych, wyszukiwarka może taką wskazówkę pominąć, a jeśli ją uwzględni, strony miast przestaną być widoczne na zapytania lokalne. Wreszcie błędem jest pośpiech: ocenianie efektu po kilku dniach i wprowadzanie kolejnych zmian, zanim robot zdążył odwiedzić poprawione adresy. Jeśli porządki odbywają się przy okazji przebudowy serwisu, warto zapoznać się z zasadami opisanymi we wpisie o migracji strony bez utraty pozycji.
Lista kontrolna po zakończeniu prac
- Każda ważna fraza ma przypisaną jedną podstronę docelową.
- Wartościowe fragmenty z usuwanych tekstów zostały przeniesione przed ustawieniem przekierowań.
- Przekierowania są stałe i prowadzą bezpośrednio na podstronę o tym samym temacie.
- Znacznik kanoniczny, mapa witryny i linki wewnętrzne wskazują ten sam adres.
- Strona kanoniczna zawiera znacznik wskazujący na samą siebie, zapisany pełnym adresem.
- Żaden adres z regułą noindex nie jest zablokowany w pliku robots.txt.
- Podstrony, które zostały, różnią się tytułem, nagłówkami i odpowiadają na inne pytania.
- Stan wyjściowy z raportu Skuteczność został zapisany do późniejszego porównania.
Przegląd konkurujących podstron jest jednym z elementów, które obejmuje audyt SEO, a wdrożenie przekierowań i znaczników kanonicznych należy do zakresu prac, jakie wykonujemy w ramach SEO technicznego. O tym, co jeszcze sprawdza się podczas takiej analizy, piszemy we wpisie o tym, co zawiera audyt SEO.
Jeśli chcą Państwo zamówić SEO techniczne, zachęcamy do kontaktu: tel. 222 500 844 lub mailowo: biuro@pozycjonowaniestron.pl
Najczęstsze pytania
Czy kanibalizacja słów kluczowych to kara od Google?
Nie. Google wyraźnie podaje, że powielone treści w witrynie nie naruszają zasad dotyczących spamu. Kanibalizacja nie jest sankcją, tylko skutkiem tego, że wyszukiwarka musi wybierać między kilkoma podobnymi podstronami i nie zawsze wybiera tę, na której firmie zależy.
Czy dwie podstrony w wynikach na jedną frazę zawsze oznaczają problem?
Nie. Google opisuje, że domyślnie może pokazać w najważniejszych wynikach maksymalnie 2 strony z tej samej witryny. Jeśli obie stoją wysoko i odpowiadają na nieco inne potrzeby, jest to sytuacja korzystna. Problem pojawia się, gdy adresy się zmieniają, a żaden nie osiąga dobrej pozycji.
Czy do wykrycia kanibalizacji potrzebne są płatne narzędzia?
Nie są konieczne. Raport Skuteczność w Search Console z filtrem zapytania i kartą Strony pokazuje, które adresy wyświetlają się na daną frazę, a narzędzie do sprawdzania adresów URL pokazuje, którą stronę Google uznał za kanoniczną. Przy dużych witrynach przegląd wymaga jedynie więcej czasu.
Co wybrać: przekierowanie 301 czy rel=canonical?
Przekierowanie stosuje się wtedy, gdy stary adres nie jest już potrzebny użytkownikom. Znacznik rel=canonical jest właściwy, gdy obie wersje muszą pozostać dostępne, na przykład lista produktów z filtrem. Google oba rozwiązania określa jako wyraźne sygnały, przy czym wskazanie adresu kanonicznego pozostaje dla wyszukiwarki wskazówką, a nie regułą.
Czy można po prostu oznaczyć słabszą podstronę znacznikiem noindex?
Google odradza używanie tego znacznika do wskazywania wersji kanonicznej w obrębie jednej witryny, ponieważ całkowicie usuwa on stronę z wyników. Ma uzasadnienie przy stronach, które w ogóle nie powinny być widoczne w wyszukiwarce, takich jak wyniki wyszukiwania wewnętrznego.
Po jakim czasie widać efekt porządkowania?
Zależy to od tego, jak szybko robot ponownie odwiedzi zmienione adresy. Google podaje, że strony mogą pozostawać w jednej grupie duplikatów przez maksymalnie 2 tygodnie po zmianie treści, a ponowne skanowanie mniej ważnych adresów może potrwać znacznie dłużej. Dlatego wyniki oceniamy po kilku tygodniach, a nie po kilku dniach.
Czy strony miast zawsze kanibalizują stronę usługi?
Nie, o ile każda zawiera treść właściwą tylko dla danej miejscowości i odpowiada na zapytania lokalne. Kłopot powstaje, gdy podstrony różnią się wyłącznie nazwą miasta. Wówczas należy je rozbudować o informacje lokalne albo ograniczyć ich liczbę.
Źródła
- Co to jest wybór strony kanonicznej, Google Search Central
- Jak określić kanoniczny URL za pomocą rel="canonical" i innych metod, Google Search Central
- Rozwiązywanie problemów z wyborem strony kanonicznej, Google Search Central
- Przekierowania a wyszukiwarka Google, Google Search Central
- Blokowanie indeksowania przez wyszukiwarki za pomocą tagu noindex, Google Search Central
- Zarządzanie indeksowaniem adresów URL nawigacji fasetowej, Google Search Central
- Systemy rankingowe wyszukiwarki Google, Google Search Central
- Optymalizacja witryn pod kątem wyszukiwarek (SEO) - podstawy, Google Search Central
- Raport skuteczności (wyniki wyszukiwania): omówienie i podstawowa konfiguracja, Search Console - pomoc
- Raport skuteczności (wyniki wyszukiwania): wymiary i grupowanie danych, Search Console - pomoc
- Co to są wyświetlenia, pozycja i kliknięcia?, Search Console - pomoc
- Narzędzie do sprawdzania adresów URL, Search Console - pomoc
- Raport Indeksowanie stron, Search Console - pomoc
Stan wiedzy: październik 2026. Funkcje wyszukiwarek i asystentów AI zmieniają się szybko, dlatego wpis aktualizujemy po większych zmianach.