Plik robots.txt decyduje o tym, czy robot wyszukiwarki w ogóle pobierze dany adres, znacznik noindex o tym, czy pobrana strona trafi do wyników, a canonical o tym, który z kilku podobnych adresów ma reprezentować treść. Każde z tych narzędzi odpowiada na inne pytanie, dlatego użyte zamiennie albo razem na jednym adresie potrafią się wzajemnie wyłączyć. Poniżej opisujemy, co każde z nich robi, czego nie robi i które wybrać w typowych sytuacjach na stronie firmy.
Czym różnią się canonical, noindex i robots.txt
Różnią się etapem pracy wyszukiwarki, na którym działają. Google najpierw pobiera adres (skanowanie), potem decyduje, czy zapisać stronę w swojej bazie (indeksowanie), a na końcu wybiera spośród podobnych stron jedną, którą pokaże w wynikach (wybór strony kanonicznej). Robots.txt dotyczy pierwszego etapu, noindex drugiego, canonical trzeciego. Kto o tym wie, ten rzadko sięga po niewłaściwe narzędzie.
W praktyce pomyłki biorą się z tego, że wszystkie trzy mechanizmy kojarzą się z jednym celem: "żeby Google tego nie pokazywało". Tymczasem tylko jeden z nich rzeczywiście usuwa stronę z wyników. Pozostałe dwa robią coś innego i tylko czasem, przy okazji, dają podobny efekt.
Skanowanie to pobranie adresu przez robota wyszukiwarki. Indeksowanie to zapisanie pobranej strony w bazie, z której wyszukiwarka układa wyniki. Strona może być znana Google z samych linków, nawet jeśli nigdy nie została pobrana.
| Cecha | Robots.txt | Noindex | Canonical |
|---|---|---|---|
| Na co odpowiada | Czy robot może pobrać ten adres | Czy strona może być w wynikach | Który z podobnych adresów jest główny |
| Gdzie się go umieszcza | Jeden plik w katalogu głównym hosta | Znacznik meta w kodzie strony albo nagłówek HTTP | Znacznik link w kodzie strony albo nagłówek HTTP |
| Czy usuwa stronę z wyników | Nie | Tak, po ponownym pobraniu strony | Nie, łączy podobne adresy w jeden |
| Czy robot musi pobrać stronę | Nie, czyta tylko plik | Tak | Tak |
| Siła działania | Reguła, której dobrowolnie przestrzegają roboty | Reguła stosowana przez Google | Sygnał, który Google może pominąć |
| Główne zastosowanie | Ograniczenie zbędnego ruchu robotów | Wykluczenie strony z wyników | Porządkowanie duplikatów |
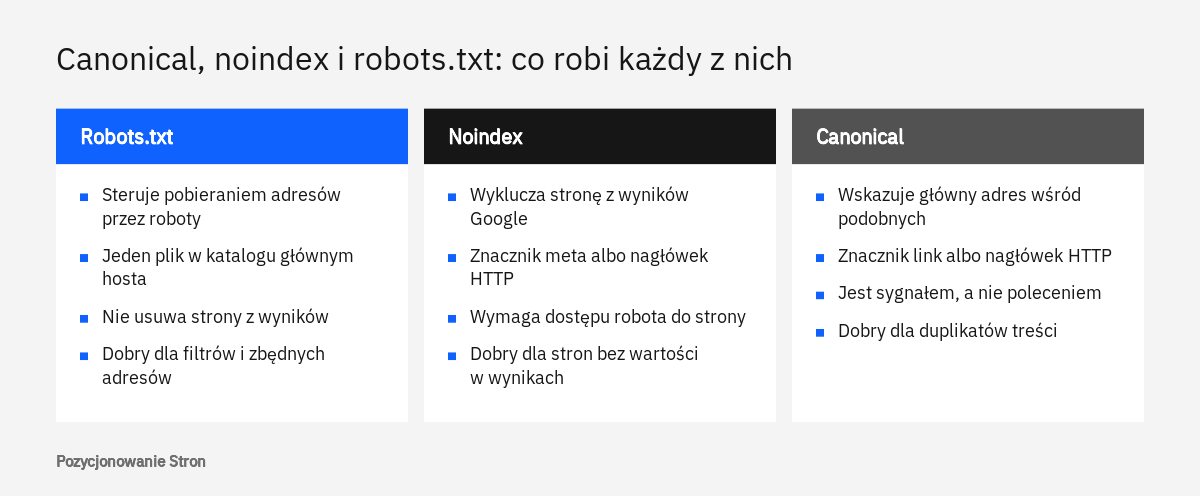
Tabela pokazuje jeszcze jedną ważną zależność: noindex i canonical znajdują się na samej stronie, więc robot musi ją pobrać, żeby je zobaczyć. Robots.txt jest osobnym plikiem, który robot czyta przed wizytą na stronie. Z tej jednej różnicy wynika większość problemów opisanych w dalszych sekcjach.
Co robi plik robots.txt, a czego nie robi
Plik robots.txt informuje roboty wyszukiwarek, do których adresów w witrynie mogą uzyskać dostęp. Według wprowadzenia do robots.txt w Google Search Central służy on głównie temu, by serwer nie był przeciążany żądaniami robotów, i nie jest mechanizmem ukrywania strony przed Google. To zdanie z dokumentacji warto zapamiętać, bo przeczy najczęstszemu sposobowi użycia tego pliku.
Jak wygląda i gdzie leży
Plik musi nazywać się robots.txt i leżeć w katalogu głównym hosta, a witryna może mieć tylko jeden taki plik. Zgodnie z instrukcją tworzenia pliku robots.txt jego reguły obowiązują wyłącznie dla protokołu, hosta i portu, pod którymi został opublikowany. Plik w domenie głównej nie obejmuje więc subdomeny - sklep działający pod osobną subdomeną potrzebuje własnego pliku. Reguły składają się z grup: wiersz user-agent wskazuje robota, a wiersze disallow i allow podają ścieżki zabronione i dozwolone. Wielkość liter w ścieżkach ma znaczenie.
User-agent: *
Disallow: /koszyk/
Disallow: /*?s=

Sitemap: https://www.example.com/sitemap.xml
Dlaczego zablokowany adres może trafić do wyników
Blokada w robots.txt zatrzymuje pobieranie, ale nie zapisywanie adresu w bazie Google. Jeśli do zablokowanej strony prowadzą linki z innych miejsc, jej adres nadal może pojawić się w wynikach wyszukiwania, tyle że bez opisu, bo robot nie poznał treści. Dokumentacja wymienia to wprost jako ograniczenie pliku. Drugie ograniczenie: reguły nie wymuszają niczego technicznie. Przestrzeganie ich zależy od robota, a różne roboty mogą inaczej interpretować składnię. Osobnym tematem są roboty asystentów AI, które opisujemy we wpisie o robotach AI i pliku robots.txt.
Z tego samego źródła wynika podział na rodzaje plików. Dla stron internetowych plik służy do zarządzania ruchem robotów i nie powinien być używany do ukrywania stron w wynikach. Dla plików multimedialnych, czyli grafik, wideo i dźwięku, może posłużyć do wykluczenia ich z wyników. Pliki zasobów, takie jak skrypty i arkusze stylów, można blokować tylko wtedy, gdy ich brak nie utrudnia Google zrozumienia strony.
Co robi noindex i kiedy przestaje działać
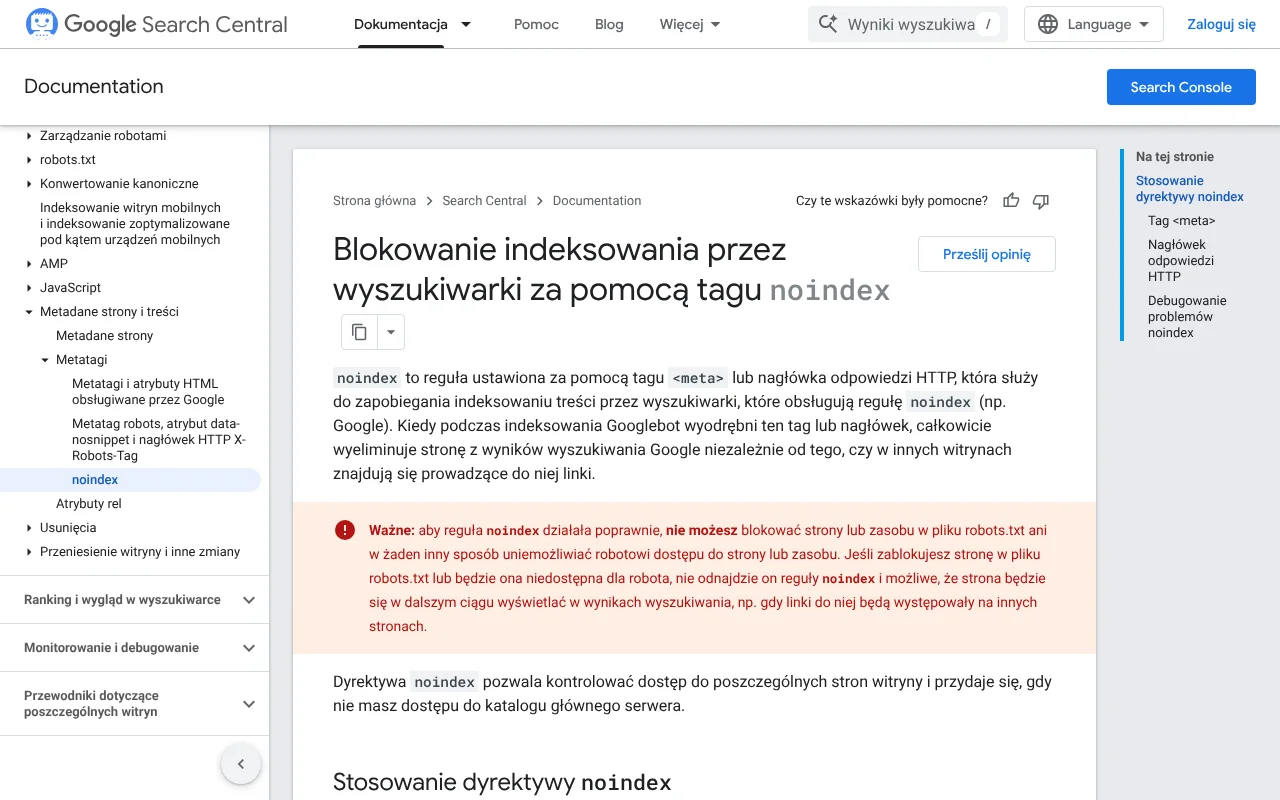
Noindex to reguła, która zapobiega umieszczeniu strony w wynikach wyszukiwania. Jak podaje strona o blokowaniu indeksowania za pomocą noindex, po odczytaniu tej reguły Google całkowicie usuwa stronę z wyników, nawet jeśli linkują do niej inne witryny. To jedyny z trzech omawianych mechanizmów, który rzeczywiście wyklucza stronę z wyników Google.
Dwie postacie: znacznik meta i nagłówek HTTP
Regułę można podać na dwa sposoby i oba dają ten sam efekt. Pierwszy to znacznik meta w sekcji head kodu strony. Drugi to nagłówek odpowiedzi serwera o nazwie X-Robots-Tag, przydatny dla plików, które nie mają kodu HTML, na przykład dokumentów PDF, grafik czy wideo. W systemach zarządzania treścią, takich jak WordPress, zwykle nie trzeba edytować kodu ręcznie - dokumentacja Google zaznacza, że często istnieje osobna strona ustawień wyszukiwarki albo inny sposób ustawienia znaczników meta.
<meta name="robots" content="noindex">

HTTP/1.1 200 OK
X-Robots-Tag: noindex
Warunek: robot musi stronę pobrać
Noindex działa tylko wtedy, gdy robot ma dostęp do strony. Specyfikacja metatagów robots wyjaśnia, że znaczniki meta i nagłówki X-Robots-Tag są odczytywane podczas skanowania adresu. Jeśli plik robots.txt blokuje skanowanie, robot nie zobaczy reguł dotyczących indeksowania i ich nie zastosuje. Dlatego strona z noindex nie może być jednocześnie zablokowana w robots.txt. Ta sama dokumentacja dodaje, że wpisanie noindex do samego pliku robots.txt nie jest przez Google obsługiwane.
Druga rzecz to czas. Strona nie znika z wyników w chwili dodania znacznika, lecz dopiero po ponownej wizycie robota. Według dokumentacji taka wizyta może nastąpić nawet po kilku miesiącach, zależnie od znaczenia strony. Można to przyspieszyć, prosząc o ponowne zindeksowanie w narzędziu do sprawdzania adresów URL w Search Console. Trzeba też wiedzieć, że noindex dotyczy wyszukiwarek, które go obsługują, a strona pozostaje dostępna dla każdego, kto zna jej adres.
Co robi canonical i dlaczego Google może go pominąć
Canonical, czyli wskazanie strony kanonicznej, mówi wyszukiwarce, który z kilku adresów o tej samej lub bardzo podobnej treści ma ją reprezentować w wynikach. Nie usuwa on żadnej strony i nie zabrania robotowi niczego. Dokumentacja Google o wyborze strony kanonicznej opisuje ten proces jako wybór reprezentatywnego adresu dla fragmentu treści i zaznacza, że Google może wybrać inną stronę niż wskazana przez właściciela witryny.
Skąd biorą się duplikaty
Powielone adresy powstają zwykle bez niczyjej złej woli. Google wymienia wśród przyczyn warianty dla regionów i urządzeń, wersje tej samej strony pod protokołem HTTP i HTTPS, funkcje witryny, takie jak sortowanie i filtrowanie strony kategorii, a także przypadkowo dostępne wersje demonstracyjne. To samo źródło uspokaja, że powielone treści bywają rzeczą normalną i same w sobie nie naruszają zasad dotyczących spamu. Utrudniają jednak śledzenie, która wersja jest widoczna w wynikach. Pokrewnym, ale innym problemem są różne podstrony odpowiadające na to samo zapytanie, o czym piszemy we wpisie o kanibalizacji słów kluczowych.
Jak wskazać stronę kanoniczną
Google bierze pod uwagę kilka sygnałów o różnej sile. Strona o określaniu kanonicznego adresu URL porządkuje je następująco: przekierowanie jest wyraźnym sygnałem, że adres docelowy powinien być kanoniczny, znacznik link z atrybutem rel="canonical" również jest sygnałem wyraźnym, a obecność adresu w mapie witryny sygnałem słabym. Metody można łączyć, bo ich działanie się sumuje, pod warunkiem że wszystkie wskazują ten sam adres.
<link rel="canonical" href="https://www.example.com/sukienki/" />Z tej samej dokumentacji wynika kilka zasad wykonania. Znacznik jest uwzględniany tylko wtedy, gdy znajduje się w sekcji head. Adres powinien być podany jako pełna ścieżka bezwzględna, a nie względna. Strona kanoniczna powinna wskazywać samą siebie. Linki wewnętrzne w serwisie należy kierować do adresu kanonicznego, a nie do duplikatu, co wiąże się z tym, jak zaplanowane jest linkowanie wewnętrzne. Nie należy też podawać jednego adresu w mapie witryny, a innego w znaczniku canonical dla tej samej strony. Dla plików bez kodu HTML, na przykład PDF, canonical można przekazać w nagłówku HTTP.
Dlaczego nie należy łączyć tych mechanizmów na jednym adresie
Ponieważ jeden potrafi unieważnić drugi albo przekazać wyszukiwarce sprzeczne informacje. Każdy adres powinien mieć jedno, jasne przeznaczenie: albo robot ma go nie pobierać, albo strona ma nie być w wynikach, albo ma zostać połączona z inną. Próba osiągnięcia dwóch celów naraz kończy się zwykle tym, że nie działa żaden.
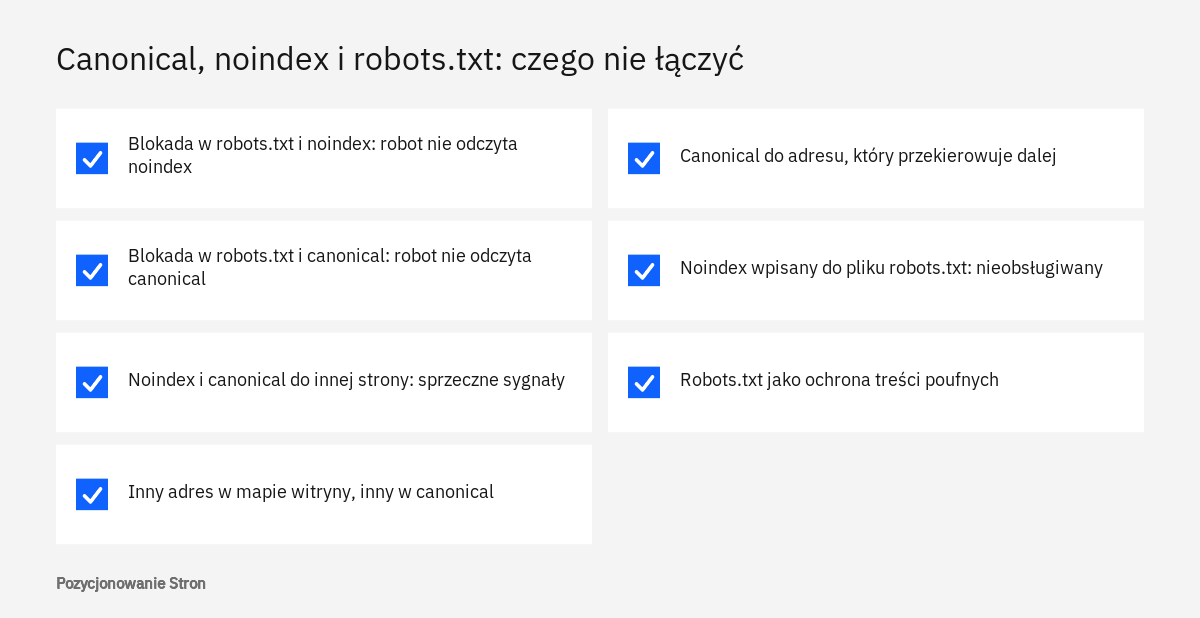
Robots.txt razem z noindex
To połączenie spotykamy najczęściej. Właściciel strony chce mieć pewność, więc dodaje noindex i dodatkowo blokuje adres w robots.txt. Skutek jest odwrotny do zamierzonego: robot nie może pobrać strony, więc nie odczyta noindex, a adres, który już był w wynikach lub do którego prowadzą linki, może w nich pozostać. Pomoc Search Console opisuje taki stan jako ostrzeżenie "Strona zindeksowana, ale zablokowana przez plik robots.txt" i zaleca wówczas usunięcie blokady z robots.txt oraz pozostawienie noindex.
Robots.txt razem z canonical
Mechanizm jest ten sam. Canonical znajduje się w kodzie strony, więc przy blokadzie skanowania robot go nie widzi i nie może połączyć duplikatu z wersją główną. Dokumentacja Google wprost odradza używanie robots.txt do wyboru strony kanonicznej, przypominając, że adresy zablokowane w tym pliku mogą zostać zindeksowane bez swojej zawartości.
Noindex razem z canonical do innej strony
Tu sygnały są sprzeczne co do sensu. Canonical mówi: ta strona jest odpowiednikiem tamtej i ma być z nią traktowana łącznie. Noindex mówi: tej strony ma nie być w wynikach. Google nie zaleca stosowania noindex do rozstrzygania, która wersja w obrębie jednej witryny jest kanoniczna, i wskazuje, że lepszym rozwiązaniem jest znacznik rel="canonical". W naszej praktyce przyjmujemy więc prostą regułę: duplikat dostaje canonical, a strona, która nie ma żadnego odpowiednika wartego pokazania, dostaje noindex.
Wyjątkiem, który nie jest sprzecznością, jest strona z noindex i z canonical wskazującym ją samą, bo wiele systemów dodaje taki znacznik automatycznie do każdej podstrony. Uporządkowanie takich zależności w całym serwisie jest stałym elementem prac, które wykonujemy w ramach usługi SEO techniczne.
Jeśli chcą Państwo zamówić SEO techniczne, zachęcamy do kontaktu: tel. 222 500 844 lub mailowo: biuro@pozycjonowaniestron.pl
Kiedy którego mechanizmu użyć: tabela decyzji
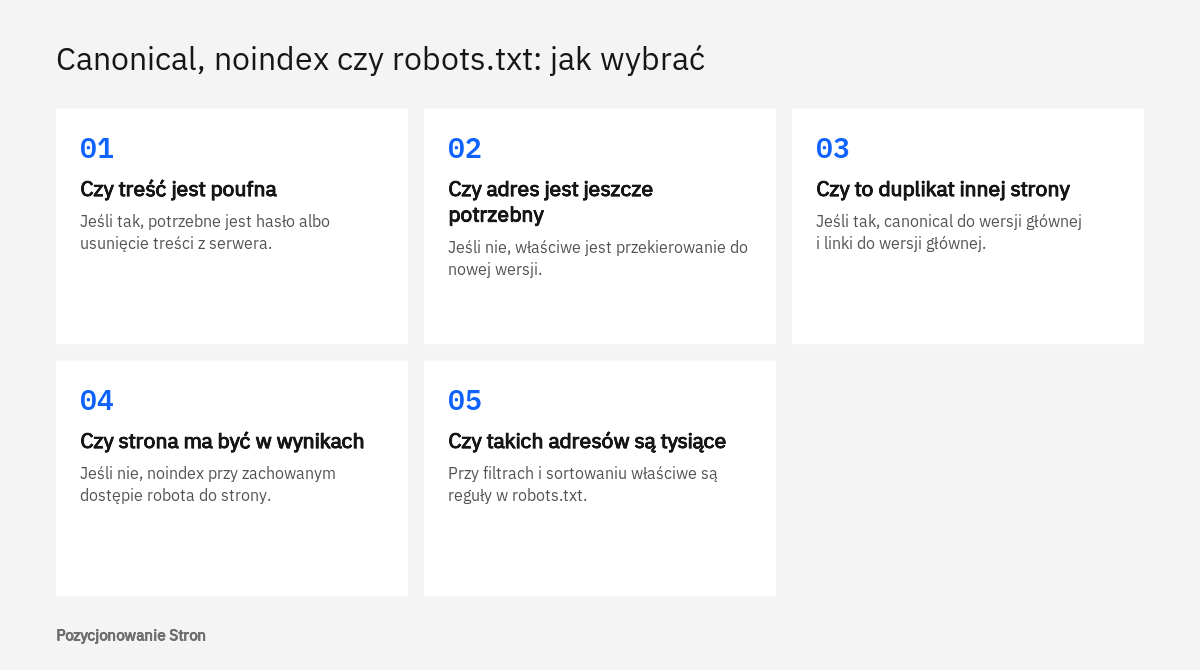
Wybór zależy od odpowiedzi na jedno pytanie: co ma się stać z danym adresem. Jeśli treść ma być widoczna, ale pod innym adresem, właściwy jest canonical lub przekierowanie. Jeśli strona ma działać dla użytkowników, ale nie pojawiać się w wynikach, właściwy jest noindex. Jeśli chodzi o to, by roboty nie traciły czasu na tysiące mało istotnych adresów, właściwy jest robots.txt. Jeśli treści nie powinien zobaczyć nikt niepowołany, żaden z trzech mechanizmów nie wystarczy.
| Sytuacja | Właściwe rozwiązanie | Czego unikać |
|---|---|---|
| Ta sama treść pod kilkoma adresami, wszystkie potrzebne użytkownikom | Canonical do wersji głównej, linki wewnętrzne do wersji głównej | Blokady duplikatów w robots.txt i noindex na duplikatach |
| Stary adres zastąpiony nowym | Przekierowanie po stronie serwera | Pozostawiania obu wersji z samym canonical |
| Strona potrzebna, ale bez wartości w wynikach (podziękowanie po formularzu, logowanie) | Noindex, adres dostępny dla robotów | Blokady tego adresu w robots.txt |
| Strona prywatna lub poufna | Hasło albo usunięcie treści z serwera | Polegania na robots.txt lub samym noindex |
| Filtry i sortowanie w sklepie, które nie mają być w wynikach | Reguły w robots.txt dla parametrów filtrów | Liczenia wyłącznie na canonical przy dużej liczbie kombinacji |
| Wersja testowa serwisu | Hasło na całym środowisku testowym | Samej blokady w robots.txt |
| Dokument PDF, który nie ma być w wynikach | Nagłówek X-Robots-Tag z regułą noindex | Blokady pliku w robots.txt |
| Strona, która musi szybko zniknąć z wyników | Narzędzie do usuwania w Search Console oraz trwała metoda | Uznania tymczasowego usunięcia za rozwiązanie stałe |
Duplikat treści
Przy duplikacie należy najpierw ustalić, czy obie wersje są potrzebne. Sklep z Poznania może mieć ten sam produkt dostępny w dwóch kategoriach, pod dwoma adresami, i obie ścieżki są dla kupujących wygodne. Wówczas jeden adres zostaje uznany za główny, drugi otrzymuje canonical wskazujący na główny, a menu i linki w treści prowadzą do wersji głównej. Jeśli natomiast drugi adres jest pozostałością po dawnej strukturze i nikomu nie służy, lepsze jest przekierowanie. Google wskazuje, że przekierowań warto używać wtedy, gdy duplikat jest wycofywany, a najszybszy efekt dają przekierowania wykonywane po stronie serwera.
Podobnie wygląda sprawa firmy z kilkoma lokalizacjami. Kancelaria z Krakowa, która tworzy osobne podstrony dla kilku miast, nie rozwiąże problemu niemal identycznych tekstów samym znacznikiem canonical, bo wtedy w wynikach pozostanie tylko jedna z tych podstron. Tu potrzebna jest odrębna treść dla każdej lokalizacji, co opisujemy we wpisie o firmie z wieloma oddziałami w Google.
Strona prywatna
Treść, której nie powinien zobaczyć nikt spoza firmy, wymaga hasła albo usunięcia. Strona Google o usuwaniu informacji o witrynie wymienia zabezpieczenie hasłem jako sposób, który wpuszcza uprawnionych użytkowników, a zatrzymuje roboty, i odradza blokowanie stron plikiem robots.txt. Noindex ukrywa stronę tylko w wyszukiwarce: każdy, kto zna adres, nadal ją otworzy. Dlatego cennik dla wybranych kontrahentów, panel klienta czy katalog ze skanami dokumentów nie powinny opierać się na znaczniku noindex. Kwestie ochrony danych osobowych na takich stronach warto dodatkowo omówić z prawnikiem.
Inaczej jest ze stronami, które nie są tajne, a jedynie niepotrzebne w wynikach: podziękowanie po wysłaniu formularza, strona logowania, potwierdzenie zapisu na listę mailową. Dla nich noindex jest rozwiązaniem wystarczającym i właściwym.
Filtr w sklepie
Dla filtrów, które nie mają być w wynikach, Google zaleca blokadę w robots.txt. Strona o zarządzaniu adresami nawigacji fasetowej, czyli filtrowania listy produktów według cech, opisuje dwa skutki pozostawienia filtrów bez kontroli: nadmierne skanowanie, bo każda kombinacja koloru, rozmiaru i ceny wygląda dla robota jak nowy adres, oraz wolniejsze odkrywanie nowych, wartościowych stron. To samo źródło podaje, że canonical wskazujący stronę bez filtrów może z czasem ograniczyć skanowanie wersji niekanonicznych, ale na dłuższą metę jest mniej skuteczny niż blokada w robots.txt.
User-agent: Googlebot
Disallow: /*?*kolor=
Disallow: /*?*rozmiar=
To jedyna z typowych sytuacji, w której robots.txt jest pierwszym wyborem, i warto rozumieć dlaczego: celem nie jest tu ukrycie czegokolwiek, lecz oszczędzenie robotom pracy. Jeśli natomiast wybrane filtry mają być w wynikach, bo klienci rzeczywiście szukają na przykład czerwonych sukienek w konkretnym rozmiarze, tych adresów nie należy blokować. Dokumentacja zaleca wówczas stałą kolejność filtrów w adresie, standardowy znak rozdzielający parametry oraz kod 404 dla kombinacji, które nie zwracają żadnych produktów. Więcej o strukturze kategorii i filtrów piszemy we wpisie o pozycjonowaniu sklepu internetowego.
Wersja testowa
Wersję testową serwisu należy zabezpieczyć hasłem. Google wymienia przypadkowo dostępne wersje demonstracyjne wśród typowych źródeł duplikatów, a sama blokada w robots.txt nie chroni przed pojawieniem się adresu w wynikach, jeśli ktoś do niego zalinkuje. Hasło ma jeszcze jedną zaletę: nie da się go przez pomyłkę przenieść na stronę produkcyjną razem z plikami. Z naszych obserwacji wynika, że odwrotny błąd, czyli skopiowanie z wersji testowej pliku robots.txt z blokadą całej witryny albo ustawienia noindex, zdarza się przy wdrożeniach regularnie. Hydraulik z Łodzi, który odbiera nową stronę od wykonawcy, powinien otrzymać potwierdzenie, że oba te ustawienia zostały sprawdzone po uruchomieniu.
Gdy strona musi zniknąć szybko
Do pilnych przypadków służy narzędzie do usuwania w Search Console. Według dokumentacji pozwala ono usunąć stronę z wyników Google w ciągu jednego dnia, ale działa tymczasowo: prośba pozostaje aktywna przez około 6 miesięcy. W tym czasie trzeba zastosować metodę trwałą, czyli usunąć treść, zabezpieczyć ją hasłem albo dodać noindex. Narzędzie nie nadaje się natomiast do porządkowania duplikatów, ponieważ ukrywa w wyszukiwarce wszystkie wersje adresu.
Gdzie sprawdzić, co Google widzi na danym adresie
Stan każdego adresu pokazuje Search Console, czyli dostępny bez opłat panel Google dla właścicieli witryn. Potrzebne są dwa miejsca: narzędzie do sprawdzania adresów URL, które opisuje pojedynczą stronę, oraz raport "Indeksowanie stron", który grupuje wszystkie znane adresy według przyczyny, dla której nie znalazły się w indeksie.
Pojedynczy adres
Zgodnie z pomocą narzędzia do sprawdzania adresów URL wystarczy wpisać pełny adres w pasku wyszukiwania u góry dowolnego ekranu Search Console. W wyniku należy odszukać pięć pól. "Czy skanowanie jest dozwolone" informuje, czy adresu nie blokuje reguła w robots.txt. "Pobranie strony" mówi, czy robot zdołał pobrać stronę z serwera. "Czy indeksowanie jest dozwolone" pokazuje, czy strona nie zawiera noindex. "Adres kanoniczny określony przez użytkownika" to adres ze znacznika canonical, a "Adres kanoniczny wybrany przez Google" to ten, który wyszukiwarka faktycznie uznała za główny. Porównanie dwóch ostatnich pól od razu pokazuje, czy Google uwzględniło Państwa wskazanie.
Dane te opisują ostatnią wizytę robota, a nie stan bieżący. Po wprowadzeniu zmiany warto uruchomić test wersji opublikowanej, dostępny w tym samym narzędziu, który pobiera stronę na żywo. Gdy wynik jest zgodny z zamiarem, w tym samym miejscu znajduje się przycisk z prośbą o zindeksowanie.
Cały serwis
Raport "Indeksowanie stron" znajduje się w bocznym menu Search Console w grupie dotyczącej indeksowania. Pomoc tego raportu opisuje statusy, z których sześć wiąże się bezpośrednio z omawianymi mechanizmami.
| Status w raporcie | Co oznacza | Co zrobić |
|---|---|---|
| URL zablokowany przez plik robots.txt | Reguła w pliku nie pozwala pobrać adresu; nie gwarantuje to braku w wynikach | Upewnić się, że blokada jest zamierzona i nie obejmuje ważnych podstron |
| URL zawiera tag "noindex" | Google odczytało regułę i pominęło stronę | Jeśli strona ma być w wynikach, usunąć regułę |
| Alternatywna strona zawierająca prawidłowy tag strony kanonicznej | Duplikat poprawnie wskazuje zindeksowaną wersję główną | Nic, to stan pożądany |
| Duplikat, użytkownik nie oznaczył strony kanonicznej | Google samo uznało stronę za duplikat i wybrało inną | Wskazać wersję główną znacznikiem canonical lub przekierowaniem |
| Duplikat, wyszukiwarka Google wybrała inną stronę kanoniczną niż użytkownik | Wskazanie właściciela zostało pominięte | Sprawdzić, czy linki wewnętrzne, mapa witryny i przekierowania wskazują ten sam adres |
| Strona zindeksowana, ale zablokowana przez plik robots.txt | Adres jest w indeksie mimo blokady skanowania | Zdjąć blokadę i dodać noindex albo zdjąć blokadę, jeśli strona ma być widoczna |
Po naprawieniu wszystkich wystąpień danego problemu można w szczegółach statusu uruchomić sprawdzenie poprawki. Według pomocy Search Console taka weryfikacja trwa zwykle do 2 tygodni, a o jej przebiegu informują wiadomości e-mail. Pozostałe statusy tego raportu omawiamy we wpisie o tym, dlaczego Google nie indeksuje strony.
Typowe pomyłki i kolejność ich naprawy
Najczęstszą pomyłką jest użycie robots.txt do usunięcia strony z wyników. Druga w kolejności to dodanie noindex do adresu, który już jest zablokowany, i oczekiwanie, że strona zniknie. Trzecia to canonical wskazujący stronę o wyraźnie innej treści, na przykład ze wszystkich podstron oferty na stronę główną. Ponieważ canonical jest sygnałem dotyczącym stron o takiej samej lub bardzo podobnej treści, nie należy się po nim spodziewać połączenia stron, które duplikatami nie są.
Osobną grupę stanowią błędy wykonania. Canonical z adresem względnym albo umieszczony poza sekcją head, canonical kierujący do adresu, który sam przekierowuje dalej, inny adres w mapie witryny niż w znaczniku, blokada w robots.txt plików stylów i skryptów potrzebnych do wyświetlenia strony. Każdy z nich z osobna wygląda niegroźnie, ale razem sprawiają, że wyszukiwarka dostaje niespójny obraz serwisu.
Od czego zacząć naprawę
Kolejność ma znaczenie, ponieważ zmiany w robots.txt decydują o tym, czy robot w ogóle zobaczy pozostałe poprawki. Jeśli strona ma zniknąć z wyników, a jest zablokowana, najpierw zdejmuje się blokadę, potem dodaje noindex, czeka na ponowne pobranie strony i dopiero wówczas, jeśli nadal jest taka potrzeba, przywraca regułę w robots.txt. Odwrócenie tej kolejności utrwala problem.
- Plik robots.txt otwiera się pod adresem domeny i nie zawiera blokady całej witryny.
- Żaden adres z regułą noindex nie jest jednocześnie zablokowany w robots.txt.
- Żaden adres z canonical do innej strony nie jest zablokowany w robots.txt.
- Duplikaty mają canonical, a nie noindex.
- Każdy canonical zawiera pełny adres bezwzględny i znajduje się w sekcji head.
- Strony główne wskazują w znaczniku canonical same siebie.
- Mapa witryny zawiera wyłącznie adresy kanoniczne, bez stron z noindex.
- Linki wewnętrzne prowadzą do adresów kanonicznych.
- Treści poufne i wersja testowa są chronione hasłem.
- Pola dotyczące skanowania, indeksowania i adresu kanonicznego w Search Console zgadzają się z zamiarem dla najważniejszych podstron.
Kiedy potrzebna jest pomoc specjalisty
Pojedynczy znacznik na małej stronie firmowej da się zwykle poprawić w ustawieniach systemu zarządzania treścią. Wsparcie jest potrzebne wtedy, gdy problem dotyczy setek lub tysięcy adresów naraz: sklepu z rozbudowanymi filtrami, serwisu po zmianie struktury adresów, witryny w kilku językach albo sytuacji, w której Google konsekwentnie wybiera inną stronę kanoniczną niż wskazana. W takich przypadkach pojedyncze poprawki nie wystarczą i trzeba przejrzeć cały serwis, co jest zakresem, który obejmuje audyt SEO. Pomoc przydaje się również przed większym wdrożeniem, bo błąd w jednej regule robots.txt może wyłączyć ze skanowania całą witrynę, a jego skutki bywają widoczne dopiero jako spadek ruchu z Google.
Jeśli chcą Państwo zamówić SEO techniczne, zachęcamy do kontaktu: tel. 222 500 844 lub mailowo: biuro@pozycjonowaniestron.pl
Najczęstsze pytania
Czy blokada w robots.txt usunie stronę z Google?
Nie. Robots.txt zatrzymuje pobieranie strony, ale jej adres nadal może pojawiać się w wynikach, jeśli prowadzą do niego linki, tyle że bez opisu. Do wykluczenia strony z wyników służy noindex, a do ochrony treści poufnych hasło.
Czy można wpisać noindex do pliku robots.txt?
Dokumentacja Google podaje, że określanie noindex w pliku robots.txt nie jest obsługiwane. Regułę należy umieścić w znaczniku meta w kodzie strony albo w nagłówku HTTP X-Robots-Tag.
Jak długo trwa zniknięcie strony z wyników po dodaniu noindex?
Strona znika dopiero po ponownym pobraniu przez robota. Według Google może to potrwać nawet kilka miesięcy, zależnie od znaczenia strony. Proces można przyspieszyć prośbą o zindeksowanie w narzędziu do sprawdzania adresów URL, a w pilnych przypadkach narzędziem do usuwania.
Dlaczego Google wybrało inną stronę kanoniczną niż wskazana?
Canonical jest jednym z kilku sygnałów, obok przekierowań, protokołu HTTPS i mapy witryny, a Google może wybrać inny adres. Zwykle warto sprawdzić, czy pozostałe sygnały, w tym linki wewnętrzne, nie wskazują innej wersji niż znacznik.
Czy każda podstrona powinna mieć znacznik canonical?
Google podaje, że określanie adresu kanonicznego zazwyczaj nie jest niezbędne, bo wyszukiwarka sama ustala najlepszą wersję. Zaleca jednak, by strona kanoniczna wskazywała samą siebie, co zmniejsza ryzyko pomyłki przy adresach z parametrami. Wiele systemów dodaje taki znacznik automatycznie.
Czym zabezpieczyć wersję testową strony przed Google?
Hasłem. Zabezpieczenie hasłem zatrzymuje roboty i osoby postronne, a nie da się go przypadkiem przenieść na stronę produkcyjną. Sama blokada w robots.txt nie wyklucza pojawienia się adresu w wynikach.
Czy noindex wystarczy do ukrycia dokumentów z danymi klientów?
Nie. Noindex dotyczy wyłącznie wyszukiwarek, które go obsługują, a plik pozostaje dostępny dla każdego, kto zna adres. Takie dokumenty powinny być chronione hasłem albo usunięte z publicznego serwera, a kwestie prawne warto omówić z prawnikiem.
Źródła
- Plik robots.txt - wprowadzenie i przewodnik, Centrum wyszukiwarki Google
- Tworzenie i przesyłanie pliku robots.txt, Google for Developers
- Blokowanie indeksowania przez wyszukiwarki za pomocą tagu noindex, Centrum wyszukiwarki Google
- Specyfikacje metatagów robots, Centrum wyszukiwarki Google
- Co to jest wybór strony kanonicznej, Centrum wyszukiwarki Google
- Jak określić kanoniczny URL za pomocą rel="canonical" i innych metod, Centrum wyszukiwarki Google
- Zarządzanie indeksowaniem adresów URL nawigacji fasetowej, Google for Developers
- Usuwanie informacji o witrynie z Google, Centrum wyszukiwarki Google
- Raport Indeksowanie stron, Pomoc Search Console
- Narzędzie do sprawdzania adresów URL, Pomoc Search Console
Funkcje wyszukiwarek i asystentów AI zmieniają się szybko, dlatego wpis aktualizujemy po większych zmianach.