Sieć dostarczania treści, czyli CDN, przyspiesza stronę wtedy, gdy problemem jest odległość między serwerem a odbiorcą, ciężar plików albo przeciążony serwer. Nie naprawi natomiast wolnego kodu ani skryptów, które blokują wyświetlanie. Poniżej wyjaśniamy, jak rozpoznać, z którą sytuacją mają Państwo do czynienia, i na co uważać, żeby wdrożenie nie zaszkodziło widoczności w Google.
Jak działa sieć dostarczania treści
Sieć dostarczania treści to grupa serwerów rozmieszczonych w wielu lokalizacjach, która staje między odwiedzającym a serwerem strony i wysyła pliki z miejsca położonego najbliżej odbiorcy. Skrót CDN pochodzi od angielskiej nazwy Content Delivery Network. Zamiast łączyć się za każdym razem z jednym serwerem, na przykład w Warszawie, przeglądarka klienta z Lizbony albo z Toronto dostaje pliki z punktu w swoim regionie.
Zespół Google w serwisie web.dev opisuje trzy źródła korzyści: serwery znajdują się bliżej użytkowników, połączenia sieciowe są lepiej zoptymalizowane, a pamięć podręczna oszczędza drogi do serwera głównego. Szczegóły zawiera opracowanie Content delivery networks (CDNs). Warto przy tym poznać trzy pojęcia, które pojawiają się w każdym panelu takiej usługi.
Serwer, na którym faktycznie działa strona i z którego sieć pobiera treść. W panelach bywa oznaczany angielskim słowem origin.
Punkt sieci położony blisko odbiorców, który przechowuje kopie plików i odpowiada na żądania przeglądarek w zastępstwie serwera źródłowego.
Liczba żądań obsłużonych z kopii podzielona przez liczbę wszystkich żądań w danym okresie. Według web.dev rozsądnym celem dla większości witryn jest poziom 90 procent.
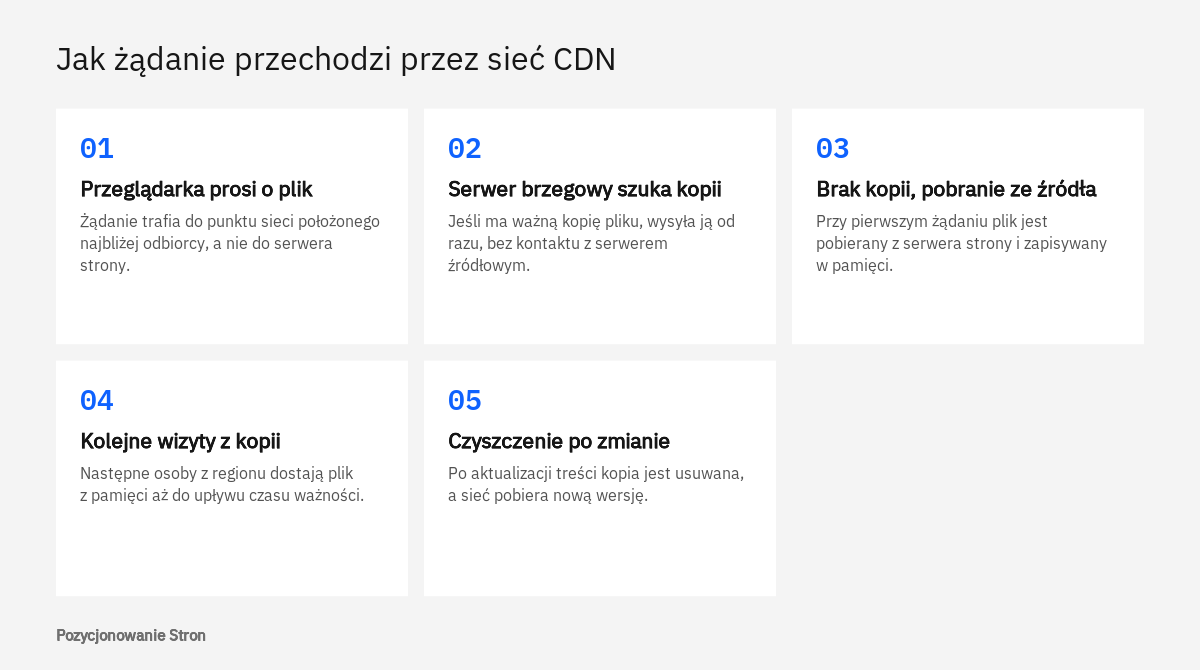
Pierwsze żądanie o dany plik trafia do serwera brzegowego, który nie ma jeszcze kopii, więc pobiera ją z serwera źródłowego i zapamiętuje. Kolejne osoby z tego regionu dostają plik od razu z kopii. Dlatego tuż po uruchomieniu usługi współczynnik trafień zaczyna od zera i rośnie w miarę napływu ruchu, a pomiar wykonany pięć minut po wdrożeniu niczego jeszcze nie dowodzi.
Które pliki trafiają do kopii
O tym, czy plik zostanie zapamiętany, decydują nagłówki odpowiedzi serwera. Z opisu web.dev wynika, że zasób musi mieć przynajmniej jeden z nagłówków określających czas ważności, czyli Cache-Control z wartością max-age lub s-maxage albo nagłówek Expires. Odpowiedź z dyrektywą no-store nie zostanie zapisana, a zasoby oznaczone jako prywatne nie powinny trafiać do wspólnej pamięci sieci. Jak dobierać te wartości, opisujemy we wpisie o nagłówkach Cache-Control.
W praktyce pliki dzielą się na trzy grupy. Treści statyczne, takie jak obrazy, filmy, arkusze stylów i skrypty z numerem wersji w nazwie, mogą mieć długi czas ważności, liczony w miesiącach. Treści dynamiczne, czyli kod HTML budowany przez system zarządzania treścią, również da się przechowywać, ale krótko. Treści osobiste, jak koszyk czy panel klienta, muszą zawsze pochodzić z serwera źródłowego.
Kiedy CDN realnie przyspiesza stronę
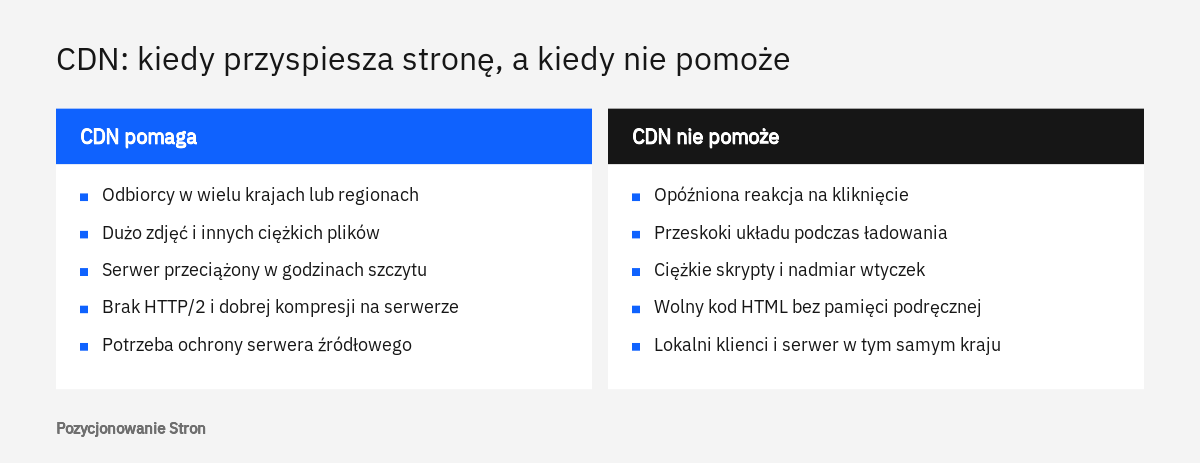
Sieć dostarczania treści daje wyraźny efekt w trzech sytuacjach: gdy odbiorcy są daleko od serwera, gdy strona przesyła dużo ciężkich plików i gdy serwer źródłowy nie radzi sobie z liczbą odwiedzin. Im więcej z tych warunków jest spełnionych jednocześnie, tym większa różnica w pomiarach.
Ruch z wielu regionów
Każde połączenie z serwerem wymaga kilku wymian danych, zanim popłynie pierwsza część strony, a każda taka wymiana trwa tym dłużej, im większa odległość. Producent mebli z Poznania, który sprzedaje do Niemiec, Hiszpanii i Stanów Zjednoczonych, ma klientów w bardzo różnych odległościach od swojego serwera. Dla nich punkt sieci w ich regionie skraca czas do pierwszego bajta, czyli TTFB. Autorzy web.dev w opracowaniu Optimize Time to First Byte zalecają wdrożenie CDN jako sprawę o wysokim priorytecie, jeśli witryna jeszcze z niego nie korzysta, a jako orientacyjny cel podają czas nie dłuższy niż 0,8 sekundy. Więcej o samym wskaźniku piszemy we wpisie o czasie odpowiedzi serwera, a o przygotowaniu serwisu na inne rynki przy okazji pozycjonowania zagranicznego.
Ciężkie obrazy i inne duże pliki
Obrazy to zwykle najcięższa część strony. W opracowaniu web.dev podano, że na przeciętnej stronie odpowiadają one za około połowę przesyłanych bajtów. Sklep z odzieżą, biuro nieruchomości z Krakowa czy fotograf ślubny pokazują dziesiątki zdjęć na jednej podstronie, więc przeniesienie ich bliżej odbiorcy skraca czas pobierania. Wiele sieci oferuje też przetwarzanie obrazów: usuwanie zbędnych danych zapisanych w pliku, kompresję i zamianę na nowocześniejszy format, na przykład WebP. Nie zwalnia to z podstaw, które opisujemy we wpisie o obrazach na stronie.
Szybsze obrazy wpływają na LCP, czyli czas wyświetlenia największego elementu widocznego na ekranie, którym często jest właśnie zdjęcie. Google przyjmuje, że dobry wynik to najwyżej 2,5 sekundy dla co najmniej 75 procent odwiedzin.
Obciążony serwer
Kiedy większość plików wysyłają serwery brzegowe, serwer źródłowy obsługuje tylko ułamek żądań i ma więcej zasobów na budowanie stron. Widać to szczególnie w chwilach szczytu. Sklep z Łodzi, który po emisji reklamy przyjmuje w kwadrans tyle wizyt, ile zwykle przez cały dzień, bez pośrednika może przestać odpowiadać. Autorzy web.dev zauważają, że przy dużym natężeniu sens ma nawet bardzo krótkie przechowywanie treści dynamicznych, rzędu kilku sekund, bo tylko pierwsza osoba po wygaśnięciu kopii czeka na odpowiedź serwera źródłowego.
Kiedy CDN nie pomoże
Sieć dostarczania treści nie pomoże, jeśli strona jest wolna z powodów, które leżą po stronie przeglądarki albo samego kodu, a nie po stronie przesyłania plików. Pośrednik skraca drogę danych, ale nie zmienia tego, co przeglądarka musi z nimi zrobić po odebraniu.
Pierwszy przypadek to lokalna firma z serwerem w kraju. Hydraulik z Łodzi albo kancelaria z Krakowa mają klientów w promieniu kilkudziesięciu kilometrów, a serwer w polskim centrum danych. Odległość jest niewielka, więc zysk z punktu sieci w tym samym kraju bywa trudny do zauważenia. Jeżeli taka strona otwiera się powoli, przyczyny trzeba szukać w ciężkim motywie, nadmiarze wtyczek albo słabym serwerze, o czym piszemy we wpisie o hostingu a SEO.
Drugi przypadek to wolno budowany kod HTML. Jeśli system potrzebuje dwóch sekund na przygotowanie podstrony, a dokument nie jest przechowywany w pamięci sieci, każdy odwiedzający nadal czeka te dwie sekundy. Autorzy web.dev zwracają też uwagę na zjawisko odwrotne: pamięć podręczna potrafi ukryć powolne zaplecze, dlatego warto mieć sposób na pominięcie kopii podczas testów, na przykład specjalny parametr w adresie.
Trzeci przypadek to skrypty. Opóźniona reakcja na kliknięcie, mierzona wskaźnikiem INP, oraz przeskoki układu, mierzone wskaźnikiem CLS, wynikają z pracy przeglądarki nad kodem JavaScript i ze sposobu osadzenia elementów. Żaden pośrednik w przesyłaniu plików tego nie zmieni.
Czwarty przypadek to źle ustawiona pamięć. Sieć, która niczego nie przechowuje, jest tylko dodatkowym przystankiem na drodze. Autorzy web.dev wymieniają typowe powody niskiego współczynnika trafień: zbędne parametry w adresach, różna kolejność tych samych parametrów, niewłaściwe użycie nagłówka Vary oraz nagłówki Set-Cookie dołączane do odpowiedzi.
| Objaw | Czy CDN pomoże | Co zrobić w pierwszej kolejności |
|---|---|---|
| Strona wolna dla odbiorców z zagranicy, szybka w Polsce | Tak, to typowe zastosowanie | Wdrożyć sieć dla całej domeny i porównać czas do pierwszego bajta |
| Długie pobieranie zdjęć na kartach produktów | Tak, zwłaszcza z przetwarzaniem obrazów | Uporządkować rozmiary i formaty, potem przenieść pliki do sieci |
| Serwer przestaje odpowiadać w godzinach szczytu | Tak, odciąża serwer źródłowy | Ustawić przechowywanie plików statycznych, rozważyć krótką pamięć dla HTML |
| Wolne budowanie podstrony przez system | Tylko przy przechowywaniu kodu HTML | Pamięć podręczna po stronie serwera, przegląd wtyczek |
| Opóźniona reakcja na kliknięcie | Nie | Ograniczyć i odroczyć skrypty |
| Przeskoki układu podczas ładowania | Nie | Podać wymiary obrazów i zarezerwować miejsce na elementy |
Cała domena czy osobna subdomena z plikami
Sieć można wdrożyć na dwa sposoby: skierować przez nią całą domenę albo wydzielić osobną subdomenę tylko na pliki statyczne. Autorzy web.dev wskazują pierwszy wariant jako docelowy, a drugi jako rozwiązanie na wypadek, gdyby pierwszego nie dało się zastosować.
W wariancie pełnym zmienia się rekordy DNS domeny tak, żeby wskazywały na sieć. Od tej chwili każde żądanie, także o kod HTML, przechodzi przez serwer brzegowy. Adresy podstron i obrazów pozostają bez zmian, więc z punktu widzenia wyszukiwarki nic się nie przenosi. To rozwiązanie daje najwięcej: szybsze nawiązanie połączenia dla dokumentu, ochronę serwera źródłowego i możliwość przechowywania HTML.
W wariancie z subdomeną tworzy się adres w rodzaju static.example.com i przepisuje odnośniki do obrazów, stylów i skryptów. Dokument HTML nadal pochodzi bezpośrednio z serwera strony. Rozwiązanie jest prostsze do cofnięcia, ale ma swoją cenę. W opracowaniu Optimize Largest Contentful Paint podkreślono, że pobieranie obrazów z innej domeny wymaga nawiązania dodatkowego połączenia, a najlepszym wyjściem jest serwowanie ich z tego samego źródła co dokument. Koszt można zmniejszyć wskazówką preconnect, która każe przeglądarce połączyć się z drugą domeną zawczasu.
<link rel="preconnect" href="https://static.example.com">Najmniej korzystny jest adres w domenie dostawcy. Zmiana usługodawcy oznacza wtedy zmianę wszystkich adresów plików, podczas gdy własną subdomenę da się w razie potrzeby skierować gdzie indziej.
Jeśli chcą Państwo zamówić SEO techniczne, zachęcamy do kontaktu: tel. 222 500 844 lub mailowo: biuro@pozycjonowaniestron.pl
Obrazy na innej domenie a widoczność w Grafice Google
Przeniesienie obrazów na inną domenę lub subdomenę samo w sobie nie jest błędem i Google wprost dopuszcza takie rozwiązanie. Kłopoty zaczynają się wtedy, gdy adresy plików zmieniają się bez przekierowań, występują w kilku wersjach albo znikają razem ze zmianą dostawcy.
W dokumentacji Sprawdzone metody dotyczące SEO obrazów znajdują się trzy wskazówki ważne dla każdego, kto korzysta z sieci. Po pierwsze, mapa witryny z obrazami może zawierać adresy z innych domen, co właśnie umożliwia hostowanie grafik w CDN. Po drugie, Google zachęca do zweryfikowania własności domeny sieci w Search Console, ponieważ dzięki temu może informować o wykrytych błędach indeksowania. Po trzecie, do tego samego obrazu należy odwoływać się zawsze pod tym samym adresem, żeby Google mógł zapisać plik w pamięci i używać go ponownie bez kolejnych żądań.
Co się dzieje przy zmianie adresów plików
Obraz widoczny w Grafice Google jest powiązany z konkretnym adresem pliku. Jeśli sklep z Poznania przenosi kilka tysięcy zdjęć z katalogu na własnej domenie na subdomenę sieci, dla wyszukiwarki są to nowe pliki, które trzeba odkryć i pobrać od początku. Z naszej praktyki wynika, że ruch z wyszukiwarki grafiki może w takim okresie spaść, jeżeli stare adresy po prostu przestaną działać. Dlatego dotychczasowe adresy obrazów warto przekierować na nowe kodem 301 i utrzymać te przekierowania długo, tak samo jak przy przenoszeniu podstron. Dla sklepów, w których zdjęcia produktów przyciągają klientów, to jeden z ważniejszych punktów prac nad pozycjonowaniem sklepu.
Kopia całej strony pod adresem sieci
Zdarza się, że subdomena przeznaczona na pliki zwraca także kod HTML, czyli pod adresem sieci otwiera się pełna kopia serwisu. Powstaje wtedy duplikacja treści na dwóch nazwach hosta. Zabezpieczeniem jest takie ustawienie sieci, żeby subdomena obsługiwała wyłącznie pliki statyczne, a na wszelki wypadek także adres kanoniczny w kodzie każdej podstrony. Google w dokumentacji o określaniu strony kanonicznej zaleca podawanie go w postaci bezwzględnej.
Certyfikat i szyfrowanie po włączeniu sieci
Po włączeniu sieci połączenie szyfrowane składa się z dwóch odcinków: od przeglądarki do serwera brzegowego oraz od serwera brzegowego do serwera źródłowego. Oba muszą być zabezpieczone ważnym certyfikatem, w przeciwnym razie odwiedzający zobaczą ostrzeżenie albo strona wpadnie w pętlę przekierowań.
Na pierwszym odcinku certyfikat wystawia zwykle sama sieć i musi on obejmować wszystkie używane nazwy: domenę główną, wersję z www oraz subdomenę z plikami. Brak którejkolwiek z nich to najczęstsza przyczyna awarii w dniu wdrożenia, jaką spotykamy. Na drugim odcinku serwer źródłowy powinien nadal mieć własny, ważny certyfikat. Ustawienie, w którym sieć rozmawia z serwerem bez szyfrowania, a serwer jednocześnie wymusza przejście na HTTPS, kończy się nieskończonym ciągiem przekierowań i podstrona nie nadaje się do zindeksowania.
Po wdrożeniu należy przejść ręcznie przez cztery warianty adresu: z http lub https oraz z www lub bez. Każdy powinien jednym przekierowaniem prowadzić do tej samej, docelowej wersji. Autorzy web.dev przypominają, że każde zbędne przekierowanie wydłuża czas do pierwszego bajta. Zasady wdrażania szyfrowania opisujemy szerzej we wpisie o przejściu z HTTP na HTTPS.
Zabezpieczenia sieci, które blokują roboty wyszukiwarek
Największym zagrożeniem dla widoczności po wdrożeniu sieci jest zapora, która uzna Googlebota za niepożądany ruch i zacznie mu odmawiać dostępu. Usługi tego rodzaju mają wbudowane filtry, ograniczenia liczby żądań oraz strony sprawdzające, czy po drugiej stronie jest człowiek. Robot wyszukiwarki takiej weryfikacji nie przejdzie.
Skutki zależą od kodu odpowiedzi, jaki dostaje robot. Z dokumentacji Jak kody stanu HTTP wpływają na roboty Google wynika kilka zasad. Adresy zwracające kody z grupy 4xx nie są indeksowane, a te już zindeksowane są usuwane z indeksu. Dotyczy to także kodu 403, który zapory wysyłają najczęściej. Kod 429 oraz kody z grupy 5xx robot traktuje jako sygnał przeciążenia i na pewien czas zwalnia, przy czym adresy początkowo zostają w indeksie, lecz po dłuższym okresie błędów również są usuwane. Z kolei strona weryfikacyjna wysłana z kodem 200 jest dla Google zwykłą treścią: jeżeli wygląda jak komunikat o błędzie, Search Console pokaże pozorny błąd 404.
W dokumentacji o zmniejszaniu szybkości indeksowania Google zaznacza, że zwracanie kodów 500, 503 lub 429 to rozwiązanie awaryjne na kilka godzin albo jeden do dwóch dni. Jeśli robot przez kilka dni widzi je pod tymi samymi adresami, może usunąć te adresy z indeksu. Zapora, która przez dwa tygodnie po cichu odrzuca ruch Googlebota, robi więc dokładnie to, przed czym ta dokumentacja ostrzega.
Blokada krajów
Częsty błąd to blokowanie ruchu spoza Polski. Właściciel lokalnej firmy widzi w statystykach próby włamań z odległych krajów i wyłącza dostęp dla całego świata. Tymczasem, jak czytamy w omówieniu robotów Google, żądania wysyłane są głównie z adresów IP w Stanach Zjednoczonych. Google dodaje, że w razie blokady może spróbować dotrzeć do witryny z adresów w innych krajach, lecz nie warto na tym polegać.
Jak odróżnić prawdziwego Googlebota
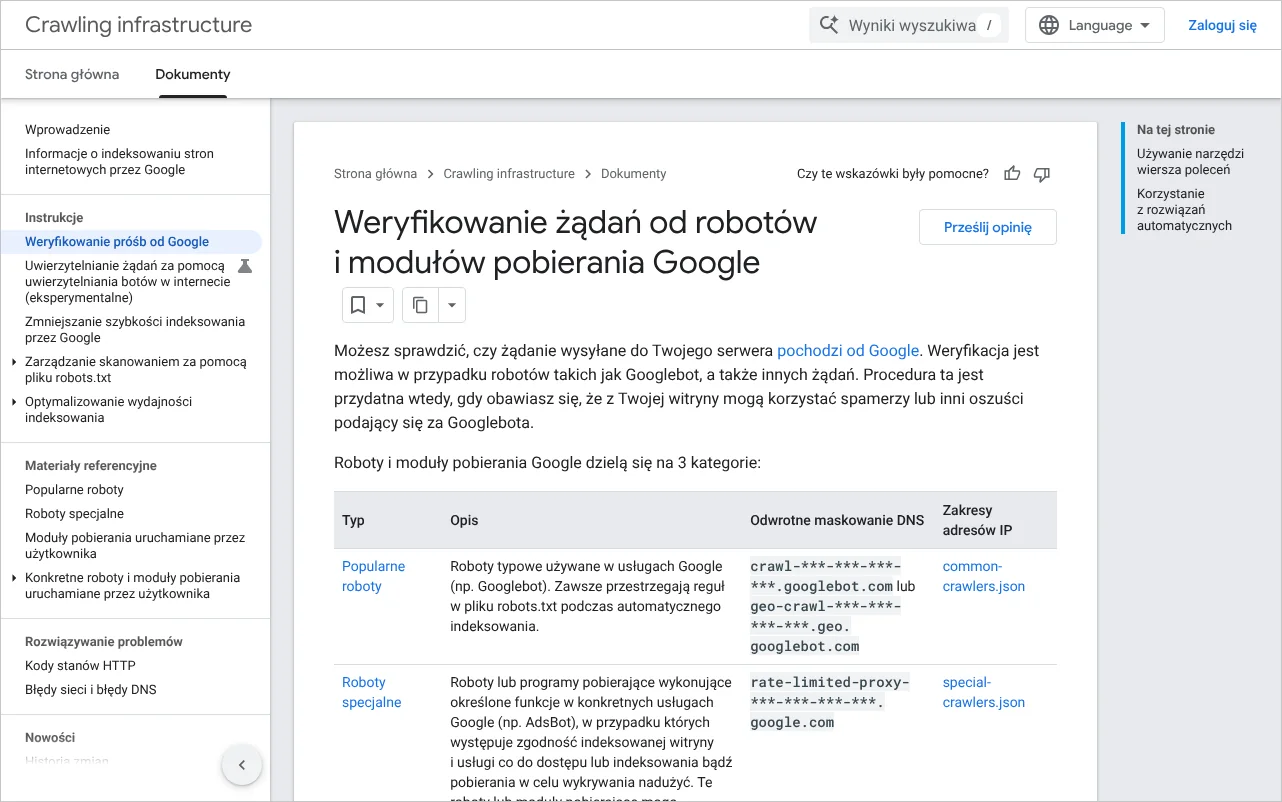
Nie należy przepuszczać każdego, kto przedstawia się jako Googlebot, bo tę nazwę łatwo podrobić. Google opisuje dwa sposoby weryfikacji. Ręczny polega na odwrotnym wyszukiwaniu DNS adresu IP z logów: nazwa powinna należeć do domeny googlebot.com, google.com lub googleusercontent.com, a zwykłe wyszukiwanie DNS tej nazwy musi zwrócić ten sam adres. Automatyczny polega na porównaniu adresu z zakresami publikowanymi przez Google w plikach JSON.
Większość sieci ma gotową listę zweryfikowanych robotów wyszukiwarek, którą wystarczy włączyć jako wyjątek w regułach zapory. Osobną decyzją jest dostęp dla robotów asystentów AI, które wiele zabezpieczeń domyślnie odrzuca, o czym piszemy we wpisie o robotach AI.
Pamięć podręczna HTML: duży zysk i największe ryzyko
Przechowywanie w sieci gotowego kodu HTML daje największe skrócenie czasu do pierwszego bajta, ponieważ serwer brzegowy oddaje całą podstronę bez pytania serwera źródłowego. To zarazem ustawienie, przy którym najłatwiej o poważny błąd, bo kopia może zawierać treść nieaktualną albo przeznaczoną dla innej osoby.
Pierwsze ryzyko to dane osobiste. Jeśli sieć zapamięta podstronę wygenerowaną dla zalogowanego klienta, kolejny odwiedzający może zobaczyć cudzy koszyk lub cudze dane. Dlatego podstrony koszyka, zamówienia, konta i panelu administracyjnego muszą być wyłączone z przechowywania, a odpowiedzi dla osób z ciasteczkiem logowania pomijane. W sklepach na WooCommerce, PrestaShop czy Shopify reguły te wymagają szczególnej staranności.
Drugie ryzyko to nieaktualna treść pokazywana wyszukiwarce. Googlebot dostaje to samo, co każdy inny odwiedzający, czyli kopię. Jeżeli w serwisie zmieniono tytuł podstrony, usunięto znacznik noindex albo poprawiono adres kanoniczny, a sieć jeszcze przez dobę oddaje starą wersję, robot zobaczy stan sprzed zmiany. Rozwiązaniem jest automatyczne czyszczenie kopii po każdej zmianie treści. Autorzy web.dev opisują taki model: długi czas ważności połączony z usuwaniem kopii w chwili, gdy treść się zmienia.
cache-control: public, max-age=0, s-maxage=600
etag: "a1b2c3"
Nagłówek ETag pozwala potwierdzić, że treść się nie zmieniła, bez przesyłania jej od nowa. Google informuje, że jego roboty obsługują taki mechanizm. O warstwach pamięci po stronie serwera, przeglądarki i sieci piszemy osobno we wpisie o rodzajach pamięci podręcznej.
Jak sprawdzić, czy CDN działa i nie szkodzi widoczności
Efekt wdrożenia ocenia się w trzech miejscach: w nagłówkach odpowiedzi, w pomiarach szybkości oraz w Search Console. Każde z nich odpowiada na inne pytanie, dlatego nie warto poprzestawać na jednym.
Nagłówki odpowiedzi w przeglądarce
W przeglądarce Chrome należy otworzyć narzędzia dla programistów klawiszem F12, przejść do karty Sieć, odświeżyć stronę i kliknąć wybrany plik. W części z nagłówkami odpowiedzi widać wartość Cache-Control oraz nagłówek stanu kopii dodawany przez sieć. Jego nazwa zależy od dostawcy, ale wartości oznaczają zwykle trafienie lub pudło. Trafienie przy drugim odświeżeniu oznacza, że plik pochodzi z serwera brzegowego. Stałe pudło dla obrazów i stylów to sygnał, że pamięć jest źle ustawiona.
Pomiary szybkości przed zmianą i po niej
Przed wdrożeniem warto zapisać wyniki kilku ważnych podstron w PageSpeed Insights: czas do pierwszego bajta oraz LCP. Po wdrożeniu test laboratoryjny pokaże różnicę od razu, natomiast dane od rzeczywistych użytkowników zbierane są z dłuższego okresu, więc pełny obraz pojawia się po kilku tygodniach. Autorzy web.dev przypominają, że to dane od użytkowników są podstawowym źródłem wiedzy o TTFB, a wydajność sieci różni się w zależności od regionu i pory dnia. Jak czytać oba rodzaje danych, wyjaśniamy we wpisie o raporcie PageSpeed Insights.
Search Console po wdrożeniu
W Search Console trzeba zajrzeć w dwa miejsca. Pierwsze to raport dostępny po kliknięciu pozycji Ustawienia i wybraniu Statystyk indeksowania. Zgodnie z opisem w pomocy Search Console pokazuje on łączną liczbę żądań robota, całkowity rozmiar pobierania i średni czas odpowiedzi, a w części Stan hosta trzy kategorie: pobieranie pliku robots.txt, rozpoznawanie nazw DNS i połączenie z serwerem. Po wdrożeniu sieci średni czas odpowiedzi powinien spaść albo pozostać bez zmian, a w zestawieniu odpowiedzi nie powinien rosnąć udział kodów 403, 429 i 5xx. Raport dla usługi domeny obejmuje również subdomeny, więc własna subdomena z plikami będzie w nim widoczna, a obrazy trzymane w zupełnie innej domenie już nie.
Drugie miejsce to narzędzie do sprawdzania adresów URL. Po wpisaniu adresu podstrony w górnym polu wyszukiwania należy uruchomić test wersji opublikowanej, a następnie otworzyć podgląd przetestowanej strony. Widać tam zrzut ekranu, zwrócony kod HTML, nagłówki odpowiedzi HTTP oraz listę wczytanych zasobów. Jeżeli na zrzucie zamiast strony pojawia się ekran weryfikacji albo strona bez stylów i zdjęć, zapora blokuje robota lub pliki z subdomeny. Statusy, które mogą się wtedy pojawić w raportach, omawiamy we wpisie o tym, dlaczego Google nie indeksuje strony.
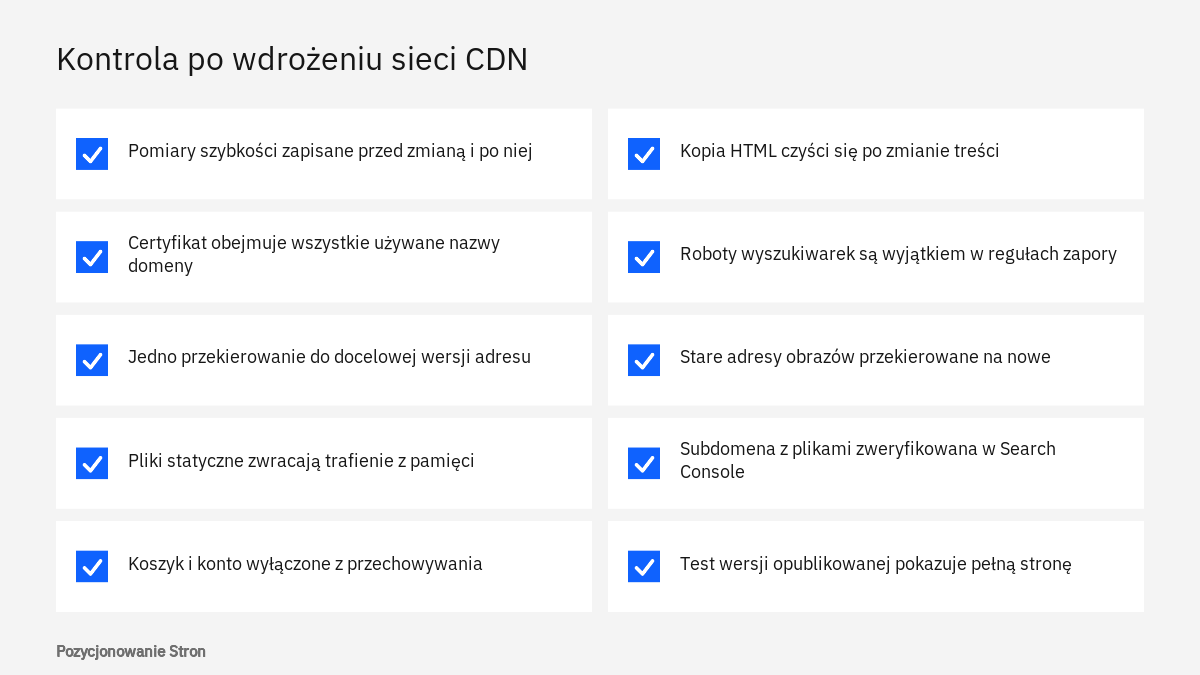
- Wyniki szybkości kilku podstron zapisane przed wdrożeniem i porównane po nim.
- Certyfikat obejmuje domenę główną, wersję z www i subdomenę z plikami.
- Wszystkie warianty adresu prowadzą jednym przekierowaniem do wersji docelowej.
- Pliki statyczne zwracają trafienie przy drugim żądaniu.
- Koszyk, konto i panel administracyjny są wyłączone z przechowywania.
- Kopia HTML czyści się automatycznie po zmianie treści.
- Zweryfikowane roboty wyszukiwarek są wyjątkiem w regułach zapory.
- Stare adresy obrazów przekierowują na nowe.
- Test wersji opublikowanej pokazuje poprawny zrzut ekranu.
Samodzielne wdrożenie jest w zasięgu właściciela prostej strony firmowej, zwłaszcza gdy sieć obsługuje tylko pliki statyczne. Pomoc specjalisty przydaje się przy sklepach, serwisach z logowaniem i wszędzie tam, gdzie planowane jest przechowywanie kodu HTML. Ocenę, czy sieć w ogóle jest potrzebna, najlepiej oprzeć na pomiarach, które wykonujemy w ramach audytu SEO, a wdrożenie i kontrolę po nim prowadzimy jako część SEO technicznego.
Jeśli chcą Państwo zamówić SEO techniczne, zachęcamy do kontaktu: tel. 222 500 844 lub mailowo: biuro@pozycjonowaniestron.pl
Najczęstsze pytania
Czy CDN jest czynnikiem rankingowym w Google?
Samo korzystanie z sieci nie jest oceniane. Znaczenie ma to, jak strona działa u odbiorców, czyli między innymi wskaźnik LCP, na który sieć może wpływać przez krótszy czas odpowiedzi i szybsze pobieranie obrazów. Czas do pierwszego bajta nie należy do podstawowych wskaźników internetowych, ale poprzedza pozostałe pomiary.
Czy mała lokalna firma potrzebuje sieci dostarczania treści?
Często nie. Jeśli klienci i serwer znajdują się w tym samym kraju, a strona ma kilkanaście lekkich podstron, zysk bywa niewielki. Więcej da zwykle uporządkowanie obrazów, wtyczek i pamięci podręcznej na serwerze.
Czy przeniesienie obrazów na subdomenę obniży widoczność w Grafice Google?
Google dopuszcza obrazy na innej domenie i pozwala umieszczać takie adresy w mapie witryny. Ryzyko dotyczy samej zmiany adresów, dlatego stare adresy plików warto przekierować kodem 301, a subdomenę zweryfikować w Search Console.
Skąd wiadomo, że zapora blokuje Googlebota?
Sygnałem jest wzrost udziału kodów 403, 429 lub 5xx w raporcie Statystyki indeksowania oraz ekran weryfikacji widoczny na zrzucie w teście wersji opublikowanej. Warto też przejrzeć dziennik zdarzeń zapory w panelu sieci.
Czy można przechowywać w sieci kod HTML sklepu internetowego?
Można, ale tylko dla podstron jednakowych dla wszystkich, takich jak kategorie, karty produktów i wpisy na blogu. Koszyk, zamówienie i konto klienta muszą być wyłączone, a kopie powinny czyścić się po zmianie ceny lub dostępności.
Co zrobić, gdy po włączeniu sieci strona pokazuje starą treść?
Trzeba wyczyścić kopię w panelu sieci dla zmienionego adresu albo dla całej witryny i upewnić się, że system strony wysyła takie polecenie automatycznie po każdej aktualizacji. Jeśli problem wraca, czas ważności kopii HTML jest zbyt długi w stosunku do tego, jak często zmienia się treść.
Źródła
- Content delivery networks (CDNs), web.dev
- Optimize Time to First Byte, web.dev
- Optimize Largest Contentful Paint, web.dev
- Sprawdzone metody dotyczące SEO obrazów, Centrum wyszukiwarki Google
- Jak kody stanu HTTP wpływają na roboty Google, Google for Developers
- Zmniejszanie szybkości indeksowania przez Google, Google for Developers
- Weryfikowanie żądań od robotów i modułów pobierania Google, Google for Developers
- Omówienie robotów (klientów użytkownika) Google, Google for Developers
- Raport Statystyki indeksowania, Search Console - pomoc
- Narzędzie do sprawdzania adresów URL, Search Console - pomoc
- Jak określić stronę kanoniczną za pomocą rel="canonical" i innych metod, Centrum wyszukiwarki Google
Funkcje wyszukiwarek i asystentów AI zmieniają się szybko, dlatego wpis aktualizujemy po większych zmianach.