Duplikacja treści w serwisie powstaje wtedy, gdy ta sama lub prawie ta sama zawartość otwiera się pod kilkoma adresami jednej domeny. Najczęściej nie jest to skutek kopiowania tekstów, lecz sposobu działania systemu strony: protokołów, parametrów, sortowania i wersji pomocniczych. Poniżej opisujemy, skąd biorą się takie kopie, jak traktuje je Google, gdzie je znaleźć w Search Console i w jakiej kolejności je uporządkować.
Czym jest duplikacja treści w serwisie
Duplikacja treści w serwisie to sytuacja, w której wyszukiwarka znajduje w jednej domenie kilka adresów z identyczną albo bardzo podobną główną zawartością. Dla człowieka jest to wciąż ta sama podstrona, na przykład oferta albo karta produktu. Dla robota każdy adres jest osobnym dokumentem, dopóki go nie pobierze i nie porówna z pozostałymi.
Warto od razu oddzielić dwie sprawy. Pierwsza to duplikacja wewnętrzna, czyli powielone podstrony w obrębie własnej domeny. Druga to powtarzanie tych samych tekstów w różnych domenach, na przykład opisów producenta, które trafiają do wielu sklepów. Ten wpis dotyczy przede wszystkim pierwszej sytuacji, bo to ją właściciel strony może uporządkować bez oglądania się na innych.
Jeden adres, który wyszukiwarka uznaje za reprezentatywny dla grupy stron o tej samej lub bardzo podobnej treści. To on jest zwykle pokazywany w wynikach wyszukiwania.
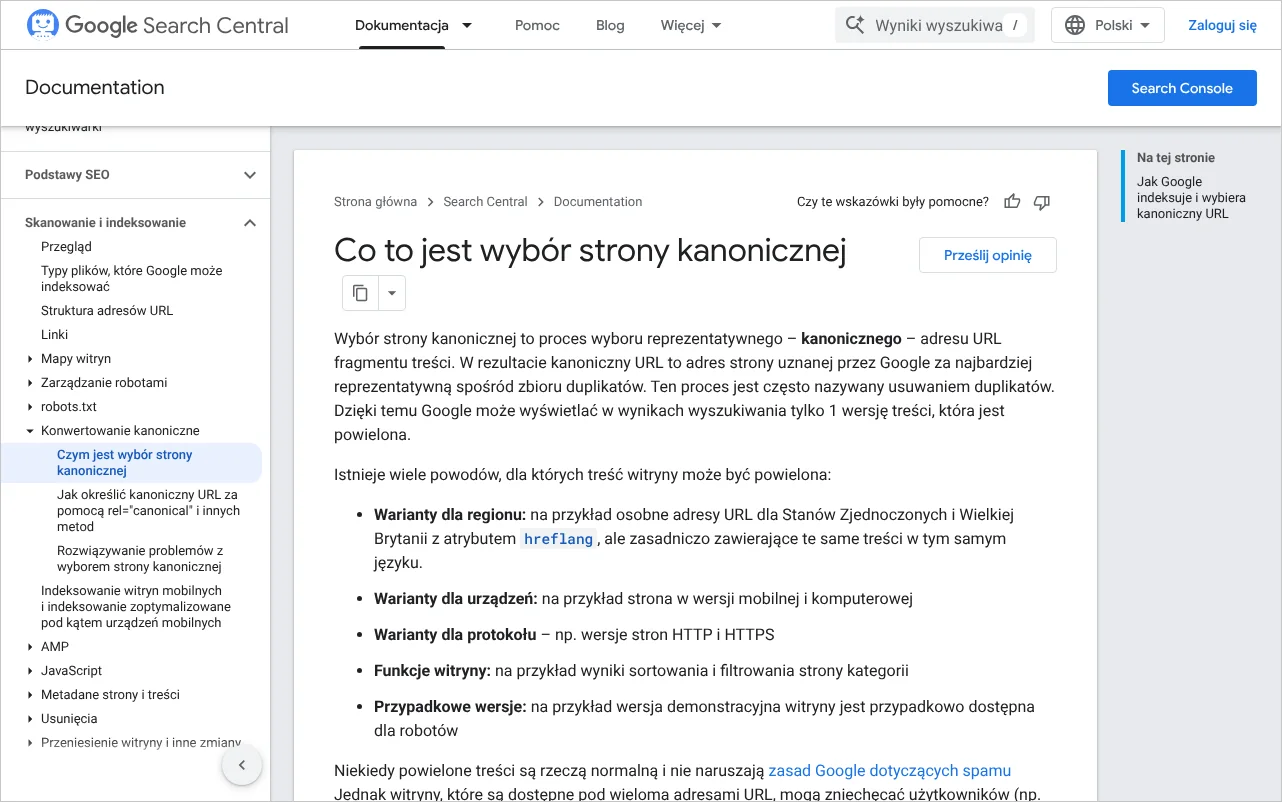
Dokumentacja Google nazywa cały proces wyborem strony kanonicznej albo usuwaniem duplikatów. Jak czytamy na stronie Co to jest wybór strony kanonicznej, polega on na wskazaniu jednego reprezentatywnego adresu dla treści dostępnej pod kilkoma adresami. Samo wdrożenie znacznika opisaliśmy osobno we wpisie o tym, jak poprawnie wdrożyć adres kanoniczny. Tutaj zajmujemy się szerszym pytaniem: skąd duplikaty się biorą i jak przywrócić w serwisie porządek.
Skąd biorą się powielone podstrony w jednej domenie
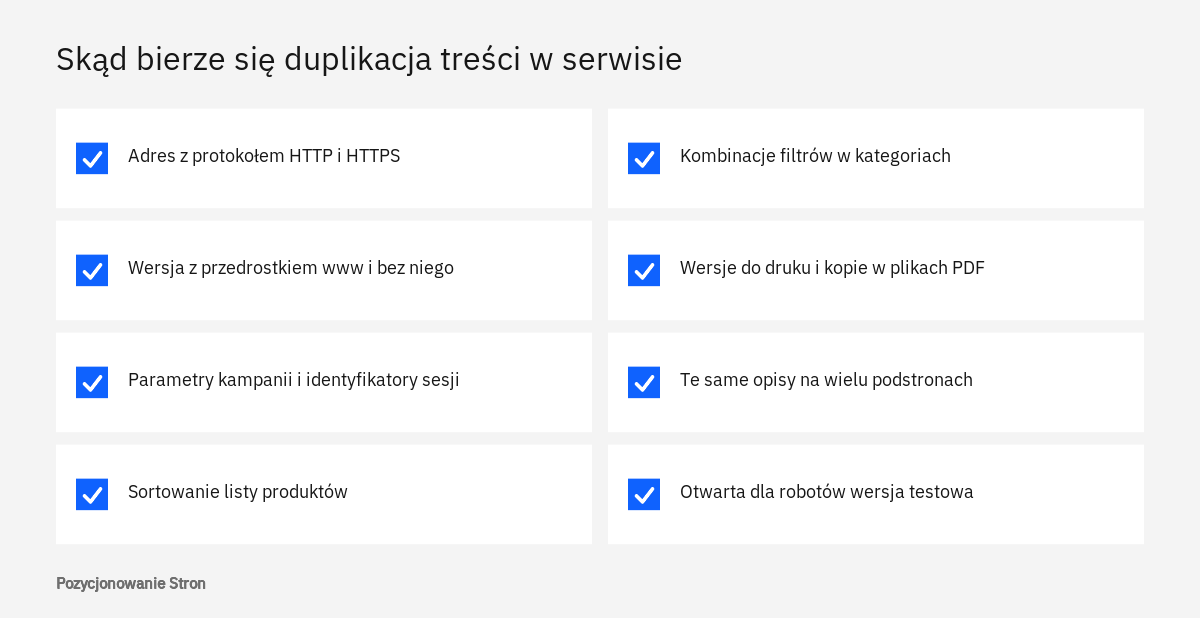
Powielone podstrony biorą się głównie z tego, że system strony pozwala dotrzeć do tej samej zawartości wieloma drogami. Google wymienia wśród typowych powodów warianty protokołu, wersje przeznaczone na różne urządzenia, warianty regionalne w tym samym języku, funkcje witryny takie jak sortowanie i filtrowanie kategorii oraz wersje testowe przypadkowo dostępne dla robotów. Poniżej omawiamy źródła, które spotykamy najczęściej.
Protokoły i warianty nazwy domeny
Ta sama strona główna może odpowiadać pod adresem z protokołem HTTP i HTTPS, z przedrostkiem www i bez niego. Daje to cztery warianty każdej podstrony, zanim ktokolwiek doda do serwisu jedno zdanie. Z naszej praktyki wynika, że podobnie działają drobniejsze różnice w zapisie: adres z ukośnikiem na końcu i bez niego, adres z nazwą pliku startowego oraz adresy różniące się wielkością liter. O tej ostatniej sprawie Google pisze wprost w zaleceniach dla sklepów: jeżeli serwer nie rozróżnia wielkości liter, w adresach należy stosować jednolity zapis.
Parametry w adresie
Parametr to fragment adresu po znaku zapytania, na przykład oznaczenie kampanii reklamowej, identyfikator sesji albo znacznik źródła wejścia. Treść strony pozostaje taka sama, ale adres jest inny. Wystarczy, że link z takim dopiskiem zostanie opublikowany w mediach społecznościowych albo na innej stronie, a robot go odnajdzie. Dokumentacja Google dotycząca adresów w sklepach zaleca unikanie w linkach wewnętrznych parametrów tymczasowych, takich jak identyfikatory sesji i kody śledzenia.
Sortowanie, filtry i podział na strony
Lista produktów ułożona od najtańszych, od najnowszych i według popularności zawiera te same pozycje w innej kolejności. Filtry koloru, rozmiaru, marki i ceny mnożą adresy jeszcze mocniej. Google opisuje to zjawisko pod nazwą nawigacji fasetowej, czyli filtrowania listy według cech, i zwraca uwagę, że przy wielu filtrach liczba możliwych kombinacji, a więc i adresów, może stać się bardzo duża. Do tej samej grupy należy podział listy na kolejne strony, jeśli pierwsza otwiera się raz z parametrem numeru, a raz bez niego.
Wersje do druku i inne kopie pomocnicze
Starsze systemy i część wtyczek tworzą osobny adres z wersją podstrony przygotowaną do wydruku albo osobną wersję na telefony w subdomenie. Do tego dochodzą kopie plików, na przykład ten sam cennik jako podstrona i jako dokument PDF, oraz środowisko testowe pozostawione po zakończeniu prac. O wersjach do druku dokumentacja, z której korzystaliśmy, nie wspomina osobno, dlatego traktujemy je jako obserwację z praktyki: zachowują się jak każda inna kopia tej samej treści pod drugim adresem.
Kopie opisów
Ostatnie źródło to powtarzane teksty. Sklep z Poznania, który sprzedaje ten sam model buta w ośmiu kolorach, ma osiem kart z identycznym opisem. Firma usługowa tworzy podstrony dla kolejnych miejscowości, zmieniając w nich wyłącznie nazwę miasta. W takich przypadkach adresy są poprawne, ale zawartość niemal się nie różni, więc wyszukiwarka może połączyć je w jedną grupę.
| Źródło duplikatu | Jak wygląda w adresie | Typowe rozwiązanie |
|---|---|---|
| Protokół i przedrostek www | http i https, z www i bez www | Stałe przekierowanie na jedną wersję |
| Parametry śledzące | Dopisek po znaku zapytania | Adres kanoniczny bez parametru |
| Sortowanie i filtry | Parametry kolejności, koloru, ceny | Adres kanoniczny listy lub ograniczenie skanowania |
| Wersja do druku, kopia w PDF | Osobny adres lub plik | Adres kanoniczny w kodzie lub w nagłówku HTTP |
| Powtórzone opisy | Różne adresy, ten sam tekst | Odrębna treść albo połączenie podstron |
| Wersja testowa serwisu | Subdomena z kopią strony | Zamknięcie dostępu hasłem |
Jak Google grupuje duplikaty i wybiera jeden adres
Google podczas indeksowania ustala główną treść każdej strony, a następnie łączy strony identyczne lub bardzo podobne w grupę i wybiera z niej jeden adres kanoniczny. Według dokumentacji jest to ta strona, która na podstawie zebranych sygnałów wydaje się najbardziej kompletna i przydatna dla użytkowników. Pozostałe adresy z grupy stają się wersjami alternatywnymi.
Wśród sygnałów branych pod uwagę dokumentacja wymienia protokół, przekierowania, obecność adresu w mapie witryny oraz adnotacje rel="canonical". Domyślnie wyszukiwarka woli wersję HTTPS. Ta preferencja przestaje jednak działać, gdy strona zabezpieczona ma kłopoty: nieprawidłowy certyfikat, przekierowanie prowadzące z powrotem na HTTP albo znacznik kanoniczny wskazujący wersję niezabezpieczoną.
Bardzo ważne jest jedno zastrzeżenie. Wskazanie preferowanego adresu przez właściciela strony jest dla Google wskazówką, a nie poleceniem. Wyszukiwarka może uznać, że inny adres lepiej reprezentuje grupę, zwłaszcza gdy sygnały na stronie sobie przeczą: znacznik kanoniczny pokazuje jeden adres, mapa witryny zawiera drugi, a menu prowadzi do trzeciego.
Co dzieje się z wersjami alternatywnymi
Strona kanoniczna jest odwiedzana przez robota najczęściej, a duplikaty rzadziej, co według Google zmniejsza obciążenie serwera. W wynikach zwykle pojawia się wersja kanoniczna, choć wyszukiwarka może pokazać inny adres z grupy, jeśli lepiej pasuje do sytuacji użytkownika, na przykład wersję mobilną osobie korzystającej z telefonu. Linki prowadzące do kopii są przypisywane do adresu kanonicznego. To dobra wiadomość, pod warunkiem że wyszukiwarka wybrała ten adres, o który Państwu chodzi.
Tłumaczenia nie są duplikatami. Google traktuje wersje językowe jako kopie tylko wtedy, gdy główna treść jest w tym samym języku, a w takiej sytuacji zaleca łączenie adresów kanonicznych z oznaczeniami hreflang, czyli znacznikami informującymi o wersjach językowych i regionalnych strony.
Dlaczego duplikacja nie jest karą, a mimo to kosztuje widoczność
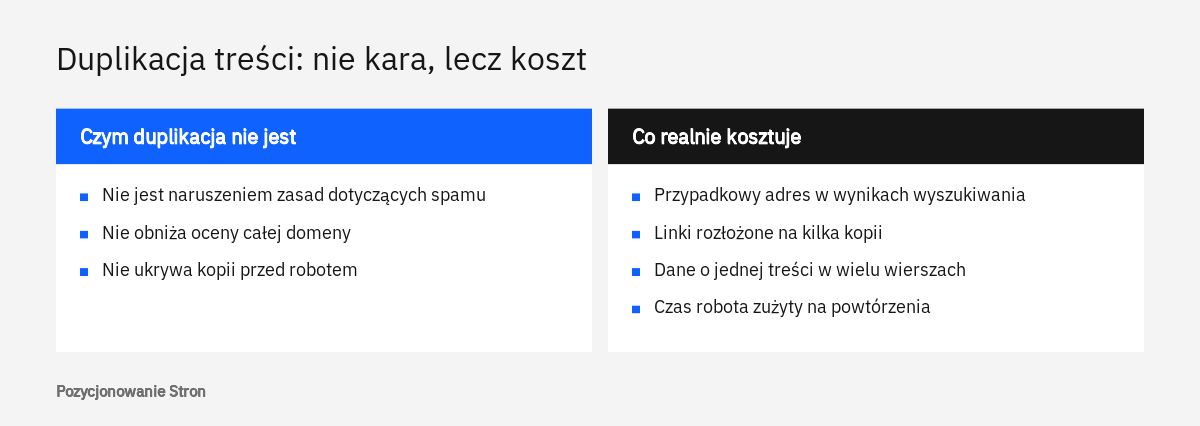
Duplikacja nie jest karą, ponieważ Google nie traktuje powielonej treści w obrębie witryny jako naruszenia zasad. Dokumentacja o wyborze strony kanonicznej podkreśla, że powtarzająca się zawartość bywa czymś zwyczajnym i sama w sobie nie łamie zasad dotyczących spamu. Wyszukiwarka nie obniża z tego powodu oceny całej domeny, tylko wybiera jedną wersję do pokazania.
Inaczej wygląda sytuacja, gdy podobne strony powstają celowo i masowo po to, by wpływać na ranking. Zasady dotyczące spamu w wyszukiwarce Google opisują między innymi strony przejściowe, czyli wiele niemal identycznych podstron tworzonych pod podobne zapytania, oraz przenoszenie treści z cudzych witryn bez dodawania czegokolwiek od siebie. To już nie jest kwestia technicznego nieporządku, lecz praktyk, za które grożą konsekwencje.
Co właściciel strony realnie traci
Skoro nie ma kary, skąd spadki widoczności kojarzone z duplikatami? Google wymienia cztery powody, dla których warto samodzielnie wskazać adres kanoniczny, a z każdego wynika konkretny koszt zaniedbania.
Pierwszy to kontrola nad adresem widocznym w wynikach. Bez wyraźnych sygnałów w wyszukiwarce może pojawić się adres z parametrem kampanii zamiast czystego adresu kategorii. Drugi to łączenie sygnałów: linki prowadzące do różnych kopii powinny pracować na jedną stronę. Trzeci to czytelność danych, ponieważ wyświetlenia i kliknięcia tej samej treści rozkładają się na kilka adresów i trudno ocenić, jak podstrona naprawdę sobie radzi. Czwarty to czas robota, który zamiast pobierać nowe i zmienione podstrony, wraca do kopii.
Ten ostatni koszt zależy od wielkości serwisu. W materiale Optymalizacja budżetu indeksowania Google zaznacza, że temat dotyczy przede wszystkim dużych witryn z często zmieniającą się zawartością, a małe strony nie muszą się nim zajmować. Dużym serwisom zaleca usuwanie powielonych treści, tak aby robot skupiał się na niepowtarzalnej zawartości, a nie na niepowtarzalnych adresach. Dla kancelarii z Krakowa z trzydziestoma podstronami problemem będzie więc raczej niewłaściwy adres w wynikach i rozproszone linki. Dla sklepu z rozbudowanymi filtrami dochodzi wolniejsze odkrywanie nowych produktów.
Porządkowanie duplikatów nie służy zatem unikaniu sankcji, lecz odzyskaniu wpływu na to, który adres reprezentuje firmę w wynikach. Taki przegląd jest stałą częścią usługi, jaką jest audyt SEO. Od podobnego zjawiska, w którym różne teksty walczą o tę samą frazę, odróżniamy je we wpisie o tym, jak wykryć podstrony, które konkurują ze sobą.
Jeśli chcą Państwo zamówić audyt SEO, zachęcamy do kontaktu: tel. 222 500 844 lub mailowo: biuro@pozycjonowaniestron.pl
Jak wykryć duplikaty w Search Console
Duplikaty najprościej znaleźć w raporcie Indeksowanie stron w Google Search Console, który pokazuje, ile adresów serwisu nie trafiło do indeksu i z jakiego powodu. Raport otwiera się z menu po lewej stronie, w grupie Indeksowanie, pozycja Strony. Pod wykresem znajduje się tabela zatytułowana „Dlaczego strony nie są indeksowane”. Kliknięcie wiersza z przyczyną otwiera stronę szczegółów z listą przykładowych adresów.
Statusy, które mówią o powielonej treści
Z duplikacją wiążą się cztery przyczyny opisane na stronie pomocy Raport Indeksowanie stron. Każda oznacza coś innego i tylko część z nich wymaga działania.
| Przyczyna w raporcie | Co oznacza | Czy wymaga reakcji |
|---|---|---|
| Alternatywna strona zawierająca prawidłowy tag strony kanonicznej | Adres jest kopią, poprawnie wskazuje stronę główną, a ta jest w indeksie | Zwykle nie, to stan pożądany |
| Duplikat, użytkownik nie oznaczył strony kanonicznej | Strona powtarza inną i nie ma deklaracji, Google wybrał adres sam | Tak, warto wskazać adres albo zróżnicować treść |
| Duplikat, wyszukiwarka Google wybrała inną stronę kanoniczną niż użytkownik | Deklaracja istnieje, ale Google uznał inny adres za lepszy | Tak, trzeba ujednolicić sygnały lub zmienić treść |
| Strona zawiera przekierowanie | Adres przenosi na inny i sam nie jest indeksowany | Nie, jeśli przekierowanie jest zamierzone |
Najczęstsze nieporozumienie dotyczy pierwszego wiersza. Duża liczba adresów ze statusem alternatywnej strony z prawidłowym tagiem kanonicznym nie jest błędem. Pokazuje, że mechanizm działa zgodnie z planem. Uwagi wymagają natomiast dwa statusy zaczynające się od słowa „Duplikat”, zwłaszcza gdy na listach przykładów widać ważne podstrony ofertowe, a nie adresy z parametrami. Pozostałe przyczyny omawiamy we wpisie o tym, dlaczego Google nie indeksuje strony.
Sprawdzenie pojedynczego adresu
Drugim narzędziem jest pole wyszukiwania na samej górze Search Console, czyli narzędzie do sprawdzania adresów URL. Po wpisaniu pełnego adresu podstrony i rozwinięciu sekcji Indeksowanie stron widać dwa pola: „Adres kanoniczny określony przez użytkownika” oraz „Adres kanoniczny wybrany przez Google”. Pierwsze pokazuje, co deklaruje sama strona. Drugie pokazuje, który adres wyszukiwarka faktycznie uznała za główny. Jeśli się różnią, Google nie zgodził się z deklaracją.
Pomoc Google wyjaśnia przy tym dwie rzeczy, które łatwo przeoczyć. Wartość „Brak” w polu adresu określonego przez użytkownika jest poprawna, gdy strona nie ma kopii. Adres wybrany przez Google jest ustalany podczas indeksowania i może aktualizować się z opóźnieniem, dlatego po wprowadzeniu zmian nie widać efektu natychmiast. Po naprawie na stronie szczegółów problemu można zgłosić poprawkę do sprawdzenia, a według pomocy Google taka weryfikacja trwa zwykle do około dwóch tygodni.
Jak uporządkować powielone adresy: przekierowanie, adres kanoniczny, mapa witryny
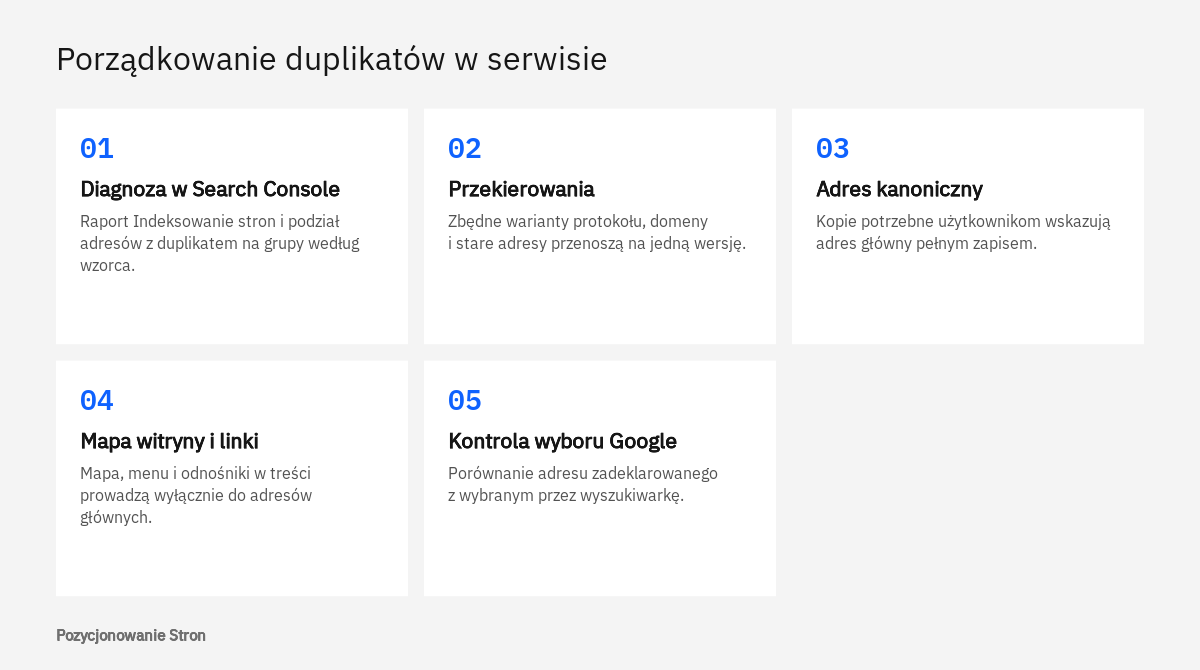
Powielone adresy porządkuje się trzema metodami, które Google opisuje w kolejności od najsilniejszej: przekierowaniem, elementem rel="canonical" i mapą witryny. Zgodnie ze stroną Jak określić kanoniczny URL za pomocą rel="canonical" i innych metod przekierowanie jest sygnałem najsilniejszym, adnotacja kanoniczna silnym, a obecność adresu w mapie witryny słabym. Metody można łączyć i im bardziej są zgodne, tym większa szansa, że wyszukiwarka przyjmie wskazany adres.
Przekierowanie, gdy kopia ma zniknąć
Przekierowanie stosuje się wtedy, gdy drugi adres nie jest nikomu potrzebny. Dotyczy to wariantów protokołu i przedrostka www, adresów z nazwą pliku startowego oraz starych adresów po przebudowie strony. Użytkownik i robot trafiają wtedy od razu pod właściwy adres. Do scalania duplikatów służy przekierowanie stałe, a różnice między rodzajami wyjaśniamy we wpisie przekierowanie 301 a 302.
Element rel="canonical", gdy kopia ma pozostać dostępna
Część kopii jest potrzebna ludziom. Lista posortowana od najtańszych, adres z parametrem kampanii czy wersja do druku powinny działać, ale nie powinny być osobnymi wynikami. W takich przypadkach w sekcji nagłówkowej kopii umieszcza się element wskazujący adres główny. Google zaleca też, aby strona główna wskazywała w ten sam sposób samą siebie oraz aby używać adresów bezwzględnych, czyli pełnych, z protokołem i nazwą domeny.
<!-- w sekcji head adresu https://przyklad.pl/buty-biegowe/?sortuj=cena -->
<link rel="canonical" href="https://przyklad.pl/buty-biegowe/" />

# nagłówek odpowiedzi serwera dla pliku cennik.pdf
Link: <https://przyklad.pl/cennik/>; rel="canonical"
Drugi zapis przydaje się przy dokumentach, które nie mają kodu HTML. Dokumentacja radzi stosować dla danej strony jeden sposób deklaracji, ponieważ użycie obu naraz zwiększa ryzyko pomyłki.
Mapa witryny i linki wewnętrzne
Mapa witryny powinna zawierać wyłącznie adresy główne. Jeśli znajdują się w niej warianty z parametrami albo adresy, które przekierowują, wysyła ona sygnał sprzeczny z pozostałymi. Zasady jej budowy opisaliśmy we wpisie o tym, co umieścić w mapie witryny XML. Równie ważne są linki wewnętrzne: Google zaleca, aby menu, stopka i odnośniki w treści prowadziły do adresu kanonicznego, a nie do jego kopii.
Czego nie stosować do scalania duplikatów
Dokumentacja wymienia trzy narzędzia, które do tego celu się nie nadają. Plik robots.txt nie służy do wyboru strony kanonicznej, ponieważ zablokowany adres może mimo to trafić do indeksu, tyle że bez treści. Dyrektywa noindex nie jest sposobem na wskazanie wersji głównej w obrębie witryny, bo wyłącza stronę z wyników. Narzędzie do usuwania adresów w Search Console ukrywa wszystkie wersje, również tę właściwą. Różnice między tymi mechanizmami zestawiliśmy we wpisie canonical, noindex i robots.txt.
Parametry, sortowanie i filtry w sklepie: jak nad nimi zapanować
Nad adresami z parametrami panuje się przez decyzję, które z nich mają być widoczne w wyszukiwarce, a które służą wyłącznie wygodzie kupującego. Sortowanie nigdy nie tworzy nowej treści, więc nie ma powodu, by lista ułożona według ceny była osobnym wynikiem. Z filtrami bywa różnie: lista „buty biegowe damskie” może odpowiadać na realne zapytanie, a lista ograniczona jednocześnie do koloru, rozmiaru i przedziału cenowego raczej nie.
Dla adresów, które nie powinny być skanowane, Google w materiale Zarządzanie indeksowaniem adresów URL nawigacji fasetowej opisuje dwa podejścia. Pierwsze to zablokowanie parametrów filtrów w pliku robots.txt przy pozostawieniu dostępu do kart produktów i do listy bez filtrów. Drugie to zapisywanie ustawień filtrów we fragmencie adresu, po znaku kratki. Jako metody mniej skuteczne w dłuższym okresie dokumentacja wymienia adres kanoniczny wskazujący listę bez filtrów oraz atrybut nofollow na linkach do wyników filtrowania.
Tu pojawia się pozorna sprzeczność z poprzednią sekcją. Plik robots.txt nie służy do wskazywania strony kanonicznej, ale służy do ograniczania skanowania. W małym sklepie wystarczy adres kanoniczny na listach z sortowaniem. W dużym, w którym robot spędza większość czasu na kombinacjach filtrów, ważniejsze staje się odcięcie tych adresów od skanowania.
Jeżeli wybrane listy z filtrami mają być indeksowane, Google zaleca standardowy znak łączący parametry, stałą kolejność filtrów zapisanych w ścieżce adresu oraz zwracanie kodu błędu 404 dla kombinacji bez wyników. W zaleceniach dla sklepów dodaje, że parametr numeru pierwszej strony listy należy konsekwentnie stosować albo konsekwentnie pomijać, a warianty produktu z opcjonalnym parametrem powinny wskazywać jako kanoniczny adres bez tego parametru. Więcej o budowie list piszemy we wpisie o stronach kategorii w sklepie, a prace tego rodzaju prowadzimy w ramach usługi pozycjonowanie sklepów.
Kopie opisów i podobne podstrony: kiedy trzeba napisać treść na nowo
Treść trzeba napisać na nowo wtedy, gdy dwie podstrony mają istnieć jako osobne wyniki, a różnią się jedynie szczegółem. Żaden znacznik tego nie załatwi. Pomoc Search Console przy statusie duplikatu bez oznaczonej strony kanonicznej podaje dwie drogi: jeśli strona nie powinna być kopią, należy zmienić jej zawartość tak, by wyraźnie się różniła, a jeśli jest kopią, trzeba wskazać adres główny.
Hydraulik z Łodzi, który przygotował dwadzieścia podstron dla okolicznych miejscowości z tym samym tekstem i podmienioną nazwą, stoi przed takim właśnie wyborem. Może pozostawić jedną dobrą stronę usługi z listą obsługiwanych miejscowości i przekierować na nią pozostałe. Może też rozwinąć wybrane podstrony o informacje, które naprawdę dotyczą danego miejsca. Wiele niemal identycznych stron tworzonych pod podobne zapytania zasady Google zaliczają do stron przejściowych, więc pierwsza droga jest zwykle bezpieczniejsza. Temat rozwijamy we wpisie o firmie z wieloma oddziałami w Google.
W sklepie podobny wybór dotyczy wariantów. Jeśli kolor nie zmienia niczego poza zdjęciem, rozsądnie jest wskazać jeden adres produktu jako kanoniczny dla wszystkich wariantów. Jeśli klienci szukają konkretnej wersji i ma ona inne cechy, wariant zasługuje na własny opis.
Typowe pomyłki przy porządkowaniu duplikatów i kiedy potrzebna jest pomoc
Najczęstszą pomyłką jest wysyłanie wyszukiwarce sprzecznych sygnałów, czyli sytuacja, w której znacznik kanoniczny, mapa witryny, przekierowania i linki wewnętrzne wskazują różne adresy. Google wprost odradza stosowanie różnych sygnałów dla tej samej strony.
Drugi błąd to znacznik kanoniczny ustawiony automatycznie na stronę główną dla wszystkich podstron albo wskazujący wersję HTTP w serwisie działającym pod HTTPS. Trzeci to jednoczesne użycie znacznika kanonicznego i blokady w robots.txt: robot nie pobierze zablokowanej strony, więc nie przeczyta znacznika. Czwarty to wstawianie znacznika skryptem dopiero po załadowaniu strony, choć dokumentacja radzi, by adres kanoniczny znajdował się już w kodzie źródłowym. Zdarza się też nadgorliwość: po zobaczeniu kilku tysięcy adresów ze statusem alternatywnej strony właściciel próbuje je blokować, choć raport pokazuje stan prawidłowy.
- Wszystkie warianty protokołu i przedrostka www przekierowują na jedną wersję adresu.
- Każda ważna podstrona zawiera element rel="canonical" wskazujący ją samą, zapisany pełnym adresem.
- Listy z sortowaniem i adresy z parametrami kampanii wskazują jako kanoniczny adres podstawowy.
- Mapa witryny, menu i linki w treści zawierają te same adresy główne.
- Wersja testowa serwisu jest niedostępna dla robotów.
- Adres zadeklarowany i wybrany przez Google są zgodne dla kluczowych podstron.
- Podstrony o prawie identycznych opisach zostały połączone albo otrzymały odrębną treść.
Wsparcie specjalisty przydaje się w trzech sytuacjach. Pierwsza to duży sklep z filtrami, w którym błędna reguła w robots.txt może odciąć od wyszukiwarki całe kategorie. Druga to zmiana domeny, protokołu lub systemu strony, kiedy przekierowania trzeba zaplanować dla wszystkich adresów naraz, co opisujemy przy usłudze migracja domeny i hostingu. Trzecia to przypadek, w którym mimo poprawnych znaczników Google przyjmuje inny adres niż zadeklarowany. Przyczyna leży wtedy zwykle w linkowaniu, w treści albo w ustawieniach serwera, którymi zajmuje się SEO techniczne. Nie obiecujemy przy tym określonych pozycji: uporządkowanie adresów usuwa przeszkodę, a nie zastępuje pracy nad treścią i ofertą.
Jeśli chcą Państwo zamówić audyt SEO, zachęcamy do kontaktu: tel. 222 500 844 lub mailowo: biuro@pozycjonowaniestron.pl
Najczęstsze pytania
Czy Google nakłada karę za duplikację treści w obrębie jednej strony?
Nie. Dokumentacja Google podkreśla, że powielona treść bywa zjawiskiem zwyczajnym i sama w sobie nie narusza zasad dotyczących spamu. Konsekwencje grożą dopiero za celowe, masowe tworzenie podobnych stron w celu wpływania na ranking.
Ile powtórzonego tekstu wystarczy, aby strony zostały uznane za duplikaty?
W dokumentacji, z której korzystaliśmy, nie ma żadnego progu procentowego. Mowa jest o stronach identycznych lub bardzo podobnych pod względem głównej treści. Wiarygodnym sprawdzianem jest narzędzie do sprawdzania adresów URL w Search Console.
Co oznacza status „Alternatywna strona zawierająca prawidłowy tag strony kanonicznej”?
Oznacza, że dany adres jest wersją alternatywną, poprawnie wskazuje stronę główną, a strona główna znajduje się w indeksie. Pomoc Search Console opisuje ten stan jako prawidłowy i zwykle nie wymaga on żadnych działań.
Dlaczego Google wybrał inny adres kanoniczny niż zadeklarowany na stronie?
Deklaracja jest dla wyszukiwarki wskazówką, a nie poleceniem. Google mógł uznać inny adres za lepszego reprezentanta grupy, zwłaszcza przy sprzecznych sygnałach. Rozwiązaniem jest ich ujednolicenie albo wyraźne zróżnicowanie treści obu stron.
Czy lepiej zastosować przekierowanie, czy adres kanoniczny?
Zależy to od tego, czy kopia jest potrzebna użytkownikom. Jeśli nie, przekierowanie jest najsilniejszym sygnałem i usuwa drugi adres. Jeśli kopia ma działać, jak lista z sortowaniem lub adres z parametrem kampanii, właściwy jest element rel="canonical".
Czy mała strona firmowa powinna przejmować się budżetem indeksowania?
Zazwyczaj nie. Google zaznacza, że zarządzanie budżetem indeksowania dotyczy przede wszystkim dużych witryn z często zmieniającą się zawartością. W małym serwisie duplikaty szkodzą głównie przez niewłaściwy adres w wynikach i rozproszone linki.
Źródła
- Co to jest wybór strony kanonicznej, Centrum wyszukiwarki Google
- Jak określić kanoniczny URL za pomocą rel="canonical" i innych metod, Centrum wyszukiwarki Google
- Raport Indeksowanie stron, Search Console - pomoc
- Narzędzie do sprawdzania adresów URL, Search Console - pomoc
- Optymalizacja budżetu indeksowania, Google for Developers
- Zarządzanie indeksowaniem adresów URL nawigacji fasetowej, Google for Developers
- Sprawdzone metody projektowania struktury adresów URL na potrzeby witryn e-commerce, Centrum wyszukiwarki Google
- Zasady dotyczące spamu w wyszukiwarce Google, Centrum wyszukiwarki Google
Funkcje wyszukiwarek i asystentów AI zmieniają się szybko, dlatego wpis aktualizujemy po większych zmianach.