Transkrypcja to tekstowa wersja tego, co słychać w filmie lub nagraniu dźwiękowym: wypowiedzi oraz dźwięków potrzebnych do zrozumienia treści. Żeby stała się czytelnym tekstem, trzeba ją spisać, sprawdzić, uporządkować w akapity i opatrzyć nagłówkami, a dopiero potem opublikować obok nagrania. Poniżej opisujemy, czym różni się zapis dosłowny od napisów i od tekstu redakcyjnego, jak poprawiać wynik automatycznego rozpoznawania mowy i czego wymagają wytyczne dostępności W3C.
Czym jest transkrypcja i komu służy
Transkrypcja jest zapisem tekstowym nagrania, który pozwala poznać jego treść bez słuchania i bez oglądania. Inicjatywa dostępności W3C opisuje ją na stronie poświęconej transkrypcjom jako tekstową wersję mowy oraz tych dźwięków spoza mowy, które są potrzebne do zrozumienia materiału. Nie chodzi więc wyłącznie o słowa. Jeżeli w nagraniu szkoleniowym słychać sygnał alarmu, po którym prowadzący przerywa pokaz, czytelnik zapisu powinien się o tym sygnale dowiedzieć.
Z transkrypcji korzystają przede wszystkim osoby głuche i słabosłyszące oraz osoby, którym trudno przetwarzać informacje podawane dźwiękiem. W praktyce grono odbiorców jest szersze. Tekst czyta się w miejscach, w których nie można włączyć głośnika. Tekst pozwala też szybko odszukać jedno zdanie w godzinnej rozmowie i skopiować fragment do notatek. Dla firmy oznacza to, że wiedza zamknięta dotąd w nagraniu staje się treścią, którą da się przeszukiwać, cytować i rozwijać.
Podstawowa, opisowa i interaktywna
W3C rozróżnia trzy odmiany. Transkrypcja podstawowa zawiera mowę i istotne dźwięki. Transkrypcja opisowa dodaje do tego słowny opis informacji przekazywanych obrazem, na przykład treści slajdu, napisu na ekranie albo czynności, którą wykonuje osoba w kadrze. Według W3C taka wersja jest niezbędna, aby materiał wideo był dostępny dla osób jednocześnie głuchych i niewidomych, a przy okazji może zastąpić osobną wersję podstawową. Trzecia odmiana, transkrypcja interaktywna, jest funkcją odtwarzacza: wykorzystuje plik z napisami, podświetla zdanie wypowiadane w danej chwili i pozwala kliknąć fragment tekstu, aby przejść do odpowiedniego miejsca filmu.
Dla większości firmowych materiałów punktem wyjścia jest wersja podstawowa. Wersję opisową warto rozważyć tam, gdzie obraz niesie informację, której nikt nie wypowiada: w instrukcjach montażu, pokazach obsługi programu, nagraniach z prezentacją pełną wykresów. Załóżmy, że producent mebli z Poznania nagrywa film o składaniu szafy, a lektor mówi jedynie „teraz łączymy te dwa elementy”. Sam zapis słów nikomu nie pomoże, dopóki nie pojawi się w nim informacja, o które elementy chodzi.
Zapis dosłowny, napisy i tekst na podstawie nagrania - czym się różnią
Różnią się celem, a z celu wynika wszystko inne: stopień wierności, układ i miejsce publikacji. Zapis dosłowny oddaje każde słowo, napisy pokazują wypowiedzi na ekranie w rytmie nagrania, a tekst redakcyjny przekazuje tę samą wiedzę językiem pisanym, we własnym porządku. Kłopoty zaczynają się wtedy, gdy jeden materiał próbuje pełnić wszystkie role jednocześnie.
Zapis dosłowny obejmuje także wtrącenia, powtórzenia i urwane zdania. W3C w materiale o zamianie dźwięku na tekst wskazuje, że taka pełna wierność jest potrzebna w niektórych rodzajach treści, na przykład w zeznaniach, natomiast w większości materiałów publikowanych w sieci można pominąć elementy, które nie niosą treści: wypełniacze, kaszlnięcia i fałszywe początki zdań. Taką wersję nazywa się zwykle transkrypcją oczyszczoną i to ona najczęściej trafia na stronę firmy.
Napisy to ten sam tekst, ale zsynchronizowany z dźwiękiem i podzielony na krótkie porcje. W3C na stronie o napisach rozdziela dwa pojęcia, które po polsku zlewają się w jedno: napisy w języku nagrania, przeznaczone dla osób niesłyszących, oraz napisy będące tłumaczeniem na inny język. Tylko pierwsze odpowiadają na potrzebę związaną z dostępnością. Napisy mogą być zamknięte, czyli włączane i wyłączane przez widza, albo otwarte, czyli wtopione w obraz na stałe. W3C zaleca, aby napis zajmował jedną lub dwie linie, a wiersz miał najlepiej mniej niż trzydzieści dwa znaki.
Tekst redakcyjny na podstawie nagrania jest już osobnym utworem. Autor wybiera z rozmowy najważniejsze wątki, zmienia ich kolejność, dopisuje wprowadzenie i wyjaśnienia. Taki tekst nie zastępuje transkrypcji w rozumieniu wytycznych dostępności, ponieważ nie oddaje wiernie tego, co padło w nagraniu. Może natomiast stać obok niej. O tym, kiedy film powinien mieć towarzyszący mu tekst, a kiedy sam wystarcza, piszemy we wpisie o wideo na stronie firmy, dlatego tutaj skupiamy się na samym warsztacie zamiany mowy w tekst.
| Cecha | Zapis dosłowny | Transkrypcja oczyszczona | Napisy | Tekst na podstawie nagrania |
|---|---|---|---|---|
| Wierność wobec nagrania | Pełna, łącznie z wtrąceniami | Pełna co do treści, bez wypełniaczy | Pełna co do treści, w krótkich porcjach | Swobodna, autor wybiera i porządkuje |
| Powiązanie z czasem | Zwykle brak | Znaczniki czasu tam, gdzie pomagają | Każdy napis ma czas wyświetlenia | Brak |
| Typowe zastosowanie | Dokumentacja, materiały dowodowe | Strona z filmem lub podkastem | Odtwarzacz wideo | Blog, baza wiedzy, strona usługi |
| Rola dla dostępności | Transkrypcja | Transkrypcja | Napisy | Uzupełnienie, nie zamiennik |
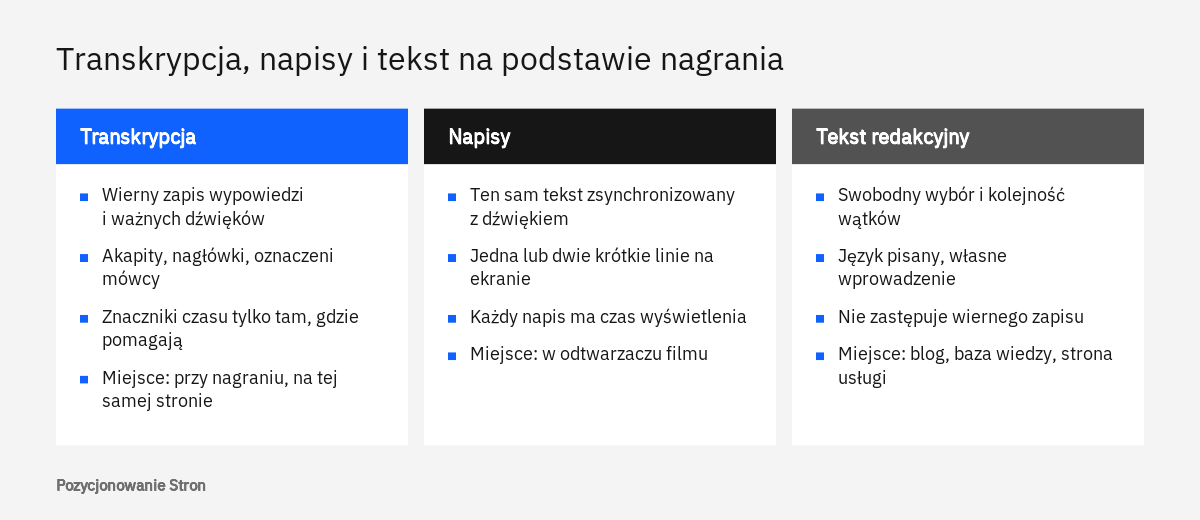
Napisy i transkrypcja mają wspólne źródło. W3C zauważa, że zawierają ten sam tekst, więc jedno można przygotować z drugiego: większość narzędzi do napisów potrafi wyeksportować zwykły tekst, który następnie wystarczy złożyć w akapity. Trzeba tylko liczyć się z tym, że w napisach często brakuje informacji wizualnych oraz oznaczenia osób, bo na ekranie widać, kto mówi. W zapisie przeznaczonym do czytania te luki należy uzupełnić.
Automatyczne rozpoznawanie mowy i konieczna korekta
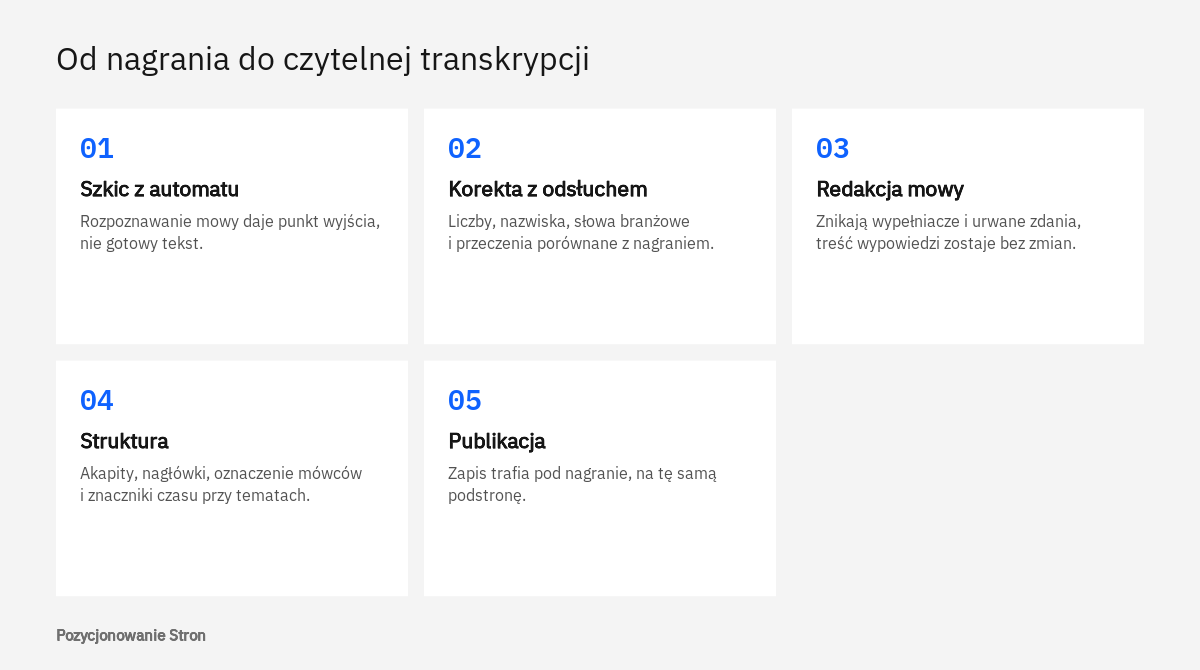
Automat potrafi szybko spisać długie nagranie, ale jego wynik jest szkicem, a nie gotową transkrypcją. W3C mówi o tym wprost: napisy tworzone automatycznie nie są wystarczające, dopóki nie zostanie potwierdzone, że są w pełni zgodne z nagraniem, i zazwyczaj wymagają znacznych poprawek. Mogą natomiast służyć jako punkt wyjścia do dalszej pracy.
Powód jest prosty: błąd rozpoznawania mowy potrafi odwrócić sens zdania. W materiałach W3C pojawiają się dwa przykłady warte zapamiętania. W pierwszym automat gubi słowo przeczenia, przez co instrukcja mówi coś odwrotnego niż prowadzący. W drugim wyrażenie „od czterech do pięciu minut” zostaje zapisane jako „czterdzieści pięć minut”. W przepisie kulinarnym skończy się to przypalonym daniem, w opisie procedury bezpieczeństwa skutki mogą być poważniejsze.
Pomoc YouTube opisuje źródła takich pomyłek podobnie. Na stronie o korzystaniu z napisów automatycznych czytamy, że napisy powstają dzięki technologii rozpoznawania mowy opartej na uczeniu maszynowym, a ich jakość bywa różna. Błędy wynikają z wymowy, akcentu, dialektu i szumów w tle. Serwis zaleca, aby napisy automatyczne zawsze przejrzeć i poprawić fragmenty zapisane nieprawidłowo. Język polski znajduje się na liście języków, w których napisy automatyczne są tworzone dla filmów. Inaczej jest z transmisjami na żywo: według tej samej strony automatyczne napisy na żywo działają wyłącznie po angielsku.
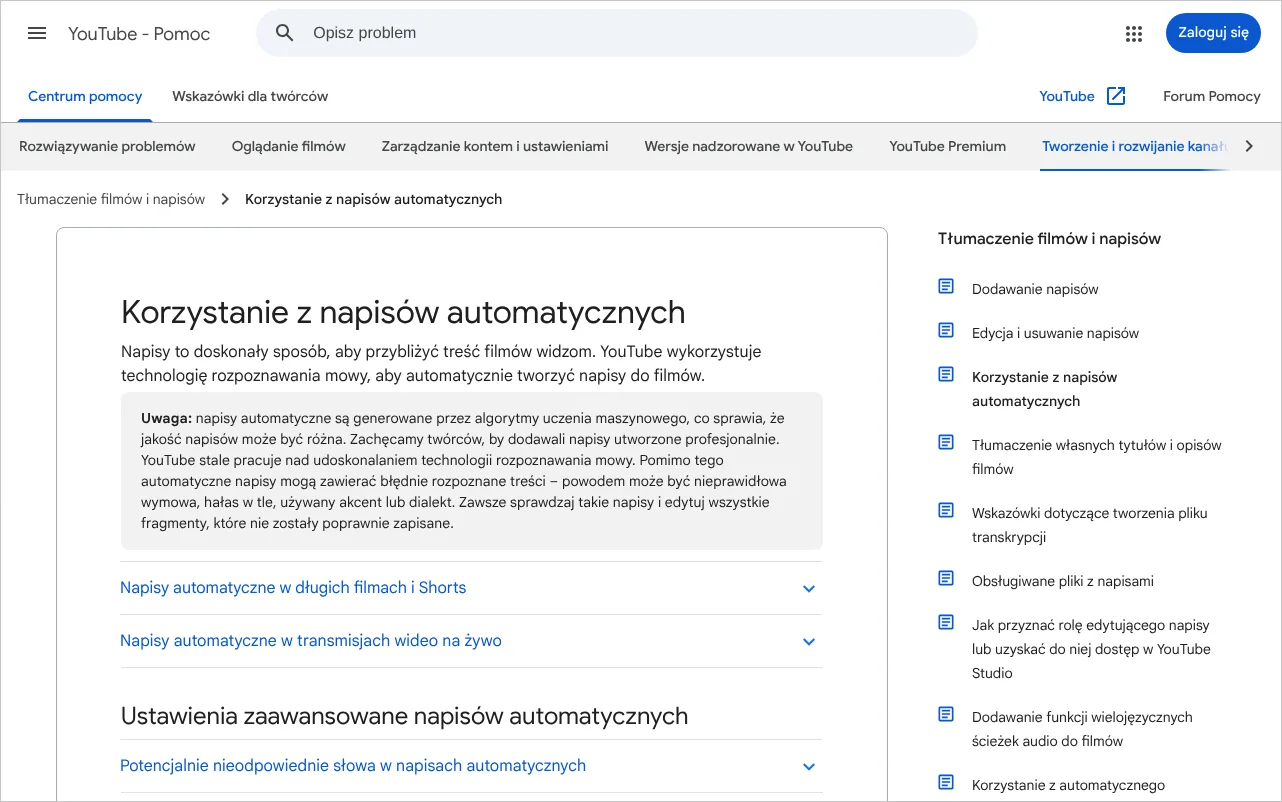
Gdzie poprawić napisy automatyczne w YouTube
Po zalogowaniu do YouTube Studio należy wybrać w menu po lewej stronie pozycję „Napisy”, a następnie kliknąć film, którego dotyczy korekta. W sekcji „Napisy” obok wersji utworzonej automatycznie znajduje się ikona „Więcej” w postaci trzech kropek. Po jej kliknięciu można przejrzeć zapis, poprawić błędne fragmenty albo je usunąć.
Jeżeli firma ma już własny, sprawdzony tekst, może go wgrać zamiast poprawiać wersję automatu. Strona pomocy o dodawaniu napisów opisuje tę drogę: w zakładce „Napisy” po kliknięciu filmu używa się przycisku dodawania języka, wskazuje język, a potem wybiera jedną z metod. Pierwsza to przesłanie gotowego pliku z tekstem i znacznikami czasu. Druga nosi nazwę „Autosynchronizacja”: wkleja się sam tekst wypowiedzi, a serwis dopasowuje go do dźwięku, co może potrwać kilka minut. Trzecia to ręczne wpisywanie napisów w trakcie odtwarzania filmu. Autosynchronizacja jest wygodna zwłaszcza wtedy, gdy nagranie powstało według scenariusza - wystarczy drobna korekta, aby tekst zgadzał się z ostatecznym dźwiękiem.
Na co patrzeć przy korekcie
Z naszej praktyki wynika, że automat najczęściej myli się w tych samych miejscach: w liczbach, nazwach własnych, słowach branżowych oraz krótkich wyrazach zmieniających sens. Dlatego korektę warto prowadzić według stałej listy.
- Wszystkie liczby, kwoty, jednostki i godziny porównane z nagraniem.
- Nazwiska, nazwy produktów i miejscowości zapisane poprawnie.
- Słowa branżowe i skróty zgodne z tym, co faktycznie powiedziano.
- Żadne przeczenie nie zniknęło i żadne się nie pojawiło.
- Fragmenty niezrozumiałe oznaczone w nawiasie kwadratowym, a nie zgadywane.
- Interpunkcja i podział na zdania nadane ręcznie tam, gdzie automat ich nie postawił.
- Zapis odsłuchany w całości przynajmniej raz razem z tekstem na ekranie.
Ostatni punkt bywa pomijany z braku czasu, a jest najważniejszy. Czytanie samego tekstu nie wykrywa błędów, które brzmią sensownie. W3C uprzedza, że na poprawianie wyniku automatu trzeba przeznaczyć sporo czasu, i dodaje, że dobre spisywanie jest bardziej sztuką niż nauką. Kto ma taką możliwość, powinien powierzyć je osobie z doświadczeniem, a kto jej nie ma, i tak powinien udostępnić transkrypcję lub napisy przygotowane samodzielnie.
Jak redagować język mówiony, żeby dało się go czytać
Redakcja transkrypcji polega na usunięciu tego, co utrudnia czytanie, przy zachowaniu wszystkiego, co zostało powiedziane. Granicę wyznacza W3C: wolno pominąć mowę pozbawioną treści, nie wolno zmieniać, przerabiać ani uzupełniać wypowiedzi. To zasadnicza różnica między transkrypcją a tekstem redakcyjnym, w którym autor ma pełną swobodę.
Mowa i pismo rządzą się innymi prawami. Mówiący zaczyna zdanie, porzuca je, wraca do myśli sprzed minuty, powtarza słowo, szukając następnego. W rozmowie tego nie słychać, w zapisie takie zdania stają się nieczytelne. Dlatego z tekstu przeznaczonego na stronę usuwa się wypełniacze w rodzaju „yyy” i „no więc”, urwane początki, które mówiący sam zaraz zastąpił pełnym zdaniem, oraz odgłosy bez znaczenia. Zostają natomiast wszystkie informacje, opinie, zastrzeżenia i przykłady, także te, które w ocenie redaktora wypadły niezręcznie.
Wytyczne W3C zawierają kilka zasad uczciwości, o których łatwo zapomnieć w dobrej wierze. Co do zasady nie poprawia się gramatyki ani pomyłek mówiącego. Nie cenzuruje się wypowiedzi: jeśli w nagraniu słowo zostało zagłuszone sygnałem, zaznacza się to w tekście, a jeśli nie zostało, pozostaje w zapisie. Jeżeli redaktor pomija dłuższy fragment niezwiązany z tematem, informuje o tym w nawiasie kwadratowym. Fragment, którego nie da się zrozumieć, oznacza się jako niezrozumiały, zamiast wpisywać domysł.
Akapity, interpunkcja i dźwięki
Najwięcej dla czytelności robi podział na akapity. W3C zaleca, aby wiersze napisów połączyć w logiczne całości: akapity, a tam, gdzie pasuje, listy lub komórki tabeli. Dobrą miarą jest jedna myśl w jednym akapicie i nowy akapit przy każdej zmianie mówcy. Interpunkcję stawia się zgodnie z sensem, nie z oddechem mówiącego, ponieważ pauza w mowie nie zawsze oznacza koniec zdania.
Dźwięki spoza mowy zapisuje się w nawiasach, krótko i rzeczowo, na przykład „(śmiech sali)” albo „(dzwonek telefonu)”. W3C proponuje małe litery i kursywę oraz opis obiektywny, bez ocen. Muzykę w tle odnotowuje się tylko wtedy, gdy ma znaczenie dla treści. Wielkie litery w całym wyrazie są zarezerwowane dla krzyku.
Nagłówki, oznaczenie mówców i znaczniki czasu
Te trzy elementy zamieniają długi blok tekstu w materiał, po którym można się poruszać. Nagłówki pokazują, o czym jest dana część rozmowy, oznaczenie mówców wyjaśnia, czyje to słowa, a znaczniki czasu łączą tekst z konkretnym miejscem nagrania. W3C zaleca wszystkie trzy, przy czym znaczniki czasu tylko tam, gdzie są rzeczywiście przydatne.
Nagłówki
Nagłówków nikt w nagraniu nie wypowiada, więc są dodatkiem redaktora. W3C zachęca do ich stosowania, podobnie jak do wstawiania odnośników, ponieważ ułatwiają korzystanie z zapisu, a przy okazji, jak zaznacza, pomagają w pozycjonowaniu. Dobry nagłówek transkrypcji nazywa temat fragmentu słowami, jakich użyłby czytelnik szukający tej informacji. „Część druga” nie mówi nic, „Ile trwa wymiana pieca gazowego” mówi wszystko. Zasady układania poziomów są takie same jak w każdym innym tekście i opisujemy je we wpisie o nagłówkach H1, H2 i H3.
Oznaczenie mówców
Każda zmiana osoby mówiącej powinna być widoczna. W3C proponuje, aby przy pierwszym wystąpieniu podać pełne imię i nazwisko, a później samo imię albo samo nazwisko, zależnie od stopnia oficjalności. W zapisie rozmowy dwóch osób można wyróżnić pogrubieniem nazwisko gościa, aby czytelnik łatwo odnajdywał odpowiedzi. Osobę, której nie widać w kadrze, warto oznaczyć inaczej, na przykład kursywą. O tym, jak przygotować samą rozmowę, aby potem dobrze się ją spisywało, piszemy we wpisie o wywiadzie na blogu firmowym.
Znaczniki czasu
Znacznik czasu to zapis minuty i sekundy, w której zaczyna się dany fragment. Według W3C w transkrypcji nie musi być tak gęsty jak w napisach i nie wymaga podawania czasu zakończenia. W praktyce wystarcza jeden znacznik przy każdym nagłówku albo przy zmianie tematu. Znacznik przy każdym zdaniu zamienia tekst w tabelę liczb i utrudnia czytanie, zamiast je ułatwiać.
<h3>Ile trwa wymiana pieca gazowego</h3>
<p>[04:10]</p>
<p><strong>Anna Kowalska:</strong> Ile czasu trzeba zarezerwować
na samą wymianę?</p>
<p><strong>Jan Nowak:</strong> Zwykle jeden dzień roboczy.
Jeżeli trzeba przerobić komin, dochodzi drugi.</p>
<p><em>(dzwonek telefonu)</em></p>
<p>[pominięto rozmowę o ustawieniu mikrofonu]</p>
Te same znaczniki czasu można wykorzystać w serwisie wideo. Strona pomocy YouTube o rozdziałach filmu podaje warunki, które musi spełnić lista w opisie filmu, aby serwis utworzył z niej rozdziały: pierwsza sygnatura czasowa ma mieć wartość 00:00, sygnatur musi być co najmniej trzy, mają być ułożone rosnąco, a najkrótszy rozdział trwa co najmniej dziesięć sekund. Listę wpisuje się w YouTube Studio w zakładce „Treści”, po kliknięciu filmu, w polu opisu. Własne rozdziały zastępują te, które serwis utworzyłby automatycznie.
Rozdziały mają też znaczenie dla wyszukiwarki. Google w sprawdzonych metodach dotyczących SEO filmów wyjaśnia, że stara się samodzielnie wykrywać segmenty filmu i pokazywać je jako kluczowe momenty, ale pierwszeństwo daje momentom wskazanym przez właściciela materiału. Przy filmach w YouTube wskazuje się je sygnaturami czasowymi w opisie. Przy filmach osadzonych z własnego serwera służą do tego dane strukturalne, do których wracamy niżej.
Jeśli chcą Państwo zamówić treści SEO, zachęcamy do kontaktu: tel. 222 500 844 lub mailowo: biuro@pozycjonowaniestron.pl
Wymagania dostępności W3C dla materiałów audio i wideo
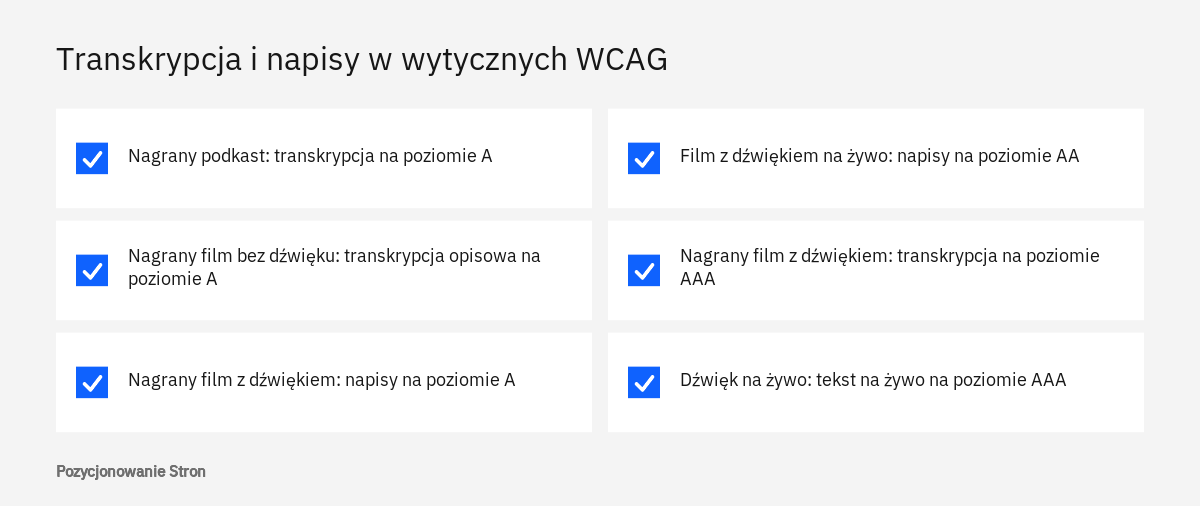
Wytyczne WCAG, czyli opracowany przez W3C zbiór zasad dostępności treści internetowych, uzależniają wymagania od rodzaju materiału: czy jest to sam dźwięk, sam obraz, czy obraz z dźwiękiem, oraz czy materiał jest nagrany wcześniej, czy nadawany na żywo. Wymagania mają trzy poziomy: A jako podstawowy, AA jako pośredni i AAA jako najwyższy. Poniższe zestawienie odtwarza to, co W3C podaje na stronach o transkrypcjach i napisach.
| Rodzaj materiału | Transkrypcja | Napisy |
|---|---|---|
| Sam dźwięk, nagrany wcześniej (podkast) | Wymagana na poziomie A (kryterium 1.2.1) | WCAG ich nie wymaga |
| Sam dźwięk, na żywo | Transkrypcja lub tekst nadawany na żywo na poziomie AAA (1.2.9) | Tekst na żywo na poziomie AAA |
| Sam obraz, nagrany wcześniej | Transkrypcja opisowa albo audiodeskrypcja na poziomie A (1.2.1) | Nie dotyczy, brak dźwięku |
| Film z dźwiękiem, nagrany wcześniej | Poziom AAA (1.2.8) | Wymagane na poziomie A (1.2.2) |
| Film z dźwiękiem, na żywo | Przydatna, lecz niewymagana przez WCAG | Wymagane na poziomie AA (1.2.4) |
Z tabeli wynikają dwa praktyczne wnioski. Firma, która publikuje podkast, powinna zacząć od transkrypcji, bo to ona jest podstawowym wymaganiem dla nagranego dźwięku. Firma, która publikuje filmy z dźwiękiem, powinna zacząć od napisów, a transkrypcję traktować jako kolejny krok. Ponieważ oba materiały powstają z tego samego tekstu, przygotowanie obu wymaga niewiele więcej pracy niż przygotowanie jednego.
Wytyczne W3C są standardem technicznym, a nie przepisem prawa. To, czy i w jakim zakresie dany podmiot ma prawny obowiązek je stosować, zależy od rodzaju organizacji i świadczonych usług, dlatego w razie wątpliwości warto zapytać prawnika.
Plik z napisami jako źródło transkrypcji
Najczęściej używanym w sieci formatem napisów jest według W3C WebVTT, czyli plik tekstowy, w którym każdy napis ma czas wyświetlenia. Obok niego spotyka się formaty SRT i TTML. Plik WebVTT może zawierać oznaczenie mówcy, co ułatwia późniejsze składanie transkrypcji.
WEBVTT

00:04:10.000 --> 00:04:13.500
<v Anna Kowalska>Ile czasu trzeba zarezerwować
na samą wymianę?

00:04:14.000 --> 00:04:17.000
<v Jan Nowak>Zwykle jeden dzień roboczy.
Z takiego pliku powstaje transkrypcja po usunięciu znaczników czasu, połączeniu wierszy w zdania i akapity oraz dopisaniu nagłówków.
Gdzie opublikować transkrypcję i co z niej odczyta wyszukiwarka
Transkrypcja powinna znaleźć się jak najbliżej nagrania. W3C zaleca, aby sam zapis albo odnośnik do niego umieścić tuż przy odtwarzaczu, a w przypadku materiałów na własnej stronie najlepiej na tej samej podstronie, na przykład pod filmem. Dla nagrań przechowywanych w zewnętrznym serwisie dopuszcza osobną podstronę z zapisem. Najgorszym rozwiązaniem jest plik do pobrania ukryty w stopce, o którym odbiorca nie ma szans się dowiedzieć.
Transkrypcja a Google
Dokumentacja Google dotycząca filmów nie wymienia transkrypcji wśród wymagań. Wymienia natomiast warunki, które decydują o tym, czy film w ogóle może pojawić się w wynikach: strona odtwarzania musi być zaindeksowana i dobrze radzić sobie w wyszukiwarce, film musi być na niej umieszczony i nie może być zasłonięty innymi elementami, a miniatura powinna mieć stały adres. Z naszej praktyki wynika, że dobrze zredagowana transkrypcja dostarcza stronie z filmem treści, której wcześniej tam nie było, natomiast nieuporządkowany zapis automatu rzadko komukolwiek służy. Nie należy oczekiwać, że samo wklejenie tekstu pod film zmieni pozycję strony.
W słowniku schema.org dla typu VideoObject, służącego do opisywania filmów w kodzie strony, istnieje właściwość transcript przeznaczona na zapis nagrania dźwiękowego lub filmu. Warto jednak wiedzieć, że dokumentacja Google o znacznikach wideo nie wymienia jej ani wśród właściwości wymaganych, ani zalecanych. Wymagane są trzy: nazwa filmu, adres miniatury i data przesłania.
Bezpośrednie przełożenie na wygląd wyniku mają natomiast znaczniki czasu. Dla filmów spoza YouTube Google opisuje dane strukturalne Clip, w których podaje się nazwę segmentu, sekundę jego początku i adres prowadzący do tego miejsca filmu. Film musi trwać co najmniej trzydzieści sekund, a dwa segmenty na tej samej stronie nie mogą zaczynać się w tym samym momencie. Drugi mechanizm, SeekToAction, pozwala Google samodzielnie wyznaczać momenty na podstawie wzoru adresu, lecz działa tylko w wybranych językach, a polskiego na tej liście nie ma. Wdrożenie takich znaczników należy do zakresu SEO technicznego, a pracę nad widocznością samych filmów opisujemy przy usłudze pozycjonowania w YouTube.
Gotowy, sprawdzony zapis jest też dobrym surowcem dla osobnych tekstów. Załóżmy, że kancelaria z Krakowa nagrywa rozmowę o dziedziczeniu długów. Transkrypcja trafia pod nagranie w całości, a na jej podstawie powstaje tekst poświęcony jednemu zagadnieniu z tej rozmowy, z własnym układem i odnośnikiem do pełnego nagrania. Nagrywanie rozmów jest przy tym wygodnym sposobem pozyskiwania wiedzy od pracowników, o czym piszemy we wpisie o treściach eksperckich.
Typowe pomyłki i sytuacje, w których przydaje się pomoc
Najczęstszą pomyłką jest publikacja surowego wyniku automatu bez odsłuchania. Taki tekst wygląda na gotowy, a zawiera przekręcone nazwiska, zgubione przeczenia i błędne liczby, pod którymi firma podpisuje się własną nazwą.
Druga pomyłka to brak jakiejkolwiek struktury: kilkanaście tysięcy znaków w jednym bloku, bez akapitów, nagłówków i informacji, kto mówi. Trzecia jest jej odwrotnością i polega na zbyt głębokiej redakcji. Redaktor wygładza wypowiedzi, dopisuje wyjaśnienia, skraca odpowiedzi i nadal nazywa wynik transkrypcją, choć jest to już tekst autorski. Osoba, która nie słyszy nagrania, dostaje wówczas inną treść niż osoba, która go słucha.
Czwarta pomyłka dotyczy obrazu. Zapis filmu instruktażowego, w którym brakuje informacji o tym, co widać na ekranie, bywa bezużyteczny, bo prowadzący mówi „tutaj” i „ten przycisk”. Piąta polega na traktowaniu tłumaczenia jako zamiennika napisów: angielskie napisy pod polskim filmem nie pomagają polskiemu widzowi, który nie słyszy.
Pomoc z zewnątrz przydaje się w kilku sytuacjach. Pierwszą jest duże archiwum: kilkadziesiąt odcinków podkastu albo nagrania ze szkoleń, których nikt w firmie nie zdąży odsłuchać. Drugą są treści specjalistyczne, medyczne, prawne lub techniczne, w których błąd w jednym słowie zmienia znaczenie zalecenia. Trzecią jest potrzeba przygotowania na podstawie nagrań pełnych tekstów na stronę, z doborem tematów i układem dopasowanym do tego, czego szukają klienci. Tym zajmujemy się w ramach treści SEO oraz przy prowadzeniu blogów i wideoblogów, gdzie nagranie i tekst planuje się od początku jako dwa uzupełniające się materiały.
Jeśli chcą Państwo zamówić treści SEO, zachęcamy do kontaktu: tel. 222 500 844 lub mailowo: biuro@pozycjonowaniestron.pl
Najczęstsze pytania
Czy napisy automatyczne z YouTube wystarczą jako transkrypcja?
Nie w postaci, w jakiej tworzy je automat. W3C wskazuje, że napisy automatyczne nie są wystarczające, dopóki nie zostanie potwierdzona ich pełna zgodność z nagraniem, a sam YouTube zaleca ich przejrzenie i poprawę. Po korekcie mogą być podstawą zarówno napisów, jak i transkrypcji.
Czy z transkrypcji wolno usunąć „yyy” i powtórzenia?
W większości materiałów publikowanych w sieci tak. W3C dopuszcza pominięcie wypełniaczy, kaszlnięć i urwanych początków zdań, o ile nie zmienia to treści wypowiedzi. Pełny zapis dosłowny jest potrzebny w szczególnych rodzajach treści, takich jak zeznania.
Czy podkast firmowy musi mieć transkrypcję?
W wytycznych WCAG transkrypcja nagranego wcześniej materiału dźwiękowego jest wymaganiem podstawowego poziomu A. To, czy stosowanie wytycznych jest dla danej firmy obowiązkiem prawnym, zależy od jej sytuacji i warto to ustalić z prawnikiem.
Jak często wstawiać znaczniki czasu?
Tylko tam, gdzie pomagają czytelnikowi. W3C podkreśla, że w transkrypcji znaczniki mogą być rzadsze niż w napisach i nie wymagają czasu zakończenia. W praktyce wystarcza jeden przy każdym nagłówku lub przy zmianie tematu.
Czy transkrypcja pod filmem nie będzie powieleniem treści filmu?
Film i jego zapis to ta sama treść w dwóch postaciach, przeznaczona dla różnych odbiorców, a umieszczenie ich na jednej podstronie jest rozwiązaniem zalecanym przez W3C. Tekst napisany na podstawie nagrania powinien natomiast mieć własny zakres i układ.
Czy poprawiać błędy językowe osoby mówiącej?
Według W3C co do zasady nie: transkrypcja nie zmienia wypowiedzi i nie poprawia gramatyki ani pomyłek. Można natomiast dodać w nawiasie kwadratowym brakujące słowo, wyraźnie oznaczone jako dopisek redakcji. Wygładzoną wersję wypowiedzi lepiej opublikować jako osobny tekst.
Źródła
- Transcripts, Web Accessibility Initiative (WAI), W3C
- Captions/Subtitles, Web Accessibility Initiative (WAI), W3C
- Transcribing Audio to Text, Web Accessibility Initiative (WAI), W3C
- Korzystanie z napisów automatycznych, YouTube - Pomoc
- Dodawanie napisów, YouTube - Pomoc
- Rozdziały filmu, YouTube - Pomoc
- Sprawdzone metody dotyczące SEO filmów, Centrum wyszukiwarki Google
- Znaczniki schema.org wideo (VideoObject, Clip, BroadcastEvent), Centrum wyszukiwarki Google
- VideoObject, Schema.org
Funkcje wyszukiwarek i asystentów AI zmieniają się szybko, dlatego wpis aktualizujemy po większych zmianach.