Z punktu widzenia robota Google najbezpieczniejsze są numerowane strony zbudowane ze zwykłych linków, a przycisk doczytywania i nieskończone przewijanie działają poprawnie tylko wtedy, gdy pod spodem istnieją te same, osobne adresy kolejnych części listy. Poniżej wyjaśniamy, czym różnią się trzy rozwiązania, jak ustawić adres kanoniczny kolejnych stron, co zrobić z tekstem kategorii oraz jak samodzielnie ocenić, czy sklep nie ukrywa produktów przed wyszukiwarką.
Trzy sposoby dzielenia listy produktów i czym się różnią
Listę produktów w kategorii można podzielić na trzy sposoby: na numerowane strony, za pomocą przycisku, który doczytuje kolejną porcję, albo przez nieskończone przewijanie, w którym nowe produkty pojawiają się same, gdy klient zbliża się do końca ekranu. Dla kupującego to kwestia wygody. Dla wyszukiwarki to pytanie, czy do produktów z dalszej części listy prowadzi jakakolwiek droga, którą robot potrafi przejść.
Google opisuje wszystkie trzy wzorce w dokumencie o podziale na strony i przyrostowym wczytywaniu stron, który jest częścią zaleceń dla sklepów internetowych. Nie wskazuje w nim jednego zwycięzcy. Wymienia natomiast mocne i słabe strony każdego rozwiązania z perspektywy użytkownika, a osobno tłumaczy, jak każde z nich widzi robot. Poniższa tabela zbiera te uwagi.
| Rozwiązanie | Zalety według Google | Wady według Google | Co widzi robot |
|---|---|---|---|
| Numerowane strony | Klient widzi liczbę wyników i wie, w którym miejscu listy się znajduje. | Treść jest rozbita na wiele stron, a każda kolejna porcja wymaga przeładowania strony. | Osobne adresy połączone linkami, po których robot przechodzi bez przeszkód. |
| Przycisk doczytywania | Wszystko pozostaje na jednej stronie, a przy przycisku można pokazać łączną liczbę wyników. | Nie sprawdza się przy bardzo dużej liczbie wyników, bo wszystkie trafiają na jedną stronę. | Tylko pierwszą porcję, jeśli przycisk nie jest jednocześnie linkiem do kolejnej strony. |
| Nieskończone przewijanie | Wszystko na jednej stronie, obsługa jest intuicyjna. | Może męczyć, nie wiadomo, ile wyników zostało, słabo radzi sobie z dużą liczbą wyników. | Tylko pierwszą porcję, jeśli kolejne części nie mają własnych adresów i linków. |
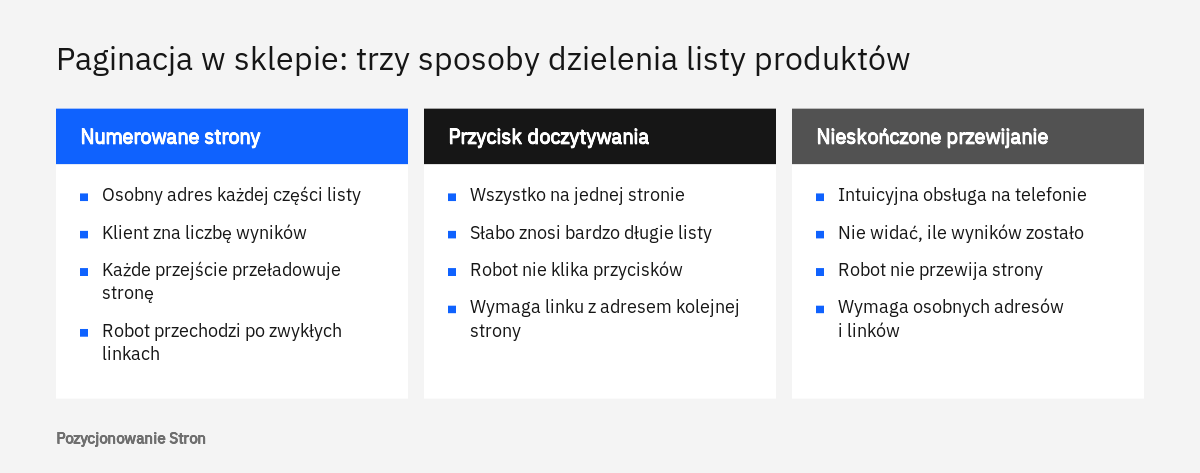
Z tabeli wynika rzecz najważniejsza dla całego tematu: wybór wyglądu listy i sposób, w jaki sklep udostępnia ją robotowi, to dwie osobne decyzje. Sklep z meblami z Poznania może pokazywać klientom wygodny przycisk doczytywania, a jednocześnie mieć w kodzie komplet zwykłych adresów kolejnych stron. Może też mieć klasyczne numerki, które po kliknięciu zmieniają zawartość strony skryptem i nie prowadzą pod żaden nowy adres. W pierwszym przypadku wyszukiwarka dotrze do całego asortymentu, w drugim nie, choć na pierwszy rzut oka wygląda to odwrotnie. Więcej o samym układzie listy piszemy we wpisie o tym, jak zbudować strony kategorii w sklepie.
Jak robot Google przechodzi po liście produktów
Robot Google odkrywa kolejne części listy wyłącznie przez linki, czyli elementy a z atrybutem href, w którym stoi prawdziwy adres. Nie klika przycisków, nie przewija strony i nie wykonuje czynności, które wymagają działania użytkownika. Google pisze o tym wprost w zaleceniach dla sklepów oraz w dokumencie o leniwym ładowaniu treści: wyszukiwarka nie wchodzi w interakcję ze stroną.
Co uznaje się za link czytelny dla robota, opisują sprawdzone metody dotyczące linków. Poprawny jest element a z adresem w atrybucie href, także wtedy, gdy ma dodatkowo podpiętą obsługę kliknięcia przez skrypt. Link wstawiony przez JavaScript również może zostać odczytany, pod warunkiem że w wynikowym kodzie strony ma tę samą postać. Niezalecane są natomiast elementy, które tylko udają link: znacznik span z adresem, element a bez atrybutu href, w którym całą pracę wykonuje zdarzenie kliknięcia, czy adres zaczynający się od słowa javascript.
<!-- poprawnie: zwykły link z prawdziwym adresem -->
<a href="/kategoria/fotele?page=2">Następna strona</a>

<!-- poprawnie: link z adresem, a wygodne doczytywanie obsługuje skrypt -->
<a href="/kategoria/fotele?page=2" onclick="doczytaj(2)">Kolejne produkty</a>

<!-- niezalecane: brak adresu, wszystko robi skrypt -->
<a onclick="doczytaj(2)">Kolejne produkty</a>
<button type="button" onclick="doczytaj(2)">Kolejne produkty</button>
Drugi przykład w ramce pokazuje, że wygoda klienta i potrzeby robota nie muszą się wykluczać. Element wygląda jak przycisk, po kliknięciu doczytuje produkty bez przeładowania, a jednocześnie ma w kodzie adres drugiej strony listy. Robot odczyta adres, człowiek skorzysta z doczytywania.
Google dodaje, że mapa witryny albo plik danych przesłany do Merchant Center pomaga wyszukiwarce znaleźć wszystkie produkty sklepu. To cenne uzupełnienie, ale nie zamiennik linków. Google zaleca, aby każda ważna strona serwisu miała przynajmniej jeden link z innej strony tej samej witryny, a dla produktu, który nie trafił do żadnej promocji, lista w kategorii bywa jedynym takim miejscem. Link przekazuje też tekst odnośnika, który pomaga zrozumieć, co znajduje się na stronie docelowej. Szerzej opisujemy to we wpisie o tym, jak pisać tekst odnośnika zgodnie z zaleceniami Google.
Numerowane strony: jak zbudować adresy i linki
Poprawnie zbudowane numerowane strony spełniają trzy warunki: każda ma własny adres, każda prowadzi zwykłym linkiem do następnej, a z każdej da się wrócić do pierwszej. Tak Google opisuje sekwencyjne łączenie stron w zaleceniach dla sklepów.
Własny adres każdej strony
Google zaleca, aby każda strona listy miała niepowtarzalny adres, na przykład z parametrem zapisanym jako ?page=n, gdzie n to numer strony. Równie dobrze sprawdza się numer w ścieżce adresu, jeśli tak działa oprogramowanie sklepu. Istotne jest to, że wyszukiwarka traktuje takie adresy jako odrębne strony. Druga strona kategorii z fotelami nie jest dla niej dodatkiem do pierwszej, tylko osobnym dokumentem z własną listą produktów.
Numeru strony nie należy zapisywać we fragmencie adresu, czyli w części po znaku krzyżyka. Google ignoruje fragmenty, więc adres z dopiskiem po krzyżyku jest dla niego tym samym adresem co pierwsza strona, a link do niego może zostać pominięty. W praktyce agencji taki zapis spotykamy w sklepach, w których lista jest wymieniana skryptem. Klient widzi zmieniające się numerki, a robot wciąż jedną i tę samą stronę.
Linki do następnej i do pierwszej strony
Każda strona listy powinna zawierać link do strony następnej, zapisany jako zwykły element a z atrybutem href. To minimum, które pozwala robotowi przejść całą sekwencję po kolei. Numery kilku sąsiednich stron i link do ostatniej skracają tę drogę, co ma znaczenie w kategoriach liczących kilkadziesiąt stron: produkt z końca listy nie powinien wymagać od robota kilkudziesięciu przejść.
Google radzi też, aby na wszystkich stronach kolekcji umieścić link prowadzący z powrotem do pierwszej strony. Taki link pokazuje wyszukiwarce, gdzie kolekcja się zaczyna, dzięki czemu pierwsza strona może być lepszym celem wyszukiwania niż pozostałe. W sklepie rolę tę zwykle pełni numer jeden w nawigacji stronicowania oraz okruszki, czyli ścieżka nawigacyjna z nazwą kategorii. Warto dopilnować, by oba elementy prowadziły do czystego adresu kategorii, a nie do jego kopii z dopiskiem ?page=1. W przeciwnym razie pierwsza strona istnieje pod dwoma adresami.
Znaczniki rel next i rel prev
Google nie korzysta już ze znaczników link z atrybutami rel next i rel prev, którymi dawniej oznaczało się sąsiednie strony sekwencji. W dokumentacji zaznaczono, że inne wyszukiwarki nadal mogą z nich korzystać. Nie ma więc powodu, by usuwać je ze sklepu, ale nie należy też liczyć na to, że zastąpią linki widoczne w treści strony. Jeśli w kodzie są takie znaczniki, a w treści nie ma ani jednego zwykłego linku do drugiej strony, dla Google lista kończy się na pierwszej porcji produktów.
Adres kanoniczny kolejnych stron listy
Każda strona listy powinna wskazywać jako kanoniczny własny adres. Google pisze o tym jednoznacznie: pierwszej strony sekwencji nie należy ustawiać jako kanonicznej dla pozostałych, a każda strona ma mieć własny adres kanoniczny.
Adres wskazany wyszukiwarce jako główna wersja strony, gdy ta sama lub bardzo podobna treść jest dostępna pod kilkoma adresami. Najczęściej zapisuje się go w nagłówku strony jako element link z atrybutem rel o wartości canonical.
Skąd bierze się pokusa, by wszystkie strony kierować na pierwszą? Z obawy przed powielaniem treści i z chęci skupienia całej siły kategorii w jednym adresie. Tyle że druga strona listy nie jest kopią pierwszej. Zawiera inne produkty. Wskazanie pierwszej strony jako kanonicznej to komunikat, że dalsze strony są jej duplikatami i można je pominąć. Jeśli wyszukiwarka go posłucha, linki do produktów z dalszych stron przestaną być dla niej punktem odniesienia. Jeśli nie posłucha, w Search Console pojawi się rozbieżność między adresem zadeklarowanym a wybranym przez Google.
<!-- strona: https://example.com/kategoria/fotele?page=2 -->

<!-- poprawnie: strona wskazuje samą siebie -->
<link rel="canonical" href="https://example.com/kategoria/fotele?page=2">

<!-- błędnie: druga strona udaje kopię pierwszej -->
<link rel="canonical" href="https://example.com/kategoria/fotele">
Dokument Google o określaniu strony kanonicznej zawiera kilka zasad, które przy stronicowaniu łatwo złamać. Adres kanoniczny powinien być bezwzględny, czyli pełny, z protokołem i domeną. Strona kanoniczna powinna wskazywać samą siebie. Linki wewnętrzne powinny prowadzić do wersji kanonicznej. Sygnały nie mogą sobie przeczyć, więc w mapie witryny nie powinien stać inny adres niż w elemencie canonical tej samej strony. W sklepach budowanych w całości na skryptach adres kanoniczny warto umieścić w kodzie źródłowym i nie zmieniać go później JavaScriptem.
Czy dalsze strony listy powinny w ogóle trafiać do indeksu? Zalecenia Google nie każą ich z niego wyłączać. Mówią o osobnych adresach, własnych adresach kanonicznych i o tym, że robot sam stara się rozpoznać strony należące do sekwencji i odpowiednio je obsłużyć. Rolą dalszych stron nie jest zdobywanie ruchu z wyszukiwarki, tylko doprowadzenie robota do produktów. Jeśli w wynikach wyszukiwania częściej pojawia się trzecia strona kategorii niż pierwsza, zwykle warto przyjrzeć się linkom do pierwszej strony i samej treści kategorii, a nie blokować stronę trzecią.
Jeśli chcą Państwo zamówić SEO techniczne, zachęcamy do kontaktu: tel. 222 500 844 lub mailowo: biuro@pozycjonowaniestron.pl
Przycisk doczytywania i nieskończone przewijanie: jak je zbudować, by Google widział całą listę
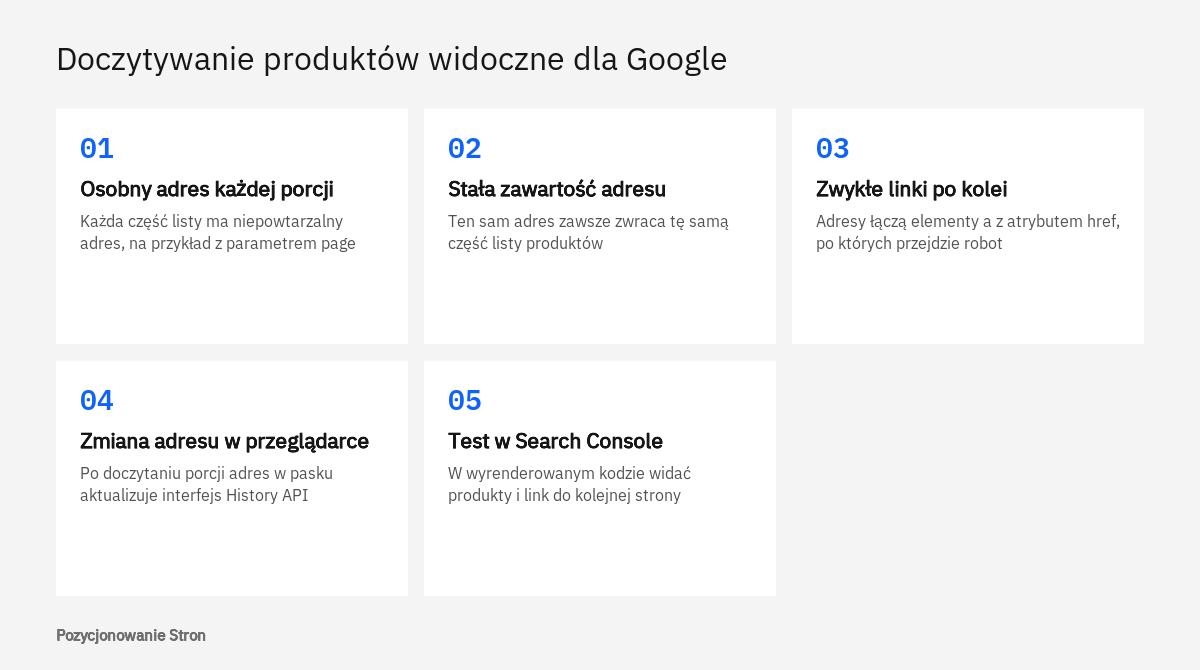
Przycisk doczytywania i nieskończone przewijanie są bezpieczne dla widoczności sklepu tylko wtedy, gdy każda doczytywana porcja produktów ma własny adres i gdy do tych adresów prowadzą zwykłe linki. Oba rozwiązania działają zwykle w oparciu o JavaScript i wymagają czynności użytkownika, a tej robot nie wykona.
Zasady opisuje dokument Google o naprawianiu leniwie ładującej się zawartości, w części poświęconej nieskończonemu przewijaniu. Ich sens jest prosty: wygodny mechanizm dla klienta ma być nakładką na zwykłą listę podzieloną na strony, a nie jej zamiennikiem.
- Osobny adres dla każdej porcji
Każda część listy otrzymuje niepowtarzalny adres, na przykład z parametrem page. Adres wpisany bezpośrednio w przeglądarce otwiera stronę z tą właśnie porcją produktów.
- Stała zawartość pod adresem
Ten sam adres zawsze zwraca tę samą część listy. Google zaleca bezwzględne numery stron, takie jak ?page=12, a nie wartości względne, liczone na przykład od wczorajszej daty.
- Linki łączące adresy po kolei
Poszczególne adresy są połączone zwykłymi linkami, aby robot mógł znaleźć cały zestaw. Przycisk doczytywania może być takim linkiem, jeśli w kodzie jest elementem a z adresem następnej strony.
- Aktualizacja adresu w przeglądarce
Gdy doczytana porcja staje się główną treścią widoczną na ekranie, adres w pasku przeglądarki zmienia się za pomocą interfejsu History API. Klient może wtedy odświeżyć stronę, przesłać link znajomemu albo wrócić z karty produktu w to samo miejsce.
- Test w Search Console
Po wdrożeniu należy ocenić w narzędziu do sprawdzania adresów URL, czy w wyrenderowanym kodzie strony znajdują się produkty i linki do kolejnych porcji.
Weźmy sklep z odzieżą dziecięcą z Łodzi, który po zmianie szablonu zastąpił numerki nieskończonym przewijaniem. Jeśli nowy szablon doczytuje produkty zapytaniem w tle i nie zostawia w kodzie żadnych linków do kolejnych stron, robot widzi w każdej kategorii tylko pierwszą porcję, powiedzmy pierwsze kilkadziesiąt produktów. Pozostałe są osiągalne dla niego wyłącznie przez mapę witryny albo przypadkowe linki z innych miejsc. Sklep działa, klienci kupują, a część asortymentu traci jedyne stałe linki wewnętrzne.
Tekst kategorii, tytuły i opisy na dalszych stronach
Tekst kategorii najrozsądniej pokazywać w całości tylko na pierwszej stronie listy, a na kolejnych zostawić nagłówek, okruszki i produkty. To zalecenie wynikające z praktyki agencji, a nie z dokumentacji Google, która o opisie kategorii na dalszych stronach nie mówi nic. Wynika ono jednak wprost z tego, co Google mówi o samych stronach: są traktowane jako odrębne dokumenty, a pierwsza z nich ma być najlepszym celem wyszukiwania.
Jeśli ten sam opis o długości kilku akapitów powtarza się na dwudziestu stronach kategorii, każda z nich zawiera identyczny blok tekstu i różni się jedynie listą produktów. Wyszukiwarka dostaje dwadzieścia dokumentów, które na pytanie o fotele biurowe odpowiadają tymi samymi słowami. Gdy opis zostaje wyłącznie na pierwszej stronie, sygnał jest czytelny: to ona opisuje kategorię, a kolejne służą do przeglądania asortymentu. Zyskuje także klient, który na czwartej stronie listy nie musi przewijać tego samego wstępu. O długości i miejscu samego tekstu piszemy osobno we wpisie o tym, jak przygotować opis kategorii w sklepie.
Tytuły i opisy meta kolejnych stron
Tytuły i opisy meta kolejnych stron listy mogą być takie same jak na pierwszej. Google zaznacza, że zwykle zaleca niepowtarzalne tytuły, ale w przypadku stron sekwencji nie jest to konieczne, ponieważ robot stara się sam rozpoznać, że należą do jednej kolekcji. Dopisywanie numeru strony do tytułu nie jest więc wymogiem. W praktyce agencji bywa jednak przydatne z powodów porządkowych: w raportach Search Console i w statystykach łatwiej wtedy odróżnić strony od siebie. Jak ułożyć wzorce tytułów dla całego asortymentu, opisujemy we wpisie o szablonach tytułów i meta opisów w sklepie.
Sortowanie, filtry i liczba produktów na stronie
Warianty tej samej listy powstające przez sortowanie i filtrowanie warto wyłączyć z indeksu, bo w połączeniu ze stronicowaniem mnożą adresy w tempie, którego nie widać w panelu sklepu. Google podaje przykład parametru ?order=price: lista zawiera te same produkty, tylko w innej kolejności.
Prosty rachunek pokazuje skalę. Kategoria ma dziesięć stron. Klient może sortować ją na cztery sposoby i wybrać trzy różne liczby produktów na stronie. Z jednej listy robi się ponad sto adresów z tym samym asortymentem, a każdy filtr koloru czy rozmiaru mnoży tę liczbę dalej. Google wskazuje dwa sposoby zapobiegania indeksowaniu takich wariantów: regułę noindex w metatagu robots albo zablokowanie wzorców adresów w pliku robots.txt.
<!-- metatag robots w nagłówku strony z sortowaniem -->
<meta name="robots" content="noindex">

# albo reguły w pliku robots.txt
User-agent: *
Disallow: /*?order=
Disallow: /*&order=
Obu metod nie należy stosować jednocześnie dla tych samych adresów. Z dokumentu Google o blokowaniu indeksowania za pomocą tagu noindex wynika, że robot musi móc odwiedzić stronę, aby zobaczyć regułę noindex. Jeśli adres jest zablokowany w robots.txt, reguła pozostaje nieodczytana, a strona może nadal pojawiać się w wynikach, na przykład z powodu linków z innych witryn. Szerzej omawiamy to we wpisach o tym, które kombinacje filtrów pokazać Google, oraz o tym, których serwisów dotyczy budżet indeksowania.
Blokada ma obejmować sortowanie i filtry, a nie sam parametr numeru strony. Zdarza się, że jedna zbyt szeroka reguła w robots.txt, zakazująca wszystkich adresów ze znakiem zapytania, odcina robota od drugiej i kolejnych stron każdej kategorii. To jedna z pierwszych rzeczy, które oceniamy podczas prac nad pozycjonowaniem sklepów.
Jak ocenić stronicowanie sklepu w Search Console
Stan stronicowania najpewniej pokazuje narzędzie do sprawdzania adresów URL w Google Search Console, uzupełnione raportem Indeksowanie stron. Pierwsze odpowiada na pytanie, co robot widzi na konkretnej stronie listy, drugie pokazuje skalę zjawiska w całym sklepie.
Narzędzie do sprawdzania adresów URL
Zgodnie z pomocą Search Console narzędzie uruchamia się przez wpisanie pełnego adresu w pasku wyszukiwania u góry ekranu. Adres musi należeć do otwartej usługi. Warto zacząć od adresu drugiej strony dużej kategorii. W wynikach istotne są cztery pola. Pole Adres kanoniczny określony przez użytkownika pokazuje, co sklep zadeklarował, i przy poprawnym wdrożeniu powinien tam stać adres drugiej strony, a nie pierwszej. Pole Adres kanoniczny wybrany przez Google pokazuje, którą wersję wyszukiwarka uznała za główną. Pole Strona odsyłająca wskazuje stronę, przez którą Google najprawdopodobniej odkrył adres, a pole Mapy witryn informuje, czy adres znajduje się w przesłanej mapie.
Następnie warto uruchomić test wersji opublikowanej, do czego służy przycisk o nazwie mówiącej o sprawdzeniu adresu URL wersji opublikowanej. Po zakończeniu testu opcja Wyświetl przetestowaną stronę otwiera szczegóły: zwrócony kod HTML oraz kartę Zrzut ekranu. W kodzie należy wyszukać dwie rzeczy. Po pierwsze nazwy produktów z dalszej części listy, co pokazuje, ile porcji robot faktycznie otrzymał. Po drugie adres kolejnej strony, czyli fragment z parametrem page i następnym numerem. Jeśli adres ten występuje w atrybucie href elementu a, robot ma dokąd pójść. Jeśli nie ma go wcale albo stoi wyłącznie w kodzie skryptu, lista kończy się dla Google w tym miejscu.
Raport Indeksowanie stron
Raport Indeksowanie stron pokazuje, z jakich powodów adresy sklepu nie trafiły do indeksu. Przy stronicowaniu znaczenie mają zwłaszcza trzy statusy opisane w pomocy dotyczącej tego raportu. Status Duplikat, wyszukiwarka Google wybrała inną stronę kanoniczną niż użytkownik oznacza, że deklaracja sklepu nie została przyjęta. Jeśli widnieją pod nim dalsze strony kategorii, warto porównać ich treść z pierwszą stroną: być może różnią się zbyt mało. Status URL zawiera tag noindex pozwala wychwycić strony listy wyłączone z indeksu przez ustawienia szablonu lub wtyczki. Status URL zablokowany przez plik robots.txt ujawnia zbyt szerokie reguły.
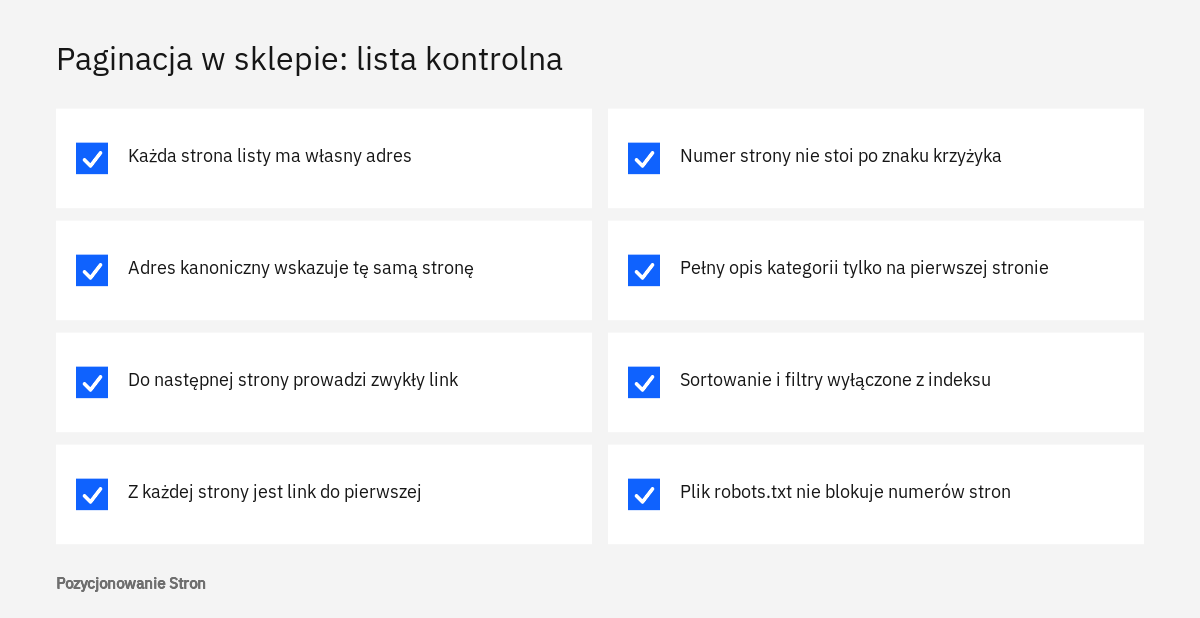
- Druga strona kategorii otwiera się pod własnym adresem wpisanym bezpośrednio w przeglądarce.
- Adres kanoniczny drugiej strony wskazuje ją samą, w pełnej postaci z protokołem i domeną.
- W wyrenderowanym kodzie pierwszej strony jest element a z atrybutem href prowadzącym do strony następnej.
- Z każdej strony listy prowadzi link do pierwszej strony, a ten link nie zawiera dopisku z numerem jeden.
- Numer strony nie jest zapisany po znaku krzyżyka.
- Pełny opis kategorii wyświetla się tylko na pierwszej stronie.
- Adresy z sortowaniem i filtrami mają regułę noindex albo blokadę w robots.txt, ale nie obie naraz.
- Reguły w robots.txt nie obejmują parametru numeru strony.
- Mapa witryny zawiera wszystkie produkty przeznaczone do indeksu.
Typowe pomyłki i kiedy potrzebna jest pomoc specjalisty
Najczęstsze pomyłki przy dzieleniu listy produktów mają wspólne źródło: stronicowanie traktuje się jako element wyglądu, a nie nawigacji dla robota. Większość z nich powstaje przy zmianie szablonu lub instalacji dodatku do doczytywania produktów i przez długi czas pozostaje niezauważona, bo sklep z punktu widzenia klienta działa bez zarzutu.
Do najczęstszych należą: adres kanoniczny wszystkich stron listy skierowany na stronę pierwszą, przycisk doczytywania zbudowany jako element button albo link bez adresu, numer strony zapisany po znaku krzyżyka oraz poleganie na znacznikach rel next i rel prev, z których Google już nie korzysta. Równie często spotykamy pełny opis kategorii powielony na każdej stronie, pierwszą stronę dostępną pod dwoma adresami, czystym i z dopiskiem ?page=1, a także brak ograniczeń dla sortowania, przez co każda kategoria istnieje w kilku kolejnościach. Najbardziej dotkliwa jest reguła w robots.txt, która przy okazji blokowania filtrów zamyka robotowi drogę do dalszych stron.
Kiedy samodzielna kontrola nie wystarcza? Wtedy, gdy sklep ma kilka tysięcy produktów i rozbudowane filtry, gdy lista jest w całości tworzona skryptem po stronie przeglądarki, gdy w raporcie Indeksowanie stron przybywa adresów z parametrami albo gdy po zmianie szablonu spada liczba zindeksowanych kart produktów. W takich sytuacjach potrzebna jest analiza kodu, plików konfiguracyjnych i danych z Search Console jednocześnie, a poprawki wymagają pracy programisty według dokładnej specyfikacji. Tym zajmuje się u nas SEO techniczne, a pełny przegląd sklepu, obejmujący także treści i linki, wchodzi w zakres usługi kompleksowy audyt SEO. Poprawne stronicowanie nie daje gwarancji pozycji, usuwa natomiast przeszkodę, przez którą część asortymentu w ogóle nie bierze udziału w wyszukiwaniu.
Jeśli chcą Państwo zamówić SEO techniczne, zachęcamy do kontaktu: tel. 222 500 844 lub mailowo: biuro@pozycjonowaniestron.pl
Najczęstsze pytania
Które rozwiązanie jest najlepsze dla pozycjonowania sklepu?
Google nie wskazuje jednego najlepszego wzorca. Dla robota liczy się to, czy każda część listy ma własny adres i czy prowadzą do niej zwykłe linki. Numerowane strony spełniają ten warunek najprościej, a przycisk i nieskończone przewijanie wymagają dodatkowej pracy programisty.
Czy dalsze strony kategorii powinny mieć znacznik noindex?
Zalecenia Google dotyczące stronicowania tego nie wymagają. Mówią o osobnych adresach i własnych adresach kanonicznych kolejnych stron. Regułę noindex Google zaleca dla wariantów sortowania i filtrowania tej samej listy.
Czy adres kanoniczny drugiej strony może wskazywać pierwszą stronę kategorii?
Nie powinien. Google wprost odradza ustawianie pierwszej strony sekwencji jako kanonicznej dla pozostałych. Każda strona listy zawiera inne produkty, więc wskazuje jako kanoniczny własny adres.
Czy znaczniki rel next i rel prev są jeszcze potrzebne?
Google już z nich nie korzysta, choć według dokumentacji inne wyszukiwarki nadal mogą. Można je zostawić, ale nie zastąpią zwykłych linków do następnej i poprzedniej strony widocznych w treści.
Czy mapa witryny wystarczy, jeśli sklep ma nieskończone przewijanie bez linków?
Mapa witryny i plik danych w Merchant Center pomagają Google znaleźć produkty, i Google sam je w tym kontekście wymienia. Nie zastępują jednak linków wewnętrznych z kategorii, które pokazują, do jakiej grupy produkt należy. Bezpieczniej jest zapewnić jedno i drugie.
Czy tytuł każdej strony listy musi być inny?
Nie musi. Google dopuszcza te same tytuły i opisy na wszystkich stronach sekwencji, bo stara się sam rozpoznać, że tworzą jedną kolekcję. Numer strony w tytule można dopisać dla porządku w raportach.
Źródła
- Sprawdzone metody dotyczące podziału na strony, Centrum wyszukiwarki Google
- Sprawdzone metody dotyczące linków w Google, Centrum wyszukiwarki Google
- Naprawianie leniwie ładującej się zawartości witryny, Centrum wyszukiwarki Google
- Jak określić stronę kanoniczną za pomocą rel="canonical" i innych metod, Centrum wyszukiwarki Google
- Blokowanie indeksowania przez wyszukiwarki za pomocą tagu noindex, Centrum wyszukiwarki Google
- Narzędzie do sprawdzania adresów URL, Pomoc Search Console
- Raport Indeksowanie stron, Pomoc Search Console
Funkcje wyszukiwarek i asystentów AI zmieniają się szybko, dlatego wpis aktualizujemy po większych zmianach.