Wyszukiwarka Google pracuje w trzech etapach: najpierw robot pobiera stronę, potem system analizuje jej treść i zapisuje ją w indeksie, a na końcu dobiera wyniki do konkretnego zapytania. Strona może odpaść na każdym z tych etapów i za każdym razem oznacza to inny problem oraz inną naprawę. Poniżej opisujemy każdy etap językiem właściciela firmy i pokazujemy, w których raportach Search Console widać, gdzie strona się zatrzymała.
Trzy etapy pracy wyszukiwarki w jednym obrazie
Zanim strona firmy pojawi się komuś na ekranie, musi przejść trzy kolejne etapy: skanowanie, indeksowanie i wyświetlanie wyników. Tak opisuje to sam Google na stronie Jak działa wyszukiwarka Google i od razu zastrzega, że nie każda strona pokonuje całą drogę. Zrozumienie tej kolejności porządkuje myślenie o widoczności: zamiast pytać ogólnie, dlaczego strony nie ma w Google, można zapytać, na którym etapie się zatrzymała.
Pobieranie tekstu, obrazów i filmów ze stron internetowych przez automatyczne programy nazywane robotami.
Analiza pobranej treści i zapisanie informacji o niej w indeksie Google, czyli w bardzo dużej bazie danych.
Dobieranie z indeksu stron pasujących do zapytania, które wpisał użytkownik, i ułożenie ich w kolejności.
W tej samej dokumentacji znajdują się dwa zastrzeżenia, o których warto wiedzieć przed rozmową z jakimkolwiek wykonawcą. Po pierwsze Google nie przyjmuje płatności za częstsze skanowanie witryny ani za wyższe miejsce w wynikach. Po drugie nie gwarantuje, że dana strona zostanie przeskanowana, zindeksowana lub wyświetlona, nawet jeżeli spełnia podstawowe zasady dotyczące wyszukiwarki. Z tego powodu uczciwa rozmowa o widoczności dotyczy usuwania przeszkód i podnoszenia jakości, a nie obietnic konkretnego miejsca.
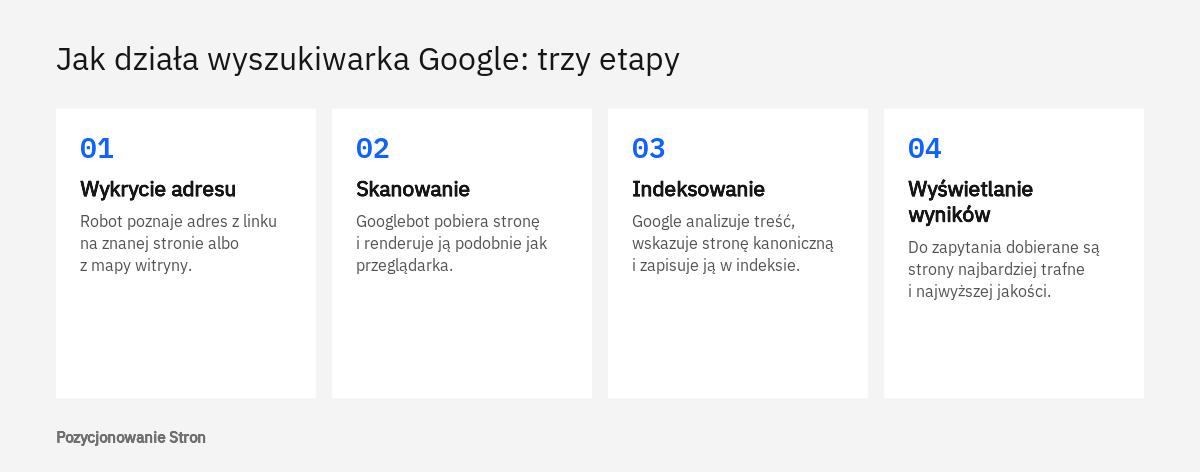
Kolejność etapów ma praktyczne znaczenie. Strona, której robot nie pobrał, nie może trafić do indeksu. Strona, której nie ma w indeksie, nie może się wyświetlić. Dlatego diagnozę zawsze prowadzi się od początku drogi: najpierw dostęp robota, potem obecność w indeksie, a dopiero na końcu pozycje i kliknięcia. Odwrócenie tej kolejności kończy się zwykle poprawianiem tekstów na stronie, której Google w ogóle nie odwiedził.
Skanowanie: jak robot trafia na adres strony
Robot Google trafia na nowy adres na dwa główne sposoby: przechodzi po linku umieszczonym na stronie, którą już zna, albo odczytuje adres z mapy witryny przesłanej przez właściciela. Dokumentacja wyjaśnia, że nie istnieje żaden centralny rejestr wszystkich stron w internecie, więc Google musi stale szukać stron nowych i zaktualizowanych. Ten wstępny krok nosi nazwę wykrywania adresów URL.
Przykład z dokumentacji jest bardzo codzienny: strona kategorii bloga zawiera link do nowego wpisu, robot odwiedza kategorię i w ten sposób dowiaduje się o istnieniu wpisu. W firmie wygląda to podobnie. Hydraulik z Łodzi, który dopisał podstronę o udrażnianiu kanalizacji, ale nie umieścił do niej odnośnika w menu ani na stronie z usługami, zostawił robotowi bardzo mało szans na jej znalezienie. Strona istnieje, działa po wpisaniu adresu, a mimo to z punktu widzenia wyszukiwarki pozostaje ukryta.
Googlebot i tempo wizyt
Program, który pobiera strony, nazywa się Googlebot. Dokumentacja opisuje, że to on na podstawie algorytmów ustala, które witryny odwiedzić, jak często to robić i ile stron pobrać z każdej z nich. Roboty są przy tym zaprogramowane tak, aby nie przeciążać serwera. Reagują na jego odpowiedzi: gdy witryna zwraca błędy z grupy 500, robot zwalnia. Wolny lub niestabilny serwer ogranicza więc liczbę stron, które Google jest w stanie pobrać w danym czasie. Dla niewielkiej strony firmowej rzadko bywa to kłopotem, natomiast w dużych sklepach staje się osobnym zagadnieniem, które opisaliśmy we wpisie o budżecie indeksowania.
Renderowanie, czyli strona widziana jak w przeglądarce
Po pobraniu adresu Google renderuje stronę, to znaczy uruchamia znaleziony na niej kod JavaScript w aktualnej wersji przeglądarki Chrome, podobnie jak robi to przeglądarka zwykłego użytkownika. Dokumentacja podkreśla, że ma to duże znaczenie, ponieważ wiele serwisów doczytuje treść właśnie za pomocą JavaScriptu i bez renderowania Google mógłby jej nie zauważyć. W praktyce oznacza to, że opis usługi lub lista produktów, które pojawiają się dopiero po zadziałaniu skryptu, są zależne od tego, czy skrypt i potrzebne mu pliki są dla robota dostępne.
Mapa witryny jako podpowiedź
Mapa witryny to plik z listą adresów, które właściciel uważa za ważne. Według strony Informacje o mapach witryn przydaje się ona szczególnie w serwisach dużych, w nowych witrynach, do których prowadzi niewiele linków z zewnątrz, oraz tam, gdzie jest dużo filmów i obrazów. Ta sama strona podaje, że mapa może nie być potrzebna w małej witrynie, czyli liczącej do 500 stron przeznaczonych do wyników, o ile wszystkie ważne podstrony są dobrze połączone linkami. Mapa pomaga rozpoznać adresy, ale nie daje gwarancji, że wszystkie zostaną przeskanowane i zindeksowane. Systemy takie jak WordPress zwykle tworzą ją automatycznie.
Co zatrzymuje robota jeszcze przed pobraniem strony
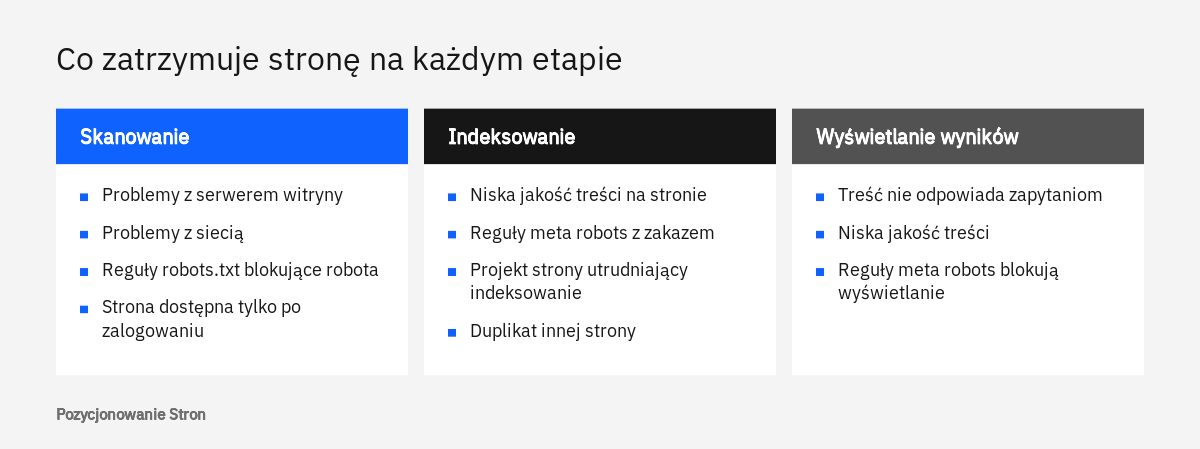
Robota zatrzymują trzy grupy przyczyn wymienione w dokumentacji: problemy z serwerem obsługującym witrynę, problemy z siecią oraz reguły w pliku robots.txt, które zabraniają Googlebotowi dostępu. Do tego dochodzą strony widoczne dopiero po zalogowaniu, do których robot nie ma jak wejść. Każda z tych sytuacji oznacza, że treść w ogóle nie dotarła do Google, więc dalsze etapy nie mają na czym pracować.
Plik robots.txt i jego właściwa rola
Plik robots.txt informuje roboty, do których adresów w witrynie mogą sięgać. Strona Plik robots.txt - wprowadzenie i przewodnik wyjaśnia, że służy on przede wszystkim do tego, aby żądania robotów nie przeciążały serwera, i wprost zaznacza, że nie jest to sposób na ukrycie strony przed Google. Adres zablokowany w tym pliku nadal może pojawić się w wynikach, jeżeli prowadzą do niego linki z innych miejsc, tyle że bez opisu. Ta sama strona ostrzega przed blokowaniem skryptów, stylów i obrazów, jeśli ich brak utrudnia zrozumienie strony.
User-agent: *
Disallow: /koszyk/

Sitemap: https://www.przyklad.pl/sitemap.xml
Najgroźniejsza pomyłka wygląda niewinnie. Podczas budowy nowej wersji serwisu wykonawca zamyka wersję roboczą przed robotami jedną regułą obejmującą całą witrynę, a po uruchomieniu nikt tej reguły nie zdejmuje. Sklep z Poznania może w takiej sytuacji działać bez zarzutu dla klientów, przyjmować zamówienia z reklam i jednocześnie tygodniami tracić widoczność, ponieważ robot grzecznie stosuje się do zakazu.
Serwer, sieć i strony za logowaniem
Druga grupa przyczyn dotyczy techniki. Jeżeli serwer odpowiada błędem albo nie odpowiada wcale, robot nie pobierze treści, a przy powtarzających się błędach ograniczy liczbę wizyt. Trzecia grupa to treści zamknięte: cennik dostępny po zalogowaniu, strefa klienta, materiały dla partnerów. Dokumentacja wymienia konieczność logowania jako jeden z powodów, dla których wykryta strona nie zostaje przeskanowana. Jest to stan pożądany, o ile zamknięte są rzeczywiście te strony, które miały być zamknięte.
Indeksowanie: co trafia do indeksu, a co zostaje poza nim
Do indeksu trafia strona, którą Google pobrał, zrozumiał i uznał za wartą zapisania, przy czym z grupy podobnych adresów zapisywana jest jedna wersja uznana za najbardziej reprezentatywną. Na tym etapie system analizuje tekst, zawartość znacznika tytułu, teksty alternatywne obrazów, same obrazy, filmy i pozostałe elementy, aby ustalić, czego strona dotyczy. Dokumentacja mówi jasno, że indeksowanie nie jest gwarantowane i nie każda przetworzona strona zostaje zapisana.
Strona kanoniczna i jej duplikaty
W trakcie indeksowania Google ustala, czy dana strona nie powiela innej strony z internetu. Podobne adresy łączy w grupę, którą dokumentacja nazywa klastrem, i wskazuje w niej stronę kanoniczną, czyli tę, która może być pokazywana w wynikach. Pozostałe adresy z grupy są wersjami alternatywnymi i mogą być wyświetlane w innych okolicznościach, na przykład użytkownikowi telefonu. O stronie kanonicznej i jej grupie Google zbiera dodatkowe sygnały, między innymi język strony, kraj, dla którego przeznaczona jest treść, oraz łatwość korzystania ze strony.
Dla właściciela firmy najważniejszy wniosek jest taki, że ten sam tekst dostępny pod kilkoma adresami nie daje kilku miejsc w wynikach. Sklep, w którym ta sama lista produktów otwiera się pod adresem kategorii, pod adresem z sortowaniem i pod adresem z filtrem, ma z punktu widzenia Google jedną treść i kilka jej kopii. Według strony o określaniu kanonicznego adresu URL właściciel może zasugerować, który adres jest główny. Wyraźnym sygnałem jest przekierowanie oraz element rel="canonical", słabszym obecność adresu w mapie witryny. Bez takiej podpowiedzi decyzję podejmie Google.
<link rel="canonical" href="https://www.przyklad.pl/uslugi/hydraulik-lodz/" />

<meta name="robots" content="noindex">
Co przeszkadza w indeksowaniu
Dokumentacja wymienia trzy typowe przeszkody: niską jakość treści na stronie, reguły meta robots, które zabraniają indeksowania, oraz projekt witryny utrudniający indeksowanie. Pierwsza jest najtrudniejsza do przyjęcia, ponieważ nie da się jej naprawić jednym przełącznikiem. Podstrona z dwoma zdaniami opisu, strona miasta różniąca się od dwudziestu innych tylko nazwą miejscowości albo karta produktu z samym zdjęciem i ceną mogą zostać pobrane i mimo to pominięte.
Druga przeszkoda bywa czysto techniczna. Reguła noindex, opisana na stronie o blokowaniu indeksowania, to znacznik w kodzie strony albo nagłówek odpowiedzi serwera. Gdy robot go odczyta, strona zostaje usunięta z wyników, nawet jeśli prowadzą do niej linki z innych witryn. Warunkiem jest dostęp robota do strony, dlatego adres z regułą noindex nie może być jednocześnie zablokowany w robots.txt. W systemach do zarządzania treścią taki znacznik często ustawia się jednym polem wyboru i równie łatwo o nim zapomnieć. Celowe wyłączanie stron z wyników omawiamy osobno we wpisie o usuwaniu strony z wyników Google.
Jeśli chcą Państwo zamówić pozycjonowanie strony, zachęcamy do kontaktu: tel. 222 500 844 lub mailowo: biuro@pozycjonowaniestron.pl
Wyświetlanie: z czego składany jest wynik dla konkretnego zapytania
Wynik jest składany w chwili, gdy użytkownik wpisuje zapytanie: system przeszukuje indeks w poszukiwaniu pasujących stron i zwraca te, które uznaje za najwyższej jakości i najbardziej trafne. Dokumentacja podaje, że trafność zależy od setek czynników, a wśród nich wymienia lokalizację użytkownika, jego język oraz urządzenie. Podany tam przykład dotyczy zapytania o naprawę rowerów, które da inne wyniki osobie w Warszawie, a inne osobie w Hongkongu.
Z tego opisu wynikają dwie rzeczy ważne dla firmy. Pierwsza: nie istnieje jedna lista wyników wspólna dla wszystkich. Kancelaria z Krakowa oglądana z biura w Krakowie i z telefonu klienta w Gdańsku może zajmować inne miejsca. Druga: kolejność ustalają algorytmy. Google zaznacza, że nie przyjmuje płatności za wyższą pozycję, a reklamy są w wynikach oddzielone od wyników organicznych. O tym, które sygnały są potwierdzone, piszemy we wpisie o czynnikach rankingowych Google.
Różne zapytania, różny wygląd strony wyników
Od zapytania zależy także to, jakie elementy pojawią się na stronie wyników. Według dokumentacji zapytanie o naprawę rowerów pokaże raczej wyniki lokalne, natomiast zapytanie o nowoczesny rower częściej pokaże obrazy. Strona firmy konkuruje więc nie tylko z innymi stronami, lecz także z mapą, obrazami, filmami i innymi blokami. Ich przegląd znajduje się we wpisie o tym, z czego składa się strona wyników Google.
Strona zindeksowana, ale niewidoczna
Obecność w indeksie nie oznacza obecności w wynikach. Dokumentacja opisuje sytuację, w której Search Console pokazuje stronę jako zindeksowaną, a mimo to nie widać jej w wyszukiwarce, i podaje trzy możliwe powody: treść strony nie odpowiada zapytaniom użytkowników, jakość treści jest niska albo reguły meta robots zapobiegają wyświetlaniu. Pierwszy powód spotykamy w małych firmach bardzo często. Strona opisuje usługę językiem branży, a klienci szukają jej zupełnie innymi słowami, więc system nie ma podstaw, aby połączyć jedno z drugim.
Na którym etapie strona najczęściej odpada
Etap, na którym strona odpadła, da się rozpoznać po nazwie stanu, który Search Console przypisuje adresowi w raporcie Indeksowanie stron. Stany opisane na stronie pomocy Raport Indeksowanie stron można przypisać do kolejnych etapów pracy wyszukiwarki, co pokazuje poniższa tabela. Samo przypisanie do etapów jest naszym uporządkowaniem, a nazwy i znaczenie stanów pochodzą z pomocy Google.
| Stan w raporcie | Etap | Co oznacza | Co zwykle należy zrobić |
|---|---|---|---|
| Strona wykryta - obecnie niezindeksowana | Skanowanie | Google zna adres, ale jeszcze go nie pobrał. Często wizyta została odłożona, aby nie przeciążyć witryny. | Poczekać, a przy ważnej stronie ocenić linki wewnętrzne, które do niej prowadzą. |
| URL zablokowany przez plik robots.txt | Skanowanie | Reguła w pliku zabrania robotowi wejścia. | Zdjąć blokadę, jeżeli strona ma być widoczna. |
| Błąd serwera (5xx) | Skanowanie | Serwer odpowiedział błędem. | Ocenić stan hosta, czas odpowiedzi i ustawienia zapory. |
| Strona zeskanowana, ale jeszcze niezindeksowana | Indeksowanie | Google pobrał stronę, lecz nie zapisał jej w indeksie. | Ponowne zgłaszanie nie jest potrzebne. Warto ocenić jakość i unikalność treści. |
| URL zawiera tag "noindex" | Indeksowanie | Strona sama zabrania indeksowania. | Usunąć znacznik lub nagłówek, jeżeli znalazł się tam przez pomyłkę. |
| Duplikat, użytkownik nie oznaczył strony kanonicznej | Indeksowanie | Strona powiela inną, a Google wskazał inny adres jako główny. | Jeżeli wybór jest słuszny, nic. Jeżeli nie, wskazać adres kanoniczny lub zróżnicować treść. |
Z naszej praktyki, a nie z danych Google, wynika pewna prawidłowość. Małe strony firmowe rzadko mają kłopot z samym dostępem robota, o ile nie pozostała na nich blokada z okresu budowy. Znacznie częściej zatrzymują się na indeksowaniu, ze stanem informującym o zeskanowaniu bez zapisania w indeksie albo o duplikacie. W sklepach z dużą liczbą filtrów i wariantów dominuje z kolei nadmiar adresów: robot zna tysiące kombinacji, a do indeksu trafia ich niewielka część. Najwięcej rozczarowań przynosi jednak wyświetlanie wyników, ponieważ tam nie ma komunikatu o błędzie. Strona jest w indeksie, raport nie zgłasza problemów, a zapytań i kliknięć nie przybywa.
Gdzie to widać w Search Console
Każdy z trzech etapów ma w Search Console własne miejsce: skanowanie widać w raporcie Statystyki indeksowania, indeksowanie w raporcie Indeksowanie stron i w narzędziu do sprawdzania adresów URL, a wyświetlanie w raporcie Skuteczność.
Raport Indeksowanie stron
Raport znajduje się w menu po lewej stronie, w grupie Indeksowanie, pod pozycją Strony. Według pomocy Google pokazuje on, które adresy witryny zostały zeskanowane i zindeksowane, a strona podsumowania zawiera wykres oraz tabelę zatytułowaną "Dlaczego strony nie są indeksowane". Każdy wiersz tej tabeli to jeden powód, a po jego kliknięciu otwiera się lista przykładowych adresów. Osobna tabela zbiera ostrzeżenia, które nie blokują indeksowania, na przykład stan "Strona zindeksowana, ale zablokowana przez plik robots.txt".
Po usunięciu przyczyny na stronie danego problemu dostępny jest przycisk sprawdzania poprawki. Pomoc podaje, że taka weryfikacja trwa zwykle do dwóch tygodni, czasem dłużej, a przed jej uruchomieniem trzeba naprawić wszystkie wystąpienia problemu.
Narzędzie do sprawdzania adresów URL
Do oceny pojedynczej strony służy pasek wyszukiwania u góry Search Console, w który wkleja się pełny adres. Zgodnie ze stroną pomocy Narzędzie do sprawdzania adresów URL wynik pokazuje wersję zapisaną w indeksie, czyli stan z ostatniego skanowania, a nie to, co jest na stronie w tej chwili. U góry pojawia się ogólny werdykt, na przykład "Adres URL znajduje się w Google" albo "Adres URL nie znajduje się w Google". Niżej, w sekcji Indeksowanie stron, znajdują się pola, które odpowiadają kolejnym etapom.
- Wykrycie adresu
Pola "Mapy witryn" i "Strona odsyłająca" pokazują, skąd Google dowiedział się o adresie.
- Skanowanie
Pola "Ostatnie skanowanie", "Czy skanowanie jest dozwolone" oraz "Pobranie strony" informują, kiedy robot był na stronie, czy robots.txt mu na to pozwala i czy serwer oddał treść.
- Indeksowanie
Pole "Czy indeksowanie jest dozwolone" ujawnia regułę noindex, a pola "Adres kanoniczny określony przez użytkownika" i "Adres kanoniczny wybrany przez Google" pozwalają porównać wskazanie właściciela z decyzją wyszukiwarki.
- Test wersji opublikowanej
Osobny przycisk uruchamia test aktualnej wersji strony. Pomoc zaznacza, że taki test nie przewiduje, czy strona zostanie zindeksowana.
Narzędzie zawiera też przycisk z prośbą o zindeksowanie. Liczba takich próśb w ciągu dnia jest ograniczona, a przy wielu adresach Google zaleca przesłanie mapy witryny. Strona o zgłaszaniu próśb o ponowne zindeksowanie podaje, że skanowanie może zająć od kilku dni do kilku tygodni, a wielokrotne zgłaszanie tego samego adresu niczego nie przyspiesza. Szczegółowy opis każdego pola znajduje się w naszym wpisie o sprawdzaniu adresu URL w Search Console.
Statystyki indeksowania i raport Skuteczność
Raport Statystyki indeksowania otwiera się z pozycji Ustawienia w menu. Pokazuje łączną liczbę żądań robota, średni czas odpowiedzi oraz stan hosta z podziałem na pobieranie pliku robots.txt, rozpoznawanie nazw DNS i połączenie z serwerem. Pomoc Google określa go jako raport dla zaawansowanych użytkowników i zaznacza, że w witrynie mającej mniej niż tysiąc stron zwykle nie ma potrzeby z niego korzystać. Wyświetlanie opisuje raport Skuteczność z liczbą wyświetleń, kliknięć i zapytań. Sposób jego czytania przedstawiamy we wpisie o raporcie Skuteczność w Search Console.
Co zrobić po kolei, gdy strony nie widać w Google
Diagnozę warto prowadzić w tej samej kolejności, w jakiej pracuje wyszukiwarka: najpierw ustalić, czy Google zna adres i czy go pobrał, następnie czy zapisał go w indeksie, a na końcu czy strona pojawia się na jakiekolwiek zapytania. Każda odpowiedź zawęża pole poszukiwań i wskazuje, kto powinien się zająć naprawą: administrator serwera, osoba opiekująca się stroną czy autor treści.
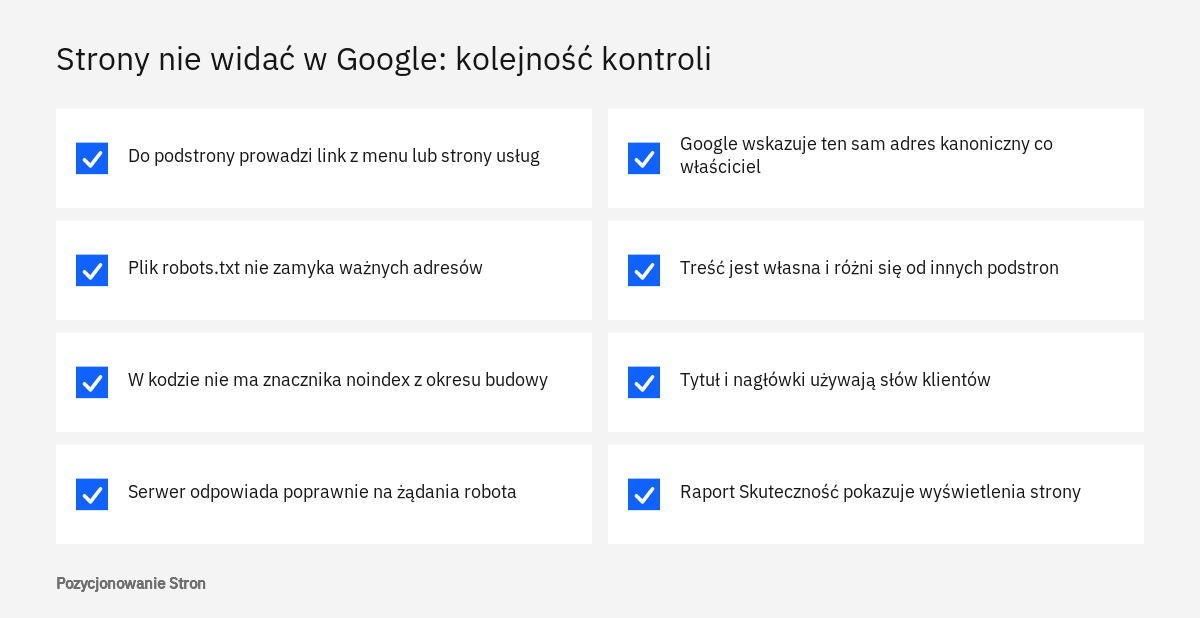
- Adres ważnej podstrony ma link z menu, ze strony usług lub z innej często odwiedzanej części serwisu.
- Plik robots.txt nie zawiera reguły zamykającej całą witrynę ani katalogu z ważnymi stronami.
- W kodzie strony nie pozostał znacznik noindex z okresu budowy.
- Serwer odpowiada poprawnie, a w narzędziu do sprawdzania adresów pole o pobraniu strony nie zgłasza błędu.
- Adres kanoniczny wybrany przez Google jest tym samym adresem, który wskazuje właściciel.
- Treść podstrony jest własna i wyraźnie różni się od pozostałych podstron serwisu.
- Tytuł i nagłówki używają słów, którymi klienci faktycznie opisują daną usługę lub produkt.
- W raporcie Skuteczność strona ma wyświetlenia na zapytania związane z ofertą.
Typowe pomyłki
Najczęstsza pomyłka polega na traktowaniu trzech etapów jak jednego. Właściciel widzi, że strony nie ma na frazę, na której mu zależy, i zleca prośbę o zindeksowanie, choć strona od dawna jest w indeksie i problem leży w dopasowaniu treści do zapytań. Druga pomyłka to wielokrotne zgłaszanie tego samego adresu w nadziei na szybszy efekt, co według dokumentacji nie przynosi skutku. Trzecia to próba ukrycia strony przez robots.txt, po której adres nadal pojawia się w wynikach, tylko bez opisu. Czwarta dotyczy zmian w serwisie: przebudowa strony lub zmiana adresów podstron zmieniają warunki skanowania i indeksowania, dlatego po takich pracach raport Indeksowanie stron warto przeglądać częściej niż zwykle.
Kiedy potrzebna jest pomoc
Samodzielnie da się zwykle ustalić etap i usunąć proste przyczyny: brakujący link, zapomniany znacznik, błędną regułę w pliku. Wsparcie przydaje się wtedy, gdy liczba niezindeksowanych adresów rośnie mimo poprawek, gdy Google uparcie wskazuje inny adres kanoniczny niż właściciel, gdy treść zależy od skryptów i nie wiadomo, co widzi robot, albo gdy serwis ma tysiące adresów z filtrów i parametrów. Takimi sprawami zajmujemy się w ramach SEO technicznego, a pełny przegląd witryny od dostępu robota po treść obejmuje audyt SEO. Gdy przeszkody techniczne są usunięte, a strona nadal nie zdobywa wyświetleń, praca przenosi się na treść, strukturę i linki, czyli na stałe pozycjonowanie stron.
Jeśli chcą Państwo zamówić pozycjonowanie strony, zachęcamy do kontaktu: tel. 222 500 844 lub mailowo: biuro@pozycjonowaniestron.pl
Najczęstsze pytania
Czy skanowanie i indeksowanie to to samo?
Nie. Skanowanie to pobranie strony przez robota, a indeksowanie to analiza pobranej treści i zapisanie jej w bazie Google. Strona może zostać przeskanowana i mimo to nie trafić do indeksu, co raport pokazuje jako stan "Strona zeskanowana, ale jeszcze niezindeksowana".
Ile trwa pojawienie się nowej strony w Google?
Dokumentacja Google podaje, że skanowanie może zająć od kilku dni do kilku tygodni, i nie gwarantuje ani terminu, ani samego zapisania strony w indeksie. Postęp można śledzić w raporcie Indeksowanie stron oraz w narzędziu do sprawdzania adresów URL.
Czy można zapłacić Google za szybsze zindeksowanie strony?
Nie. Google wprost informuje, że nie przyjmuje płatności za częstsze skanowanie witryny ani za wyższą pozycję w wynikach. Reklamy są osobnym systemem, oddzielonym od wyników organicznych.
Czy mała strona firmowa potrzebuje mapy witryny?
Nie zawsze. Według dokumentacji mapa może nie być potrzebna w witrynie liczącej do 500 stron, w której wszystkie ważne podstrony są połączone linkami. WordPress i podobne systemy zwykle tworzą ją jednak automatycznie, więc najczęściej wystarczy przesłać jej adres w Search Console.
Dlaczego strona jest zindeksowana, a nie widać jej w wynikach?
Indeks to baza stron, z której Google dopiero dobiera wyniki do konkretnego zapytania. Dokumentacja podaje trzy możliwe powody braku widoczności: treść nie odpowiada temu, czego szukają użytkownicy, jej jakość jest niska albo reguły meta robots zapobiegają wyświetlaniu.
Czy blokada w robots.txt usuwa stronę z Google?
Nie. Plik robots.txt zabrania robotowi wejścia na stronę, ale adres nadal może pojawić się w wynikach bez opisu, jeśli prowadzą do niego linki. Do wyłączenia strony z wyników służy reguła noindex albo zabezpieczenie hasłem, przy czym strona z regułą noindex musi pozostać dostępna dla robota.
Źródła
- Jak działa wyszukiwarka Google, Centrum wyszukiwarki Google
- Podstawowe zasady dotyczące wyszukiwarki Google (wcześniej Wytyczne dla webmasterów), Centrum wyszukiwarki Google
- Raport Indeksowanie stron, Search Console - pomoc
- Narzędzie do sprawdzania adresów URL, Search Console - pomoc
- Raport Statystyki indeksowania, Search Console - pomoc
- Plik robots.txt - wprowadzenie i przewodnik, Centrum wyszukiwarki Google
- Blokowanie indeksowania przez wyszukiwarki za pomocą tagu noindex, Centrum wyszukiwarki Google
- Jak określić kanoniczny URL za pomocą rel="canonical" i innych metod, Centrum wyszukiwarki Google
- Co to jest mapa witryny, Centrum wyszukiwarki Google
- Zgłaszanie do Google prośby o ponowne zindeksowanie witryny, Centrum wyszukiwarki Google
Funkcje wyszukiwarek i asystentów AI zmieniają się szybko, dlatego wpis aktualizujemy po większych zmianach.