Google nie indeksuje strony najczęściej z jednego z kilku powodów: robot nie ma do niej dostępu, strona sama prosi o pominięcie, jest kopią innego adresu albo jej treść nie przekonała wyszukiwarki. Każdy z tych przypadków ma w Search Console własną nazwę, a z nazwy wynika, czy trzeba coś naprawiać, czy wystarczy zostawić sprawę w spokoju. Poniżej wyjaśniamy po kolei, co oznaczają poszczególne statusy i jak postępować przy każdym z nich.
Jak strona trafia do Google: skanowanie, indeksowanie, wyświetlanie wyników
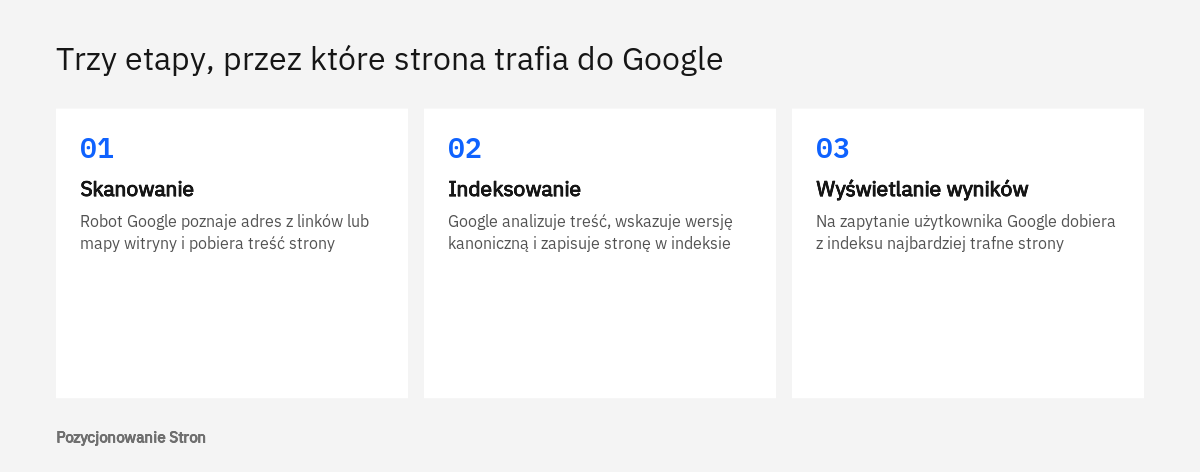
Strona pojawia się w Google dopiero po przejściu trzech etapów i na każdym z nich może zostać zatrzymana. Dokumentacja Google „Jak działa wyszukiwarka” nazywa je kolejno: skanowanie, indeksowanie i wyświetlanie wyników wyszukiwania. Zrozumienie tej kolejności bardzo ułatwia czytanie komunikatów w Search Console, ponieważ każdy status mówi w gruncie rzeczy o tym, na którym etapie strona się zatrzymała.
Skanowanie polega na tym, że automatyczny program, nazywany Googlebotem, pobiera ze strony tekst, obrazy i filmy. Google nie ma żadnego centralnego spisu stron, więc najpierw musi się o adresie dowiedzieć. Robi to na dwa sposoby: podąża za linkami z już znanych stron oraz korzysta z map witryn przesłanych przez właścicieli. Podczas skanowania Google uruchamia też skrypty strony w aktualnej wersji przeglądarki Chrome, ponieważ wiele serwisów wczytuje treść właśnie skryptami. Skanowanie może się nie udać z powodu kłopotów z serwerem, problemów z siecią albo reguł w pliku robots.txt, które zabraniają robotowi wejścia.
Indeksowanie to analiza pobranej treści i zapisanie jej w indeksie, czyli w ogromnej bazie danych wyszukiwarki. Google ocenia wtedy, czego strona dotyczy, sprawdza tytuł, teksty alternatywne obrazów i samą treść. Na tym etapie porównuje także stronę z innymi podobnymi adresami. Podobne strony łączy w grupy i z każdej grupy wskazuje jedną, najbardziej reprezentatywną, nazywaną stroną kanoniczną. To ona może pojawiać się w wynikach, a pozostałe są traktowane jako wersje alternatywne.
Wyświetlanie wyników to moment, w którym ktoś wpisuje zapytanie, a Google dobiera z indeksu strony uznane za najbardziej trafne. Warto wiedzieć, że sama obecność w indeksie nie oznacza jeszcze widoczności. Strona może być zaindeksowana i mimo to nie pojawiać się na zapytania ważne dla firmy, jeśli jej treść do nich nie pasuje albo ustępuje jakością innym wynikom. Szerzej opisujemy to we wpisie o tym, jak działa Google i co podnosi widoczność.
Google nie obiecuje zaindeksowania każdej strony
Najważniejsze zastrzeżenie znajduje się w tej samej dokumentacji: Google wprost informuje, że nie gwarantuje skanowania, indeksowania ani wyświetlania strony w wynikach, nawet jeśli spełnia ona podstawowe zasady wyszukiwarki. Nie każda strona, którą robot pobrał, trafia do indeksu. Wśród typowych przeszkód Google wymienia niską jakość treści, reguły w znaczniku meta robots zakazujące indeksowania oraz projekt strony, który indeksowanie utrudnia.
Dla właściciela firmy wynika z tego praktyczny wniosek. Celem nie jest stan, w którym każdy adres w witrynie znajduje się w indeksie, lecz stan, w którym w indeksie są wszystkie strony ważne dla klientów: strona główna, oferta, podstrony usług, kategorie i produkty, wpisy na blogu, dane kontaktowe. Pomoc Search Console mówi podobnie: nie należy oczekiwać, że wszystkie adresy w witrynie zostaną zaindeksowane, a większość witryn ma przynajmniej kilka stron poza indeksem.
Baza danych, w której wyszukiwarka zapisuje informacje o przeanalizowanych stronach. W wynikach wyszukiwania mogą pojawiać się wyłącznie strony, które się w niej znajdują.
Gdzie sprawdzić, czy Google indeksuje stronę
Odpowiedź daje Search Console, czyli udostępniany przez Google bez opłat panel dla właścicieli witryn, a w nim dwa miejsca: raport „Indeksowanie stron” oraz narzędzie „Sprawdzanie adresu URL”. Pierwsze pokazuje obraz całej witryny, drugie stan jednej, wskazanej podstrony. Do codziennej pracy potrzebne są oba, ponieważ odpowiadają na różne pytania.
Raport „Indeksowanie stron”
Raport znajduje się w menu po lewej stronie, w części poświęconej indeksowaniu. Na górze widać wykres i dwie liczby: strony zaindeksowane oraz niezaindeksowane. Poniżej znajduje się tabela „Dlaczego strony nie są indeksowane”, w której każdy wiersz to jeden powód wraz z liczbą adresów. Po kliknięciu wiersza otwiera się lista przykładowych adresów oraz wykres pokazujący, od kiedy problem występuje.
Jak opisuje pomoc Search Console dotycząca tego raportu, czytanie warto zacząć od pytania, czy zaindeksowane są adresy naprawdę ważne, a dopiero potem przeglądać powody. Duża liczba stron niezaindeksowanych nie musi oznaczać kłopotów, o ile są to duplikaty, strony alternatywne lub adresy celowo wyłączone. Uwagę powinny natomiast zwrócić nagłe zmiany: gwałtowny wzrost liczby błędów albo spadek liczby stron w indeksie. Pomoc wskazuje, że takie skoki często mają związek ze zmianą szablonu, pliku robots.txt, pojawieniem się tagów noindex lub wymogiem logowania.
Przy każdym powodzie raport podaje też źródło problemu: witrynę albo Google. To cenna podpowiedź. Usunąć można tylko te problemy, których źródłem jest witryna, na przykład błędny tag lub niedziałający serwer. Jeśli źródłem jest Google, jak przy statusie mówiącym o stronie zeskanowanej, ale jeszcze niezaindeksowanej, nie ma przełącznika, który by to zmienił, i pozostaje praca nad samą stroną.
Przydatny jest również filtr map witryn nad wykresem. Pozwala ograniczyć raport do adresów zgłoszonych w mapie, czyli do tych, na których firmie rzeczywiście zależy. Jeśli w tak zawężonym widoku nadal widać wiele stron poza indeksem, to znak, że pominięcie dotyczy ważnych adresów, a nie technicznych odpadów.
Narzędzie „Sprawdzanie adresu URL”
Narzędzie uruchamia się, wpisując pełny adres podstrony w pole wyszukiwania na samej górze Search Console. Zgodnie z opisem w pomocy pokazuje ono informacje o wersji strony zapisanej w indeksie Google, a nie o tym, co jest na stronie w tej chwili. Widać między innymi stronę odsyłającą, z której Google prawdopodobnie dowiedział się o adresie, mapy witryn zawierające ten adres, czas ostatniego skanowania oraz dwa adresy kanoniczne: wskazany przez właściciela i przyjęty przez Google.
Drugą możliwością jest test wersji opublikowanej. Narzędzie pobiera wtedy stronę w czasie rzeczywistym i pokazuje, czy da się ją zaindeksować w obecnym kształcie. Po udanym teście dostępny jest zrzut ekranu, pobrany kod HTML, nagłówki odpowiedzi serwera i komunikaty z konsoli skryptów. To najprostszy sposób, aby przekonać się, czy poprawka wprowadzona przed chwilą faktycznie działa, bez czekania na kolejną wizytę robota. Pomoc zastrzega przy tym, że nie istnieje test, który gwarantowałby przyjęcie strony do indeksu.
Strona zeskanowana lub wykryta, ale niezindeksowana - co to oznacza
Oba statusy oznaczają, że Google wie o stronie, ale nie przyjął jej jeszcze do indeksu, przy czym różni je etap, na którym strona czeka. To dwa najczęściej mylone komunikaty i jednocześnie te, przy których najłatwiej o niepotrzebne, nerwowe działania.
„Strona zeskanowana, ale jeszcze niezindeksowana”
Robot pobrał stronę, ale wyszukiwarka nie zapisała jej w indeksie. Pomoc Search Console dodaje, że strona może zostać zaindeksowana w przyszłości i że nie ma potrzeby ponownego przesyłania adresu do skanowania. Przeszkodą nie jest więc dostęp, skoro robot stronę odwiedził. W dokumentacji o działaniu wyszukiwarki Google wskazuje, że indeksowanie zależy od zawartości strony, a jedną z typowych przeszkód jest niska jakość treści. Dlatego przy tym statusie należy przede wszystkim przyjrzeć się samej podstronie.
W praktyce widzimy ten status najczęściej przy podstronach, które niewiele wnoszą: opisach produktów złożonych z dwóch zdań, wpisach powielających to, co witryna mówi już w innym miejscu, pustych stronach tagów i archiwów, a także przy podstronach, do których nie prowadzi żaden link z menu ani z treści. Sklep z Poznania może mieć w tej grupie setki kart produktów z opisem skopiowanym od producenta. Rozwiązaniem nie jest wtedy ponawianie zgłoszeń, lecz rozbudowanie opisów o informacje, których klient naprawdę szuka, oraz podlinkowanie produktów z kategorii i wpisów.
Jeżeli status dotyczy kilku świeżo opublikowanych stron, zwykle wystarcza cierpliwość. Jeżeli obejmuje dużą część ważnych podstron i utrzymuje się długo, to sygnał do przeglądu treści i linkowania wewnętrznego.
„Strona wykryta - obecnie niezindeksowana”
Google zna adres, ale jeszcze go nie odwiedził. Według pomocy Search Console typową przyczyną jest sytuacja, w której wyszukiwarka zamierzała zeskanować stronę, lecz mogłoby to nadmiernie obciążyć witrynę, więc skanowanie zostało przełożone na później. Stąd w raporcie puste pole z datą ostatniego skanowania.
Warto w takiej sytuacji ocenić dwie rzeczy. Pierwsza to kondycja serwera: jeśli strona działa wolno lub zwraca błędy, robot celowo ogranicza tempo. Druga to liczba adresów, które witryna wystawia. Sklep, w którym każda kombinacja filtrów i sortowania tworzy osobny adres, podsuwa Google tysiące prawie identycznych stron, a ważne podstrony czekają w tej samej kolejce. Uporządkowanie takich adresów i wskazanie w mapie witryny wyłącznie tych istotnych zwykle pomaga bardziej niż jakiekolwiek zgłoszenia.
Noindex i robots.txt - dwa różne zakazy
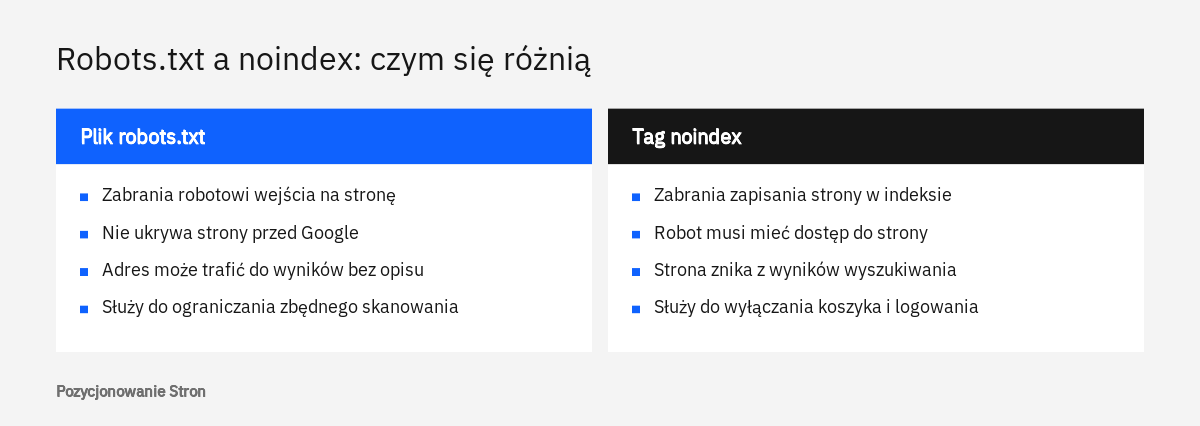
Tag noindex zabrania zapisania strony w indeksie, a plik robots.txt zabrania robotowi wejścia na stronę. To dwie różne rzeczy i właśnie ich mylenie jest jedną z najczęstszych przyczyn kłopotów z indeksowaniem. W raporcie odpowiadają im dwa statusy: „URL zawiera tag „noindex”” oraz „URL zablokowany przez plik robots.txt”. W rozmowach często używa się opisowych nazw, czyli strona wykluczona za pomocą tagu noindex oraz strona zablokowana przez plik robots.txt.
Strona wykluczona tagiem noindex
Status oznacza, że Google wszedł na stronę, odczytał prośbę o pominięcie i ją uszanował. Prośbę zapisuje się na dwa sposoby opisane w dokumentacji Google o blokowaniu indeksowania: jako znacznik meta robots z wartością noindex w nagłówku strony albo jako nagłówek odpowiedzi serwera X-Robots-Tag, przydatny przy plikach takich jak PDF.
Czy to problem, zależy wyłącznie od tego, czy wykluczenie było zamierzone. Przy stronie logowania, koszyku lub podziękowaniu za zamówienie wszystko jest w porządku. Jeśli jednak na liście znajdują się podstrony oferty, trzeba ustalić, skąd tag się wziął. Najczęstsze źródła to ustawienie w WordPressie proszące wyszukiwarki o nieindeksowanie witryny, pozostawione po okresie budowy strony, ustawienia wtyczki do SEO dla całego typu treści oraz wersja testowa strony przeniesiona na adres docelowy razem z blokadą. Kancelaria z Krakowa, która po uruchomieniu nowej witryny przez wiele tygodni nie widzi jej w Google, bardzo często trafia właśnie na ten przypadek.
Po usunięciu tagu warto wykonać test wersji opublikowanej w narzędziu „Sprawdzanie adresu URL” i dopiero po pozytywnym wyniku poprosić o zaindeksowanie.
Strona zablokowana przez plik robots.txt
Status oznacza, że reguła w pliku robots.txt nie pozwoliła robotowi pobrać strony. Zgodnie z wprowadzeniem Google do pliku robots.txt plik ten informuje roboty, do których adresów mogą mieć dostęp, i służy głównie temu, aby witryna nie była przeciążona żądaniami. Google zaznacza wyraźnie, że nie jest to sposób na ukrycie strony przed wyszukiwarką.
Powód jest prosty. Strona zablokowana w robots.txt nadal może trafić do indeksu, jeśli prowadzą do niej linki z innych witryn. Google nie zna wtedy jej treści, więc pokazuje sam adres, bez opisu. W raporcie taki przypadek ma osobną nazwę: „Strona zindeksowana, ale zablokowana przez plik robots.txt”.
Dlaczego nie wolno łączyć obu blokad
Zablokowana w robots.txt strona nie pokaże Google tagu noindex, ponieważ robot w ogóle jej nie otwiera. Dokumentacja Google stawia sprawę jednoznacznie: aby reguła noindex zadziałała, strona nie może być zablokowana w pliku robots.txt. W przeciwnym razie robot nie odczyta zakazu, a adres może dalej pojawiać się w wynikach. Google nie obsługuje również reguły noindex wpisanej do samego pliku robots.txt.
Wynika z tego jasna zasada. Gdy strona ma zniknąć z wyników, należy pozwolić robotowi na wejście i umieścić na niej tag noindex. Gdy chodzi tylko o to, aby robot nie tracił czasu na mało istotne adresy, właściwym narzędziem jest robots.txt. O samym pliku, także w kontekście robotów narzędzi sztucznej inteligencji, piszemy osobno we wpisie o robotach AI i pliku robots.txt.
Przy okazji warto sprawdzić, czy plik robots.txt nie blokuje plików stylów i skryptów. Google nie pobiera zablokowanych zasobów, więc strona, której treść powstaje dzięki skryptom, może zostać odczytana jako niepełna.
Jeśli chcą Państwo zamówić audyt SEO, zachęcamy do kontaktu: tel. 222 500 844 lub mailowo: biuro@pozycjonowaniestron.pl
Duplikaty, strony kanoniczne i przekierowania
Statusy z tej grupy mówią, że Google uznał dany adres za kopię lub odnośnik do innej strony i w indeksie umieścił tamtą. W większości przypadków to prawidłowe działanie wyszukiwarki, a nie usterka. Pomoc Search Console przypomina, że w indeksie powinna się znaleźć kanoniczna wersja każdej ważnej strony, natomiast duplikaty i wersje alternatywne zwykle nie powinny być indeksowane.
„Duplikat, użytkownik nie oznaczył strony kanonicznej”
Google znalazł kilka bardzo podobnych adresów, właściciel nie wskazał, który jest główny, więc wyszukiwarka zdecydowała sama. Jak wyjaśnia dokumentacja o adresach kanonicznych, przy braku wskazania Google samodzielnie ustala wersję, którą uznaje za najlepszą do pokazania w wynikach.
Typowe przykłady to ten sam produkt dostępny pod kilkoma adresami w różnych kategoriach, adresy z parametrami sortowania i śledzenia kampanii, wersje do druku oraz strona dostępna jednocześnie z przedrostkiem www i bez niego. Jeśli Google trafnie wskazał wersję główną, nic złego się nie dzieje. Warto mimo to wskazać ją samodzielnie, aby nie zdawać się na przypadek. Dokumentacja opisuje trzy sposoby i ocenia ich siłę: przekierowanie oraz element rel="canonical" w nagłówku strony to wyraźne sygnały, a umieszczenie adresu w mapie witryny to sygnał słaby. Sygnały można łączyć, byle wskazywały ten sam adres.
Pokrewny status to „Duplikat, wyszukiwarka Google wybrała inną stronę kanoniczną niż użytkownik”. Oznacza on, że właściciel wskazał jedną wersję, a Google przyjął inną. Warto wtedy sprawdzić, czy linki wewnętrzne prowadzą do adresu wskazanego jako główny, ponieważ Google zaleca kierowanie linków w witrynie właśnie na adres kanoniczny, a nie na jego kopie.
„Alternatywna strona zawierająca prawidłowy tag strony kanonicznej”
Ten status, znany też pod opisową nazwą strony alternatywnej z prawidłowym tagiem strony kanonicznej, jest potwierdzeniem, że wszystko działa. Strona wskazuje inną jako główną, Google tę wskazówkę przyjął i zaindeksował wersję główną. Pomoc Search Console stwierdza, że nie są tu potrzebne żadne działania. Jedyne, co warto zrobić, to rzucić okiem na listę adresów i upewnić się, że nie trafiła na nią przez pomyłkę żadna strona, która powinna być samodzielna.
„Strona zawierająca przekierowanie”
Adres przekierowuje pod inny, więc sam nie jest indeksowany. Google przetwarza treść strony docelowej, a nie adresu pośredniego. Po zmianie adresów, przejściu na HTTPS lub przeniesieniu witryny taka lista jest naturalna i z czasem maleje. Uwagi wymaga osobny status „Błąd przekierowania”, który według pomocy oznacza zbyt długi łańcuch, pętlę albo błędny adres w łańcuchu. O planowaniu przekierowań przy zmianie serwisu piszemy we wpisie o migracji strony bez utraty pozycji.
Błędy 404, pozorne błędy 404 i błędy serwera 5xx
Te statusy mówią o tym, co serwer odpowiedział robotowi: że strony nie ma, że strona wygląda na pustą albo że serwer w ogóle nie poradził sobie z żądaniem. Dwa pierwsze bywają całkowicie niegroźne, trzeci wymaga szybkiej reakcji. Sposób traktowania poszczególnych odpowiedzi opisuje dokumentacja Google o kodach stanu HTTP.
„Nie znaleziono (404)”
Serwer poinformował, że pod danym adresem nie ma strony. Pomoc Search Console uspokaja: odpowiedź 404 nie musi być problemem, jeśli strona została usunięta i nie ma następcy. Adresy, które były wcześniej w indeksie, a zwracają błąd z grupy 4xx, są z niego usuwane, a robot odwiedza je coraz rzadziej. Mogą jeszcze przez pewien czas pojawiać się w raporcie, ponieważ Google nadal je sprawdza.
Działanie jest potrzebne w dwóch sytuacjach. Jeśli strona została przeniesiona pod inny adres, należy ustawić przekierowanie 301 do nowego miejsca. Jeśli do nieistniejącego adresu prowadzą linki z własnej witryny albo figuruje on w mapie witryny, trzeba poprawić linki i mapę. Hydraulik z Łodzi, który po przebudowie strony zmienił adresy podstron usług i nie ustawił przekierowań, zobaczy w raporcie stare adresy z błędem 404, a nowe będą musiały zdobywać widoczność od początku.
„Pozorny błąd 404”
Strona wygląda jak komunikat o braku treści, ale serwer odpowiada tak, jakby wszystko było w porządku. Google ocenia zawartość i jeśli przypomina ona błąd, na przykład jest pusta lub zawiera komunikat o błędzie, zgłasza właśnie ten status. W sklepach dotyczy to często pustych kategorii, wyników filtrowania bez produktów oraz kart wycofanych towarów z samym napisem o braku w ofercie.
Naprawa zależy od tego, czym strona ma być. Jeśli rzeczywiście nie istnieje, serwer powinien zwracać prawdziwy kod 404 albo 410. Jeśli została przeniesiona, właściwe jest przekierowanie. Jeśli jest potrzebna, trzeba uzupełnić ją o treść, która odróżni ją od strony błędu: opis kategorii, podobne produkty, informację o terminie dostępności.
„Błąd serwera (5xx)”
Serwer nie obsłużył żądania robota. To status, którego nie należy odkładać. Według dokumentacji błędy z grupy 5xx oraz kod 429 są dla robotów Google sygnałem, aby na pewien czas zwolnić skanowanie, a adresy, które stale zwracają błąd serwera, są usuwane z indeksu. Chwilowa awaria nie powoduje usunięcia strony, a gdy serwer znowu odpowiada poprawnie, Google stopniowo przywraca wcześniejsze tempo.
Przyczyn warto szukać z administratorem serwera lub firmą hostingową: w dziennikach błędów, w limitach pamięci, w ostatnich aktualizacjach wtyczek i motywu, a także w zabezpieczeniach, które potrafią omyłkowo potraktować robota jak atak. Podobny charakter mają statusy mówiące o kodach 401 i 403, czyli o wymaganym logowaniu lub odmowie dostępu.
| Status w raporcie | Co oznacza | Czy to problem | Co zrobić |
|---|---|---|---|
| Strona zeskanowana, ale jeszcze niezindeksowana | Robot pobrał stronę, indeks jej nie przyjął | Tak, jeśli dotyczy ważnych podstron przez dłuższy czas | Poprawić treść i linkowanie wewnętrzne |
| Strona wykryta - obecnie niezindeksowana | Google zna adres, ale go nie odwiedził | Tak, jeśli lista rośnie i obejmuje ważne strony | Sprawdzić serwer, ograniczyć liczbę zbędnych adresów |
| URL zawiera tag „noindex” | Strona prosi o pominięcie | Tylko gdy wykluczenie jest niezamierzone | Usunąć tag z ważnych stron |
| URL zablokowany przez plik robots.txt | Robot nie może wejść na stronę | Tylko gdy blokada obejmuje ważne strony lub zasoby | Poprawić reguły w pliku |
| Duplikat, użytkownik nie oznaczył strony kanonicznej | Google sam wskazał wersję główną | Zwykle nie | Wskazać adres kanoniczny samodzielnie |
| Alternatywna strona zawierająca prawidłowy tag strony kanonicznej | Wersja główna jest w indeksie | Nie | Nic, jedynie przejrzeć listę |
| Strona zawierająca przekierowanie | Adres prowadzi pod inny | Nie | Nic, o ile cel jest właściwy |
| Nie znaleziono (404) | Strony nie ma | Tylko gdy strona została przeniesiona lub jest linkowana | Przekierowanie 301, poprawa linków i mapy |
| Pozorny błąd 404 | Strona wygląda na pustą lub błędną | Tak, jeśli strona jest potrzebna | Uzupełnić treść albo zwracać prawdziwy kod 404 |
| Błąd serwera (5xx) | Serwer nie obsłużył żądania | Tak | Pilnie ustalić przyczynę z administratorem |
Mapa witryny i prośba o zaindeksowanie - co dają, a czego nie
Oba rozwiązania informują Google o istnieniu strony, ale żadne nie zobowiązuje wyszukiwarki do jej przyjęcia. To pomoc w dotarciu do adresu, a nie sposób na ominięcie oceny strony.
Mapa witryny to plik z listą adresów i dodatkowymi informacjami o stronach, filmach i innych plikach w serwisie. Według dokumentacji Google o mapach witryn przydaje się ona szczególnie w trzech sytuacjach: gdy witryna jest duża, gdy jest nowa i prowadzi do niej niewiele linków z zewnątrz oraz gdy zawiera wiele filmów i obrazów. Mała witryna, czyli według Google mająca do 500 stron, z dobrze połączonymi podstronami, może się bez niej obyć. Ta sama dokumentacja zastrzega, że mapa pomaga rozpoznawać adresy, lecz nie gwarantuje, że wszystkie elementy witryny zostaną zeskanowane i zaindeksowane.
W praktyce mapa ma jeszcze jedną zaletę: porządkuje raport. Powinny się w niej znajdować wyłącznie adresy, które mają być w indeksie, czyli działające, kanoniczne i bez tagu noindex. Mapa pełna przekierowań, błędów 404 i wykluczonych stron wysyła sprzeczne sygnały i utrudnia odczytanie raportu przez filtr map.
Prośba o zaindeksowanie to przycisk w narzędziu „Sprawdzanie adresu URL”. Nadaje się do pojedynczych, ważnych stron: nowej podstrony usługi, poprawionego opisu, strony po usunięciu blokady. Pomoc Search Console zaznacza, że przesłanie żądania nie gwarantuje pojawienia się strony w indeksie, że obowiązuje dzienny limit zgłoszeń, a przy większej liczbie adresów lepiej przesłać mapę witryny. Z kolei dokumentacja o ponownym skanowaniu podaje, że cały proces trwa od kilku dni do kilku tygodni i że systemy Google najszybciej uwzględniają treści wysokiej jakości.
Podobnie działa przycisk weryfikacji poprawki w raporcie „Indeksowanie stron”. Po naprawieniu wszystkich wystąpień danego problemu można poprosić Google o ponowne sprawdzenie całej grupy adresów. Według pomocy weryfikacja trwa zwykle do 2 tygodni, a o postępach informują wiadomości e-mail.
Jakość treści, skrypty i nowa domena jako powody pomijania
Gdy strona jest technicznie dostępna, a mimo to pozostaje poza indeksem, przyczyna leży zwykle w jednym z trzech obszarów: treść nie wnosi nic nowego, wyszukiwarka nie widzi jej w całości albo witryna jest zbyt młoda i mało znana. Żaden z tych powodów nie ma własnego, jednoznacznego statusu, dlatego trzeba je rozpoznawać pośrednio.
Słaba lub powielona treść
Google wymienia niską jakość treści wśród typowych przeszkód w indeksowaniu, a strony bardzo podobne do siebie łączy w grupy i pokazuje tylko jedną z nich. Dla firm oznacza to kłopot przede wszystkim przy treściach tworzonych seryjnie. Podstrony usług dla kilkunastu miejscowości, różniące się wyłącznie nazwą miasta, są dla wyszukiwarki niemal tym samym dokumentem. Podobnie opisy produktów przepisane od producenta, które w identycznym brzmieniu znajdują się w wielu sklepach.
Lepszy efekt daje mniejsza liczba stron, z których każda odpowiada na konkretne pytanie klienta: zakres usługi, przebieg realizacji, obszar dojazdu, przykłady wykonanych prac, odpowiedzi na częste wątpliwości. Jak przygotowywać takie materiały, opisujemy we wpisie o tym, jak pisać treści SEO.
Strony, których treść wczytują skrypty
Google potrafi uruchamiać skrypty, ale odbywa się to w osobnym etapie. Dokumentacja o podstawach SEO dla JavaScriptu dzieli przetwarzanie takich stron na trzy fazy: skanowanie, renderowanie, czyli złożenie strony w całość po uruchomieniu skryptów, oraz indeksowanie. Strona czeka na renderowanie w kolejce, co może potrwać kilka sekund albo dłużej.
Z tej samej dokumentacji wynikają trzy praktyczne ostrzeżenia. Linki powinny być zwykłymi elementami a z atrybutem href, ponieważ takie Google wykrywa. Jeśli w pierwotnym kodzie strony znajduje się tag noindex, Google może pominąć renderowanie, więc usunięcie tego tagu dopiero przez skrypt może nie zadziałać. Wreszcie w aplikacjach, które całą treść budują w przeglądarce, łatwo o pozorne błędy 404, gdy nieistniejąca podstrona odpowiada tak samo jak istniejąca. Google zaleca przygotowywanie treści po stronie serwera lub wstępne renderowanie, także dlatego, że nie wszystkie roboty potrafią wykonywać skrypty.
Czy problem dotyczy Państwa strony, da się ustalić w kilka minut. Wystarczy wykonać test wersji opublikowanej i obejrzeć zrzut ekranu oraz pobrany kod HTML. Jeśli brakuje w nich opisu oferty, cennika lub listy produktów widocznych w zwykłej przeglądarce, Google również ich nie widzi.
Nowa domena i cierpliwość
Nowa witryna jest indeksowana wolniej, ponieważ Google dowiaduje się o adresach głównie z linków, a do świeżej domeny prowadzi ich niewiele. Właśnie dlatego dokumentacja wymienia nowe witryny wśród tych, którym mapa witryny przydaje się najbardziej. Rozsądne postępowanie obejmuje dodanie witryny do Search Console, przesłanie mapy, prośbę o zaindeksowanie strony głównej i najważniejszych podstron oraz zadbanie o to, aby każda z nich była osiągalna z menu.
Potem potrzebny jest czas. Skoro samo skanowanie trwa od kilku dni do kilku tygodni, brak części podstron w indeksie tuż po starcie nie jest powodem do przebudowy strony. O tym, jak rozłożyć oczekiwania w czasie, piszemy we wpisie o tym, ile trwa pozycjonowanie.
W jakiej kolejności szukać przyczyny
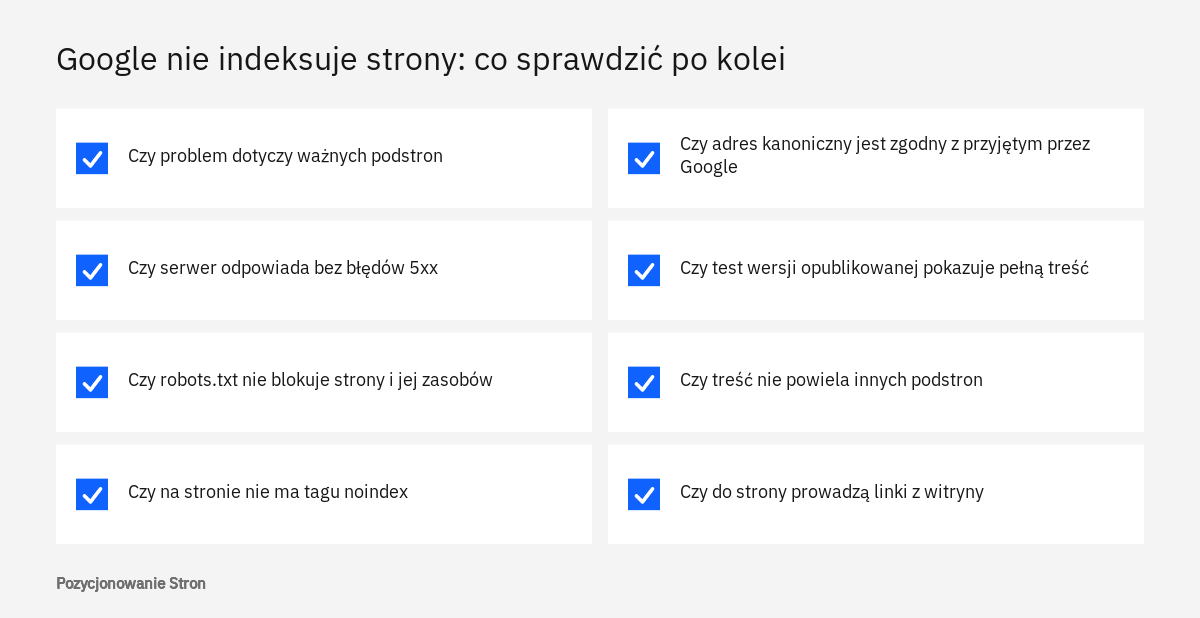
Diagnozę warto prowadzić w tej samej kolejności, w jakiej pracuje wyszukiwarka: najpierw dostęp, potem zgoda na indeksowanie, następnie wybór wersji głównej, a na końcu jakość. Taki porządek oszczędza czas, ponieważ nie ma sensu poprawiać treści strony, której robot nie może nawet otworzyć.
- Ustalenie, czy problem dotyczy ważnych stron
W raporcie „Indeksowanie stron” włączamy filtr przesłanej mapy witryny i przeglądamy powody. Adresy techniczne i duplikaty odkładamy na bok.
- Sprawdzenie odpowiedzi serwera
Błędy 5xx, kody 401 i 403 oraz błędy przekierowań mają pierwszeństwo, ponieważ zatrzymują robota już na etapie skanowania.
- Sprawdzenie blokad
W narzędziu „Sprawdzanie adresu URL” widać, czy skanowanie jest dozwolone przez robots.txt i czy strona nie zawiera tagu noindex.
- Porównanie adresów kanonicznych
Adres wskazany na stronie i adres przyjęty przez Google powinny być takie same. Różnica oznacza, że wyszukiwarka uznała stronę za kopię innej.
- Test wersji opublikowanej
Zrzut ekranu i pobrany kod pokazują, czy Google widzi pełną treść, także tę wczytywaną skryptami.
- Ocena treści i linków
Jeśli wszystko powyżej jest w porządku, pozostaje pytanie, czy strona wnosi coś, czego nie ma na innych podstronach, i czy prowadzą do niej linki z witryny.
Po wprowadzeniu poprawek należy potwierdzić je testem wersji opublikowanej, a następnie skorzystać z weryfikacji poprawki w raporcie albo z prośby o zaindeksowanie przy pojedynczych adresach. Raport nie odświeża się natychmiast, więc na zmianę liczb trzeba poczekać.
Opisana kolejność jest też stałym elementem naszej pracy. Kontrola indeksowania otwiera każdy audyt SEO, ponieważ od niej zależy sens pozostałych działań, a szerszy opis zakresu takiej analizy znajduje się we wpisie o tym, co zawiera audyt SEO. Stałe pilnowanie raportu, map witryn i odpowiedzi serwera należy z kolei do usługi SEO technicznego.
Które wykluczenia są prawidłowe i nie wymagają naprawy
Prawidłowe są te wykluczenia, które dotyczą stron nieprzeznaczonych dla osób szukających czegoś w Google. Pomoc Search Console podkreśla, że niezaindeksowany adres nie zawsze jest błędem, a duplikaty i wersje alternatywne zwykle nie powinny znajdować się w indeksie. W dobrze prowadzonej witrynie lista stron pominiętych jest więc czymś normalnym, a w sklepach bywa wyraźnie dłuższa od listy stron zaindeksowanych.
W naszej praktyce celowo wyłączamy z indeksu koszyk i kolejne etapy składania zamówienia, stronę logowania i rejestracji, panel klienta, wyniki wyszukiwania wewnętrznego oraz strony z podziękowaniem po wysłaniu formularza. Osoba, która trafiłaby na nie prosto z wyników wyszukiwania, nie znalazłaby tam nic użytecznego. Wyniki wyszukiwania wewnętrznego potrafią dodatkowo tworzyć nieskończoną liczbę adresów, po jednym na każde wpisane hasło.
Niegroźne są również adresy z parametrami sortowania i śledzenia kampanii, które poprawnie wskazują wersję kanoniczną, stare adresy przekierowane po zmianie struktury oraz usunięte strony, które zwracają kod 404 i nie mają następcy. Więcej o porządkowaniu takich adresów w handlu internetowym piszemy przy usłudze pozycjonowania sklepów.
Niepokoić powinna natomiast każda sytuacja, w której na listach wykluczeń pojawia się strona zarabiająca: podstrona usługi, kategoria, produkt dostępny w sprzedaży, wpis odpowiadający na pytania klientów czy strona kontaktowa. Dlatego listę warto przeglądać regularnie, a obowiązkowo po każdej większej zmianie w witrynie.
- Strona główna i wszystkie podstrony oferty mają w narzędziu „Sprawdzanie adresu URL” informację, że znajdują się w Google.
- Na liście stron z tagiem noindex znajdują się wyłącznie adresy wyłączone celowo.
- Plik robots.txt nie blokuje ważnych podstron ani plików stylów i skryptów.
- Żadna strona, która ma zniknąć z wyników, nie jest jednocześnie zablokowana w robots.txt.
- Adres kanoniczny wskazany na ważnych stronach zgadza się z adresem przyjętym przez Google.
- Mapa witryny zawiera tylko działające, kanoniczne adresy przeznaczone do indeksu.
- Przeniesione strony mają przekierowania 301, a linki w witrynie prowadzą do nowych adresów.
- W raporcie nie ma błędów serwera 5xx ani nagłego spadku liczby zaindeksowanych stron.
- Zrzut ekranu z testu wersji opublikowanej pokazuje pełną treść strony.
Jeśli chcą Państwo zamówić SEO techniczne, zachęcamy do kontaktu: tel. 222 500 844 lub mailowo: biuro@pozycjonowaniestron.pl
Najczęstsze pytania
Ile trzeba czekać na zaindeksowanie nowej strony?
Dokumentacja Google podaje, że skanowanie i indeksowanie trwa od kilku dni do kilku tygodni. Wielokrotne zgłaszanie tego samego adresu nie skraca tego czasu. Jeśli po kilku tygodniach ważna strona nadal jest poza indeksem, warto sprawdzić jej status w narzędziu „Sprawdzanie adresu URL”.
Czy przesłanie mapy witryny gwarantuje zaindeksowanie wszystkich podstron?
Nie. Mapa witryny pomaga Google poznać adresy, ale dokumentacja wyraźnie zastrzega, że nie gwarantuje ich zeskanowania ani zaindeksowania. O przyjęciu strony decyduje jej dostępność dla robota oraz treść.
Czy duża liczba stron niezaindeksowanych w raporcie oznacza problem?
Niekoniecznie. Pomoc Search Console przypomina, że większość witryn ma strony poza indeksem i że nie należy oczekiwać zaindeksowania wszystkich adresów. Liczy się to, czy wśród pominiętych nie ma stron ważnych dla Państwa firmy.
Strona jest zablokowana w robots.txt, a mimo to widać ją w Google. Dlaczego?
Plik robots.txt zabrania skanowania, a nie indeksowania. Jeśli do strony prowadzą linki z innych witryn, Google może pokazać jej adres bez opisu. Aby strona zniknęła z wyników, należy zdjąć blokadę w robots.txt i zastosować tag noindex.
Czy błędy 404 szkodzą całej witrynie?
Według pomocy Search Console odpowiedź 404 nie musi być problemem, jeśli strona została usunięta i nie ma następcy. Naprawy wymagają adresy, które zostały przeniesione, oraz te, do których nadal prowadzą linki lub które figurują w mapie witryny.
Co zrobić, gdy Google przyjął inny adres kanoniczny niż wskazany na stronie?
Warto sprawdzić, czy wszystkie sygnały wskazują ten sam adres: element rel="canonical", przekierowania, mapa witryny i linki wewnętrzne. Google zaleca, aby linki w witrynie prowadziły do wersji kanonicznej, a różne metody nie podawały sprzecznych adresów.
Czy strona zaindeksowana zawsze pojawia się w wynikach wyszukiwania?
Nie. Indeksowanie to drugi z trzech etapów, a o tym, co pojawia się w wynikach, decyduje dopasowanie treści do zapytania i jej jakość na tle innych stron. Obecność w indeksie jest warunkiem koniecznym, ale nie daje żadnej pewności co do pozycji.
Źródła
- Szczegółowy przewodnik po działaniu wyszukiwarki Google, Google Search Central
- Raport Indeksowanie stron, Pomoc Search Console
- Narzędzie do sprawdzania adresów URL, Pomoc Search Console
- Blokowanie indeksowania za pomocą tagu noindex, Google Search Central
- Wprowadzenie do pliku robots.txt, Google Search Central
- Określanie kanonicznego adresu URL, Google Search Central
- Wpływ kodów stanu HTTP oraz błędów sieci i DNS na wyszukiwarkę Google, Google Search Central
- Mapy witryn - wprowadzenie, Google Search Central
- Proszenie Google o ponowne zeskanowanie adresów URL, Google Search Central
- Podstawowe informacje o SEO JavaScriptu, Google Search Central
Stan wiedzy: październik 2026. Funkcje wyszukiwarek i asystentów AI zmieniają się szybko, dlatego wpis aktualizujemy po większych zmianach.