Łańcuch przekierowań powstaje wtedy, gdy stary adres prowadzi do właściwej strony dopiero przez kilka adresów pośrednich, a pętla wtedy, gdy adresy odsyłają do siebie nawzajem i żaden nie zwraca treści. Oba zjawiska da się wykryć w nagłówkach odpowiedzi serwera oraz w Search Console, a naprawa polega na tym, by każdy stary adres wskazywał od razu adres końcowy. Poniżej opisujemy, skąd biorą się takie konstrukcje, jak je znaleźć i jak uporządkować reguły na serwerze.
Czym jest łańcuch, a czym pętla przekierowań
Łańcuch przekierowań to sytuacja, w której serwer na prośbę o jeden adres odpowiada odesłaniem pod drugi, ten odsyła pod trzeci i dopiero kolejny zwraca stronę. Pętla to szczególny przypadek: któryś z adresów w łańcuchu odsyła z powrotem do adresu wcześniejszego, więc przeglądarka i robot krążą w kółko i nigdy nie otrzymują treści.
Pojedyncze przekierowanie nie jest niczym złym. To zwykły sposób poinformowania przeglądarki i wyszukiwarki, że strona ma nowy adres. Różnice między przekierowaniem trwałym a tymczasowym omawiamy osobno we wpisie przekierowanie 301 a 302, a szersze tło we wpisie o tym, jak Googlebot traktuje kody odpowiedzi HTTP. Kłopot zaczyna się wtedy, gdy przekierowań jest kilka pod rząd, a nikt w firmie nie wie, że tak jest, bo strona w przeglądarce w końcu się otwiera.
Jedno odesłanie z adresu do adresu. Odpowiedź serwera ma wtedy kod z grupy 3xx oraz nagłówek Location ze wskazaniem, dokąd należy się udać. Łańcuch z trzema przeskokami oznacza cztery żądania, zanim pojawi się strona.
W nagłówkach odpowiedzi łańcuch wygląda jak seria krótkich odpowiedzi bez treści, zakończona odpowiedzią z kodem 200. Poniższy przykład jest ilustracją dla wymyślonej domeny: stary adres oferty bez szyfrowania i bez przedrostka www trafia do celu dopiero za czwartym razem.
http://example.com/oferta.html
  HTTP/1.1 301 Moved Permanently
  Location: https://example.com/oferta.html

https://example.com/oferta.html
  HTTP/1.1 301 Moved Permanently
  Location: https://www.example.com/oferta.html

https://www.example.com/oferta.html
  HTTP/1.1 301 Moved Permanently
  Location: https://www.example.com/uslugi/

https://www.example.com/uslugi/
  HTTP/1.1 200 OK
Pętla wygląda podobnie, z tą różnicą, że ostatnia odpowiedź nigdy nie ma kodu 200. Adres ze znakiem ukośnika na końcu odsyła do wersji bez ukośnika, a ta z powrotem do wersji z ukośnikiem. Z obserwacji z naszej praktyki wynika, że przeglądarka po kilkunastu próbach przerywa wczytywanie i wyświetla komunikat o zbyt wielu przekierowaniach, a użytkownik widzi wyłącznie stronę błędu.
Skąd biorą się kilkustopniowe przekierowania
Łańcuchy prawie nigdy nie powstają celowo. Narastają warstwami: każda przebudowa strony dokłada nową regułę, a starych nikt nie poprawia, więc dawne adresy prowadzą do adresów, które same zostały już przeniesione.
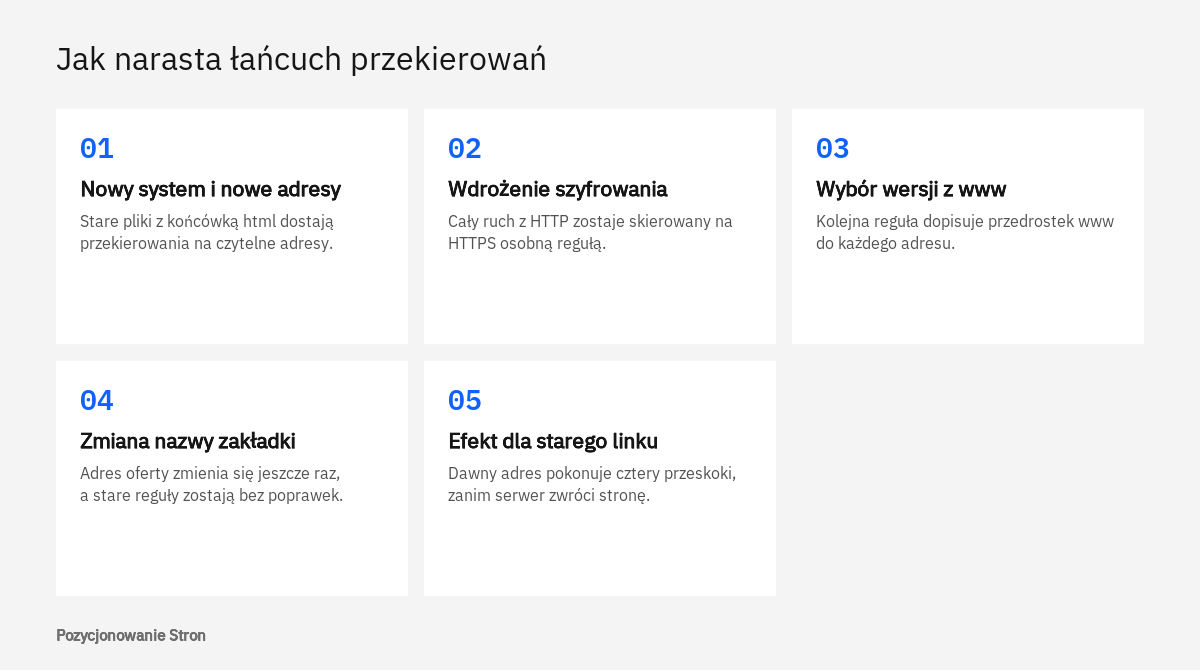
Dobrze pokazuje to hipotetyczny przykład. Kancelaria z Krakowa uruchamia pierwszą stronę z adresami zakończonymi na .html. Po kilku latach przenosi serwis na WordPressa i zmienia adresy na czytelne, więc dodaje przekierowania ze starych plików. Potem wdraża certyfikat i kieruje cały ruch z HTTP na HTTPS. Następnie decyduje, że adresem głównym będzie wersja z www. Na koniec zmienia nazwę zakładki z ofertą. Każda z tych decyzji była rozsądna i każda została wdrożona poprawnie, ale osobno. W efekcie link ze starego katalogu firm, prowadzący do pierwszej wersji adresu, pokonuje cztery przeskoki.
Warstwy, które nakładają się najczęściej
Pierwsza grupa przyczyn to reguły ogólne dla całej domeny: szyfrowanie, wersja z www lub bez www, ukośnik na końcu adresu, wielkość liter. Jeśli każda z nich jest osobną regułą, to adres, który narusza trzy zasady naraz, dostaje trzy przekierowania zamiast jednego. Jak wybrać jedną wersję adresu, opisujemy we wpisie adres z www czy bez www, a samo wdrożenie szyfrowania we wpisie przejście z HTTP na HTTPS.
Druga grupa to przekierowania konkretnych podstron: po zmianie struktury kategorii w sklepie, po połączeniu kilku wpisów w jeden, po usunięciu produktu. Trzecia to miejsca, w których reguły powstają: plik konfiguracyjny serwera, panel hostingu, sieć dostarczania treści, wtyczka do przekierowań i sam system zarządzania treścią. WordPress ma na przykład wbudowaną funkcję redirect_canonical, która zgodnie z dokumentacją dla programistów przekierowuje przychodzące odwołania na właściwy adres ustalony na podstawie adresu witryny. Gdy serwer ma jedną zasadę, a system drugą, ich odpowiedzi ustawiają się w kolejce albo zaczynają sobie przeczyć.
Skąd biorą się pętle
Pętla powstaje wtedy, gdy dwie reguły mają sprzeczne cele. Typowy układ to serwer, który dopisuje przedrostek www, oraz system zarządzania treścią, w którego ustawieniach wpisano adres bez www. Podobnie działa para reguł, z których jedna dodaje ukośnik na końcu adresu, a druga go usuwa. Z naszej praktyki pochodzi jeszcze jedna obserwacja: pętla szyfrowania pojawia się często po włączeniu pośrednika przed serwerem, na przykład sieci dostarczania treści. Pośrednik rozmawia z serwerem bez szyfrowania, serwer uznaje więc każde żądanie za nieszyfrowane i odsyła je na HTTPS bez końca.
Ile przeskoków śledzi Googlebot
Dokumentacja Google podaje konkretną liczbę: roboty Google domyślnie śledzą do 10 przeskoków przekierowania. Ta informacja znajduje się na stronie o tym, jak kody stanu HTTP wpływają na roboty Google, która zastrzega zarazem, że roboty poszczególnych produktów mogą mieć inne limity.
Limit dziesięciu przeskoków nie jest jednak zachętą do ich wykorzystania. W dokumencie Google o przenoszeniu witryny zalecenie jest jednoznaczne: łańcuchów należy unikać i przekierowywać od razu do miejsca docelowego. Jeżeli nie jest to możliwe, łańcuch powinien być krótki, najlepiej nie dłuższy niż 3 kolejne adresy, a w żadnym razie nie dłuższy niż 5. Ta sama strona wyjaśnia powód: łańcuchy spowalniają wczytywanie, a nie wszystkie przeglądarki i programy obsługują długie sekwencje.
Co Google robi z adresami pośrednimi
Treść otrzymana z adresu, który przekierowuje, jest przez Google ignorowana, a przetwarzana jest treść spod adresu końcowego. Dokumentacja opisuje też różnicę w sile sygnału: kod 301 jest traktowany jako mocna wskazówka, że należy przetworzyć cel przekierowania, a kod 302 jako wskazówka słaba. Na stronie Przekierowania a wyszukiwarka Google czytamy z kolei, że przy przekierowaniu trwałym w wynikach pokazuje się strona docelowa, a przy tymczasowym strona źródłowa.
Z tych zasad wynika praktyczny wniosek dla łańcuchów mieszanych. Jeśli w środku sekwencji trwałych przekierowań znajdzie się jedno tymczasowe, cały ciąg przestaje być spójnym komunikatem o przeprowadzce. To nasza interpretacja dokumentacji, a nie jej dosłowny zapis, ale takie ogniwo traktujemy jako błąd do poprawy w pierwszej kolejności. Dokumentacja nie opisuje też szczegółowo, co dzieje się z adresem po przekroczeniu limitu przeskoków. Wiadomo natomiast, że Search Console wymienia zbyt długi łańcuch wśród przyczyn błędu przekierowania.
Jak łańcuchy wydłużają ładowanie i utrudniają skanowanie
Każdy przeskok to osobne żądanie do serwera, na które przeglądarka musi poczekać, zanim w ogóle zacznie pobierać stronę. Dokumentacja narzędzia Lighthouse w części poświęconej wielokrotnym przekierowaniom podaje, że przekierowanie może dodać setki milisekund opóźnienia, a audyt nie zostaje zaliczony, gdy strona zawiera co najmniej 2 przekierowania.
Opóźnienie to powstaje przed pierwszym bajtem właściwej strony, dlatego żadna optymalizacja obrazów ani skryptów go nie zniweluje. Zależności między czasem odpowiedzi a wynikami pomiarów opisujemy we wpisie TTFB, czyli czas odpowiedzi serwera. Szczególnie kosztowne są łańcuchy na adresach, do których prowadzą reklamy. Hipotetyczny sklep z Poznania, który w kampanii podaje adres kategorii sprzed zmiany struktury, płaci za kliknięcie, po którym klient czeka na trzy odpowiedzi serwera, zanim zobaczy cokolwiek. Dokumentacja Lighthouse radzi, aby odnośniki kierować do bieżących lokalizacji zasobów, a przekierowań unikać zwłaszcza dla zasobów potrzebnych do wyświetlenia strony.
Wpływ na skanowanie serwisu
Dla robota każdy adres pośredni to żądanie, które nie przynosi żadnej treści. Google w dokumencie o zarządzaniu budżetem indeksowania wymienia unikanie długich łańcuchów przekierowań wśród dobrych praktyk i zaznacza, że mają one negatywny wpływ na skanowanie. Ten sam dokument zastrzega, że temat budżetu dotyczy przede wszystkim dużych serwisów, które mają ponad milion unikalnych stron, oraz średnich i większych, z ponad 10 tys. stron zmieniających się codziennie.
Mała strona usługowa nie musi się więc obawiać, że robotowi zabraknie na nią zasobów. Duży sklep po kilku zmianach struktury kategorii jest w innym położeniu: tysiące starych adresów produktów z trzema przeskokami każdy to wielokrotnie więcej żądań, niż jest potrzebne. Szerzej piszemy o tym we wpisie o budżecie indeksowania. Niezależnie od wielkości serwisu długi łańcuch zwiększa też ryzyko zwykłej awarii: wystarczy, że jedno ogniwo przestanie działać, na przykład wygaśnie stara domena, a wszystkie adresy przed nim prowadzą donikąd.
Jeśli chcą Państwo zamówić SEO techniczne, zachęcamy do kontaktu: tel. 222 500 844 lub mailowo: biuro@pozycjonowaniestron.pl
Jak wykryć łańcuch w nagłówkach odpowiedzi
Najpewniejszym sposobem jest obejrzenie odpowiedzi serwera przeskok po przeskoku: każda odpowiedź z kodem 3xx i nagłówkiem Location to jedno ogniwo. Wystarczy do tego przeglądarka Chrome albo polecenie curl w wierszu poleceń, bez żadnych dodatkowych programów.
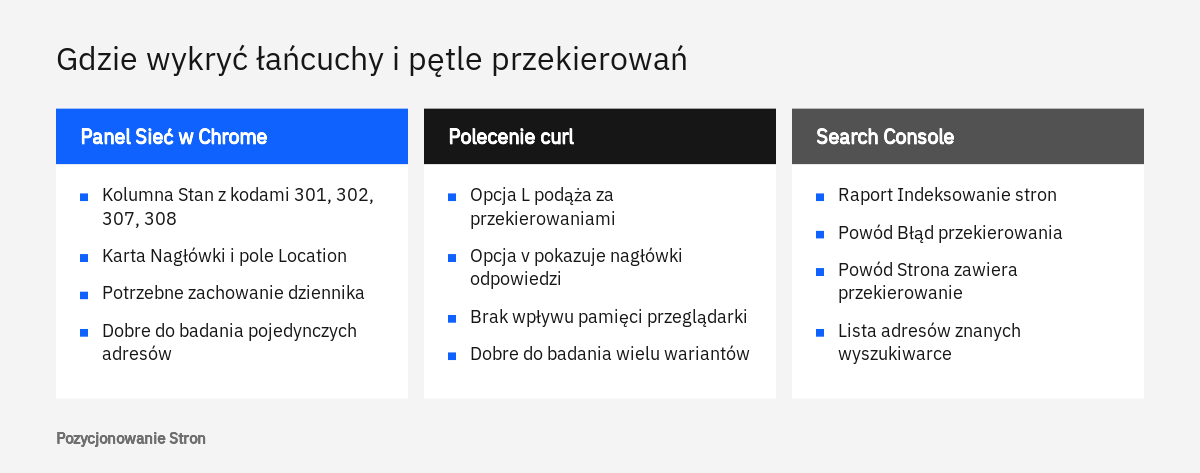
Panel Sieć w przeglądarce Chrome
Narzędzia dla programistów otwiera się klawiszem F12, a potrzebny widok to panel o nazwie Sieć. Przed wpisaniem adresu warto zaznaczyć dwa pola wyboru opisane w dokumentacji panelu: pole odpowiadające za zachowanie dziennika między wczytaniami stron oraz pole wyłączające pamięć podręczną. Bez pierwszego lista żądań jest czyszczona przy każdym przejściu pod nowy adres i wcześniejsze ogniwa znikają. Bez drugiego przeglądarka może odtworzyć trwałe przekierowanie z pamięci i nie zapytać serwera, co bywa mylące tuż po zmianie reguł.
Następnie w pasku adresu wpisuje się badany adres w najstarszej znanej postaci. Na liście żądań pierwsze wiersze od góry to kolejne ogniwa: w kolumnie Stan widać kody 301, 302, 307 lub 308, a dopiero ostatni wiersz dokumentu ma kod 200. Po kliknięciu wiersza w kolumnie Nazwa otwiera się karta Nagłówki, a w niej sekcja Nagłówki odpowiedzi z polem Location, czyli adresem, pod który serwer odesłał przeglądarkę. Spisanie tych adresów po kolei daje pełny obraz łańcucha.
Polecenie curl
Program curl jest dostępny w wierszu poleceń większości współczesnych systemów. Zgodnie z jego dokumentacją domyślnie nie podąża za przekierowaniami, tylko zwraca samą odpowiedź z odesłaniem. Dopiero opcja -L każe mu iść dalej, przy czym program podąża domyślnie za najwyżej 30 przekierowaniami, co chroni go przed nieskończoną pętlą. Opcja -v włącza tryb szczegółowy, w którym widać wszystkie nagłówki wysyłane i odbierane, a wiersze odpowiedzi serwera są poprzedzone znakiem mniejszości.
curl -v -L http://example.com/oferta.html

< HTTP/1.1 301 Moved Permanently
< Location: https://example.com/oferta.html
...
< HTTP/1.1 301 Moved Permanently
< Location: https://www.example.com/oferta.html
...
< HTTP/1.1 301 Moved Permanently
< Location: https://www.example.com/uslugi/
...
< HTTP/1.1 200 OK
Liczba wierszy z kodem 3xx to liczba przeskoków. Gdy zamiast odpowiedzi 200 program kończy pracę komunikatem o przekroczeniu dozwolonej liczby przekierowań, a w wyniku powtarzają się na zmianę te same adresy, mamy do czynienia z pętlą. Warto zbadać w ten sposób nie jeden adres, lecz cały zestaw wariantów: z HTTP i HTTPS, z www i bez, z ukośnikiem i bez, z wielką literą, a także kilka adresów z poprzednich wersji serwisu.
Co pokazuje Search Console
Search Console pokazuje skutki łańcuchów i pętli w raporcie Indeksowanie stron, w dwóch powodach niezindeksowania: Błąd przekierowania oraz Strona zawiera przekierowanie. Raport znajduje się w menu po lewej stronie, w grupie Indeksowanie, pod pozycją Strony, a lista powodów jest w tabeli poniżej wykresu.
Według pomocy Search Console błąd przekierowania może mieć cztery przyczyny: zbyt długi łańcuch przekierowań, pętlę przekierowań, przekierowanie, które ostatecznie przekroczyło maksymalną długość adresu URL, albo nieprawidłowy lub pusty adres w łańcuchu. To jest grupa wymagająca działania: każdy adres z tej listy należy przebadać w nagłówkach odpowiedzi. Pomoc sugeruje też użycie narzędzia do debugowania, takiego jak Lighthouse, aby uzyskać więcej informacji o przekierowaniu. Jak uruchomić to narzędzie, opisujemy we wpisie Lighthouse: audyt strony w Chrome.
Druga grupa, Strona zawiera przekierowanie, sama w sobie nie oznacza błędu. Pomoc opisuje taki adres jako niekanoniczny, który przekierowuje do innej strony, i wyjaśnia, że nie zostanie on zindeksowany, natomiast adres docelowy może, ale nie musi trafić do indeksu. Stare adresy po przebudowie serwisu powinny znajdować się właśnie tutaj. Lista ta jest jednak cennym materiałem roboczym: to gotowy spis adresów, które Google zna i odwiedza, więc warto pobrać ją i sprawdzić, ile przeskoków ma każdy z nich.
| Co widać | Co to oznacza | Co zrobić |
|---|---|---|
| Błąd przekierowania | Zbyt długi łańcuch, pętla, za długi adres albo błędny lub pusty adres w łańcuchu | Zbadać nagłówki odpowiedzi i poprawić reguły na serwerze |
| Strona zawiera przekierowanie | Adres niekanoniczny, który odsyła do innej strony | Zwykle nic, poza sprawdzeniem liczby przeskoków i celu |
| Adres z mapy witryny w grupie z przekierowaniem | Mapa podaje nieaktualne adresy | Wymienić adresy w mapie na końcowe |
| Lighthouse zgłasza wielokrotne przekierowania | Badany adres ma co najmniej 2 przekierowania | Skrócić łańcuch i poprawić linki prowadzące do strony |
Sprawdzanie pojedynczego adresu
Narzędzie do sprawdzania adresów URL, dostępne w polu wyszukiwania u góry ekranu Search Console, ma przy przekierowaniach istotne ograniczenie. Jak podaje pomoc tego narzędzia, test wersji opublikowanej podąża za wszystkimi przekierowaniami, ale nie informuje, że one wystąpiły, ani nie pokazuje adresu, który ostatecznie przetestował. Poprawny wynik testu nie dowodzi więc, że łańcucha nie ma. Więcej mówią dane o wersji zindeksowanej: pola Pobranie strony, Strona odsyłająca, Adres kanoniczny określony przez użytkownika i Adres kanoniczny wybrany przez Google. Obsługę tego ekranu opisujemy we wpisie sprawdzanie adresu URL w Search Console.
Jak uporządkować reguły na serwerze
Porządkowanie polega na tym, by każdy adres źródłowy wskazywał bezpośrednio adres końcowy, a reguły ogólne dla domeny zostały połączone w jedną. Starych przekierowań się przy tym nie usuwa, tylko zmienia ich cel.
Pracę warto zacząć od ustalenia jednej, ostatecznej postaci adresu: z szyfrowaniem, z www albo bez, z ukośnikiem na końcu albo bez, małymi literami. Dopiero wobec takiego wzorca można ocenić, które reguły są potrzebne.
- Spis wszystkich miejsc z regułami
Plik konfiguracyjny serwera, panel hostingu, sieć dostarczania treści, wtyczki i ustawienia systemu zarządzania treścią. Reguły trafiają do jednego arkusza z kolumnami: adres źródłowy, adres docelowy, kod.
- Spłaszczenie mapy
Dla każdego adresu źródłowego ustala się adres, pod którym łańcuch się kończy, i wpisuje go jako nowy cel. Jeżeli A prowadziło do B, a B do C, to po zmianie zarówno A, jak i B prowadzą prosto do C.
- Połączenie reguł ogólnych
Szyfrowanie i wybór wersji z www powinny być obsłużone jednym przekierowaniem, a nie dwoma kolejnymi.
- Właściwa kolejność
Reguły szczegółowe dla konkretnych starych adresów umieszcza się przed regułami ogólnymi i od razu z pełnym adresem końcowym.
- Jedno miejsce zarządzania
Te same zasady nie powinny być powielone na serwerze, w panelu i we wtyczce. Dublowanie to najprostsza droga do pętli.
- Ponowny pomiar
Po wdrożeniu cały zestaw adresów testowych bada się jeszcze raz w nagłówkach odpowiedzi. Każdy powinien mieć najwyżej jeden przeskok.
Przykłady reguł łączonych
Dokumentacja Google pokazuje podstawowe sposoby ustawiania przekierowań na dwóch popularnych serwerach: w Apache służą do tego moduły mod_alias i mod_rewrite, a w nginx dyrektywy return oraz rewrite. Poniższy zapis dla Apache łączy dwa warunki, brak szyfrowania oraz niewłaściwą nazwę hosta, w jedną regułę, która od razu wysyła pod pełny adres docelowy.
RewriteEngine On

# stary adres od razu do adresu koncowego
RewriteRule ^oferta\.html$ https://www.example.com/uslugi/ [R=301,L]

# jedna regula ogolna zamiast dwoch
RewriteCond %{HTTPS} off [OR]
RewriteCond %{HTTP_HOST} !^www\.example\.com$ [NC]
RewriteRule ^(.*)$ https://www.example.com/$1 [R=301,L]
Dwa szczegóły z dokumentacji flag modułu mod_rewrite mają tu duże znaczenie. Flaga R bez podanego kodu oznacza przekierowanie 302, więc przy trwałej zmianie adresu kod 301 trzeba wpisać wprost. Flaga L kończy przetwarzanie zestawu reguł, ale w plikach konfiguracji katalogów przepisane żądanie może zostać przetworzone ponownie od początku, co według dokumentacji bywa źródłem pętli.
server {
    listen 80;
    server_name example.com www.example.com;
    return 301 https://www.example.com$request_uri;
}

server {
    listen 443 ssl;
    server_name example.com;
    return 301 https://www.example.com$request_uri;
}Co poprawić poza serwerem
Same reguły nie wystarczą, bo najlepsze przekierowanie to takie, które w ogóle nie jest potrzebne. Po skróceniu łańcuchów trzeba jeszcze zadbać, aby własne odnośniki serwisu prowadziły od razu pod adresy końcowe.
Dokument Google o przenoszeniu witryny zaleca zastąpienie starych adresów w linkach wewnętrznych nowymi, zaktualizowanie znaczników kanonicznych oraz adnotacji hreflang, a także przesłanie mapy witryny z nowymi adresami. Dotyczy to menu, stopki, okruszków, linków w treści wpisów i banerów, a w sklepie także powiązań między produktami. Ten sam dokument radzi utrzymywać przekierowania możliwie długo, zwykle co najmniej rok, oraz zadbać o aktualizację najważniejszych linków z innych serwisów.
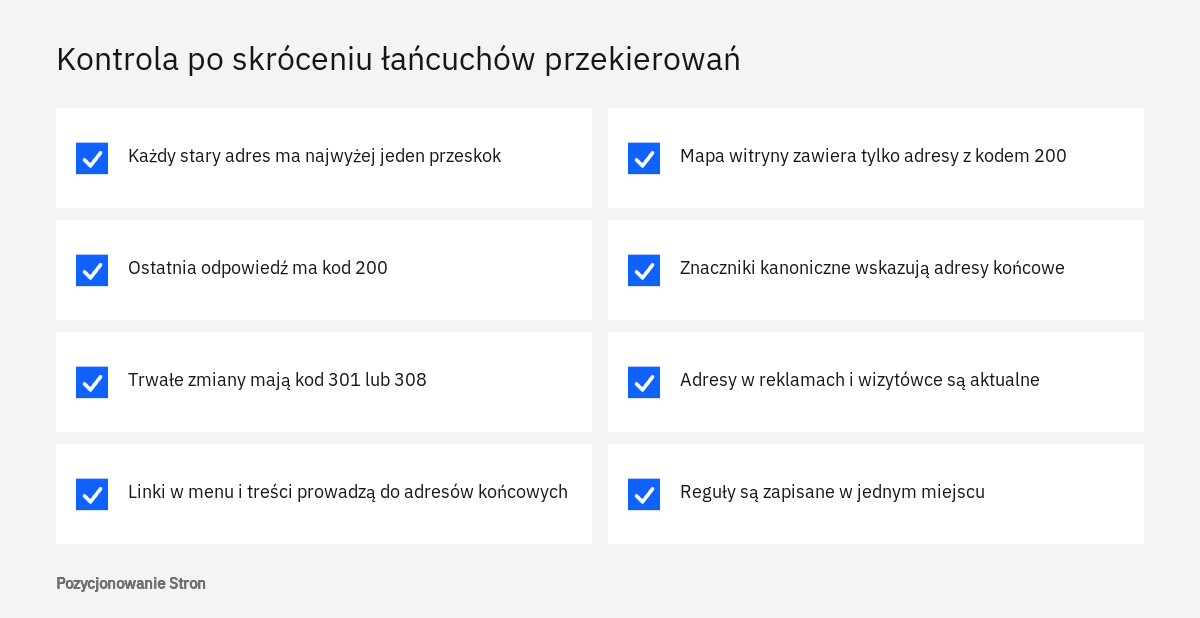
- Każdy adres testowy ma najwyżej jeden przeskok i kończy się odpowiedzią 200.
- W łańcuchach nie ma przekierowań tymczasowych tam, gdzie zmiana jest trwała.
- Linki w menu, stopce i treści prowadzą pod adresy końcowe.
- Mapa witryny zawiera wyłącznie adresy zwracające kod 200.
- Znaczniki kanoniczne i hreflang wskazują adresy końcowe, nie pośrednie.
- Adresy docelowe reklam i linków w wizytówce Google są aktualne.
- Stare domeny używane w przekierowaniach są nadal opłacone.
- Reguły są zapisane w jednym miejscu i opisane komentarzami.
Zasady przygotowania mapy opisujemy we wpisie mapa witryny XML, a kwestie znaczników kanonicznych we wpisie adres kanoniczny. Warto też przyjąć w firmie prostą zasadę na przyszłość: każda zmiana adresu kończy się przeglądem reguł, które wskazywały adres zmieniany.
Typowe pomyłki i kiedy potrzebna jest pomoc
Najczęstszą pomyłką jest usunięcie starych reguł w ramach porządków. Dawne adresy wciąż mają linki z innych stron i wciąż są odwiedzane, więc po usunięciu reguły zaczynają zwracać błąd 404. Regułę należy skrócić, czyli zmienić jej cel, a nie usunąć.
Druga pomyłka to skierowanie wszystkich starych adresów na stronę główną. Google ostrzega, że przekierowanie wielu adresów w jedno nietrafne miejsce dezorientuje użytkowników i może zostać potraktowane jako pozorny błąd 404. Każdy stary adres powinien prowadzić do swojego odpowiednika. Trzecia pomyłka to pozostawienie kodu 302 po pracach testowych, a czwarta to zastępowanie reguł serwera przekierowaniami w JavaScripcie, których Google zaleca używać tylko wtedy, gdy przekierowania po stronie serwera nie są możliwe.
Piąta pomyłka dotyczy sprawdzania efektów. Z naszej praktyki wynika, że przeglądarka potrafi odtwarzać zapamiętane przekierowanie trwałe, więc po zmianie reguł wynik warto potwierdzić poleceniem curl albo przy wyłączonej pamięci podręcznej.
Samodzielna naprawa jest realna na małej stronie z kilkunastoma regułami. Wsparcie specjalisty przydaje się wtedy, gdy reguły pochodzą z kilku przebudów i liczą setki pozycji, gdy przed serwerem działa pośrednik, gdy serwis ma wersje językowe albo gdy zbliża się kolejna zmiana adresów. Porządkowanie przekierowań jest stałym elementem prac w ramach usługi SEO techniczne i jednym z punktów, które obejmuje audyt SEO. Przy planowanej zmianie domeny lub serwera mapę przekierowań warto przygotować jeszcze przed startem, o czym piszemy we wpisie migracja strony a SEO.
Jeśli chcą Państwo zamówić SEO techniczne, zachęcamy do kontaktu: tel. 222 500 844 lub mailowo: biuro@pozycjonowaniestron.pl
Najczęstsze pytania
Czy jedno przekierowanie szkodzi pozycjom strony?
Pojedyncze przekierowanie to normalny sposób zmiany adresu i Google je obsługuje. Według dokumentacji przy przekierowaniu trwałym w wynikach pokazuje się strona docelowa. Problemem są dopiero sekwencje kilku przekierowań oraz pętle.
Ile przekierowań pod rząd to już za dużo?
Roboty Google domyślnie śledzą do 10 przeskoków, ale Google zaleca przekierowywać od razu do celu. Gdy to niemożliwe, łańcuch powinien mieć najlepiej nie więcej niż 3 kolejne adresy i nigdy więcej niż 5. Audyt Lighthouse zgłasza uwagę już przy 2 przekierowaniach.
Jak rozpoznać pętlę przekierowań?
W przeglądarce strona się nie otwiera, a zamiast niej pojawia się komunikat o zbyt wielu przekierowaniach. W nagłówkach odpowiedzi widać te same adresy powtarzające się na zmianę, bez odpowiedzi z kodem 200. Search Console wymienia pętlę wśród przyczyn statusu Błąd przekierowania.
Czy po skróceniu łańcucha można usunąć stare reguły?
Nie należy ich usuwać, tylko zmienić ich cel na adres końcowy. Google radzi utrzymywać przekierowania możliwie długo, zwykle co najmniej rok. Dopóki do starego adresu prowadzą linki z innych stron, reguła jest potrzebna.
Dlaczego test w Search Console nie pokazuje łańcucha?
Test wersji opublikowanej podąża za przekierowaniami i bada stronę końcową, ale nie informuje, że przekierowania wystąpiły. Liczbę przeskoków trzeba sprawdzić w nagłówkach odpowiedzi, na przykład w panelu Sieć przeglądarki Chrome lub poleceniem curl.
Czy łańcuchy przekierowań mają znaczenie dla małej strony firmowej?
Budżet indeksowania dotyczy głównie dużych serwisów, więc mała strona raczej nie odczuje problemów ze skanowaniem. Odczuje natomiast wolniejsze otwieranie strony przez klientów oraz ryzyko, że jedno zepsute ogniwo odetnie stare linki.
Źródła
- Przekierowania a wyszukiwarka Google, Centrum wyszukiwarki Google
- Jak kody stanu HTTP wpływają na roboty Google, Google for Developers
- Przenoszenie witryny i migracja, Centrum wyszukiwarki Google
- Zarządzanie budżetem indeksowania, Google for Developers
- Raport Indeksowanie stron, Search Console - pomoc
- Narzędzie do sprawdzania adresów URL, Search Console - pomoc
- Unikaj wielokrotnych przekierowań, Chrome for Developers
- Informacje o funkcjach sieci, Chrome for Developers
- RewriteRule Flags, Apache HTTP Server
- Redirects, everything curl
- redirect_canonical(), Developer.WordPress.org
Funkcje wyszukiwarek i asystentów AI zmieniają się szybko, dlatego wpis aktualizujemy po większych zmianach.