Narzędzie do sprawdzania adresów URL w Search Console pokazuje, co Google wie o jednej, konkretnej podstronie: czy jest w indeksie, kiedy była ostatnio skanowana, czy robot mógł ją pobrać i który adres został uznany za kanoniczny. Poniżej opisujemy, jak odczytać każdą część wyniku, czym różnią się dane z indeksu od testu wersji opublikowanej oraz kiedy prośba o zindeksowanie rzeczywiście pomaga, a kiedy niczego nie zmienia.
Czym jest narzędzie do sprawdzania adresów URL i gdzie je znaleźć
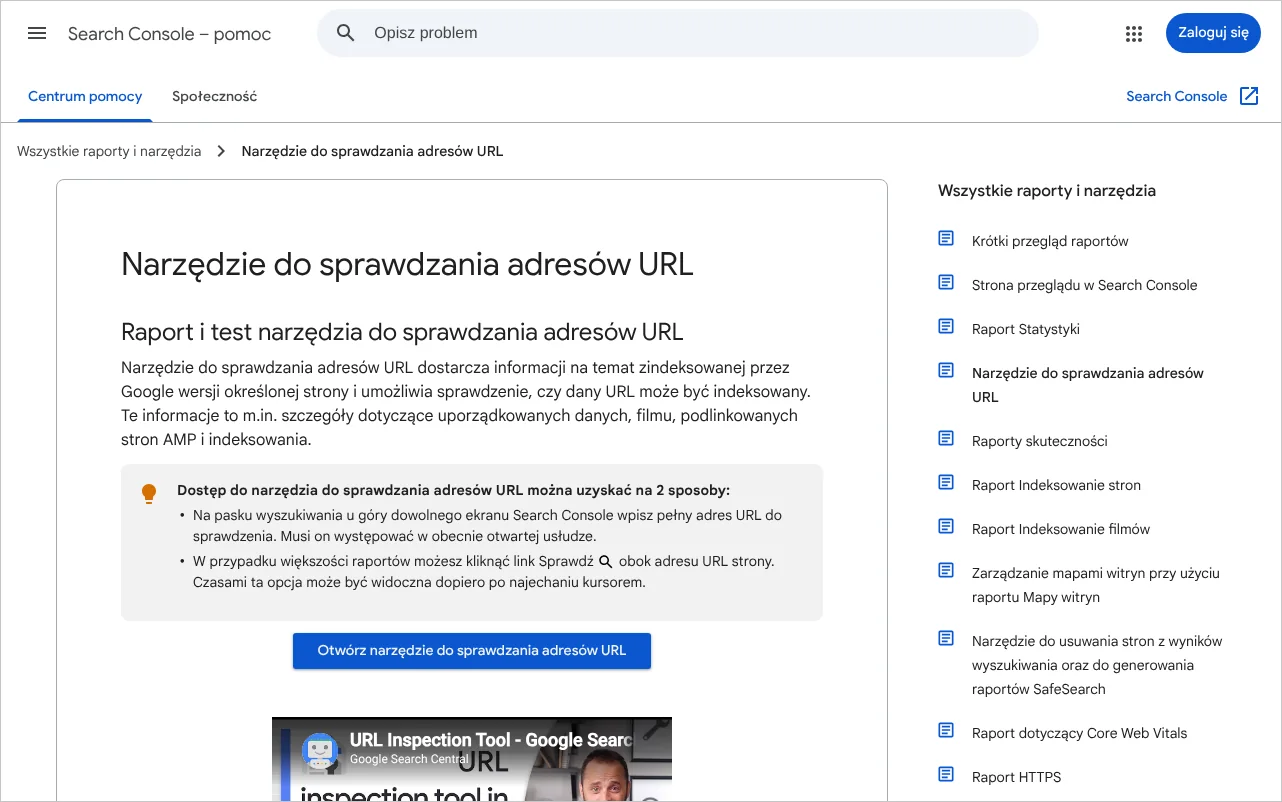
Narzędzie do sprawdzania adresów URL to część Search Console, która dla pojedynczego adresu pokazuje wersję strony zapisaną w indeksie Google oraz pozwala przetestować, czy aktualna wersja strony nadaje się do zindeksowania. Zgodnie z pomocą Search Console wynik obejmuje także informacje o uporządkowanych danych, filmach i stronach AMP, czyli przyspieszonych stronach mobilnych.
Do narzędzia prowadzą dwie drogi. Pierwsza to pasek wyszukiwania u góry każdego ekranu Search Console: wystarczy wkleić w nim pełny adres podstrony razem z protokołem i zatwierdzić klawiszem Enter. Druga to opcja sprawdzenia adresu, która pojawia się przy pojedynczych pozycjach w wielu raportach, na przykład na liście przykładowych adresów w raporcie Indeksowanie stron. W obu przypadkach otwiera się ten sam ekran wyniku.
Jest jedno ograniczenie, o którym łatwo zapomnieć: adres musi należeć do usługi, która jest w danej chwili otwarta w Search Console. Jeśli firma ma osobno dodaną wersję z przedrostkiem www i bez niego albo osobne usługi dla subdomen, adres wklejony w niewłaściwej usłudze nie zostanie sprawdzony. Samą prośbę o zindeksowanie mogą wysłać tylko właściciel usługi albo użytkownik z pełnym dostępem, co wynika z dokumentacji Centrum wyszukiwarki Google.
Zbiór informacji o stronach, które Google zeskanował, przeanalizował i zapisał, aby móc je pokazywać w wynikach wyszukiwania. Strona, której nie ma w indeksie, nie wyświetli się w wynikach.
Żeby wynik narzędzia był zrozumiały, dobrze mieć w pamięci trzy etapy pracy wyszukiwarki opisane w dokumencie Jak działa wyszukiwarka Google. Najpierw robot wykrywa adres i skanuje stronę, przy czym uruchamia także skrypty JavaScript, aby odczytać treść, która ładuje się dopiero w przeglądarce. Potem następuje indeksowanie, czyli analiza treści i decyzja, czy i pod jakim adresem zapisać stronę. Na końcu jest wyświetlanie wyników. Narzędzie do sprawdzania adresów opisuje dwa pierwsze etapy i tylko pośrednio mówi cokolwiek o trzecim.
Dane z indeksu a test wersji opublikowanej: dwa różne wyniki
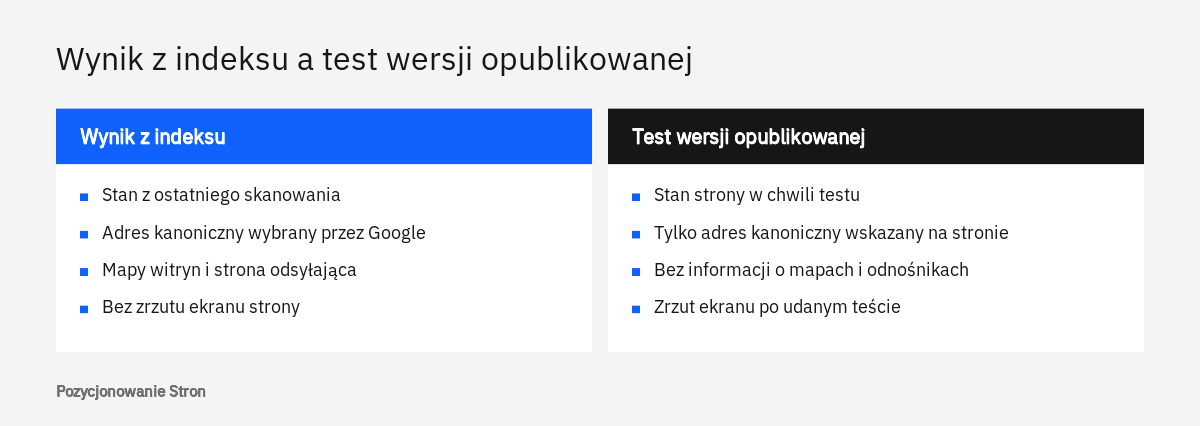
Narzędzie zwraca dwa rodzaje wyników i to rozróżnienie jest podstawą poprawnego odczytu: wynik z indeksu opisuje stronę taką, jaką Google zapamiętał przy ostatnim skanowaniu, a test wersji opublikowanej pobiera stronę w czasie rzeczywistym. Pierwszy wynik pojawia się od razu po wklejeniu adresu. Drugi trzeba uruchomić osobno, przyciskiem testu wersji opublikowanej w prawym górnym rogu ekranu wyniku.
Z tego podziału wynika najczęstsze nieporozumienie. Jeżeli rano usunięto ze strony znacznik noindex, a po południu narzędzie nadal pokazuje, że indeksowanie jest niedozwolone, nie oznacza to błędu w poprawce. Wynik z indeksu po prostu nadal opisuje poprzednie skanowanie. Pomoc Search Console mówi wprost, że po takich zmianach oba wyniki mogą się różnić do czasu, aż Google ponownie zeskanuje stronę. Dopiero test wersji opublikowanej pokazuje, jak strona wygląda dla Google w tej chwili.
| Cecha | Wynik z indeksu | Test wersji opublikowanej |
|---|---|---|
| Czego dotyczy | Stanu z ostatniego skanowania | Stanu strony w chwili testu |
| Adres kanoniczny wybrany przez Google | Jest podany | Nie jest podany, widać tylko adres wskazany przez właściciela |
| Mapy witryn i strona odsyłająca | Są podane, jeśli Google je zna | Test ich nie sprawdza |
| Zrzut ekranu strony | Niedostępny | Dostępny po udanym teście |
| Przekierowania | Wynik dotyczy wpisanego adresu, a nie adresu docelowego | Test przechodzi przez przekierowanie i bada stronę docelową, ale tego nie sygnalizuje |
| Wymagania | Adres w otwartej usłudze | Strona dostępna publicznie, bez logowania |
Szczególnej uwagi wymaga wiersz o przekierowaniach. Test wersji opublikowanej najpierw podąża za przekierowaniem, a dopiero potem bada stronę, jednak nie informuje, że do przekierowania doszło, i nie pokazuje adresu końcowego. Można więc otrzymać poprawny wynik dla adresu, który sam niczego nie wyświetla, bo odsyła gdzie indziej. Wynik z indeksu dotyczy z kolei adresu wpisanego, dlatego stan strony docelowej trzeba sprawdzić osobno, pod jej własnym adresem. Zasady doboru rodzaju przekierowania opisujemy we wpisie o tym, czym różni się przekierowanie 301 od 302.
Test na żywo wykonuje osobny robot o nazwie Google-InspectionTool. Z wykazu typowych robotów Google wynika, że służy on narzędziom testowym, takim jak sprawdzanie adresów w Search Console czy test wyników z elementami rozszerzonymi, i nie ma wpływu na samą wyszukiwarkę. Ma to znaczenie dla firm, których serwer albo zapora sieciowa filtrują ruch robotów: jeśli zwykły robot Google jest wpuszczany, a robot testowy blokowany, test pokaże brak dostępu, mimo że indeksowanie działa poprawnie.
Jak czytać ogólny stan adresu na górze wyniku
Pierwsza karta wyniku podaje jedno z kilku krótkich podsumowań i to od niego warto zacząć lekturę. Komunikat, że adres URL znajduje się w Google, oznacza, że strona jest w indeksie i może wyświetlać się w wynikach. Pomoc Search Console zaznacza przy tym, że nie jest to gwarancja wyświetlania. Drugi wariant mówi, że adres znajduje się w Google, ale występują związane z nim problemy: strona jest w indeksie, lecz narzędzie znalazło ostrzeżenia albo błędy w części dotyczącej ulepszeń, na przykład w uporządkowanych danych. Trzeci komunikat, że adres URL nie znajduje się w Google, oznacza, że strona nie pojawi się w wynikach, a przyczynę podaje niższa część wyniku.
Pod podsumowaniem znajdują się rozwijane sekcje. Najważniejsza nosi nazwę Indeksowanie stron i zawiera wszystko, co dotyczy wykrycia adresu, skanowania i wyboru adresu kanonicznego. Niżej umieszczono część Ulepszenia, w której narzędzie wymienia rozpoznane typy wyników z elementami rozszerzonymi i ewentualne błędy w ich oznaczeniu.
W sekcji Indeksowanie stron pierwszy wiersz to stan indeksowania. Przyjmuje on jedną z trzech postaci: strona została zindeksowana, strony nie ma w indeksie albo strony nie ma w indeksie, ponieważ adres URL jest Google nieznany. Ostatni wariant oznacza, że wyszukiwarka jeszcze nie wykryła tego adresu. Nie jest to błąd strony. Przy nowych podstronach to częsty i zupełnie naturalny wynik.
Gdy strony nie ma w indeksie, obok stanu wyświetlana jest przyczyna, taka sama jak w raporcie Indeksowanie stron. Dwie z nich brzmią podobnie, a znaczą coś innego. Status "Strona wykryta - obecnie niezindeksowana" mówi, że Google zna adres, ale jeszcze go nie zeskanował, dlatego pole z datą ostatniego skanowania jest puste. Status "Strona zeskanowana, ale jeszcze niezindeksowana" mówi, że robot stronę odwiedził, lecz nie dodał jej do indeksu, i według opisu raportu Indeksowanie stron ponowne zgłaszanie adresu nie jest wtedy potrzebne. Pełne omówienie przyczyn zawiera nasz wpis o tym, dlaczego Google nie indeksuje strony.
Co oznaczają pola o wykryciu i skanowaniu strony
Pola w sekcji Indeksowanie stron odpowiadają na trzy pytania: skąd Google zna ten adres, czy mógł pobrać stronę i czy wolno mu ją zindeksować. Pierwszą grupę, dotyczącą wykrycia, tworzą dwa wiersze. Mapy witryn wymieniają mapy, w których znajduje się adres, ale tylko te przesłane w raporcie Mapy witryn albo wskazane w pliku robots.txt. Strona odsyłająca to strona, przez którą Google prawdopodobnie znalazł adres. Brak wartości w tym wierszu nie znaczy, że do podstrony nie prowadzą żadne odnośniki, a jedynie że narzędzie nie ma tej informacji.
Druga grupa dotyczy skanowania. Każde pole ma zamknięty zestaw wartości, więc łatwo je zestawić w jednym miejscu.
| Pole w wyniku | Co pokazuje | Na co zwrócić uwagę |
|---|---|---|
| Ostatnie skanowanie | Datę i godzinę ostatniej wizyty robota, w czasie lokalnym | Jeżeli zmiany na stronie są późniejsze, wynik z indeksu ich nie uwzględnia |
| Zindeksowano jako | Rodzaj robota: komputer albo urządzenie mobilne | Pole wskazuje, którą wersję strony odczytał robot |
| Czy skanowanie jest dozwolone | Tak albo Nie, zależnie od reguł w pliku robots.txt | Wartość Nie oznacza, że robot nie odczytał treści strony |
| Pobranie strony | Udało się, Niepowodzenie albo Nie dotyczy | Niepowodzenie wskazuje na problem po stronie serwera, przekierowań lub dostępu |
| Czy indeksowanie jest dozwolone | Tak albo Nie, zależnie od dyrektywy noindex | Przy blokadzie w robots.txt pole zawsze pokazuje Tak |
Ostatni wiersz tabeli opisuje pułapkę, która w audytach powtarza się regularnie. Jeśli adres jest zablokowany w pliku robots.txt, Google nie pobiera strony, a więc nie może odczytać umieszczonej na niej dyrektywy noindex. Narzędzie pokazuje wtedy, że indeksowanie jest dozwolone, choć właściciel strony zamierzał je wyłączyć. Z opisu raportu Indeksowanie stron wynika ponadto, że sama blokada w robots.txt nie gwarantuje, iż adres nie znajdzie się w indeksie. Różnice między tymi mechanizmami opisujemy we wpisie o tym, czym różnią się canonical, noindex i robots.txt.
<meta name="robots" content="noindex">Przykład z praktyki: firma remontowa z Bydgoszczy uruchomiła nową stronę, a w szablonie pozostał znacznik noindex z okresu budowy. Wynik z indeksu pokazywał, że indeksowanie jest niedozwolone. Po usunięciu znacznika wynik ten przez pewien czas pozostawał bez zmian, natomiast test wersji opublikowanej od razu potwierdził, że adres może być indeksowany.
Jak odczytać sekcję o wyborze adresu kanonicznego
Ostatnia grupa pól w sekcji Indeksowanie stron pokazuje dwa adresy: kanoniczny określony przez użytkownika oraz kanoniczny wybrany przez Google. Jeśli są takie same, a sprawdzany adres jest jednym z nich, strona jest indeksowana pod własnym adresem. Jeśli się różnią, w wynikach wyszukiwania pojawia się inny adres niż ten, który Państwo sprawdzają, a badana podstrona jest traktowana jako duplikat.
Pierwsze pole zawiera to, co zadeklarowano na stronie: wartość ze znacznika rel=canonical, z nagłówka odpowiedzi serwera albo z mapy witryny. Jeżeli niczego nie wskazano, pojawia się słowo Brak. Drugie pole pokazuje decyzję wyszukiwarki. Dokumentacja Google dotycząca wyboru strony kanonicznej wyjaśnia, że deklaracja właściciela jest wskazówką, a nie poleceniem. Wyszukiwarka grupuje strony o takiej samej lub bardzo podobnej treści głównej i wybiera tę, którą na podstawie zebranych sygnałów uznaje za najbardziej kompletną i użyteczną. Do sygnałów należą między innymi protokół HTTPS, przekierowania, obecność adresu w mapie witryny oraz znaczniki rel=canonical.
Rozbieżność między polami najczęściej widać w sklepach. Sklep z Poznania ma tę samą listę produktów dostępną pod adresem kategorii oraz pod adresami z parametrami sortowania i filtrowania. Przy niemal identycznej treści Google może wybrać adres kategorii i oznaczyć pozostałe jako duplikaty. W raporcie Indeksowanie stron odpowiada temu status "Duplikat, wyszukiwarka Google wybrała inną stronę kanoniczną niż użytkownik". Sam w sobie nie jest to powód do niepokoju, o ile wybrany adres jest tym, który ma się wyświetlać klientom.
Gorzej, gdy Google wybiera adres niepożądany, na przykład wersję z parametrem zamiast czystego adresu kategorii. Wtedy trzeba uporządkować sygnały: ujednolicić linkowanie wewnętrzne, poprawić znaczniki, usunąć z mapy witryny adresy, które nie mają być indeksowane, i wyraźnie zróżnicować treść stron, które mają istnieć osobno. Zasady wdrożenia opisujemy we wpisie o tym, jak poprawnie wdrożyć adres kanoniczny.
Przy tym polu obowiązują dwa zastrzeżenia z pomocy Search Console. Wartość adresu wybranego przez Google może aktualizować się z kilkugodzinnym opóźnieniem. Ponadto pole to jest dostępne tylko w wyniku z indeksu, ponieważ wybór adresu kanonicznego zapada dopiero podczas indeksowania. Test wersji opublikowanej pokazuje wyłącznie deklarację właściciela.
Jeśli chcą Państwo zamówić SEO techniczne, zachęcamy do kontaktu: tel. 222 500 844 lub mailowo: biuro@pozycjonowaniestron.pl
Podgląd wyrenderowanej strony: co naprawdę widzi robot
Podgląd pokazuje stronę tak, jak odebrał ją Google: zwrócony kod HTML, nagłówki odpowiedzi serwera, komunikaty konsoli JavaScript oraz listę załadowanych zasobów. W wyniku z indeksu otwiera go przycisk wyświetlenia zindeksowanej strony, a po teście na żywo przycisk wyświetlenia przetestowanej strony. Obie opcje znajdują się tuż pod ogólnym stanem adresu.
Między tymi dwoma podglądami jest istotna różnica. Zrzut ekranu, czyli obraz strony po wyrenderowaniu, jest dostępny wyłącznie po udanym teście wersji opublikowanej. Dla wersji z indeksu pomoc Search Console wprost wskazuje, że zrzuty ekranu są niedostępne.
Renderowanie to przetworzenie kodu strony do postaci, którą widzi odwiedzający, łącznie z wykonaniem skryptów. Ma ono znaczenie zwłaszcza w serwisach, w których treść jest dokładana przez JavaScript: opisy produktów, opinie, cenniki, listy realizacji. Jeżeli w podglądzie kodu HTML brakuje tekstu, który widać w przeglądarce, to znak, że robot go nie otrzymał. Z naszej praktyki wynika, że przyczyn bywa kilka: skrypt zablokowany w pliku robots.txt, błąd w kodzie widoczny w komunikatach konsoli, zasób z innej domeny, którego nie udało się pobrać, albo treść pojawiająca się dopiero po kliknięciu.
Lista załadowanych zasobów pozwala znaleźć takie przypadki bez zgadywania. Nie każda pozycja oznacza problem. Pliki narzędzi analitycznych nie wpływają na odczytanie treści, natomiast zablokowany arkusz stylów albo skrypt budujący główną część strony już tak. Dlatego listę warto przejrzeć pod kątem tego, co odpowiada za treść i układ, a resztę pominąć.
Test na żywo potrafi też zgłosić problemy dotyczące całej witryny, a nie jednej podstrony. Pomoc Search Console wymienia wśród nich kłopoty z systemem nazw domen, brak połączenia z serwerem, nieprawidłowy certyfikat SSL, niedostępny plik robots.txt oraz przekroczony limit obciążenia hosta. Taki wynik oznacza, że sprawa wykracza poza treść i znaczniki, i najczęściej wymaga kontaktu z administratorem serwera. O wpływie serwera na skanowanie piszemy we wpisie o tym, jak hosting wpływa na indeksowanie strony.
Kiedy prośba o zindeksowanie ma sens
Prośba o zindeksowanie ma sens wtedy, gdy chodzi o pojedynczy, ważny adres: nową podstronę, której Google jeszcze nie zna, albo stronę po istotnej zmianie, na przykład po naprawie błędu blokującego indeksowanie. Przycisk z prośbą znajduje się na ekranie wyniku, obok ogólnego stanu adresu, a zgłoszenie poprzedza test wersji opublikowanej.
Dokumentacja Google opisuje tę funkcję bardzo powściągliwie. Skanowanie może nastąpić po kilku dniach, ale może też zająć kilka tygodni. Zgłoszenie nie gwarantuje, że strona trafi do indeksu szybko ani że trafi do niego w ogóle. Wielokrotne zgłaszanie tego samego adresu niczego nie przyspiesza. Google podkreśla, że pierwszeństwo mają wysokiej jakości treści przydatne użytkownikom.
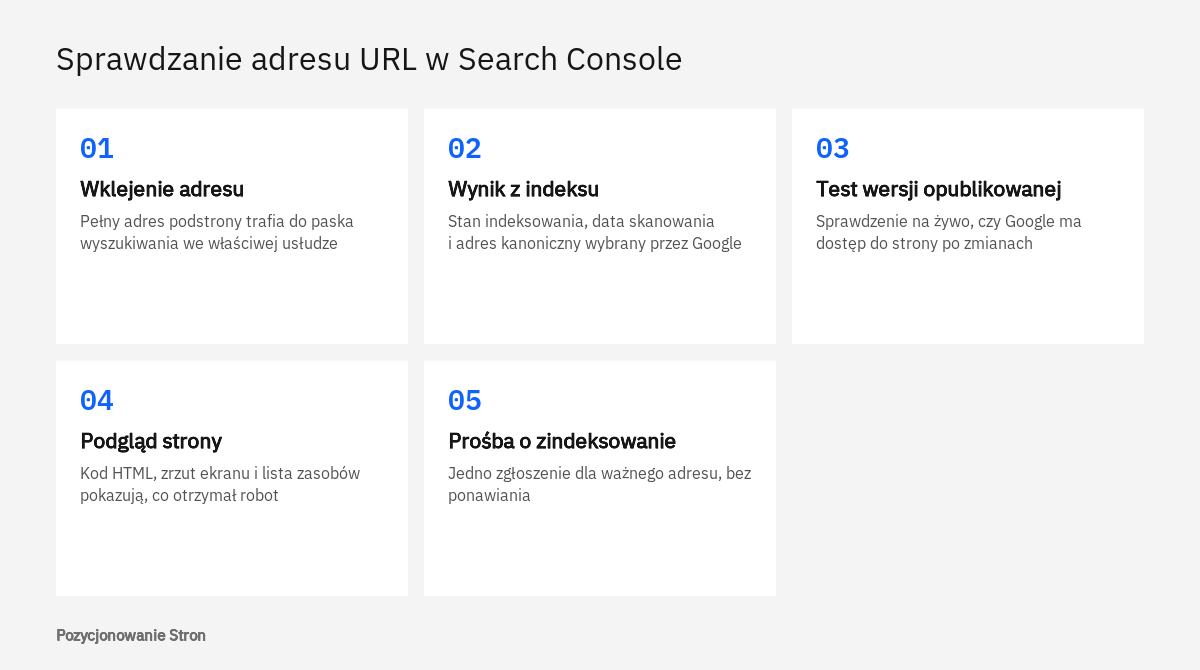
- Wklejenie pełnego adresu
Adres należy wpisać w pasek wyszukiwania Search Console, w usłudze, do której należy podstrona.
- Odczytanie wyniku z indeksu
Stan indeksowania, data ostatniego skanowania i oba adresy kanoniczne pokazują, jak Google widział stronę do tej pory.
- Test wersji opublikowanej
Test potwierdza, czy po wprowadzonych zmianach Google ma dostęp do strony i czy indeksowanie jest dozwolone.
- Przegląd podglądu strony
Kod HTML, zrzut ekranu i lista zasobów pozwalają ocenić, czy robot otrzymał pełną treść.
- Prośba o zindeksowanie
Zgłoszenie wysyła się raz, a postęp obserwuje w tym samym narzędziu albo w raporcie Indeksowanie stron.
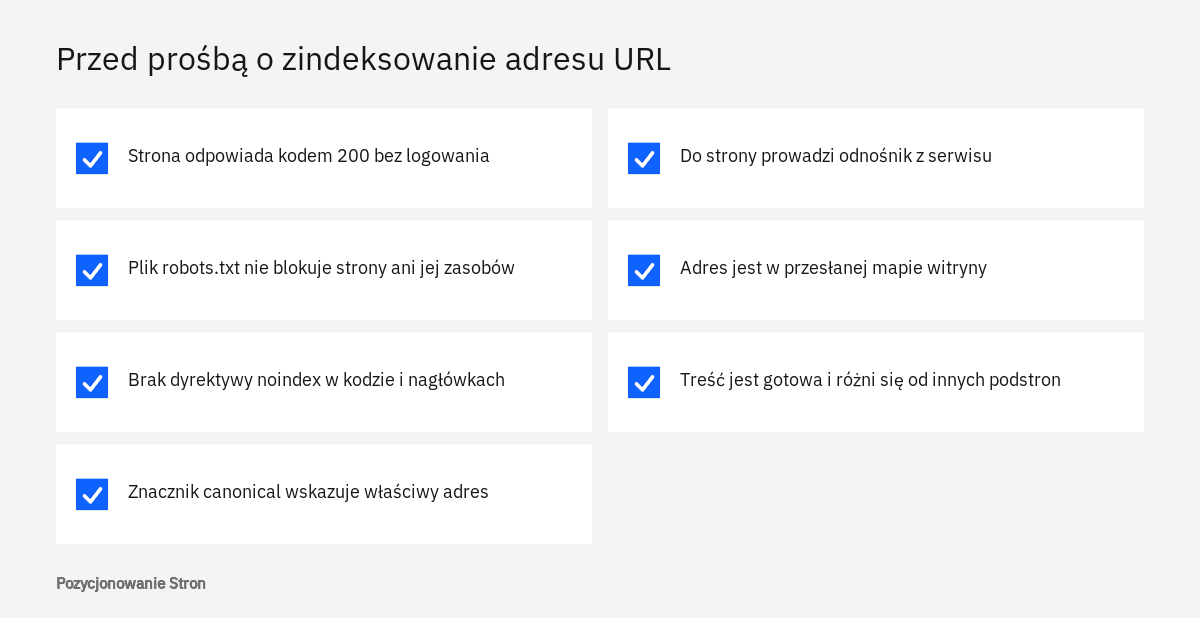
Przed wysłaniem prośby dobrze jest przejść przez krótką listę. Zgłaszanie adresu, który ma niedokończoną treść albo błędne znaczniki, niczego nie przyspiesza, a zużywa dzienny limit.
- Strona odpowiada kodem 200 i jest dostępna bez logowania.
- Plik robots.txt nie blokuje ani samej strony, ani zasobów potrzebnych do jej wyświetlenia.
- W kodzie i w nagłówkach serwera nie ma dyrektywy noindex.
- Znacznik rel=canonical wskazuje ten adres, który ma się wyświetlać w wynikach.
- Do strony prowadzi przynajmniej jeden odnośnik z innej podstrony serwisu.
- Adres znajduje się w mapie witryny przesłanej do Search Console.
- Treść jest gotowa, a nie robocza, i różni się od pozostałych podstron.
Są też sytuacje, w których prośba nie pomoże. Jeśli strona ma status "Strona zeskanowana, ale jeszcze niezindeksowana", robot już ją odwiedził, więc kolejne zgłoszenie nie wnosi nowej informacji. Z naszej praktyki wynika, że wtedy lepsze skutki daje praca nad samą stroną: rozbudowa treści, wyraźne odróżnienie jej od podobnych podstron i mocniejsze linkowanie wewnętrzne. Prośba nie rozwiąże także problemu duplikatu, bo o wyborze adresu kanonicznego decydują sygnały, a nie liczba zgłoszeń.
Przy większej liczbie adresów, na przykład po dodaniu kilkuset produktów albo po przebudowie serwisu, Google zaleca przesłanie mapy witryny zamiast pojedynczych zgłoszeń. Według dokumentacji o przygotowywaniu i przesyłaniu mapy witryny pojedynczy plik mapy może zawierać do 50 000 adresów i mieć do 50 MB bez kompresji. Znacznik lastmod, czyli data ostatniej istotnej zmiany strony, jest brany pod uwagę wtedy, gdy jest podawany spójnie i zgodnie z prawdą, natomiast znaczniki priority i changefreq Google pomija. Szczegóły zawiera nasz wpis o tym, jak przygotować mapę witryny XML.
Jakie są limity i czego narzędzie nie gwarantuje
Narzędzie ma trzy osobne dzienne limity: na sprawdzenia wersji z indeksu, na testy wersji opublikowanej oraz na prośby o zindeksowanie. Limity dotyczą każdej usługi w Search Console z osobna. Google nie podaje w pomocy ich wartości liczbowych, dlatego nie należy opierać planu pracy na liczbach krążących w sieci. Po wyczerpaniu limitu pozostaje poczekać do następnego dnia albo skorzystać z mapy witryny.
Ważniejsze od limitów jest to, czego narzędzie nie obiecuje. Dokument o działaniu wyszukiwarki zawiera jasne zastrzeżenie: Google nie gwarantuje skanowania, indeksowania ani wyświetlania strony w wynikach, nawet jeśli spełnia ona podstawowe zasady. Wynik narzędzia należy więc czytać jako opis stanu technicznego, a nie zapowiedź widoczności. Strona może być w indeksie i nie wyświetlać się na żadne ważne dla firmy zapytanie, bo o doborze wyników decydują trafność i jakość, a nie sama obecność w indeksie.
Pomoc Search Console wymienia też konkretne rzeczy, których narzędzie nie sprawdza. Nie ocenia zgodności strony z wytycznymi dotyczącymi jakości i bezpieczeństwa. Nie uwzględnia ręcznych działań, problemów dotyczących bezpieczeństwa, usunięć z przyczyn prawnych ani tymczasowych blokad adresów. Test na żywo nie sprawdza obecności adresu w mapach witryn ani na stronach odsyłających. W przypadku filmów test pokazuje tylko, czy film został wykryty, a nie czy został zindeksowany.
Z tego powodu przy stronie, która ma poprawny wynik, a mimo to nie pojawia się w wyszukiwarce, pomoc zaleca przejrzenie raportów o ręcznych działaniach i o problemach dotyczących bezpieczeństwa oraz listy tymczasowych usunięć. Ostatecznym sprawdzianem pozostaje wyszukanie adresu w Google. O tym, jak działają usunięcia, piszemy we wpisie o usuwaniu strony z wyników Google.
Typowe pomyłki przy odczycie i kiedy potrzebna jest pomoc
Najczęstsza pomyłka to traktowanie wyniku z indeksu jak obrazu aktualnego stanu strony. Zaraz po niej jest przekonanie, że poprawny test na żywo oznacza zindeksowanie. Test mówi tylko, że adres może być indeksowany, a decyzja zapada później i zależy także od oceny treści oraz wyboru adresu kanonicznego.
Kolejna pomyłka to codzienne ponawianie prośby dla tego samego adresu. Dokumentacja mówi wprost, że to nie skraca oczekiwania. Następna dotyczy usług: adres sprawdzany w usłudze dla innej wersji domeny nie zwróci wyniku, co bywa mylnie odbierane jako brak strony w Google.
Najbardziej kosztowna jest próba naprawiania pojedynczych adresów tam, gdzie problem dotyczy całego serwisu. Jeśli ten sam status powtarza się na dziesiątkach albo setkach podstron, sprawdzanie ich po kolei niewiele da. Trzeba znaleźć wspólną przyczynę: szablon, regułę w pliku robots.txt, sposób generowania adresów, powieloną treść. Po jej usunięciu w raporcie Indeksowanie stron można zgłosić poprawkę do weryfikacji dla całej grupy adresów. Według opisu tego raportu weryfikacja trwa zwykle do dwóch tygodni, a Search Console informuje o postępach wiadomością e-mail.
Pomoc specjalisty przydaje się wtedy, gdy wynik narzędzia jest poprawny, a strona nadal nie zyskuje widoczności, gdy Google uparcie wybiera inny adres kanoniczny niż wskazany, gdy podgląd kodu pokazuje braki w treści ładowanej skryptami albo gdy problem obejmuje dużą część serwisu po migracji lub zmianie szablonu. W takich sprawach samo narzędzie wskazuje objaw, a ustalenie przyczyny wymaga analizy całej witryny. Tym właśnie zajmuje się SEO techniczne, a punktem wyjścia bywa audyt SEO, w którym wyniki z Search Console zestawia się z danymi o strukturze serwisu i jego treści.
Jeśli chcą Państwo zamówić SEO techniczne, zachęcamy do kontaktu: tel. 222 500 844 lub mailowo: biuro@pozycjonowaniestron.pl
Najczęstsze pytania
Ile trwa zindeksowanie strony po wysłaniu prośby?
Google podaje, że może to zająć od kilku dni do kilku tygodni. Prośba nie daje gwarancji ani terminu, ani samego zindeksowania. Postęp można śledzić w tym samym narzędziu oraz w raporcie Indeksowanie stron.
Czy ponowne wysłanie prośby przyspiesza indeksowanie?
Nie. Dokumentacja Google wprost wskazuje, że wielokrotne zgłaszanie tego samego adresu nie przyspiesza skanowania. Ponowna prośba ma sens dopiero po wprowadzeniu na stronie kolejnej istotnej zmiany.
Dlaczego narzędzie pokazuje starą wersję strony, skoro treść została zmieniona?
Wynik domyślny pochodzi z indeksu i opisuje stan z ostatniego skanowania, którego datę widać w polu Ostatnie skanowanie. Aktualny stan pokazuje dopiero test wersji opublikowanej. Oba wyniki zrównają się, gdy Google ponownie zeskanuje stronę.
Co oznacza komunikat, że adres URL jest Google nieznany?
Oznacza, że wyszukiwarka jeszcze nie wykryła tego adresu. Warto wykonać test wersji opublikowanej, usunąć ewentualne przeszkody i wysłać prośbę o zindeksowanie. Pomaga też odnośnik z innej podstrony serwisu oraz obecność adresu w mapie witryny.
Czy poprawny wynik oznacza, że strona będzie widoczna w wyszukiwarce?
Nie. Wynik mówi, że strona jest w indeksie albo może być indeksowana, a nie że będzie się wyświetlać na konkretne zapytania. Narzędzie nie uwzględnia też ręcznych działań, problemów dotyczących bezpieczeństwa ani tymczasowych usunięć.
Dlaczego Google wybrał inny adres kanoniczny niż wskazany na stronie?
Znacznik rel=canonical jest dla Google wskazówką, a nie poleceniem. Wyszukiwarka bierze pod uwagę także przekierowania, protokół HTTPS i mapę witryny, a przy bardzo podobnej treści może uznać inną stronę za bardziej reprezentatywną. Rozwiązaniem jest uporządkowanie tych sygnałów i zróżnicowanie treści.
Źródła
- Narzędzie do sprawdzania adresów URL, Search Console - pomoc
- Zgłaszanie do Google prośby o ponowne zindeksowanie adresów URL, Centrum wyszukiwarki Google
- Raport Indeksowanie stron, Search Console - pomoc
- Co to jest wybór strony kanonicznej, Centrum wyszukiwarki Google
- Jak działa wyszukiwarka Google, Centrum wyszukiwarki Google
- Typowe roboty Google, Google for Developers
- Przygotowywanie i przesyłanie mapy witryny, Centrum wyszukiwarki Google
Funkcje wyszukiwarek i asystentów AI zmieniają się szybko, dlatego wpis aktualizujemy po większych zmianach.