Kod 403 oznacza, że serwer odebrał żądanie, ale odmówił wydania strony. Jeśli taką odpowiedź dostaje robot Google, podstrona nie trafi do indeksu, a z czasem może z niego wypaść, choć klienci widzą ją w przeglądarce bez żadnych przeszkód. Poniżej opisujemy, gdzie taki problem widać, skąd się bierze, jak go potwierdzić i co przekazać administratorowi serwera.
Co oznacza kod 403 i jak traktuje go Google
Kod 403, po angielsku Forbidden, czyli dostęp zabroniony, to odpowiedź serwera, który rozpoznał żądanie i świadomie go nie zrealizował. Strona istnieje, ale serwer uznał, że pytający nie ma prawa jej zobaczyć. Tym różni się od kodu 404, który mówi, że pod danym adresem niczego nie ma, oraz od błędów z grupy 5xx, które oznaczają awarię po stronie serwera.
Dla wyszukiwarki skutek jest prosty. Dokumentacja Google o kodach stanu HTTP podaje, że Google nie używa treści z adresów, które zwracają kod z grupy 4xx, a adresy wcześniej zindeksowane, które zaczęły tak odpowiadać, są usuwane z indeksu. Wszystkie błędy 4xx poza kodem 429 są traktowane jednakowo: tak, jakby treści pod tym adresem nie było. Robot nie zgaduje, czy odmowa była zamierzona, czy przypadkowa.
Ogólne zasady dla całych grup odpowiedzi opisaliśmy we wpisie o kodach odpowiedzi HTTP a SEO. Tutaj zajmujemy się wyłącznie odmową dostępu, ponieważ jest to błąd szczególnie podstępny: w przeglądarce właściciela wszystko działa, a w wynikach wyszukiwania strona stopniowo znika.
Odpowiedź serwera oznaczająca odmowę dostępu do istniejącego zasobu. W Search Console opisana jako zabroniony dostęp.
Czym kod 403 różni się od kodu 401
Kod 401 oznacza, że serwer czeka na dane logowania. Kod 403 oznacza odmowę niezależnie od tego, kim jest pytający. W praktyce obie odpowiedzi kończą się dla wyszukiwarki tak samo, ponieważ Googlebot, jak przypomina pomoc Search Console, nigdy nie podaje danych logowania. Search Console pokazuje je jednak jako dwa osobne powody: zablokowanie z powodu nieautoryzowanego żądania (401) oraz zablokowanie z powodu zabronionego dostępu (403).
Kod 403 nie spowalnia robota
Zdarza się, że administrator przeciążonego serwera zaczyna odpowiadać robotom kodem 403, licząc na to, że Google ograniczy liczbę odwiedzin. To nie działa. Google wprost zaleca, aby nie używać kodów 401 i 403 do ograniczania szybkości skanowania, ponieważ kody 4xx poza 429 nie mają na nią wpływu. Sygnałem przeciążenia są dla robota odpowiedzi 5xx oraz 429. Jak bezpiecznie zamknąć serwis na czas prac, wyjaśniamy we wpisie o kodzie 503 i przerwie technicznej.
Gdzie widać odmowę dostępu w Search Console
Odmowę dostępu widać w trzech miejscach Search Console: w raporcie Indeksowanie stron, w raporcie Statystyki indeksowania oraz w narzędziu do sprawdzania adresów URL. Każde z nich odpowiada na inne pytanie, dlatego warto zajrzeć do wszystkich.
Raport Indeksowanie stron
W menu po lewej stronie, w grupie Indeksowanie, znajduje się pozycja Strony. Pod wykresem widoczna jest tabela z powodami, dla których strony nie zostały zindeksowane. Interesujący nas wiersz to „Strona zablokowana z powodu zabronionego dostępu (błąd 403)”. Po jego kliknięciu pojawia się lista przykładowych adresów oraz wykres pokazujący, od kiedy liczba takich stron rośnie. Ta data bywa najcenniejszą wskazówką: jeśli pokrywa się z dniem zmiany hostingu, włączenia nowej zapory albo aktualizacji wtyczki zabezpieczającej, przyczyna jest w zasadzie znaleziona.
W tej samej tabeli może pojawić się pokrewny wiersz „URL jest zablokowany z powodu innego błędu 4xx”. Trafiają tam odpowiedzi z grupy 4xx, których nie obejmuje żadna inna kategoria. Pozostałe powody z tego raportu omawiamy we wpisie o tym, dlaczego Google nie indeksuje strony.
Raport Statystyki indeksowania
Drugi raport pokazuje, co robot faktycznie dostawał od serwera. Otwiera się go przez Ustawienia, a następnie pozycję Statystyki indeksowania. Raport jest dostępny tylko dla usług obejmujących całą domenę albo prefiks adresu na poziomie głównym. Jak opisuje pomoc Search Console, zawiera on między innymi zestawienie odpowiedzi na żądania robota. Kod 403 nie ma w nim osobnej pozycji. Jest grupa „Brak autoryzacji (401/407)” oraz grupa „Inny błąd klienta (4XX)” i to w tej drugiej należy szukać odmów dostępu. Po kliknięciu grupy widać przykładowe adresy z datą żądania, co pozwala ustalić, czy problem trwa nadal.
W tym samym raporcie warto obejrzeć sekcję Stan hosta. Ocenia ona trzy rzeczy: pobieranie pliku robots.txt, rozpoznawanie nazw DNS i połączenie z serwerem. Jeśli zapora nie odpowiada kodem 403, lecz po prostu zrywa połączenie, kłopot ujawni się właśnie tutaj, a nie w tabeli odpowiedzi.
Dlaczego serwer odmawia dostępu Googlebotowi
Serwer odmawia dostępu Googlebotowi najczęściej dlatego, że jakieś zabezpieczenie uznało jego ruch za podejrzany albo że pliki strony mają źle ustawione uprawnienia. Poniższe przyczyny to obserwacje z praktyki technicznej, a nie lista z dokumentacji Google. Dokumentacja opisuje skutek odmowy, natomiast źródło leży zawsze po stronie serwera lub usług, które stoją przed nim.
Zabezpieczenia hostingu i zapora
Wiele firm hostingowych włącza ochronę przed automatycznym ruchem dla wszystkich kont. Zapora aplikacyjna analizuje każde żądanie i odrzuca te, które pasują do jej reguł: zbyt wiele odwiedzin w krótkim czasie, nietypowy adres, brak plików cookie, brak obsługi skryptu sprawdzającego przeglądarkę. Robot wyszukiwarki spełnia kilka z tych warunków jednocześnie, ponieważ odwiedza wiele podstron jedna po drugiej i nie zachowuje się jak człowiek. Dobrze skonfigurowana ochrona rozpoznaje znane roboty i je przepuszcza. Źle skonfigurowana wrzuca je do jednego worka z programami, które kopiują treści lub szukają luk.
Podobnie działają usługi pośredniczące, czyli sieci dostarczania treści z wbudowaną ochroną. W takim układzie odmowa może powstać zanim żądanie w ogóle dotrze do właściwego serwera, dlatego w jego dziennikach nie będzie po niej śladu. Więcej o takich usługach piszemy we wpisie o CDN a SEO.
Blokady adresów IP i krajów
Druga grupa przyczyn to listy zablokowanych adresów. Administrator po ataku dopisuje do zapory całe zakresy adresów, z których przyszedł niechciany ruch, i przy okazji obejmuje nimi adresy używane przez Google. Częstym wariantem jest blokada geograficzna: firma działa tylko w Polsce, więc ktoś postanawia odciąć ruch z zagranicy. Tymczasem roboty Google łączą się z adresów, których zakresy Google publikuje w osobnych plikach, a w dokumentacji Googlebota mowa jest wprost o skanowaniu z adresów IP w Stanach Zjednoczonych. Blokada całego ruchu spoza kraju może więc zamknąć drzwi przed wyszukiwarką.
Wtyczki zabezpieczające i reguły w plikach serwera
W serwisach opartych na WordPressie odmowę potrafi wygenerować wtyczka zabezpieczająca: limit liczby żądań na minutę, lista zakazanych identyfikatorów programów, ochrona przed robotami kopiującymi treść. Reguły tego rodzaju bywają też wpisane ręcznie w pliku .htaccess albo w konfiguracji serwera, nieraz przez poprzedniego wykonawcę, o czym obecny właściciel nie wie. Osobnym przypadkiem jest ochrona wersji roboczej serwisu, która po uruchomieniu nowej strony została przeniesiona na adres produkcyjny razem z całą konfiguracją.
Błędne uprawnienia plików i katalogów
Ostatnia przyczyna nie ma nic wspólnego z rozpoznawaniem robotów. Jeśli serwer nie ma prawa odczytać pliku albo katalogu, odpowie kodem 403 każdemu. Zdarza się to po przenosinach strony, po przywróceniu kopii zapasowej lub po wgraniu plików z innego konta. Dokumentacja WordPressa podaje jako punkt odniesienia uprawnienia 755 lub 750 dla katalogów oraz 644 lub 640 dla plików, a dla pliku .htaccess wartość 644 jako zwykle wymaganą i zalecaną. Ta sama dokumentacja przestrzega przed nadawaniem katalogom uprawnień 777, także katalogom z przesłanymi plikami. Odmowa dla wszystkich pojawia się również wtedy, gdy w katalogu brakuje pliku startowego, a serwer ma wyłączone wyświetlanie listy plików.
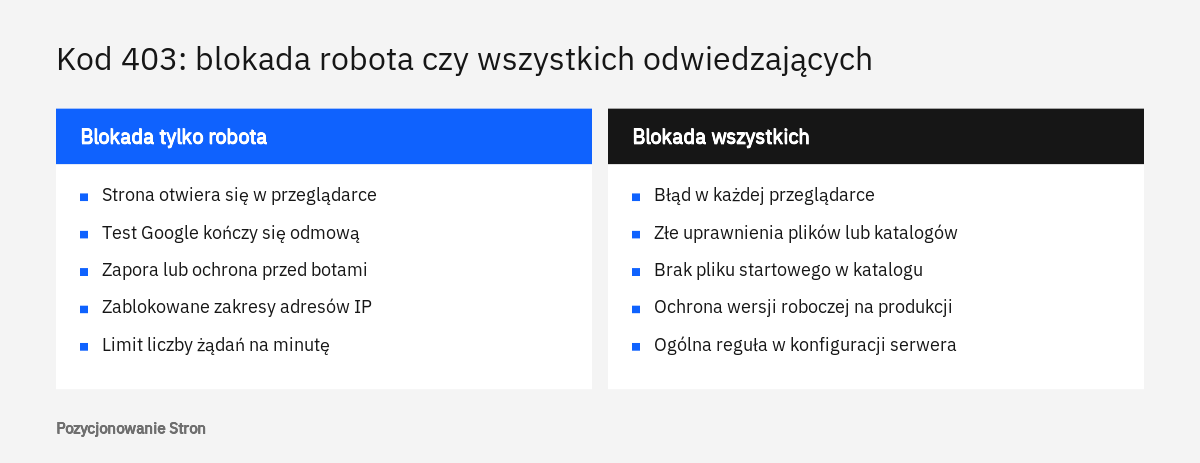
| Przyczyna | Kogo dotyczy | Po czym ją poznać |
|---|---|---|
| Zapora lub ochrona przed botami | Najczęściej tylko robotów | Strona działa w przeglądarce, test Google kończy się niepowodzeniem |
| Blokada adresów IP lub krajów | Robotów i części odwiedzających z zagranicy | Strona nie otwiera się również z zagranicznego połączenia |
| Wtyczka zabezpieczająca lub reguła w pliku .htaccess | Robotów albo wybranych adresów | Odmowa znika po czasowym wyłączeniu wtyczki lub reguły |
| Uprawnienia plików i katalogów | Wszystkich | Ten sam błąd w każdej przeglądarce, zwykle w jednym katalogu |
| Ochrona wersji roboczej przeniesiona na produkcję | Wszystkich niezalogowanych | Problem zaczyna się w dniu uruchomienia nowej strony |
Przykład czysto poglądowy: sklep z Poznania po serii prób włamania włącza w panelu hostingu najwyższy poziom ochrony. Klienci kupują jak dawniej, więc nikt niczego nie podejrzewa, a w raporcie Indeksowanie stron z tygodnia na tydzień przybywa adresów z odmową dostępu. Dopiero zestawienie daty na wykresie z datą zmiany ustawień pokazuje, co się stało.
Jak odróżnić blokadę robota od blokady wszystkich odwiedzających
Rozróżnienie jest proste: jeśli strona otwiera się w przeglądarce bez logowania, a Google zgłasza kod 403, blokada dotyczy robota. Jeśli nie otwiera się nikomu, problem leży w uprawnieniach lub w ogólnej regule serwera. Od tej odpowiedzi zależy, do kogo się zwrócić i czego szukać.
Pierwszy test nie wymaga żadnych narzędzi. Wystarczy otworzyć adres z raportu w oknie prywatnym przeglądarki, w którym nie działa zapisane logowanie do panelu strony. Pomoc Search Console zaleca ten sam sposób przy błędzie 401. Jeśli strona się wyświetla, warto powtórzyć próbę z telefonu połączonego przez sieć komórkową, czyli z innego adresu IP niż biurowy. Adres biura bywa dopisany do listy zaufanych i wtedy wynik z firmowego komputera niczego nie dowodzi.
Drugi test polega na wysłaniu żądania z identyfikatorem programu takim, jakim przedstawia się Googlebot. Identyfikator ten, przesyłany w nagłówku User-Agent, można ustawić w narzędziach dla programistów w przeglądarce albo w wierszu poleceń.
curl -I https://www.example.com/oferta/

curl -I -A "Mozilla/5.0 (compatible; Googlebot/2.1; +http://www.google.com/bot.html)" https://www.example.com/oferta/
Pierwsza linia odpowiedzi zawiera kod. Jeśli zwykłe żądanie kończy się kodem 200, a drugie kodem 403, serwer odrzuca ruch na podstawie samej nazwy robota. Trzeba jednak znać granice tego testu. Żądanie wychodzi z komputera badającego, a nie z sieci Google, więc nie ujawni blokady opartej na adresach IP. Bywa też odwrotnie: zabezpieczenie odrzuca każdego, kto podaje się za Googlebota, a nie łączy się z adresu Google, i wtedy wynik 403 jest fałszywym alarmem. Rozstrzyga dopiero test wykonany przez samą wyszukiwarkę.
Jak potwierdzić blokadę testem wersji opublikowanej
Blokadę potwierdza test wersji opublikowanej w narzędziu do sprawdzania adresów URL, ponieważ Google pobiera wtedy stronę na bieżąco i pokazuje, co dostał od serwera. To jedyny dostępny właścicielowi test, który wychodzi z infrastruktury wyszukiwarki, a nie z prywatnego komputera.
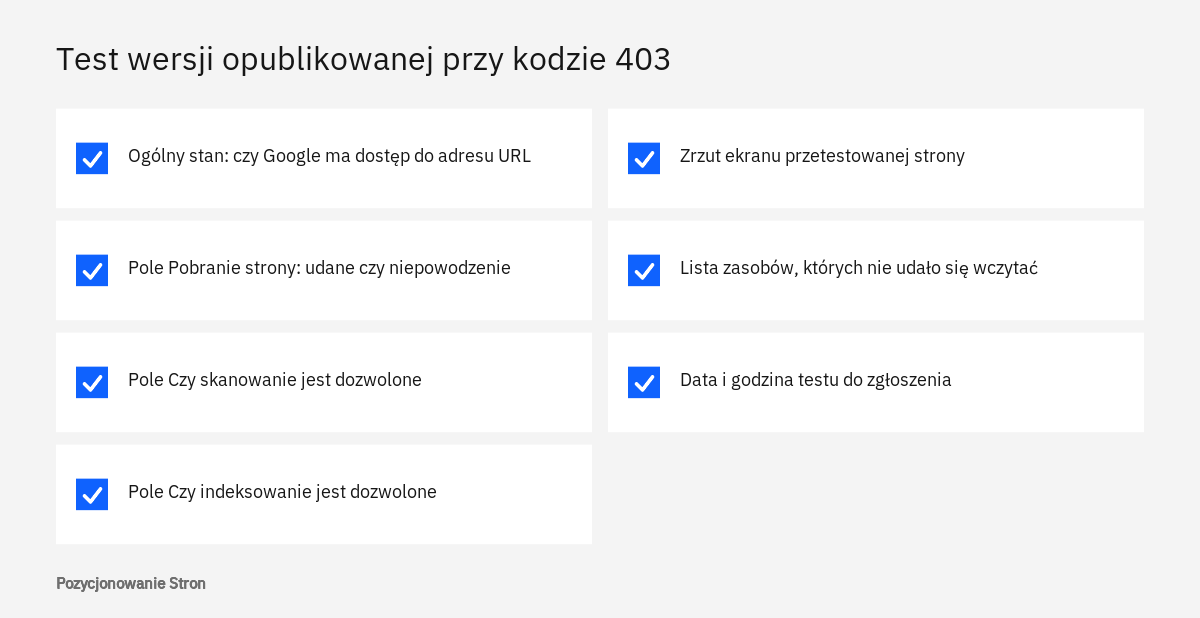
Pełny adres podstrony wpisuje się w pasek na górze Search Console. Pierwszy ekran pokazuje dane z indeksu, czyli stan z ostatniej wizyty robota, która mogła mieć miejsce dawno. W prawym górnym rogu znajduje się przycisk uruchamiający sprawdzenie adresu w wersji opublikowanej. Po chwili pojawia się wynik z jednym z trzech ogólnych stanów opisanych w pomocy narzędzia: Google ma dostęp do adresu URL, ma dostęp, ale występują problemy, albo nie ma dostępu.
Szczegóły kryją się w sekcji Dostępność strony. Najważniejsze jest pole Pobranie strony. Wartość „Udało się” oznacza, że w chwili testu serwer wpuścił robota. Wartość „Niepowodzenie” z dopiskiem o zabronionym dostępie potwierdza odmowę. Obok znajdują się pola Czy skanowanie jest dozwolone, które dotyczy pliku robots.txt, oraz Czy indeksowanie jest dozwolone, które dotyczy dyrektywy noindex. Dzięki temu od razu widać, czy problemem jest serwer, czy zakaz ustawiony w samej witrynie.
Przy udanym pobraniu dostępny jest odnośnik otwierający przetestowaną stronę, a w nim kod HTML, zrzut ekranu, nagłówki odpowiedzi HTTP i lista załadowanych zasobów. Zrzut ekranu powstaje tylko wtedy, gdy pobranie się powiodło, więc jego brak sam w sobie jest wskazówką. Dokładny opis wszystkich pól zawiera nasz wpis o sprawdzaniu adresu URL w Search Console.
Jak czytać wynik testu
Możliwe są trzy sytuacje. Jeśli dane z indeksu pokazują odmowę, a test na żywo kończy się powodzeniem, blokada była przejściowa albo została już zdjęta i wystarczy poprosić o ponowne sprawdzenie. Jeśli oba wyniki pokazują odmowę, blokada trwa. Jeśli test raz się udaje, a raz nie, serwer odrzuca część żądań, co zwykle wskazuje na limit liczby odwiedzin albo na ochronę, która ocenia każde połączenie osobno. Test warto powtórzyć kilka razy w odstępach oraz wykonać dla kilku adresów: strony głównej, wybranej podstrony oferty i jednego adresu z listy błędów. Za każdym razem należy zapisać godzinę, ponieważ przyda się administratorowi.
Jeśli chcą Państwo zamówić SEO techniczne, zachęcamy do kontaktu: tel. 222 500 844 lub mailowo: biuro@pozycjonowaniestron.pl
Jak sprawdzić, czy zablokowany ruch pochodził od prawdziwego Googlebota
Prawdziwego Googlebota rozpoznaje się po adresie IP, a nie po nazwie, którą się przedstawia. Google zaznacza, że nagłówek z identyfikatorem programu jest często fałszowany przez inne roboty, dlatego przed odblokowaniem ruchu warto ustalić, kto naprawdę pukał do serwera. Ma to znaczenie w obie strony: administrator nie powinien blokować wyszukiwarki, ale nie musi też wpuszczać każdego programu, który używa jej nazwy.
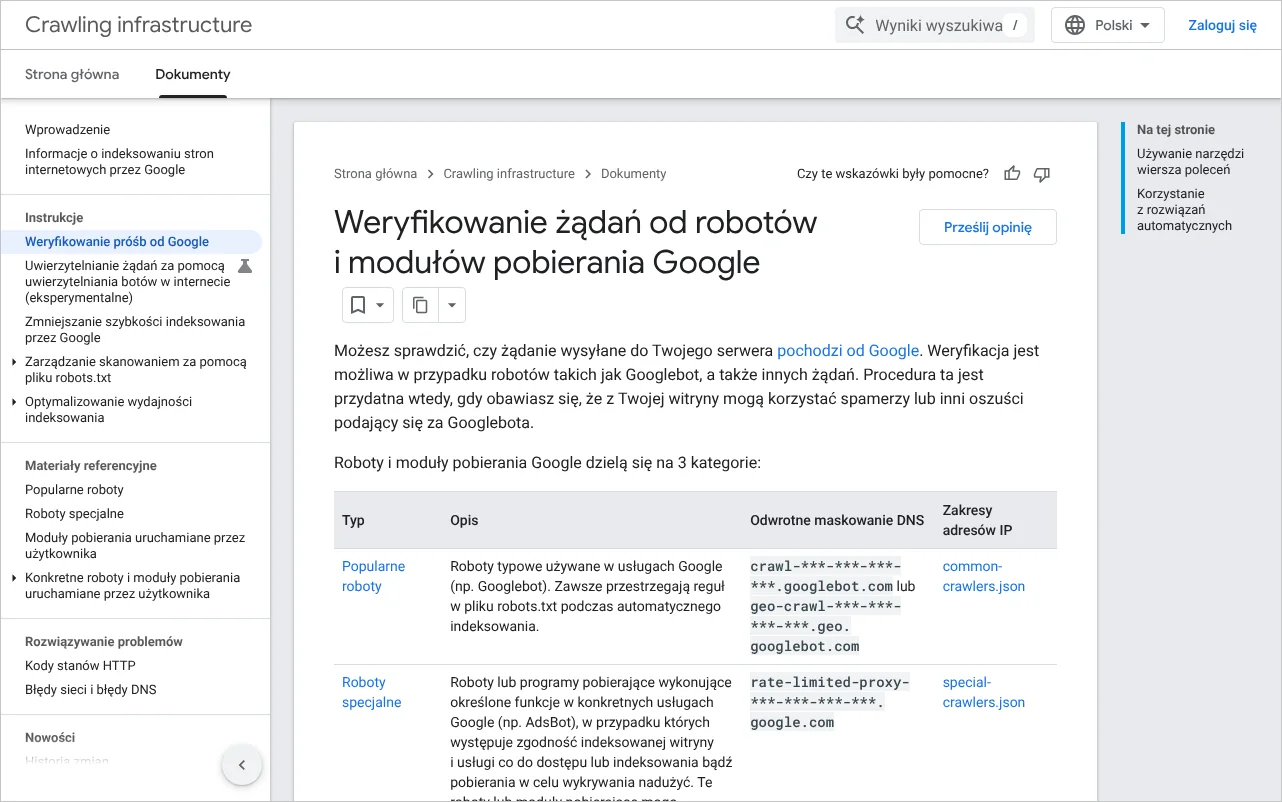
Strona o weryfikowaniu żądań od robotów Google opisuje dwa sposoby. Pierwszy, ręczny, nadaje się do pojedynczych sprawdzeń. Dla adresu IP z dziennika serwera wykonuje się odwrotne zapytanie DNS i sprawdza, czy otrzymana nazwa kończy się na googlebot.com, google.com lub googleusercontent.com. Następnie dla tej nazwy wykonuje się zwykłe zapytanie DNS i porównuje wynik z adresem wyjściowym. Zgodność w obu kierunkach oznacza prawdziwego robota.
host 66.249.66.1
1.66.249.66.in-addr.arpa domain name pointer crawl-66-249-66-1.googlebot.com.

host crawl-66-249-66-1.googlebot.com
crawl-66-249-66-1.googlebot.com has address 66.249.66.1
Drugi sposób, automatyczny, polega na porównaniu adresu z listami zakresów IP, które Google publikuje w plikach JSON. Osobne pliki obejmują popularne roboty, do których należy Googlebot, roboty specjalne, takie jak AdsBot, oraz moduły pobierania uruchamiane na żądanie użytkownika. To właśnie te listy administrator powinien wczytać do zapory jako wyjątki. Wpisanie ręcznie kilku adresów zauważonych w dzienniku pomaga na krótko, ponieważ robot korzysta z wielu adresów.
Szczególne przypadki: robots.txt, zasoby strony i odmowa zamierzona
Kod 403 nie zawsze dotyczy samej podstrony i nie zawsze jest błędem. Inaczej należy ocenić odmowę dla pliku robots.txt, inaczej dla arkuszy stylów i skryptów, a jeszcze inaczej dla adresów, które z założenia mają być zamknięte.
Plik robots.txt z kodem 403
Jeśli serwer odmawia dostępu do pliku robots.txt, Google nie wstrzymuje skanowania. Zgodnie z opisem interpretacji specyfikacji robots.txt wszystkie błędy 4xx poza kodem 429 są traktowane tak, jakby prawidłowy plik nie istniał, czyli jakby nie było żadnych ograniczeń. Raport Statystyki indeksowania uznaje taką odpowiedź za prawidłową. Skutek bywa zaskakujący: reguły, które miały trzymać robota z dala od koszyka, wyników wyszukiwarki wewnętrznej czy filtrów, przestają obowiązywać. Inaczej jest przy błędach serwera z grupy 5xx, kiedy przez pierwsze 12 godzin Google przestaje skanować witrynę. Zasady pisania tego pliku omawiamy we wpisie o pliku robots.txt.
Style, skrypty i obrazy z kodem 403
Zdarza się, że sam dokument HTML jest wydawany poprawnie, a odmowa dotyczy plików, z których strona się składa, na przykład całego katalogu z motywem albo obrazów chronionych przed wyświetlaniem na obcych stronach. Raport Indeksowanie stron może wtedy niczego nie zgłaszać. Ślad widać w teście wersji opublikowanej: na zrzucie ekranu strona wygląda inaczej niż w przeglądarce, a lista zasobów pokazuje pliki, których nie udało się wczytać.
Kiedy odmowa jest poprawna
Nie każdy adres z listy wymaga naprawy. Panel administracyjny, pliki konfiguracyjne, katalogi techniczne czy strefa klienta powinny być zamknięte i odpowiedź 403 jest tam na miejscu. Dokumentacja Googlebota przypomina zresztą, że do całkowitego zablokowania dostępu służą właśnie metody takie jak ochrona hasłem, a nie plik robots.txt. Jeśli na liście w Search Console są wyłącznie takie adresy, wystarczy upewnić się, że nie prowadzą do nich linki w menu ani wpisy w mapie witryny. Powodem do działania są dopiero podstrony, które mają zdobywać ruch: oferta, kategorie, produkty, wpisy.
Co zgłosić administratorowi serwera
Administratorowi serwera należy przekazać dowody i konkretne pytania, a nie samą informację, że Google nie widzi strony. Dział pomocy hostingu zwykle zaczyna od otwarcia witryny w przeglądarce, widzi działającą stronę i zamyka zgłoszenie. Dobrze przygotowana wiadomość skraca sprawę z kilku dni do jednej wymiany korespondencji.
- Pełne adresy dwóch lub trzech podstron, dla których test wersji opublikowanej zakończył się odmową.
- Dokładna data i godzina każdego testu wraz ze strefą czasową, aby dało się odnaleźć wpis w dzienniku.
- Informacja, że w przeglądarce te same adresy zwracają kod 200, a robot Google otrzymuje kod 403.
- Dzień, od którego liczba błędów rośnie w raporcie Indeksowanie stron, oraz zmiany wprowadzone w tym czasie na koncie.
- Prośba o sprawdzenie dzienników zapory i ochrony przed botami pod kątem żądań Googlebota z podanych godzin.
- Prośba o wskazanie reguły, która odrzuciła żądanie, oraz o dodanie wyjątku opartego na oficjalnych zakresach adresów IP Google.
- Pytanie o blokady geograficzne i limity liczby żądań obowiązujące na koncie.
Do zgłoszenia warto dołączyć odnośnik do strony Google o weryfikowaniu robotów, ponieważ zawiera adresy plików z zakresami IP. Jeśli przed serwerem działa usługa pośrednicząca, to samo zgłoszenie powinno trafić do osoby, która nią zarządza. Firma hostingowa nie widzi żądań zatrzymanych wcześniej i zgodnie z prawdą odpowie, że w jej dziennikach odmowy nie ma. Jeśli źródłem jest wtyczka zabezpieczająca, sprawę rozwiązuje osoba opiekująca się stroną, a nie hosting.
Co zrobić po usunięciu blokady i jakich pomyłek unikać
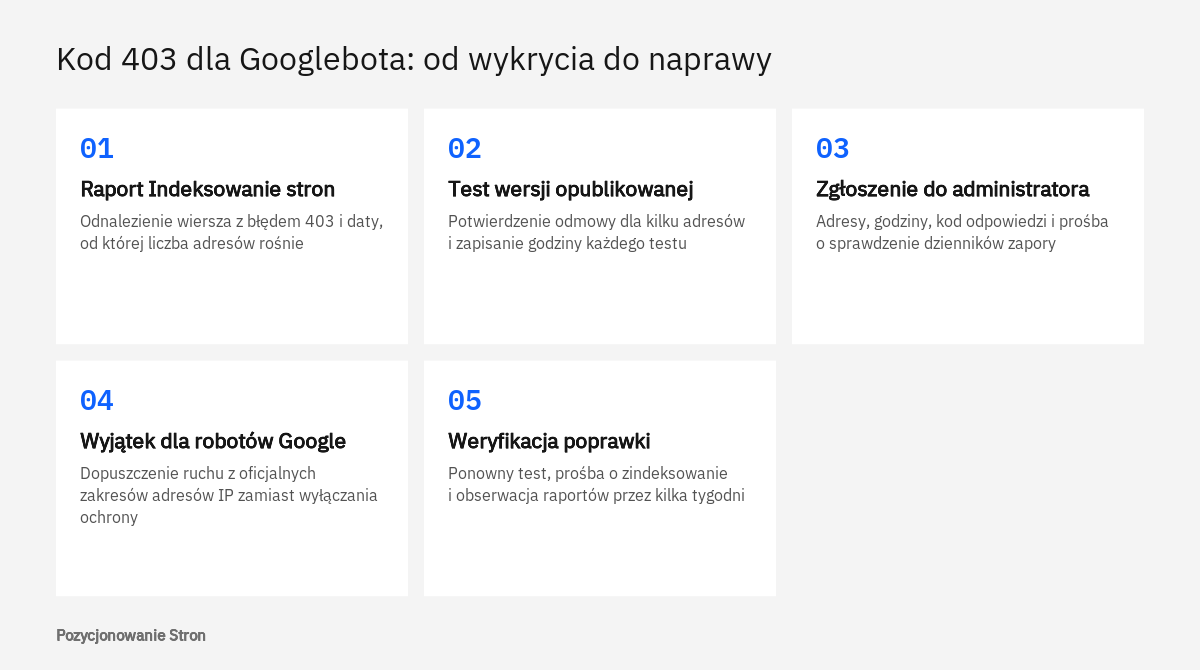
Po usunięciu blokady należy potwierdzić naprawę testem, zgłosić ją w raporcie i przez kilka tygodni obserwować wyniki. Sama zmiana na serwerze nie przywraca stron do indeksu od razu, ponieważ robot musi ponownie odwiedzić każdy adres.
- Powtórzenie testu wersji opublikowanej
Te same adresy, które wcześniej kończyły się odmową, powinny teraz pokazywać udane pobranie strony. Warto sprawdzić także zrzut ekranu, aby upewnić się, że robot dostał właściwą treść, a nie stronę z zadaniem weryfikacyjnym.
- Prośba o zindeksowanie najważniejszych adresów
Na ekranie wyniku znajduje się przycisk z prośbą o zindeksowanie. Obowiązuje dzienny limit takich próśb, dlatego należy użyć go dla kilku kluczowych podstron, a resztę pozostawić mapie witryny.
- Uruchomienie weryfikacji poprawki
W raporcie Indeksowanie stron, po wejściu w wiersz z błędem 403, dostępny jest przycisk rozpoczynający sprawdzanie poprawki. Search Console najpierw bada kilka stron, a jeśli nie znajdzie problemu, przechodzi do pozostałych znanych adresów.
- Obserwacja raportów
Weryfikacja zajmuje zazwyczaj do 2 tygodni, choć może trwać dłużej. W tym czasie w raporcie Statystyki indeksowania powinien maleć udział grupy „Inny błąd klienta (4XX)”.
Typowe pomyłki
Najczęstsza pomyłka to uznanie sprawy za załatwioną, ponieważ strona otwiera się w przeglądarce. Przy odmowie dostępu to niczego nie dowodzi. Druga to ponowne uruchamianie weryfikacji poprawki w trakcie trwającego sprawdzania, czego pomoc Search Console odradza. Trzecia to dopisanie do zapory kilku adresów IP zamiast pełnych, oficjalnych zakresów, przez co problem wraca po pewnym czasie.
Do pomyłek należy też wpuszczanie ruchu na podstawie samej nazwy robota. Taki wyjątek otwiera serwer dla każdego programu, który się pod Googlebota podszyje. Wreszcie zdarza się zmiana uprawnień wszystkich plików na najszersze możliwe, co usuwa objaw kosztem bezpieczeństwa strony.
Pomoc specjalisty przydaje się wtedy, gdy odmowy są wybiórcze i trudne do powtórzenia, gdy stroną opiekuje się kilka podmiotów, które odsyłają sprawę między sobą, albo gdy problem ujawnił się po zmianie serwera. W tym ostatnim przypadku warto zlecić audyt SEO obejmujący analizę dzienników serwera, a przy planowanych przenosinach skorzystać z usługi migracji domeny i hostingu, w ramach której dostępność strony dla robotów sprawdza się jeszcze przed przełączeniem. Stałą kontrolę odpowiedzi serwera obejmuje także SEO techniczne.
Jeśli chcą Państwo zamówić SEO techniczne, zachęcamy do kontaktu: tel. 222 500 844 lub mailowo: biuro@pozycjonowaniestron.pl
Najczęstsze pytania
Czy kod 403 obniża pozycje całej strony?
Skutek dotyczy adresów, które zwracają odmowę: Google nie korzysta z ich treści, a zindeksowane wcześniej usuwa z indeksu. Jeśli blokada obejmuje całą witrynę, znikać mogą wszystkie podstrony. Jeśli dotyczy jednego katalogu, pozostałe części serwisu są skanowane normalnie.
Jak szybko strony wracają do indeksu po zdjęciu blokady?
Google nie podaje jednego terminu. Robot musi ponownie odwiedzić każdy adres, a weryfikacja poprawki w Search Console trwa zazwyczaj do 2 tygodni i może się wydłużyć. Prośba o zindeksowanie przyspiesza sprawę dla wybranych podstron, ale niczego nie gwarantuje.
Strona działa w przeglądarce. Skąd więc błąd 403 w Search Console?
Serwer lub zabezpieczenie przed nim odróżnia ruch robota od ruchu ludzi i odrzuca tylko ten pierwszy. Decyduje o tym adres IP, identyfikator programu albo liczba żądań w krótkim czasie. Potwierdza to test wersji opublikowanej, który wychodzi z infrastruktury Google.
Czy można celowo odpowiadać Googlebotowi kodem 403, żeby odciążyć serwer?
Nie. Google zaleca, aby nie używać kodów 401 i 403 do ograniczania szybkości skanowania, ponieważ nie mają na nią wpływu. Przy przeciążeniu stosuje się odpowiedzi 503 lub 429, i to nie dłużej niż przez 2 lub 3 dni.
Czy plik robots.txt może powodować kod 403?
Nie. Plik robots.txt zawiera wskazówki dla robotów, a kod 403 jest odpowiedzią serwera na żądanie. W Search Console są to dwa różne powody z osobnymi wierszami. Jeśli natomiast sam plik robots.txt zwraca kod 403, Google traktuje to tak, jakby pliku nie było.
Czy adresy panelu administracyjnego z kodem 403 trzeba naprawiać?
Nie. Zamknięte części serwisu powinny odmawiać dostępu i taka odpowiedź jest poprawna. Warto jedynie sprawdzić, czy adresy te nie znalazły się w mapie witryny i czy nie prowadzą do nich linki z publicznych podstron.
Źródła
- Jak kody stanu HTTP wpływają na roboty Google, Google for Developers
- Raport Indeksowanie stron, Search Console - pomoc
- Narzędzie do sprawdzania adresów URL, Search Console - pomoc
- Raport Statystyki indeksowania, Search Console - pomoc
- Weryfikowanie żądań od robotów i modułów pobierania Google, Google for Developers
- Co to jest Googlebot, Centrum wyszukiwarki Google
- Jak Google interpretuje specyfikację pliku robots.txt, Google for Developers
- Changing File Permissions, Developer.WordPress.org
Funkcje wyszukiwarek i asystentów AI zmieniają się szybko, dlatego wpis aktualizujemy po większych zmianach.