Znacznik meta robots to jedna linijka w kodzie podstrony, która mówi wyszukiwarkom, czy wolno im pokazać tę podstronę w wynikach, czy mają korzystać z jej linków i jak duży fragment treści mogą wyświetlić. Poniżej opisujemy wszystkie wartości obsługiwane przez Google i Bing, zasady ich łączenia oraz sytuacje, w których robot w ogóle nie odczyta zapisanej dyrektywy.
Czym jest znacznik meta robots i jak wygląda w kodzie
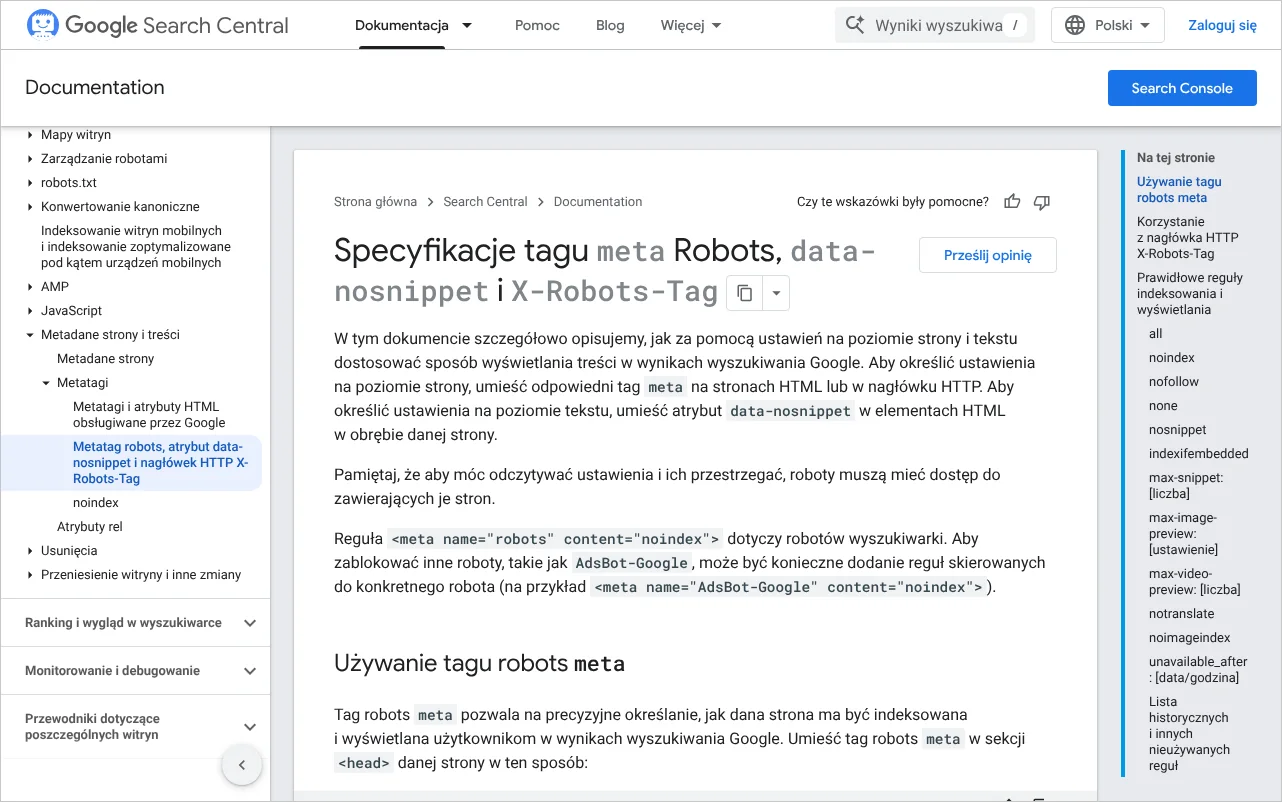
Znacznik meta robots to element kodu HTML umieszczany w sekcji head podstrony, który przekazuje robotom wyszukiwarek reguły dotyczące indeksowania i sposobu prezentowania tej jednej podstrony w wynikach. Nie jest widoczny dla odwiedzających i dotyczy tylko tych robotów, które takich reguł przestrzegają. Google opisuje go w specyfikacji tagu meta robots, atrybutu data-nosnippet i nagłówka X-Robots-Tag, na której opieramy większość poniższych informacji.
Pojedyncza reguła wpisana w atrybucie content znacznika, na przykład noindex. W jednym znaczniku można podać kilka reguł oddzielonych przecinkami.
Znacznik składa się z dwóch atrybutów. Atrybut name wskazuje, do kogo reguła jest skierowana, a atrybut content zawiera same reguły. Według dokumentacji Google wielkość liter w nazwach reguł nie ma znaczenia, więc zapis NOINDEX zostanie odczytany tak samo jak noindex.
<head>
  <meta name="robots" content="noindex">
</head>
Znacznika nie należy mylić z plikiem robots.txt, który decyduje o tym, czy robot w ogóle pobierze dany adres, ani z adresem kanonicznym, który wskazuje główną wersję spośród podobnych podstron. Różnice omawiamy we wpisie canonical, noindex i robots.txt.
Co oznacza brak znacznika
Brak znacznika meta robots oznacza, że podstrona może być indeksowana i pokazywana w wynikach bez ograniczeń. Google podaje wprost, że wartość all, czyli brak ograniczeń, jest ustawieniem domyślnym i jej jawne wpisanie niczego nie zmienia. To samo dotyczy popularnego zapisu index, follow, który wiele systemów dodaje automatycznie. Nie szkodzi on stronie, ale też w niczym nie pomaga. Każda dyrektywa jest więc ograniczeniem względem stanu wyjściowego i należy ją stosować tylko tam, gdzie jest potrzebna.
Jakie wartości znacznika meta robots obsługuje Google
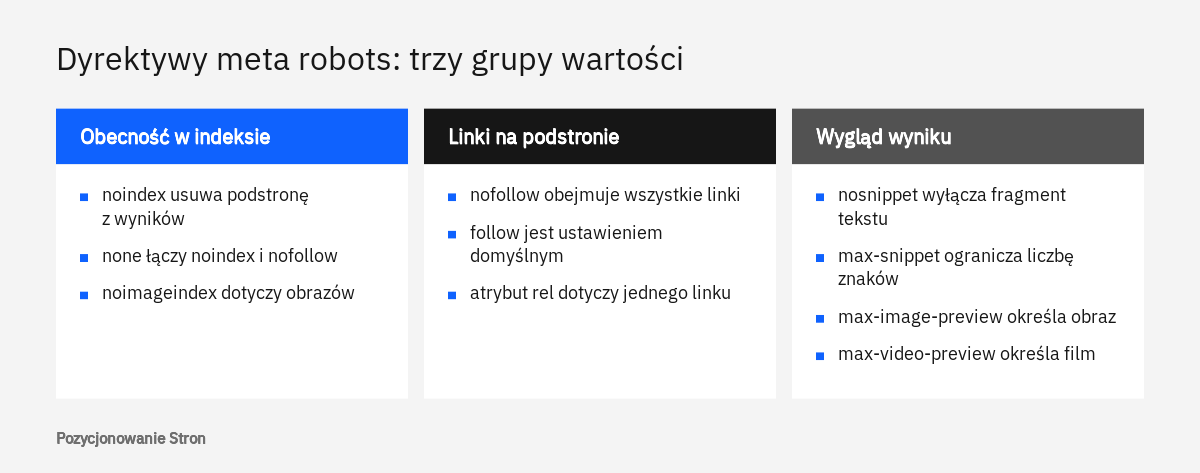
Google obsługuje kilkanaście wartości, które dzielą się na trzy grupy: reguły decydujące o obecności podstrony w indeksie, reguły dotyczące linków oraz reguły sterujące wyglądem wyniku, czyli opisem, obrazem i filmem. Pełne zestawienie znajduje się w tabeli poniżej.
| Wartość | Co oznacza dla Google |
|---|---|
| all | Brak ograniczeń. Wartość domyślna, jej wpisanie nie daje żadnego efektu. |
| noindex | Podstrona, plik lub inny zasób nie będzie pokazywany w wynikach wyszukiwania. |
| nofollow | Google nie powinien korzystać z linków na tej podstronie do odnajdywania innych adresów. |
| none | Skrót oznaczający jednocześnie noindex i nofollow. |
| nosnippet | Wynik bez fragmentu tekstu i bez podglądu filmu. Miniatura obrazu nadal może się pojawić. |
| max-snippet:[liczba] | Najwyższa dopuszczalna liczba znaków we fragmencie tekstu. Zero działa jak nosnippet, a wartość -1 oznacza brak limitu. |
| max-image-preview:[ustawienie] | Największy dopuszczalny podgląd obrazu: none, standard albo large. |
| max-video-preview:[liczba] | Najdłuższy dopuszczalny podgląd filmu w sekundach. Zero oznacza sam obraz statyczny, a wartość -1 brak limitu. |
| indexifembedded | Zgoda na indeksowanie treści osadzonej na innej stronie w ramce, mimo dyrektywy noindex. Działa tylko razem z noindex. |
| noimageindex | Obrazy z tej podstrony nie będą indeksowane. |
| notranslate | Google nie zaproponuje tłumaczenia podstrony w wynikach. |
| unavailable_after:[data] | Po wskazanym dniu i godzinie podstrona przestaje być pokazywana w wynikach. |
Noindex, nofollow i none
Dyrektywa noindex to najważniejsza i najczęściej używana wartość. Podstrona z takim znacznikiem pozostaje dostępna dla każdego, kto zna jej adres lub trafi na nią z menu, ale nie pojawia się w wynikach wyszukiwania. Dyrektywa nofollow dotyczy wszystkich linków na danej podstronie jednocześnie i oznacza prośbę, aby Google nie używał ich do odkrywania kolejnych adresów. Trzeba ją odróżnić od atrybutu rel o tej samej nazwie, który ustawia się przy pojedynczym odnośniku i o którym piszemy we wpisie atrybut nofollow: kiedy go stosować. Nofollow nie służy do ukrywania podstron: w dokumentacji o kwalifikowaniu linków wychodzących Google zaznacza, że docelowy adres może zostać znaleziony inną drogą, na przykład dzięki mapie witryny.
Reguły sterujące opisem, obrazem i filmem
Dyrektywy nosnippet, max-snippet, max-image-preview i max-video-preview nie usuwają podstrony z wyników, tylko ograniczają to, co wyszukiwarka może przy niej pokazać. Według dokumentacji Google reguła nosnippet obejmuje także przeglądy od AI i tryb AI, a więc blokuje użycie treści jako bezpośredniego źródła odpowiedzi tworzonych przez sztuczną inteligencję, a max-snippet ogranicza ilość treści wykorzystywanej w tych funkcjach. Jak działają same funkcje, wyjaśniamy we wpisach o Przeglądzie od AI i o trybie AI w Google.
Jeśli chcą Państwo wykluczyć z opisu tylko wybrany fragment, na przykład zastrzeżenie prawne, lepszym narzędziem jest atrybut data-nosnippet. Google odczytuje go wyłącznie w elementach span, div i section.
<p>Oferta obejmuje montaż i serwis.
  <span data-nosnippet>Regulamin promocji dostępny w biurze.</span>
</p>
Wartości, których Google już nie bierze pod uwagę
Dokumentacja Google wymienia też reguły historyczne, które są obecnie ignorowane: noarchive, nocache oraz nositelinkssearchbox. Pierwsza z nich zabraniała pokazywania kopii podstrony z pamięci podręcznej, a Google wyjaśnia, że odnośnik do takiej kopii przestał istnieć. Obecność tych wartości w kodzie nie wyrządza szkody.
Które dyrektywy meta robots obsługuje Bing
Bing obsługuje podstawowe dyrektywy noindex i nofollow, reguły ograniczające wygląd wyniku oraz dwie wartości dotyczące kopii podstrony, z których Google już zrezygnował. Zestawienie opracowane przez MDN Web Docs podaje, że noindex i nofollow respektują wszystkie główne roboty wyszukiwarek, natomiast przy Bing wymienia dodatkowo nosnippet, noarchive oraz nocache, które jest synonimem noarchive.
Reguły sterujące długością fragmentów Bing wprowadził w ślad za Google. Na blogu Bing dla webmasterów opisano trzy wartości: max-snippet z liczbą znaków, max-image-preview z ustawieniem none, standard lub large oraz max-video-preview z liczbą sekund. Ich znaczenie jest takie samo jak w Google, łącznie z tym, że zero wyłącza fragment tekstu, a wartość -1 znosi limit. Bing zaznaczył przy tym, że traktuje te zapisy jako polecenia, a nie jako wskazówki, oraz że nosnippet pozostaje obsługiwany. Reguły można podać w kodzie HTML albo w nagłówku X-Robots-Tag.
Z tego samego zestawienia wynika, że wartości all, none i noimageindex są opisane jako obsługiwane przez Google, a przy Bing się nie pojawiają. Wniosek praktyczny jest prosty: jeśli zależy Państwu na jednakowym działaniu w obu wyszukiwarkach, bezpieczniej zapisać noindex, nofollow pełnymi słowami, niż posługiwać się skrótem none.
Jak łączyć dyrektywy i co się dzieje przy sprzecznych zapisach
Dyrektywy łączy się, wpisując je po przecinku w jednym atrybucie content albo umieszczając na podstronie kilka osobnych znaczników meta. Oba sposoby Google traktuje jednakowo. Gdy reguły sobie przeczą, obowiązuje ta bardziej restrykcyjna, co dokumentacja ilustruje przykładem: przy jednoczesnym zapisie max-snippet:50 i nosnippet zastosowanie ma nosnippet.
<meta name="robots" content="max-snippet:150, max-image-preview:large">

<meta name="robots" content="max-snippet:150">
<meta name="robots" content="max-image-preview:large">
Zasada bardziej restrykcyjnej reguły ma duże znaczenie na stronach opartych na gotowych systemach. Zdarza się, że szablon dodaje jeden znacznik, wtyczka do optymalizacji drugi, a programista dopisuje trzeci w nagłówku serwera. Jeśli w którymkolwiek z tych miejsc pojawi się noindex, to właśnie on zadecyduje o losie podstrony, niezależnie od tego, że w innym znaczniku stoi index. Z kolei MDN Web Docs zwraca uwagę, że zachowanie robotów przy wzajemnie wykluczających się parach, takich jak index i noindex, nie jest nigdzie jednolicie określone. Najbezpieczniej więc dopilnować, aby podstrona miała jeden, spójny zestaw reguł.
Połączenia, które mają sens
Najczęściej spotykane połączenie to noindex, follow, czyli w praktyce samo noindex, bo korzystanie z linków jest ustawieniem domyślnym. Stosuje się je na podstronach, które nie powinny być w wynikach, ale prowadzą do ważnych treści. Zestaw noindex, nofollow wybiera się dla podstron, które są całkowicie poza zainteresowaniem wyszukiwarki, na przykład dla wersji testowej serwisu. Połączenie max-snippet z max-image-preview:large pozwala z kolei zostawić Google swobodę w pokazywaniu dużych obrazów przy jednoczesnej kontroli długości opisu.
Osobnym przypadkiem jest para noindex, indexifembedded. Przydaje się firmom, które udostępniają własne materiały do osadzania na cudzych stronach, na przykład odtwarzacz z filmem instruktażowym. Sam adres odtwarzacza nie powinien pojawiać się w wynikach, ale treść osadzona na stronie partnera może zostać zindeksowana razem z tą stroną.
Dyrektywa z datą wygaśnięcia
Wartość unavailable_after wymaga podania dnia i godziny w jednym z powszechnie używanych formatów zapisu daty. Dokumentacja Google wymienia tu RFC 822, RFC 850 oraz ISO 8601 i zastrzega, że data zapisana nieprawidłowo zostanie zignorowana. Po upływie terminu podstrona przestaje być wyświetlana, a robot zagląda na nią znacznie rzadziej. To wygodne rozwiązanie dla ogłoszeń o naborze, ofert sezonowych i zapowiedzi wydarzeń, które po określonym dniu tracą sens.
Czym różni się znacznik dla wszystkich robotów od znacznika dla Googlebota
Różnica tkwi w atrybucie name. Znacznik o nazwie robots jest skierowany do wszystkich wyszukiwarek, które obsługują dane reguły, a znacznik o nazwie googlebot wyłącznie do Google. Potwierdza to strona Metatagi i atrybuty obsługiwane przez Google. Dzięki temu na jednej podstronie można ustawić inne zasady dla Google, a inne dla pozostałych robotów.
<meta name="robots" content="nofollow">
<meta name="googlebot" content="noindex">
W znaczniku meta Google rozpoznaje dwie nazwy własnych robotów: googlebot, odpowiadający za zwykłe wyniki wyszukiwania, oraz googlebot-news, odpowiadający za Wiadomości Google. Inne wartości wpisane w atrybucie name są pomijane. Ma to znaczenie na przykład dla wydawców, którzy chcą pozostać w zwykłych wynikach, ale nie w Wiadomościach, albo odwrotnie.
Trzeba też wiedzieć, jak Google łączy regułę ogólną ze szczegółową. Ograniczenia się sumują. W przykładzie powyżej Googlebot zastosuje zarówno nofollow ze znacznika ogólnego, jak i noindex ze znacznika skierowanego do niego, czyli potraktuje podstronę tak, jakby miała zapis noindex, nofollow. Nie da się więc znacznikiem dla Googlebota złagodzić ograniczenia zapisanego dla wszystkich robotów. Jeśli ogólny znacznik zawiera noindex, dopisanie dla Google wartości index niczego nie zmieni.
Znacznik meta robots nie jest przy tym narzędziem do sterowania robotami, które pobierają treści na potrzeby uczenia modeli sztucznej inteligencji. Do tego służą reguły w pliku robots.txt, o których piszemy we wpisie roboty AI i robots.txt.
Kiedy noindex działa, a kiedy robot go nie zobaczy
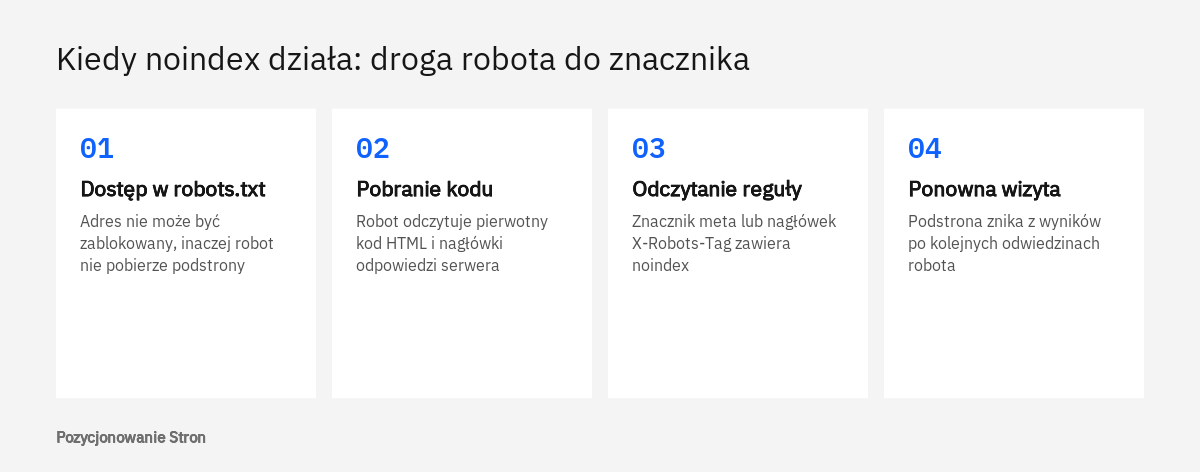
Dyrektywa noindex działa tylko wtedy, gdy robot może pobrać podstronę i odczytać jej kod. Jeżeli dostęp do adresu blokuje plik robots.txt, robot nie zobaczy ani znacznika meta, ani nagłówka X-Robots-Tag, więc nie będzie ich przestrzegać. Google pisze o tym wprost na stronie Blokowanie indeksowania przez wyszukiwarki za pomocą tagu noindex i dodaje, że taka zablokowana podstrona może nadal pojawiać się w wynikach, na przykład wtedy, gdy prowadzą do niej linki z innych witryn.
To najczęstsze nieporozumienie związane ze znacznikiem. Właściciel strony chce mieć pewność, więc stosuje dwa zabezpieczenia jednocześnie: wpisuje noindex i dodatkowo zakazuje robotom wstępu w pliku robots.txt. Efekt jest odwrotny do zamierzonego, bo drugie zabezpieczenie uniemożliwia odczytanie pierwszego. Jak napisać ten plik, aby nie zasłaniał robotom ważnych informacji, opisujemy we wpisie plik robots.txt: jak go napisać.
Ile trwa zniknięcie podstrony z wyników
Podstrona nie znika z wyników w chwili dodania znacznika. Robot musi ją najpierw ponownie odwiedzić i odczytać nową regułę. Google informuje, że w zależności od znaczenia podstrony w internecie może minąć nawet kilka miesięcy, zanim robot do niej wróci. Proces można przyspieszyć, prosząc o ponowne zindeksowanie adresu w narzędziu do sprawdzania adresów URL w Search Console. Jeśli treść musi zniknąć pilnie, dokumentacja odsyła do osobnych procedur usuwania treści z wyników.
Noindex a strony budowane skryptami
Na stronach, których treść powstaje w przeglądarce za pomocą języka JavaScript, liczy się to, co znajduje się w pierwotnym kodzie HTML wysłanym przez serwer. W dokumencie JavaScript a SEO - podstawy Google wyjaśnia, że po napotkaniu noindex może pominąć renderowanie podstrony i wykonywanie skryptów. Oznacza to, że usuwanie znacznika skryptem jest zawodne: jeśli noindex stoi w kodzie początkowym, skrypt, który miał go zdjąć, może w ogóle nie zostać uruchomiony. Podstrona, która ma być w indeksie, nie powinna mieć tej dyrektywy w kodzie początkowym.
Miejsce znacznika w kodzie
Znacznik powinien znajdować się w sekcji head, a sama sekcja musi być poprawnie zbudowana. Jednocześnie specyfikacja Google zaznacza, że znacznik meta robots umieszczony w części body również zostanie uwzględniony. Jeśli więc fragment kodu z noindex trafi do treści podstrony przypadkiem, na przykład wklejony razem z osadzonym elementem, Google może go potraktować poważnie. Kontrola takich wdrożeń to typowy element prac, które prowadzimy w ramach usługi SEO techniczne.
Jeśli chcą Państwo zamówić SEO techniczne, zachęcamy do kontaktu: tel. 222 500 844 lub mailowo: biuro@pozycjonowaniestron.pl
Kiedy zamiast znacznika potrzebny jest nagłówek X-Robots-Tag
Nagłówek X-Robots-Tag jest potrzebny wtedy, gdy zasób nie ma kodu HTML, w którym dałoby się umieścić znacznik: przy plikach PDF, obrazach, filmach czy arkuszach. Serwer wysyła go razem z odpowiedzią na żądanie pliku, a w jego treści można podać te same reguły, co w znaczniku meta. Można wysłać kilka takich nagłówków albo jeden z listą reguł oddzielonych przecinkami.
HTTP/1.1 200 OK
Content-Type: application/pdf
X-Robots-Tag: noindex

X-Robots-Tag: googlebot: nofollow
Podobnie jak w znaczniku meta, regułę można ograniczyć do jednego robota, wpisując jego nazwę przed dwukropkiem. Reguła bez nazwy dotyczy wszystkich robotów. Specyfikacja Google zawiera gotowe przykłady ustawień dla popularnych serwerów, między innymi takie, które wyłączają z indeksu wszystkie pliki PDF w serwisie.
Nagłówek ma jedną istotną wadę: nie widać go w kodzie źródłowym podstrony. Z naszej praktyki wynika, że to jedna z trudniejszych do wykrycia przyczyn problemów z indeksowaniem, zwłaszcza po zmianie serwera, gdy ustawienia zostały skopiowane z wersji testowej. Zasada odczytu pozostaje ta sama, co przy znaczniku: jeśli plik jest zablokowany w robots.txt, robot nagłówka nie otrzyma.
Przykład z życia: kancelaria z Krakowa udostępnia klientom wzory pism w plikach PDF, które zaczynają pojawiać się w wynikach zamiast podstron z opisem usług. Rozwiązaniem jest nagłówek z regułą noindex ustawiony dla katalogu z dokumentami. Pliki nadal można pobrać ze strony, a w wynikach zostają podstrony, które prowadzą do kontaktu.
Gdzie stosować meta robots na stronie firmowej i w sklepie
Znacznik z dyrektywą noindex stosuje się na podstronach, które są potrzebne użytkownikom, ale nie powinny być punktem wejścia z wyszukiwarki. Poniższe przykłady to obserwacje z naszej praktyki, a nie zalecenia wyszukiwarek, dlatego każdy przypadek wymaga oceny na konkretnej stronie.
Strona firmowa
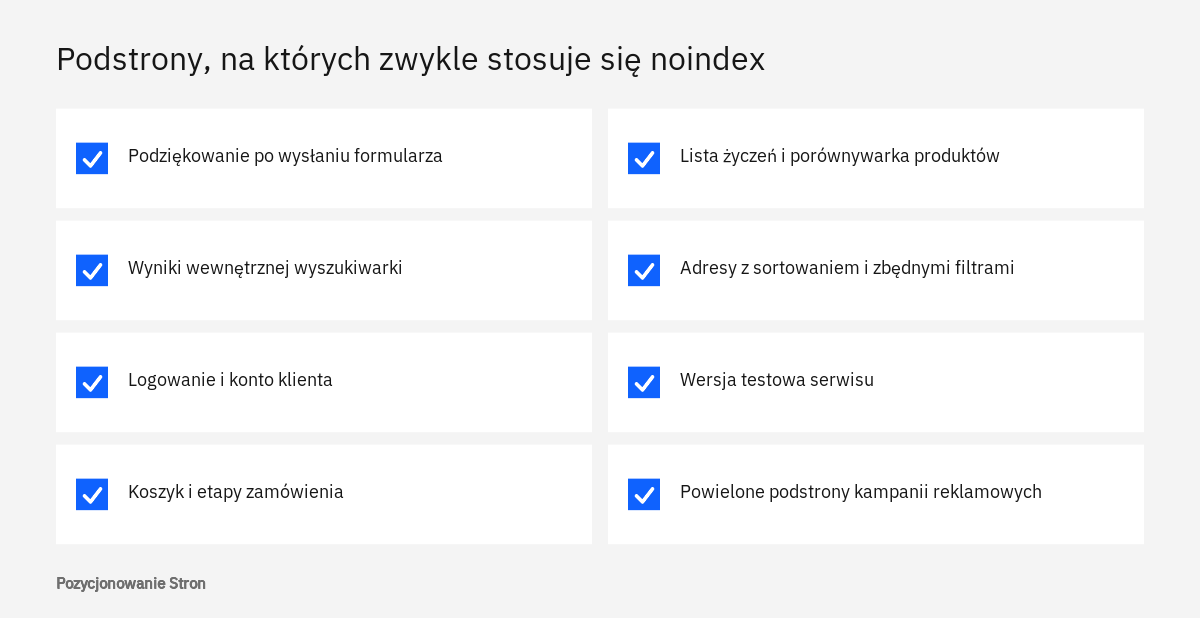
Na stronie usługowej dyrektywa noindex trafia zwykle na podstrony z podziękowaniem po wysłaniu formularza, wyniki wewnętrznej wyszukiwarki, strony logowania do strefy klienta oraz podstrony przygotowane wyłącznie pod kampanie reklamowe, jeśli powielają ofertę opisaną gdzie indziej. Przykładowo hydraulik z Łodzi, który prowadzi kampanię w Google Ads na osobnej podstronie z formularzem, może wyłączyć ją z indeksu, aby w wynikach organicznych pojawiała się pełna podstrona usługi.
Szczególnej uwagi wymaga wersja testowa serwisu. W systemie WordPress służy do tego opcja w ustawieniach czytania, która prosi wyszukiwarki o nieindeksowanie witryny. Zgodnie z dokumentacją WordPressa po jej zaznaczeniu system od wersji 5.3 dodaje do każdej podstrony znacznik meta robots z wartościami noindex i nofollow. Kłopot zaczyna się wtedy, gdy ustawienie zostaje przeniesione na wersję produkcyjną. Dlatego sprawdzenie tej jednej opcji powinno być stałym punktem każdego uruchomienia nowej strony, o czym przypominamy także we wpisie o migracji strony.
Sklep internetowy
W sklepie podstron technicznych jest znacznie więcej. Koszyk, kolejne etapy zamówienia, konto klienta, lista życzeń i porównywarka produktów nie niosą treści, której ktoś szuka w Google, więc zazwyczaj otrzymują noindex. Systemy takie jak WooCommerce, PrestaShop czy Shopify część z tych ustawień wprowadzają samodzielnie, ale po instalacji dodatków i zmianie szablonu warto to zweryfikować.
Trudniejszą decyzją są adresy powstające po użyciu filtrów i sortowania. Sklep z Poznania sprzedający oświetlenie może mieć kilkadziesiąt kategorii, ale po połączeniu filtrów koloru, mocy i ceny liczba adresów rośnie wielokrotnie. Część z nich odpowiada na prawdziwe zapytania klientów i zasługuje na własną, dopracowaną podstronę, a reszta jest tylko innym układem tych samych produktów. Dla tej drugiej grupy rozważa się noindex albo adres kanoniczny wskazujący kategorię główną. Wybór między nimi omawiamy we wpisie o adresie kanonicznym. Kart produktów, kategorii i wpisów blogowych nie należy natomiast oznaczać dyrektywą noindex, nawet czasowo, bo powrót do indeksu może potrwać.
Adresy oznaczone noindex nie powinny też znajdować się w mapie witryny XML. Z naszej praktyki wynika, że mieszanie w niej adresów do indeksowania z adresami wyłączonymi utrudnia późniejsze czytanie raportów.
Jak sprawdzić, jakie dyrektywy widzi robot na Państwa stronie
Najpewniejszym sposobem jest narzędzie do sprawdzania adresów URL w Google Search Console, ponieważ pokazuje kod HTML, który Googlebot faktycznie pobrał. Po zalogowaniu wystarczy wkleić pełny adres podstrony w pole wyszukiwania u góry ekranu. Google wskazuje to narzędzie zarówno do kontroli poprawności wdrożenia noindex, jak i do zgłaszania prośby o ponowne zindeksowanie.
Obraz całej witryny daje raport Indeksowanie stron, dostępny w menu po lewej stronie w grupie Indeksowanie, pod pozycją Strony. W części z powodami niezindeksowania należy odszukać pozycję dotyczącą tagu noindex. Pomoc Search Console opisuje ją jako sytuację, w której Google przy próbie zindeksowania podstrony napotkał dyrektywę noindex i nie wykonał tego działania. Po kliknięciu wyświetla się lista adresów. Jeśli są na niej wyłącznie podstrony techniczne, wszystko jest w porządku. Jeśli znajdują się tam podstrony usług, kategorie lub wpisy, trzeba ustalić, skąd wziął się znacznik.
W tym samym raporcie warto zwrócić uwagę na ostrzeżenie o podstronach zindeksowanych mimo blokady w pliku robots.txt. To opisany wcześniej przypadek, w którym robot nie mógł odczytać reguł. Pomoc Search Console zaleca wtedy usunięcie blokady z pliku i zastosowanie noindex. Pozostałe statusy objaśniamy we wpisie dlaczego Google nie indeksuje strony.
Typowe pomyłki
W audytach najczęściej spotykamy kilka powtarzających się błędów: znacznik noindex pozostawiony po zakończeniu prac nad nową wersją strony, jednoczesną blokadę w robots.txt i noindex na tej samej podstronie, dwa znaczniki o sprzecznej treści pochodzące z szablonu i z wtyczki, a także noindex ustawiony przez nieuwagę na całej grupie podstron. Poniższa lista pomaga przejść przez najważniejsze punkty kontroli.
- Strona główna, podstrony usług, kategorie i produkty nie mają dyrektywy noindex ani w kodzie, ani w nagłówku serwera.
- Podstrony z noindex nie są zablokowane w pliku robots.txt.
- Każda podstrona ma jeden spójny zestaw reguł, bez sprzecznych znaczników.
- W systemie zarządzania treścią wyłączona jest opcja zniechęcająca wyszukiwarki do indeksowania witryny.
- Lista adresów ze statusem dotyczącym tagu noindex w Search Console zawiera wyłącznie podstrony, które miały zostać wyłączone.
- Po każdej zmianie szablonu, wtyczki lub serwera kontrola jest powtarzana.
Pomoc specjalisty przydaje się przede wszystkim wtedy, gdy źródła znacznika nie widać w panelu systemu, gdy serwis liczy tysiące adresów z filtrami albo gdy widoczność spadła po przebudowie strony. W takich sytuacjach kontrola dyrektyw jest częścią szerszej analizy, którą wykonujemy jako audyt SEO.
Jeśli chcą Państwo zamówić SEO techniczne, zachęcamy do kontaktu: tel. 222 500 844 lub mailowo: biuro@pozycjonowaniestron.pl
Najczęstsze pytania
Czy trzeba dodawać znacznik index, follow na każdej podstronie?
Nie. Indeksowanie i korzystanie z linków to ustawienia domyślne, więc brak znacznika oznacza dokładnie to samo. Google podaje, że jawne wpisanie braku ograniczeń nie daje żadnego efektu.
Czy noindex i blokadę w robots.txt można stosować razem?
Nie powinno się tego robić. Robot, który nie może pobrać podstrony, nie odczyta znacznika, a adres może pozostać w wynikach, jeśli prowadzą do niego linki. Aby noindex zadziałał, podstrona musi być dostępna dla robota.
Jak szybko podstrona z noindex znika z Google?
Dopiero po ponownej wizycie robota. Google zaznacza, że w zależności od znaczenia podstrony może to potrwać nawet kilka miesięcy. Proces przyspiesza prośba o ponowne zindeksowanie w narzędziu do sprawdzania adresów URL w Search Console.
Czym różni się nofollow w znaczniku meta od nofollow przy linku?
Znacznik meta obejmuje wszystkie linki na podstronie jednocześnie, a atrybut rel dotyczy jednego wybranego odnośnika. Do oznaczania pojedynczych linków reklamowych lub dodanych przez użytkowników Google przewiduje osobne wartości atrybutu rel.
Czy nosnippet wyłącza treść z odpowiedzi AI w Google?
Według dokumentacji Google reguła nosnippet obejmuje przeglądy od AI i tryb AI, a max-snippet ogranicza ilość treści wykorzystywanej w tych funkcjach. Trzeba jednak liczyć się z tym, że zwykły wynik również straci opis.
Jak wyłączyć z wyników plik PDF?
W pliku PDF nie ma miejsca na znacznik meta, dlatego stosuje się nagłówek HTTP X-Robots-Tag z regułą noindex, ustawiany w konfiguracji serwera. Plik nie może być przy tym zablokowany w robots.txt, bo robot nie otrzyma wtedy nagłówka.
Źródła
- Specyfikacje tagu meta Robots, data-nosnippet i X-Robots-Tag, Google Search Central
- Blokowanie indeksowania przez wyszukiwarki za pomocą tagu noindex, Google Search Central
- Metatagi i atrybuty obsługiwane przez Google, Google Search Central
- JavaScript a SEO - podstawy, Google Search Central
- Kwalifikowanie linków wychodzących na potrzeby wyszukiwarki Google, Google Search Central
- Raport Indeksowanie stron, Pomoc Search Console
- Announcing new options for webmasters to control their snippets at Bing, Bing Webmaster Blog
- meta name="robots" HTML attribute value, MDN Web Docs
- Settings Reading screen, WordPress.org
Funkcje wyszukiwarek i asystentów AI zmieniają się szybko, dlatego wpis aktualizujemy po większych zmianach.