Raport dotyczący pliku robots.txt w Search Console pokazuje, które pliki robots.txt Google znalazł w Państwa witrynie, kiedy ostatnio je pobrał, z jakim skutkiem i czy przy ich odczytywaniu pojawiły się błędy lub ostrzeżenia. Dzięki niemu widać nie to, co leży na serwerze w tej chwili, lecz to, czym faktycznie kierują się roboty Google, a po pilnej poprawce można poprosić o szybsze pobranie nowej wersji.
Czym jest raport dotyczący pliku robots.txt i co zastąpił
Raport dotyczący pliku robots.txt to widok w Search Console, który przedstawia stan plików robots.txt z perspektywy Google: listę plików znalezionych na hostach witryny, wynik ostatniej próby pobrania każdego z nich, treść pobranej wersji oraz problemy wykryte podczas jej analizowania. Odpowiada więc na pytanie, które przy awariach widoczności pada jako jedno z pierwszych: co dokładnie Google ma teraz zapisane jako reguły dla Państwa strony.
Zwykły plik tekstowy umieszczony w katalogu głównym hosta, który informuje roboty wyszukiwarek, do jakich adresów w witrynie mogą wysyłać żądania. Służy do zarządzania ruchem robotów, a nie do ukrywania stron w wynikach wyszukiwania.
Wielu właścicieli stron pamięta dawny tester pliku robots.txt, w którym wklejało się adres i od razu otrzymywało informację, czy dana reguła go blokuje. Obecnie dokumentacja Google, opisując tworzenie i testowanie pliku robots.txt, wymienia dwa narzędzia: raport dotyczący pliku robots.txt w Search Console oraz bibliotekę o otwartym kodzie źródłowym, przeznaczoną dla programistów, która pozwala testować pliki lokalnie na komputerze. Rola raportu jest przy tym inna niż rola dawnego testera. Raport nie służy do wpisywania pojedynczych adresów, tylko do kontroli samego pliku: czy został pobrany, w jakiej wersji i czy Google rozumie wszystkie jego wiersze. Pytanie o konkretną podstronę przeniosło się do narzędzia do sprawdzania adresów URL, o czym piszemy w dalszej części.
Warto od początku rozdzielić dwie sprawy, które w praktyce często się zlewają. Plik robots.txt steruje skanowaniem, czyli tym, czy robot w ogóle pobierze stronę. Nie decyduje o tym, czy adres pojawi się w wynikach. Google we wprowadzeniu do pliku robots.txt zaznacza wprost, że nie jest to mechanizm ukrywania strony przed wyszukiwarką: zablokowany adres może trafić do wyników, jeśli prowadzą do niego linki z innych witryn, tyle że bez opisu. Do wykluczania z wyników służy znacznik noindex albo zabezpieczenie hasłem. Raport pomaga więc w diagnozie skanowania, a nie w zarządzaniu tym, co jest widoczne w wyszukiwarce.
Gdzie w Search Console znajduje się raport
Raport znajduje się w ustawieniach usługi. Po zalogowaniu do Search Console i wskazaniu właściwej usługi należy przejść do pozycji ustawień w menu bocznym, a następnie otworzyć raport dotyczący pliku robots.txt. Nie ma go wśród raportów o indeksowaniu ani o skuteczności, dlatego osoby, które szukają go w głównym menu, często dochodzą do wniosku, że w ich koncie go brakuje.
Dostępność raportu zależy od rodzaju usługi. Według pomocy Search Console raport jest dostępny dla usług domenowych oraz dla usług z prefiksem adresu URL, o ile prefiks wskazuje na katalog główny hosta. Usługa założona dla adresu w rodzaju https://example.com/ go pokaże, natomiast usługa założona dla samego podkatalogu, na przykład https://example.com/blog/, już nie. Ma to proste uzasadnienie: plik robots.txt zawsze dotyczy całego hosta, więc nie da się go przypisać do części witryny.
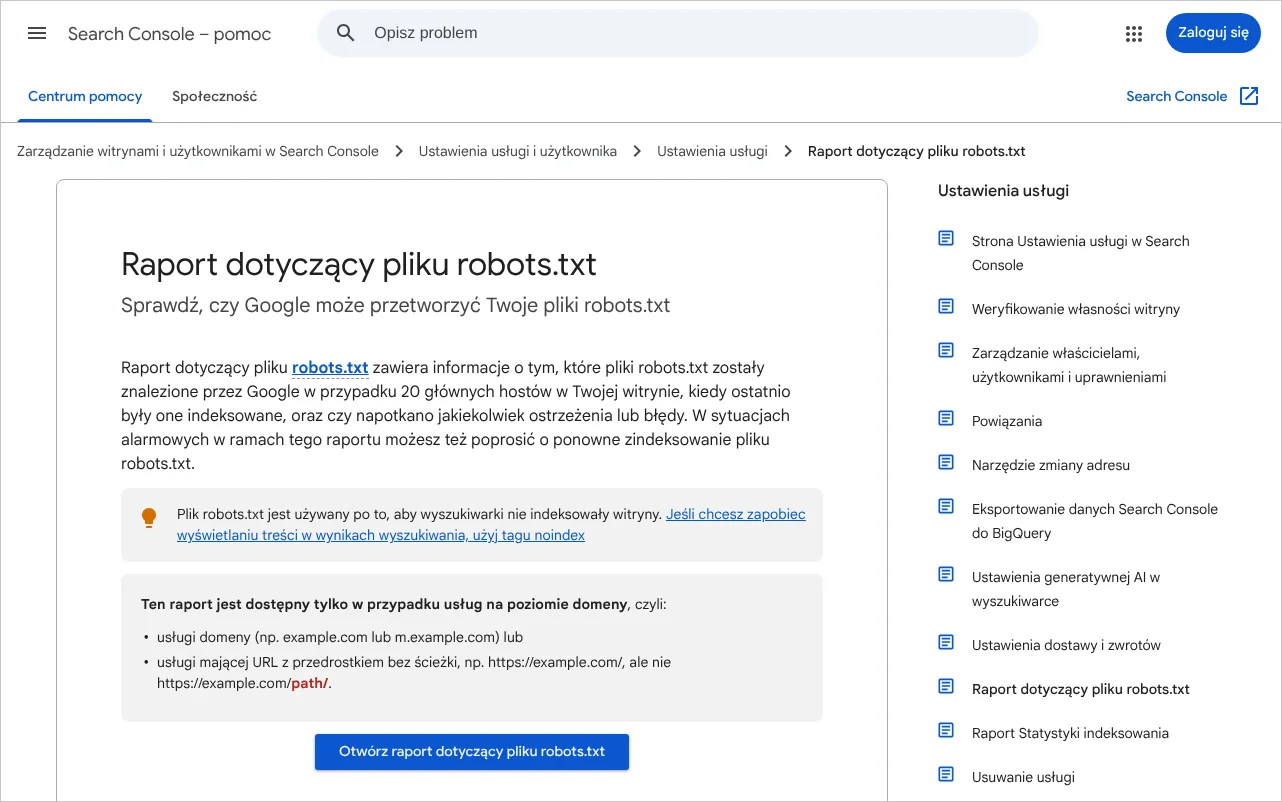
Rodzaj usługi wpływa również na to, ile plików pojawi się na liście. Usługa domenowa obejmuje wszystkie protokoły i subdomeny, więc pokaże pliki z wielu hostów naraz. Usługa z prefiksem adresu URL sprawdza wyłącznie własny adres źródłowy, czyli jedno połączenie protokołu i hosta. Jeżeli firma ma osobno sklep, blog i panel klienta w subdomenach, pełny obraz daje usługa domenowa. Gdy pliku z któregoś hosta na liście brakuje, pomoc Search Console podpowiada rozwiązanie: można założyć odrębną usługę dla tej subdomeny i tam sprawdzić jej plik.
Lista plików robots.txt dla hostów usługi
Lista w raporcie obejmuje pliki robots.txt z maksymalnie 20 najważniejszych hostów witryny, przy czym o kolejności decyduje to, jak intensywnie Google je skanuje. Dla każdej domeny raport może pokazać dwa adresy źródłowe, czyli wersję http i https, dlatego tabela może liczyć do 40 wierszy. W małej firmie zwykle zobaczą Państwo od jednego do czterech wierszy: wersje z www i bez www, każdą w dwóch protokołach.
Skąd tyle plików, skoro na serwerze leży jeden? Odpowiedź wynika z zasady opisanej w dokumencie o interpretowaniu specyfikacji robots.txt przez Google: reguły obowiązują tylko dla tego hosta, protokołu i numeru portu, pod którymi plik jest udostępniony. Subdomena potrzebuje własnego pliku, a plik umieszczony w podkatalogu jest pomijany. Adres https://example.com/robots.txt nie dotyczy więc ani adresów z http, ani subdomeny www, ani subdomeny sklep. Pomoc Search Console podaje prosty sposób na ustalenie, który plik odpowiada za daną podstronę: w jej adresie wystarczy zastąpić wszystko, co następuje po nazwie hosta, ścieżką /robots.txt. Dla strony https://images.example.com/flowers/daffodil.png będzie to https://images.example.com/robots.txt. Do jednej strony zawsze stosuje się tylko jeden plik.
Wyobraźmy sobie przykładowy sklep z Poznania, który główną witrynę prowadzi pod adresem z www, a blog w subdomenie. Po przeniesieniu bloga na nowy serwer wpisy przestają pojawiać się w Google. Właściciel sprawdza plik robots.txt głównej domeny i nie widzi w nim nic niepokojącego. Dopiero lista w raporcie pokazuje osobny wiersz dla subdomeny bloga, a w nim plik z regułą blokującą całość, pozostawiony po wersji testowej. To zmyślona sytuacja, ale dobrze oddaje sens listy: przypomina, że każdy host ma własne zasady i każdy trzeba obejrzeć osobno.
Co oznaczają kolumny raportu i stany pobierania
Każdy wiersz raportu opisuje jeden plik pięcioma polami: ścieżką pliku, stanem pobierania, czasem ostatniego sprawdzenia, rozmiarem oraz liczbą problemów. Najważniejszy jest stan pobierania, ponieważ od niego zależy, czy Google stosuje Państwa reguły, czy też skanuje witrynę bez żadnych ograniczeń albo wstrzymuje skanowanie.
| Pole w raporcie | Co pokazuje | Na co zwrócić uwagę |
|---|---|---|
| Ścieżka pliku | Pełny adres, pod którym Google szukał pliku | Wiersz jest widoczny tylko wtedy, gdy w ostatnich 30 dniach odnotowano pobranie albo nieudaną próbę |
| Stan pobierania | Wynik ostatniego żądania pliku | Trzy możliwości: pobrano, nie pobrano z powodu braku pliku (404), nie pobrano z innego powodu |
| Sprawdzono | Moment ostatniej próby pobrania, w czasie lokalnym | Jeśli jest wcześniejszy niż Państwa poprawka, Google nadal korzysta ze starej wersji |
| Rozmiar | Wielkość pobranego pliku w bajtach | Pole pozostaje puste, gdy ostatnia próba się nie powiodła |
| Problemy | Liczba błędów i ostrzeżeń z analizy ostatnio pobranej treści | Błąd wyłącza regułę z użycia, ostrzeżenie nie |
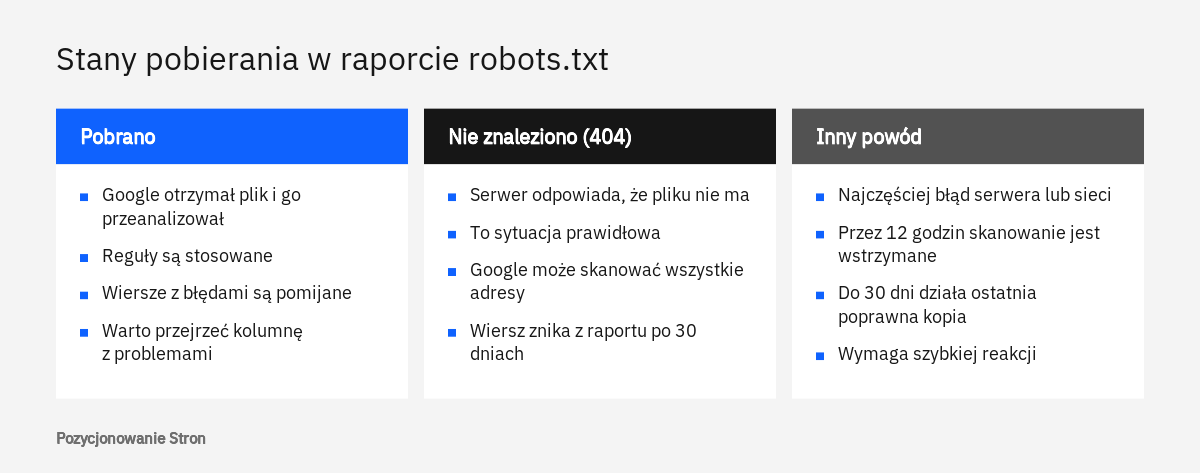
Pobrano
Stan ten oznacza, że Google otrzymał plik i go przeanalizował. Nie oznacza jeszcze, że plik jest poprawny. Jeżeli podczas analizowania pojawiły się kłopoty, ich liczba trafia do kolumny z problemami, a Google pomija wiersze, których nie potrafi odczytać, i stosuje pozostałe. Plik ze stanem pobrania i z błędami jest więc plikiem działającym częściowo, co łatwo przeoczyć.
Nie pobrano - nie znaleziono (404)
Serwer odpowiedział, że pliku nie ma. Wbrew pierwszemu wrażeniu nie jest to awaria. Pomoc Search Console zaznacza, że brak pliku robots.txt to sytuacja prawidłowa i oznacza po prostu, że Google może skanować wszystkie adresy w witrynie. Po 30 dniach taki wiersz znika z raportu, choć Google dalej sprawdza w tle, czy plik się nie pojawił. Reakcja jest potrzebna tylko w dwóch przypadkach: gdy plik miał istnieć i zniknął, na przykład po migracji, albo gdy witryna ma sekcje, których roboty nie powinny odwiedzać.
Nie pobrano - dowolny inny powód
To stan wymagający najszybszej reakcji. Oznacza, że przy żądaniu pliku wystąpił inny kłopot niż zwykły brak pliku, a pomoc odsyła w tym miejscu do listy problemów z indeksowaniem. Najczęściej chodzi o błędy serwera. Dokumentacja opisuje ich skutki dokładnie: przez pierwsze 12 godzin Google wstrzymuje skanowanie witryny i ponawia próby pobrania pliku, następnie przez okres do 30 dni korzysta z ostatniej poprawnie pobranej kopii, a jeżeli błędy trwają dłużej i witryna jest ogólnie dostępna, zachowuje się tak, jakby pliku nie było. Gdy sama witryna też jest niedostępna, skanowanie ustaje. Tak samo jak błędy serwera traktowane są awarie sieci i usługi nazw domen, przekroczenia czasu oczekiwania oraz zerwane połączenia. Tło tych zasad omawiamy szerzej we wpisie o tym, jak Googlebot traktuje kody odpowiedzi HTTP.
Jak sprawdzić, którą wersję pliku widzi Google
Aby zobaczyć wersję, którą Google ma obecnie w pamięci, wystarczy kliknąć wybrany plik na liście w raporcie. Otworzy się treść ostatnio pobranej wersji razem z informacją o czasie pobrania. To właśnie ten tekst, a nie zawartość serwera, jest podstawą decyzji robota o tym, które adresy wolno mu odwiedzić.
Rozbieżność między serwerem a raportem jest czymś zwyczajnym i ma dobrze opisaną przyczynę. Google zazwyczaj przechowuje plik robots.txt w pamięci podręcznej do 24 godzin. Jeśli odświeżenie się nie uda, na przykład z powodu przekroczenia czasu oczekiwania albo błędu serwera, kopia może być używana dłużej. Czas przechowywania może też zostać wydłużony lub skrócony na podstawie nagłówka Cache-Control z wartością max-age, który serwer wysyła razem z plikiem. W praktyce oznacza to, że reguła usunięta rano może obowiązywać jeszcze przez wiele godzin, a reguła dopisana przez pomyłkę może przez ten sam czas pozostać niezauważona przez roboty.
Raport pozwala również cofnąć się w czasie. Dla każdego pliku dostępne są wersje pobrane w ciągu ostatnich 30 dni, przy czym nowa pozycja w historii pojawia się tylko wtedy, gdy treść pliku albo wynik pobrania różniły się od poprzedniego żądania. Historia nie jest więc dziennikiem wszystkich wizyt robota, lecz listą zmian. To wygodne przy ustalaniu przyczyn spadku ruchu: jeśli plik przez kilka dni zawierał regułę blokującą całą witrynę, a potem wrócił do poprawnej postaci, na serwerze nie ma już po tym śladu, natomiast raport pokazuje, kiedy błąd się pojawił i kiedy został cofnięty.
Historię warto zestawiać z innymi danymi. Raport Statystyki indeksowania, dostępny także w ustawieniach usługi, pokazuje w części o stanie hosta wykres pobierania pliku robots.txt, czyli odsetek żądań tego pliku zakończonych niepowodzeniem. Pomoc Google wyjaśnia przy nim, że za prawidłowe uznaje się odpowiedź 200 z plikiem, nawet pustym lub zawierającym błędy składni, a także odpowiedzi 403, 404 i 410. Nieprawidłowe są kod 429 oraz błędy z grupy 5xx. Jeśli raport robots.txt pokazuje pojedynczą nieudaną próbę, wykres w statystykach pozwala ocenić, czy to incydent, czy powtarzający się kłopot z serwerem.
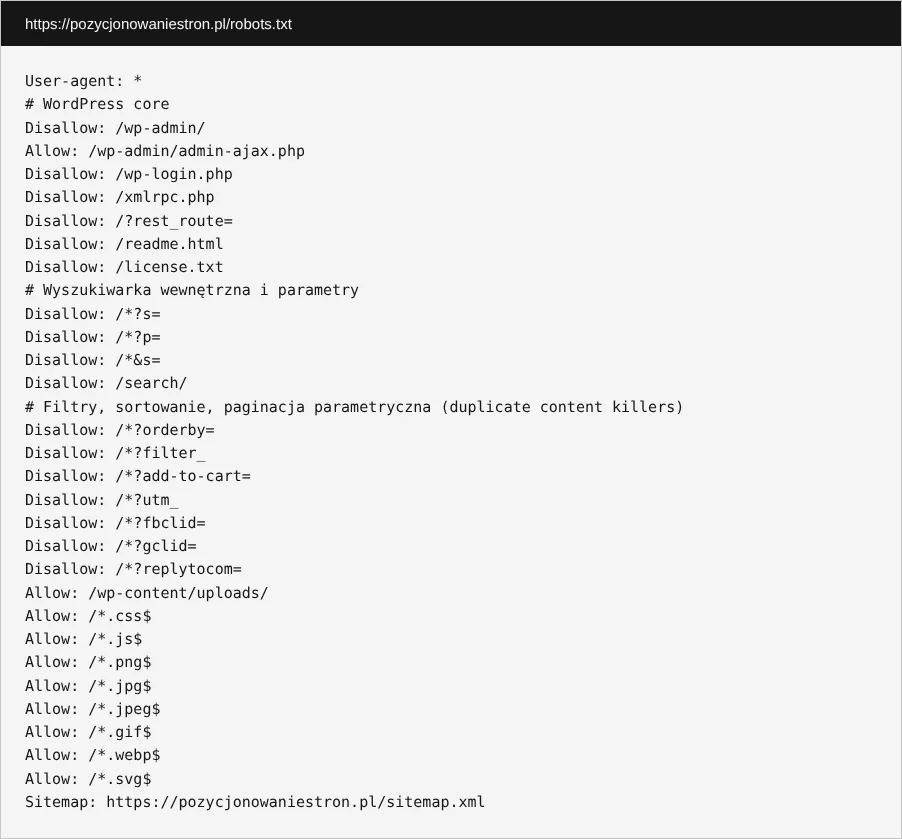
Dobrym nawykiem jest też porównanie pobranej wersji z tym, co widać publicznie pod adresem pliku. Powyżej znajduje się plik robots.txt naszego serwisu w postaci dostępnej dla każdego. W poprawnie działającej witrynie treść z raportu i treść z przeglądarki są takie same albo różnią się wyłącznie o zmiany wprowadzone w ostatnich godzinach.
Jak poprosić o ponowne pobranie pliku po pilnej poprawce
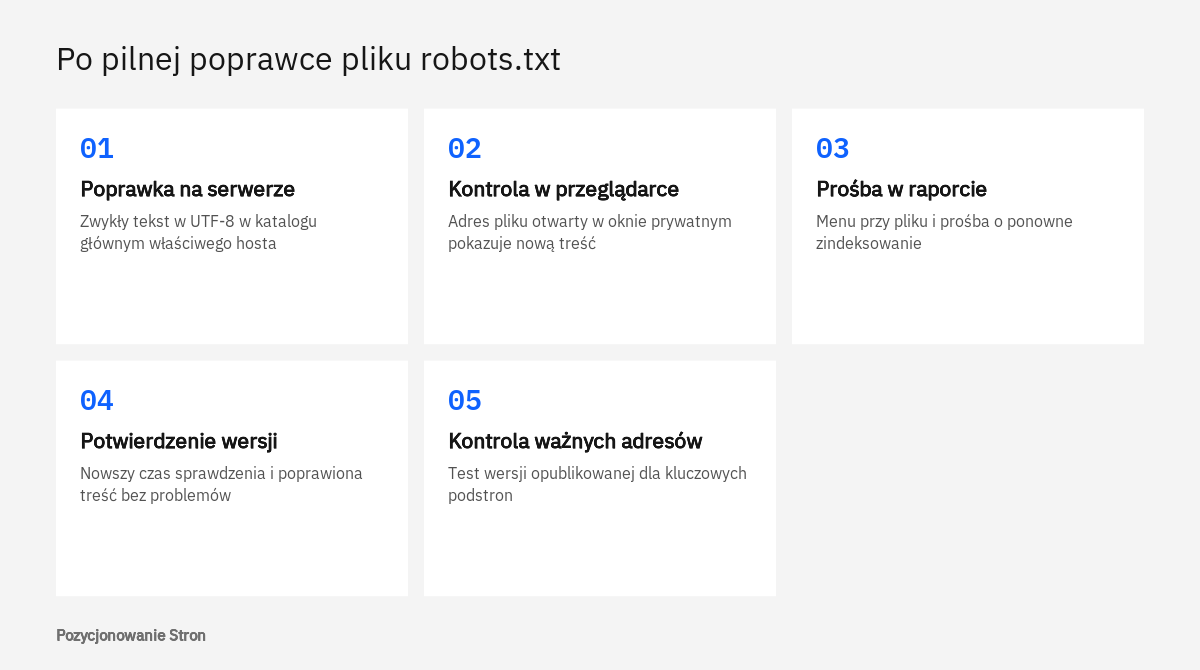
Po pilnej poprawce należy otworzyć raport, znaleźć na liście właściwy plik, kliknąć ikonę dodatkowych ustawień widoczną obok niego i wskazać opcję prośby o ponowne zindeksowanie. Mimo nazwy opcja ta dotyczy samego pliku robots.txt: jest prośbą, aby Google pobrał go wcześniej, niż zrobiłby to w zwykłym trybie.
W codziennej pracy nie trzeba z niej korzystać. Pomoc Search Console zaznacza, że Google często sam ponownie pobiera plik, a dokumentacja o aktualizowaniu pliku robots.txt podaje, że roboty wykrywają zmiany podczas zwykłego skanowania i odświeżają przechowywaną wersję co 24 godziny. Prośba ma sens w dwóch sytuacjach wymienionych przez Google: gdy zmienili Państwo reguły, aby odblokować ważne adresy, oraz gdy usunęli Państwo błąd pobierania albo inny krytyczny błąd. Google zastrzega przy tym, że prośba nie gwarantuje natychmiastowego ponownego skanowania odblokowanych stron. Nowa wersja pliku to dopiero pierwszy warunek: same podstrony robot odwiedzi w swoim rytmie.
- Poprawka na serwerze
Plik należy zapisać jako zwykły tekst w kodowaniu UTF-8 i umieścić w katalogu głównym właściwego hosta. Do edycji służy zwykły edytor tekstu, ponieważ procesory tekstu potrafią wstawić niepożądane znaki, na przykład cudzysłowy drukarskie.
- Kontrola w przeglądarce
W oknie prywatnym warto otworzyć adres pliku i upewnić się, że widać nową treść. Jeżeli nadal widać starą, przyczyną bywa pamięć podręczna serwera lub sieci dostarczania treści.
- Prośba w raporcie
W raporcie dotyczącym pliku robots.txt, przy właściwym pliku, należy otworzyć menu dodatkowych ustawień i wskazać prośbę o ponowne zindeksowanie.
- Potwierdzenie nowej wersji
Po pewnym czasie pole z czasem sprawdzenia powinno pokazać nowszy moment, a po kliknięciu pliku powinna być widoczna poprawiona treść bez zgłoszonych problemów.
- Kontrola ważnych adresów
Na koniec warto sprawdzić kilka kluczowych podstron w narzędziu do sprawdzania adresów URL, w teście wersji opublikowanej.
Jeśli witryna ma kilka hostów, prośbę składa się osobno dla każdego pliku, którego dotyczyła poprawka. Częsty błąd polega na odświeżeniu pliku dla adresu bez www, podczas gdy ruch i skanowanie odbywają się pod adresem z www.
Jeśli chcą Państwo zamówić SEO techniczne, zachęcamy do kontaktu: tel. 222 500 844 lub mailowo: biuro@pozycjonowaniestron.pl
Jak czytać komunikaty o błędach i ostrzeżeniach składni
Liczba w kolumnie z problemami obejmuje dwa rodzaje komunikatów o różnej wadze. Pomoc Search Console ujmuje różnicę krótko: błędy uniemożliwiają użycie reguły, ostrzeżenia nie. Wiersz z błędem jest dla Google tak, jakby go w pliku nie było, a pozostałe wiersze działają dalej. Po kliknięciu pliku w raporcie można obejrzeć jego treść razem ze zgłoszonymi problemami i ustalić, których wierszy dotyczą.
Żeby zrozumieć komunikaty, trzeba znać kilka zasad, którymi kieruje się Google. Każdy prawidłowy wiersz składa się z nazwy pola, dwukropka i wartości. Google obsługuje cztery pola: user-agent, allow, disallow i sitemap. Inne pola są pomijane, a dokumentacja jako przykład takiego pomijanego pola podaje crawl-delay. Reguła allow lub disallow bez podanej ścieżki jest ignorowana. Ścieżka musi zaczynać się od ukośnika i jest wrażliwa na wielkość liter, więc zapis /Sklep/ nie obejmuje adresu /sklep/. Adres mapy witryny w polu sitemap musi być pełnym adresem bezwzględnym. Komentarze zaczynają się od znaku krzyżyka. Gwiazdka zastępuje dowolny ciąg znaków, a znak dolara oznacza koniec adresu.
# Wersja z problemami
User-agent: *
Disallow: koszyk/
Crawl-delay: 10
Disallow:
Sitemap: /sitemap.xml

# Wersja poprawiona
User-agent: *
Disallow: /koszyk/
Sitemap: https://example.com/sitemap.xml
W pierwszej wersji ścieżka katalogu koszyka nie zaczyna się od ukośnika, pole crawl-delay nie jest przez Google obsługiwane, reguła bez ścieżki nie ma żadnego skutku, a adres mapy witryny jest względny zamiast pełnego. Żaden z tych wierszy nie zatrzyma pracy robota, ale też żaden nie zadziała tak, jak zakładał autor. Stąd bierze się najczęstsza niespodzianka: plik wygląda na rozbudowany, a część witryny, która miała być wyłączona ze skanowania, jest skanowana bez przeszkód.
Osobną grupę stanowią problemy z samym plikiem jako całością. Google stosuje limit rozmiaru wynoszący 500 kibibajtów i pomija treść wykraczającą poza ten próg, dlatego w bardzo dużych plikach końcowe reguły mogą nie obowiązywać. Plik zapisany w innym kodowaniu niż UTF-8 może zostać odczytany ze zniekształconymi znakami, co psuje reguły zawierające polskie litery. Zdarza się wreszcie, że serwer pod adresem pliku zwraca stronę HTML, na przykład ekran logowania. Google próbuje wtedy wydobyć z odpowiedzi poprawne reguły i pomija resztę. Przy naprawie pomoc Search Console sugeruje skorzystanie z walidatora plików robots.txt, a programistom wskazuje bibliotekę Google do testów lokalnych.
Gdzie sprawdzić blokadę konkretnego adresu
Blokadę pojedynczej podstrony sprawdza się w narzędziu do sprawdzania adresów URL, a nie w raporcie dotyczącym pliku robots.txt. Pełny adres należy wkleić w pole wyszukiwania widoczne u góry każdego ekranu Search Console, a następnie odczytać w części o indeksowaniu strony pole informujące, czy skanowanie jest dozwolone. Wartość przecząca oznacza, że reguła w pliku robots.txt nie pozwala Google pobrać tej strony.
Przy odczytywaniu wyniku trzeba pamiętać o dwóch rzeczach opisanych w pomocy narzędzia do sprawdzania adresów URL. Po pierwsze wynik domyślny pochodzi z indeksu, czyli z ostatniego skanowania, i może być nieaktualny. Stan bieżący pokazuje dopiero test wersji opublikowanej, uruchamiany osobnym przyciskiem, po którym wyniki są dostępne w dwóch zakładkach: jednej z danymi z indeksu i drugiej z testem. Po drugie, gdy strona jest zablokowana w pliku robots.txt, pole o tym, czy indeksowanie jest dozwolone, zawsze pokazuje odpowiedź twierdzącą, ponieważ Google nie może pobrać strony i odczytać ewentualnego znacznika noindex. Nie jest to więc potwierdzenie, że ze stroną wszystko jest w porządku. Całe narzędzie opisujemy we wpisie o sprawdzaniu adresu URL w Search Console.
Gdy trzeba ustalić, która reguła odpowiada za blokadę, pomocna jest znajomość zasad pierwszeństwa. Robot Google stosuje tę grupę reguł, której nazwa najdokładniej do niego pasuje, a pozostałe grupy pomija. Grupa z nazwą konkretnego robota i grupa ogólna z gwiazdką nie są łączone. W obrębie grupy wygrywa reguła najbardziej szczegółowa, czyli ta o najdłuższej pasującej ścieżce, a przy równej długości stosowana jest reguła mniej restrykcyjna, a więc allow. Dokumentacja podaje przykład: przy regułach zezwalającej na /page i zabraniającej /*.htm adres /page.htm jest zablokowany, ponieważ ścieżka zakazu jest dłuższa.
Skalę problemu w całej witrynie pokazuje z kolei raport Indeksowanie stron. Występują w nim dwa stany związane z omawianym plikiem. Pierwszy informuje, że adres został zablokowany przez plik robots.txt, przy czym pomoc do tego raportu zastrzega, że blokada nie daje pewności, iż strona nie zostanie zindeksowana inną drogą. Drugi opisuje stronę zindeksowaną mimo blokady, zwykle na podstawie linków z innych witryn, z bardzo ograniczonym opisem w wynikach. Zalecenie Google jest w obu przypadkach podobne: jeżeli strona ma zniknąć z wyników, należy zdjąć blokadę i użyć znacznika noindex, a jeżeli ma być widoczna, wystarczy ją odblokować. Szerzej piszemy o tym we wpisie o stronie zindeksowanej, ale zablokowanej przez robots.txt.
Typowe pomyłki i sytuacje, w których potrzebna jest pomoc
Najczęstsza pomyłka polega na ocenianiu pliku z serwera zamiast wersji, którą ma Google. Druga to traktowanie pliku robots.txt jako sposobu na usunięcie strony z wyników. Trzecia to sprawdzanie jednego hosta, gdy witryna działa na kilku. Wszystkie trzy da się wyłapać w kilka minut, jeśli raport ogląda się regularnie, a nie dopiero po spadku ruchu.
Do tej listy warto dopisać kilka mniej oczywistych błędów. Blokada całej witryny przeniesiona z wersji testowej na produkcyjną to klasyczny skutek wdrożeń wykonywanych w pośpiechu, dlatego kontrolę pliku należy wpisać w każdą migrację domeny i hostingu. Podawanie robotom innej treści pliku niż ludziom jest praktyką, przed którą pomoc Google przestrzega wprost: pliku nie należy maskować ani zmieniać w zależności od klienta. Kłopotliwe bywa też łączenie blokady w pliku ze znacznikiem noindex na tej samej stronie, ponieważ robot, który nie może pobrać strony, nie odczyta znacznika.
- Na liście w raporcie są wszystkie hosty, z których korzysta witryna, łącznie z subdomenami.
- Każdy ważny plik ma stan pobrania zakończonego powodzeniem albo świadomie zaakceptowany brak pliku.
- Czas ostatniego sprawdzenia jest późniejszy niż ostatnia zmiana w pliku.
- Kolumna z problemami pokazuje zero albo znane i ocenione ostrzeżenia.
- Treść pobranej wersji zgadza się z treścią widoczną w przeglądarce.
- Kluczowe podstrony przechodzą test wersji opublikowanej z dozwolonym skanowaniem.
- Raport Indeksowanie stron nie pokazuje nieoczekiwanego wzrostu liczby adresów zablokowanych przez plik.
Samodzielna diagnoza wystarcza w większości prostych przypadków. Pomoc specjalisty przydaje się wtedy, gdy stan inny niż pobranie powtarza się mimo poprawnego pliku, co zwykle wskazuje na konfigurację serwera, zapory lub sieci dostarczania treści, gdy witryna ma wiele hostów i wersji językowych z odrębnymi plikami, albo gdy duży sklep steruje skanowaniem filtrów i parametrów i każda zmiana reguły dotyczy tysięcy adresów. W takich sytuacjach analiza pliku jest częścią szerszej pracy, którą wykonujemy w ramach SEO technicznego, a jej punktem wyjścia bywa kompleksowy audyt SEO, obejmujący także dzienniki serwera i budżet indeksowania.
Jeśli chcą Państwo zamówić SEO techniczne, zachęcamy do kontaktu: tel. 222 500 844 lub mailowo: biuro@pozycjonowaniestron.pl
Najczęstsze pytania
Dlaczego nie widzę raportu dotyczącego pliku robots.txt w Search Console?
Raport znajduje się w ustawieniach usługi, a nie w głównym menu raportów. Jest dostępny dla usług domenowych oraz dla usług z prefiksem adresu URL założonych dla katalogu głównego hosta. Usługa obejmująca sam podkatalog go nie pokaże.
Po jakim czasie Google zauważy zmianę w pliku robots.txt?
Google zazwyczaj przechowuje plik w pamięci podręcznej do 24 godzin i odświeża go samodzielnie. Czas ten może być inny, jeśli serwer wysyła nagłówek Cache-Control z wartością max-age albo gdy odświeżenie się nie powiedzie. W pilnych przypadkach można skorzystać z prośby o ponowne zindeksowanie pliku w raporcie.
Czy brak pliku robots.txt jest błędem?
Nie. Pomoc Search Console wskazuje, że brak pliku jest sytuacją prawidłową i oznacza, że Google może skanować wszystkie adresy w witrynie. Plik warto przygotować wtedy, gdy część witryny nie powinna być odwiedzana przez roboty.
Czym różni się błąd od ostrzeżenia w kolumnie z problemami?
Błąd sprawia, że dana reguła nie może zostać użyta, natomiast ostrzeżenie jej nie wyłącza. W obu przypadkach Google pomija tylko kłopotliwe wiersze i stosuje resztę pliku. Każdy błąd warto wyjaśnić, ponieważ oznacza regułę, która nie działa.
Czy w raporcie można sprawdzić, czy konkretna podstrona jest zablokowana?
Raport pokazuje stan i treść plików, a nie wynik dla pojedynczego adresu. Do tego służy narzędzie do sprawdzania adresów URL, w którym jedno z pól informuje, czy skanowanie jest dozwolone. Programiści mogą dodatkowo testować reguły lokalnie za pomocą biblioteki udostępnionej przez Google.
Czy prośba o ponowne zindeksowanie pliku przywróci strony do wyników?
Nie bezpośrednio. Prośba przyspiesza pobranie nowej wersji pliku, ale Google zastrzega, że nie gwarantuje to natychmiastowego ponownego skanowania odblokowanych adresów. Powrót stron do wyników zależy od kolejnych wizyt robota i oceny samych stron.
Źródła
- Raport dotyczący pliku robots.txt, Search Console - pomoc
- Jak Google interpretuje specyfikację pliku robots.txt, Google for Developers
- Aktualizowanie pliku robots.txt, Google for Developers
- Tworzenie i przesyłanie pliku robots.txt, Google for Developers
- Plik robots.txt - wprowadzenie, Centrum wyszukiwarki Google
- Narzędzie do sprawdzania adresów URL, Search Console - pomoc
- Raport Indeksowanie stron, Search Console - pomoc
- Raport Statystyki indeksowania, Search Console - pomoc
Funkcje wyszukiwarek i asystentów AI zmieniają się szybko, dlatego wpis aktualizujemy po większych zmianach.