Status „Strona zindeksowana, ale zablokowana przez plik robots.txt” oznacza, że Google umieścił adres w indeksie, chociaż nie wolno mu było pobrać jego treści. Wyjście z tej sprzeczności zawsze zaczyna się od jednej decyzji: czy dana podstrona ma być widoczna w wynikach, czy ma z nich zniknąć. W obu przypadkach blokadę trzeba zdjąć, a różni się dopiero to, co dzieje się potem.
Co oznacza ten status w Search Console
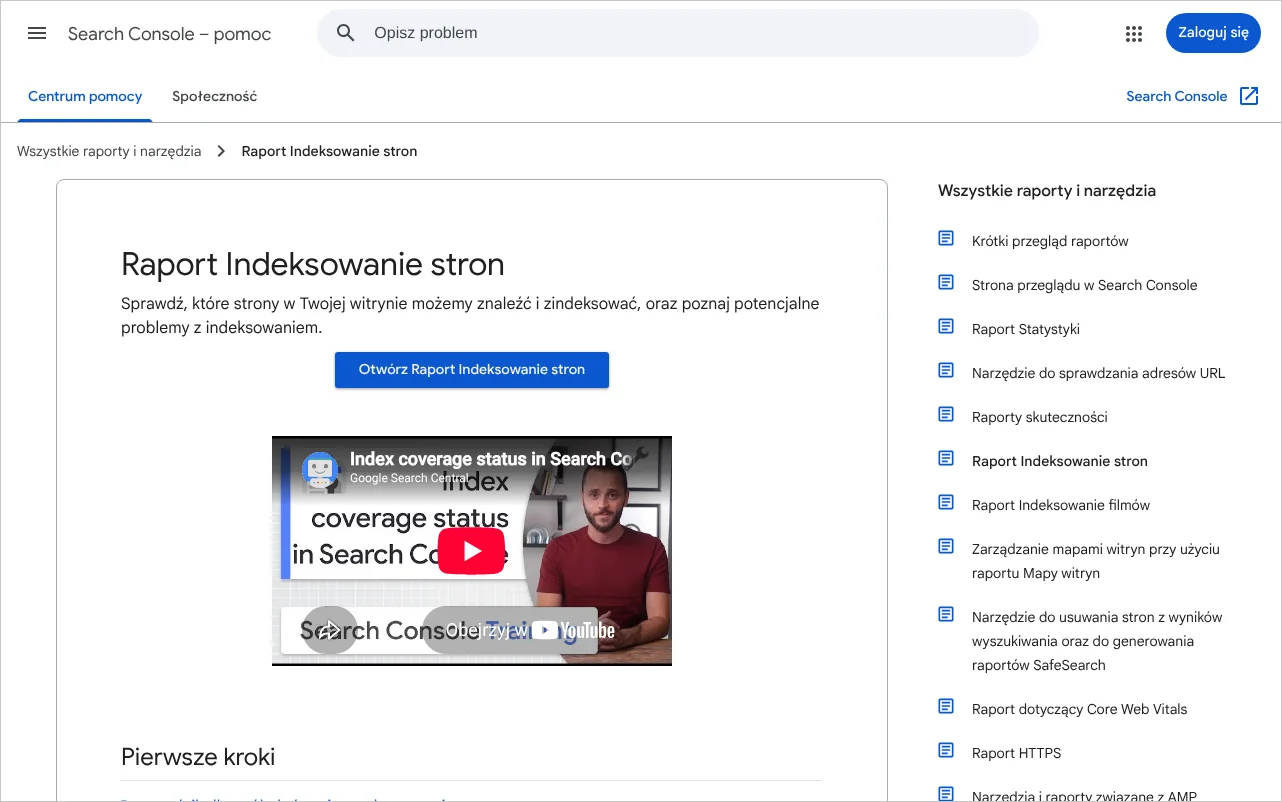
Komunikat informuje, że adres znajduje się w indeksie Google, mimo że plik robots.txt w Państwa witrynie zabrania robotowi jego skanowania. Pomoc Search Console w opisie raportu Indeksowanie stron ujmuje to jednym zdaniem: strona została zindeksowana, mimo że została zablokowana przez plik robots.txt. Google zalicza ten stan do ostrzeżeń, czyli problemów, które nie uniemożliwiają indeksowania, ale ograniczają to, jak wyszukiwarka rozumie i prezentuje stronę.
Sprzeczność jest pozorna i znika, gdy rozdzieli się dwa etapy pracy wyszukiwarki. Skanowanie to pobranie strony przez robota i odczytanie jej zawartości. Indeksowanie to zapisanie informacji o adresie w bazie, z której powstają wyniki wyszukiwania. Plik robots.txt dotyczy wyłącznie pierwszego etapu. W dokumentacji Google Search Central o pliku robots.txt znajduje się wprost zastrzeżenie, że nie jest to mechanizm służący do ukrywania strony przed Google, a jego głównym zadaniem jest zarządzanie ruchem robotów, tak aby nie przeciążały serwera.
Plik tekstowy umieszczony w katalogu głównym witryny, który informuje roboty wyszukiwarek, do których adresów mogą uzyskać dostęp. Reguła Disallow zabrania pobierania wskazanej ścieżki, reguła Allow na to zezwala.
Właściciel witryny zakazał więc robotowi wchodzenia pod dany adres, ale nie zakazał pokazywania go w wynikach. Tego drugiego komunikatu nie da się zresztą przekazać w pliku robots.txt: dokumentacja dotycząca blokowania indeksowania za pomocą noindex zaznacza, że reguła noindex wpisana do tego pliku nie jest przez Google obsługiwana.
Dlaczego zablokowany adres pojawia się w wynikach
Zablokowany adres trafia do wyników, ponieważ Google dowiaduje się o nim z innych miejsc niż sama strona, przede wszystkim z linków. Dokumentacja pliku robots.txt opisuje to jako jedno z ograniczeń tego rozwiązania: strona zablokowana przed skanowaniem może zostać zindeksowana, jeżeli prowadzi do niej link z innej witryny. Google nie odwiedza wtedy adresu, lecz może go wyświetlić na podstawie tego, co wie o nim z zewnątrz.
Skutek jest charakterystyczny. Skoro robot nie pobrał treści, wyszukiwarka nie ma z czego zbudować opisu, dlatego według dokumentacji taki adres może pojawiać się w wynikach bez opisu. Dla podstrony, która ma sprzedawać, jest to strata. Dla podstrony, która w ogóle nie powinna być widoczna, jest to dowód, że blokada nie spełniła zadania.
Skąd Google zna adres, którego nie pobrał
W narzędziu do sprawdzania adresów URL w Search Console służą do tego pola „Strona odsyłająca” i „Mapy witryn”, które pokazują, którędy robot trafił na dany adres. Warto do nich zajrzeć, zanim zacznie się cokolwiek zmieniać. Z naszej praktyki wynika, że odpowiedź bywa zaskakująca: do zablokowanej podstrony linkuje stopka, menu albo mapa witryny tworzona automatycznie przez system zarządzania treścią.
Sytuację dobrze obrazuje hipotetyczny przykład. Załóżmy, że sklep internetowy z Poznania zablokował w pliku robots.txt cały katalog z wynikami wyszukiwarki wewnętrznej, a jednocześnie umieścił w stopce linki do kilku popularnych wyszukiwań. Robot widzi linki, zapisuje adresy, ale nie może ich pobrać. Po pewnym czasie część tych adresów może pojawić się w raporcie właśnie z omawianym ostrzeżeniem. Podobny mechanizm zadziałałby u kancelarii z Krakowa, która zablokowałaby katalog z plikami PDF do pobrania, gdyby do jednego z dokumentów zaczęły prowadzić linki z zewnętrznych serwisów.
Czym ten status różni się od statusu samej blokady
Różnica polega na tym, czy adres trafił do indeksu. W raporcie istnieją dwa podobnie brzmiące stany: „URL zablokowany przez plik robots.txt” oraz „Strona zindeksowana, ale zablokowana przez plik robots.txt”. W pierwszym przypadku robot nie pobrał strony i adres nie znalazł się w indeksie, więc trafia do tabeli z przyczynami braku indeksacji. W drugim przypadku robot również nie pobrał strony, ale adres mimo to został zindeksowany, dlatego Google pokazuje go jako ostrzeżenie.
Pierwszy stan bardzo często jest po prostu potwierdzeniem, że blokada działa zgodnie z zamiarem. Jeżeli zablokowali Państwo koszyk, panel logowania albo wyniki filtrowania i te adresy widnieją jako zablokowane i niezindeksowane, nie ma czego naprawiać. Pomoc Search Console dodaje jednak ważne zastrzeżenie: sama blokada nie gwarantuje, że adres nie trafi do indeksu, bo Google może znaleźć informacje o nim w innych miejscach. Kto chce mieć pewność, powinien według tej samej strony pomocy usunąć blokadę i zastosować dyrektywę noindex.
| Cecha | URL zablokowany przez plik robots.txt | Strona zindeksowana, ale zablokowana przez plik robots.txt |
|---|---|---|
| Czy robot pobrał treść | Nie | Nie |
| Czy adres jest w indeksie | Nie | Tak |
| Miejsce w raporcie | Tabela „Dlaczego strony nie są indeksowane” | Tabela ostrzeżeń pod listą przyczyn braku indeksacji |
| Czy adres może pojawić się w wynikach | Obecnie nie, ale blokada tego nie gwarantuje na przyszłość | Tak, zwykle bez opisu |
| Kiedy reagować | Gdy zablokowana została strona, która powinna być widoczna | Zawsze, ponieważ stan jest sprzeczny z każdym możliwym zamiarem |
Stan „zindeksowana, ale zablokowana” nie odpowiada żadnemu rozsądnemu celowi. Jeśli podstrona miała być widoczna, blokada odbiera jej opis. Jeśli miała być niewidoczna, to jest widoczna. Pokrewne stany, w których robot zna adres, ale go nie indeksuje, opisujemy we wpisach o statusie strona wykryta, obecnie niezindeksowana oraz strona zeskanowana, ale jeszcze niezindeksowana.
Gdzie znaleźć ten status i jak zbadać pojedynczy adres
Ostrzeżenie znajduje się w Search Console, w menu po lewej stronie, w grupie „Indeksowanie”, w raporcie „Strony”, który w pomocy Google nosi nazwę raportu Indeksowanie stron. Pod wykresem widoczna jest tabela „Dlaczego strony nie są indeksowane”, a poniżej niej druga tabela, przeznaczona na ostrzeżenia dotyczące stron zindeksowanych. Właśnie w tej drugiej tabeli pojawia się wiersz „Strona zindeksowana, ale zablokowana przez plik robots.txt” wraz z liczbą adresów.
Kliknięcie wiersza otwiera stronę szczegółów z historią problemu na wykresie i listą przykładowych adresów. Kolumna „Źródło” informuje, czy przyczyna leży po stronie witryny, czy po stronie Google. Pomoc Search Console wyjaśnia, że naprawić można tylko te problemy, których źródłem jest witryna. Nad wykresem działa filtr mapy witryny. Ustawienie „Wszystkie przesłane strony” pokazuje wyłącznie adresy zgłoszone w mapie, co pozwala szybko stwierdzić, czy witryna sama podsuwa Google adresy, których jednocześnie zabrania skanować.
Co pokazuje narzędzie do sprawdzania adresów URL
Przy każdym adresie na liście przykładów znajduje się ikona, która otwiera narzędzie do sprawdzania adresów URL. W sekcji „Indeksowanie stron” widoczne są pola opisujące ostatnią wizytę robota. Zgodnie z pomocą narzędzia do sprawdzania adresów URL przy blokadzie w pliku robots.txt pole „Czy skanowanie jest dozwolone” ma wartość „Nie”, a pole „Pobranie strony” wartość „Niepowodzenie”.
Najbardziej mylące jest trzecie pole, „Czy indeksowanie jest dozwolone”. Przy zablokowanym adresie pokazuje ono zawsze „Tak”, nawet jeśli w kodzie strony znajduje się dyrektywa noindex. Pomoc Google tłumaczy to wprost: wyszukiwarka nie może odczytać dyrektyw noindex na stronie, której nie wolno jej pobrać. To jedno pole najlepiej pokazuje, na czym polega cały problem. Więcej o odczytywaniu poszczególnych pól piszemy we wpisie o sprawdzaniu adresu URL w Search Console.
Raport dotyczący pliku robots.txt
Treść pliku w wersji, którą zna Google, można obejrzeć w Search Console w sekcji „Ustawienia”, w raporcie dotyczącym pliku robots.txt. Według pomocy tego raportu dla każdego pliku widoczny jest jego adres, stan ostatniego pobrania, czas ostatniego sprawdzenia, rozmiar oraz liczba problemów z analizą. Po kliknięciu pliku wyświetla się ostatnio pobrana wersja, a opcja „Wersje” pokazuje wcześniejsze pobrania z ostatnich 30 dni. Historia pomaga ustalić, kiedy blokująca reguła pojawiła się w pliku, na przykład po aktualizacji wtyczki albo przeniesieniu serwisu.
Od czego zacząć: czy adres ma być w wynikach
Naprawę zaczyna się od podziału listy adresów na dwie grupy: te, które powinny być widoczne w Google, oraz te, które powinny z niego zniknąć. Pomoc Search Console opisuje dokładnie te dwie sytuacje. Jeśli strona nie powinna być blokowana, należy zaktualizować plik robots.txt, żeby ją odblokować. Jeśli natomiast celem było ukrycie strony w wynikach, robots.txt nie jest do tego właściwym narzędziem: trzeba usunąć blokadę i użyć dyrektywy noindex.
Do pierwszej grupy trafiają zwykle podstrony zablokowane przez pomyłkę. Hipotetyczny hydraulik z Łodzi mógłby po przebudowie strony odkryć, że reguła pozostawiona po wersji testowej zamyka katalog z opisami usług. Takie adresy mają wartość dla klientów i powinny zostać normalnie zeskanowane. Do drugiej grupy należą adresy, które nie niosą treści dla szukających: wyniki wyszukiwarki wewnętrznej, strony podziękowań po wysłaniu formularza, wersje do druku, kombinacje filtrów. Osobną kategorią są treści rzeczywiście poufne, dla których właściwym zabezpieczeniem jest logowanie, a nie dyrektywy dla robotów.
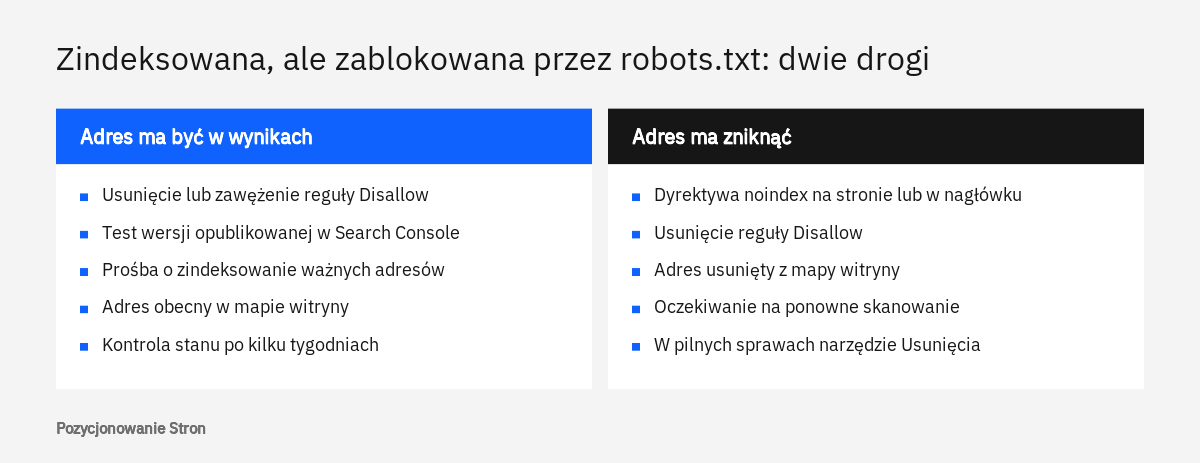
Lista przykładów w raporcie bywa mieszanką obu grup, ponieważ jedna reguła Disallow potrafi obejmować jednocześnie adresy, które mają być widoczne, i takie, które mają zniknąć. Wówczas każda grupa dostaje własne rozwiązanie.
Droga pierwsza: odblokować i pozwolić zindeksować
Jeżeli podstrona ma być widoczna w wynikach, naprawa polega na takiej zmianie pliku robots.txt, aby robot Google mógł ją pobrać. Po odblokowaniu i ponownym skanowaniu wyszukiwarka pozna treść strony i będzie miała z czego zbudować opis. Nie trzeba niczego usuwać z indeksu, wystarczy otworzyć robotowi drogę.
Najpierw należy ustalić, która reguła faktycznie blokuje adres. Specyfikacja pliku robots.txt w interpretacji Google podaje kilka zasad, które w tym pomagają. Robot stosuje się do grupy z najbardziej konkretnym pasującym oznaczeniem user-agent, a pozostałe grupy pomija. W obrębie grupy wygrywa reguła najbardziej szczegółowa, czyli ta o najdłuższej ścieżce, a przy konflikcie reguł Google przestrzega najmniej restrykcyjnej. Wielkość liter w ścieżkach ma znaczenie. Gwiazdka zastępuje dowolny ciąg znaków, a znak dolara oznacza koniec adresu.
Te zasady tłumaczą wiele niespodzianek. Reguła zapisana jako ścieżka bez ukośnika na końcu obejmuje wszystkie adresy zaczynające się od tego ciągu znaków, a nie tylko jeden katalog. Dokumentacja podaje przykład: reguła dla ścieżki /fish pasuje także do adresu /fishheads. Blokada katalogu /oferta-archiwum zapisana niestarannie jako /oferta zamknie więc również bieżącą ofertę.
# Przed zmianą: blokada obejmuje także /oferta/ i /oferta-specjalna/
User-agent: *
Disallow: /oferta

# Po zmianie: zablokowany tylko katalog archiwum,
# a jedna podstrona z archiwum pozostaje dostępna
User-agent: *
Disallow: /oferta-archiwum/
Allow: /oferta-archiwum/cennik-uslug/
Po zapisaniu zmian warto otworzyć plik w przeglądarce pod adresem domeny z dopiskiem /robots.txt i upewnić się, że serwer zwraca nową wersję. Dokumentacja Google o aktualizowaniu pliku robots.txt zaznacza, że sposób przesyłania pliku w znacznej mierze zależy od platformy i serwera. Z naszej praktyki wynika, że w serwisach opartych na WordPressie, WooCommerce czy PrestaShop plik bywa tworzony przez sam system albo wtyczkę i wtedy reguły poprawia się w ich ustawieniach, a nie na dysku serwera.
Następnie w narzędziu do sprawdzania adresów URL można uruchomić test wersji opublikowanej, który pobiera stronę w czasie rzeczywistym i pokazuje, czy Google ma do niej dostęp. Jeśli test się powiedzie, dostępna staje się opcja zgłoszenia prośby o zindeksowanie. Pomoc Google zastrzega, że obowiązuje dzienny limit takich zgłoszeń, a prośba nie gwarantuje obecności w indeksie. Przy większej liczbie adresów lepszym rozwiązaniem jest aktualna mapa witryny XML z datami ostatniej modyfikacji.
Po odblokowaniu robot wreszcie widzi treść, więc zaczyna ją oceniać i adres może trafić do innego stanu w raporcie. Dlatego po kilku tygodniach warto sprawdzić, co stało się z odblokowanymi adresami. Taki przegląd jest stałym elementem prac z zakresu SEO technicznego.
Jeśli chcą Państwo zamówić audyt SEO, zachęcamy do kontaktu: tel. 222 500 844 lub mailowo: biuro@pozycjonowaniestron.pl
Droga druga: odblokować, dodać noindex i poczekać
Jeżeli podstrona ma zniknąć z wyników, trzeba postąpić wbrew intuicji: zdjąć blokadę w pliku robots.txt i zakazać indeksowania dyrektywą noindex. Dokumentacja Google stawia ten warunek jednoznacznie: aby reguła noindex zadziałała, strona ani zasób nie mogą być zablokowane w pliku robots.txt, a robot musi mieć do nich dostęp. W przeciwnym razie nigdy nie zobaczy zakazu i adres może pozostać w wynikach.
Dyrektywę można przekazać na dwa sposoby. Pierwszy to znacznik meta w sekcji head dokumentu HTML. Drugi to nagłówek odpowiedzi HTTP o nazwie X-Robots-Tag, który według dokumentacji sprawdza się przy zasobach innych niż strony HTML, takich jak pliki PDF, filmy czy obrazy. Dla kancelarii z wcześniejszego przykładu właściwy byłby właśnie nagłówek.
<!-- W sekcji head strony HTML -->
<meta name="robots" content="noindex">

# W odpowiedzi serwera, np. dla pliku PDF
HTTP/1.1 200 OK
X-Robots-Tag: noindex
Wszystkie wartości znacznika i ich łączenie omawiamy we wpisie o znaczniku meta robots.
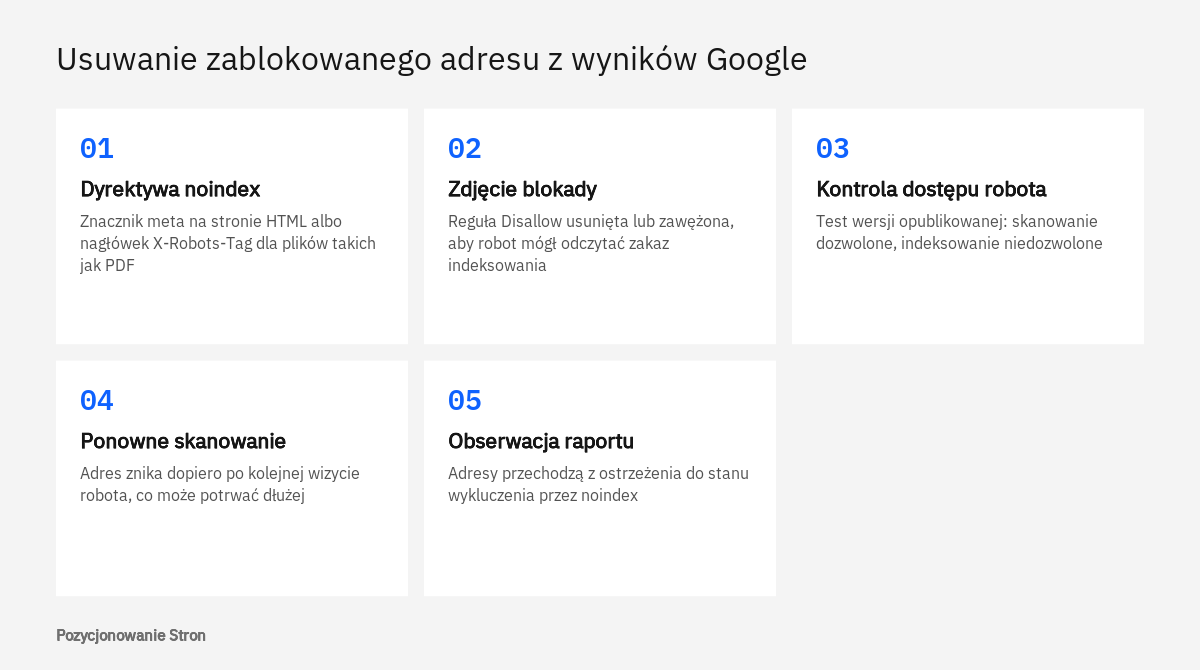
- Wdrożenie dyrektywy noindex
Dyrektywa trafia na wszystkie adresy, które mają zniknąć. Dobrze jest zrobić to przed zdjęciem blokady albo w tej samej chwili, aby robot przy pierwszej wizycie od razu zobaczył zakaz.
- Usunięcie reguły z pliku robots.txt
Reguła Disallow obejmująca te adresy jest usuwana albo zawężana tak, aby przestała ich dotyczyć.
- Kontrola w narzędziu do sprawdzania adresów URL
Dokumentacja zaleca to narzędzie do sprawdzenia, czy robot widzi dyrektywę w pobranym kodzie strony.
- Oczekiwanie na ponowne skanowanie
Adres znika z wyników dopiero wtedy, gdy robot ponownie go odwiedzi i odczyta zakaz. Dla ważnych adresów można zgłosić prośbę o ponowne zindeksowanie.
- Obserwacja raportu
Raport Indeksowanie stron pokazuje adresy, na których robot znalazł dyrektywę noindex, w tabeli przyczyn braku indeksacji.
Czy po zniknięciu adresów można wrócić do blokady
Dokumentacja Google nie opisuje takiego kroku. Ponowna blokada sprawia, że robot znowu nie widzi dyrektywy noindex, więc adres może z czasem wrócić do indeksu, jeżeli nadal prowadzą do niego linki. W bardzo dużych serwisach bywa to mimo wszystko rozważane jako świadomy kompromis, ale to nasza obserwacja z praktyki, a nie zalecenie Google. O gospodarowaniu wizytami robota piszemy we wpisie o budżecie indeksowania, a o porządkowaniu filtrów w sklepach we wpisie o nawigacji fasetowej.
Kiedy zamiast noindex lepsze jest inne rozwiązanie
Dyrektywa noindex pasuje do stron, które mają działać dla użytkowników, ale nie mają być wynikiem wyszukiwania. Jeżeli podstrona jest już niepotrzebna, prościej ją usunąć, tak aby serwer zwracał kod 404 lub 410. Jeżeli zawiera dane, których nie powinien widzieć nikt postronny, właściwe jest zabezpieczenie hasłem. Wyjątkiem są pliki multimedialne: według dokumentacji grafikę, wideo i dźwięk można wyłączyć z wyników właśnie plikiem robots.txt.
Ile trwa naprawa i jak potwierdzić, że się powiodła
Zmiana w pliku robots.txt jest widoczna dla Google zwykle w ciągu doby, natomiast zniknięcie ostrzeżenia z raportu wymaga ponownego skanowania każdego adresu, co trwa znacznie dłużej. Google przechowuje treść pliku robots.txt w pamięci podręcznej maksymalnie przez 24 godziny, więc przez ten czas robot może jeszcze kierować się starą wersją. Raport dotyczący pliku robots.txt w Search Console zawiera opcję zgłoszenia prośby o ponowne pobranie pliku. Pomoc Google wskazuje, że warto z niej skorzystać właśnie po zmianie reguł, która odblokowuje ważne adresy, choć nie daje to gwarancji natychmiastowego efektu.
Dalszy czas zależy od tego, jak często robot odwiedza poszczególne podstrony. Przy drodze z dyrektywą noindex dokumentacja uprzedza, że w zależności od znaczenia strony w internecie ponowna wizyta robota może nastąpić nawet po kilku miesiącach. Do tego momentu adres nadal może być widoczny w wynikach i nie świadczy to o błędzie we wdrożeniu.
Weryfikacja poprawki w raporcie
Na stronie szczegółów ostrzeżenia znajduje się przycisk uruchamiający sprawdzanie poprawki. Po jego użyciu Search Console najpierw bada kilka przykładowych adresów. Jeżeli problem nadal na nich występuje, weryfikacja od razu się kończy. Jeżeli nie, stan zmienia się na „Rozpoczęto” i system sprawdza kolejne znane adresy z tym problemem. Według pomocy Google weryfikacja zajmuje zazwyczaj do dwóch tygodni, ale w niektórych przypadkach może potrwać znacznie dłużej, a w jej trakcie nie należy uruchamiać jej ponownie. Końcowy stan „Powodzenie” oznacza, że problem zniknął ze wszystkich sprawdzonych adresów.
Gdy adres musi zniknąć szybko
W pilnych sytuacjach służy do tego narzędzie „Usunięcia” w Search Console. Zgodnie z pomocą tego narzędzia zatwierdzona prośba ukrywa adres w wynikach na około sześć miesięcy, ale nie wyłącza indeksowania strony. Jest to więc rozwiązanie tymczasowe, które daje czas na trwałe uporządkowanie sprawy: usunięcie treści, zabezpieczenie hasłem albo dyrektywę noindex. Ta sama strona pomocy zawiera krótkie ostrzeżenie, które dobrze podsumowuje cały temat: do blokowania nie należy używać pliku robots.txt. Wszystkie metody porównujemy we wpisie o usuwaniu strony z wyników Google.
Typowe pomyłki przy usuwaniu tego ostrzeżenia
Najczęstszą pomyłką jest próba pozbycia się adresu z wyników przez dopisanie kolejnej blokady albo przez wstawienie dyrektywy noindex bez zdjęcia tej, która już istnieje. W obu przypadkach robot nadal nie może pobrać strony, więc nic się nie zmienia. W narzędziu do sprawdzania adresów URL widać to od razu: pole o dozwolonym skanowaniu wciąż pokazuje „Nie”, a pole o indeksowaniu „Tak”, mimo że w kodzie strony zakaz już jest.
Drugą pomyłką jest wpisanie reguły noindex do samego pliku robots.txt, czego Google nie obsługuje. Trzecią jest odblokowanie adresu, który wcale nie powinien być widoczny, bez równoczesnego oznaczenia go dyrektywą noindex. Ostrzeżenie znika, raport wygląda lepiej, ale w wynikach pojawia się pełny wynik strony, której nikt nie chciał pokazywać.
Czwarta pomyłka dotyczy niespójnych sygnałów. Witryna jednocześnie blokuje adres, umieszcza go w mapie witryny i linkuje do niego z menu. Naszym zdaniem adres, który ma zniknąć, powinien wypaść z mapy witryny, a adres, który ma być widoczny, powinien być w mapie, mieć linki i być dostępny dla robota. Adresy z parametrami, które szczególnie często wpadają w tę pułapkę, omawiamy we wpisie o parametrach w adresach URL.
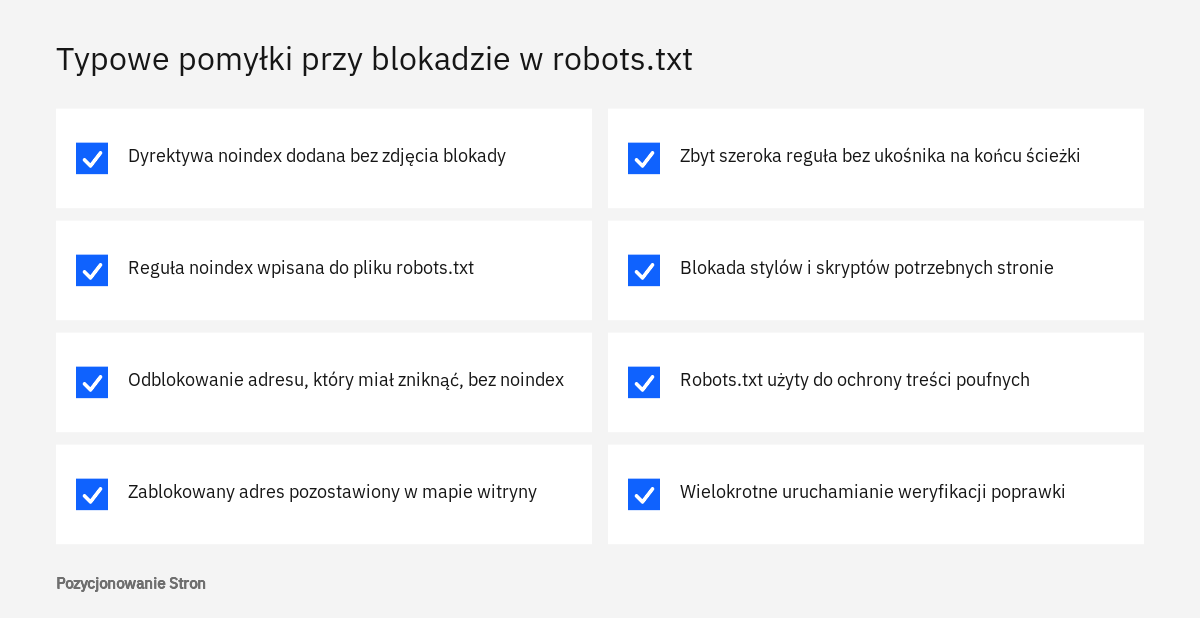
Piąta pomyłka to blokowanie zasobów potrzebnych do wyświetlenia strony. Dokumentacja Google dopuszcza blokadę skryptów, stylów czy mniej istotnych obrazów tylko wtedy, gdy ich brak nie wpłynie istotnie na załadowaną stronę, i przestrzega przed blokowaniem zasobów potrzebnych robotowi do jej interpretacji.
- Lista adresów z ostrzeżeniem została podzielona na te, które mają być widoczne, i te, które mają zniknąć.
- Wiadomo, która reguła w pliku robots.txt blokuje każdą grupę adresów i po co ją kiedyś wpisano.
- Adresy przeznaczone do usunięcia mają dyrektywę noindex w znaczniku meta albo w nagłówku X-Robots-Tag.
- Reguła blokująca została usunięta lub zawężona, a nowa wersja pliku jest widoczna pod adresem /robots.txt.
- Test wersji opublikowanej potwierdza, że skanowanie jest dozwolone.
- Weryfikacja poprawki została uruchomiona raz, po naprawieniu wszystkich adresów.
Kiedy warto skorzystać z pomocy specjalisty
Pojedynczą zablokowaną podstronę w małym serwisie da się zwykle naprawić samodzielnie. Pomoc przydaje się, gdy ostrzeżenie obejmuje setki lub tysiące adresów, gdy plik robots.txt powstaje automatycznie i nie wiadomo, który element systemu go tworzy, albo gdy problem pojawił się po zmianie szablonu, migracji czy wdrożeniu nowego sklepu. W takich sytuacjach sam plik jest tylko objawem, a przyczyna leży w architekturze serwisu, linkowaniu wewnętrznym lub konfiguracji serwera. Audyt SEO pozwala wtedy przejrzeć wszystkie sygnały naraz: reguły dla robotów, dyrektywy na stronach, adresy kanoniczne, mapę witryny i stany w raporcie indeksowania, a następnie ułożyć zmiany w bezpiecznej kolejności.
Jeśli chcą Państwo zamówić audyt SEO, zachęcamy do kontaktu: tel. 222 500 844 lub mailowo: biuro@pozycjonowaniestron.pl
Najczęstsze pytania
Czy status „zindeksowana, ale zablokowana przez robots.txt” jest karą dla witryny?
Nie. Google opisuje ten stan jako ostrzeżenie dotyczące konkretnych adresów. Skutek jest lokalny: zablokowana podstrona wyświetla się zwykle bez opisu, a wyszukiwarka nie zna jej treści.
Dlaczego wynik zablokowanej strony nie ma opisu?
Robot nie pobrał treści strony, więc wyszukiwarka nie ma z czego utworzyć opisu. Adres został zindeksowany na podstawie informacji z zewnątrz, przede wszystkim linków.
Czy można wpisać noindex do pliku robots.txt?
Nie. Dokumentacja Google wprost podaje, że reguła noindex w pliku robots.txt nie jest obsługiwana. Dyrektywę należy umieścić w znaczniku meta na stronie albo w nagłówku odpowiedzi HTTP o nazwie X-Robots-Tag.
Jak długo trzeba czekać, aż adres z noindex zniknie z wyników?
Adres znika po tym, jak robot ponownie go odwiedzi i odczyta dyrektywę. Google uprzedza, że w zależności od znaczenia strony może to potrwać nawet kilka miesięcy. W pilnych sytuacjach pomaga narzędzie „Usunięcia”, które ukrywa adres tymczasowo.
Czy status „URL zablokowany przez plik robots.txt” też trzeba naprawiać?
Tylko wtedy, gdy zablokowana została strona, która powinna być widoczna w wynikach. Jeśli blokada obejmuje adresy świadomie wyłączone ze skanowania, stan potwierdza, że reguła działa. Sama blokada nie gwarantuje jednak braku indeksacji.
Po odblokowaniu ostrzeżenie nadal jest w raporcie. Czy coś poszło źle?
Niekoniecznie. Google przechowuje plik robots.txt w pamięci podręcznej do 24 godzin, a każdy adres musi zostać ponownie zeskanowany, zanim zmieni stan. Weryfikacja poprawki w raporcie trwa zazwyczaj do dwóch tygodni, a czasem dłużej.
Źródła
- Raport Indeksowanie stron - Search Console - pomoc, Google
- Plik robots.txt - wprowadzenie i przewodnik, Google Search Central
- Blokowanie indeksowania przez wyszukiwarki za pomocą tagu noindex, Google Search Central
- Jak Google interpretuje specyfikację pliku robots.txt, Google Search Central
- Aktualizowanie pliku robots.txt, Google Search Central
- Narzędzie do sprawdzania adresów URL - Search Console - pomoc, Google
- Raport dotyczący pliku robots.txt - Search Console - pomoc, Google
- Narzędzie do usuwania stron z wyników wyszukiwania oraz do generowania raportów SafeSearch - Search Console - pomoc, Google
Funkcje wyszukiwarek i asystentów AI zmieniają się szybko, dlatego wpis aktualizujemy po większych zmianach.