Stronę można wycofać z wyników Google na dwa sposoby: szybko, ale tylko na pewien czas, albo trwale, przez zmianę na samym serwerze. Najczęściej potrzebne są oba kroki naraz. Poniżej opisujemy każdą metodę, sytuacje, do których pasuje, oraz kolejność działań, gdy w wyszukiwarce pojawiły się dane, których nikt nie powinien oglądać.
Co właściwie oznacza usunięcie strony z wyników Google
Usunięcie strony z wyników oznacza, że adres przestaje się pojawiać po wpisaniu zapytania w wyszukiwarce. Nie jest to to samo, co usunięcie treści z internetu. Wyszukiwarka pokazuje jedynie to, co wcześniej zapisała w swoim indeksie, czyli w ogromnym spisie odwiedzonych stron. Dopóki treść leży na serwerze i jest dostępna dla każdego, kto zna adres, dopóty może wrócić do wyników albo trafić do innych wyszukiwarek.
Z tego rozróżnienia wynika cały podział metod. Część z nich zmienia tylko to, co pokazuje Google, a część zmienia samą stronę. Dokumentacja Google w tekście o usuwaniu informacji o witrynie z Google mówi wprost, że szybkie ukrycie w narzędziu do usuwania trzeba uzupełnić jednym z trwałych rozwiązań: usunięciem lub zmianą treści, ochroną hasłem albo znacznikiem noindex. Bez tego adres po pewnym czasie może się znów pojawić.
Zbiór stron, które robot Google odwiedził, przeanalizował i zapisał. W wynikach wyszukiwania pojawiają się wyłącznie adresy znajdujące się w indeksie.
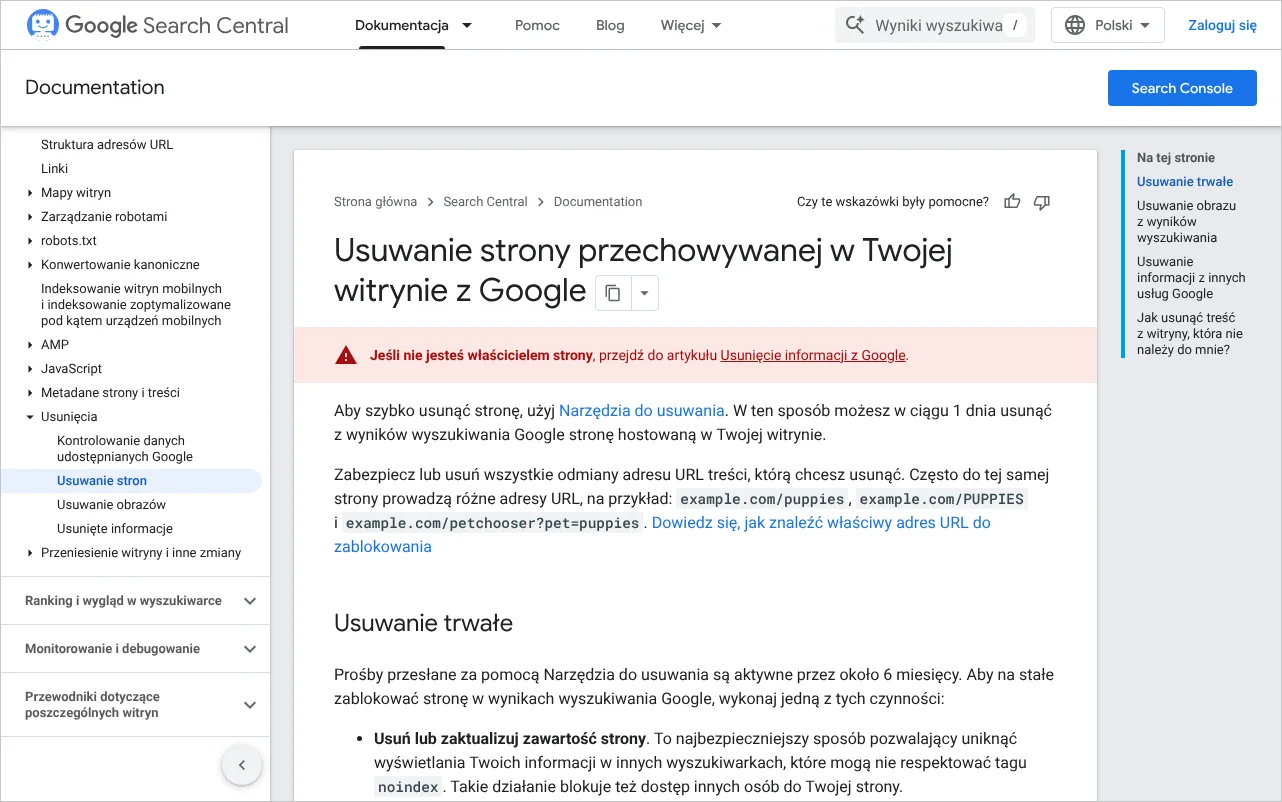
Przed pracą warto spisać wszystkie adresy, pod którymi dana treść jest dostępna. Google zwraca uwagę, że ta sama zawartość bywa widoczna pod kilkoma adresami, na przykład z różną wielkością liter albo z parametrem po znaku zapytania, i że zabezpieczyć lub usunąć trzeba każdy z nich. W sklepie będzie to karta produktu, jej wersja z filtrem i wersja do druku, a w kancelarii z Krakowa na przykład podstrona z wyrokiem oraz plik PDF z tym samym dokumentem.
Jakie są metody usuwania adresu z wyszukiwarki
Metod jest pięć: tymczasowe ukrycie w Search Console, znacznik noindex, usunięcie treści z odpowiedzią 404 lub 410, ochrona hasłem oraz usunięcie pliku z serwera. Pierwsza działa najszybciej i najkrócej, pozostałe są trwałe, ale wymagają czasu, bo robot Google musi ponownie odwiedzić adres.
Różnią się też tym, kto po ich zastosowaniu nadal ma dostęp do treści. Po usunięciu nikt już jej nie otworzy. Po założeniu hasła otworzą ją tylko osoby uprawnione. Po wstawieniu znacznika noindex strona działa jak dawniej, tyle że nie pokazuje się w Google. To rozróżnienie decyduje o wyborze: regulamin dawnej promocji można zostawić dostępny dla osób z linkiem, a listy klientów z numerami telefonów nie wolno zostawić w żadnej formie.
| Metoda | Skutek | Kto nadal widzi treść | Kiedy pasuje |
|---|---|---|---|
| Tymczasowe usunięcie w Search Console | Ukrycie na około 6 miesięcy | Każdy, kto zna adres | Sprawy pilne, zawsze razem z metodą trwałą |
| Usunięcie treści, kod 404 lub 410 | Trwałe wycofanie z indeksu | Nikt | Treść zbędna albo taka, której nie wolno udostępniać |
| Usunięcie pliku z serwera | Trwałe wycofanie z indeksu | Nikt | Dokumenty PDF, arkusze, zdjęcia |
| Ochrona hasłem | Trwała blokada dla robotów | Osoby z hasłem | Wersje testowe, strefy klienta, materiały wewnętrzne |
| Znacznik noindex | Trwałe wycofanie z wyników Google | Każdy, kto zna adres | Strony potrzebne użytkownikom, lecz zbędne w wyszukiwarce |
| Blokada w robots.txt | Brak gwarancji usunięcia | Każdy, kto zna adres | Nie służy do usuwania stron z wyników |
Google określa usunięcie lub zmianę treści jako rozwiązanie najbezpieczniejsze, ponieważ działa także w innych wyszukiwarkach i odcina dostęp wszystkim. Znacznik noindex pomoc Search Console opisuje jako metodę mniej bezpieczną: treść dalej jest dostępna, a wyszukiwarki, które tego znacznika nie obsługują, mogą ją pokazywać.
Jak działa tymczasowe ukrycie adresu w Search Console
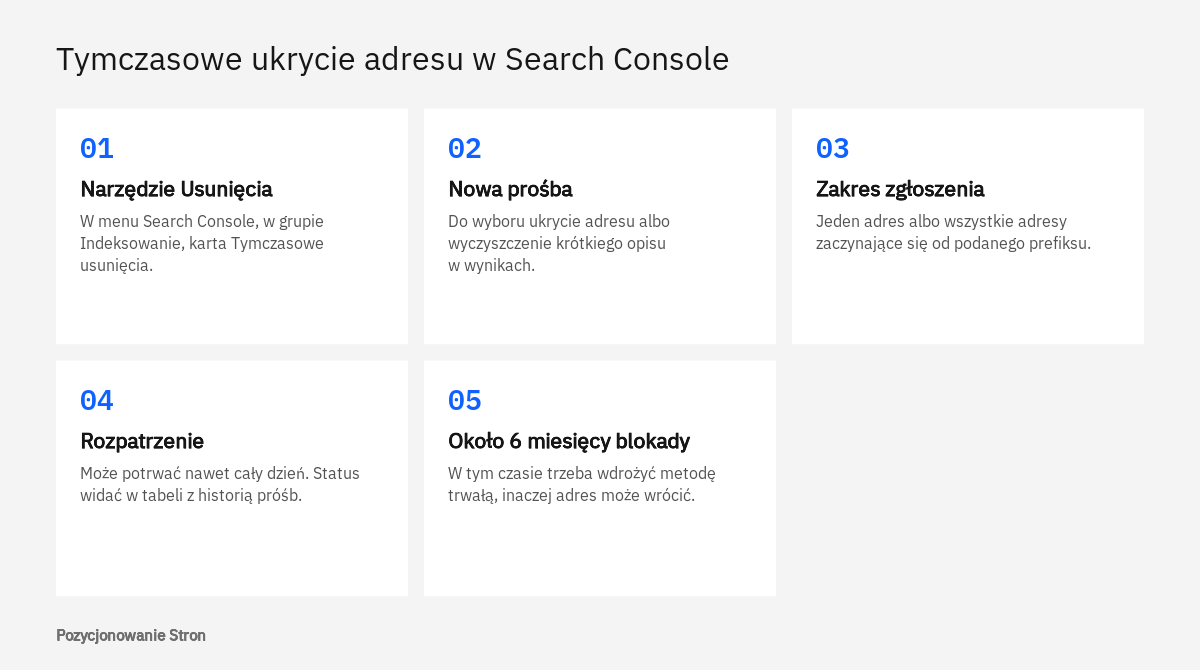
Tymczasowe ukrycie polega na zgłoszeniu adresu w narzędziu Usunięcia w Search Console. Według pomocy Search Console rozpatrzenie prośby może potrwać nawet cały dzień, a blokada obowiązuje około 6 miesięcy, czyli 180 dni. Po tym czasie strona może wrócić do wyników, jeśli nie została wycofana trwale. Narzędzie nie usuwa treści z internetu ani z innych wyszukiwarek i nie zmienia niczego na serwerze.
Narzędzie jest dostępne w menu Search Console w grupie Indeksowanie, pod nazwą Usunięcia. Ma trzy karty. Karta „Tymczasowe usunięcia” służy właścicielom witryny. Karta „Nieaktualna treść” pokazuje zgłoszenia złożone przez osoby z zewnątrz w publicznym formularzu. Karta „Filtrowanie SafeSearch” zawiera adresy zgłoszone jako treści dla dorosłych. Usuwanie zaczyna się na pierwszej karcie od przycisku „Nowa prośba”.
Dwa rodzaje prośby
Po otwarciu okna nowej prośby do wyboru są dwie możliwości. Pierwsza to tymczasowe usunięcie adresu URL, które ukrywa stronę lub obraz w wynikach. Druga to wyczyszczenie krótkiego opisu w wyszukiwarce: adres zostaje w wynikach, ale znika fragment tekstu wyświetlany pod tytułem, do czasu ponownego odczytania strony przez robota. Ta druga opcja przydaje się, gdy sama strona ma zostać, a z jej treści usunięto już na przykład numer telefonu, który wciąż widać w opisie wyniku.
Przy usuwaniu adresu narzędzie pyta jeszcze o zakres: tylko ten jeden adres albo wszystkie adresy zaczynające się od podanego początku, czyli prefiksu. Zgłoszenie prefiksu kończącego się nazwą katalogu obejmie wszystkie podstrony w tym katalogu. Trzeba tu zachować ostrożność, bo podanie samego adresu strony głównej jako prefiksu ukrywa całą witrynę.
Co oznaczają statusy prośby
Każde zgłoszenie trafia do tabeli z historią obejmującą ostatnie 6 miesięcy. Status „Przetwarzam prośbę” oznacza oczekiwanie, „Tymczasowe usunięcie” potwierdza, że adres jest ukryty, „Wyczyszczono” dotyczy próśb o usunięcie opisu, a „Usunięcie wygasło” informuje o końcu okresu blokady. Pojawiają się też statusy „Prośba odrzucona” i „Prośba anulowana”. Zgłoszenie można wycofać samodzielnie: w tabeli przy danej pozycji znajduje się menu z dodatkowymi ustawieniami, a w nim polecenie anulowania prośby.
Kiedy wystarczy znacznik noindex
Znacznik noindex wystarczy wtedy, gdy strona ma nadal działać dla osób, które na nią trafią, a jedynie nie powinna pokazywać się w Google. To dobre rozwiązanie dla podziękowań po wysłaniu formularza, wyników wewnętrznej wyszukiwarki, stron koszyka, archiwalnych regulaminów czy podstron przygotowanych wyłącznie dla odbiorców kampanii reklamowej.
Dokumentacja Google o blokowaniu indeksowania za pomocą tagu noindex opisuje dwa równorzędne sposoby wdrożenia. Pierwszy to znacznik meta w nagłówku strony, czyli w części kodu między znacznikami head. Drugi to nagłówek odpowiedzi serwera o nazwie X-Robots-Tag, przydatny zwłaszcza dla plików, które nie są stronami HTML: dokumentów PDF, filmów i obrazów. Oba dają ten sam efekt, więc wybiera się ten, który łatwiej wprowadzić w danym serwisie.
<meta name="robots" content="noindex">

HTTP/1.1 200 OK
X-Robots-Tag: noindex
W systemach zarządzania treścią, takich jak WordPress, zwykle nie trzeba edytować kodu ręcznie. Ustawienie widoczności w wyszukiwarkach znajduje się w panelu, często przy edycji konkretnej podstrony. Dokładne znaczenie poszczególnych dyrektyw omawiamy we wpisie o znaczniku meta robots.
Warunek, bez którego noindex nie zadziała
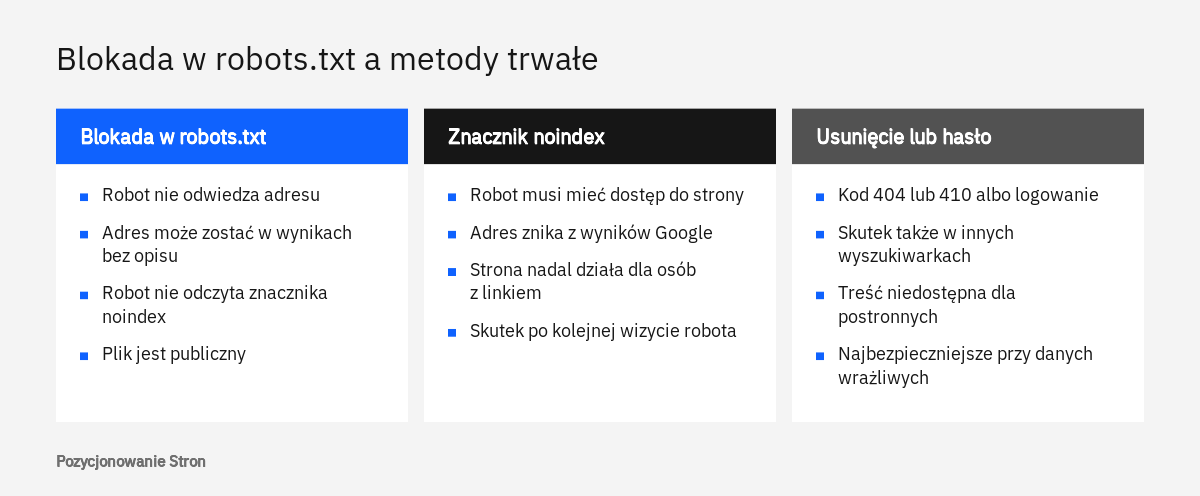
Robot Google musi móc wejść na stronę, żeby odczytać znacznik. Jeżeli adres jest równocześnie zablokowany w pliku robots.txt, robot go nie odwiedzi, znacznika nie zobaczy, a strona może dalej pojawiać się w wynikach, na przykład dzięki linkom z innych stron. Google podkreśla też, że nie obsługuje reguły noindex wpisanej do samego pliku robots.txt. Przed wdrożeniem znacznika należy więc upewnić się, że adres nie jest objęty żadną regułą blokującą.
Drugie ograniczenie to czas. Znacznik zaczyna działać po kolejnej wizycie robota, a niektóre podstrony są odwiedzane rzadko. Dokumentacja wspomina, że może to trwać nawet kilka miesięcy. Jeżeli strona z noindex wciąż jest w wynikach, najczęściej oznacza to po prostu, że robot jeszcze na niej nie był od czasu zmiany.
Gdzie sprawdzić, czy Google widzi znacznik
Służą do tego dwa miejsca w Search Console. Narzędzie do sprawdzania adresów URL, dostępne przez pole wyszukiwania u góry ekranu, pokazuje kod, który robot pobrał przy ostatniej wizycie, oraz informację, czy indeksowanie jest dozwolone. Raport Indeksowanie stron, w menu pod nazwą Strony, zawiera listę przyczyn wykluczenia, a wśród nich pozycję o stronach wykluczonych za pomocą tagu noindex. Obecność adresu na tej liście potwierdza, że znacznik został odczytany. Znaczenie pozostałych statusów z tego raportu wyjaśniamy we wpisie o tym, dlaczego Google nie indeksuje strony.
Kiedy usunąć treść i zwrócić kod 404 lub 410
Usunięcie treści jest właściwe wtedy, gdy strona nie jest już nikomu potrzebna albo gdy jej zawartość w ogóle nie powinna być publiczna. Po usunięciu serwer odpowiada kodem 404, czyli „nie znaleziono”, albo 410, czyli „zasób został usunięty”. Pomoc Search Console wymienia oba kody jako sposób na trwałe wycofanie adresu.
Jak Google traktuje te odpowiedzi, opisuje dokumentacja o wpływie kodów stanu HTTP na roboty Google. Wyszukiwarka nie korzysta z treści adresów, które zwracają kody z grupy 4xx, a adresy już zindeksowane, które zaczęły zwracać taki kod, są usuwane z indeksu. Dokumentacja nie różnicuje przy tym kodów 404 i 410: oba należą do tej samej grupy i prowadzą do tego samego skutku. Szerzej piszemy o tym we wpisie o błędzie 404 i jego wpływie na widoczność.
Przekierowanie 301 nie jest metodą usuwania, lecz sposobem na przeniesienie odwiedzających i robotów pod inny adres. Ma sens, gdy istnieje podstrona o tej samej tematyce, na przykład nowszy model produktu. Takie przypadki opisujemy we wpisie o produktach wycofanych ze sprzedaży.
Pułapka: strona „usunięta”, która odpowiada kodem 200
Częsty błąd polega na tym, że treść znika, ale serwer nadal odpowiada kodem 200, a użytkownik widzi pustą stronę albo komunikat „nie znaleziono”. Google nazywa to pozornym błędem 404 (ang. soft 404) i zgłasza w Search Console. Wyszukiwarka nie dostaje wtedy jednoznacznej informacji, że zasób przestał istnieć. Po usunięciu podstrony warto więc sprawdzić faktyczny kod odpowiedzi, na przykład w narzędziu do sprawdzania adresów URL w Search Console albo w narzędziach deweloperskich przeglądarki, na karcie Sieć.
Pliki PDF, arkusze i zdjęcia
Dokumenty i obrazy wymagają osobnej uwagi, ponieważ nie mają kodu HTML, w którym dałoby się umieścić znacznik meta. Pomoc Search Console zaleca, aby pliki inne niż HTML, na przykład PDF, po prostu usunąć z serwera. Jeśli plik ma zostać dostępny, ale poza wyszukiwarką, pozostaje nagłówek X-Robots-Tag. W WordPressie trzeba przy tym pamiętać, że usunięcie odnośnika do pliku z treści wpisu nie usuwa samego pliku: nadal leży on w bibliotece mediów pod tym samym adresem.
Dla obrazów Google przygotowało odrębną instrukcję o usuwaniu obrazów ze swojej witryny z wyszukiwarki. Najszybszą drogą jest to samo narzędzie do usuwania, z tym samym zastrzeżeniem o tymczasowym skutku. Trwale działa usunięcie pliku albo nagłówek X-Robots-Tag z wartością noindex wysyłany razem z obrazem. W przypadku obrazów dokumentacja dopuszcza też reguły w pliku robots.txt dla robota Googlebot-Image, przy czym nie należy łączyć obu sposobów, bo zablokowany robot nie odczyta nagłówka.
Jeśli chcą Państwo zamówić SEO techniczne, zachęcamy do kontaktu: tel. 222 500 844 lub mailowo: biuro@pozycjonowaniestron.pl
Kiedy lepiej zabezpieczyć stronę hasłem
Hasło jest najlepszym wyborem, gdy treść ma być dostępna dla określonej grupy osób, a dla wszystkich pozostałych, w tym dla robotów, zamknięta. Google wymienia ochronę hasłem wśród metod trwałych: uprawnieni użytkownicy wchodzą na stronę, a Googlebot i inne roboty zostają zatrzymane.
Typowe zastosowania to wersja testowa serwisu, na której trwają prace przed uruchomieniem, strefa klienta z dokumentami, cennik dla partnerów handlowych czy materiały szkoleniowe dla pracowników. Wersje testowe zasługują na szczególną uwagę. Z naszych obserwacji wynika, że to jedno z najczęstszych źródeł niechcianych adresów w wynikach: kopia sklepu z Poznania wystawiona pod adresem w rodzaju test.nazwa-sklepu.pl, bez żadnego zabezpieczenia, potrafi trafić do indeksu razem z całym asortymentem i konkurować z właściwą witryną.
Hasło można ustawić na poziomie serwera, tak aby przeglądarka prosiła o dane logowania przed wyświetleniem czegokolwiek, albo w systemie zarządzania treścią, jeśli obsługuje on konta użytkowników. Pierwszy sposób jest prostszy przy całych katalogach i wersjach testowych, drugi przy pojedynczych podstronach. W obu przypadkach należy sprawdzić, czy zabezpieczenie obejmuje także pliki, a nie tylko strony, które do nich prowadzą. Dokument PDF dostępny pod bezpośrednim adresem pozostaje publiczny, nawet gdy strona z odnośnikiem do niego wymaga logowania.
Przy treściach, które już są w wynikach, hasło warto połączyć z prośbą o tymczasowe usunięcie. Samo zabezpieczenie zadziała dopiero po ponownej wizycie robota, a do tego czasu tytuł i opis strony będą wciąż widoczne w wyszukiwarce.
Dlaczego sama blokada w robots.txt nie wystarcza
Plik robots.txt mówi robotom, których adresów mają nie odwiedzać, ale nie zabrania pokazywania tych adresów w wynikach. Google pisze o tym wprost we wprowadzeniu do pliku robots.txt: nie jest to mechanizm służący do ukrywania strony internetowej przed Google. Do tego celu dokumentacja wskazuje znacznik noindex albo hasło.
Mechanizm jest następujący. Jeżeli do zablokowanej strony prowadzą linki z innych miejsc w sieci, wyszukiwarka może zindeksować sam adres, choć nigdy nie odczytała jego zawartości. Taki wynik pojawia się wtedy bez opisu. Dla firmy, która chciała coś ukryć, bywa to gorsze niż stan wyjściowy, bo sam adres potrafi zdradzić, co się pod nim znajduje.
Druga wada jest mniej oczywista. Blokada w robots.txt uniemożliwia robotowi zobaczenie zmian, które miałyby doprowadzić do usunięcia: nie odczyta on znacznika noindex, nie dowie się o haśle ani o tym, że strona zwraca już kod 404. Pomoc Search Console w części o trwałym usuwaniu zawiera dlatego krótkie zalecenie, aby nie blokować stron w pliku robots.txt.
Nie znaczy to, że robots.txt jest zbędny. Służy do kierowania ruchem robotów, na przykład po to, by nie obciążały serwera odwiedzaniem tysięcy kombinacji filtrów w sklepie. Jak przygotować ten plik, opisujemy we wpisie o pisaniu pliku robots.txt, a różnice między trzema najczęściej mylonymi narzędziami zestawiamy w tekście o canonical, noindex i robots.txt.
Ile trwa zniknięcie strony z wyników
Tymczasowe ukrycie w Search Console działa zwykle w ciągu jednego dnia. Metody trwałe zależą od tego, kiedy robot Google ponownie odwiedzi adres, a to może trwać od kilku dni do kilku tygodni, w przypadku rzadko odwiedzanych podstron także dłużej. Google nie podaje gwarantowanego terminu. W sprawach pilnych stosuje się dlatego obie drogi naraz: zmianę na serwerze oraz prośbę o tymczasowe usunięcie.
Wizytę robota można przyspieszyć. Dokumentacja o zgłaszaniu prośby o ponowne zindeksowanie wskazuje dwie drogi. Dla pojedynczych adresów służy narzędzie do sprawdzania adresów URL w Search Console: po wpisaniu adresu w pole u góry ekranu pojawia się możliwość zgłoszenia prośby o zindeksowanie. Obowiązuje limit liczby zgłoszeń, a wielokrotne wysyłanie tego samego adresu niczego nie przyspiesza. Dla większej liczby adresów lepiej sprawdza się mapa witryny XML. Samo zgłoszenie nie daje jednak pewności, że zmiana zostanie uwzględniona od razu.
Jak sprawdzić, czy adres rzeczywiście zniknął
Najprostszy test to wpisanie w wyszukiwarkę polecenia site: z pełnym adresem podstrony. Pewniejszą informację daje narzędzie do sprawdzania adresów URL, które podaje stan adresu w indeksie, datę ostatniej wizyty robota i odpowiedź, jaką wtedy otrzymał. Warto zwrócić uwagę na datę: jeśli jest wcześniejsza niż wprowadzona zmiana, robot jeszcze jej nie widział i trzeba poczekać albo zgłosić adres ponownie.
Osobnym zjawiskiem jest stary opis w wynikach. Zdarza się, że strona została już poprawiona, a wyszukiwarka wciąż pokazuje fragment dawnej treści. Właściciel witryny może wtedy użyć opcji czyszczenia krótkiego opisu w narzędziu Usunięcia. Osoba, która witryną nie zarządza, ma do dyspozycji publiczne narzędzie opisane w pomocy wyszukiwarki pod hasłem odświeżanie nieaktualnych treści. Służy ono do zgłaszania wyników, które pokazują treść już usuniętą ze strony, i wymaga jedynie podania adresu strony lub obrazu.
Jak postępować, gdy do wyników trafiły dane wrażliwe
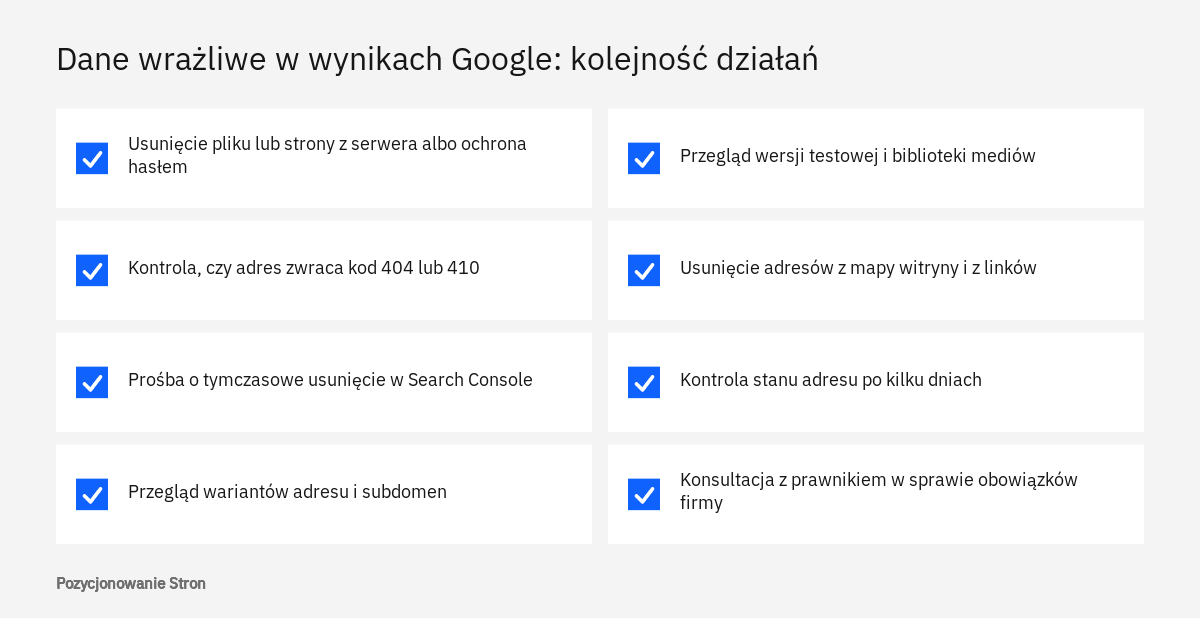
Przy danych wrażliwych liczy się kolejność: najpierw odcięcie dostępu do treści na serwerze, potem prośba o tymczasowe usunięcie z wyników, a na końcu sprawdzenie, czy te same dane nie leżą pod innymi adresami. Odwrócenie tej kolejności zostawia treść dostępną dla każdego, kto zapisał link.
Takie sytuacje zdarzają się częściej, niż mogłoby się wydawać. Gabinet stomatologiczny z Kielc wgrywa na serwer arkusz z listą pacjentów, aby przesłać go współpracownikowi, a hurtownia z Łodzi zostawia w publicznym katalogu faktury w plikach PDF. Samo ukrycie w wyszukiwarce nie rozwiązuje wtedy problemu, ponieważ plik nadal można otworzyć.
- Usunięcie lub zabezpieczenie treści
Plik należy usunąć z serwera, a stronę zdjąć albo zabezpieczyć hasłem. Google określa usunięcie treści jako opcję najbezpieczniejszą, bo działa także w innych wyszukiwarkach.
- Potwierdzenie odpowiedzi serwera
Adres powinien zwracać kod 404 lub 410 albo żądać logowania. Warto otworzyć go w oknie prywatnym przeglądarki, aby wykluczyć wyświetlanie zapisanej kopii.
- Prośba o tymczasowe usunięcie
W narzędziu Usunięcia zgłasza się adres, a przy większej liczbie plików w jednym katalogu cały prefiks.
- Poszukiwanie kopii
Trzeba sprawdzić warianty adresu, subdomeny, wersję testową, mapę witryny i bibliotekę mediów. Blokada w narzędziu nie obejmuje innych subdomen.
- Kontrola po kilku dniach
Narzędzie do sprawdzania adresów URL pokaże, czy robot odnotował zmianę, a tabela próśb, czy zgłoszenie ma status tymczasowego usunięcia.
Gdy dane znajdują się na cudzej stronie
Jeżeli treść opublikował ktoś inny, pierwszym adresatem jest właściciel tamtej witryny, bo tylko on może ją usunąć ze źródła. Google zastrzega w pomocy o usuwaniu informacji prywatnych z wyszukiwarki, że może usuwać treści wyłącznie z własnych wyników. Strona pozostaje wtedy w sieci i jest osiągalna przez linki, media społecznościowe oraz inne wyszukiwarki.
Formularz Google przyjmuje zgłoszenia dotyczące między innymi adresu zamieszkania, numeru telefonu i adresu poczty elektronicznej, numerów dokumentów i numeru PESEL, numerów rachunków bankowych i kart płatniczych, zdjęć podpisu lub dokumentów tożsamości, dokumentacji medycznej oraz poufnych danych logowania. W zgłoszeniu podaje się konkretne adresy stron, bo tylko one są sprawdzane. Wynik może być pełny, gdy strona znika z wyszukiwarki całkowicie, albo częściowy, gdy przestaje się pojawiać jedynie przy zapytaniach zawierających imię i nazwisko. Google może też pozostawić treść ważną dla opinii publicznej.
Odrębną drogą są wnioski oparte na przepisach prawa, które Google przyjmuje w osobnym trybie. Tu kończy się praca techniczna, a zaczyna prawna: ocena, czy doszło do naruszenia ochrony danych i jakie obowiązki z tego wynikają dla firmy, wymaga konsultacji z prawnikiem. Gdy treści nie da się usunąć, a szkodzi ona wizerunkowi, pozostają działania takie jak wypieranie negatywnych wyników.
Jakie pomyłki zdarzają się najczęściej i kiedy potrzebna jest pomoc
Najczęstsze pomyłki to poprzestanie na tymczasowym ukryciu, połączenie znacznika noindex z blokadą w robots.txt oraz pominięcie części adresów, pod którymi treść jest dostępna. Każda z nich kończy się tak samo: strona wraca do wyników albo w ogóle z nich nie znika.
Do tej listy dopisalibyśmy kilka błędów, które widujemy podczas audytów. Pierwszy to zgłoszenie zbyt szerokiego prefiksu, przez które z wyszukiwarki znika cały dział serwisu zamiast jednej podstrony. Drugi to noindex ustawiony na szablonie, a nie na pojedynczej stronie, co wyłącza z wyników setki adresów naraz. Trzeci to mylenie usuwania z porządkowaniem duplikatów: gdy dwie podstrony mają tę samą treść, zwykle właściwszy jest adres kanoniczny niż wycofywanie jednej z nich.
- Spisane są wszystkie adresy, pod którymi występuje treść, razem z plikami.
- Wybrana jest metoda trwała dopasowana do tego, kto ma zachować dostęp.
- Adres nie jest zablokowany w pliku robots.txt.
- Serwer zwraca właściwy kod odpowiedzi, a nie pustą stronę z kodem 200.
- W sprawach pilnych złożona jest prośba o tymczasowe usunięcie.
- Usunięte adresy zniknęły z mapy witryny i z linków wewnętrznych.
- Po kilku dniach sprawdzony jest stan adresu w Search Console.
Samodzielnie da się przeprowadzić usunięcie jednej lub kilku podstron w małym serwisie. Wsparcie specjalisty przydaje się wtedy, gdy adresów są setki, gdy powstają automatycznie z filtrów i parametrów, gdy do indeksu trafiła cała wersja testowa albo gdy po wcześniejszych próbach z wyników zniknęły strony, które miały w nich zostać. W takich przypadkach potrzebna jest analiza całego serwisu, jaką obejmuje audyt SEO, a następnie wdrożenie zmian w ramach usługi SEO techniczne.
Jeśli chcą Państwo zamówić SEO techniczne, zachęcamy do kontaktu: tel. 222 500 844 lub mailowo: biuro@pozycjonowaniestron.pl
Najczęstsze pytania
Czy narzędzie Usunięcia w Search Console usuwa stronę na stałe?
Nie. Prośba ukrywa adres na około 6 miesięcy, po czym strona może wrócić do wyników. Trwały skutek daje dopiero usunięcie treści, ochrona hasłem albo znacznik noindex.
Czy kod 410 działa szybciej niż 404?
Dokumentacja Google opisuje oba kody łącznie, jako odpowiedzi z grupy 4xx, po których zindeksowany adres jest usuwany z indeksu. Nie wskazuje różnicy w szybkości, więc wybór między nimi można traktować jako kwestię porządku w serwisie.
Strona ma noindex, a nadal jest w Google. Dlaczego?
Najczęściej robot nie odwiedził jej jeszcze od czasu zmiany albo nie może jej odwiedzić, bo adres jest zablokowany w robots.txt. Warto sprawdzić datę ostatniej wizyty w narzędziu do sprawdzania adresów URL i zgłosić prośbę o ponowne zindeksowanie.
Czy można usunąć z Google stronę, która nie należy do Państwa firmy?
Narzędzie Usunięcia jest przeznaczone dla właścicieli witryn. Osoby z zewnątrz mogą zgłosić nieaktualny wynik albo złożyć wniosek dotyczący danych prywatnych, lecz samą treść może usunąć tylko właściciel serwisu, w którym ją opublikowano.
Czy usunięcie z Google usuwa stronę także z innych wyszukiwarek?
Nie. Narzędzia Google działają tylko w wynikach Google. W innych wyszukiwarkach skuteczne jest usunięcie treści lub hasło, natomiast znacznik noindex może być przez nie interpretowany inaczej.
Czy da się cofnąć tymczasowe usunięcie?
Tak. W tabeli z historią próśb przy każdym zgłoszeniu jest menu z poleceniem anulowania. Po anulowaniu adres może ponownie pojawiać się w wynikach, o ile nadal znajduje się w indeksie.
Źródła
- Usuwanie informacji o witrynie z Google, Centrum wyszukiwarki Google
- Narzędzie do usuwania stron z wyników wyszukiwania oraz do generowania raportów SafeSearch, Search Console - pomoc
- Blokowanie indeksowania przez wyszukiwarki za pomocą tagu noindex, Centrum wyszukiwarki Google
- Plik robots.txt - wprowadzenie i przewodnik, Centrum wyszukiwarki Google
- Jak kody stanu HTTP wpływają na roboty Google, Google for Developers
- Usuwanie obrazów ze swojej witryny z wyszukiwarki Google, Centrum wyszukiwarki Google
- Zgłaszanie do Google prośby o ponowne zindeksowanie witryny, Centrum wyszukiwarki Google
- Odświeżanie nieaktualnych treści, Wyszukiwarka Google - Pomoc
- Usuwanie informacji prywatnych z wyszukiwarki Google, Wyszukiwarka Google - Pomoc
Funkcje wyszukiwarek i asystentów AI zmieniają się szybko, dlatego wpis aktualizujemy po większych zmianach.