Model językowy oszczędza czas tam, gdzie wynik jego pracy da się sprawdzić w kilka minut: przy porządkowaniu list fraz, szkicach konspektów, wyrażeniach regularnych, szkieletach znaczników i redakcji gotowego tekstu. Szkodzi tam, gdzie błąd wygląda wiarygodnie i nikt go nie weryfikuje: przy faktach, liczbach, wnioskach z danych oraz treściach publikowanych seryjnie. Poniżej opisujemy zadanie po zadaniu, jak korzystać z AI w pracy nad stroną firmy i jak kontrolować to, co model oddaje.
Gdzie AI pomaga w pracy nad SEO, a gdzie szkodzi
AI pomaga w zadaniach powtarzalnych i formalnych, których wynik można szybko sprawdzić, a szkodzi w zadaniach wymagających wiedzy o faktach, o konkretnej firmie i o aktualnym stanie wyników wyszukiwania. Granica nie przebiega więc między zadaniami łatwymi i trudnymi, tylko między takimi, w których pomyłkę widać od razu, a takimi, w których pomyłka wygląda jak poprawna odpowiedź.
Przyczynę tej różnicy Google opisuje wprost we wskazówkach dotyczących treści utworzonych za pomocą generatywnej AI: modele generatywne nie wyszukują faktów, lecz przewidują prawdopodobną sekwencję słów na podstawie danych treningowych, przez co ich odpowiedzi mogą zawierać błędy. Szerzej tłumaczymy ten mechanizm we wpisie o tym, jak działa duży model językowy. Dla osoby pracującej nad stroną wynika z tego prosty wniosek: model jest sprawnym pomocnikiem przy formie i porządku, a słabym świadkiem w sprawie faktów.
Warto od początku rozróżnić dwa rodzaje pomyłek. Pierwszy to błąd głośny: wyrażenie regularne, którego filtr nie przyjmuje, albo znacznik odrzucony przez test. Taki błąd kosztuje kilka minut. Drugi to błąd cichy: wymyślona właściwość w danych strukturalnych, fraza przypisana do niewłaściwej grupy, zmyślona liczba w akapicie albo wniosek z logów oparty na ruchu, który wcale nie pochodził od Google. Błąd cichy trafia na stronę i zostaje na niej miesiącami.
| Zadanie | Co model robi dobrze | Typowy błąd trudny do zauważenia | Jak to sprawdzić |
|---|---|---|---|
| Grupowanie fraz | Porządkuje długą listę według tematu | Łączy frazy o różnych intencjach albo dopisuje frazy spoza listy | Porównanie liczby fraz przed i po, przegląd wyników wyszukiwania |
| Konspekt | Proponuje układ sekcji i pytania czytelników | Układ powielany z podobnych tekstów, bez wiedzy o firmie | Uzupełnienie o własne dane i pytania od klientów |
| Wyrażenia regularne | Zapisuje wzorzec na podstawie opisu słownego | Wzorzec łapie za dużo albo za mało zapytań | Test w filtrze raportu Skuteczność |
| Analiza logów | Pisze formuły, skrypty i zestawienia | Liczy ruch podszywający się pod Googlebota jako prawdziwy | Weryfikacja adresów IP, raport Statystyki indeksowania |
| Znaczniki | Tworzy szkielet danych strukturalnych, warianty tytułów i opisów | Zmyślone wartości: oceny, godziny, ceny | Test znaczników i porównanie z widoczną treścią |
| Redakcja | Skraca, upraszcza, wyłapuje powtórzenia | Zmienia sens zdania albo dopisuje twierdzenie | Porównanie wersji przez osobę znającą temat |
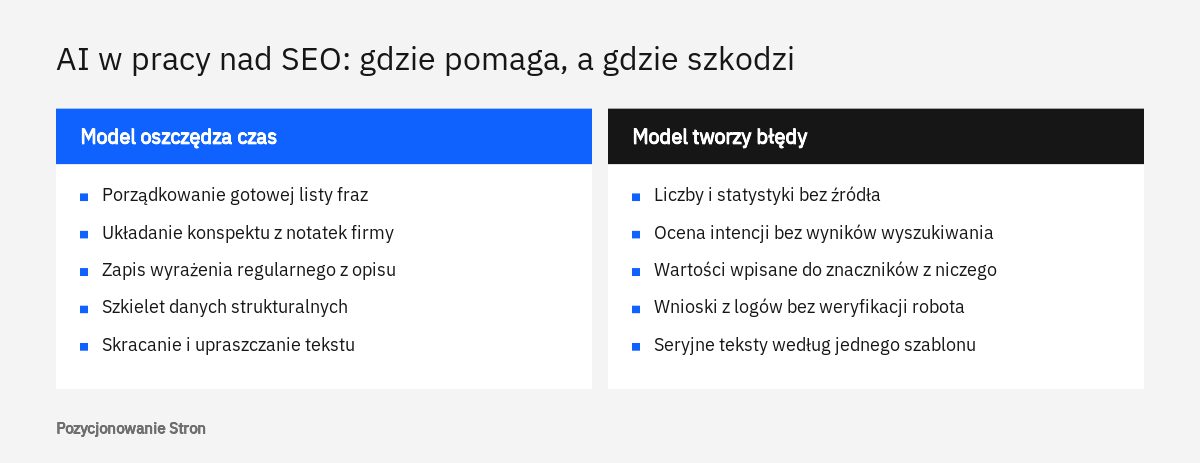
Z tabeli wynika zasada, do której będziemy wracać: im łatwiej sprawdzić wynik, tym śmielej można oddać zadanie modelowi.
Grupowanie fraz: szybkie porządki i ciche pomyłki
Grupowanie fraz to zadanie, w którym model oszczędza najwięcej czasu, pod warunkiem że dostaje gotową listę i ma ją tylko uporządkować. Lista kilkuset zapytań pobranych z raportu Skuteczność w Search Console albo z Planera słów kluczowych Google zostaje w kilka chwil podzielona na tematy, a każda grupa dostaje roboczą nazwę.
Co model robi dobrze
Model dobrze rozpoznaje podobieństwo znaczeniowe, odmianę i szyk wyrazów. Zapytania "hydraulik łódź awaria", "awaria rury łódź hydraulik" i "pogotowie hydrauliczne w łodzi" trafią do jednej grupy bez dodatkowych wskazówek. Sprawnie oddziela też zapytania z nazwą miejscowości od ogólnych oraz pytania od zapytań zakupowych.
Gdzie pojawiają się błędy
Model nie widzi wyników wyszukiwania, dopóki nie korzysta z wyszukiwarki, więc o intencji wnioskuje wyłącznie z brzmienia frazy. Tymczasem dwa podobnie brzmiące zapytania mogą prowadzić do zupełnie różnych wyników: na jedno Google pokazuje sklepy, na drugie wpisy z wyjaśnieniami. Model chętnie połączy je w jedną grupę i zaproponuje jedną podstronę, która nie odpowie dobrze na żadne z nich. Drugi częsty błąd to dopisywanie. Poproszony o "uzupełnienie" listy model dodaje frazy brzmiące sensownie, ale niepoparte żadnymi danymi o wyszukiwaniach, a czasem samodzielnie podaje ich popularność. Takich liczb nie należy traktować jako danych: źródłem informacji o tym, jak często dane zapytanie jest wpisywane, pozostają narzędzia Google i własne raporty.
Trzeci błąd jest najtrudniejszy do wychwycenia: przy długich listach część fraz znika albo pojawia się w dwóch grupach. Dlatego w poleceniu warto od razu poprosić o kontrolę liczebności.
Poniżej wklejam listę 240 zapytań z raportu Skuteczność (zapytanie, kliknięcia, wyświetlenia).
Proszę podzielić je na grupy tematyczne dla strony firmy hydraulicznej z Łodzi.
Zasady:
- każda fraza trafia do dokładnie jednej grupy,
- proszę nie dopisywać żadnych fraz spoza listy i nie zmieniać ich brzmienia,
- proszę nie podawać żadnych liczb poza tymi z listy,
- przy każdej grupie proszę wskazać przypuszczalną intencję i oznaczyć słowem NIEPEWNE
  grupy, w których intencja nie wynika jasno z brzmienia,
- na końcu proszę podać liczbę fraz w każdej grupie i sumę, która musi wynosić 240.
Wynik w tabeli: grupa, intencja, frazy, liczba fraz.
Po otrzymaniu wyniku wystarczą trzy czynności kontrolne. Suma fraz musi zgadzać się z liczbą wierszy na wejściu. Grupy oznaczone jako niepewne trzeba sprawdzić ręcznie, wpisując po dwie frazy w wyszukiwarkę i porównując rodzaj wyników. Każdą grupę należy też zestawić z istniejącymi podstronami, bo model nie wie, co już jest w serwisie. Dane, od których warto zacząć, opisujemy we wpisie o raporcie Skuteczność w Search Console.
Konspekty: dobry punkt wyjścia, słaby produkt końcowy
Konspekt przygotowany przez model nadaje się na pierwszą wersję układu tekstu, ale nie na gotowy plan publikacji. Model szybko zbierze pytania, które czytelnik zwykle zadaje przy danym temacie, i zaproponuje kolejność sekcji. Nie wie natomiast niczego o Państwa firmie: nie zna cennika, przebiegu realizacji ani typowych problemów klientów.
Skutek łatwo przewidzieć. Firmy z tej samej branży, które poproszą o konspekt tekstu na ten sam temat, dostaną bardzo podobny układ nagłówków. Google w zaleceniach o tworzeniu treści przydatnych, rzetelnych i ukierunkowanych na użytkowników podkreśla, że treść powinna powstawać przede wszystkim po to, by była przydatna dla odwiedzających, a nie wyłącznie w celu poprawy pozycji.
Jak pracować z konspektem od modelu
Sprawdza się odwrócenie kolejności: najpierw człowiek spisuje to, co wie tylko firma, a dopiero potem model układa z tego strukturę. Kancelaria z Krakowa przygotowująca tekst o podziale majątku może zacząć od pytań, które klienci zadają na pierwszym spotkaniu, od listy potrzebnych dokumentów i od opisu typowego przebiegu sprawy. Model dostaje te notatki z zadaniem ułożenia ich w logiczny ciąg sekcji i wskazania luk. Treścią konspektu jest wtedy doświadczenie firmy, a model odpowiada tylko za porządek.
Poniżej wklejam notatki specjalisty: pytania klientów, przebieg usługi, najczęstsze nieporozumienia.
Proszę ułożyć z nich konspekt tekstu na stronę firmy: nagłówki drugiego i trzeciego stopnia
oraz jedno zdanie o tym, na jakie pytanie odpowiada każda sekcja.
Proszę korzystać wyłącznie z informacji z notatek. Jeżeli w konspekcie brakuje czegoś,
co czytelnik powinien wiedzieć, proszę wypisać to osobno jako listę pytań do specjalisty,
bez samodzielnego udzielania odpowiedzi.
Lista pytań do specjalisty bywa cenniejsza niż sam konspekt, bo pokazuje, czego w notatkach zabrakło. Odpowiedzi musi jednak udzielić człowiek. Hierarchię nagłówków warto potem ocenić według zasad opisanych we wpisie o nagłówkach H1, H2 i H3, a przy większych planach publikacji pomocne bywają treści SEO przygotowywane we współpracy z osobami, które znają branżę klienta.
Wyrażenia regularne: zadanie niemal stworzone dla modelu
Pisanie wyrażeń regularnych to zastosowanie, w którym model sprawdza się bardzo dobrze, ponieważ wynik weryfikuje się natychmiast w samym narzędziu. Wyrażenie regularne to zapis wzorca tekstu, który pozwala jednym filtrem wybrać wiele zapytań lub adresów naraz. Osoba, która nie zna składni, opisuje słowami, czego szuka, a model zamienia opis na wzorzec.
Gdzie wpisać wyrażenie w Search Console
Filtr znajduje się w raporcie Skuteczność. Zgodnie z pomocą Search Console o zaawansowanym filtrowaniu i porównywaniu w wierszu filtrów należy użyć przycisku dodawania filtra, wskazać wymiar Zapytania lub Strony, a następnie wybrać opcję Niestandardowe (wyrażenie regularne) i wpisać wzorzec. Domyślnie działa tryb Pasuje do wyrażenia regularnego, a tryb Nie pasuje do wyrażenia regularnego pozwala wykluczyć dopasowania. Całość zatwierdza przycisk Zastosuj.
Ta sama strona pomocy podaje kilka zasad, które warto przekazać modelowi w poleceniu. Raport używa składni RE2. Dopasowanie jest domyślnie częściowe, czyli wzorzec może wystąpić w dowolnym miejscu zapytania, a znaki ^ i $ wiążą go z początkiem lub końcem ciągu. Domyślnie wielkość liter nie ma znaczenia, a jej uwzględnienie wymaga wpisania (?-i) na początku wyrażenia. Kilka wartości oddziela się znakiem pionowej kreski i ujmuje w nawias.
Zapytania będące pytaniami:
^(jak|ile|czy|gdzie|kiedy|dlaczego)

Zapytania z nazwą miasta w różnych odmianach:
(łódź|łodzi|łódzki)

Zapytania złożone z co najmniej pięciu wyrazów:
^(\S+\s+){4,}\S+$

Zapytania z nazwą firmy (w trybie "Nie pasuje do wyrażenia regularnego" pokażą ruch bez marki):
(nazwa ?firmy|nazwafirmy)
Na co uważać
Odmian wyrażeń regularnych jest kilka i różnią się zakresem obsługiwanych konstrukcji, dlatego w poleceniu trzeba wyraźnie napisać, że wzorzec ma być zgodny ze składnią RE2 i trafi do filtra w Search Console. Jeżeli model zaproponuje konstrukcję, której raport nie przyjmie, błąd będzie głośny i łatwy do naprawienia. Gorszy jest wzorzec poprawny formalnie, ale zbyt szeroki. Wzorzec "(las)" użyty do wyszukania zapytań o las dopasuje także "klasa" i "plaster", ponieważ dopasowanie jest częściowe. Dlatego po zastosowaniu filtra należy przejrzeć listę dopasowanych zapytań, a następnie odwrócić filtr i sprawdzić, czy wśród odrzuconych nie ma zapytań, o które chodziło. Pomoc Search Console zaznacza ponadto, że filtrowanie według zapytania lub adresu może wpływać na sumy w raporcie, więc różnica w sumach nie musi oznaczać błędu wyrażenia.
Potrzebuję wyrażenia regularnego do filtra Zapytania w raporcie Skuteczność w Search Console.
Składnia RE2, dopasowanie częściowe, wielkość liter domyślnie bez znaczenia.
Cel: zapytania, w których występuje słowo "cena", "cennik", "koszt" lub "ile kosztuje".
Proszę podać wyrażenie, a pod nim po pięć przykładowych zapytań, które zostaną dopasowane,
i pięć podobnych, które dopasowane nie zostaną.
Jeśli chcą Państwo zamówić pozycjonowanie strony, zachęcamy do kontaktu: tel. 222 500 844 lub mailowo: biuro@pozycjonowaniestron.pl
Analiza logów serwera: model liczy sprawnie, ale nie wie, co liczy
Przy analizie logów model przydaje się jako pomocnik techniczny: napisze formułę do arkusza, skrypt dzielący wiersze logu na kolumny albo zestawienie żądań według adresu i kodu odpowiedzi. Nie należy natomiast oczekiwać, że sam wyciągnie trafne wnioski, ponieważ nie zna budowy serwisu i nie odróżni prawdziwego robota Google od programu, który tylko się pod niego podszywa.
Plik, w którym serwer zapisuje każde żądanie: adres IP, czas, żądany adres, kod odpowiedzi i nazwę programu, który o stronę poprosił (tak zwany klient użytkownika).
Podszywanie się pod Googlebota
Najczęstszy cichy błąd polega na zaufaniu nazwie klienta użytkownika. Google w dokumentacji o weryfikowaniu żądań od robotów i modułów pobierania Google opisuje sprawdzenie na wypadek, gdy witrynę odwiedzają spamerzy lub inni oszuści podający się za Googlebota. Model poproszony o policzenie wizyt Googlebota odfiltruje wiersze po nazwie i poda wynik z pełnym przekonaniem, choć część tych żądań mogła pochodzić z zupełnie innych źródeł.
Dokumentacja wskazuje dwie metody. Ręczna polega na odwrotnym wyszukaniu nazwy dla adresu IP poleceniem host, sprawdzeniu, czy nazwa należy do domeny googlebot.com, google.com lub googleusercontent.com, a następnie na zwykłym wyszukaniu tej nazwy i porównaniu wyniku z adresem z logu. Automatyczna, przeznaczona dla większej skali, polega na porównaniu adresów z publikowanymi przez Google listami zakresów IP.
host 66.249.66.1
1.66.249.66.in-addr.arpa domain name pointer crawl-66-249-66-1.googlebot.com.

host crawl-66-249-66-1.googlebot.com
crawl-66-249-66-1.googlebot.com has address 66.249.66.1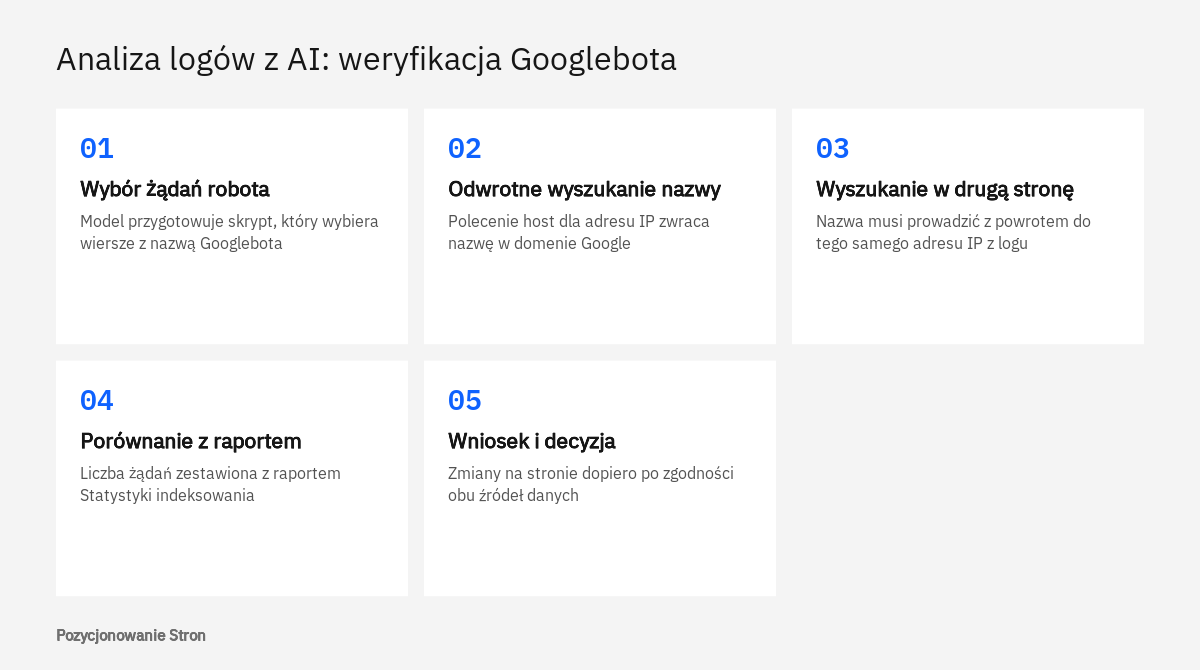
Punkt odniesienia: raport Statystyki indeksowania
Wynik uzyskany z logów warto zestawić z danymi samego Google. W Search Console, w ustawieniach usługi, znajduje się raport Statystyki indeksowania. Według pomocy Search Console pokazuje on łączną liczbę żądań robota indeksującego, całkowity rozmiar pobierania i średni czas odpowiedzi, a także podział żądań według odpowiedzi serwera, typu pliku, celu indeksowania i typu Googlebota. Raport jest dostępny tylko dla usług najwyższego poziomu.
Jeżeli liczba żądań policzona z logów znacznie przewyższa tę z raportu, najbardziej prawdopodobnym wyjaśnieniem jest ruch nieprawdziwego robota albo błąd w skrypcie. Sklep z Poznania, który na podstawie analizy od modelu uzna, że Google marnuje większość wizyt na adresy z filtrami, powinien przed jakąkolwiek zmianą w pliku robots.txt potwierdzić ten obraz w obu źródłach. Znaczenie poszczególnych grup odpowiedzi wyjaśniamy we wpisie o kodach odpowiedzi HTTP, a to, których serwisów problem dotyczy, we wpisie o budżecie indeksowania.
Znaczniki: tytuły, opisy i dane strukturalne
Przy znacznikach model dobrze sprawdza się jako autor szkieletu i wariantów, natomiast źle jako źródło wartości, które do tego szkieletu trafiają. Google we wskazówkach o generatywnej AI zaznacza, że ręcznej kontroli wymagają także metadane: elementy title, metaopisy, uporządkowane dane i teksty alternatywne obrazów, ponieważ mogą one pojawić się w wynikach wyszukiwania.
Tytuły i metaopisy
Przygotowanie kilku wariantów tytułu dla jednej podstrony to wygodne zastosowanie: model dostaje treść strony i podaje propozycje, z których człowiek wybiera najlepszą. Ryzyko rośnie przy pracy seryjnej. Google w dokumentacji o linkach z tytułami zaleca, aby każda strona miała inny, zwięzły i opisowy tekst w elemencie title, odradza powtarzanie tych samych słów oraz tytuły szablonowe, a także wskazuje, że gdy tytuł nie odzwierciedla zawartości strony, link w wynikach może zostać zmodyfikowany. Model generujący setki tytułów naraz ma skłonność właśnie do szablonu.
Z metaopisami jest podobnie. Według strony Jak tworzyć metaopisy krótkie opisy w wynikach powstają głównie na podstawie zawartości strony, identyczne lub bardzo podobne opisy na wielu stronach nie są pomocne, a opisy tworzone automatycznie dla dużych serwisów powinny pozostać zróżnicowane, czytelne i oparte na danych znajdujących się na stronie. Do modelu warto więc przekazywać faktyczną treść każdej podstrony, a nie samą nazwę kategorii.
Dane strukturalne
Model bez trudu zapisze poprawny składniowo blok JSON-LD, czyli zalecany przez Google format danych strukturalnych. Kłopot polega na tym, że równie chętnie wypełni go wartościami, których nikt mu nie podał: średnią oceną, liczbą opinii, godzinami otwarcia, zakresem cen. Blok wygląda profesjonalnie i dlatego łatwo przechodzi przez pobieżny przegląd.
Ogólne wytyczne dotyczące uporządkowanych danych są tu jednoznaczne: dane muszą przedstawiać rzeczywistą zawartość strony, nie wolno oznaczać treści niewidocznych dla użytkowników ani nietrafnych lub mylących. Naruszenie może skończyć się ręcznym działaniem, po którym strona przestaje kwalifikować się do wyników z elementami rozszerzonymi. Wytyczne zastrzegają również, że poprawne dane nie gwarantują wyświetlenia takiego wyniku.
Proszę przygotować blok JSON-LD typu LocalBusiness zgodny z dokumentacją Google.
Dane firmy wklejam poniżej. Proszę użyć wyłącznie tych danych.
Jeżeli brakuje wartości dla właściwości wymaganej lub zalecanej, proszę nie wymyślać jej,
tylko wpisać w jej miejscu DO_UZUPELNIENIA i wypisać brakujące pola pod kodem.
Proszę nie dodawać ocen, liczby opinii ani cen, jeżeli nie ma ich w danych.
Gotowy kod należy wkleić do Testu wyników z elementami rozszerzonymi, o którym Google pisze we wprowadzeniu do znaczników uporządkowanych danych, a po wdrożeniu obserwować raport o stanie wyników z elementami rozszerzonymi w Search Console. To samo źródło radzi, by podać mniej zalecanych właściwości, ale w pełni i dokładnie. Test potwierdza jednak tylko składnię. Zgodność wartości z tym, co widzi użytkownik, musi sprawdzić człowiek, porównując kod z podstroną pole po polu. Więcej o tym temacie zawiera wpis o danych strukturalnych a odpowiedziach AI.
Redakcja i pisanie: gdzie kończy się pomoc, a zaczyna ryzyko
Redakcja gotowego tekstu to bezpieczne zastosowanie AI, a seryjne pisanie stron od zera jest zastosowaniem najbardziej ryzykownym. W pierwszym przypadku treść pochodzi od człowieka, a model ją skraca, upraszcza i porządkuje. W drugim model sam dostarcza treść, czyli robi dokładnie to, w czym jest najmniej wiarygodny.
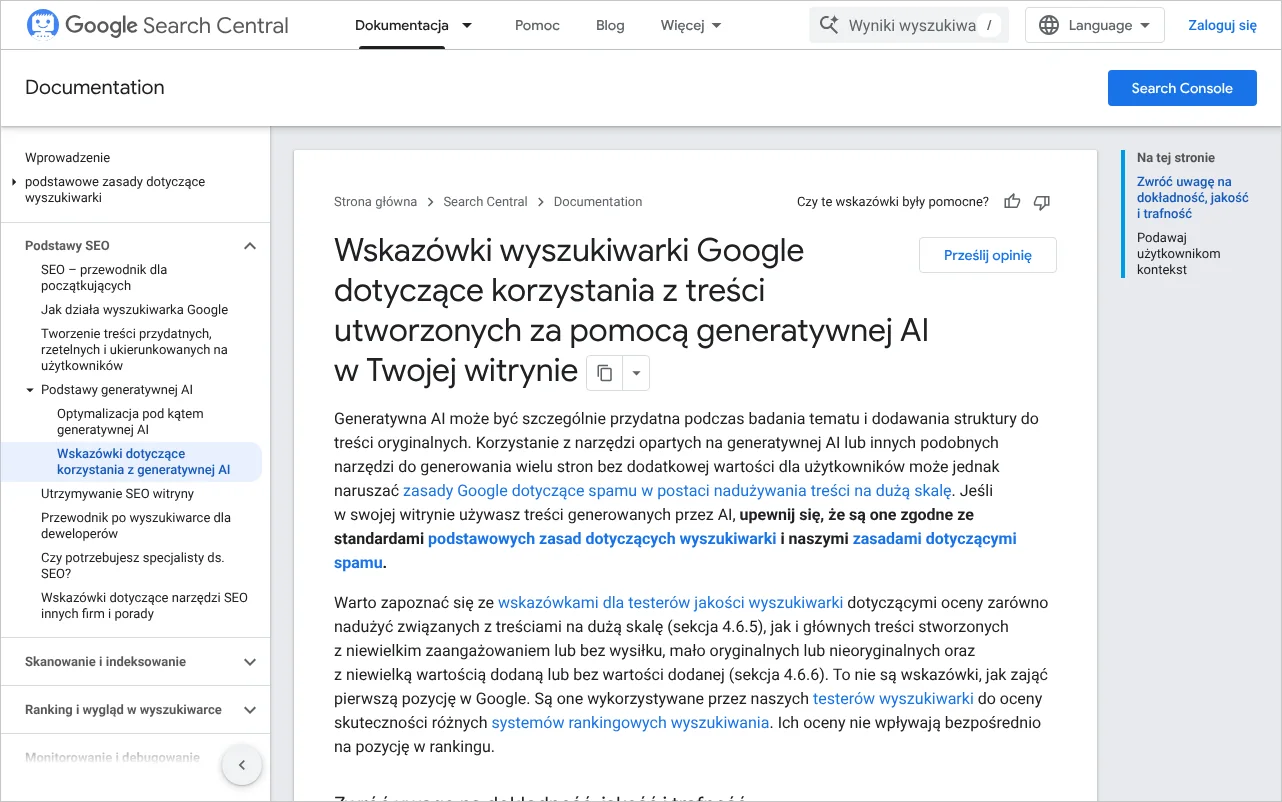
Google nie ocenia tekstu według tego, kto lub co go napisało. W zasadach dotyczących spamu nadużywanie treści na dużą skalę opisano jako generowanie wielu stron przede wszystkim po to, by manipulować rankingami, niezależnie od sposobu ich utworzenia, a wśród przykładów wymieniono użycie narzędzi generatywnej AI do tworzenia wielu stron bez dodatkowej wartości dla użytkowników. Firma, która w krótkim czasie publikuje kilkaset opisów miejscowości różniących się nazwą miasta, wchodzi więc na teren opisany w tych zasadach, nawet jeżeli każdy tekst z osobna jest poprawny językowo. Więcej na ten temat zawiera wpis o treściach pisanych przez AI a Google.
Przy redakcji typowy cichy błąd to zmiana sensu. Model wygładzający akapit potrafi zamienić "zwykle" na "zawsze", usunąć zastrzeżenie albo dopisać zdanie łączące, które brzmi dobrze, lecz zawiera twierdzenie nieobecne w oryginale. W tekstach o prawie, zdrowiu i finansach taka zmiana ma realne konsekwencje. Dlatego w poleceniu redakcyjnym warto zastrzec, że nie wolno dodawać żadnych informacji, i poprosić o listę wprowadzonych zmian.
Proszę zredagować poniższy tekst: krótsze zdania, prostsze słowa, bez powtórzeń.
Proszę nie dodawać żadnych faktów, liczb ani przykładów i nie usuwać zastrzeżeń.
Pod tekstem proszę wypisać wszystkie miejsca, w których zmieniło się znaczenie zdania
lub w których twierdzenie wymaga potwierdzenia w źródle.
Zasady weryfikacji: jak sprawdzać to, co oddaje model
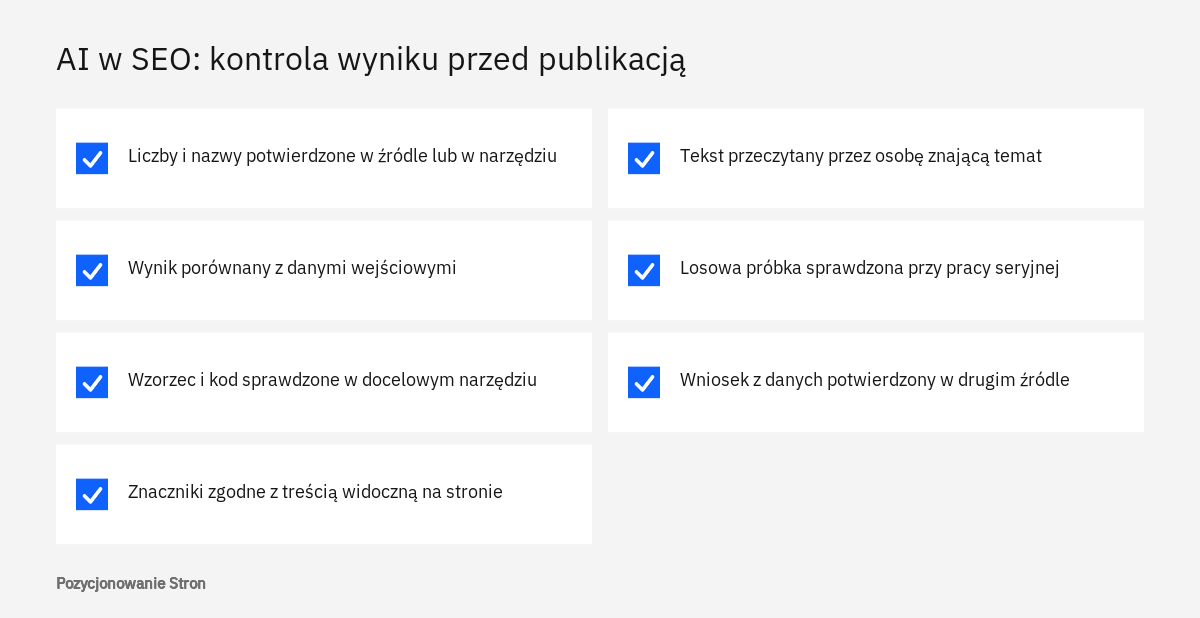
Wynik pracy modelu należy traktować jak szkic, którego autor nigdy nie przyznaje się do niewiedzy: wszystko, co ma trafić na stronę, przechodzi kontrolę w narzędziu lub w źródle. Google ujmuje to krótko: przed publikacją treści z generatywnej AI należy ręcznie sprawdzić ich dokładność i wiarygodność.
Kontrola nie musi być długa, jeżeli jest dopasowana do zadania. Wzorzec sprawdza filtr, znacznik sprawdza test, grupowanie sprawdza suma fraz, a twierdzenie o działaniu wyszukiwarki sprawdza dokumentacja. Słabym sposobem weryfikacji jest pytanie modelu, czy jest pewien swojej odpowiedzi, ponieważ potwierdzenie powstaje w ten sam sposób co pierwsza odpowiedź.
- Każda liczba, nazwa własna i nazwa funkcji została potwierdzona w źródle lub w narzędziu.
- Wynik został porównany z danymi wejściowymi: nic nie zniknęło i nic nie zostało dopisane.
- Kod, wzorzec lub znacznik przeszedł test w docelowym narzędziu.
- Wartości w danych strukturalnych, tytułach i opisach zgadzają się z treścią widoczną na podstronie.
- Tekst przeczytała osoba znająca temat i firmę.
- Przy pracy seryjnej sprawdzono losową próbkę pod kątem powtarzalnego szablonu.
- Wniosek z danych został potwierdzony w drugim, niezależnym źródle.
Z czego składa się dobre polecenie
Przykłady z wcześniejszych sekcji mają wspólną budowę. Zawierają dane wejściowe zamiast prośby o ich wymyślenie, opis celu i narzędzia, do którego trafi wynik, zakaz dopisywania informacji, żądany format oraz prośbę o oznaczenie miejsc niepewnych i braków. Ten ostatni element jest najważniejszy, ponieważ zamienia błędy ciche na głośne: zamiast zmyślonej wartości pojawia się wyraźne pole do uzupełnienia.
Kiedy potrzebna jest pomoc specjalisty
Samodzielna praca z modelem wystarcza przy porządkowaniu fraz, redakcji i prostych filtrach. Wsparcie jest potrzebne wtedy, gdy wynik ma prowadzić do zmian trudnych do odwrócenia: blokad w pliku robots.txt, przekierowań, przebudowy struktury serwisu, masowej wymiany tytułów lub wdrożenia danych strukturalnych w szablonie sklepu. W takich sytuacjach warto zacząć od audytu SEO albo zlecić prace z zakresu SEO technicznego. Tak samo podchodzimy do tego w ramach usług SEO: model przyspiesza pracę, a za treść i zmiany odpowiada człowiek.
Jeśli chcą Państwo zamówić pozycjonowanie strony, zachęcamy do kontaktu: tel. 222 500 844 lub mailowo: biuro@pozycjonowaniestron.pl
Najczęstsze pytania
Czy Google karze za korzystanie z AI przy pracy nad stroną?
Zasady Google nie zakazują samego użycia AI. Naruszeniem może być generowanie wielu stron bez wartości dla użytkowników, niezależnie od tego, czy powstały ręcznie, czy automatycznie. Liczy się cel i przydatność treści.
Czy model może podać liczbę wyszukiwań danej frazy?
Model może podać liczbę, ale nie należy jej traktować jako danych, ponieważ modele przewidują prawdopodobny tekst, a nie odczytują statystyk. Informacji o popularności zapytań trzeba szukać w narzędziach Google i we własnym raporcie Skuteczność.
Jak sprawdzić wyrażenie regularne przygotowane przez AI?
Najprościej wpisać je w raporcie Skuteczność jako filtr Niestandardowe (wyrażenie regularne) i przejrzeć dopasowane wiersze. Następnie warto przełączyć filtr na tryb Nie pasuje do wyrażenia regularnego i sprawdzić, czy nie odpadły zapytania, które miały zostać.
Czy dane strukturalne wygenerowane przez AI można wdrożyć bez sprawdzania?
Nie. Test wyników z elementami rozszerzonymi potwierdzi składnię, ale nie wykryje zmyślonej oceny ani nieprawdziwych godzin otwarcia. Wytyczne Google wymagają, by dane odpowiadały rzeczywistej, widocznej treści strony.
Czy można zlecić modelowi analizę logów serwera?
Można zlecić mu przygotowanie skryptu lub formuł, które uporządkują dane. Wnioski wymagają potwierdzenia, że żądania faktycznie pochodziły od Google, oraz porównania z raportem Statystyki indeksowania w Search Console.
Czy trzeba informować czytelników, że tekst powstał z pomocą AI?
Google zaleca wyjaśnianie, jak treść powstała, zwłaszcza gdy czytelnik może się takiej informacji spodziewać. Obowiązki wynikające z przepisów to odrębna sprawa, którą w razie wątpliwości warto omówić z prawnikiem.
Źródła
- Wskazówki wyszukiwarki Google dotyczące korzystania z treści utworzonych za pomocą generatywnej AI w Twojej witrynie, Centrum wyszukiwarki Google
- Zasady dotyczące spamu w wyszukiwarce Google, Centrum wyszukiwarki Google
- Tworzenie treści przydatnych, rzetelnych i ukierunkowanych na użytkowników, Centrum wyszukiwarki Google
- Raport skuteczności (wyniki wyszukiwania): zaawansowane filtrowanie i porównywanie, Search Console - pomoc
- Weryfikowanie żądań od robotów i modułów pobierania Google, Google for Developers
- Raport Statystyki indeksowania, Search Console - pomoc
- Wpływ na linki z tytułami w wyszukiwarce Google, Centrum wyszukiwarki Google
- Jak tworzyć metaopisy, Centrum wyszukiwarki Google
- Ogólne wytyczne dotyczące uporządkowanych danych, Centrum wyszukiwarki Google
- Jak działają znaczniki uporządkowanych danych - wprowadzenie, Centrum wyszukiwarki Google
Funkcje wyszukiwarek i asystentów AI zmieniają się szybko, dlatego wpis aktualizujemy po większych zmianach.