Duży model językowy to program, który na podstawie ogromnej liczby przeczytanych tekstów przewiduje, jaki fragment tekstu powinien pojawić się jako następny. Nie przeszukuje bazy faktów i niczego nie sprawdza, tylko układa najbardziej prawdopodobny ciąg dalszy. Zrozumienie tej jednej zasady wyjaśnia, dlaczego asystenci AI piszą tak sprawnie, dlaczego czasem się mylą i od czego zależy, czy wspomną o Państwa firmie.
Czym jest duży model językowy
Duży model językowy, w skrócie LLM (od angielskiego large language model), to model, który szacuje, z jakim prawdopodobieństwem dany fragment tekstu wystąpi po innych fragmentach, i na tej podstawie tworzy odpowiedź. Tak opisuje go kurs systemów uczących się przygotowany przez Google: model językowy ocenia prawdopodobieństwo pojedynczego fragmentu lub całej ich sekwencji w dłuższym ciągu.
Najprostsze porównanie, którego używa sam kurs Google, to autouzupełnianie znane z telefonu. Klawiatura podpowiada jedno następne słowo na podstawie dwóch lub trzech poprzednich. Duży model robi to samo, ale bierze pod uwagę całą dotychczasową rozmowę i potrafi dopisać nie jedno słowo, lecz kilka akapitów. Pytanie użytkownika jest dla niego początkiem tekstu, a odpowiedź to brakujący ciąg dalszy, który trzeba uzupełnić.
Model językowy o bardzo dużej liczbie parametrów, wytrenowany na ogromnym zbiorze tekstów, który przewiduje kolejne fragmenty tekstu i w ten sposób pisze odpowiedzi, streszczenia czy tłumaczenia.
Co oznacza słowo „duży”
Słowo „duży” odnosi się do liczby parametrów, czyli wartości liczbowych, które model ustala w trakcie nauki. Słowniczek Google definiuje duży model językowy po prostu jako model językowy z bardzo dużą liczbą parametrów, a w części kursu poświęconej budowie takich modeli pada skala: setki miliardów, a nawet biliony parametrów. Dla właściciela firmy ważny jest wniosek, a nie sama liczba. Parametry to nie zdania ani dokumenty. To ustawienia ogromnej sieci, w których zapisały się zależności między słowami. Nie da się otworzyć modelu i znaleźć w nim akapitu o konkretnej kancelarii z Krakowa.
Model a asystent, z którym się rozmawia
Model to silnik, a asystent to cały pojazd. Okno rozmowy, pamięć wcześniejszych wypowiedzi, dostęp do wyszukiwarki, możliwość wczytania pliku - to elementy dobudowane wokół modelu przez producenta. To rozróżnienie przydaje się w praktyce, ponieważ ten sam asystent raz odpowiada wyłącznie z tego, czego nauczył się model, a innym razem najpierw przeszukuje sieć. Różnice między poszczególnymi usługami opisujemy we wpisie porównującym asystentów okiem marketera.
Jak model przewiduje kolejne fragmenty tekstu
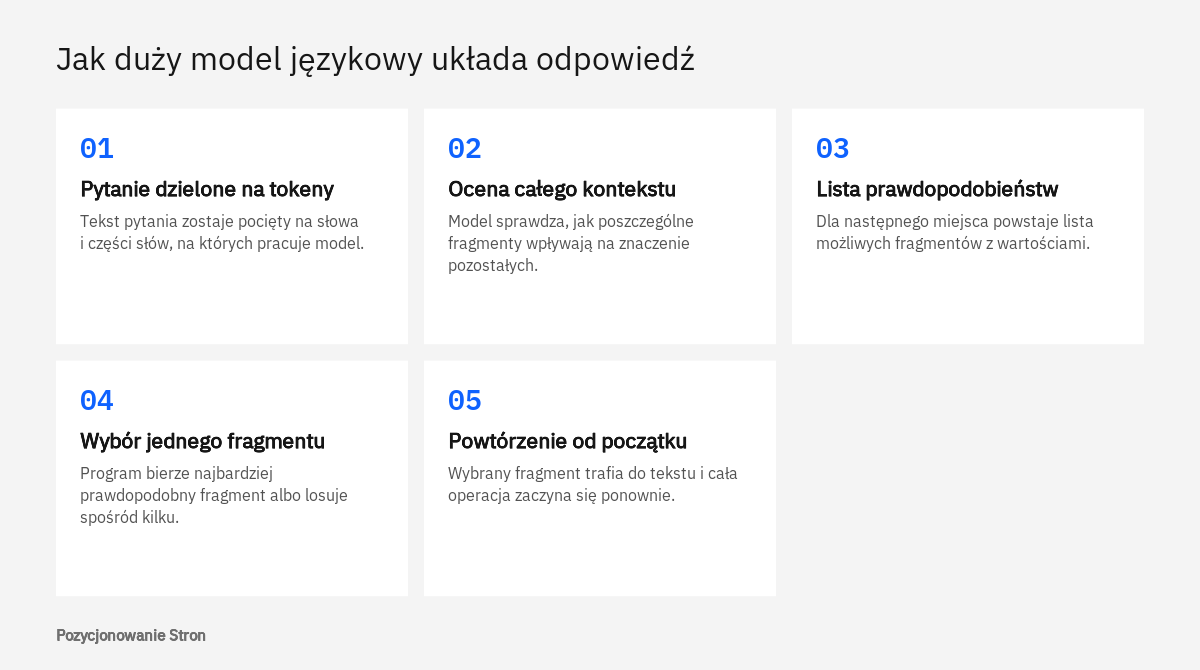
Model nie pisze całej odpowiedzi naraz. Dopisuje ją po kawałku: dla każdego miejsca oblicza, jak prawdopodobne są różne możliwe ciągi dalsze, wybiera jeden z nich, dołącza go do tekstu i powtarza całą operację od początku. Te kawałki nazywa się tokenami.
Czym jest token
Token to najmniejsza jednostka tekstu, na której pracuje model. Według kursu Google może nią być całe słowo, część słowa albo pojedynczy znak. Współczesne modele dzielą tekst na części słów, dzięki czemu radzą sobie także z wyrazami rzadkimi i odmienionymi. Podział zależy od języka. Dla angielskiego kurs podaje orientacyjnie, że jeden token to około czterech znaków, czyli mniej więcej trzy czwarte słowa, a 400 tokenów odpowiada około 300 słowom. Dla polskiego te proporcje mogą wyglądać inaczej, dlatego traktujemy je wyłącznie jako ilustrację.
Prawdopodobieństwa zamiast pewności
W kursie Google znajduje się przykład zdania z luką: ktoś słyszy deszcz na dachu i coś robi w kuchni. Model nie wskazuje jednej odpowiedzi, lecz listę możliwości z wartościami. Gotowanie zupy otrzymuje tam 9,4 procent, nastawienie czajnika 5,2 procent, a kolejne propozycje jeszcze mniej. Żadna z nich nie jest „prawdą” o tym, co zdarzyło się w kuchni. Są to po prostu ciągi dalsze, które w tekstach podobnych do tego zdania występowały częściej lub rzadziej.
Program korzystający z modelu może potem postąpić na dwa sposoby opisane w tym samym kursie: wziąć fragment o najwyższym prawdopodobieństwie albo wylosować jeden spośród tych, które przekraczają ustalony próg. O tym, ile losowości znajdzie się w odpowiedzi, decyduje między innymi ustawienie nazywane temperaturą, które słowniczek generatywnej AI opisuje jako parametr sterujący stopniem losowości wyniku.
Skąd model wie, o co chodzi w zdaniu
Model bierze pod uwagę wszystkie fragmenty pytania jednocześnie i dla każdego z nich ocenia, jak mocno pozostałe wpływają na jego znaczenie. Mechanizm ten nazywa się samouwagą (self-attention) i jest sercem architektury o nazwie Transformer, na której zbudowane są obecne modele. Kurs Google pokazuje to na zdaniu o zwierzęciu, które nie przeszło przez ulicę, bo było zbyt zmęczone. Zaimek wiąże się tam ze zwierzęciem. Wystarczy zamienić ostatnie słowo na „szeroka”, a ten sam zaimek zaczyna odnosić się do ulicy. Dlatego sposób zadania pytania ma znaczenie: zapytanie „hydraulik Łódź” i pytanie o naprawę cieknącego pieca gazowego w sobotę wieczorem prowadzą do innych odpowiedzi.
Jak model się uczy: trenowanie na ogromnych zbiorach tekstu
Model uczy się przez zgadywanie ukrytych fragmentów w bardzo dużej liczbie tekstów. W materiale treningowym zasłania się losowe tokeny, model próbuje je przewidzieć, a po każdej próbie jego parametry są nieznacznie korygowane tak, aby następnym razem trafiał częściej. Kurs Google nazywa ten etap przewidywaniem zamaskowanych fragmentów i podkreśla, że odbywa się on bez nauczyciela: nikt nie oznacza ręcznie, co w zdaniu jest prawdą, a co nie. Z miliardów takich drobnych korekt powstaje coś, co z zewnątrz wygląda jak wiedza o świecie.
Z czego składa się materiał do nauki
Podstawowym składnikiem jest ogromny zbiór tekstów, zwykle wcześniej przefiltrowany. Kurs nie wylicza konkretnych źródeł, mówi jedynie o skali. Z dokumentacji Google dla wydawców wynika natomiast, że treści stron internetowych mogą służyć do trenowania kolejnych generacji modeli Gemini i że właściciel witryny ma na to wpływ.
Dla firmy ważne jest co innego: model poznaje świat z tekstów, a nie z rzeczywistości. Jeśli o sklepie z Poznania napisano w sieci niewiele, model ma o nim niewiele skojarzeń. Jeśli opisy są sprzeczne, na przykład w jednym miejscu podano inny zakres usług niż w drugim, model nie ma jak rozstrzygnąć, która wersja jest właściwa.
Dlaczego modeli nie trenuje się co tydzień
Trenowanie od podstaw jest bardzo kosztowne. Kurs Google wymienia wśród trudności zebranie ogromnego zbioru danych, proces trwający wiele miesięcy oraz duże zapotrzebowanie na moc obliczeniową i energię elektryczną, i stwierdza, że w praktyce mało kto trenuje taki model od zera. Wynika z tego prosta konsekwencja: wiedza zapisana w parametrach odpowiada stanowi tekstów zebranych przed nauką. Zmiana adresu biura, nowa usługa czy otwarcie oddziału, które nastąpiły później, nie znajdą się w modelu, dopóki nie powstanie jego następna wersja albo dopóki asystent nie sięgnie po aktualne strony.
Dostrajanie, destylacja i polecenia: jak model przystosowuje się do zadań
Model po pierwszym etapie nauki jest ogólną podstawą, którą dopiero potem przystosowuje się do konkretnej pracy. Część kursu Google poświęcona dostrajaniu, destylacji i tworzeniu poleceń opisuje trzy sposoby takiego przystosowania. Dwa pierwsze należą do producentów i zespołów technicznych, trzeci jest dostępny dla każdego, kto wpisuje pytanie w okno rozmowy.
| Sposób | Na czym polega | Co się zmienia w modelu | Kto to robi |
|---|---|---|---|
| Dostrajanie | Dodatkowa nauka na przykładach odpowiadających konkretnemu zadaniu, czasem kilkuset lub kilku tysiącach | Parametry są korygowane, ich liczba pozostaje taka sama | Producent modelu lub zespół wdrażający |
| Destylacja | Mniejszy model uczy się na odpowiedziach większego | Powstaje nowy, mniejszy model: szybszy i tańszy, zwykle mniej dokładny | Producent modelu |
| Polecenie | Tekst wpisany przez użytkownika, czasem z przykładami oczekiwanej odpowiedzi | Nic, parametry pozostają nietknięte | Każdy użytkownik |
Dlaczego model odpowiada, zamiast tylko dopisywać tekst
Model, który umie wyłącznie kontynuować tekst, na pytanie mógłby odpowiedzieć kolejnym pytaniem. Dlatego po nauce ogólnej stosuje się dodatkowy etap nazywany w kursie dostrajaniem pod kątem instrukcji, który poprawia wykonywanie poleceń. To on sprawia, że asystent zachowuje się jak rozmówca: streszcza, gdy prosi się o streszczenie, i porównuje, gdy prosi się o porównanie. Sama zasada działania pozostaje bez zmian. Kurs zwraca uwagę, że nawet model rozwiązujący zadania matematyczne z treścią w istocie nadal uzupełnia tekst, choć sprawia wrażenie rozumowania.
Destylacja tłumaczy z kolei, dlaczego ten sam producent oferuje kilka modeli o różnej wielkości. Szybka, skrócona odpowiedź i długa odpowiedź w rozbudowanym trybie asystenta mogą pochodzić z modeli o różnej dokładności.
Polecenie z przykładem i bez przykładu
Polecenie, nazywane też promptem, to według słowniczka Google tekst podany modelowi po to, aby nakierować go na określone zachowanie. Kurs rozróżnia polecenie bez przykładu, z jednym przykładem i z kilkoma przykładami. Różnica bywa duża. Model zapytany bez żadnego kontekstu o słowo o dwóch znaczeniach może wybrać nie to, o które chodziło pytającemu. Wystarczy jeden wzór oczekiwanej odpowiedzi, aby trafił częściej.
Zadanie: opisać usługę w dwóch zdaniach, prostym językiem, bez przymiotników oceniających.

Wzór:
Usługa: przegląd pieca gazowego
Opis: Technik sprawdza szczelność instalacji, czyści palnik i mierzy skład spalin. Po wizycie klient otrzymuje protokół z wynikami.

Usługa: montaż pompy ciepła
Opis:
Jakość wyniku zależy więc w dużej mierze od tego, co model dostanie na wejściu, ale nawet najlepsze polecenie nie zastąpi sprawdzenia tekstu przez człowieka, który zna firmę. O zasadach, jakie Google stosuje wobec takich materiałów, piszemy we wpisie o treściach pisanych przez AI.
Co model wie, a czego nie wie
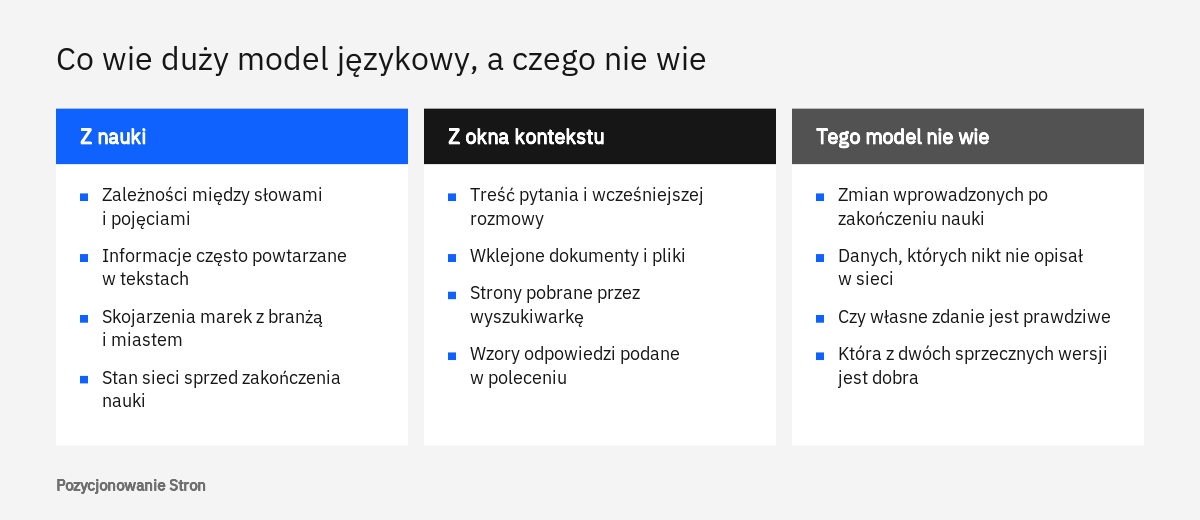
Model „wie” to, co wielokrotnie powtarzało się w tekstach użytych do nauki, oraz to, co dostał w bieżącej rozmowie. Nie wie niczego, co nie trafiło do żadnego z tych dwóch miejsc. Nie ma też wglądu we własną wiedzę: nie potrafi sprawdzić, czy dane zdanie pochodzi z dobrze udokumentowanego faktu, czy z luźnego skojarzenia.
Drugim źródłem informacji jest okno kontekstu, czyli według słowniczka Google liczba tokenów, które model może przetworzyć w ramach jednego polecenia. W tym oknie mieszczą się pytanie, wcześniejsza część rozmowy, wklejone dokumenty i treść stron pobranych przez wyszukiwarkę. To, co znajduje się w oknie, model ma „przed oczami” i może z tego korzystać dosłownie. To, czego w oknie nie ma, musi odtworzyć ze swoich parametrów.
W praktyce agencji rozróżniamy więc trzy sytuacje. Firma szeroko opisywana w sieci bywa wymieniana przez asystenta nawet bez wyszukiwania, bo jej nazwa utrwaliła się w modelu w połączeniu z branżą i miastem. Firma lokalna, o której napisano niewiele, pojawia się zwykle dopiero wtedy, gdy asystent przeszukuje sieć. Firma nowa albo taka, która niedawno zmieniła nazwę, w odpowiedziach „z pamięci” najczęściej nie występuje lub występuje pod starymi danymi. To obserwacja z naszej pracy, a nie reguła opisana w dokumentacji, ale wynika wprost z tego, jak przebiega trenowanie.
Model nie jest bazą danych ani wyszukiwarką
W bazie danych rekord o firmie można odnaleźć, poprawić i usunąć. W modelu nie ma rekordów. Są ustawienia sieci, z których każdorazowo na nowo powstaje zdanie. Dlatego nie istnieje formularz, w którym dałoby się „zaktualizować wpis” w modelu, i dlatego dwa pytania o tę samą firmę mogą dać dwa różne numery telefonu. Co można zrobić w takiej sytuacji, opisujemy osobno we wpisie o błędnych informacjach o firmie w AI.
Jeśli chcą Państwo zamówić pozycjonowanie AI, zachęcamy do kontaktu: tel. 222 500 844 lub mailowo: biuro@pozycjonowaniestron.pl
Dlaczego model brzmi pewnie nawet wtedy, gdy się myli
Model brzmi pewnie, ponieważ płynność i poprawność językowa są dokładnie tym, czego się uczył, a prawdziwość nie była osobno sprawdzana. Zdanie fałszywe i zdanie prawdziwe powstają w ten sam sposób: jako najbardziej prawdopodobny ciąg dalszy. Jeżeli w tekstach, na których model się uczył, informacje o firmach miały zwykle postać „nazwa, ulica, numer, godziny otwarcia”, to model zapytany o mało znany warsztat ułoży zdanie o takiej samej budowie i wstawi do niego elementy, które pasują statystycznie, a niekoniecznie odpowiadają rzeczywistości.
Według słowniczka Google jest to wytworzenie przez model generatywnej AI wyniku, który wydaje się wiarygodny, ale jest niezgodny z faktami.
Nie jest to rzadka usterka, którą można pominąć. Kurs Google wymienia halucynacje wśród głównych problemów dużych modeli i stwierdza, że ich przewidywania często zawierają błędy. Podobnie ostrzega centrum prywatności aplikacji z Gemini: narzędzia oparte na dużych modelach mogą się mylić i podawać niepoprawne informacje jako fakty, także na temat osób, a ich wyników nie należy traktować jako porady medycznej, prawnej ani finansowej.
Kiedy ryzyko błędu rośnie
Z samej zasady działania i z naszych obserwacji wynika, że błędy pojawiają się najczęściej tam, gdzie model ma mało materiału, a pytanie wymaga konkretu. Dotyczy to zwłaszcza danych liczbowych i adresowych małych firm, cen, nazwisk, terminów i szczegółów oferty, a także wszystkiego, co zmieniło się po zakończeniu nauki modelu. Kancelaria z Krakowa może w ten sposób „otrzymać” specjalizację, której nie prowadzi, tylko dlatego, że w tekstach o kancelariach z tego miasta taka specjalizacja często występowała.
Skąd asystent bierze aktualne informacje
Aktualne informacje asystent bierze z wyszukiwarki: zanim odpowie, pobiera treść stron i dostarcza ją modelowi razem z pytaniem. Dokumentacja Google nazywa to groundingiem, czyli oparciem odpowiedzi na źródłach, i opisuje jako przekazanie modelowi treści z indeksu wyszukiwarki w chwili zadania pytania. Model nadal przewiduje kolejne fragmenty, ale ma w oknie kontekstu gotowy materiał, z którego może czerpać, zamiast odtwarzać wszystko z parametrów.
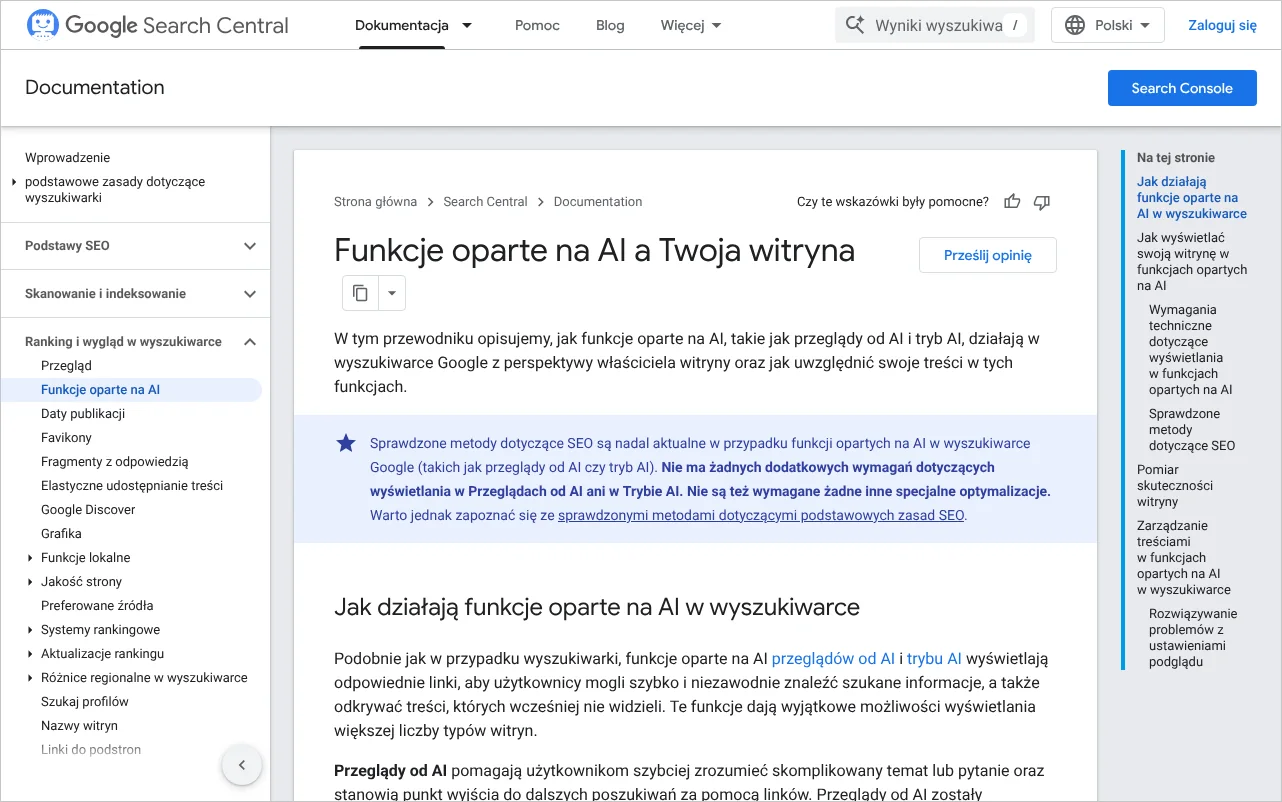
W wyszukiwarce Google działają w ten sposób Przeglądy od AI i Tryb AI. Dokumentacja funkcji opartych na AI wyjaśnia, że system rozkłada pytanie na wiele powiązanych wyszukiwań dotyczących podtematów, dzięki czemu znajduje szerszy zestaw stron niż klasyczne wyszukiwanie. Ta sama strona podaje warunek obecności wśród linków: witryna musi być zaindeksowana i kwalifikować się do wyświetlania w wynikach z fragmentem tekstu. Google zaznacza, że nie ma żadnych dodatkowych wymagań technicznych ani specjalnych plików dla AI, a spełnienie warunków niczego nie gwarantuje. Szerzej opisujemy to we wpisie o Trybie AI w Google.
Jaką kontrolę ma właściciel strony
Właściciel witryny decyduje o dwóch osobnych sprawach: o widoczności w wyszukiwarce i o wykorzystaniu treści przez modele Gemini poza wyszukiwarką. Pierwszą regulują znane mechanizmy, czyli plik robots.txt dla Googlebota oraz dyrektywy ograniczające fragmenty i indeksowanie. Drugą reguluje osobny znacznik w pliku robots.txt o nazwie Google-Extended. Według dokumentacji robotów Google pozwala on określić, czy treści mogą służyć do trenowania kolejnych generacji modeli Gemini oraz do opierania na nich odpowiedzi w aplikacjach z Gemini. Nie wpływa na obecność strony w wyszukiwarce i nie jest czynnikiem rankingowym.
User-agent: Google-Extended
Disallow: /

User-agent: Googlebot
Allow: /
Dla większości firm usługowych i sklepów taka blokada jest sprzeczna z celem: komu zależy na tym, aby asystent wspominał o marce, ten nie powinien odcinać mu dostępu do własnych treści. Decyzję warto podjąć świadomie, a nie odziedziczyć po domyślnych ustawieniach wtyczki.
Wnioski praktyczne dla marketingu i obecności marki w odpowiedziach
Skoro model powtarza to, co często i spójnie występuje w tekstach, a asystent z wyszukiwarką czyta to, co jest zaindeksowane, praca nad obecnością marki sprowadza się do dwóch rzeczy: jednoznacznych treści na własnej stronie oraz wzmianek o firmie w innych wiarygodnych miejscach. Nie istnieje ustawienie ani plik, który sam w sobie wprowadza firmę do odpowiedzi.
Własna strona: tekst, który da się przeczytać i zacytować
Zalecenia Google dla funkcji opartych na AI są takie same jak dla zwykłego wyszukiwania. Dokumentacja wymienia między innymi: brak blokad indeksowania w pliku robots.txt i po stronie serwera, linki wewnętrzne prowadzące do ważnych podstron, najważniejsze informacje podane w formie tekstu, dane strukturalne zgodne z tym, co widać na stronie, oraz aktualne dane w Profilu Firmy i w Merchant Center. Od strony technicznej zajmuje się tym SEO techniczne, od strony tekstu - treści SEO.
Z zasady przewidywania wynika dodatkowa wskazówka redakcyjna. Model łatwiej korzysta ze zdań, które są zrozumiałe bez otoczenia. Zdanie „wykonujemy przeglądy pieców gazowych w Łodzi i w promieniu trzydziestu kilometrów, także w soboty” niesie komplet informacji. Zdanie „działamy kompleksowo na terenie całego regionu” nie niesie żadnej, więc nie ma czego z niego powtórzyć.
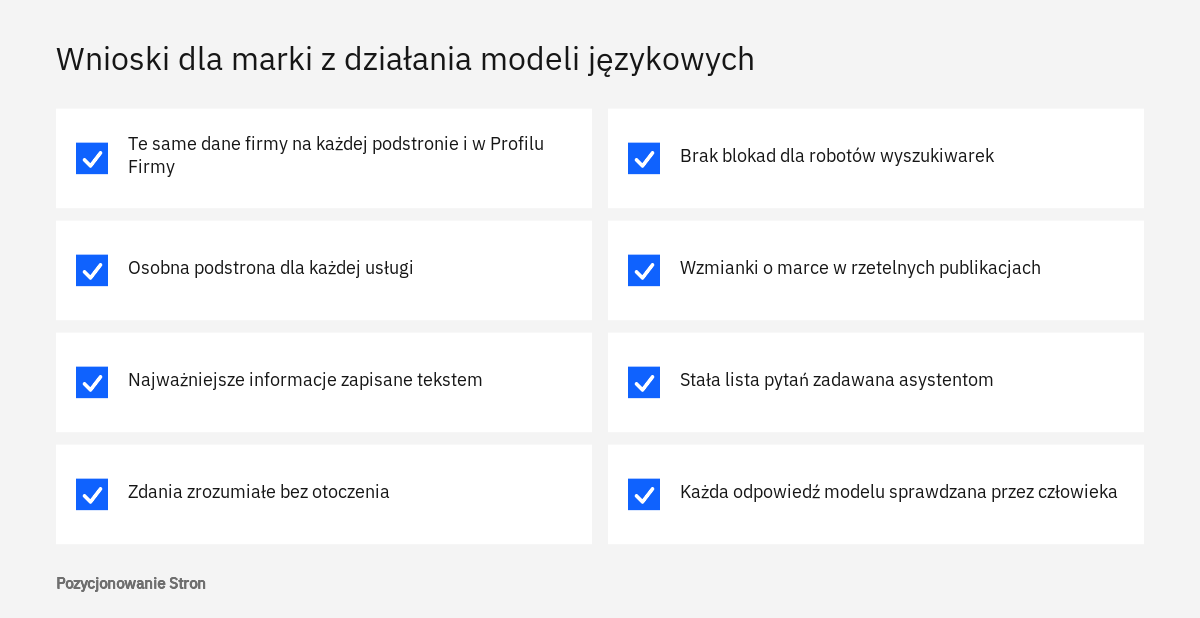
- Nazwa firmy, adres, telefon i zakres usług są zapisane tekstem, w identycznym brzmieniu na każdej podstronie i w Profilu Firmy.
- Każda usługa ma własną podstronę z odpowiedzią na pytania: co, dla kogo, gdzie, w jakim czasie.
- Najważniejsze informacje nie są ukryte wyłącznie w grafikach, plikach do pobrania ani elementach ładowanych dopiero po kliknięciu.
- Plik robots.txt i ustawienia serwera nie blokują Googlebota ani robotów asystentów, na których firmie zależy.
- Dane strukturalne opisują dokładnie to, co widzi człowiek na stronie.
- Nieaktualne informacje, na przykład stary adres lub wycofana usługa, zostały poprawione także na starszych podstronach.
Wzmianki poza własną stroną
Model uczy się skojarzeń z całej sieci, a nie tylko z witryny firmy. Im częściej nazwa marki występuje obok nazwy usługi i miasta w rzetelnych tekstach, tym silniejsze jest to połączenie. Dlatego rośnie znaczenie działań, które dawniej uznawano za czysto wizerunkowe: publikacji eksperckich, wypowiedzi w mediach branżowych, opisów realizacji. Zajmuje się tym PR internetowy, a mechanizm wyjaśniamy we wpisie o tym, skąd modele wiedzą, kogo polecić.
Gdzie sprawdzić, co asystenci mówią o firmie
Najprostsze sprawdzenie polega na zadaniu asystentom pytań, które zadałby klient, i zapisaniu odpowiedzi. Warto przygotować stałą listę kilkunastu pytań trzech rodzajów: o samą firmę („czym zajmuje się firma o tej nazwie”), o usługę w mieście („kto w Poznaniu naprawia ekspresy ciśnieniowe”) oraz o problem („co zrobić, gdy ekspres przestał spieniać mleko”). Każde pytanie zadaje się kilka razy, w nowej rozmowie, a w arkuszu notuje się, czy firma została wymieniona, czy dane były poprawne i jakie źródła podano.
Ruch z funkcji AI w wyszukiwarce Google nie ma w Search Console osobnego raportu. Według dokumentacji jest wliczany do ogólnych danych w raporcie Skuteczność, przy typie wyszukiwania „Sieć”. Cały sposób pomiaru opisujemy we wpisie o tym, jak mierzyć widoczność marki w odpowiedziach AI.
Typowe pomyłki w myśleniu o modelach i moment, w którym przydaje się pomoc
Najczęstsza pomyłka polega na traktowaniu modelu jak wyszukiwarki z jedną listą wyników, na której można zająć stałe miejsce. Model nie ma listy. Każda odpowiedź powstaje od nowa i zależy od brzmienia pytania, wersji modelu, losowości oraz tego, czy asystent sięgnął do sieci. Dlatego nie obiecujemy „pierwszego miejsca w ChatGPT” i z ostrożnością podchodzimy do takich obietnic.
Druga pomyłka to wiara w jedno techniczne rozwiązanie. Google wprost informuje, że do obecności w funkcjach AI nie są potrzebne specjalne znaczniki ani nowe pliki. Trzecia pomyłka to ocenianie sytuacji po jednej odpowiedzi: zrzut ekranu, na którym asystent pominął firmę albo podał błędny adres, pokazuje jeden z wielu możliwych wyników, a nie stan stały.
Czwarta pomyłka dotyczy własnej pracy z asystentem. Tekst oferty czy opis produktu przygotowany przez model wymaga sprawdzenia każdej liczby, nazwy i obietnicy, ponieważ model nie odróżnia tego, co firma naprawdę oferuje, od tego, co zwykle oferują firmy podobne. W sprawach prawnych, medycznych i finansowych właściwą drogą pozostaje rozmowa ze specjalistą.
Pomoc z zewnątrz przydaje się zwykle w trzech sytuacjach: gdy asystenci uporczywie podają błędne dane o firmie mimo poprawek na stronie, gdy konkurenci są wymieniani regularnie, a Państwa firma wcale, oraz gdy witryna jest duża i trudno ustalić, czy przeszkodą jest indeksowanie, treść czy brak wzmianek. W takich przypadkach zaczynamy od panelu pytań i przeglądu technicznego, a dopiero potem planujemy treści. Całość opisuje strona usługi pozycjonowanie AI.
Jeśli chcą Państwo zamówić pozycjonowanie AI, zachęcamy do kontaktu: tel. 222 500 844 lub mailowo: biuro@pozycjonowaniestron.pl
Najczęstsze pytania
Czy duży model językowy rozumie to, co pisze?
Model przewiduje kolejne fragmenty tekstu na podstawie zależności poznanych w trakcie nauki. Kurs Google opisuje go jako bardzo rozbudowane autouzupełnianie i zaznacza, że nawet przy zadaniach matematycznych model w istocie uzupełnia tekst. Dla użytkownika ważniejsze od sporu o słowo „rozumie” jest to, że odpowiedzi należy sprawdzać.
Dlaczego asystent za każdym razem odpowiada trochę inaczej?
Przy wyborze kolejnego fragmentu program może losować spośród kilku prawdopodobnych możliwości, a stopień tej losowości reguluje ustawienie nazywane temperaturą. Do tego dochodzą różnice w brzmieniu pytania i w wynikach wyszukiwania, jeśli asystent z niego korzysta.
Czy można poprawić błędną informację o firmie bezpośrednio w modelu?
Nie w taki sposób, jak poprawia się wpis w katalogu. Wiedza modelu jest zapisana w parametrach, a nie w rekordach, które da się edytować. Realny wpływ ma uporządkowanie danych na własnej stronie i w innych miejscach w sieci, z których asystent korzysta podczas wyszukiwania.
Czy model zna treść naszej strony internetowej?
To zależy od dwóch rzeczy: czy treść znalazła się w materiale użytym do nauki oraz czy asystent może pobrać stronę w chwili zadania pytania. W przypadku funkcji AI w wyszukiwarce Google warunkiem jest zaindeksowanie strony i możliwość wyświetlenia jej z fragmentem tekstu.
Czy blokada Google-Extended obniży pozycje strony w Google?
Według dokumentacji Google znacznik Google-Extended nie wpływa na obecność witryny w wyszukiwarce i nie jest czynnikiem rankingowym. Dotyczy wykorzystania treści do trenowania modeli Gemini i do opierania na nich odpowiedzi w aplikacjach z Gemini, więc blokada może ograniczyć obecność marki w tych odpowiedziach.
Czy większy model zawsze odpowiada lepiej?
Kurs Google podaje, że większe modele oparte na architekturze Transformer konsekwentnie osiągają lepsze wyniki, ale zużywają więcej zasobów przy każdej odpowiedzi. Mniejsze modele powstałe w drodze destylacji są szybsze i zwykle mniej dokładne. Halucynacje pozostają problemem niezależnie od rozmiaru.
Źródła
- Introduction to Large Language Models, Google for Developers
- LLM: co to jest duży model językowy?, Google for Developers
- LLM: dostrajanie, oczyszczanie i inżynieria promptów, Google for Developers
- Słowniczek systemów uczących się: generatywna AI, Google for Developers
- Funkcje oparte na AI a Twoja witryna, Centrum wyszukiwarki Google
- Typowe roboty Google, Google for Developers
- Centrum prywatności dotyczące aplikacji z Gemini, Pomoc Google
Funkcje wyszukiwarek i asystentów AI zmieniają się szybko, dlatego wpis aktualizujemy po większych zmianach.