Claude sięga do sieci wtedy, gdy pytanie wymaga informacji aktualnych, zmiennych albo nieobecnych w danych, na których model był uczony, a w odpowiedzi podaje odnośniki do stron, z których skorzystał. Wydawca asystenta opisuje trzy osobne roboty: do zbierania treści na potrzeby trenowania modeli, do wyszukiwania oraz do pobrań na żądanie użytkownika. Każdym z nich można sterować oddzielnie w pliku robots.txt, a ich wizyty da się rozpoznać w logach serwera.
Kiedy Claude korzysta z wyszukiwania w sieci
Claude nie przeszukuje internetu przy każdym pytaniu. Zgodnie z dokumentacją narzędzia wyszukiwania model sam decyduje, czy sięgnąć do sieci, i robi to wtedy, gdy odpowiedź zależy od informacji bieżących, zmieniających się albo wykraczających poza jego dane treningowe. Dokumentacja wymienia tu aktualne wiadomości, bieżące ceny i statystyki, informacje o organizacjach lub osobach, które mogły się zmienić, oraz wyraźne prośby o wyszukanie czegoś.
Na pytania dotyczące wiedzy ustalonej Claude odpowiada bez wyszukiwania. Chodzi o utrwalone fakty, matematykę, podstawy nauk ścisłych, zadania twórcze, analizę materiału wklejonego do rozmowy czy zwykłe powitanie. Dla właściciela firmy to rozróżnienie ma praktyczne znaczenie. Pytanie o to, czym różni się pompa ciepła od kotła gazowego, może zostać obsłużone wyłącznie z pamięci modelu, bez jednego odnośnika. Pytanie o to, kto obecnie montuje pompy ciepła w Kielcach i w jakich godzinach przyjmuje zgłoszenia, wymaga już świeżych danych, więc jest dużo bardziej prawdopodobne, że asystent przeszuka sieć i poda źródła.
Wyszukiwanie w aplikacji trzeba mieć włączone
W aplikacji Claude wyszukiwanie jest funkcją, którą użytkownik włącza i wyłącza. Strona pomocy o włączaniu i używaniu wyszukiwania opisuje ścieżkę: w polu wpisywania wiadomości znajduje się ikona suwaków, po jej kliknięciu otwiera się menu z pozycją wyszukiwania w sieci i przełącznikiem. W planach zespołowych i firmowych funkcję musi najpierw uruchomić właściciel przestrzeni roboczej w ustawieniach administracyjnych, w części poświęconej możliwościom asystenta. Dopiero potem poszczególni członkowie zespołu mogą z niej korzystać w rozmowach.
Ta sama strona pomocy podaje, że użytkownik może wymusić wyszukiwanie, prosząc o nie wprost w treści pytania, a także poprosić, aby asystent nie szukał. W trakcie pracy widoczny jest wskaźnik trwającego wyszukiwania, po czym Claude przegląda kilka źródeł i odpowiada w zwykłej, rozmownej formie. Pomoc zaznacza też, że asystent może ustalić przybliżoną lokalizację użytkownika na podstawie adresu IP, aby dopasować wyniki do miejsca. Z tego powodu dwie osoby zadające to samo pytanie z różnych miast mogą zobaczyć inne źródła.
Jak przebiega wyszukiwanie i skąd biorą się cytowane strony
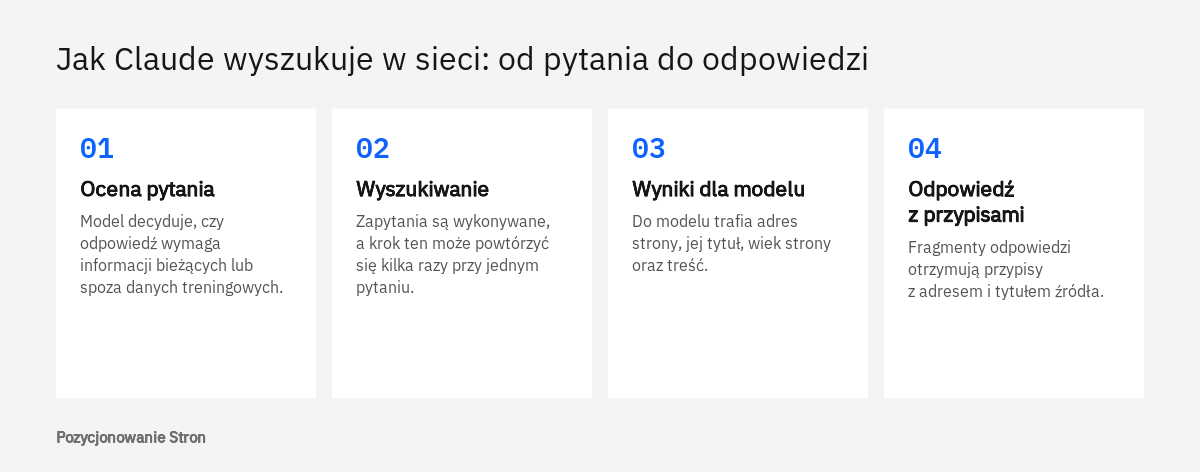
Cytowane strony pochodzą z wyników wyszukiwania, które asystent otrzymuje w trakcie przygotowywania odpowiedzi. Dokumentacja opisuje ten przebieg w trzech etapach: najpierw Claude na podstawie pytania decyduje, czy szukać, następnie wyszukiwanie jest wykonywane, a jego wyniki trafiają do modelu, na końcu zaś powstaje odpowiedź z przywołanymi źródłami. Środkowy etap może się powtórzyć kilka razy w ramach jednego pytania. Asystent układa wtedy kolejne zapytania, na przykład zawężając temat albo sprawdzając szczegół, którego zabrakło w pierwszych wynikach.
Dokumentacja podaje, że proste pytania wymagają zwykle od jednego do trzech wyszukiwań. Każdy wynik, który trafia do modelu, zawiera adres strony, jej tytuł, informację o tym, kiedy strona była ostatnio aktualizowana, oraz treść przekazaną w postaci zaszyfrowanej. Z tego opisu płyną dwa wnioski. Tytuł strony jest jedną z pierwszych rzeczy, które model widzi przy ocenie wyniku, więc powinien jasno mówić, czego dotyczy podstrona. Informacja o wieku strony także należy do zestawu danych, co przemawia za utrzymywaniem ważnych treści w aktualnym stanie.
Dokumentacja nie wymienia z nazwy dostawcy wyników wyszukiwania i nie opisuje czynników, które decydują o kolejności wyników. Nie ma więc podstaw, aby twierdzić, że istnieje lista zabiegów zapewniających cytowanie. Wiadomo natomiast, że wydawca prowadzi własnego robota wyszukiwania, który przegląda sieć po to, by poprawiać jakość wyników dla użytkowników. Mechanizm sięgania po zewnętrzne dokumenty w trakcie odpowiedzi jest wspólny dla większości asystentów i opisujemy go szerzej we wpisie o tym, dlaczego asystenci AI cytują strony internetowe.
Pobranie konkretnego adresu to coś innego niż wyszukiwanie
Obok wyszukiwania istnieje druga droga, którą treść strony trafia do rozmowy: pobranie wskazanego adresu. Strona pomocy podaje, że przy włączonym wyszukiwaniu Claude potrafi przeczytać pełną treść konkretnego adresu podanego przez użytkownika, na przykład wpisu na blogu. W praktyce wygląda to tak, że ktoś wkleja odnośnik do oferty biura rachunkowego i prosi o streszczenie warunków albo porównanie z inną ofertą.
W interfejsie dla programistów odpowiada temu osobne narzędzie pobierania stron. Jego dokumentacja zawiera kilka informacji ważnych dla właścicieli serwisów. Narzędzie pobiera tylko adresy, które już wystąpiły w rozmowie, czyli podane przez użytkownika albo zwrócone wcześniej przez wyszukiwanie. Obsługuje tekst, kod HTML i pliki PDF. Nie obsługuje natomiast stron, których treść powstaje dopiero w przeglądarce za pomocą skryptów JavaScript. Wyniki pobrań są przechowywane w pamięci podręcznej, więc asystent może przez pewien czas widzieć starszą wersję strony. Jeśli cennik, opis usługi albo dane kontaktowe pojawiają się na Państwa stronie dopiero po wykonaniu skryptów, istnieje ryzyko, że narzędzie tego typu zobaczy pustą stronę.
Jak Claude oznacza źródła w odpowiedzi
Odpowiedź oparta na wyszukiwaniu zawiera przypisy prowadzące do stron, z których pochodzi dana informacja. Strona pomocy aplikacji podaje, że każda taka odpowiedź ma odnośniki pozwalające sprawdzić źródła, a obok bezpośrednich wskazań źródeł mogą pojawić się linki do dalszej lektury i, tam gdzie to zasadne, przytoczone fragmenty. Dla użytkownika oznacza to możliwość przejścia jednym kliknięciem na stronę firmy, urzędu czy redakcji, na którą powołał się asystent.
Bardziej szczegółowy obraz daje dokumentacja dla programistów. Wynika z niej, że przy wyszukiwaniu przypisy są zawsze włączone. Każdy przypis jest przypięty do konkretnego fragmentu odpowiedzi i składa się z adresu cytowanej strony, jej tytułu, technicznego identyfikatora oraz pola z cytowanym tekstem, które mieści do 150 znaków treści źródła. Dokumentacja stawia też wymóg firmom budującym własne produkty na tym modelu: jeśli pokazują odpowiedź użytkownikom bez zmian, przypisy muszą prowadzić do pierwotnego źródła.
Co wynika z budowy przypisu dla autora treści
Skoro przypis wiąże pojedyncze twierdzenie z krótkim fragmentem strony, to cytowane bywają konkretne zdania, a nie ogólne wrażenie z całego serwisu. Jest to obserwacja z praktyki agencji, nie zapis z dokumentacji: łatwiej przywołać zdanie, które samo w sobie niesie pełną informację, niż akapit, w którym odpowiedź jest rozłożona na kilka zdań i wymaga kontekstu.
Drugi wniosek dotyczy tytułów. W przypisie użytkownik widzi tytuł strony, więc tytuł pełni rolę wizytówki źródła i powinien mówić, o czym jest dana podstrona. O podawaniu danych i przepisów w sposób, który ułatwia ich przywoływanie, piszemy we wpisie o cytowaniu źródeł w tekstach firmowych. Przypis nie jest przy tym gwarancją poprawności, ponieważ asystent może błędnie streścić cytowaną stronę.
Jakie trzy roboty opisuje dokumentacja wydawcy
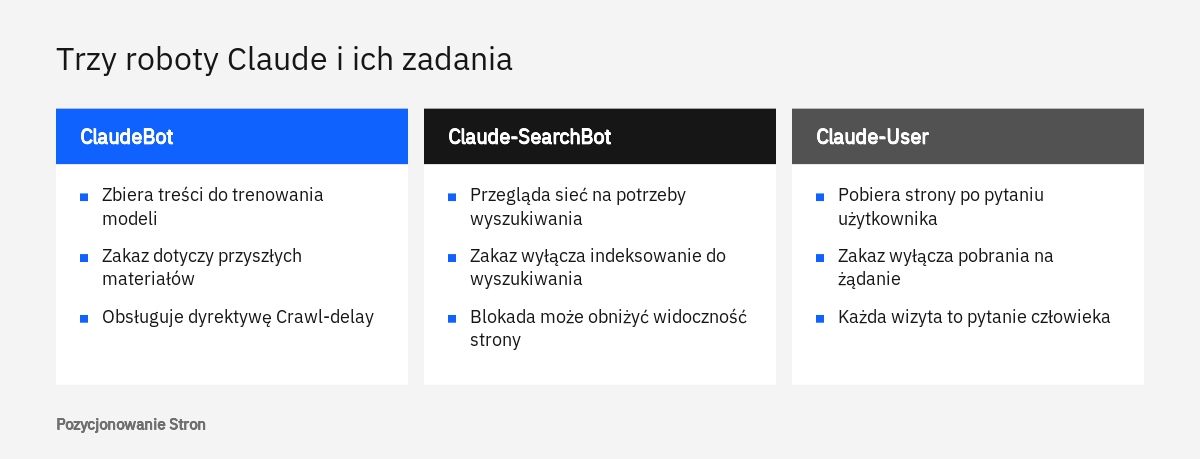
Wydawca asystenta opisuje trzy roboty o różnych zadaniach: ClaudeBot, Claude-SearchBot i Claude-User. Ich opis znajduje się na stronie pomocy poświęconej robotom i sposobom ich blokowania. Rozdzielenie ról jest dla właściciela strony korzystne, ponieważ pozwala osobno zdecydować o trenowaniu modeli na swoich treściach, a osobno o obecności w wyszukiwaniu asystenta.
ClaudeBot zbiera treści z sieci, które mogą posłużyć do trenowania modeli. Według dokumentacji ograniczenie mu dostępu jest sygnałem, że przyszłe materiały z danej witryny mają zostać wyłączone ze zbiorów treningowych. Słowo „przyszłe” jest tu istotne: zapis mówi o tym, co zostanie pominięte od tej pory, a nie o treściach zebranych wcześniej.
Claude-SearchBot przegląda sieć po to, by poprawiać jakość wyników wyszukiwania dla użytkowników. Dokumentacja ostrzega, że jego zablokowanie uniemożliwia indeksowanie treści na potrzeby wyszukiwania, co może obniżyć widoczność strony i trafność informacji o niej w wynikach.
Claude-User działa na rzecz użytkownika: odwiedza strony wtedy, gdy ktoś zada asystentowi pytanie wymagające zajrzenia do sieci. Jego zablokowanie sprawia, że asystent nie pobierze treści w odpowiedzi na takie pytanie, co według dokumentacji również może ograniczyć widoczność witryny.
| Nazwa robota | Do czego służy | Skutek zablokowania według dokumentacji |
|---|---|---|
| ClaudeBot | Zbieranie treści, które mogą posłużyć do trenowania modeli | Przyszłe materiały z witryny mają być wyłączone ze zbiorów treningowych |
| Claude-SearchBot | Przeglądanie sieci w celu poprawy jakości wyników wyszukiwania | Brak indeksowania na potrzeby wyszukiwania, możliwa niższa widoczność i trafność |
| Claude-User | Pobieranie stron, gdy wymaga tego pytanie użytkownika | Brak pobrań w odpowiedzi na pytania, możliwa niższa widoczność |
Zasady, które wydawca deklaruje wobec właścicieli stron
Ta sama strona pomocy zawiera kilka deklaracji dotyczących zachowania robotów. Roboty mają się przedstawiać, czyli podawać swoją nazwę, i respektować zakazy zapisane w pliku robots.txt. Nie powinny obciążać serwera: wydawca deklaruje rozkładanie w czasie żądań kierowanych do jednej domeny i respektowanie dyrektywy Crawl-delay, czyli zapisu określającego odstęp między kolejnymi żądaniami. Nie próbują też obchodzić zabezpieczeń takich jak testy CAPTCHA. Podobny podział ról stosują inni wydawcy, co pokazuje wpis o tym, jak wyszukuje ChatGPT Search i z jakich robotów korzysta.
Jak świadomie ustawić dostęp w pliku robots.txt
Dostęp ustawia się osobno dla każdego z trzech robotów, wpisując jego nazwę w wierszu User-agent pliku robots.txt i dodając pod nią regułę zakazu lub zezwolenia. Plik musi leżeć w katalogu głównym witryny. Dokumentacja wydawcy podkreśla, że rezygnację trzeba powtórzyć dla każdej subdomeny z osobna, ponieważ każda subdomena ma własny plik. Sklep działający pod adresem głównym i blog pod osobną subdomeną to z punktu widzenia robotów dwa różne miejsca.
Przed zmianami warto odpowiedzieć sobie na dwa oddzielne pytania. Pierwsze: czy treści firmy mogą służyć do trenowania modeli. Drugie: czy firma chce być znajdowana i cytowana, gdy użytkownik asystenta szuka usługi lub produktu. To dwie różne decyzje i dokumentacja pozwala podjąć je niezależnie. Najczęstszy wybór firm usługowych i sklepów, które zabiegają o klientów, to pozostawienie dostępu robotowi wyszukiwania i robotowi działającemu na żądanie użytkownika, a decyzję o robocie uczącym podejmuje się zależnie od tego, jak cenne i unikalne są publikowane materiały.
User-agent: ClaudeBot
Disallow: /

User-agent: Claude-SearchBot
Allow: /

User-agent: Claude-User
Allow: /
Powyższy układ pasuje na przykład do wydawcy płatnych kursów z Poznania, który nie chce, aby jego lekcje zasilały zbiory treningowe, ale zależy mu na tym, by asystent mógł wskazać stronę kursu osobie szukającej szkolenia. Zakaz dla robota ClaudeBot ma dokładnie taką postać, jaką podaje dokumentacja wydawcy. Wiersze z zezwoleniem nie są konieczne, gdy plik nie zawiera innych zakazów, ale porządkują zapis i pokazują, że decyzja była świadoma.
User-agent: ClaudeBot
Crawl-delay: 1
Disallow: /koszyk/
Disallow: /moje-konto/

User-agent: Claude-SearchBot
Disallow: /koszyk/
Disallow: /moje-konto/

User-agent: Claude-User
Disallow: /koszyk/
Disallow: /moje-konto/
Drugi przykład odpowiada sytuacji sklepu internetowego, który chce być widoczny, lecz nie widzi sensu w odwiedzaniu przez roboty koszyka i panelu klienta. Zapis Crawl-delay z wartością 1 pochodzi z dokumentacji wydawcy, która nazywa tę dyrektywę niestandardowym rozszerzeniem pliku robots.txt i podaje go jako sposób na ograniczenie tempa pobierania bez całkowitego zakazu. To rozwiązanie dla serwisów, którym wizyty robota zauważalnie obciążają serwer.
Jak roboty czytają reguły
Sposób interpretowania pliku opisuje standard RFC 9309, czyli protokół wykluczania robotów. Robot szuka grupy reguł, w której wiersz User-agent pasuje do jego nazwy, przy czym wielkość liter w nazwie nie ma znaczenia. Dopiero gdy takiej grupy nie ma, stosuje reguły zapisane pod gwiazdką, czyli przeznaczone dla wszystkich. Wynika z tego pułapka: jeśli plik zawiera grupę dla Claude-SearchBot z jednym tylko wierszem, robot ten nie odziedziczy zakazów wpisanych pod gwiazdką. Wszystkie zakazy, które mają go obowiązywać, trzeba powtórzyć w jego grupie, tak jak w drugim przykładzie.
Przy sprzecznych regułach wygrywa ta, której ścieżka jest dłuższa, a ścieżki porównuje się z uwzględnieniem wielkości liter. Jeżeli żadna reguła nie pasuje do adresu, dostęp jest dozwolony. Zastrzegamy, że są to zasady standardu. Wydawca asystenta deklaruje respektowanie branżowych dyrektyw robots.txt, ale nie opisuje szczegółów interpretacji przez każdego z robotów.
Standard dopuszcza także przechowywanie pliku w pamięci robota, zwykle nie dłużej niż 24 godziny. Zmiana reguł nie musi więc zadziałać natychmiast. Ocena skutków po kilku minutach od zapisania pliku prowadzi do błędnych wniosków. Ustawieniem pliku w ramach większych porządków na stronie zajmujemy się w usłudze SEO techniczne.
Jeśli chcą Państwo zamówić pozycjonowanie AI, zachęcamy do kontaktu: tel. 222 500 844 lub mailowo: biuro@pozycjonowaniestron.pl
Jakie pomyłki zdarzają się przy blokowaniu robotów Claude
Najczęstsza pomyłka polega na zablokowaniu wszystkich trzech robotów w przekonaniu, że chodzi wyłącznie o trenowanie modeli. Właściciel strony chce chronić swoje teksty, kopiuje z sieci gotowy zestaw zakazów dla robotów AI i nieświadomie wyłącza także robota wyszukiwania oraz robota działającego na żądanie użytkownika. Skutkiem może być mniejsza widoczność w odpowiedziach asystenta, przed czym dokumentacja wydawcy wprost ostrzega.
Druga pomyłka to blokowanie adresów IP zamiast użycia pliku robots.txt. Wydawca odradza tę metodę. Wyjaśnia, że blokada adresów może nie działać poprawnie ani trwale, ponieważ uniemożliwia robotom odczytanie pliku robots.txt, a więc poznanie woli właściciela witryny. Podobny skutek mają reguły zapory lub usług ochronnych, które odcinają wszystkie automaty z góry. Gdy takie zabezpieczenie działa na serwerze, treść pliku robots.txt przestaje mieć znaczenie, bo robot i tak nie dociera do strony. Jeżeli firma zezwala robotom w pliku, a jednocześnie nie widzi ich wizyt w logach, przyczyny warto szukać właśnie w ustawieniach zapory.
Trzecia pomyłka to traktowanie pliku robots.txt jak zabezpieczenia. Standard stwierdza, że reguły nie są formą autoryzacji dostępu, a wymienione w pliku ścieżki są publicznie widoczne. Dokumentacja Google o pliku robots.txt dodaje, że plik nie może wymusić zachowania robota i że do ochrony prywatnych danych służą inne metody, na przykład hasło. Dokumenty dla klientów, cenniki hurtowe czy materiały szkoleniowe dla pracowników powinny być chronione logowaniem, a nie wierszem zakazu.
Czwarta pomyłka dotyczy oczekiwań. Zakaz dla robota uczącego odnosi się według dokumentacji do przyszłych materiałów. Nie jest narzędziem do usuwania z modelu wiedzy o firmie ani do poprawiania nieprawdziwych informacji. Jeśli asystent podaje błędne dane o Państwa firmie, potrzebne są inne działania, które opisujemy we wpisie o błędnych informacjach o firmie w AI. Kwestie prawne związane z uczeniem modeli na cudzych treściach omawiamy ogólnie we wpisie o prawie autorskim a treściach z AI, a w sprawach indywidualnych właściwym adresatem pytań jest prawnik.
Piąta pomyłka to mylenie pliku robots.txt z plikiem llms.txt. Dokumentacja robotów wydawcy mówi wyłącznie o pliku robots.txt i to on jest miejscem, w którym zapisuje się zgodę lub zakaz. Czym jest drugi z plików, wyjaśniamy we wpisie o pliku llms.txt.
Jak rozpoznać wizyty robotów Claude w logach serwera
Wizyty rozpoznaje się po nazwie robota w dzienniku dostępu serwera, czyli w pliku, w którym serwer zapisuje każde żądanie. Wiersz dziennika zawiera zwykle adres IP, datę i godzinę, żądany adres, kod odpowiedzi oraz identyfikator klienta, nazywany z angielska user agent. W tym ostatnim polu roboty podają swoje nazwy: ClaudeBot, Claude-SearchBot albo Claude-User. Dzienniki udostępnia zazwyczaj panel hostingu w części poświęconej logom lub statystykom. Dokumentacja wydawcy nie podaje pełnego brzmienia identyfikatorów, dlatego najlepiej szukać samych nazw, bez rozróżniania wielkości liter.
# wszystkie wiersze z wizytami trzech robotów
grep -i -E "claudebot|claude-searchbot|claude-user" access.log

# liczba wizyt wybranego robota
grep -i -c "claude-user" access.log

# czy robot pobiera plik robots.txt i z jakim skutkiem
grep -i "claudebot" access.log | grep "robots.txt"
Co oznaczają poszczególne wizyty
Każda z trzech nazw mówi coś innego. Wiersze z nazwą ClaudeBot oznaczają zbieranie treści, które mogą posłużyć do trenowania. Wiersze z nazwą Claude-SearchBot świadczą o tym, że strona jest przeglądana na potrzeby wyszukiwania. Najciekawsze z punktu widzenia marketingu są wiersze z nazwą Claude-User, ponieważ za każdym z nich stoi pytanie zadane przez człowieka. Jeśli w dzienniku kancelarii z Krakowa robot ten regularnie pobiera podstronę o podziale majątku, a pomija podstronę o upadłości konsumenckiej, jest to wskazówka, które tematy trafiają do rozmów z asystentem. Dziennik nie pokazuje jednak treści pytania ani tego, czy strona została ostatecznie zacytowana.
Warto też patrzeć na kody odpowiedzi. Kod 200 oznacza, że robot otrzymał treść. Kody 403 lub 429 przy nazwach robotów sugerują, że coś po stronie serwera odmawia im dostępu, choć plik robots.txt na to zezwala. Kody z grupy 500 przy żądaniu samego pliku robots.txt są groźne z powodu opisanej wcześniej zasady standardu.
Jak sprawdzić, czy wizyta naprawdę pochodzi od wydawcy
Nazwę w polu identyfikatora może wpisać dowolny program, dlatego sama nazwa nie jest dowodem. Wydawca udostępnia listę adresów IP swoich robotów i wyjaśnia, że jeśli adres źródłowy wizyty znajduje się na tej liście, wizyta pochodzi od niego. Plik zawiera znacznik czasu utworzenia oraz spis zakresów adresów w polach o nazwie ipv4Prefix. Przy każdej weryfikacji warto pobrać go na nowo, a wizyty spoza listy traktować jako niepotwierdzone, nawet jeśli nazwa się zgadza. Szersze podejście do pomiaru, obejmujące także wejścia ludzi z przypisów, opisujemy we wpisie o tym, jak mierzyć widoczność marki w odpowiedziach AI.
Co zrobić po kolei, aby strona była dostępna dla wyszukiwania Claude
Kolejność działań jest prosta: najpierw decyzja o trenowaniu i o obecności w wyszukiwaniu, potem plik robots.txt z grupami reguł dla trzech robotów, następnie sprawdzenie zabezpieczeń serwera, a na końcu praca nad samą treścią. Najlepiej napisana podstrona nie zostanie przywołana, jeśli robot dostaje odmowę już na poziomie zapory. W serwisach opartych na systemie WordPress plik bywa tworzony przez wtyczkę, więc zmiany należy wprowadzać tam, gdzie plik faktycznie powstaje, a potem otworzyć jego adres w przeglądarce i przeczytać wynik.
Skoro narzędzie pobierania stron opisane w dokumentacji nie obsługuje witryn budowanych w przeglądarce przez skrypty, kluczowe informacje powinny znajdować się w kodzie HTML wysyłanym przez serwer. Można to ocenić, wyłączając obsługę skryptów w przeglądarce i otwierając stronę ponownie. Jeśli znikają cennik, opisy usług albo dane kontaktowe, automat prawdopodobnie też ich nie zobaczy. Hydraulik z Łodzi, którego godziny pracy i obszar dojazdu są zapisane zwykłym tekstem na stronie, daje asystentowi gotowy materiał do przywołania. Ten sam hydraulik z godzinami umieszczonymi wyłącznie na grafice takiego materiału nie daje.
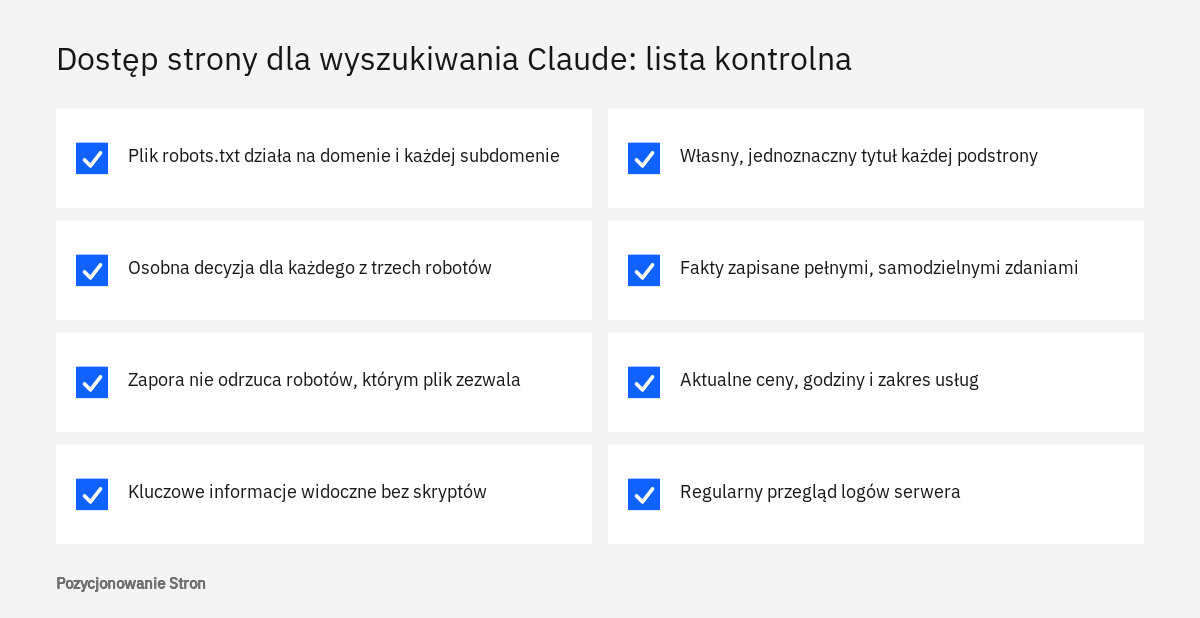
- Plik robots.txt otwiera się poprawnie pod adresem głównym i na każdej subdomenie.
- Dla każdego z trzech robotów zapisano świadomą decyzję, a zakazy z grupy ogólnej powtórzono tam, gdzie mają obowiązywać.
- Zapora i usługi ochronne nie odrzucają robotów, którym plik zezwala na dostęp.
- Najważniejsze informacje są widoczne w kodzie strony bez uruchamiania skryptów.
- Każda podstrona ma własny, jednoznaczny tytuł, a kluczowe fakty zapisano pełnymi zdaniami.
- Ceny, godziny i zakres usług są aktualne.
- Dziennik serwera jest przeglądany pod kątem trzech nazw robotów i kodów odpowiedzi.
Kiedy potrzebna jest pomoc specjalisty
Wsparcie przydaje się wtedy, gdy wyniki z dziennika nie zgadzają się z ustawieniami pliku, gdy serwis składa się z wielu subdomen albo gdy treść powstaje głównie w przeglądarce. Takie sprawy porządkujemy zwykle w ramach audytu SEO. Sam dostęp to jednak dopiero warunek wstępny. O tym, czy asystent ma po co sięgać po stronę, decydują jej treść i obecność marki w innych miejscach sieci, czym zajmuje się pozycjonowanie AI. Żaden z tych kroków nie daje pewności cytowania, ponieważ o doborze źródeł każdorazowo decyduje model.
Jeśli chcą Państwo zamówić pozycjonowanie AI, zachęcamy do kontaktu: tel. 222 500 844 lub mailowo: biuro@pozycjonowaniestron.pl
Najczęstsze pytania
Czy Claude przeszukuje internet przy każdym pytaniu?
Nie. Według dokumentacji model sam ocenia, czy pytanie wymaga informacji bieżących lub wykraczających poza jego dane treningowe. W aplikacji wyszukiwanie musi być dodatkowo włączone przez użytkownika.
Czy zablokowanie robota ClaudeBot usunie stronę z odpowiedzi asystenta?
Dokumentacja wiąże tego robota z trenowaniem modeli, a nie z wyszukiwaniem. Jego zablokowanie jest sygnałem, że przyszłe materiały z witryny mają być wyłączone ze zbiorów treningowych. Wyszukiwaniem i pobraniami na żądanie zajmują się dwa inne roboty.
Którego robota nie blokować, jeśli firmie zależy na cytowaniach?
Dokumentacja ostrzega, że zablokowanie robotów Claude-SearchBot i Claude-User może ograniczyć widoczność strony w wyszukiwaniu asystenta. Samo zezwolenie nie daje jednak pewności, że strona zostanie zacytowana.
Czy można spowolnić robota zamiast go blokować?
Tak. Wydawca deklaruje obsługę dyrektywy Crawl-delay w pliku robots.txt i podaje przykład z wartością 1 dla robota ClaudeBot. To rozwiązanie dla serwisów, którym wizyty robota obciążają serwer.
Jak odróżnić prawdziwego robota od programu, który się pod niego podszywa?
Należy porównać adres IP wizyty z listą publikowaną przez wydawcę. Sama nazwa w polu identyfikatora klienta nie wystarcza, bo może ją podać każdy program.
Dlaczego w logach nie ma wizyt, choć plik robots.txt na nie zezwala?
Możliwe, że zapora lub usługa ochronna odrzuca automaty, plik robots.txt zwraca błąd serwera albo nikt jeszcze nie zadał pytania wymagającego sięgnięcia po Państwa stronę. Warto zacząć od kodów odpowiedzi w dzienniku i ustawień zapory.
Źródła
- Does Anthropic crawl data from the web, and how can site owners block the crawler?, Anthropic, centrum pomocy Claude
- Enabling and Using Web Search, Anthropic, centrum pomocy Claude
- Web search tool - Claude Platform Docs, Anthropic
- Web fetch tool - Claude Platform Docs, Anthropic
- Lista adresów IP robotów (plik bots.json), Anthropic
- RFC 9309: Robots Exclusion Protocol, RFC Editor
- Plik robots.txt - wprowadzenie i przewodnik, Centrum wyszukiwarki Google
Funkcje wyszukiwarek i asystentów AI zmieniają się szybko, dlatego wpis aktualizujemy po większych zmianach.