Asystenci AI cytują strony internetowe, ponieważ przed napisaniem odpowiedzi coraz częściej najpierw wyszukują dokumenty, a dopiero potem układają z nich tekst i wskazują, skąd pochodzi dana informacja. Ten sposób pracy nosi nazwy RAG i grounding. Zrozumienie go pozwala ocenić, dlaczego jedna firma pojawia się w przypisach, a inna nie, oraz co warto zmienić w treści własnej strony.
Czym są RAG i grounding
RAG i grounding to dwie nazwy tego samego pomysłu: model językowy nie odpowiada wyłącznie z pamięci, lecz dostaje do ręki wyszukane dokumenty i na nich opiera odpowiedź. Skrót RAG pochodzi od angielskiego określenia retrieval-augmented generation, czyli generowania wspomaganego wyszukiwaniem. Słowo grounding oznacza ugruntowanie, a więc powiązanie każdego twierdzenia z konkretnym źródłem.
Sposób działania systemu AI, w którym tradycyjne wyszukiwanie informacji, na przykład w wyszukiwarce lub bazie danych, łączy się z modelem językowym piszącym odpowiedź na podstawie znalezionych materiałów.
Oparcie odpowiedzi modelu na dokumentach dostarczonych w chwili zadania pytania, zwykle razem z odnośnikami pokazującymi, z której strony pochodzi dane zdanie.
Taką definicję podaje między innymi opis RAG w serwisie Google Cloud: jest to rozwiązanie łączące systemy wyszukiwania informacji z dużymi modelami językowymi, a jego efektem ma być odpowiedź dokładniejsza, bardziej aktualna i lepiej dopasowana do pytania. Dla właściciela firmy ważniejsze od samej nazwy jest to, że w tym układzie strona internetowa przestaje być wyłącznie miejscem, do którego trafia klient. Staje się także materiałem, z którego asystent składa odpowiedź w ChatGPT, Gemini, Copilocie, Perplexity, Claude oraz w funkcjach AI wyszukiwarki Google.
Dlaczego sama wiedza modelu nie wystarcza
Sama wiedza modelu nie wystarcza, ponieważ pochodzi z danych, na których model był uczony, a te dane kończą się w pewnym momencie i mogą zawierać błędy. Google Cloud opisuje to wprost: modele ograniczone do danych z treningu udzielają odpowiedzi nieaktualnych i potencjalnie niedokładnych, a podanie im faktów razem z pytaniem ogranicza zjawisko nazywane halucynacjami, czyli zmyślanie brzmiące wiarygodnie.
Warto to przełożyć na zwykłą sytuację. Kancelaria z Krakowa zmieniła adres i zakres usług. Model, który uczył się na starszych tekstach, może nadal podawać poprzednią ulicę albo w ogóle nie wiedzieć o istnieniu kancelarii. Jeśli jednak asystent przed odpowiedzią wyszuka aktualną stronę kontaktową, poda nowy adres i dołączy odnośnik. Różnica nie wynika z tego, że model stał się mądrzejszy, tylko z tego, że dostał świeży dokument.
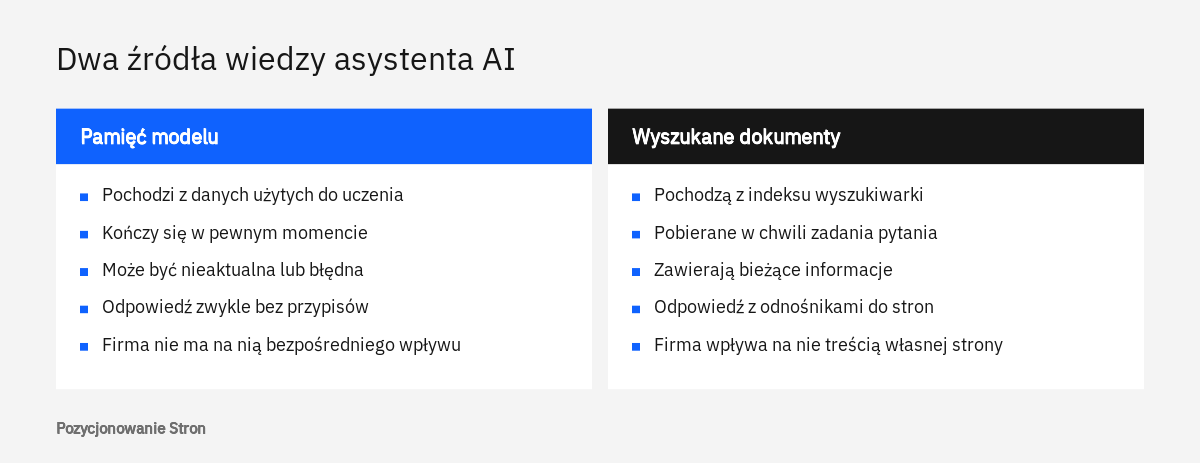
Dokumentacja Gemini, w części poświęconej oparciu odpowiedzi na wyszukiwarce Google, wymienia trzy korzyści tego mechanizmu: większą zgodność z faktami, dostęp do bieżących informacji oraz przypisy, dzięki którym użytkownik widzi, na czym opiera się dane twierdzenie. Trzeci punkt jest dla firm najciekawszy. Przypis to jedyne miejsce w odpowiedzi AI, w którym widać adres strony i z którego czytelnik może przejść dalej.
Nie każda odpowiedź powstaje jednak z wyszukiwaniem. Ta sama dokumentacja opisuje, że model najpierw analizuje pytanie i ocenia, czy wyszukiwanie poprawi odpowiedź. Na prośbę o przeredagowanie zdania albo o wyjaśnienie ogólnego pojęcia asystent może odpowiedzieć bez sięgania do sieci, a wtedy przypisów po prostu nie ma. Stąd bierze się częsta obserwacja właścicieli firm, że to samo narzędzie raz podaje źródła, a raz nie. O tym, co dzieje się z informacjami o firmie zapisanymi w pamięci modelu, piszemy osobno w tekście o błędnych informacjach o firmie w AI.
Jak powstaje odpowiedź z przypisami
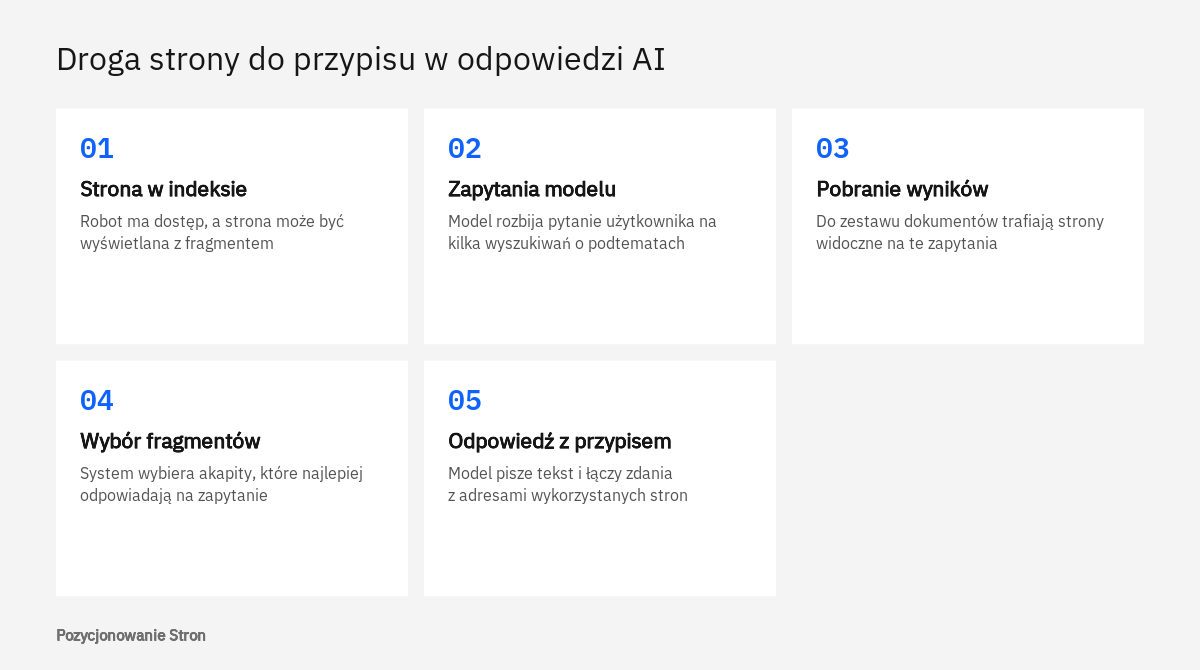
Odpowiedź z przypisami powstaje w kilku następujących po sobie etapach: model zamienia pytanie na zapytania do wyszukiwarki, pobiera wyniki, wybiera z nich najtrafniejsze fragmenty, pisze tekst i dołącza do poszczególnych zdań odnośniki. Dokumentacja Gemini opisuje tę kolejność w pięciu punktach, od wysłania pytania po zwrócenie odpowiedzi z przypisami umieszczonymi w tekście.
Etap pobrania: od pytania do listy stron
Na początku model układa własne zapytania. Według dokumentacji Gemini może ich być jedno albo kilka, a użytkownik zwykle ich nie widzi. Google w opisie Przeglądów od AI i trybu AI nazywa tę technikę rozgałęzieniem zapytania: system wysyła wiele powiązanych wyszukiwań dotyczących podtematów i różnych źródeł danych. Pytanie o to, jak wybrać pompę ciepła do starego domu, może więc zostać rozbite na osobne wyszukiwania o mocy urządzenia, o ociepleniu budynku i o kosztach eksploatacji.
Ma to ważny skutek. Strona nie musi odpowiadać na całe pytanie użytkownika, żeby trafić do zestawu dokumentów. Wystarczy, że dobrze odpowiada na jedno z zapytań cząstkowych. Instalator z Bydgoszczy, który ma rzeczowy tekst wyłącznie o doborze mocy pompy, może zostać źródłem dla tej jednej części odpowiedzi.
Wybór fragmentów: nie cała strona, tylko jej części
Pobrane dokumenty rzadko trafiają do modelu w całości. Google Cloud opisuje typowe elementy tego etapu: dokumenty są zapisywane w postaci liczbowej pozwalającej porównywać znaczenie tekstów, a nie tylko słowa, wyszukiwanie łączy dopasowanie znaczeniowe z dopasowaniem słów kluczowych, a osobny mechanizm porządkujący ustawia wyniki tak, żeby najtrafniejsze znalazły się najwyżej. Wśród czynników wpływających na jakość całego systemu wymienia się też sposób dzielenia dokumentów na części.
Dla autora strony oznacza to, że o wyborze decyduje pojedynczy akapit lub krótki blok, a nie ogólne wrażenie z całej podstrony. Fragment musi sam w sobie odpowiadać na zapytanie. Akapit zaczynający się od słów „jak wspomniano wyżej” traci sens po wyjęciu z kontekstu i przegrywa z akapitem, w którym od razu wiadomo, o jakiej usłudze, w jakim mieście i w jakiej sytuacji mowa.
Pisanie odpowiedzi
Wybrane fragmenty są dołączane do pytania i dopiero wtedy model pisze odpowiedź. Google Cloud podkreśla, że kluczowe jest podanie modelowi najtrafniejszych faktów oraz takie jego ustawienie, żeby odpowiedź opierała się na tych faktach. Model łączy informacje z kilku stron w jeden tekst, zwykle własnymi słowami, dlatego w odpowiedzi rzadko pojawia się dosłowny cytat, a często sens strony wraz z odnośnikiem.
Przypisy: powiązanie zdania ze źródłem
Ostatni etap to przypisy. W interfejsie Gemini dla programistów odpowiedź zawiera oznaczenia wskazujące adres i tytuł strony oraz miejsce w tekście, którego dane źródło dotyczy. W dokumentacji funkcji cytowań w modelach Claude opisano to jeszcze dokładniej: dostarczony tekst jest dzielony na zdania, model może wskazać jedno zdanie albo kilka kolejnych, a system wyciąga cytowany fragment bezpośrednio z dokumentu, dzięki czemu odnośnik zawsze prowadzi do miejsca, które rzeczywiście istnieje w dostarczonym materiale.
Wynika z tego prosty wniosek: przypis może wskazać tylko dokument, który został pobrany. Znajomość marki zapisana w pamięci modelu może sprawić, że nazwa firmy pojawi się w treści odpowiedzi, natomiast odnośnik wymaga obecności strony w wynikach wyszukiwania.
Skąd asystent bierze dokumenty
Asystent bierze dokumenty z indeksu wyszukiwarki, czyli z tego samego rodzaju zbioru stron, z którego powstają zwykłe wyniki wyszukiwania. Nie przegląda całego internetu w chwili zadania pytania, tylko korzysta z gotowego spisu stron wcześniej odwiedzonych przez roboty.
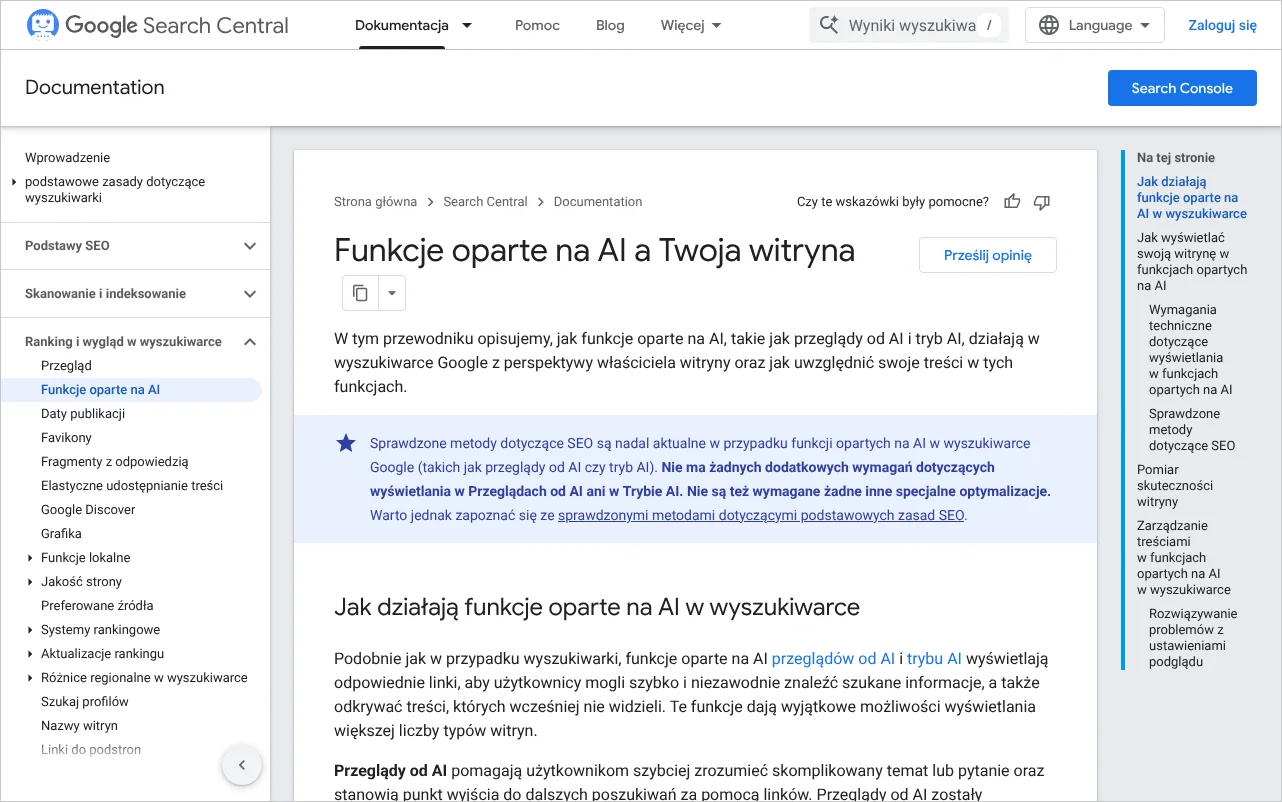
W przypadku Google sprawa jest opisana jednoznacznie. Dokumentacja funkcji opartych na AI w Centrum wyszukiwarki Google podaje, że aby strona mogła zostać linkiem pomocniczym w Przeglądach od AI lub w trybie AI, musi być zindeksowana i kwalifikować się do wyświetlania w wyszukiwarce z fragmentem. Google zaznacza, że nie ma żadnych dodatkowych wymagań technicznych, a jednocześnie że indeksowanie i wyświetlanie nie są gwarantowane.
ChatGPT korzysta z własnych robotów. Dokumentacja jego twórców, czyli przegląd robotów OpenAI, rozróżnia kilka z nich. OAI-SearchBot służy do wyszukiwania i odpowiada za pokazywanie stron w wynikach wyszukiwania ChatGPT. GPTBot zbiera treści, które mogą posłużyć do uczenia modeli. ChatGPT-User odwiedza stronę wtedy, gdy wynika to z działania konkretnego użytkownika. Każdym z tych robotów steruje się osobno w pliku robots.txt, a strona zablokowana dla OAI-SearchBot nie pojawi się w odpowiedziach wyszukiwania ChatGPT, choć może nadal występować jako link nawigacyjny. Szerzej opisujemy to w tekście o tym, jak wyszukuje ChatGPT Search.
| Rozwiązanie | Skąd pochodzą dokumenty | Co wynika z dokumentacji |
|---|---|---|
| Przeglądy od AI i tryb AI w Google | Indeks wyszukiwarki Google | Strona musi być zindeksowana i kwalifikować się do wyświetlania z fragmentem |
| Gemini z włączonym wyszukiwaniem | Wyszukiwarka Google | Model sam ocenia, czy wyszukiwanie jest potrzebne, i sam układa jedno lub kilka zapytań |
| Wyszukiwanie w ChatGPT | Strony odwiedzane przez robota OAI-SearchBot | Blokada tego robota w robots.txt wyłącza stronę z odpowiedzi wyszukiwania |
| Cytowania w modelach Claude | Dokumenty przekazane modelowi razem z pytaniem | Tekst jest dzielony na zdania, a przypis wskazuje dokładny fragment dostarczonego materiału |
Zasad działania Copilota i Perplexity nie potwierdzaliśmy w ich dokumentacji na potrzeby tego tekstu, dlatego nie opisujemy ich szczegółowo. Porównanie poszczególnych narzędzi zawiera nasz tekst o wyszukiwarkach AI.
Dlaczego widoczność w wyszukiwarce jest warunkiem cytowania
Widoczność w wyszukiwarce jest warunkiem cytowania, ponieważ etap pobrania to zwykłe wyszukiwanie, a model pisze i cytuje wyłącznie z tego, co to wyszukiwanie zwróciło. Strona, której nie ma w indeksie albo która nie pojawia się w wynikach na zapytania związane z ofertą firmy, nie trafia do zestawu dokumentów i nie ma jak znaleźć się w przypisach.
To rozumowanie potwierdza sama dokumentacja Google. Skoro warunkiem otrzymania linku w funkcjach AI jest zindeksowanie strony i możliwość pokazania jej z fragmentem, a dodatkowych wymagań nie ma, to podstawą pozostaje ta sama praca, którą wykonuje się przy zwykłym pozycjonowaniu. Google wymienia w tym miejscu znane zalecenia: dostęp dla robotów, linki wewnętrzne ułatwiające dotarcie do podstron, treści dostępne w formie tekstu, dane strukturalne zgodne z widocznym tekstem oraz aktualne informacje w Merchant Center i w Profilu Firmy.
Widoczność nie oznacza przy tym wyłącznie pierwszego miejsca na najważniejszą frazę. Ponieważ pytanie jest rozbijane na wiele zapytań cząstkowych, liczą się także wąskie, szczegółowe tematy. Google opisuje, że dzięki rozgałęzieniu zapytania funkcje AI pokazują szerszy i bardziej zróżnicowany zestaw linków. Sklep z Poznania sprzedający ekspresy do kawy może nie być widoczny na ogólną frazę o ekspresach, a mimo to zostać źródłem dla części odpowiedzi dotyczącej odkamieniania konkretnego typu urządzenia, jeśli ma o tym dobrą, zindeksowaną podstronę. Dlatego w pracy nad obecnością w AI duże znaczenie ma pozycjonowanie na długi ogon, czyli na rozbudowane, precyzyjne zapytania.
Obecność w indeksie jest przy tym warunkiem koniecznym, ale nie wystarczającym. O tym, które z pobranych stron trafią do odpowiedzi, decyduje etap wyboru fragmentów, a jego szczegółów dostawcy nie ujawniają. Nikt rzetelny nie obieca więc miejsca w przypisach, podobnie jak nie obiecuje się konkretnej pozycji w wynikach wyszukiwania.
Jeśli chcą Państwo zamówić pozycjonowanie AI, zachęcamy do kontaktu: tel. 222 500 844 lub mailowo: biuro@pozycjonowaniestron.pl
Jak budować treść, którą da się zacytować
Treść nadająca się do zacytowania składa się z fragmentów, które samodzielnie i konkretnie odpowiadają na jedno pytanie. Skoro system wybiera części strony, a model wskazuje w przypisie pojedyncze zdania lub krótkie bloki, to każdy ważny akapit powinien być zrozumiały bez czytania reszty tekstu. Poniższe zalecenia to wnioski z opisanego mechanizmu i z naszej praktyki, a nie lista oficjalnych czynników podanych przez dostawców.
Odpowiedź na początku sekcji
Najprościej zacząć od kolejności. Nagłówek powinien nazywać pytanie lub temat, a pierwsze zdanie pod nim od razu dawać odpowiedź. Rozwinięcie, wyjątki i przykłady mogą nastąpić później. Hydraulik z Łodzi, który na stronie usługi pisze najpierw trzy akapity o historii firmy, a dopiero na końcu wspomina, że przyjeżdża do awarii także w nocy, utrudnia systemowi znalezienie zdania pasującego do zapytania o nocne pogotowie hydrauliczne. To samo zdanie umieszczone pod nagłówkiem o godzinach pracy jest łatwe do wybrania.
Konkret zamiast ogólników
Model potrzebuje faktów, które można przytoczyć: zakresu usługi, obszaru działania, czasu realizacji, warunków gwarancji, parametrów produktu, kolejności czynności. Zdanie o indywidualnym podejściu i najwyższej jakości nie odpowiada na żadne pytanie, więc nie ma powodu, żeby je cytować. Zdanie informujące, że montaż trwa zwykle jeden dzień roboczy i obejmuje próbę szczelności, może zostać wykorzystane wprost.
Wytyczne Google dotyczące tworzenia przydatnych i rzetelnych treści zachęcają do zadania sobie kilku pytań: czy materiał zawiera własne dane, badania lub analizy, czy omawia temat wyczerpująco, czy wnosi coś, czego nie ma wszędzie indziej, oraz czy wiadomo, kto go stworzył i jaką ma wiedzę. Są to zalecenia pisane z myślą o wyszukiwarce, ale dobrze opisują także tekst, po który chętnie sięgnie asystent.
Akapity zrozumiałe bez kontekstu
Warto przeczytać każdy ważny akapit tak, jakby był jedynym tekstem na stronie. Jeśli nie wiadomo, o jakiej usłudze mowa, kto jest podmiotem zdania albo do czego odnosi się słowo „to”, akapit wymaga poprawki. Pomaga powtarzanie nazwy usługi lub produktu zamiast zaimków oraz podawanie miejscowości i jednostek przy liczbach. Tabele z opisanymi nagłówkami kolumn i listy czynności w ustalonej kolejności również dobrze znoszą wyjęcie z kontekstu, o ile każda pozycja jest pełną informacją.
Tekst widoczny, aktualny i spójny
Google zaleca, żeby ważne informacje były dostępne w formie tekstu oraz żeby dane strukturalne zgadzały się z tym, co widać na stronie. Cennik zapisany wyłącznie na grafice albo godziny pracy podane tylko na zdjęciu szyldu są dla systemu wyszukującego trudne do wykorzystania. Równie ważna jest zgodność informacji między miejscami: strona, Profil Firmy i inne publiczne wizytówki powinny podawać te same dane. Gdy model dostaje dwa dokumenty z różnymi adresami tej samej firmy, nie ma podstaw, żeby wybrać właściwy.
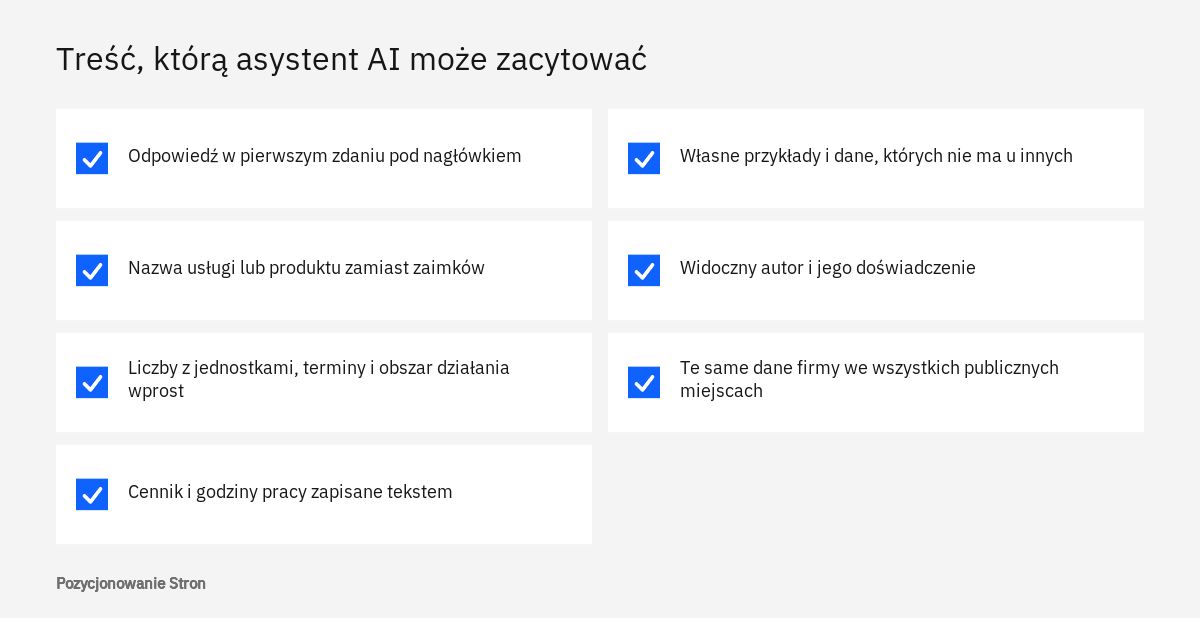
- Pierwsze zdanie pod każdym nagłówkiem odpowiada na pytanie zawarte w nagłówku.
- Akapity zawierają nazwę usługi lub produktu, a nie same zaimki.
- Liczby mają jednostki, a terminy i obszar działania są podane wprost.
- Cennik, godziny pracy i dane kontaktowe występują jako tekst, nie tylko jako obraz.
- Treść zawiera własne doświadczenia, przykłady lub dane, których nie ma u innych.
- Na stronie widać, kto odpowiada za treść i jaką ma wiedzę.
- Dane firmy są takie same na stronie, w Profilu Firmy i w innych publicznych miejscach.
Jak sprawdzić, czy strona może być źródłem
Sprawdzenie, czy strona może być źródłem, sprowadza się do trzech pytań: czy roboty mają do niej dostęp, czy jest w indeksie wyszukiwarki i czy pojawia się w wynikach na zapytania związane z ofertą. Na wszystkie można odpowiedzieć w narzędziach dostępnych bez opłat.
- Dostęp dla robotów
Plik robots.txt znajduje się pod adresem domeny z dopiskiem /robots.txt. Warto przejrzeć go pod kątem reguł blokujących Googlebota, OAI-SearchBot oraz wpisów obejmujących wszystkie roboty. Google zwraca uwagę, że blokada może też leżeć po stronie hostingu lub sieci dostarczania treści.
- Obecność w indeksie Google
W Search Console na pasku u góry ekranu znajduje się pole narzędzia do sprawdzania adresów URL. Po wpisaniu adresu podstrony narzędzie informuje, czy adres znajduje się w Google, a w części o indeksowaniu pokazuje, czy skanowanie jest dozwolone, czy strona została pobrana i czy indeksowanie jest dozwolone.
- Widoczność na zapytania
Raport Skuteczność w menu Search Console, przy typie wyszukiwania Sieć, pokazuje zapytania, na które strona się wyświetla. Google podaje, że ruch z Przeglądów od AI i z trybu AI jest wliczany właśnie do tego raportu, do ogólnego ruchu z sieci wyszukiwania.
Przykładowy plik robots.txt, który dopuszcza robota wyszukiwania ChatGPT, a jednocześnie nie zgadza się na zbieranie treści do uczenia modeli, wygląda następująco. Dokumentacja twórców ChatGPT potwierdza, że oba ustawienia są od siebie niezależne, a na uwzględnienie zmiany w wyszukiwaniu systemy mogą potrzebować około 24 godzin.
User-agent: OAI-SearchBot
Allow: /

User-agent: GPTBot
Disallow: /

User-agent: Googlebot
Allow: /
Jeśli podstrona nie jest zindeksowana albo robot nie ma do niej dostępu, przyczyna leży zwykle po stronie technicznej: w znacznikach, przekierowaniach, konfiguracji serwera lub w sposobie wczytywania treści. Tym zajmuje się SEO techniczne. Jak łączyć dane z Search Console i Analytics z własnym zestawem pytań kontrolnych, opisujemy w tekście o tym, jak mierzyć widoczność marki w odpowiedziach AI.
Jak ograniczyć wykorzystanie treści przez AI
Wykorzystanie treści w odpowiedziach AI można ograniczyć tymi samymi regułami, które sterują fragmentami w zwykłych wynikach wyszukiwania. Według specyfikacji tagu meta robots reguła nosnippet zapobiega wykorzystywaniu treści jako bezpośredniego źródła danych wejściowych do Przeglądów od AI i trybu AI, reguła max-snippet ogranicza długość wykorzystywanego fragmentu do podanej liczby znaków, a atrybut data-nosnippet wyłącza wskazaną część strony.
Jest to ważne z dwóch powodów. Po pierwsze, część firm świadomie nie chce, żeby określone informacje, na przykład szczegółowe warunki oferty, były streszczane poza stroną. Po drugie, i ten przypadek spotykamy częściej, takie reguły bywają ustawione przypadkiem: przez wtyczkę, szablon albo dawną decyzję, o której nikt już nie pamięta. Strona jest wtedy w indeksie, ale nie kwalifikuje się do wyświetlania z fragmentem, a więc nie spełnia warunku podanego przez Google dla linków w funkcjach AI.
<meta name="robots" content="nosnippet">

<meta name="robots" content="max-snippet:20">

<p>Ten tekst może trafić do fragmentu,
<span data-nosnippet>a ta część nie</span>.</p>
Dokumentacja Google wspomina też o osobnym ustawieniu Google-Extended, które dotyczy uczenia modeli i groundingu w niektórych innych systemach Google, a nie samej wyszukiwarki. Dla ChatGPT odpowiednikiem jest opisane wcześniej rozróżnienie robotów w pliku robots.txt. Warto pamiętać o zastrzeżeniu ze specyfikacji: robot musi mieć dostęp do strony, żeby odczytać reguły zapisane w jej kodzie. Blokada w robots.txt sprawia, że znacznik w ogóle nie zostanie przeczytany. Po zmianie ustawień efekt nie jest natychmiastowy, bo według Google ponowne indeksowanie może potrwać od kilku dni do kilku miesięcy. Wszystkie reguły tego rodzaju omawiamy w tekście o znaczniku meta robots.
Typowe pomyłki i kiedy potrzebna jest pomoc
Najczęstsza pomyłka polega na traktowaniu obecności w AI jako osobnej dziedziny, oderwanej od wyszukiwarki, i szukaniu specjalnych sztuczek zamiast uporządkowania podstaw. Z opisanego mechanizmu wynika coś odwrotnego: asystent cytuje to, co znalazła wyszukiwarka, a więc najpierw strona musi dać się znaleźć.
Druga pomyłka to mylenie pamięci modelu z wyszukiwaniem. Właściciel pyta asystenta o swoją firmę, dostaje odpowiedź bez przypisów i wyciąga wniosek, że strona jest niewidoczna dla AI. Tymczasem asystent mógł w ogóle nie uruchomić wyszukiwania. Wiarygodniejszy obraz dają pytania, przy których narzędzie sięga do sieci, zadawane wielokrotnie i w różnych sformułowaniach.
Trzecia pomyłka to blokowanie robotów bez rozróżnienia ich ról, o czym była mowa wcześniej. Czwarta to pisanie tekstów wyłącznie pod maszyny: krótkich, sztucznie pociętych odpowiedzi bez treści dla człowieka, albo wdrażanie rozwiązań przedstawianych jako konieczne dla AI. Google w dokumentacji funkcji AI podaje wprost, że nie trzeba tworzyć nowych plików przeznaczonych dla maszyn ani dodawać specjalnych znaczników schema.org, a zalecenia dotyczące jakości pozostają te same co dla zwykłego wyszukiwania. Szerzej piszemy o tym w tekstach o pliku llms.txt oraz o danych strukturalnych a odpowiedziach AI. Piąta pomyłka to oczekiwanie stałego wyniku. Te same pytania dają różne odpowiedzi i różne zestawy źródeł, także dlatego, że Przeglądy od AI i tryb AI mogą korzystać z różnych modeli i technik, co Google samo zaznacza.
Pomoc z zewnątrz przydaje się w kilku sytuacjach: gdy ważne podstrony nie trafiają do indeksu mimo poprawnej treści, gdy serwis jest duży i trudno ustalić, które reguły blokują roboty lub fragmenty, gdy strona jest widoczna, a asystenci konsekwentnie cytują inne źródła, oraz gdy w odpowiedziach pojawiają się nieprawdziwe informacje o firmie. W ramach usługi pozycjonowanie AI zaczynamy od sprawdzenia dostępu i indeksowania, a następnie pracujemy nad budową treści na stronach usług i w tekstach odpowiadających na pytania klientów.
Jeśli chcą Państwo zamówić pozycjonowanie AI, zachęcamy do kontaktu: tel. 222 500 844 lub mailowo: biuro@pozycjonowaniestron.pl
Najczęstsze pytania
Czy RAG i grounding to to samo?
W codziennym użyciu oba pojęcia opisują ten sam pomysł: model odpowiada na podstawie wyszukanych dokumentów, a nie wyłącznie z pamięci. RAG częściej oznacza całą budowę systemu z wyszukiwaniem i pisaniem odpowiedzi. Grounding podkreśla efekt, czyli powiązanie twierdzeń ze źródłami.
Dlaczego asystent raz podaje źródła, a raz nie?
Model sam ocenia, czy wyszukiwanie poprawi odpowiedź. Gdy uzna, że wystarczy wiedza z treningu, nie pobiera dokumentów i nie ma czego wskazać w przypisach.
Czy strona musi być na pierwszym miejscu w Google, żeby AI ją zacytowało?
Google nie podaje takiego wymogu. Warunkiem jest zindeksowanie strony i możliwość wyświetlenia jej z fragmentem. Ponieważ pytanie jest rozbijane na wiele zapytań cząstkowych, źródłem może zostać także strona dobrze odpowiadająca na wąski, szczegółowy temat.
Czy potrzebne są specjalne znaczniki lub pliki dla AI?
W przypadku funkcji AI w wyszukiwarce Google nie. Dokumentacja podaje, że nie trzeba tworzyć nowych plików dla maszyn ani dodawać specjalnych danych schema.org. Wystarczą te same podstawy co w zwykłym pozycjonowaniu: dostęp dla robotów, indeksowanie i przydatna treść.
Czy zablokowanie GPTBota usunie stronę z odpowiedzi ChatGPT?
Według dokumentacji twórców ChatGPT nie, ponieważ GPTBot dotyczy uczenia modeli, a za wyszukiwanie odpowiada OAI-SearchBot. Oba ustawienia w pliku robots.txt są niezależne. Z odpowiedzi wyszukiwania wyłącza stronę dopiero blokada robota OAI-SearchBot.
Ile trwa, zanim zmiany na stronie będą widoczne w odpowiedziach AI?
Zmieniona treść musi najpierw zostać ponownie odwiedzona przez robota i zindeksowana. Google podaje, że ponowne indeksowanie może potrwać od kilku dni do kilku miesięcy, a o przyspieszenie można poprosić w narzędziu do sprawdzania adresów URL.
Czy da się sprawdzić, ile wejść pochodzi z Przeglądów od AI?
Google wlicza ten ruch do raportu Skuteczność w Search Console, w typie wyszukiwania Sieć, razem z pozostałym ruchem z wyszukiwarki. Zachowanie odwiedzających, w tym konwersje i czas w witrynie, można dodatkowo oceniać w Google Analytics.
Źródła
- Funkcje oparte na AI a Twoja witryna, Centrum wyszukiwarki Google
- Grounding with Google Search, Google AI for Developers
- What is Retrieval-Augmented Generation (RAG)?, Google Cloud
- Overview of OpenAI Crawlers, OpenAI
- Citations, Claude Platform Docs
- Specyfikacje tagu meta Robots, data-nosnippet i X-Robots-Tag, Centrum wyszukiwarki Google
- Tworzenie treści przydatnych, rzetelnych i ukierunkowanych na użytkowników, Centrum wyszukiwarki Google
- Narzędzie do sprawdzania adresów URL, Search Console - pomoc
Funkcje wyszukiwarek i asystentów AI zmieniają się szybko, dlatego wpis aktualizujemy po większych zmianach.