Asystenci AI często nie widzą treści ładowanej skryptami, ponieważ ich roboty pobierają z serwera kod HTML i na tym poprzestają, podczas gdy przeglądarka klienta dopiero po uruchomieniu JavaScriptu składa z niego gotową stronę. Google potrafi taką stronę wyrenderować, ale sam zaznacza w dokumentacji, że nie wszystkie roboty wykonują JavaScript. Poniżej wyjaśniamy, jak sprawdzić, co zostaje z Państwa strony po wyłączeniu skryptów, które elementy znikają najczęściej i jak to trwale naprawić.
Co właściwie dostaje robot, gdy pobiera stronę
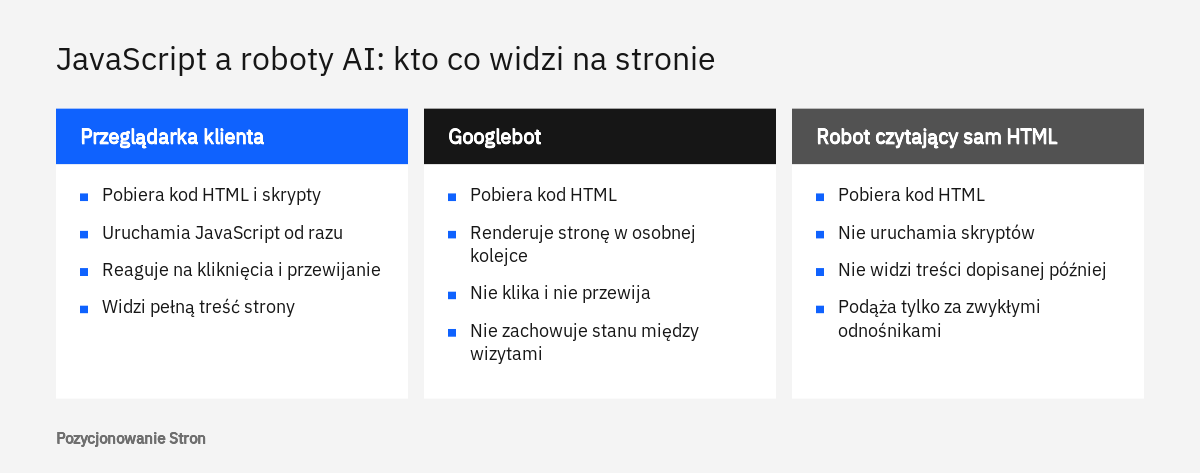
Robot dostaje od serwera dokładnie to samo, co przeglądarka w pierwszej chwili: plik z kodem HTML. Różnica polega na tym, co dzieje się później. Przeglądarka klienta pobiera dołączone skrypty, uruchamia je i na ich polecenie dopisuje do strony kolejne fragmenty: listę produktów, cennik, opinie, czasem całą treść. Robot, który skryptów nie uruchamia, zatrzymuje się na pierwszym etapie i ocenia stronę wyłącznie na podstawie tego, co było w kodzie od początku.
W wielu serwisach nie ma to większego znaczenia, ponieważ serwer od razu wysyła kompletny dokument z nagłówkami, akapitami i odnośnikami. Kłopot zaczyna się tam, gdzie stronę zbudowano jako aplikację uruchamianą w przeglądarce. Google opisuje ten układ jako model powłoki aplikacji: początkowy kod HTML nie zawiera rzeczywistych treści, a te pojawiają się dopiero po wykonaniu JavaScriptu. Człowiek widzi wtedy normalną, działającą stronę. Robot bez obsługi skryptów widzi pusty szkielet.
Zamiana kodu strony na gotowy obraz i treść, które widzi odwiedzający. Może odbywać się w przeglądarce klienta, na serwerze albo jeszcze wcześniej, w chwili budowania serwisu.
Dobrze oddaje to porównanie dwóch odpowiedzi serwera dla tej samej podstrony usługi. Weźmy hipotetyczną firmę hydrauliczną z Łodzi, która opisuje usuwanie awarii. W pierwszym wariancie serwer wysyła tylko pojemnik na treść i skrypt, w drugim od razu gotowy tekst.
<!-- Wariant A: treść dopisze dopiero skrypt -->
<body>
  <div id="app"></div>
  <script src="/static/app.4f9c21.js"></script>
</body>

<!-- Wariant B: treść jest w kodzie od początku -->
<body>
  <main>
    <h1>Usuwanie awarii hydraulicznych w Łodzi</h1>
    <p>Dojeżdżamy do mieszkań, domów i lokali usługowych...</p>
    <a href="/kontakt/">Kontakt</a>
  </main>
  <script src="/static/app.4f9c21.js"></script>
</body>
W wariancie A robot bez obsługi skryptów nie pozna ani nagłówka, ani opisu, ani odnośnika do kontaktu. W wariancie B dostaje wszystko, a skrypt jedynie ożywia stronę, na przykład obsługuje formularz czy rozwijane menu. Dla klienta oba warianty mogą wyglądać identycznie, dlatego problem tak długo pozostaje niezauważony.
Jak Google radzi sobie ze stronami opartymi na JavaScripcie
Google wykonuje JavaScript, ale robi to w osobnym etapie i nie zawsze od razu. W dokumencie JavaScript a SEO - podstawy wyszukiwarka dzieli przetwarzanie takich stron na trzy fazy: skanowanie, renderowanie i indeksowanie. Najpierw Googlebot pobiera adres i odczytuje kod HTML, następnie strona trafia do kolejki renderowania, a dopiero wyrenderowana wersja służy do zindeksowania treści.
Z tego opisu wynika kilka praktycznych wniosków. Strona może czekać w kolejce do renderowania kilka sekund albo dłużej, a samo renderowanie odbywa się wtedy, gdy pozwalają na to zasoby Google. Do renderowania kierowane są strony zwracające kod stanu 200, natomiast przy innych kodach ten etap może zostać pominięty. Wyszukiwarka nie renderuje też skryptów z plików i stron zablokowanych w pliku robots.txt, więc zakaz pobierania katalogu ze skryptami potrafi odebrać Googlebotowi całą treść.
Czego Googlebot nie zrobi mimo renderowania
Renderowanie w Google nie oznacza, że robot zachowuje się jak klient. W dokumencie Rozwiązywanie problemów z JavaScriptem związanych z wyszukiwarką czytamy, że Googlebot nie zatwierdza próśb o uprawnienia, nie zachowuje stanu między wczytaniami (dane pamięci lokalnej, sesji i pliki cookie są czyszczone), obsługuje wyłącznie zwykłe żądania HTTP i nie korzysta z niektórych funkcji przeglądarki. Treść uzależniona od zgody, od wcześniejszej wizyty albo od stałego połączenia z serwerem może więc pozostać niewidoczna nawet dla wyszukiwarki, która skrypty wykonuje.
Osobną sprawą jest treść doładowywana dopiero po działaniu użytkownika. Według dokumentu Naprawianie leniwie ładującej się zawartości witryny Googlebot nie wchodzi w interakcję ze stroną, czyli nie przewija jej i nie klika. Opinie pokazywane po kliknięciu zakładki albo kolejne produkty dociągane przy przewijaniu wymagają zatem rozwiązania, które nie polega na czynnościach odwiedzającego.
Najważniejsze zdanie pada jednak w innym miejscu tego samego zestawu dokumentów. Google stwierdza, że renderowanie po stronie serwera i wstępne renderowanie nadal są bardzo użyteczne, ponieważ przyspieszają witrynę dla użytkowników i robotów, a nie wszystkie roboty wykonują JavaScript. To właśnie tu zaczyna się temat asystentów AI.
Dlaczego roboty asystentów AI poprzestają na kodzie HTML
Roboty asystentów poprzestają na kodzie HTML, ponieważ wykonywanie skryptów jest kosztowne, a żaden z dostawców nie zobowiązuje się w dokumentacji, że to robi. Uruchomienie strony tak jak w przeglądarce wymaga pobrania wielu dodatkowych plików i mocy obliczeniowej. Nawet Bing, który ma własny silnik renderujący, przyznaje na swoim blogu dla webmasterów, że przetwarzanie JavaScriptu na dużą skalę, na każdej stronie każdej witryny, jest trudne, i że robot nie obsługuje wszystkich rozwiązań dostępnych w nowoczesnych przeglądarkach.
Sprawdziliśmy, co o swoich robotach piszą dostawcy asystentów. OpenAI w dokumencie Overview of OpenAI Crawlers opisuje OAI-SearchBot (wyszukiwanie w ChatGPT), GPTBot (zbieranie treści do trenowania modeli) i ChatGPT-User (pobranie strony na prośbę użytkownika). Anthropic w centrum pomocy wymienia ClaudeBot, Claude-User i Claude-SearchBot, a Perplexity opisuje PerplexityBot i Perplexity-User. W żadnym z tych trzech dokumentów nie ma zdania o renderowaniu stron ani o wykonywaniu JavaScriptu. Nie jest to dowód, że roboty nigdy tego nie robią, ale dla właściciela strony wniosek jest jednoznaczny: skoro nikt tego nie obiecuje, treść powinna być dostępna bez skryptów.
Asystenci korzystający z indeksu wyszukiwarki
Inaczej wygląda sytuacja funkcji AI, które czerpią z indeksu wyszukiwarki. Google w dokumencie o funkcjach opartych na AI podaje, że aby strona mogła pojawić się w Przeglądach od AI i w Trybie AI, musi być zindeksowana i kwalifikować się do wyświetlania w wyszukiwarce z fragmentem, a dodatkowych wymagań technicznych nie ma. Wśród sprawdzonych metod Google wymienia jednak upewnienie się, że ważne treści są dostępne w formie tekstowej. Skoro podstawą jest indeks Google, treść poprawnie wyrenderowana przez Googlebota ma szansę być wykorzystana także w tych funkcjach. Więcej o tym mechanizmie piszemy we wpisie o tym, dlaczego asystenci AI cytują strony internetowe.
W przypadku Copilota znaczenie ma widoczność w Bingu, a ten, jak wspomnieliśmy, sam wskazuje granice własnego renderowania. Pozostali asystenci korzystają z własnych robotów opisanych wyżej. Szczegóły ich pracy omawiamy osobno: jak wyszukuje ChatGPT Search oraz jak wyszukuje w sieci Claude.
Jak sprawdzić, co zostaje ze strony po wyłączeniu skryptów
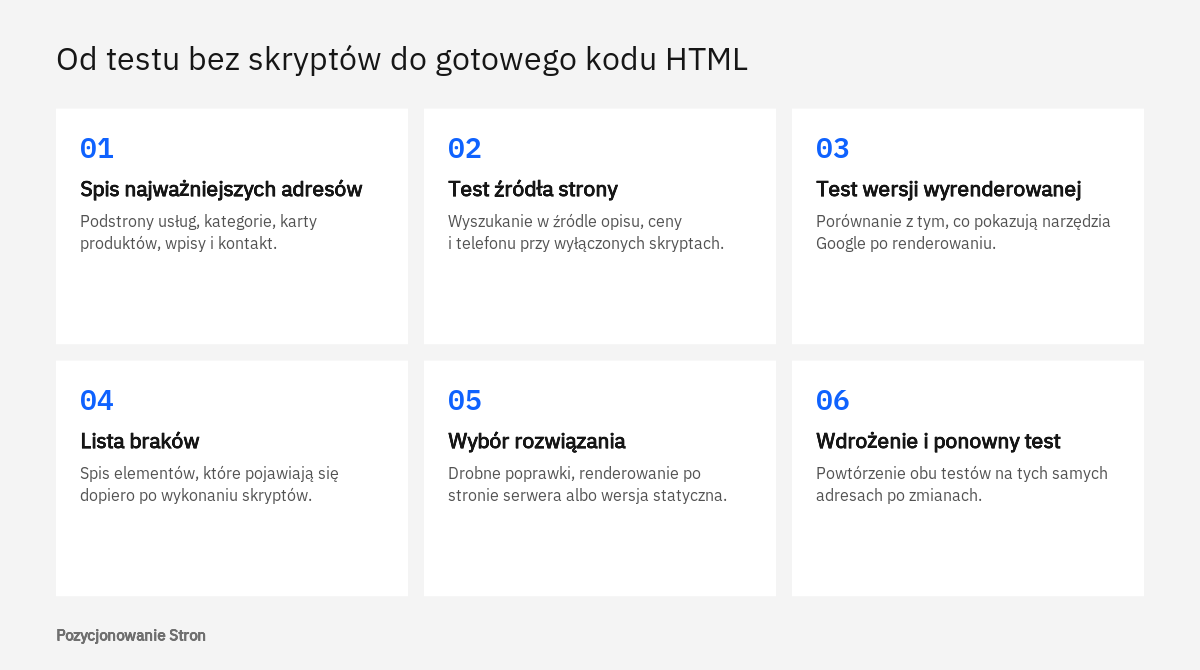
Najszybciej można to sprawdzić w przeglądarce Chrome, wyłączając JavaScript w narzędziach deweloperskich i odświeżając stronę. Cały test zajmuje kilka minut i nie wymaga żadnych płatnych programów. Według dokumentu Wyłącz JavaScript z pomocy Chrome ustawienie dotyczy tylko bieżącej karty i obowiązuje wyłącznie wtedy, gdy narzędzia deweloperskie są otwarte, więc nie ma obawy, że przeglądarka zostanie trwale przestawiona.
- Otwarcie narzędzi deweloperskich
Na badanej podstronie należy otworzyć narzędzia deweloperskie Chrome, na przykład klawiszem F12 albo z menu przeglądarki.
- Otwarcie menu poleceń
Menu poleceń uruchamia skrót Ctrl+Shift+P w systemach Windows i Linux albo Cmd+Shift+P w macOS.
- Wyłączenie JavaScriptu
Po wpisaniu słowa javascript należy wskazać polecenie wyłączające JavaScript i zatwierdzić je klawiszem Enter. W pasku adresu pojawi się ikona informująca o wyłączonych skryptach.
- Odświeżenie strony i przegląd treści
Po ponownym wczytaniu widać stronę w wersji bez skryptów. Warto przejść kolejno przez stronę główną, podstronę usługi lub kategorii, kartę produktu, wpis na blogu i kontakt.
- Przywrócenie ustawień
Skrypty wracają po wybraniu w menu poleceń polecenia włączającego JavaScript albo po zamknięciu narzędzi deweloperskich.
Drugą metodą jest podgląd źródła strony, czyli kodu przysłanego przez serwer przed uruchomieniem czegokolwiek. Wystarczy skrót Ctrl+U, a następnie wyszukanie skrótem Ctrl+F charakterystycznego zdania z opisu oferty, ceny albo numeru telefonu. Jeżeli zdania nie ma w źródle, a widać je na ekranie, oznacza to, że dopisał je skrypt. Nie należy mylić źródła z zakładką pokazującą elementy strony w narzędziach deweloperskich: ta druga prezentuje stan po wykonaniu skryptów i zawsze wygląda na kompletną.
Jak sprawdzić, co widzi Google
Do oceny, jak stronę renderuje sam Google, służą dwa narzędzia wskazane w dokumentacji: Test wyników z elementami rozszerzonymi oraz narzędzie do sprawdzania adresów URL w Search Console. Pokazują one załadowane zasoby, komunikaty i wyjątki konsoli JavaScript oraz wyrenderowany kod, w którym należy poszukać oczekiwanej treści. Test wyników z elementami rozszerzonymi jest publiczny i pozwala wybrać robota na smartfony albo na komputery.
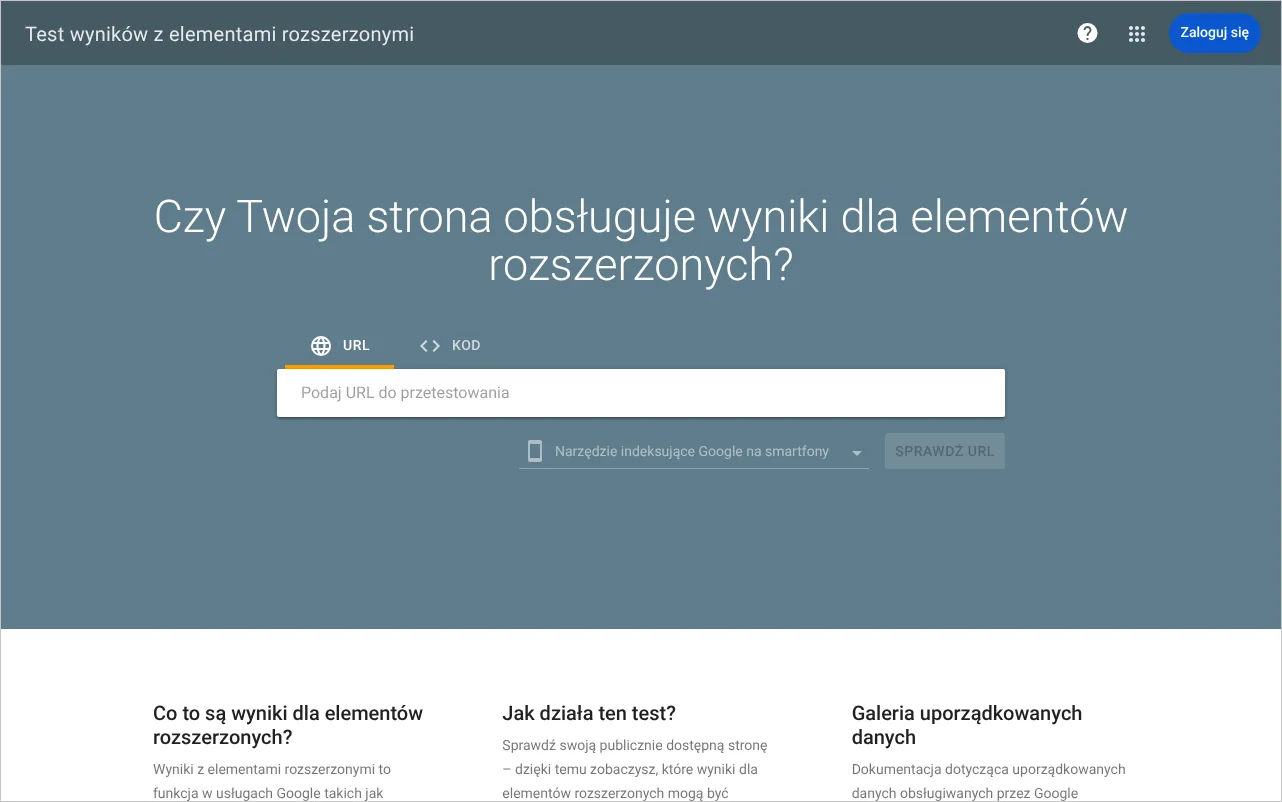
W Search Console adres wpisuje się w pole wyszukiwania u góry ekranu. Po wyświetleniu wyniku dostępny jest przycisk uruchamiający test wersji opublikowanej, a następnie opcja wyświetlenia przetestowanej strony. W otwartym panelu znajdują się wyrenderowany kod, karta Zrzut ekranu oraz karta Więcej informacji z listą zasobów strony i danymi wyjściowymi JavaScriptu. Jeżeli w wyrenderowanym kodzie brakuje opisu lub cen, problem dotyczy także Google, a nie tylko asystentów.
Jeśli chcą Państwo zamówić SEO techniczne, zachęcamy do kontaktu: tel. 222 500 844 lub mailowo: biuro@pozycjonowaniestron.pl
Które elementy strony firmowej znikają najczęściej
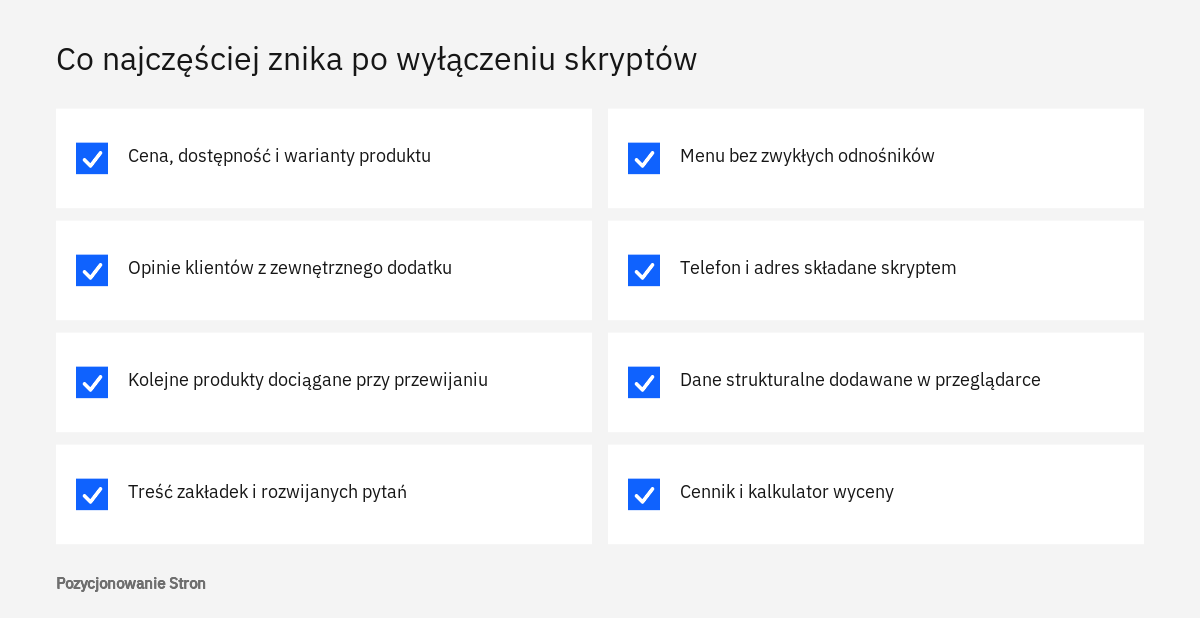
Na stronach firmowych najczęściej znikają te elementy, które dostawia zewnętrzny dodatek albo które projektant ukrył za interakcją: opinie klientów, cenniki, treść zakładek, mapy, dane kontaktowe i odnośniki w menu. Sama treść główna bywa bezpieczna, zwłaszcza w serwisach, które składają stronę na serwerze, ale to właśnie dodatki niosą informacje, o które klienci pytają asystentów: ile to kosztuje, gdzie firma działa, co mówią o niej inni.
Weźmy hipotetyczną kancelarię z Krakowa. Opisy specjalizacji są w kodzie HTML, natomiast lista prawników z ich doświadczeniem wczytuje się osobnym zapytaniem dopiero w przeglądarce, a pytania i odpowiedzi rozwijają się po kliknięciu i wtedy dopiero pobierają tekst. Asystent zapytany o to, kto w kancelarii zajmuje się prawem spadkowym, może nie mieć tej informacji, chociaż na ekranie klienta jest ona widoczna od razu.
| Element strony | Dlaczego znika bez skryptów | Jak to rozpoznać |
|---|---|---|
| Opinie klientów | Wstawia je zewnętrzny dodatek działający w przeglądarce | W źródle strony nie ma treści żadnej opinii, jest tylko pusty pojemnik |
| Cennik i kalkulator | Kwoty są wyliczane lub pobierane po wczytaniu strony | Wyszukiwanie kwoty w źródle nie daje wyniku |
| Zakładki i rozwijane pytania | Tekst jest pobierany dopiero po kliknięciu | Po wyłączeniu skryptów zakładka pozostaje pusta albo się nie otwiera |
| Menu i odnośniki | Nawigacja reaguje na kliknięcie, lecz nie używa zwykłych odnośników z adresem | W źródle brakuje znaczników odnośnika z atrybutem href |
| Dane kontaktowe | Telefon i adres są składane skryptem lub wstawiane z zewnętrznej usługi | Numer telefonu nie występuje w źródle strony |
| Dane strukturalne | Znaczniki dodaje menedżer tagów lub wtyczka po stronie przeglądarki | W źródle nie ma bloku z danymi, pojawia się dopiero po wyrenderowaniu |
Odnośniki, bez których robot nie trafi dalej
Szczególnej uwagi wymaga nawigacja. Google wyjaśnia, że Googlebot wyszukuje adresy w atrybutach href odnośników i dodaje je do kolejki skanowania. Odnośniki wstawiane skryptem są dla niego akceptowalne, o ile mają postać zwykłych, możliwych do zindeksowania linków. Robot, który skryptów nie wykonuje, takich odnośników w ogóle nie zobaczy, a więc nie dotrze do podstron, do których prowadzi wyłącznie menu budowane w przeglądarce. Z tego samego dokumentu wynika, że adresy z fragmentem po znaku krzyżyka nie są rozpoznawane jako osobne strony, dlatego serwis, w którym kolejne widoki różnią się tylko tym fragmentem, jest dla robotów jedną stroną.
Podobnie rzecz ma się z danymi strukturalnymi. Jeżeli znaczniki opisujące firmę wstrzykuje skrypt, Google odczyta je po renderowaniu, lecz robot czytający sam kod HTML ich nie dostanie. Szerzej o roli tych znaczników piszemy we wpisie dane strukturalne a odpowiedzi AI.
Co znika w sklepie internetowym
W sklepach najczęściej znikają cena i dostępność, warianty produktu, opinie kupujących, kolejne strony listy produktów oraz produkty widoczne dopiero po użyciu filtrów. Sklep ma więcej elementów zmiennych niż strona usługowa, a zmienne dane chętnie pobiera się skryptem już po wczytaniu strony, żeby zawsze były aktualne. Skutek jest taki, że w kodzie HTML karty produktu zostaje nazwa i zdjęcie, a informacje decydujące o zakupie pojawiają się później.
Wyobraźmy sobie hipotetyczny sklep z Poznania sprzedający wyposażenie łazienek. Lista produktów w kategorii pokazuje pierwsze pozycje, a następne dociąga podczas przewijania. Cena aktualizuje się po wyborze koloru i rozmiaru. Opinie wczytują się w osobnej zakładce. Klient pyta asystenta o baterię umywalkową w określonej cenie i z dobrymi ocenami. Robot, który odwiedzi kartę produktu, może nie znaleźć w kodzie ani ceny wybranego wariantu, ani ocen, a do produktów z dalszej części listy w ogóle nie dotrze, jeśli nie prowadzą do nich zwykłe odnośniki.
Listy produktów, przewijanie i filtry
Dokumentacja Google dotycząca leniwego ładowania podpowiada, jak pogodzić wygodę klienta z dostępnością dla robotów. Każda część listy powinna mieć własny, unikalny adres, pod którym za każdym razem znajduje się ta sama zawartość, a odnośniki do kolejnych stron powinny tworzyć uporządkowany zbiór, przez który da się przejść. Zalecane są bezwzględne numery stron w adresie. Jeżeli sklep stosuje przewijanie bez końca, zwykłe odnośniki stronicowania nadal powinny znajdować się w kodzie. Dzięki temu do pełnej oferty dotrze zarówno Googlebot, który nie przewija stron, jak i robot, który nie wykonuje skryptów.
Filtry warto ocenić z tego samego punktu widzenia. Jeśli wybór filtra zmienia zawartość listy bez zmiany adresu i bez odnośnika w kodzie, tak powstały widok istnieje tylko w przeglądarce klienta. Nie każdy filtr musi być dostępny dla robotów, ale decyzja, które kombinacje mają własne adresy, powinna być świadoma. Pomagamy w tym w ramach usługi pozycjonowanie sklepów.
Jak renderowanie po stronie serwera lub wersja statyczna rozwiązuje problem
Oba rozwiązania sprawiają, że serwer wysyła gotowy kod HTML z treścią, zanim uruchomi się jakikolwiek skrypt. Robot, który skryptów nie wykonuje, dostaje wtedy to samo, co klient zobaczy na ekranie. Opracowanie Renderowanie w internecie w serwisie web.dev opisuje renderowanie po stronie serwera jako popularny sposób dostarczania kompletnych treści, które roboty mogą odczytać bez dodatkowego przetwarzania, a o renderowaniu w przeglądarce mówi, że może działać, lecz zwykle wymaga dodatkowych testów i nakładu pracy.
Renderowanie po stronie serwera oznacza, że przy każdym żądaniu serwer przygotowuje kod HTML z aktualną treścią. Ceną jest czas pracy serwera, który może wydłużyć oczekiwanie na pierwszą odpowiedź. Renderowanie statyczne polega na tym, że pliki HTML dla każdego adresu powstają zawczasu, podczas budowania serwisu, i są potem tylko wysyłane. Daje to stabilnie szybką odpowiedź, ale jest trudniejsze przy bardzo wielu adresach i przy treściach dopasowanych do odbiorcy.
Etap, w którym skrypty w przeglądarce dodają interaktywność do kodu HTML przygotowanego wcześniej na serwerze. Treść jest widoczna od razu, a obsługa kliknięć pojawia się po chwili.
Wybór zależy od rodzaju serwisu. Strona usługowa z kilkudziesięcioma podstronami, które rzadko się zmieniają, dobrze nadaje się do wersji statycznej. Sklep z cenami i stanami magazynowymi zmieniającymi się w ciągu dnia zwykle potrzebuje renderowania po stronie serwera, przynajmniej dla kart produktów i kategorii. Skrypty mogą nadal obsługiwać koszyk, wyszukiwarkę i inne części, których robot nie potrzebuje.
Renderowanie dynamiczne jako rozwiązanie przejściowe
Istnieje też trzecia droga, czyli renderowanie dynamiczne: serwer rozpoznaje robota i podaje mu wersję wyrenderowaną zawczasu, a ludziom wysyła aplikację działającą w przeglądarce. Google w dokumencie Renderowanie dynamiczne jako obejście problemu określa je jako rozwiązanie tymczasowe, którego nie zaleca, ponieważ zwiększa złożoność całego procesu, i wskazuje w zamian renderowanie po stronie serwera, renderowanie statyczne lub hydrację. Nie uznaje go natomiast za maskowanie, o ile roboty i ludzie otrzymują podobną treść.
Przy robotach asystentów renderowanie dynamiczne ma dodatkową słabość: wymaga listy rozpoznawanych robotów, a robot spoza listy dostanie pusty szkielet. Gotowy kod HTML wysyłany wszystkim nie ma tego ograniczenia, dlatego traktujemy go jako rozwiązanie docelowe.
Poprawki możliwe bez przebudowy serwisu
Nie każda strona wymaga zmiany technologii. Często wystarcza przeniesienie kilku elementów do kodu HTML: wpisanie numeru telefonu i adresu zwykłym tekstem, zamiana menu na zwykłe odnośniki, umieszczenie treści zakładek i pytań w dokumencie i jedynie ukrywanie ich do chwili kliknięcia, wygenerowanie danych strukturalnych po stronie serwera, a także zapisanie wybranych opinii jako tekstu na stronie obok dodatku, który pokazuje je wszystkie.
Od czego zacząć i jakich pomyłek unikać
Zacząć należy od ustalenia, które podstrony przynoszą firmie zapytania, i sprawdzenia właśnie ich w wersji bez skryptów. Dopiero wynik tego testu pokazuje, czy potrzebna jest drobna poprawka, czy zmiana sposobu renderowania.
- Nagłówek główny i opis oferty znajdują się w źródle strony.
- Ceny, dostępność i warianty produktu są w kodzie HTML karty produktu.
- Numer telefonu, adres i godziny pracy są zapisane zwykłym tekstem.
- Menu, stronicowanie i powiązane podstrony korzystają ze zwykłych odnośników z atrybutem href.
- Treść zakładek i rozwijanych pytań jest w dokumencie od początku.
- Dane strukturalne są obecne w źródle strony, a nie tylko po wyrenderowaniu.
- Plik robots.txt nie blokuje skryptów ani stylów potrzebnych do renderowania.
- Nieistniejące adresy zwracają z serwera kod 404, a nie kod 200.
Najczęstsza pomyłka to ocenianie strony na podstawie tego, co widać w przeglądarce. Druga to przekonanie, że skoro strona jest w indeksie Google, widzą ją wszyscy: Google renderuje strony, inne roboty nie muszą. Trzecia dotyczy znaczników sterujących. Google zaleca ustawianie adresu kanonicznego w kodzie HTML i ostrzega, że po napotkaniu znacznika noindex może pominąć renderowanie, więc usuwanie go skryptem bywa nieskuteczne. JavaScript sam w sobie widoczności nie szkodzi. Chodzi wyłącznie o to, aby informacje, które mają trafić do odpowiedzi asystentów i do wyników wyszukiwania, nie zależały od skryptów.
Samodzielnie da się wykonać test i wskazać braki. Pomoc specjalistów przydaje się, gdy serwis jest aplikacją jednostronicową, gdy trzeba wybrać między renderowaniem po stronie serwera a wersją statyczną albo gdy sklep ma rozbudowane filtry. Takie prace prowadzimy w ramach usługi SEO techniczne, a pełny przegląd serwisu obejmuje audyt SEO. Jeżeli celem jest obecność w odpowiedziach asystentów, dostępność treści w kodzie HTML jest jednym z pierwszych punktów, od których zaczynamy pozycjonowanie AI. Przy budowie nowego serwisu sposób renderowania warto ustalić już na etapie projektu, co uwzględniamy, realizując tworzenie stron.
Jeśli chcą Państwo zamówić SEO techniczne, zachęcamy do kontaktu: tel. 222 500 844 lub mailowo: biuro@pozycjonowaniestron.pl
Najczęstsze pytania
Czy strona na WordPressie też może mieć ten problem?
Może, choć zwykle nie dotyczy on całej treści, lecz elementów dostawianych przez dodatki działające w przeglądarce: opinii, cenników, kalkulatorów, zakładek czy danych strukturalnych wstrzykiwanych skryptem. Rozstrzyga test źródła strony, a nie nazwa systemu.
Skoro Google renderuje JavaScript, to po co cokolwiek zmieniać?
Ponieważ Google nie jest jedynym odbiorcą strony. Sama dokumentacja wyszukiwarki zaznacza, że nie wszystkie roboty wykonują JavaScript, a renderowanie po stronie serwera przyspiesza witrynę dla użytkowników i robotów. Dodatkowo renderowanie w Google odbywa się w osobnej kolejce, w której strona może czekać.
Czy podawanie robotom innej wersji strony niż ludziom jest dozwolone?
Google nie traktuje renderowania dynamicznego jako maskowania, jeżeli robot i człowiek otrzymują podobną treść. Maskowaniem byłoby pokazywanie robotom treści istotnie innej niż użytkownikom. Jednocześnie Google określa to podejście jako tymczasowe.
Czy treść ukryta w zakładkach jest widoczna dla robotów?
To zależy od wykonania. Jeżeli tekst zakładki znajduje się w kodzie HTML i jest jedynie zwinięty, robot czytający kod go otrzyma. Jeżeli tekst jest pobierany dopiero po kliknięciu, nie zobaczy go ani robot bez obsługi skryptów, ani Googlebot, który nie klika w elementy strony.
Jak sprawdzić, czy roboty asystentów w ogóle odwiedzają stronę?
Odpowiedź dają logi serwera, w których zapisane są nazwy robotów i pobierane przez nie pliki. Widać w nich, czy robot pobrał tylko dokument HTML, czy także pliki skryptów. Jeśli robotów nie ma w logach wcale, warto sprawdzić, czy nie blokuje ich plik robots.txt.
Czy przejście na renderowanie po stronie serwera zapewni cytowanie w odpowiedziach AI?
Nie zapewni. Dostępność treści w kodzie HTML jest warunkiem, aby robot mógł ją przeczytać, ale o wyborze źródeł decyduje wiele innych czynników, w tym jakość i przydatność treści.
Źródła
- JavaScript a SEO - podstawy, Centrum wyszukiwarki Google
- Rozwiązywanie problemów z JavaScriptem związanych z wyszukiwarką, Centrum wyszukiwarki Google
- Naprawianie leniwie ładującej się zawartości witryny, Centrum wyszukiwarki Google
- Renderowanie dynamiczne jako obejście problemu, Centrum wyszukiwarki Google
- Funkcje oparte na AI a Twoja witryna, Centrum wyszukiwarki Google
- Narzędzie do sprawdzania adresów URL, Search Console - pomoc
- Renderowanie w internecie, web.dev
- Wyłącz JavaScript, Chrome for Developers
- Overview of OpenAI Crawlers, OpenAI
- Does Anthropic crawl data from the web, and how can site owners block the crawler?, Claude Help Center
- bingbot Series: JavaScript, Dynamic Rendering, and Cloaking. Oh My!, Bing Webmaster Blog
Funkcje wyszukiwarek i asystentów AI zmieniają się szybko, dlatego wpis aktualizujemy po większych zmianach.