Logi serwera to jedyne miejsce, w którym widać każde pobranie strony przez roboty asystentów AI: kto przyszedł, o której godzinie, po jaki adres i z jakim skutkiem. Wystarczy pobrać plik dziennika z panelu hostingu, odfiltrować wiersze po nazwie klienta i ułożyć z nich dwa proste zestawienia w arkuszu.
Czym są logi serwera i co zapisują o robotach AI
Log dostępu to plik tekstowy, w którym serwer dopisuje jeden wiersz dla każdego żądania: strony, grafiki, arkusza stylów czy pliku robots.txt. Zapis powstaje po stronie serwera, niezależnie od tego, czy odwiedzający uruchomił jakikolwiek skrypt, dlatego obejmuje także programy, których nie rejestruje analityka oparta na kodzie w przeglądarce.
Najczęściej spotykany układ wiersza to tak zwany format łączony (Combined Log Format). Dokumentacja serwera Apache opisuje go jako ciąg dziewięciu pól: adres IP klienta, dwa pola identyfikacyjne (zwykle puste, oznaczone dywizem), data i godzina żądania, wiersz żądania z metodą, adresem zasobu i wersją protokołu, kod odpowiedzi, rozmiar odpowiedzi w bajtach, adres strony odsyłającej oraz nagłówek User-Agent, czyli nazwa, którą klient sam się przedstawia.
203.0.113.25 - - [12/Mar/RRRR:08:14:02 +0100] "GET /cennik/ HTTP/1.1" 200 18452 "-" "Mozilla/5.0 AppleWebKit/537.36 (KHTML, like Gecko); compatible; GPTBot/1.4; +https://openai.com/gptbot"Z takiego wiersza da się odczytać komplet informacji. Robot przedstawiający się jako GPTBot poprosił o podstronę z cennikiem, serwer odpowiedział kodem 200, a więc wydał treść, i przesłał nieco ponad osiemnaście tysięcy bajtów. Pole strony odsyłającej jest puste, co u robotów jest regułą: nie przychodzą z kliknięcia w link, tylko pobierają adres bezpośrednio.
Nagłówek żądania, w którym przeglądarka lub robot podaje swoją nazwę i wersję. Serwer zapisuje go w logu bez weryfikacji, dlatego jest wygodnym filtrem, ale nie dowodem tożsamości.
Ta sama dokumentacja zwraca uwagę, że pola strony odsyłającej i nazwy klienta pochodzą w całości od odwiedzającego, który może wpisać w nie dowolny tekst. Do tej kwestii wracamy w części o potwierdzaniu tożsamości robota.
Gdzie znaleźć logi na hostingu
Na hostingu współdzielonym logi dostępu pobiera się z panelu administracyjnego konta, zwykle z działu poświęconego statystykom, dziennikom lub plikom domeny. Dokładna nazwa pozycji zależy od panelu, którego używa dana firma hostingowa, dlatego opisujemy to, co z naszej praktyki powtarza się najczęściej, a w razie wątpliwości najszybciej odpowie pomoc techniczna hostingu.
W większości paneli do wyboru są dwie drogi. Pierwsza to pozycja w menu z dziennikami lub nieprzetworzonym dostępem, gdzie dla każdej domeny czeka plik do pobrania, często spakowany do archiwum z rozszerzeniem gz. Druga to menedżer plików albo połączenie FTP: obok katalogu ze stroną bywa katalog o nazwie logs, a w nim pliki access.log oraz error.log. Pierwszy to dziennik dostępu, o którym tutaj mowa, drugi zbiera błędy aplikacji.
Na serwerze VPS lub dedykowanym położenie pliku wynika z konfiguracji. W serwerze Apache wskazuje je dyrektywa CustomLog, a układ pól - dyrektywa LogFormat, co opisuje przywołana wyżej dokumentacja. Przy innym oprogramowaniu serwera zasada pozostaje ta sama: ścieżka i format są zapisane w pliku konfiguracyjnym.
Gdy ruch przechodzi przez pośrednika
Jeżeli przed stroną działa sieć dostarczania treści albo zapora aplikacyjna, część żądań może w ogóle nie dotrzeć do serwera, bo pośrednik odpowiada z własnej pamięci lub blokuje ruch uznany za automatyczny. Dokumentacja Apache przypomina też, że w takim układzie w polu adresu IP zapisuje się adres pośrednika, a nie pierwotnego klienta. Pełny obraz daje wtedy dopiero zestawienie logów serwera z dziennikiem samego pośrednika. Robot zablokowany na zaporze nie zostawi w pliku access.log żadnego śladu, a właściciel strony może błędnie uznać, że asystent się nią nie interesuje.
Logi zawierają adresy IP odwiedzających, dlatego należy obchodzić się z nimi ostrożnie: nie wgrywać plików do publicznych narzędzi i przechowywać je tylko tak długo, jak to potrzebne. Zasady postępowania w konkretnej firmie najlepiej ustalić z osobą odpowiedzialną za ochronę danych lub z prawnikiem.
Jakich nazw szukać: roboty asystentów i ich zadania
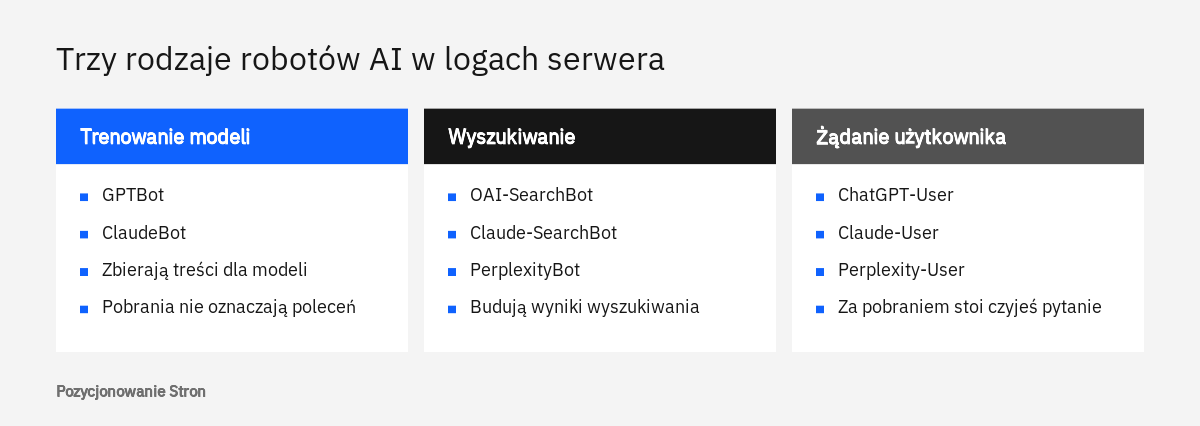
W logach należy szukać nazw publikowanych przez samych dostawców asystentów, przy czym każdy z nich ma po kilka robotów o odmiennych zadaniach. Ta sama liczba pobrań znaczy co innego, gdy pochodzi od robota zbierającego dane do trenowania modeli, a co innego, gdy stronę pobrano dlatego, że ktoś właśnie zadał asystentowi pytanie.
OpenAI opisuje cztery roboty. GPTBot zbiera treści, które mogą posłużyć do trenowania modeli. OAI-SearchBot odpowiada za to, by strony mogły pojawiać się w funkcjach wyszukiwania ChatGPT. ChatGPT-User pobiera stronę w wyniku działania użytkownika i nie służy do automatycznego przeglądania sieci. Czwarty, OAI-AdsBot, odwiedza wyłącznie strony docelowe zgłoszone jako reklamy. Więcej piszemy o tym we wpisie o tym, jak wyszukuje ChatGPT Search.
Anthropic podaje trzy nazwy: ClaudeBot zbiera treści, które mogą zasilić trenowanie modeli, Claude-SearchBot przegląda sieć na potrzeby jakości wyników wyszukiwania, a Claude-User wchodzi na strony wtedy, gdy użytkownik zadaje Claude pytanie. Szerzej opisujemy to w tekście o tym, jak Claude wyszukuje w sieci. Perplexity ma dwa roboty: PerplexityBot, który służy do pokazywania i linkowania stron w wynikach tej wyszukiwarki i według dokumentacji nie zbiera treści dla modeli bazowych, oraz Perplexity-User, pobierający stronę wtedy, gdy użytkownik zadał pytanie.
| Nazwa w logu | Dostawca | Do czego służy według dokumentacji |
|---|---|---|
| GPTBot | OpenAI | Zbieranie treści, które mogą posłużyć do trenowania modeli |
| OAI-SearchBot | OpenAI | Wyszukiwanie w ChatGPT |
| ChatGPT-User | OpenAI | Pobranie strony w wyniku działania użytkownika |
| ClaudeBot | Anthropic | Zbieranie treści, które mogą posłużyć do trenowania modeli |
| Claude-SearchBot | Anthropic | Poprawa jakości wyników wyszukiwania |
| Claude-User | Anthropic | Wejście na stronę, gdy użytkownik zadaje pytanie |
| PerplexityBot | Perplexity | Pokazywanie i linkowanie stron w wynikach Perplexity |
| Perplexity-User | Perplexity | Pobranie strony, gdy użytkownik zadał pytanie |
A co z Google i Gemini
Ruchu Google na potrzeby funkcji AI nie da się wydzielić w logach po osobnej nazwie. Dokumentacja typowych robotów Google wyjaśnia, że Google-Extended nie ma własnego ciągu znaków klienta w żądaniu HTTP. Jest to wyłącznie nazwa używana w pliku robots.txt, którą wydawca decyduje, czy treści pobrane przez Google mogą służyć do trenowania kolejnych modeli Gemini i do osadzania odpowiedzi w faktach. Samo pobieranie odbywa się pod dotychczasowymi nazwami robotów Google, więc szukanie w logach słowa Google-Extended nie przyniesie żadnego wyniku.
Osobną grupą są moduły pobierania uruchamiane przez użytkownika. Wśród nich jest Google-NotebookLM, który pobiera pojedyncze adresy wskazane przez użytkowników jako źródła w ich projektach. Listę z tabeli warto z czasem uzupełniać o roboty innych dostawców, zawsze na podstawie ich oficjalnej dokumentacji.
Jak odfiltrować wpisy robotów po nazwie klienta
Wpisy robotów odfiltrowuje się, szukając ich nazw w ostatnim polu wiersza, czyli w nagłówku User-Agent. Przy małej stronie wystarczy arkusz kalkulacyjny i filtr tekstowy, przy większej wygodniej jest najpierw zmniejszyć plik jednym poleceniem w terminalu, a dopiero wynik otworzyć w arkuszu.
Droga przez arkusz wygląda następująco. Pobrany plik trzeba rozpakować, jeśli ma rozszerzenie gz, a następnie zaimportować jako tekst rozdzielany spacjami, z cudzysłowem jako znakiem otaczającym tekst. Dzięki temu wiersz żądania, strona odsyłająca i nazwa klienta trafią każde do własnej kolumny, mimo że zawierają spacje. Po nadaniu kolumnom nagłówków wystarczy włączyć filtr i w kolumnie z nazwą klienta ustawić warunek tekstowy: zawiera GPTBot, zawiera ClaudeBot i tak dalej.
Arkusze mają jednak granicę liczby wierszy, a log ruchliwego sklepu potrafi ją przekroczyć. Wtedy lepiej sprawdza się polecenie grep, dostępne w systemach Linux i macOS, a na hostingu z dostępem SSH także bezpośrednio na serwerze.
grep -i -E "GPTBot|OAI-SearchBot|ChatGPT-User|ClaudeBot|Claude-SearchBot|Claude-User|PerplexityBot|Perplexity-User" access.log > roboty-ai.txtPrzełącznik -i każe pominąć wielkość liter, a -E pozwala podać kilka nazw rozdzielonych pionową kreską. Dla pliku spakowanego wystarczy zamienić grep na zgrep. Powstały plik jest zwykle znacznie mniejszy od całego logu i bez kłopotu otwiera się w arkuszu.
Po odfiltrowaniu dobrze jest dopisać w arkuszu dwie kolumny pomocnicze: krótką nazwę robota oraz jego rodzaj, czyli trenowanie, wyszukiwanie albo żądanie użytkownika. Wystarczą one, by później jednym ruchem budować zestawienia.
Jeśli chcą Państwo zamówić SEO techniczne, zachęcamy do kontaktu: tel. 222 500 844 lub mailowo: biuro@pozycjonowaniestron.pl
Które podstrony roboty pobierają najczęściej
Odpowiedź daje tabela przestawna zbudowana na odfiltrowanych wierszach: w wierszach adres zasobu, w kolumnach nazwa robota, w wartościach liczba wystąpień. Po posortowaniu malejąco od razu widać, które adresy przyciągają roboty, a które są dla nich niewidoczne.
Zanim powstanie tabela, warto oczyścić dane. Wiersz żądania zawiera metodę, adres i wersję protokołu, a do zestawienia potrzebny jest sam adres, więc najprościej rozdzielić tę kolumnę według spacji. Następnie dobrze jest odsiać pliki pomocnicze: grafiki, arkusze stylów, skrypty i czcionki. Osobno należy potraktować robots.txt. Jego pobrania oznaczają, że robot pyta o zasady, zanim sięgnie po treść, ale w zestawieniu podstron tylko zaciemniałyby obraz.
- Zestawienie adresów
Adres w wierszach, robot w kolumnach, liczba pobrań w wartościach. Pokazuje, co roboty czytają.
- Zestawienie dzienne
Data w wierszach, robot w kolumnach. Pokazuje, czy ruch jest stały, czy przychodzi falami.
- Zestawienie rodzajów
Rodzaj robota w wierszach. Oddziela zbieranie danych do trenowania od pobrań wywołanych pytaniami użytkowników.
- Porównanie z mapą witryny
Lista ważnych adresów firmy zestawiona z listą adresów pobranych. Pokazuje strony, do których żaden robot nie dotarł.
Osoby pracujące w terminalu uzyskają pierwsze zestawienie bez arkusza. W formacie łączonym adres zasobu jest siódmym elementem wiersza liczonym po spacjach, a kod odpowiedzi dziewiątym.
awk '{print $7}' roboty-ai.txt | sort | uniq -c | sort -rn | head -20
awk '{print $9}' roboty-ai.txt | sort | uniq -c | sort -rn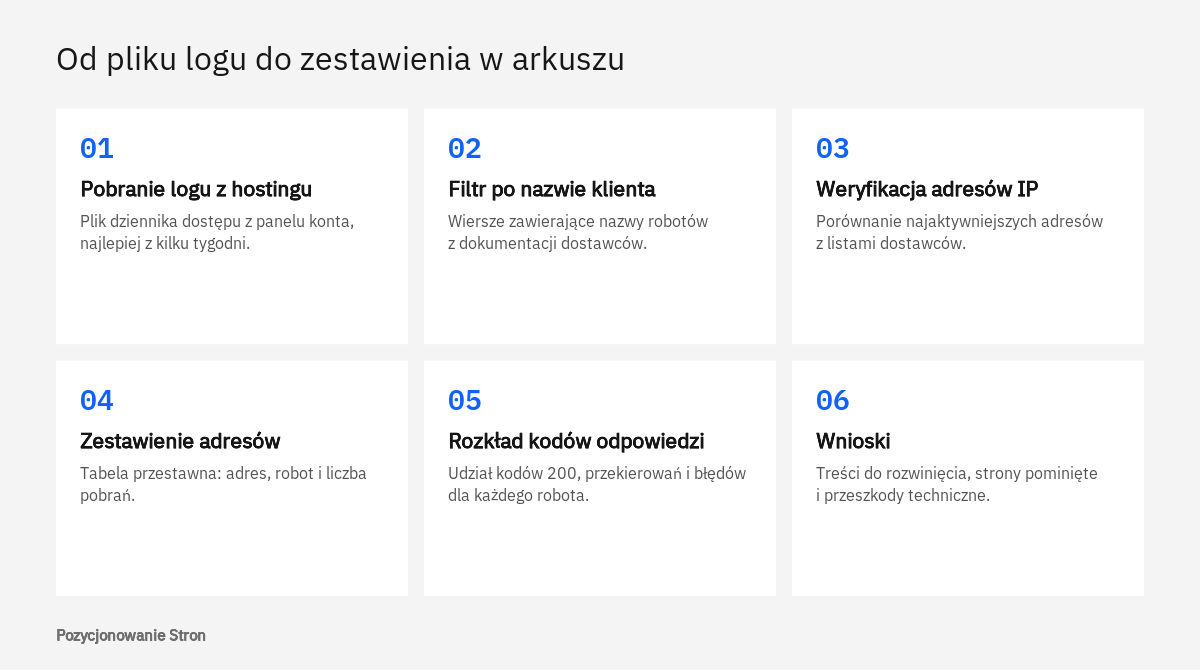
Jak czytać zestawienie adresów
Sama liczba pobrań niczego nie przesądza, liczy się jej układ. Weźmy hipotetyczną kancelarię z Krakowa, która ma na stronie opisy usług, cennik i blog. Jeżeli roboty pobierające na żądanie użytkownika trafiają głównie na wpisy blogowe, a prawie nigdy na opisy usług, to asystenci sięgają po tę stronę przy pytaniach o wiedzę, a nie przy pytaniach o wybór wykonawcy. Jeżeli z kolei hipotetyczny sklep z Poznania widzi, że większość pobrań dotyczy adresów z parametrami filtrowania i sortowania, a nie kart produktów, to robot traci czas na powielone listy. Podobny kłopot opisujemy od strony wyszukiwarki we wpisie o budżecie indeksowania w sklepie.
Szczególnie cenna jest lista adresów pobieranych przez ChatGPT-User, Claude-User i Perplexity-User. Według dokumentacji dostawców pojawiają się one wtedy, gdy ktoś zadał asystentowi pytanie, a odpowiedź wymagała zajrzenia na stronę. Nie wiadomo, o co dokładnie zapytano, ale wiadomo, która podstrona została uznana za wartą przeczytania.
Jakie kody odpowiedzi dostają roboty i co z nich wynika
Kod odpowiedzi mówi, czy robot dostał treść, czy odszedł z niczym. Zdrowy obraz to zdecydowana przewaga kodu 200 na ważnych podstronach, pojedyncze przekierowania i brak serii błędów z grup 4xx oraz 5xx. Każde odstępstwo wymaga wyjaśnienia, bo robot, który nie otrzymał treści, nie ma czego zacytować.
Dostawcy asystentów nie opisują szczegółowo, jak ich roboty reagują na poszczególne kody. Dobrym punktem odniesienia jest dokumentacja Google o kodach stanu HTTP. Wynika z niej między innymi, że treści z adresów zwracających kody z grupy 4xx nie są używane, że kod 429 jest traktowany jak sygnał przeciążenia serwera, a przy błędach serwera pobieranie zwalnia. Nie należy przenosić tych zasad wprost na inne roboty, ale logika pozostaje wspólna: odpowiedź inna niż treść oznacza, że strona w danej chwili nie została przeczytana.
| Kod | Co oznacza | Co warto zrobić |
|---|---|---|
| 200 | Serwer wydał treść | Upewnić się, że w odpowiedzi jest właściwy tekst, a nie pusty szablon |
| 301 i 302 | Przekierowanie pod inny adres | Poprawić linki wewnętrzne i mapę witryny, by prowadziły od razu do celu |
| 304 | Treść bez zmian od poprzedniego pobrania | Nic, to oszczędność zasobów po obu stronach |
| 403 | Serwer odmówił dostępu | Sprawdzić zaporę, wtyczki bezpieczeństwa i reguły hostingu |
| 404 i 410 | Strony nie ma | Ustalić, skąd robot zna adres, i przekierować go lub poprawić link |
| 429 | Zbyt wiele żądań | Ocenić, czy limit nie jest ustawiony zbyt ostro |
| 500 i 503 | Błąd lub niedostępność serwera | Poszukać przyczyny w dzienniku błędów i u dostawcy hostingu |
Najczęstszą niespodzianką jest kod 403 wydawany wyłącznie robotom. Strona działa poprawnie w przeglądarce, właściciel niczego nie blokował, a mimo to zapora hostingu lub wtyczka bezpieczeństwa odrzuca ruch uznany za automatyczny. Mechanizm jest ten sam, który opisujemy w tekście o kodzie 403 i Googlebocie. Przy seriach odpowiedzi 503 warto z kolei przeczytać, jak poprawnie obsłużyć przerwę techniczną.
Osobną uwagę warto poświęcić rozmiarowi odpowiedzi. Jeżeli strona budowana jest w całości skryptami po stronie przeglądarki, robot może otrzymać kod 200 i bardzo mały dokument bez właściwej treści. Dostawcy asystentów nie deklarują w przywołanych dokumentach, czy ich roboty wykonują skrypty, dlatego bezpieczniej założyć, że czytają to, co serwer wysyła w pierwszej odpowiedzi.
Jak potwierdzić, że wpis pochodzi od prawdziwego robota
Nazwa w logu nie dowodzi tożsamości, bo każdy program może podać dowolną. Pewność daje dopiero sprawdzenie adresu IP: jeżeli mieści się w zakresach opublikowanych przez dostawcę, żądanie rzeczywiście od niego pochodzi.
Wszyscy trzej omawiani dostawcy publikują listy adresów swoich robotów w plikach JSON, do których odsyłają w dokumentacji. OpenAI udostępnia osobną listę dla każdego robota, Perplexity osobne listy dla PerplexityBot i Perplexity-User, a Anthropic wspólną listę. Perplexity wprost zaleca łączenie obu metod, czyli dopasowania nazwy klienta i weryfikacji adresu IP.
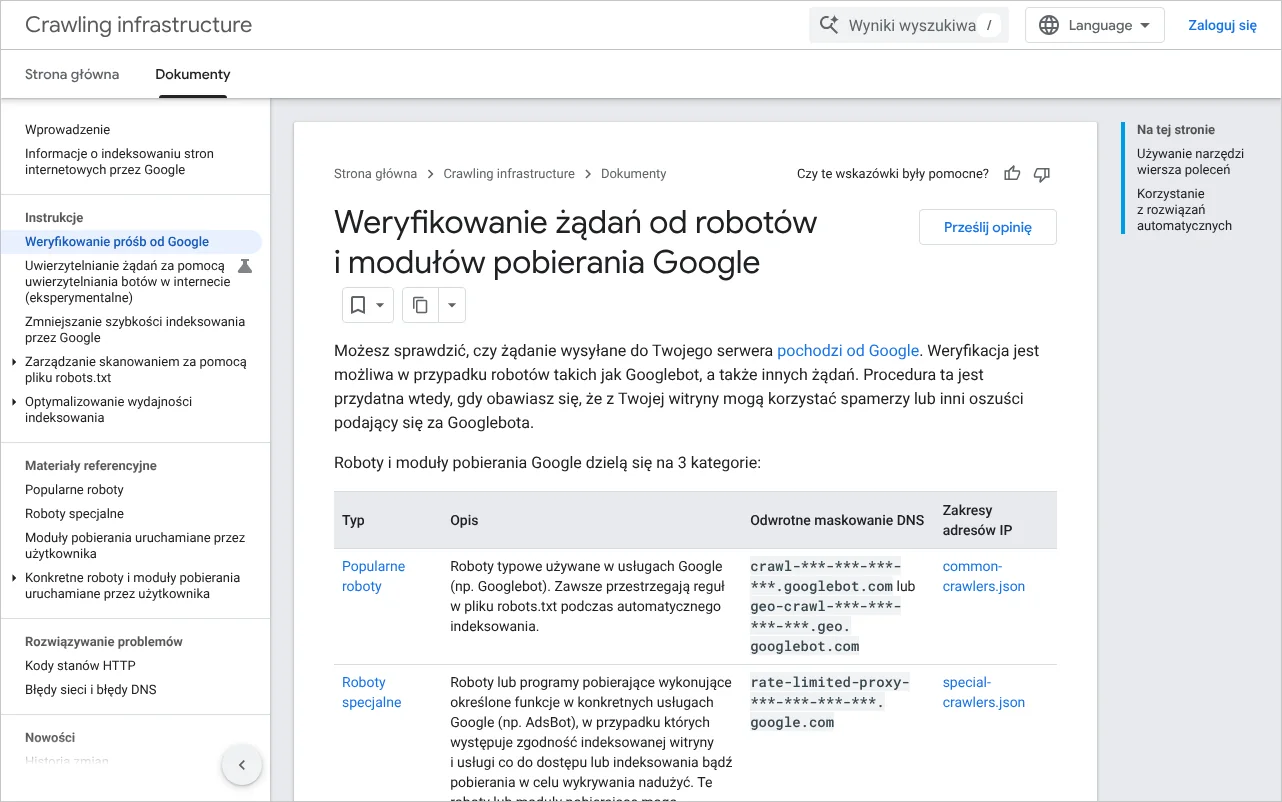
Google opisuje jeszcze jedną metodę w dokumencie o weryfikowaniu żądań od robotów i modułów pobierania. Polega ona na odwrotnym zapytaniu DNS o adres IP z logu poleceniem host, sprawdzeniu, czy zwrócona nazwa należy do domeny googlebot.com, google.com lub googleusercontent.com, a następnie na zapytaniu w drugą stronę i porównaniu wyniku z pierwotnym adresem. Przy większej skali Google zaleca porównywanie adresów z opublikowanymi listami zakresów.
W praktyce nie trzeba weryfikować każdego wiersza. Wystarczy wypisać unikalne adresy IP dla każdej nazwy robota i sprawdzić te, które odpowiadają za najwięcej żądań. Adres, który przedstawia się jako znany robot, a nie znajduje się na liście dostawcy, najpewniej należy do programu podszywającego się pod cudzą nazwę. Takie wiersze należy usunąć z analizy.
Wizyta robota a wejście człowieka z asystenta
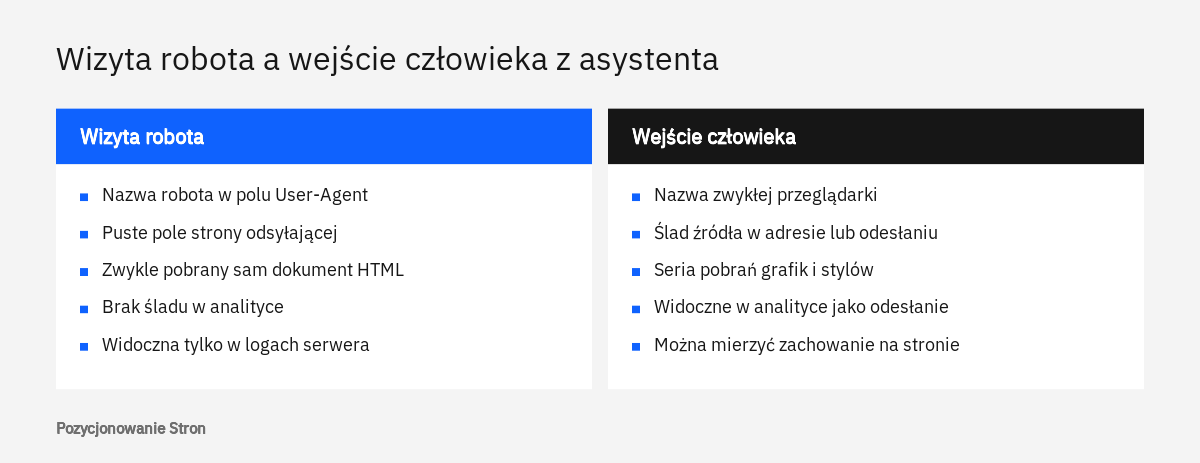
To dwa różne zdarzenia, które łatwo pomylić. Wizyta robota oznacza, że program pobrał treść strony. Wejście człowieka oznacza, że ktoś przeczytał odpowiedź asystenta, kliknął w niej link i otworzył stronę we własnej przeglądarce. Pierwsze widać tylko w logach pod nazwą robota, drugie w logach wygląda jak zwykła wizyta, a w analityce pojawia się jako ruch z odesłania.
Różnicę najłatwiej uchwycić w trzech polach wiersza. Robot ma w nazwie klienta swoją nazwę, puste pole strony odsyłającej i pobiera zazwyczaj sam dokument HTML. Człowiek przychodzi z nazwą zwykłej przeglądarki, a tuż po dokumencie jego przeglądarka pobiera grafiki, arkusze stylów i skrypty, co w logu tworzy serię wierszy z tego samego adresu IP w ciągu kilku sekund. Dodatkowo w adresie bywa ślad źródła. OpenAI informuje, że ChatGPT dopisuje do adresów odsyłających parametr utm_source=chatgpt.com, dzięki czemu wydawcy mogą śledzić ten ruch w narzędziach takich jak Google Analytics.
Roboty działające na żądanie użytkownika stoją pośrodku. Za pobraniem przez ChatGPT-User, Claude-User czy Perplexity-User stoi pytanie zadane przez człowieka, ale ten człowiek mógł nigdy nie odwiedzić strony: przeczytał odpowiedź w oknie asystenta i na tym poprzestał. Dlatego liczby pobrań przez takie roboty nie wolno sumować z wizytami ani przedstawiać jako ruchu na stronie.
Tej grupy robotów dotyczą też inne zasady niż robotów automatycznych. OpenAI zaznacza, że skoro działania ChatGPT-User inicjuje użytkownik, reguły z pliku robots.txt mogą nie mieć do nich zastosowania. Perplexity pisze, że Perplexity-User z tego samego powodu zasadniczo pomija te reguły, a Google podobnie opisuje własne moduły pobierania uruchamiane przez użytkownika. Obecność takich wpisów w logach przy zablokowanych robotach automatycznych nie musi więc oznaczać błędu w konfiguracji.
Pełny obraz powstaje z połączenia obu źródeł: logi mówią, czy asystenci czytają stronę, a analityka, czy ludzie z ich odpowiedzi na stronę przechodzą. Jak ułożyć z tego stały raport, opisujemy we wpisie o tym, jak mierzyć widoczność marki w odpowiedziach AI.
Wnioski dla treści, typowe pomyłki i moment na pomoc
Z analizy logów wynikają trzy rodzaje wniosków: które treści są czytane i warte rozwijania, które ważne podstrony pozostają niezauważone oraz gdzie technika utrudnia robotom dostęp.
Podstrony często pobierane przez roboty działające na żądanie użytkownika to treści, po które asystenci sięgają przy realnych pytaniach. Warto dbać o ich aktualność, uzupełniać o konkretne dane i jednoznaczne odpowiedzi, a także prowadzić z nich linki wewnętrzne do opisów usług. Podstrony ważne dla firmy, których roboty nie pobierają wcale, wymagają sprawdzenia podstaw: czy prowadzą do nich linki z innych stron serwisu, czy są w mapie witryny, czy plik robots.txt ich nie wyklucza i czy serwer nie odpowiada robotom błędem. Hipotetyczny hydraulik z Łodzi, który opisał usługi wyłącznie w zakładkach ładowanych skryptem, może ujrzeć w logach poprawne kody 200 i jednocześnie nie mieć w odpowiedziach asystentów żadnej wzmianki o swojej ofercie, bo w pierwszej odpowiedzi serwera tej treści nie ma.
Wnioski techniczne bywają najszybsze do wdrożenia. Usunięcie zbędnych przekierowań, odblokowanie robotów na zaporze czy poprawienie linków prowadzących do nieistniejących adresów to zmiany, których skutek widać w kolejnych logach. Przy zmianach w pliku robots.txt potrzeba cierpliwości: OpenAI podaje, że dostosowanie systemów do nowej treści tego pliku w zakresie wyników wyszukiwania może zająć około doby. Porządkowanie takich kwestii wchodzi w zakres SEO technicznego, a wnioski dotyczące treści łączymy z działaniami opisanymi w usłudze pozycjonowania AI.
Typowe pomyłki przy czytaniu logów
Pierwsza pomyłka to utożsamianie liczby pobrań z popularnością. Robot zbierający dane do trenowania może pobrać cały serwis i nie ma to związku z tym, czy asystent kiedykolwiek poleci firmę. Druga to ufanie nazwie klienta bez sprawdzenia adresu IP. Trzecia to wyciąganie wniosków z jednego dnia, choć roboty przychodzą falami. Czwarta to pomijanie pośrednika: jeżeli zapora odrzuca roboty, zanim dotrą do serwera, log pokaże pustkę. Piąta to zbyt pochopne blokowanie. Anthropic przypomina, że zablokowanie Claude-User ogranicza możliwość pobrania treści w odpowiedzi na pytania użytkowników, a OpenAI, że zablokowanie OAI-SearchBot wyłącza stronę z odpowiedzi wyszukiwania w ChatGPT. Jeżeli kłopotem jest obciążenie serwera, łagodniejszym środkiem bywa spowolnienie robota: Anthropic deklaruje, że ClaudeBot respektuje dyrektywę Crawl-delay w pliku robots.txt.
- Logi z co najmniej kilku tygodni zostały pobrane i zarchiwizowane.
- Wiersze odfiltrowano po nazwach robotów z oficjalnej dokumentacji dostawców.
- Najaktywniejsze adresy IP porównano z listami publikowanymi przez dostawców.
- Roboty podzielono na trzy rodzaje: trenowanie, wyszukiwanie, żądanie użytkownika.
- Powstało zestawienie najczęściej pobieranych adresów i rozkład kodów odpowiedzi.
- Każdą serię kodów 403, 404, 429 i 5xx wyjaśniono.
- Listę ważnych podstron porównano z listą adresów faktycznie pobranych.
- Pobrań przez roboty nie doliczono do wizyt ludzi w raportach.
Kiedy warto sięgnąć po pomoc
Samodzielna analiza sprawdza się przy stronie firmowej z kilkudziesięcioma podstronami i jednym serwerem. Wsparcie specjalisty przydaje się wtedy, gdy logi liczą miliony wierszy, ruch przechodzi przez kilka warstw pośredników albo roboty dostają błędy, których przyczyny nie widać w panelu. W takich sytuacjach analizę logów łączymy z audytem SEO, a powtarzalne zestawienia przygotowujemy w ramach analityki i raportowania SEO. Uporządkowanie dostępu usuwa przeszkody techniczne, natomiast o tym, czy asystent przywoła stronę, decyduje jej treść i wiarygodność.
Jeśli chcą Państwo zamówić SEO techniczne, zachęcamy do kontaktu: tel. 222 500 844 lub mailowo: biuro@pozycjonowaniestron.pl
Najczęstsze pytania
Czy roboty AI widać w Google Analytics?
Zasadniczo nie, ponieważ analityka liczy wizyty na podstawie kodu wykonywanego w przeglądarce, a robot pobierający sam dokument tego kodu nie uruchamia. W analityce widać natomiast ludzi, którzy kliknęli link w odpowiedzi asystenta.
Jak długo hosting przechowuje logi?
Zależy to od firmy hostingowej i ustawień konta. Z naszej praktyki wynika, że bywa to okres od kilku dni do kilku tygodni, dlatego warto włączyć archiwizację w panelu i regularnie pobierać pliki na własny dysk.
Dlaczego w logach nie ma wpisów Google-Extended?
Ponieważ Google-Extended nie jest osobnym robotem. Według dokumentacji Google to nazwa używana wyłącznie w pliku robots.txt, bez własnego ciągu znaków klienta w żądaniach. Pobieranie odbywa się pod dotychczasowymi nazwami robotów Google.
Czy duża liczba pobrań przez robota oznacza, że asystent poleca firmę?
Nie. Robot zbierający dane do trenowania modeli może pobrać cały serwis i nie wynika z tego żadna rekomendacja. Więcej mówią pobrania przez roboty działające na żądanie użytkownika, ale i one świadczą tylko o tym, że stronę przeczytano przy okazji czyjegoś pytania.
Robot dostaje kod 403, choć niczego nie blokowano. Skąd to się bierze?
Najczęściej odpowiada za to zapora hostingu, sieć dostarczania treści lub wtyczka bezpieczeństwa, która odrzuca ruch uznany za maszynowy. Warto przejrzeć ich ustawienia, a w razie potrzeby poprosić hosting o wskazanie reguły, która zadziałała.
Czy do analizy logów potrzebne jest specjalne oprogramowanie?
Przy małej i średniej stronie wystarczy arkusz kalkulacyjny z filtrem i tabelą przestawną. Przy dużych plikach pomaga wstępne odfiltrowanie wierszy poleceniem grep, po którym wynik mieści się w arkuszu.
Źródła
- Log Files - Apache HTTP Server Version 2.4, The Apache Software Foundation
- Overview of OpenAI Crawlers, OpenAI
- Publishers and Developers - FAQ, OpenAI Help Center
- Does Anthropic crawl data from the web, and how can site owners block the crawler?, Claude Help Center
- Perplexity Crawlers, Perplexity
- Typowe roboty Google, Google for Developers
- Moduły pobierania uruchamiane przez użytkownika w Google, Google for Developers
- Weryfikowanie żądań od robotów i modułów pobierania Google, Google for Developers
- Jak kody stanu HTTP wpływają na roboty Google, Google for Developers
Funkcje wyszukiwarek i asystentów AI zmieniają się szybko, dlatego wpis aktualizujemy po większych zmianach.