Perplexity to wyszukiwarka, która zamiast listy linków podaje gotową odpowiedź, a przy każdym fragmencie umieszcza numerowany przypis prowadzący do strony źródłowej. O tym, czy wśród tych przypisów znajdzie się strona Państwa firmy, decydują trzy rzeczy: dostęp robotów serwisu do witryny, obecność strony w jego indeksie oraz to, czy treść wprost odpowiada na zadane pytanie. Poniżej opisujemy cały mechanizm, wskazujemy miejsca, w których można go sprawdzić, oraz pokazujemy, jak odnaleźć wizyty z Perplexity w Google Analytics.
Czym jest Perplexity i jak powstaje odpowiedź z przypisami
Perplexity jest wyszukiwarką opartą na modelach językowych: przyjmuje pytanie zadane zwykłym zdaniem, przeszukuje internet i zwraca krótkie omówienie tematu, w którym każda informacja ma wskazane źródło. W pomocy serwisu proces ten opisano jako trzy następujące po sobie czynności. Najpierw system ustala, o co naprawdę pyta użytkownik, z uwzględnieniem kontekstu i niuansów pytania. Następnie przeszukuje sieć i zbiera informacje ze stron, artykułów i czasopism. Na końcu zestawia najważniejsze ustalenia w jedną spójną odpowiedź napisaną językiem rozmowy.
Z punktu widzenia właściciela strony najważniejszy jest ostatni element tej układanki. Pomoc serwisu podaje, że każda odpowiedź zawiera numerowane cytowania, które prowadzą do pierwotnych źródeł, tak aby użytkownik mógł zweryfikować informację albo zgłębić temat. Przypis nie jest więc ozdobnikiem, tylko linkiem do konkretnej podstrony. Jeżeli hydraulik z Łodzi opisał na swojej stronie, jak rozpoznać nieszczelność instalacji, a użytkownik zapyta o to Perplexity, to właśnie ta podstrona może pojawić się pod jednym z numerów obok zdania, które z niej pochodzi.
Odpowiedź nie powstaje z pamięci modelu, lecz z dokumentów pobranych w chwili pytania lub wcześniej zapisanych w indeksie. Ten sposób pracy nosi nazwę generowania wspomaganego wyszukiwaniem i omawiamy go szerzej we wpisie RAG i grounding: dlaczego asystenci AI cytują strony internetowe. Dla firmy wynika z tego prosty wniosek: aby strona trafiła do przypisu, system musi móc ją znaleźć, pobrać i odczytać, a potem uznać jej fragment za przydatny do zbudowania odpowiedzi.
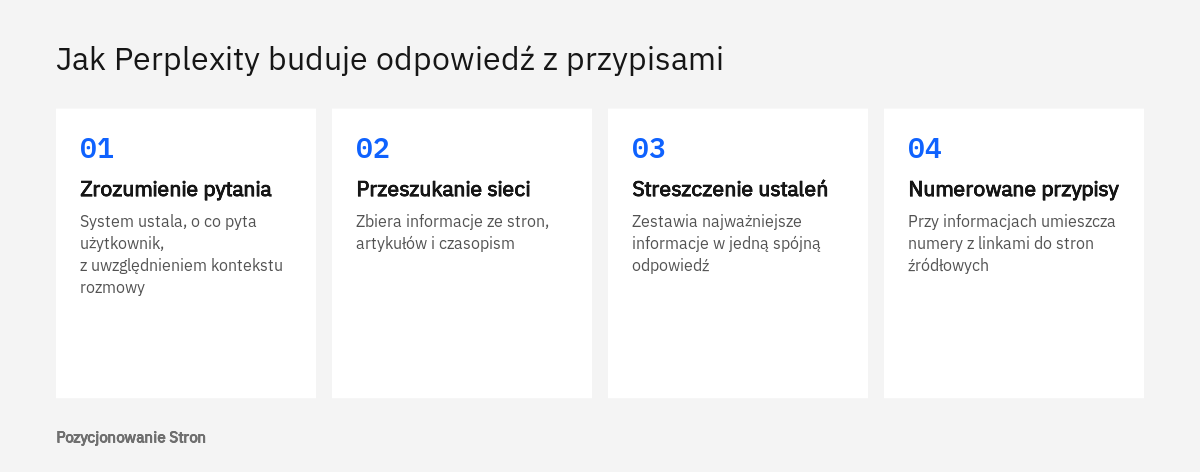
Numer umieszczony przy zdaniu lub akapicie odpowiedzi, połączony z linkiem do strony, z której pochodzi dana informacja.
Tryby wyszukiwania w Perplexity a liczba źródeł w odpowiedzi
Liczba stron, z których korzysta Perplexity, zależy od trybu wybranego przez użytkownika: zwykłe wyszukiwanie opiera się na niewielu źródłach, a tryby rozszerzone sięgają po dziesiątki lub setki dokumentów. Im więcej źródeł czyta system, tym więcej miejsc w przypisach.
Zgodnie z opisem funkcji Pro Search w pomocy serwisu tryb ten jest przeznaczony do pytań złożonych i niejednoznacznych. System wykonuje wtedy wiele wyszukiwań w artykułach, publikacjach naukowych, na forach i w materiałach wideo, czyta i analizuje dziesiątki źródeł, a następnie układa z nich jedną uporządkowaną odpowiedź. Ta sama strona pomocy zestawia to ze zwykłym wyszukiwaniem, które korzysta z jednego lub dwóch źródeł. Jeszcze dalej idzie tryb Research, czyli pogłębione badanie tematu. Według pomocy serwisu uruchamia on wiele wyszukiwań automatycznie, czyta setki źródeł i w ciągu od dwóch do czterech minut przygotowuje obszerny raport.
| Tryb | Do czego służy | Zakres źródeł według pomocy serwisu |
|---|---|---|
| Zwykłe wyszukiwanie | Szybka odpowiedź na proste pytanie | Jedno lub dwa źródła |
| Pro Search | Pytania złożone, wymagające porównania wielu informacji | Dziesiątki źródeł z wielu wyszukiwań |
| Research | Obszerny raport na zadany temat | Setki źródeł, praca trwa od dwóch do czterech minut |
Przy zwykłym wyszukiwaniu do odpowiedzi trafiają nieliczne strony, więc liczy się bardzo dobre dopasowanie do pytania. W trybach rozszerzonych system rozbija pytanie na wątki i dla każdego szuka osobnych materiałów. Sklep z Poznania sprzedający ekspresy do kawy może nie pojawić się przy ogólnym pytaniu o najlepszy ekspres, ale ma szansę na przypis przy wątku o odkamienianiu konkretnego typu urządzenia, jeśli opisał tę czynność na osobnej podstronie.
Roboty Perplexity opisane w dokumentacji serwisu
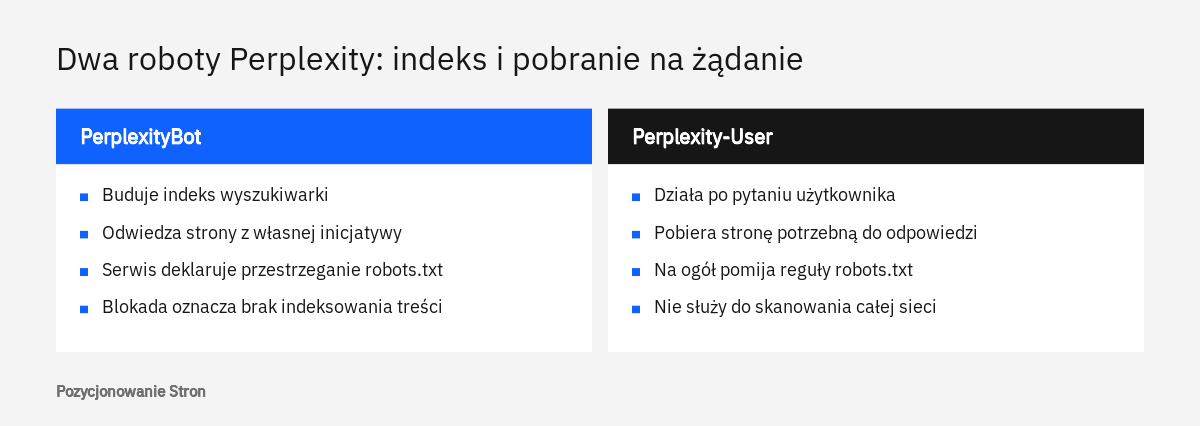
Perplexity korzysta z dwóch oficjalnie opisanych robotów: PerplexityBot oraz Perplexity-User. Oba przedstawia strona Perplexity Crawlers w dokumentacji serwisu, wraz z pełnymi nazwami, którymi roboty przedstawiają się serwerowi, oraz adresami plików z zakresami numerów IP. To pierwsze miejsce, które warto otworzyć przed jakąkolwiek zmianą w konfiguracji strony.
PerplexityBot służy do tego, aby strony były znajdowane i linkowane w wynikach wyszukiwania Perplexity. Dokumentacja zaznacza, że robot ten nie zbiera treści na potrzeby trenowania podstawowych modeli sztucznej inteligencji, i zaleca zezwolenie mu na dostęp w pliku robots.txt, jeśli właścicielowi zależy na obecności w wynikach. Perplexity-User pełni inną funkcję: obsługuje działania użytkowników. Gdy ktoś zada pytanie, robot ten może odwiedzić stronę, aby pomóc w przygotowaniu odpowiedzi, i umieścić w niej link do tej strony. On również, jak podaje dokumentacja, nie służy ani do systematycznego skanowania sieci, ani do trenowania modeli.
| Cecha | PerplexityBot | Perplexity-User |
|---|---|---|
| Zadanie | Budowa indeksu, dzięki któremu strony pojawiają się i są linkowane w wynikach | Odwiedzenie strony w związku z pytaniem konkretnego użytkownika |
| Stosunek do robots.txt | Serwis deklaruje przestrzeganie reguł i zaleca zezwolenie na dostęp | Według dokumentacji na ogół pomija reguły, ponieważ pobranie zlecił użytkownik |
| Fragment nazwy w nagłówku User-Agent | PerplexityBot/1.0 | Perplexity-User/1.0 |
| Trenowanie modeli | Nie, zgodnie z dokumentacją | Nie, zgodnie z dokumentacją |
Nagłówek User-Agent to krótki tekst, którym każdy program łączący się z serwerem informuje, kim jest. Taki podpis może jednak wpisać każdy, kto napisze własny program pobierający strony. Dlatego dokumentacja Perplexity udostępnia dwa pliki z aktualnymi zakresami adresów IP, osobny dla każdego robota, i zaleca łączenie obu metod: dopasowania nazwy w nagłówku oraz weryfikacji adresu, z którego przyszło żądanie.
Gdzie zobaczyć wizyty robotów na własnej stronie
Wizyt robotów nie widać w Google Analytics, ponieważ narzędzie to rejestruje zachowanie ludzi w przeglądarce. Ślad po robotach zostaje w dziennikach serwera, czyli w plikach, w których serwer zapisuje każde żądanie wraz z adresem IP, pobranym adresem i nagłówkiem User-Agent. Dostęp do nich daje zwykle panel hostingu, w części poświęconej statystykom lub logom. Wystarczy wyszukać w pliku słowa PerplexityBot oraz Perplexity-User, aby ustalić, czy roboty docierają do strony, które podstrony pobierają i jaki kod odpowiedzi otrzymują. Kod z grupy 200 oznacza, że strona została wydana poprawnie, a kody 403 lub 429 sugerują, że żądanie zatrzymała zapora albo limit połączeń. Znaczenie poszczególnych grup wyjaśniamy we wpisie o tym, jak roboty traktują kody odpowiedzi HTTP.
Indeksowanie a pobranie strony na żądanie użytkownika
Indeksowanie polega na tym, że robot zawczasu odwiedza strony i zapisuje je w bazie wyszukiwarki, natomiast pobranie na żądanie następuje w chwili, gdy konkretna osoba zadaje pytanie, a system uznaje, że odpowiedź wymaga zajrzenia na daną stronę. W Perplexity pierwszą czynność wykonuje PerplexityBot, drugą Perplexity-User. To rozróżnienie decyduje o tym, co faktycznie daje wpis w pliku robots.txt.
Plik robots.txt to zwykły plik tekstowy w głównym katalogu witryny, który informuje roboty, do jakich adresów mogą mieć dostęp. Dokumentacja Google poświęcona temu plikowi przypomina, że nie da się nim wymusić zachowania robota: znane roboty na ogół stosują się do reguł, ale inne mogą tego nie robić, dlatego do ochrony danych poufnych służą inne metody, na przykład hasło.
Strona pomocy o stosowaniu się Perplexity do robots.txt podaje, że PerplexityBot nie indeksuje pełnej ani częściowej treści witryny, która mu tego zabroniła. Zarazem zastrzega, że w przypadku zablokowanej strony serwis nadal może zaindeksować domenę, nagłówek oraz krótkie, rzeczowe streszczenie. Ta sama strona informuje, że Perplexity korzysta też z zewnętrznych dostawców, którzy pomagają budować indeks, i że umowy z nimi zostały zmienione tak, aby również oni respektowali robots.txt.
Inaczej wygląda sprawa z robotem Perplexity-User. Dokumentacja dla deweloperów stwierdza, że skoro pobranie zlecił użytkownik, robot ten na ogół pomija reguły robots.txt. Jednocześnie strona pomocy podaje, że możliwość streszczenia wskazanego adresu mimo blokady w robots.txt została wyłączona. Oba opisy nie pokrywają się w pełni, dlatego bezpieczniej przyjąć ostrożne założenie: wpis w robots.txt skutecznie steruje indeksowaniem przez PerplexityBot, ale nie daje pewności, że strona nigdy nie zostanie pobrana na żądanie. Jeżeli jakaś treść nie powinna być dostępna dla nikogo z zewnątrz, należy ją zabezpieczyć logowaniem lub zaporą, a nie samym plikiem tekstowym.
User-agent: PerplexityBot
Allow: /
Disallow: /panel-klienta/
Dokumentacja Perplexity zaznacza, że po zmianie ustawień w robots.txt systemy serwisu mogą potrzebować do 24 godzin, aby ją uwzględnić. Nie należy więc oceniać efektu zmiany godzinę po jej wprowadzeniu. Warto też wiedzieć, że w wielu witrynach blokada nie wynika ze świadomej decyzji. Bywa pozostałością po wtyczce, która jednym przełącznikiem zamknęła dostęp wszystkim robotom związanym ze sztuczną inteligencją, albo po ogólnej regule wprowadzonej na czas budowy strony. Przegląd pliku pod tym kątem wchodzi w zakres SEO technicznego i potrafi wyjaśnić, dlaczego dobra treść nie pojawia się w żadnych przypisach.
Zapora i serwer: jak nie zablokować robotów Perplexity przypadkiem
Robot może mieć pełne pozwolenie w robots.txt, a mimo to nie pobrać strony, jeśli zatrzyma go zapora aplikacyjna, czyli usługa filtrująca ruch przed serwerem, znana pod skrótem WAF. Dokumentacja Perplexity poświęca temu osobną część i stwierdza wprost, że przy korzystaniu z takiej zapory może być konieczne wyraźne dopuszczenie robotów serwisu.
Zalecany sposób jest ten sam niezależnie od dostawcy zapory. Należy utworzyć regułę, która przepuszcza żądania spełniające jednocześnie dwa warunki: nagłówek User-Agent zawiera nazwę PerplexityBot lub Perplexity-User, a adres IP nadawcy mieści się w zakresach opublikowanych przez serwis. Taka reguła powinna mieć wyższy priorytet niż reguły blokujące. Dokumentacja zwraca też uwagę, że zakresy adresów są regularnie aktualizowane, dlatego reguły warto odświeżać automatycznie na podstawie oficjalnych plików, zamiast przepisywać adresy ręcznie raz na zawsze.
- Odczyt pliku robots.txt
Pod adresem domeny z dopiskiem /robots.txt należy ustalić, czy nie ma reguł zabraniających dostępu robotowi PerplexityBot ani ogólnej blokady wszystkich robotów.
- Przegląd dzienników serwera
Wyszukanie nazw obu robotów pokazuje, czy docierają do strony i jakie kody odpowiedzi otrzymują.
- Kontrola zapory i zabezpieczeń hostingu
W panelu zapory lub w ustawieniach ochrony przed botami warto ustalić, czy żądania robotów nie są odrzucane lub kierowane do testu weryfikującego człowieka.
- Reguła dopuszczająca
Jeśli blokada występuje, należy dodać regułę łączącą nazwę robota z opublikowanymi zakresami adresów IP i ustawić ją przed regułami blokującymi.
- Ponowna kontrola po dobie
Po upływie 24 godzin warto ponownie przejrzeć dzienniki i zadać w Perplexity pytanie, na które odpowiada dana podstrona.
Druga częsta przeszkoda leży po stronie samej witryny. Dokumentacja Perplexity nie opisuje, czy i w jakim zakresie roboty serwisu wykonują skrypty, dlatego z praktyki agencji wynika ostrożna zasada: najważniejsze informacje, takie jak opis usługi, zakres, cena czy dane kontaktowe, powinny znajdować się w kodzie strony od razu po jej pobraniu, a nie pojawiać się dopiero po wykonaniu skryptów w przeglądarce.
Jeśli chcą Państwo zamówić pozycjonowanie AI, zachęcamy do kontaktu: tel. 222 500 844 lub mailowo: biuro@pozycjonowaniestron.pl
Jak rozpoznać ruch z Perplexity w Google Analytics
Wizyty osób, które kliknęły przypis w Perplexity, widać w Google Analytics w raporcie Pozyskiwanie ruchu po zmianie wymiaru na źródło sesji. Zgodnie z pomocą Analytics dotyczącą tego raportu ścieżka prowadzi przez Raporty, następnie sekcję Pozyskanie i pozycję Pozyskiwanie ruchu. Raport pokazuje, skąd pochodzą zarówno nowi, jak i powracający użytkownicy, w odróżnieniu od raportu Pozyskiwanie użytkowników, który obejmuje wyłącznie źródła nowych osób.
Domyślnym wymiarem raportu jest „Sesja - domyślne grupowanie kanałów”. Z listy rozwijanej nad pierwszą kolumną tabeli można wybrać inne wymiary: „Sesja - źródło”, „Sesja - medium”, „Sesja - źródło/medium”, „Sesja - kampania” oraz „Sesja - platforma źródłowa”. Po wybraniu wymiaru „Sesja - źródło/medium” wystarczy wpisać w pole wyszukiwania nad tabelą słowo perplexity. Raport pokaże wtedy wiersze, w których źródło zawiera tę nazwę, razem z liczbą sesji, sesjami z zaangażowaniem, współczynnikiem zaangażowania, kluczowymi zdarzeniami i łącznymi przychodami.
Kanał Asystent AI i jego ograniczenia
W domyślnej grupie kanałów Analytics istnieje kanał o nazwie Asystent AI. Pomoc Analytics opisująca domyślną grupę kanałów wyjaśnia, że obejmuje on ruch z asystentów AI i wymienia jako przykłady ChatGPT, Gemini, Deepseek, Copilot oraz Grok. Trafia tam ruch, dla którego witryna odsyłająca pasuje do listy asystentów prowadzonej przez Google. Kanał ten nie obejmuje Przeglądów od AI ani Trybu AI w wyszukiwarce Google, ponieważ ten ruch Analytics zalicza do wyników organicznych.
Perplexity nie jest wymieniony wśród przykładów na tej stronie pomocy, więc nie można z góry zakładać, że jego wizyty znajdą się w kanale Asystent AI. Mogą trafić także do kanału Ruch z witryn odsyłających, który obejmuje ruch z medium o wartości referral, app lub link. Z praktyki agencji wynika ponadto, że część kliknięć, zwłaszcza z aplikacji, nie przekazuje informacji o pochodzeniu i zasila kanał Bezpośrednie. Liczby w Analytics należy więc traktować jako dolną granicę, a nie pełny obraz.
Własna grupa kanałów z osobnym wierszem dla Perplexity
Porządek w danych zapewnia niestandardowa grupa kanałów, w której Perplexity otrzymuje własny wiersz. Pomoc Analytics o niestandardowych grupach kanałów podaje ścieżkę: Administracja, sekcja Wyświetlanie danych, pozycja Grupy kanałów. Potrzebna jest rola Edytującego lub wyższa. Przycisk tworzenia nowej grupy kanałów zakłada kopię grupy domyślnej, której nadaje się nazwę i opcjonalny opis. Następnie opcja dodawania nowego kanału pozwala zdefiniować warunki, na przykład wymiar Źródło z dopasowaniem do wyrażenia regularnego.
.*perplexity.*Dokładną postać warunku warto dobrać do wartości, które rzeczywiście występują w Państwa raporcie. Według pomocy Analytics wielkość liter w definicjach kanałów nie jest uwzględniana. Ważna jest natomiast kolejność: ruch trafia do pierwszego kanału, do którego definicji pasuje, dlatego nowy kanał należy przesunąć nad kanał witryn odsyłających, korzystając z opcji zmiany kolejności. Na końcu trzeba zapisać kanał, a potem całą grupę.
Pomoc podaje też ograniczenia: w usługach standardowych można utworzyć dwie niestandardowe grupy kanałów, a w każdej zmieści się do 50 kanałów. Niestandardowe grupy można stosować w raportach także do danych historycznych, więc utworzenie kanału dzisiaj pozwala obejrzeć również wcześniejsze miesiące. Sama liczba sesji mówi niewiele, dlatego warto dodać do raportu stronę docelową i ustalić, które podstrony przyciągają wizyty z przypisów oraz czy kończą się one kluczowymi zdarzeniami. Stałe zestawianie tych danych z innymi źródłami ruchu to zadanie z zakresu analityki i raportowania SEO.
Jakie cechy treści sprzyjają temu, że strona trafia do przypisów
Perplexity nie publikuje listy czynników, które decydują o wyborze źródeł, dlatego nie istnieje ustawienie ani znacznik gwarantujący cytowanie. Z opisu działania serwisu wynika jednak, czego system szuka: informacji ze źródeł uznawanych za wiarygodne, z których da się wyjąć fragment najlepiej odpowiadający na pytanie. Na tej podstawie oraz na podstawie obserwacji z praktyki agencji można wskazać cechy, które takiemu wyborowi sprzyjają. Żadna z nich nie daje pewności efektu.
Pierwszą cechą jest odpowiedź podana wprost. System buduje odpowiedź ze zdań i akapitów, które same w sobie niosą pełną informację. Akapit zaczynający się od konkretnego stwierdzenia nadaje się do zacytowania dużo lepiej niż wstęp, który przez kilka zdań krąży wokół tematu. Jak układać takie otwarcia, pokazujemy we wpisie Pierwszy akapit tekstu: jak napisać wstęp, który od razu odpowiada na pytanie.
Drugą cechą jest konkret, którego nie ma gdzie indziej. Wytyczne Google dotyczące przydatnych treści zadają pytanie, czy tekst zawiera własne informacje, badania lub analizy i czy wnosi coś ponad to, co już jest w sieci. Wytyczne te dotyczą wyszukiwarki Google, a nie Perplexity, ale opisują ten sam problem: jeżeli dziesięć stron powtarza to samo ogólne zdanie, system nie ma powodu sięgać akurat po Państwa stronę. Powód pojawia się wtedy, gdy na stronie znajduje się coś własnego, na przykład zestawienie czasu realizacji poszczególnych usług albo tabela parametrów produktów.
Trzecią cechą jest czytelna struktura: nagłówki sformułowane jak pytania klientów, krótkie akapity poświęcone jednej sprawie i tabele z jednoznacznymi nagłówkami kolumn ułatwiają odnalezienie właściwego fragmentu. Czwartą jest wiarygodność. Wytyczne Google pytają, czy informacje są podparte źródłami, czy widać, kto jest autorem, i czy tekst nie zawiera błędów łatwych do sprawdzenia. Strona z podpisanym autorem, danymi firmy i odesłaniami do źródeł jest bezpieczniejszym materiałem na przypis niż anonimowy tekst. Znaczenie ma także to, czy o firmie piszą inni, co omawiamy we wpisie Wzmianki o marce i digital PR: skąd modele wiedzą, kogo polecić.
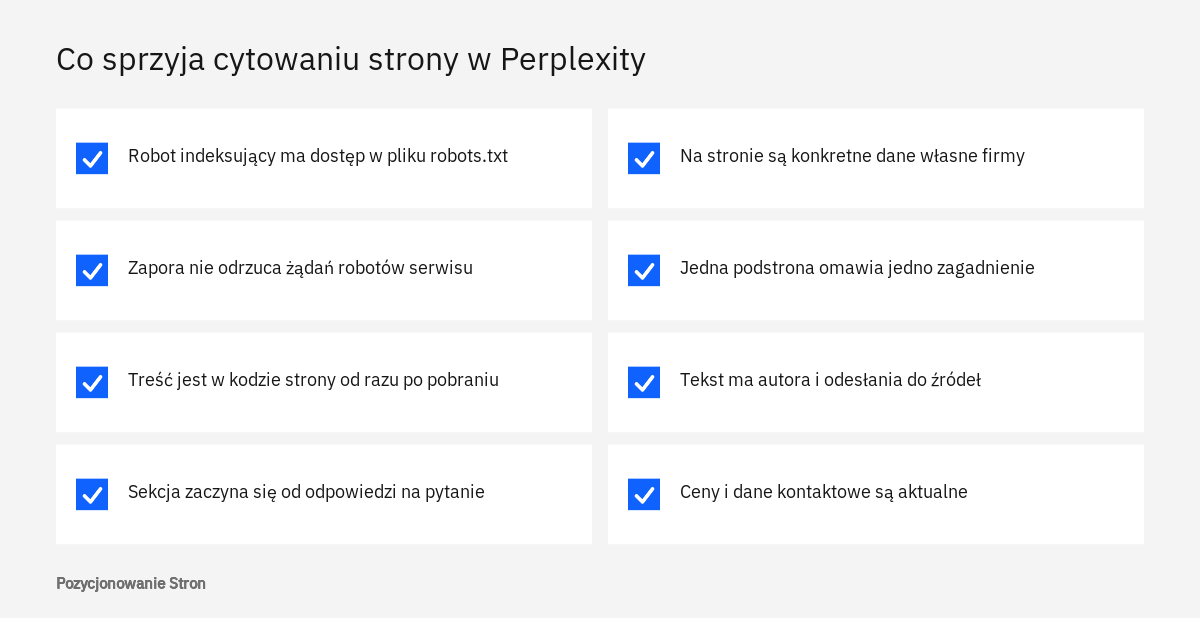
- PerplexityBot ma dostęp do witryny w pliku robots.txt i nie jest zatrzymywany przez zaporę.
- Najważniejsza treść podstrony znajduje się w kodzie strony od razu po pobraniu, bez logowania.
- Każda sekcja zaczyna się od zdania, które odpowiada na pytanie z nagłówka.
- Na stronie są konkretne dane własne: zakres usługi, czas realizacji, warunki, parametry, sposób wyceny.
- Jedna podstrona odpowiada na jedno zagadnienie, a szczegółowe pytania mają osobne sekcje lub wpisy.
- Tekst ma podpisanego autora i odesłania do źródeł tam, gdzie powołuje się na przepisy lub dokumentację.
Dobrym sprawdzianem jest prosty test: wybrać jeden akapit ze swojej strony i ocenić, czy przeniesiony w całości do cudzej odpowiedzi nadal byłby zrozumiały i prawdziwy. Sklep z Poznania, który w opisie kategorii pisze o „szerokiej ofercie w atrakcyjnych cenach”, nie daje systemowi niczego do zacytowania. Ten sam sklep, opisując, czym różnią się dwa typy młynków i dla kogo jest każdy z nich, tworzy fragment gotowy do użycia. Przygotowywaniem takich materiałów zajmujemy się w ramach treści SEO, a całość działań pod kątem asystentów obejmuje pozycjonowanie AI.
Typowe pomyłki i sytuacje, w których potrzebna jest pomoc
Najczęstszą pomyłką jest szukanie przyczyny braku cytowań w treści, podczas gdy robot w ogóle nie dociera do strony. Kolejność pracy powinna być odwrotna: najpierw dostęp, potem indeks, na końcu jakość fragmentów. Poprawianie tekstów na stronie, którą zapora odrzuca kodem 403, nie przyniesie żadnej zmiany.
Druga pomyłka to traktowanie robots.txt jak zamka do drzwi. Jak wynika z dokumentacji, plik ten steruje robotem indeksującym, natomiast pobrania zlecone przez użytkownika rządzą się innymi zasadami, a zablokowana strona wciąż może być reprezentowana w serwisie przez domenę, nagłówek i krótkie streszczenie. Firmy, które blokują roboty z obawy o wykorzystanie treści do trenowania modeli, powinny wziąć pod uwagę deklarację Perplexity, że serwis nie buduje własnych modeli podstawowych i nie używa treści stron do ich wstępnego trenowania.
Trzecia pomyłka dotyczy pomiaru. Brak wiersza z Perplexity w domyślnym widoku raportu nie oznacza braku wizyt, ponieważ mogą one być rozproszone po kilku kanałach. Zdarza się też sytuacja odwrotna: firma jest cytowana, ale użytkownicy nie klikają przypisów, bo odpowiedź w pełni zaspokoiła ich potrzebę. Dlatego pomiar ruchu warto uzupełniać ręcznym przeglądem odpowiedzi na stałą listę pytań.
Czwarta pomyłka to oczekiwanie stałości. Odpowiedzi Perplexity powstają na nowo przy każdym pytaniu i zależą od trybu, sformułowania oraz wcześniejszej rozmowy, więc ta sama osoba może dwa razy otrzymać inne przypisy. Wnioski należy wyciągać z powtarzanych obserwacji, a stałego miejsca w przypisach nikt uczciwie nie obieca.
Pomoc specjalisty przydaje się zwłaszcza wtedy, gdy strona działa za zaporą i trzeba bezpiecznie skonfigurować reguły dla robotów, gdy treść serwisu pojawia się dopiero po wykonaniu skryptów, gdy w Analytics trzeba uporządkować źródła ruchu z asystentów, a także wtedy, gdy Perplexity podaje o firmie nieaktualne lub błędne informacje. Ten ostatni przypadek omawiamy we wpisie Błędne informacje o firmie w AI.
Jeśli chcą Państwo zamówić pozycjonowanie AI, zachęcamy do kontaktu: tel. 222 500 844 lub mailowo: biuro@pozycjonowaniestron.pl
Najczęstsze pytania
Czy Perplexity korzysta z wyników Google?
Dokumentacja serwisu opisuje własnego robota indeksującego PerplexityBot oraz wspomina o zewnętrznych dostawcach, którzy pomagają budować indeks, bez podawania ich nazw. Nie znaleźliśmy w niej potwierdzenia, że źródłem są wyniki konkretnej wyszukiwarki. Dobra widoczność w Google nie oznacza więc automatycznie obecności w przypisach Perplexity.
Czy da się zgłosić stronę do indeksu Perplexity?
W dokumentacji robotów serwisu nie ma opisu formularza ani narzędzia do zgłaszania adresów. Zalecenie ogranicza się do zezwolenia robotowi PerplexityBot na dostęp w pliku robots.txt i dopuszczenia go w zaporze.
Czy zablokowanie PerplexityBot usuwa firmę z odpowiedzi?
Niekoniecznie. Według pomocy serwisu robot nie zaindeksuje wtedy treści strony, ale serwis nadal może zaindeksować domenę, nagłówek i krótkie streszczenie. Informacje o firmie mogą też pochodzić z innych witryn, które o niej piszą.
Jak szybko Perplexity zauważa zmiany w robots.txt?
Dokumentacja podaje, że uwzględnienie zmian w pliku robots.txt może potrwać do 24 godzin. Zmiany w regułach zapory także wymagają czasu, choć serwis nie wskazuje tu konkretnego terminu.
Dlaczego w Analytics nie widać wizyt z Perplexity, skoro firma jest cytowana?
Możliwe są dwie przyczyny. Użytkownicy mogli przeczytać odpowiedź bez klikania przypisu albo wizyty zostały przypisane do innego kanału, na przykład do wejść bezpośrednich. Warto przejrzeć raport Pozyskiwanie ruchu z wymiarem „Sesja - źródło/medium” i wyszukać w nim nazwę serwisu.
Czy treści strony są używane do trenowania modeli Perplexity?
Serwis deklaruje, że żaden z dwóch opisanych robotów nie służy do trenowania podstawowych modeli AI, a Perplexity nie buduje własnych modeli podstawowych. Jest to deklaracja firmy zapisana w jej dokumentacji i pomocy. W razie wątpliwości prawnych warto skonsultować się z prawnikiem.
Źródła
- Perplexity Crawlers, Perplexity
- How does Perplexity work?, Perplexity Help Center
- What is Pro Search?, Perplexity Help Center
- How does Perplexity follow robots.txt?, Perplexity Help Center
- [GA4] Raport Pozyskiwanie ruchu, Pomoc Google Analytics
- Domyślna grupa kanałów, Pomoc Google Analytics
- Niestandardowe grupy kanałów, Pomoc Google Analytics
- Plik robots.txt - wprowadzenie i przewodnik, Centrum wyszukiwarki Google
- Tworzenie treści przydatnych, rzetelnych i ukierunkowanych na użytkowników, Centrum wyszukiwarki Google
Funkcje wyszukiwarek i asystentów AI zmieniają się szybko, dlatego wpis aktualizujemy po większych zmianach.