Prawo Unii Europejskiej pozwala kopiować publicznie dostępne treści po to, by analizować je maszynowo, także na potrzeby trenowania modeli AI, chyba że uprawniony wyraźnie się temu sprzeciwi. Taki sprzeciw nazywa się zastrzeżeniem eksploracji tekstów i danych, a w przypadku strony internetowej musi mieć postać, którą odczyta program, a nie tylko człowiek. Poniżej wyjaśniamy, skąd bierze się to prawo, jak wygląda w polskiej ustawie, gdzie na stronie umieścić zastrzeżenie i czego wolno po nim oczekiwać.
Czym jest eksploracja tekstów i danych i co ma wspólnego z trenowaniem AI
Eksploracja tekstów i danych to zautomatyzowana analiza materiałów cyfrowych, której celem jest wydobycie z nich informacji: wzorców, tendencji i zależności. Polska ustawa o prawie autorskim i prawach pokrewnych definiuje ją jako analizę tekstów i danych w postaci cyfrowej prowadzoną wyłącznie przy zastosowaniu zautomatyzowanej techniki, służącą wygenerowaniu określonych informacji, w szczególności wzorców, tendencji i korelacji. Brzmienie definicji można porównać w art. 6 ustawy.
Maszynowa analiza dużych zbiorów tekstów, obrazów, dźwięków lub danych, po której powstaje nowa wiedza. W dokumentach unijnych i technicznych występuje też pod angielskim skrótem TDM (text and data mining).
Samo analizowanie nie jest problemem prawnym. Kłopot polega na tym, że zanim program cokolwiek przeanalizuje, zwykle musi treść skopiować, a kopiowanie utworu to czynność zastrzeżona dla uprawnionego. Zwraca na to uwagę preambuła dyrektywy o prawie autorskim na jednolitym rynku cyfrowym: eksploracja może wiązać się ze zwielokrotnianiem utworów lub pobieraniem zawartości baz danych, a gdy nie ma zastosowania żaden wyjątek, potrzebna jest zgoda uprawnionych.
Związek z trenowaniem modeli opisuje wprost unijne rozporządzenie o sztucznej inteligencji, czyli AI Act. W jego preambule czytamy, że rozwój i trenowanie dużych modeli generatywnych wymaga dostępu do ogromnych ilości tekstów, obrazów, nagrań i innych danych, a techniki eksploracji tekstów i danych mogą być w tym celu szeroko stosowane do pozyskiwania i analizy treści chronionych. Dlatego przepisy pisane pierwotnie z myślą o analityce i badaniach stały się dziś podstawowym narzędziem właściciela strony, który nie chce, by jego opisy, teksty eksperckie czy zdjęcia zasilały cudze modele.
Pytaniem, do kogo należy tekst lub grafika wytworzona przez AI, zajmujemy się we wpisie prawo autorskie a treści z AI. Tutaj chodzi wyłącznie o Państwa własne treści i o to, jak formalnie wyłączyć je z maszynowego kopiowania.
Dwa wyjątki w prawie unijnym: badania naukowe i wszystkie pozostałe cele
Dyrektywa wprowadziła dwa odrębne wyjątki dla eksploracji tekstów i danych, a zastrzeżenie działa tylko wobec jednego z nich. Pierwszy wyjątek służy nauce i nie da się go wyłączyć. Drugi obejmuje wszystkich pozostałych, w tym firmy komercyjne, ale obowiązuje tylko dopóty, dopóki uprawniony nie zastrzeże swoich praw.
Wyjątek naukowy powstał dlatego, że uczelnie, organizacje badawcze i instytucje dziedzictwa kulturowego napotykały niepewność co do tego, w jakim zakresie wolno im maszynowo analizować treści. Preambuła dyrektywy wyjaśnia, że podmioty te powinny móc korzystać z wyjątku wobec treści, do których mają zgodny z prawem dostęp, a pojęcie to obejmuje również treści swobodnie dostępne w internecie.
Drugi wyjątek uzasadniono inaczej. Techniki eksploracji stosują także podmioty prywatne i publiczne: do analizowania dużych ilości danych, podejmowania decyzji biznesowych, rozwijania nowych aplikacji i technologii. Aby dać im pewność prawną, dyrektywa pozwala na zwielokrotnianie i pobieranie treści w tym celu oraz na przechowywanie kopii tak długo, jak jest to potrzebne. Stawia jednak dwa warunki: korzystający musi mieć zgodny z prawem dostęp do utworu, a uprawniony nie może wcześniej zastrzec w odpowiedni sposób swoich praw.
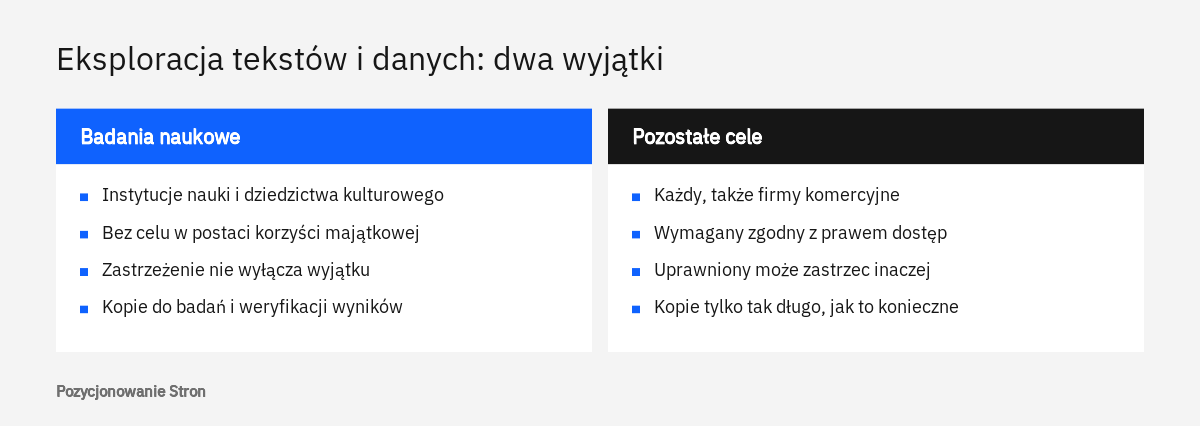
Dla właściciela strony wynikają z tego trzy praktyczne wnioski. Zastrzeżenie jest prawem, a nie obowiązkiem, i nikt nie złoży go za Państwa. Dotyczy wyłącznie eksploracji tekstów i danych: preambuła podkreśla, że nie powinno wpływać na inne sposoby korzystania z treści. Wreszcie nie zatrzyma naukowców działających w ramach pierwszego wyjątku.
Jak zastrzeżenie wygląda w polskiej ustawie o prawie autorskim
Polska wdrożyła oba wyjątki w dwóch sąsiednich przepisach ustawy o prawie autorskim i prawach pokrewnych, a kluczowy dla firm jest art. 26³. Jego pierwszy ustęp zawiera całą zasadę w jednym zdaniu: wolno zwielokrotniać rozpowszechnione utwory w celu eksploracji tekstów i danych, chyba że uprawniony zastrzegł inaczej.
Drugi ustęp mówi, jak zastrzeżenie złożyć. Ma być dokonane wyraźnie i odpowiednio do sposobu, w jaki utwór został udostępniony. Dla utworów udostępnionych publicznie w taki sposób, aby każdy mógł mieć do nich dostęp w miejscu i czasie przez siebie wybranym, a więc w praktyce dla treści w internecie, ustawa wymaga formatu przeznaczonego do odczytu maszynowego wraz z metadanymi. Po znaczenie tego formatu przepis odsyła do definicji z ustawy o otwartych danych i ponownym wykorzystywaniu informacji sektora publicznego.
Trzeci ustęp ogranicza tych, którzy z wyjątku korzystają: kopie wolno przechowywać wyłącznie w celu eksploracji tekstów i danych i tylko tak długo, jak jest to konieczne do osiągnięcia tego celu.
Wyjątek naukowy opisuje art. 26². Pozwala on instytucjom dziedzictwa kulturowego oraz wymienionym podmiotom systemu szkolnictwa wyższego i nauki zwielokrotniać utwory w celu eksploracji do celów badań naukowych, pod warunkiem że nie robią tego dla bezpośredniej lub pośredniej korzyści majątkowej. Kopie mogą być przechowywane do celów badań, w tym do weryfikacji wyników, z zabezpieczeniami dopuszczającymi do nich tylko upoważnione osoby. W tym przepisie nie ma słowa o zastrzeżeniu.
| Cecha | Eksploracja do celów badań naukowych | Eksploracja w pozostałych celach |
|---|---|---|
| Kto korzysta | Instytucje dziedzictwa kulturowego oraz wskazane podmioty szkolnictwa wyższego i nauki | Każdy, także firmy działające komercyjnie |
| Warunek | Brak celu w postaci korzyści majątkowej | Brak zastrzeżenia ze strony uprawnionego |
| Czy zastrzeżenie działa | Nie | Tak, jeśli jest wyraźne i ma właściwą formę |
| Przechowywanie kopii | Do celów badań, w tym weryfikacji wyników, z kontrolą dostępu | Wyłącznie na potrzeby eksploracji i tak długo, jak to konieczne |
Z brzmienia przepisu wynika jeszcze jedna rzecz: zastrzega „uprawniony”. Jeśli opisy produktów napisała dla Państwa zewnętrzna osoba, a zdjęcia pochodzą od fotografa, warto upewnić się w umowach, że to Państwa firma dysponuje prawami w zakresie pozwalającym takie zastrzeżenie złożyć. Dotyczy to także tekstów zamawianych u copywritera.
Co oznacza forma nadająca się do odczytu maszynowego
Forma nadająca się do odczytu maszynowego to taki zapis, który program zbierający treści może sam znaleźć i jednoznacznie zinterpretować, bez udziału człowieka. Roboty pobierają strony masowo i żaden z nich nie czyta regulaminów ani stopek tak, jak robi to klient.
Prawodawca unijny dał w preambule dyrektywy wskazówkę, jak to rozumieć. Dla treści udostępnionych publicznie w internecie za odpowiednie uznaje zastrzeżenie wyłącznie za pomocą środków nadających się do odczytu maszynowego i wymienia wśród nich metadane oraz warunki korzystania ze strony internetowej lub usługi. W innych sytuacjach zastrzeżenie może przybrać inną postać, na przykład postanowienia umowy albo jednostronnego oświadczenia.
Polski przepis jest sformułowany bardziej technicznie: mówi o formacie przeznaczonym do odczytu maszynowego wraz z metadanymi. Ani dyrektywa, ani polska ustawa nie wskazują natomiast jednego obowiązkowego pliku, znacznika czy protokołu. Dla przedsiębiorcy oznacza to niepewność: nie ma urzędowego formularza, który wystarczy wypełnić.
Tę lukę próbuje wypełnić Komisja Europejska. Prowadzi ona konsultacje w sprawie protokołów zastrzegania praw, wspierane przez Urząd Unii Europejskiej ds. Własności Intelektualnej. Ich celem jest uzgodnienie rozwiązań, które da się wdrożyć technicznie i które są szeroko przyjęte. Komisja zapowiada opublikowanie listy powszechnie uzgodnionych rozwiązań i jej przegląd co najmniej raz na dwa lata. Do tego czasu rozsądnie jest przyjąć zasadę kilku warstw: zastrzeżenie wyrażone na kilka uzupełniających się sposobów trudniej przeoczyć i trudniej podważyć.
Gdzie umieścić zastrzeżenie na stronie internetowej
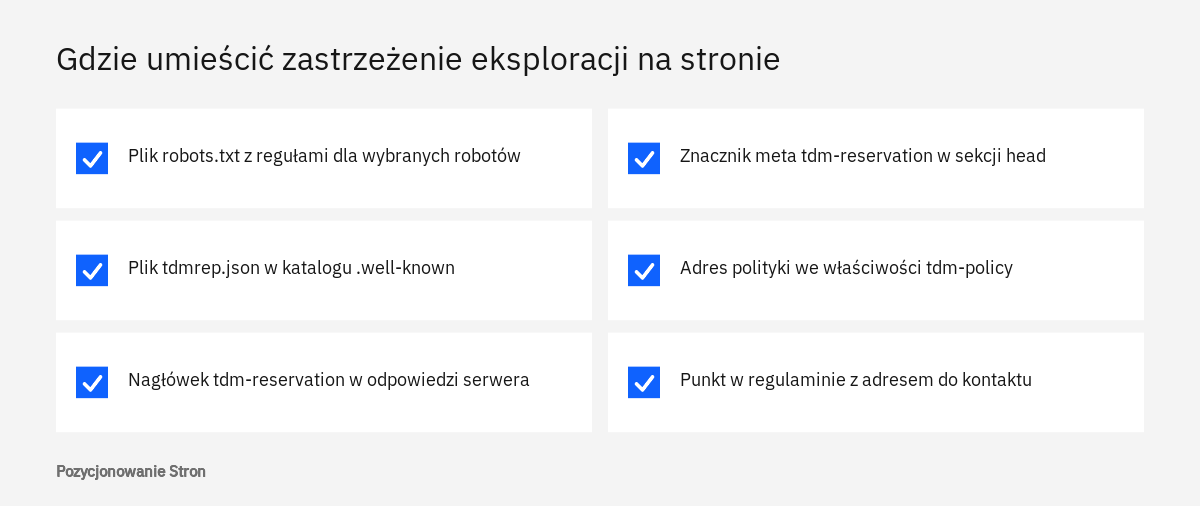
Zastrzeżenie umieszcza się w miejscach, do których robot zagląda, zanim pobierze treść: w pliku robots.txt, w pliku tdmrep.json w katalogu .well-known, w nagłówkach odpowiedzi serwera i w sekcji head kodu strony. Uzupełnieniem dla ludzi i na wypadek sporu jest zapis w regulaminie.
Plik robots.txt
Plik robots.txt to najpowszechniej odczytywany sposób przekazywania robotom instrukcji. Pozwala wskazać konkretnego robota po nazwie i zabronić mu dostępu do całej witryny albo do wybranych katalogów. Google udostępnia w tym celu osobny token Google-Extended: według dokumentacji typowych robotów Google wydawca decyduje nim, czy treści z jego witryny mogą służyć do trenowania przyszłych modeli Gemini oraz do osadzania odpowiedzi w treściach w aplikacjach Gemini. Token nie ma osobnego ciągu identyfikującego robota, nie wpływa na obecność witryny w wyszukiwarce Google i nie jest czynnikiem rankingowym.
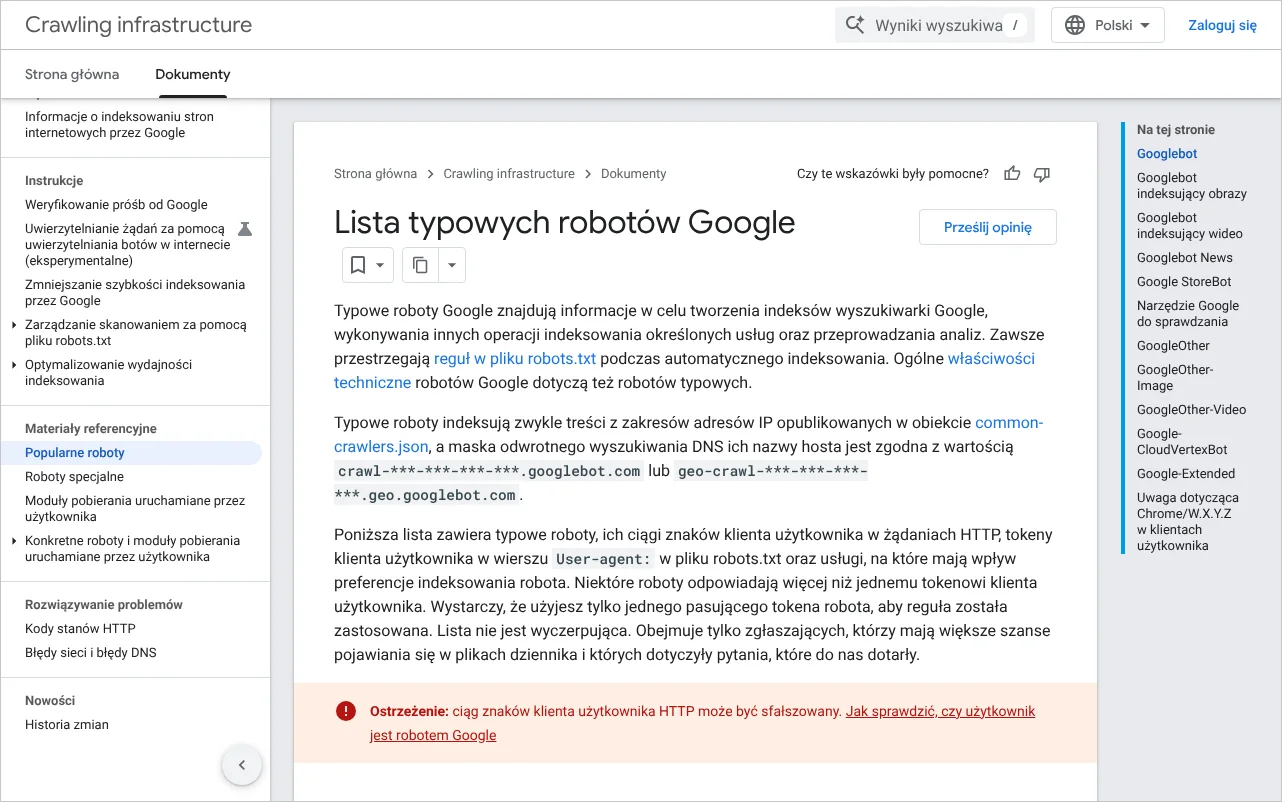
User-agent: Google-Extended
Disallow: /
Robots.txt ma dwie słabości. Jest listą nazwanych robotów, więc trzeba wiedzieć, komu się odmawia, i aktualizować wpisy. Ponadto, jak przypomina wprowadzenie Google do pliku robots.txt, instrukcje z tego pliku nie mogą narzucić robotowi zachowania: to od niego zależy, czy się do nich zastosuje. Plik mówi też o dostępie, a nie o prawach autorskich, dlatego dobrze uzupełnić go zapisem odnoszącym się wprost do eksploracji tekstów i danych. Jak ocenić, których robotów blokada ma sens biznesowy, opisujemy we wpisie o tym, czy blokować roboty AI.
Protokół TDMRep: plik, nagłówki i znaczniki meta
TDMRep (TDM Reservation Protocol, czyli protokół zastrzegania eksploracji tekstów i danych) to specyfikacja przygotowana przez grupę społecznościową działającą przy konsorcjum W3C jako techniczna odpowiedź na przepis dyrektywy o zastrzeżeniu. Dokument końcowy grupy zaznacza, że nie jest standardem W3C i nie znajduje się na ścieżce standaryzacyjnej. Mimo to mówi robotowi dokładnie to, o co chodzi w ustawie.
Protokół opiera się na dwóch właściwościach. Pierwsza, tdm-reservation, przyjmuje wartość 1, gdy prawa do eksploracji są zastrzeżone, albo 0, gdy nie są. Druga, opcjonalna tdm-policy, zawiera adres dokumentu z polityką, z którego zainteresowany dowie się, na jakich warunkach może uzyskać zgodę. Obie można podać na trzy sposoby.
Pierwszy sposób to plik tdmrep.json umieszczony w katalogu /.well-known na serwerze. Zawiera listę reguł, a każda reguła wskazuje ścieżkę (pole location) i wartość zastrzeżenia. Stosowana jest pierwsza pasująca reguła, wielkość liter ma znaczenie, a gwiazdka zastępuje dowolny ciąg znaków.
[
  {
    "location": "/",
    "tdm-reservation": 1,
    "tdm-policy": "https://przyklad.pl/polityka-tdm.json"
  }
]
Drugi sposób to nagłówki w odpowiedzi serwera na żądanie pobrania zasobu. Specyfikacja nazywa tę technikę obecnie preferowaną, a jej zaletą jest to, że obejmuje także pliki bez kodu HTML: zdjęcia, dokumenty PDF, nagrania. Trzeci sposób to znaczniki meta w sekcji head pojedynczej podstrony.
tdm-reservation: 1
tdm-policy: https://przyklad.pl/polityka-tdm.json

<meta name="tdm-reservation" content="1">
<meta name="tdm-policy" content="https://przyklad.pl/polityka-tdm.json">
Specyfikacja zaleca stosowanie na jednym serwerze jednej techniki i określa kolejność na wypadek rozbieżności: robot najpierw odczytuje plik, wartość z nagłówka zastępuje wartość z pliku, a znacznik meta zastępuje wcześniejsze. Brak właściwości nigdy nie uchyla wartości ustalonej wcześniej.
Regulamin i strona z polityką
Zapis w regulaminie nie zastąpi sygnałów technicznych, ale wyjaśnia ludziom, w tym prawnikom drugiej strony, jaki jest zakres zastrzeżenia i z kim rozmawiać o licencji. Wystarczy osobny punkt o tym, że uprawniony zastrzega korzystanie z treści serwisu w celu eksploracji tekstów i danych, ze wskazaniem adresu do kontaktu w sprawie zgody. Ostateczne brzmienie warto uzgodnić z prawnikiem.
Jak wdrożyć zastrzeżenie w firmowej witrynie lub sklepie
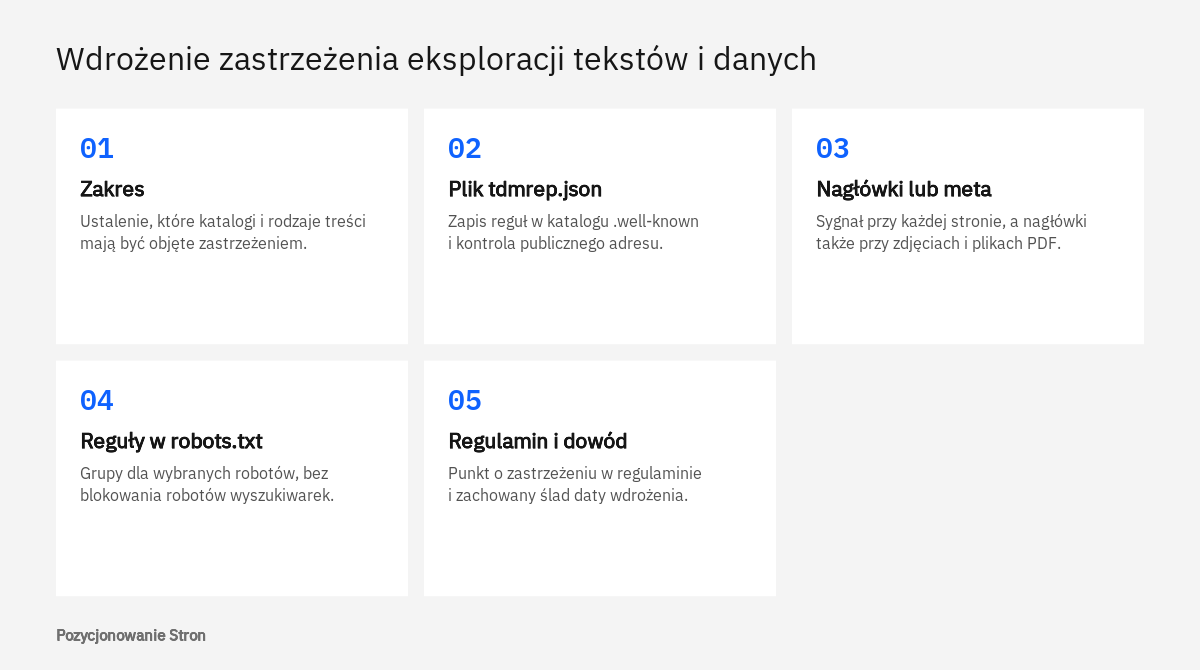
Wdrożenie sprowadza się do pięciu czynności: ustalenia zakresu, przygotowania sygnałów technicznych, dopisania reguł w robots.txt, uzupełnienia regulaminu i zachowania dowodu daty. Wykonuje je administrator strony, niezależnie od tego, czy serwis działa na WordPressie, WooCommerce, PrestaShop czy Shopify.
- Ustalenie zakresu
Nie każda treść wymaga ochrony. Hipotetyczny sklep z Poznania może chcieć zastrzec autorskie opisy i zdjęcia produktów, a pozostawić otwartą stronę kontaktową. Hipotetyczna kancelaria z Krakowa zastrzeże raczej dział z analizami niż opis zespołu.
- Przygotowanie pliku tdmrep.json
Plik zapisuje się w katalogu /.well-known w głównym katalogu domeny i sprawdza, czy otwiera się pod publicznym adresem bez logowania.
- Nagłówki lub znaczniki meta
Nagłówki ustawia się w konfiguracji serwera albo w usłudze pośredniczącej (CDN), a znaczniki meta w szablonie strony. Dla zdjęć i plików PDF działają tylko nagłówki.
- Reguły w robots.txt
Do pliku dopisuje się grupy dla tych robotów, których dotyczy decyzja, w tym token Google-Extended, jeśli zastrzeżenie ma objąć trenowanie modeli Gemini.
- Regulamin i dowód
Na końcu uzupełnia się regulamin i zachowuje ślad daty wdrożenia: kopię plików, wpis w historii zmian, zrzut ekranu odpowiedzi serwera.
Przy tej okazji łatwo o pomyłkę, która zaszkodzi widoczności: reguła pisana z myślą o robotach AI trafia do grupy obejmującej wszystkie roboty i zamyka witrynę także przed wyszukiwarkami. Dlatego zmiany w robots.txt i w nagłówkach powinny przejść przez osobę, która zna techniczną stronę SEO, a po wdrożeniu warto przejrzeć roboty AI w logach serwera.
Jeśli chcą Państwo zamówić treści SEO, zachęcamy do kontaktu: tel. 222 500 844 lub mailowo: biuro@pozycjonowaniestron.pl
Co AI Act przewiduje wobec dostawców modeli AI
AI Act nie zmienia prawa autorskiego, ale zobowiązuje dostawców modeli ogólnego przeznaczenia do tego, by zastrzeżenia faktycznie odczytywali i respektowali. Zgodnie z art. 53 rozporządzenia dostawca takiego modelu ma wprowadzić politykę zapewniającą zgodność z unijnym prawem autorskim, obejmującą w szczególności identyfikowanie zastrzeżeń praw wyrażonych na podstawie dyrektywy o prawie autorskim na jednolitym rynku cyfrowym i stosowanie się do nich. Ten sam artykuł wymaga publicznego udostępnienia wystarczająco szczegółowego streszczenia treści użytych do trenowania, według wzoru przygotowanego przez unijny Urząd ds. AI.
Preambuła rozporządzenia dopowiada dwie ważne rzeczy. Tam, gdzie prawo do sprzeciwu zostało wyraźnie i w odpowiedni sposób zastrzeżone, dostawca, który chce prowadzić eksplorację na takich utworach, musi uzyskać zgodę uprawnionych. Ponadto obowiązek posiadania polityki dotyczy każdego dostawcy wprowadzającego model na rynek Unii, bez względu na to, w jakiej jurysdykcji odbywały się czynności związane z trenowaniem. Chodzi o to, aby nikt nie zyskiwał przewagi na rynku unijnym dzięki niższym standardom ochrony praw autorskich.
Sposobem wykazania zgodności jest kodeks praktyk dla AI ogólnego przeznaczenia, który Komisja opisuje jako dobrowolne narzędzie złożone z rozdziałów o przejrzystości, o prawie autorskim oraz o bezpieczeństwie. Rozdział o prawie autorskim pokazuje, na jakie sygnały sygnatariusze zobowiązali się reagować. Według tekstu kodeksu (korzystaliśmy z nieoficjalnego serwisu odtwarzającego jego treść; wiążące są dokumenty Urzędu ds. AI) ich roboty mają odczytywać i stosować instrukcje z pliku robots.txt zgodnie ze standardem RFC 9309, a także rozpoznawać i respektować inne odpowiednie protokoły nadające się do odczytu maszynowego, na przykład metadane przypisane do zasobu lub lokalizacji, o ile są ustandaryzowane lub szeroko przyjęte. Sygnatariusze zobowiązują się też nie obchodzić skutecznych zabezpieczeń technicznych, takich jak płatny dostęp, publicznie informować o swoich robotach, wyznaczyć elektroniczny punkt kontaktowy dla uprawnionych i rozpatrywać uzasadnione skargi.
Wniosek dla Państwa firmy jest praktyczny: robots.txt pozostaje sygnałem o najpewniejszym odbiorze, a protokoły oparte na metadanych, takie jak TDMRep, mieszczą się w kategorii przewidzianej w kodeksie, choć lista uznanych rozwiązań dopiero powstaje. O obowiązkach firm korzystających z AI w promocji piszemy we wpisie AI Act a marketing.
Czego zastrzeżenie nie załatwia i jakie pomyłki zdarzają się najczęściej
Zastrzeżenie jest oświadczeniem prawnym, a nie zaporą techniczną: nie uniemożliwia pobrania strony, tylko odbiera podstawę prawną do kopiowania jej w celu eksploracji. Kto mimo to skopiuje treść, działa już poza wyjątkiem, ale wykrycie tego i dochodzenie roszczeń to osobne, trudniejsze zadanie. Preambuła dyrektywy przewiduje, że uprawnieni mogą stosować środki zapewniające poszanowanie zastrzeżeń, więc łączenie go z blokadą na poziomie serwera jest dopuszczalne. Jak odróżnić prawdziwego robota od takiego, który tylko podaje cudzą nazwę, wyjaśniamy we wpisie o weryfikacji adresów IP robotów AI.
Najczęstsza pomyłka to utożsamianie trenowania modeli z widocznością w odpowiedziach asystentów. Zastrzeżenie eksploracji i token Google-Extended dotyczą wykorzystania treści przez modele, natomiast obecność w wynikach wyszukiwania zależy od robotów wyszukiwarek. Firma, która w obawie przed AI zamknie witrynę przed wszystkimi robotami, straci ruch, na którym jej zależy. Kto inwestuje w pozycjonowanie w AI, powinien rozdzielić te dwie decyzje: można nie zgadzać się na trenowanie i jednocześnie chcieć być cytowanym źródłem.
Druga pomyłka to wiara w to, że zastrzeżenie chroni informacje. Prawo autorskie chroni sposób wyrażenia, a dyrektywa mówi wprost, że analiza samych faktów lub danych niechronionych nie wymaga zgody. Godziny otwarcia, ceny czy parametry techniczne nie staną się dzięki zastrzeżeniu niedostępne.
Trzecia pomyłka dotyczy zasięgu. Wyjątek i zastrzeżenie są konstrukcją prawa unijnego, a autorzy specyfikacji TDMRep zaznaczają, że poza Unią braku zastrzeżenia nie można traktować jako dorozumianej zgody. W innych państwach obowiązują więc odmienne zasady, a AI Act łagodzi ten problem tylko wobec modeli oferowanych w Unii.
Jak sprawdzić, czy zastrzeżenie działa, i kiedy potrzebna jest pomoc
Działanie zastrzeżenia sprawdza się tak, jak zrobiłby to robot: przez pobranie publicznych adresów i odczytanie odpowiedzi serwera. Adres pliku tdmrep.json oraz robots.txt wystarczy otworzyć w przeglądarce w oknie prywatnym. Nagłówki widać w narzędziach deweloperskich przeglądarki, na karcie Sieć, po kliknięciu żądania dokumentu i przejściu do sekcji nagłówków odpowiedzi. Znaczniki meta znajdują się w źródle strony, w sekcji head.
- Plik tdmrep.json otwiera się pod adresem domeny w katalogu /.well-known i zawiera poprawny zapis JSON.
- Nagłówek tdm-reservation pojawia się także przy zdjęciach i plikach PDF, a nie tylko przy stronach HTML.
- Wartości w pliku, nagłówkach i znacznikach meta nie są ze sobą sprzeczne.
- Reguły w robots.txt dotyczą wyłącznie wybranych robotów i nie obejmują robotów wyszukiwarek.
- Zastrzeżenie działa również na subdomenach i w wersjach językowych.
- Regulamin zawiera punkt o zastrzeżeniu i adres do kontaktu w sprawie licencji.
- Zachowano dowód daty wdrożenia.
Kontrolę warto powtarzać po każdej większej zmianie technicznej, ponieważ zmiana szablonu albo przenosiny na inny serwer potrafią usunąć nagłówki lub nadpisać robots.txt bez żadnego komunikatu.
Pomoc prawnika jest potrzebna, gdy nie jest jasne, kto jest uprawnionym do treści w serwisie, gdy firma chce zamiast zakazu zaproponować odpłatną licencję oraz gdy pojawia się podejrzenie, że treści zostały wykorzystane mimo zastrzeżenia. Wsparcie techniczne przydaje się tam, gdzie witryna ma wiele subdomen albo łączy zastrzeżenie z innymi mechanizmami, takimi jak ograniczanie fragmentów w odpowiedziach AI Google. Sama decyzja, które treści chronić, a które celowo pozostawić otwarte, należy do strategii treści SEO i warto podjąć ją, zanim powstaną kolejne teksty.
Jeśli chcą Państwo zamówić treści SEO, zachęcamy do kontaktu: tel. 222 500 844 lub mailowo: biuro@pozycjonowaniestron.pl
Najczęstsze pytania
Czy brak zastrzeżenia oznacza zgodę na trenowanie AI na treściach strony?
Nie jest to zgoda w sensie umowy, ale skutek bywa podobny. Polska ustawa pozwala zwielokrotniać rozpowszechnione utwory w celu eksploracji tekstów i danych, chyba że uprawniony zastrzegł inaczej. Kto nie złożył zastrzeżenia, pozostawia tę możliwość otwartą.
Czy wystarczy napisać o zastrzeżeniu w regulaminie?
Dla treści dostępnych w internecie polski przepis wymaga formatu przeznaczonego do odczytu maszynowego wraz z metadanymi. Regulamin jest wartościowym uzupełnieniem, ale bezpieczniej połączyć go z sygnałami technicznymi. Ocena skuteczności w konkretnej sprawie należy do prawnika.
Czy zastrzeżenie obniży pozycję strony w Google?
Zastrzeżenie wyrażone w protokole TDMRep nie jest instrukcją dla robotów wyszukiwarek. Google podaje też, że token Google-Extended nie wpływa na uwzględnienie witryny w wyszukiwarce i nie jest czynnikiem rankingowym. Ryzyko pojawia się dopiero wtedy, gdy przez pomyłkę zablokuje się roboty wyszukiwarek.
Czy TDMRep jest oficjalnym standardem?
Nie. To raport końcowy grupy społecznościowej działającej przy W3C, który sam zaznacza, że nie jest standardem W3C. Powstał jednak jako techniczna odpowiedź na unijny przepis o zastrzeżeniu.
Czy zastrzeżenie działa wobec uczelni i instytutów badawczych?
Nie w zakresie eksploracji do celów badań naukowych. Ustawa przewiduje dla instytucji dziedzictwa kulturowego oraz wskazanych podmiotów szkolnictwa wyższego i nauki osobny wyjątek, którego zastrzeżenie nie wyłącza. Warunkiem jest brak celu w postaci korzyści majątkowej.
Czy można zastrzec tylko część witryny?
Tak. W pliku tdmrep.json reguły przypisuje się do ścieżek, więc jeden katalog może być zastrzeżony, a inny nie. Podobnie działają reguły w robots.txt oraz znaczniki meta na pojedynczych podstronach.
Źródła
- Dyrektywa Parlamentu Europejskiego i Rady (UE) 2019/790 w sprawie prawa autorskiego i praw pokrewnych na jednolitym rynku cyfrowym, EUR-Lex
- Art. 26³. Zastrzeżenie zwielokrotniania utworów w celu eksploracji tekstów i danych, ustawa o prawie autorskim i prawach pokrewnych
- Art. 26². Zwielokrotnianie utworów w celu eksploracji tekstów i danych do celów badań naukowych, ustawa o prawie autorskim i prawach pokrewnych
- Article 53: Obligations for providers of general-purpose AI models, AI Act Service Desk, Komisja Europejska
- The General-Purpose AI Code of Practice, Komisja Europejska
- Commission launches consultation on protocols for reserving rights from text and data mining under the AI Act and the GPAI Code of Practice, Komisja Europejska
- TDM Reservation Protocol (TDMRep), W3C Community Group
- Typowe roboty Google, Google for Developers
Funkcje wyszukiwarek i asystentów AI zmieniają się szybko, dlatego wpis aktualizujemy po większych zmianach.