Nazwa robota widoczna w dzienniku serwera to tylko deklaracja, którą każdy program może wpisać dowolnie. O tym, czy stronę odwiedził prawdziwy robot Google, ChatGPT, Perplexity albo Claude, rozstrzyga adres IP, z którego przyszło żądanie, porównany z listą opublikowaną przez dostawcę albo potwierdzony zapytaniem DNS. Poniżej opisujemy, jak przeprowadzić taką weryfikację i jak przełożyć jej wynik na reguły zapory, które nie wpuszczą podszywki i nie odetną prawdziwych robotów.
Dlaczego nazwa robota w nagłówku niczego nie dowodzi
Nazwa robota trafia do dziennika serwera z nagłówka User-Agent, czyli z podpisu, którym program przedstawia się przy każdym żądaniu. Ten podpis ustawia sam nadawca. Serwer niczego w nim nie sprawdza, tylko zapisuje to, co otrzymał. Wystarczy jedna linia w konfiguracji dowolnego skryptu, aby program pobierający ceny ze sklepu przedstawił się jako Googlebot, GPTBot albo ClaudeBot.
Google mówi o tym otwarcie. Na stronach opisujących typowe roboty Google oraz moduły pobierania uruchamiane przez użytkownika znajduje się zastrzeżenie, że ciąg klienta użytkownika może zostać sfałszowany i dlatego żądania warto weryfikować. Skoro dotyczy to Googlebota, dotyczy także każdego robota AI, bo mechanizm nagłówka jest wszędzie ten sam.
Po co ktoś miałby się podszywać? Powód jest praktyczny. Wiele serwerów i zapór traktuje znane roboty łagodniej niż resztę ruchu: nie pokazuje im zabezpieczeń przed automatami, nie ogranicza liczby żądań, pomija je w limitach. Program, który chce masowo kopiować treści, cenniki albo dane kontaktowe, zyskuje więc na tym, że wygląda jak robot wyszukiwarki. Dla właściciela strony skutki są dwa. Rośnie obciążenie serwera, a statystyki wizyt robotów AI przestają być wiarygodne, bo część wpisów w dzienniku nie pochodzi od tych, których nazwę noszą.
Dwa rodzaje błędu, których należy uniknąć
Przy robotach łatwo popełnić błąd w obu kierunkach. Pierwszy polega na zaufaniu samej nazwie: reguła typu "przepuść wszystko, co ma w podpisie Googlebot" otwiera drzwi każdemu, kto tę nazwę wpisze. Drugi błąd jest odwrotny: administrator widzi w dzienniku tysiące żądań podpisanych nazwą robota AI, uznaje to za nadużycie i blokuje nazwę w całości. Jeśli były to podszywki, prawdziwy robot zostaje odcięty razem z nimi, a strona znika ze źródeł, z których korzysta dany asystent.
Hipotetyczny przykład dobrze to pokazuje. Sklep z Poznania zauważa nocne skoki obciążenia i w dzienniku widzi nazwę robota wyszukiwarki. Gdyby na tej podstawie zablokował nazwę, mógłby wstrzymać indeksowanie własnej oferty. Gdyby nie zrobił nic, pozwoliłby obcemu programowi dalej kopiować ceny. Właściwa decyzja wymaga jednej czynności więcej: ustalenia, skąd te żądania naprawdę przyszły.
Po czym rozpoznaje się prawdziwego robota
Prawdziwego robota rozpoznaje się po trzech cechach naraz: podpisie w nagłówku, źródłowym adresie IP i nazwie hosta zwracanej przez odwrotne zapytanie DNS. Tak właśnie opisuje to Google w omówieniu swoich robotów: roboty identyfikują się nagłówkiem, adresem źródłowym oraz odwrotną nazwą hosta. Pierwszą cechę może podrobić każdy, dwóch pozostałych podrobić w zwykłych warunkach się nie da, bo wynikają z tego, kto faktycznie zarządza danym adresem w sieci.
Liczbowy adres urządzenia w sieci, z którego przyszło żądanie. Serwer zapisuje go w dzienniku niezależnie od tego, co nadawca napisał o sobie w nagłówkach.
Pytanie do systemu nazw domenowych o to, jaka nazwa hosta jest przypisana do danego adresu IP. Zwykłe zapytanie działa w drugą stronę: od nazwy do adresu.
Sposób zapisu grupy sąsiednich adresów jednym wpisem, na przykład 192.178.4.0/27. Liczba po ukośniku określa wielkość grupy. W tym formacie dostawcy publikują listy adresów swoich robotów.
Z tych trzech cech wynika prosta zasada pracy. Nazwa w nagłówku mówi, za kogo program się podaje. Adres IP i nazwa hosta mówią, kim jest. Jeżeli obie informacje się zgadzają, robot jest prawdziwy. Jeżeli nazwa wskazuje na znanego dostawcę, a adres należy do zupełnie innej sieci, mamy do czynienia z podszywką.
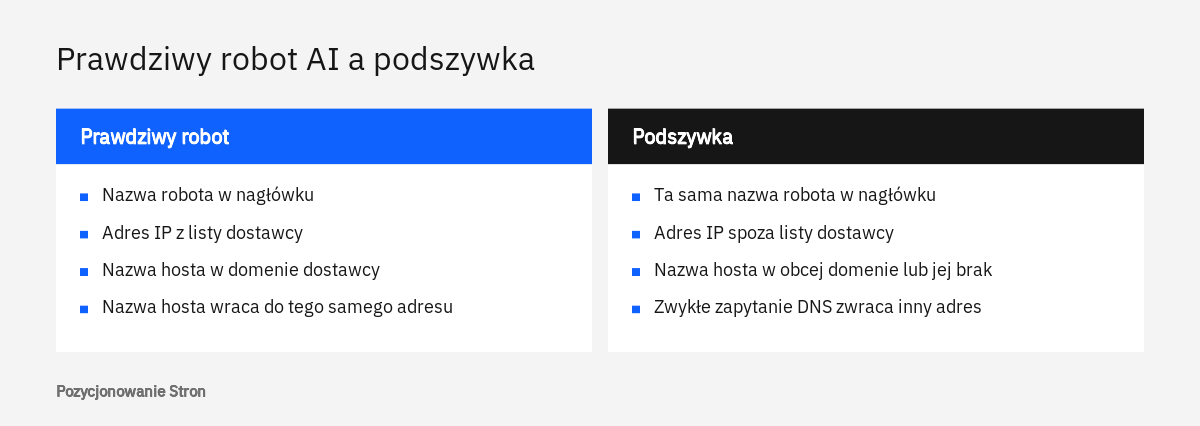
Warto zwrócić uwagę na to, czego weryfikacja nie rozstrzyga. Potwierdzenie, że robot jest prawdziwy, nie przesądza o tym, czy warto go wpuszczać. To osobna decyzja biznesowa, którą omawiamy we wpisie o tym, czy blokować roboty AI. Weryfikacja odpowiada wyłącznie na pytanie o tożsamość nadawcy i dopiero na jej podstawie można sensownie ustawiać reguły.
Jak Google opisuje weryfikację swoich robotów
Google podaje dwie metody: ręczną, opartą na dwóch zapytaniach DNS, oraz automatyczną, opartą na porównaniu adresu z opublikowanymi plikami zakresów IP. Obie opisuje strona pomocy Weryfikowanie żądań od robotów i modułów pobierania Google. Metoda ręczna wystarcza do jednorazowego sprawdzenia kilku adresów, metoda automatyczna jest przeznaczona do rozwiązań działających na większą skalę.
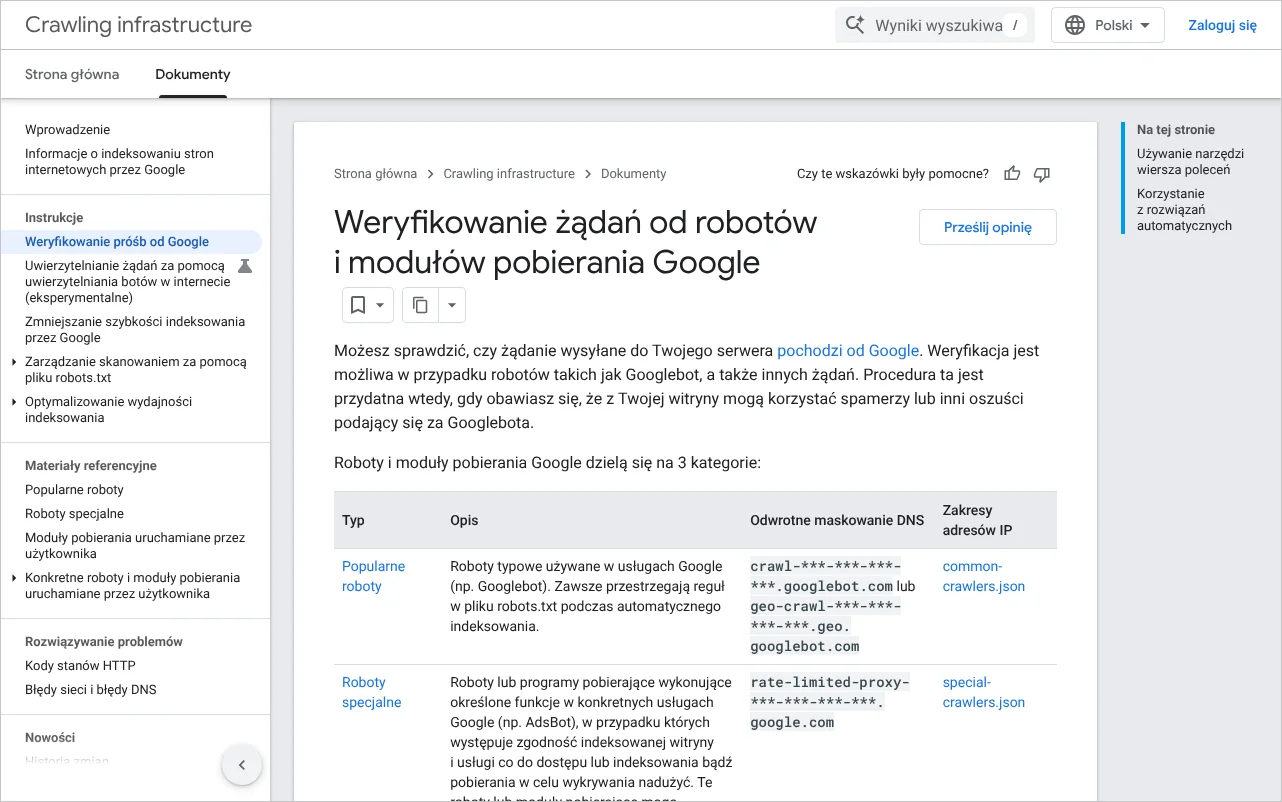
Weryfikacja ręczna składa się z czterech czynności. Najpierw wykonuje się odwrotne zapytanie DNS dla adresu IP odczytanego z dziennika, do czego służy polecenie host. Następnie sprawdza się, czy zwrócona nazwa należy do jednej z trzech domen: googlebot.com, google.com albo googleusercontent.com. Potem wykonuje się zwykłe zapytanie DNS dla tej nazwy hosta. Na końcu porównuje się otrzymany adres z adresem z dziennika. Dopiero zgodność w obu kierunkach potwierdza, że żądanie pochodzi od Google.
host 66.249.66.1
1.66.249.66.in-addr.arpa domain name pointer crawl-66-249-66-1.googlebot.com.

host crawl-66-249-66-1.googlebot.com
crawl-66-249-66-1.googlebot.com has address 66.249.66.1
Drugie zapytanie nie jest formalnością. Właściciel dowolnego adresu IP może ustawić dla niego nazwę zwrotną o dowolnym brzmieniu, także taką, która kończy się na googlebot.com. Nie może natomiast sprawić, żeby prawdziwa domena Google wskazywała na jego adres. Dlatego nazwa zwrotna bez potwierdzenia zapytaniem zwykłym nie jest dowodem.
Jakie nazwy hostów zwracają poszczególne grupy robotów Google
Google dzieli swoje programy na trzy grupy i każdej przypisuje inny wzór nazwy hosta oraz inny plik z zakresami adresów. Znajomość tego podziału pozwala od razu ocenić, czy wynik zapytania jest wiarygodny.
| Grupa | Wzór nazwy hosta | Plik z zakresami IP | Stosunek do robots.txt |
|---|---|---|---|
| Popularne roboty, na przykład Googlebot | crawl-***.googlebot.com lub geo-crawl-***.geo.googlebot.com | common-crawlers.json | Zawsze stosują reguły |
| Roboty specjalne, na przykład AdsBot | rate-limited-proxy-***.google.com | special-crawlers.json | Mogą stosować, ale nie muszą |
| Moduły pobierania uruchamiane przez użytkownika | ***.gae.googleusercontent.com lub google-proxy-***.google.com | user-triggered-fetchers.json, user-triggered-fetchers-google.json, user-triggered-agents.json | Ignorują reguły, bo pobranie zlecił użytkownik |
Osobno Google udostępnia ogólną listę swoich adresów, która służy do rozpoznawania innych żądań, na przykład pochodzących ze skryptów uruchamianych w usługach Google. Nie należy jej mylić z listami robotów: adres z listy ogólnej oznacza infrastrukturę Google, ale nie oznacza Googlebota.
Jeżeli zapora odrzuca prawdziwego Googlebota, skutkiem jest zwykle odpowiedź z kodem 403. Objawy i sposób naprawy opisujemy we wpisie o tym, dlaczego serwer odmawia dostępu Googlebotowi.
Gdzie dostawcy AI publikują listy adresów IP swoich robotów
Dostawcy publikują listy w postaci plików JSON pod stałymi adresami wskazanymi w swojej dokumentacji. Każdy plik zawiera datę utworzenia oraz tablicę zakresów w zapisie CIDR. Sprawdzenie polega na ustaleniu, czy adres z dziennika mieści się w którymkolwiek zakresie z pliku przypisanego do robota o tej nazwie.
OpenAI w omówieniu swoich robotów wymienia cztery programy i dla każdego podaje osobny plik: OAI-SearchBot obsługuje wyszukiwanie w ChatGPT, GPTBot zbiera treści, które mogą posłużyć do trenowania modeli, ChatGPT-User działa na polecenie użytkownika, a OAI-AdsBot sprawdza strony docelowe zgłoszone jako reklamy. Ustawienia są od siebie niezależne, więc można dopuścić robota wyszukiwania i zarazem wykluczyć robota treningowego. Więcej o roli tych programów piszemy we wpisie o tym, jak wyszukuje ChatGPT Search.
Perplexity w dokumentacji swoich robotów opisuje dwa programy: PerplexityBot, który służy do pokazywania i linkowania stron w wynikach, oraz Perplexity-User, który odwiedza stronę, gdy użytkownik zada pytanie. Dla obu podaje osobne pliki z adresami i zaleca łączenie dopasowania nazwy robota z weryfikacją adresu IP.
Anthropic na stronie pomocy o robotach Claude wymienia trzy programy: ClaudeBot, Claude-User i Claude-SearchBot, a listę adresów udostępnia w jednym pliku. Zaznacza, że obecność adresu źródłowego na tej liście wskazuje, że robot pochodzi od Anthropic. O samych robotach piszemy szerzej we wpisie o tym, jak Claude wyszukuje w sieci.
| Dostawca | Roboty | Adres pliku z zakresami IP |
|---|---|---|
| OpenAI | OAI-SearchBot, GPTBot, ChatGPT-User, OAI-AdsBot | openai.com/searchbot.json, openai.com/gptbot.json, openai.com/chatgpt-user.json, openai.com/adsbot.json |
| Perplexity | PerplexityBot, Perplexity-User | perplexity.com/perplexitybot.json, perplexity.com/perplexity-user.json |
| Anthropic | ClaudeBot, Claude-User, Claude-SearchBot | claude.com/crawling/bots.json |
| Googlebot i pozostałe roboty Google | pliki w katalogu developers.google.com/static/crawling/ipranges/ | |
| Bing | Bingbot | bing.com/toolbox/bingbot.json |
{
  "creationTime": "data i godzina utworzenia pliku",
  "prefixes": [
    { "ipv4Prefix": "192.178.4.0/27" },
    { "ipv6Prefix": "zakres adresów w nowszej wersji protokołu" }
  ]
}
Pliki nie są stałe. Perplexity zaznacza, że jego listy są regularnie aktualizowane, i zaleca automatyczne, okresowe odświeżanie reguł zapory. To zalecenie warto odnieść do wszystkich dostawców: lista skopiowana raz i pozostawiona bez opieki z czasem przestaje odpowiadać rzeczywistości i zaczyna odrzucać prawdziwe roboty z nowych adresów.
Jeśli chcą Państwo zamówić SEO techniczne, zachęcamy do kontaktu: tel. 222 500 844 lub mailowo: biuro@pozycjonowaniestron.pl
Jak wykonać odwrotne zapytanie DNS i odczytać wynik
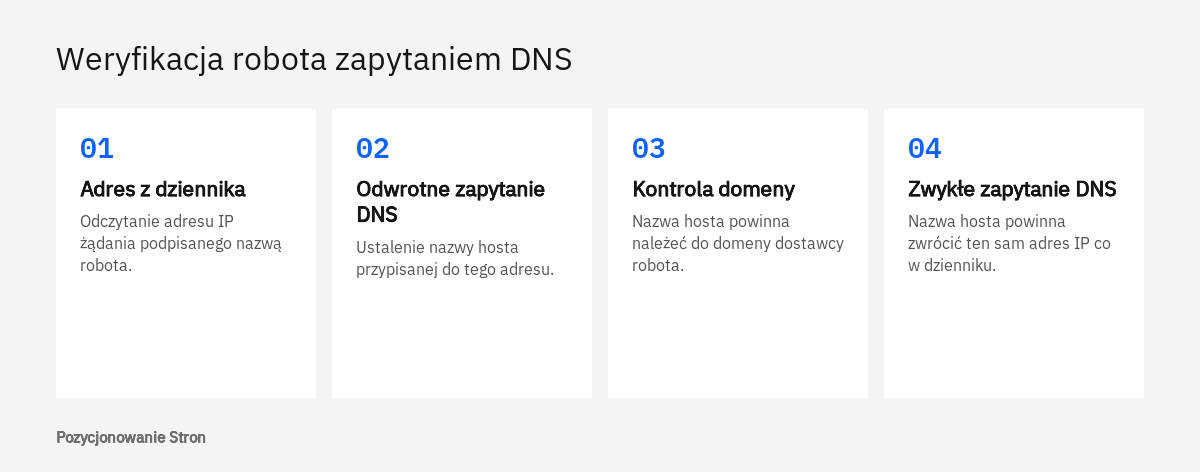
Odwrotne zapytanie DNS wykonuje się jednym poleceniem w terminalu: host w systemie Linux albo nslookup w wierszu polecenia systemu Windows, podając po nazwie polecenia adres IP z dziennika. W odpowiedzi pojawia się nazwa hosta. Tę nazwę wpisuje się następnie do tego samego polecenia i porównuje otrzymany adres z adresem wyjściowym.
Tę samą procedurę opisuje Bing we wpisie o weryfikacji Bingbota. Nazwa zwrócona przez odwrotne zapytanie powinna kończyć się na search.msn.com, a zwykłe zapytanie o tę nazwę powinno zwrócić pierwotny adres. Ma to znaczenie także dla widoczności w Copilocie, o czym piszemy przy okazji konfiguracji narzędzi Binga dla webmasterów.
nslookup 157.55.33.18
Name: msnbot-157-55-33-18.search.msn.com

nslookup msnbot-157-55-33-18.search.msn.com
Address: 157.55.33.18
Wynik odczytuje się według trzech możliwości. Jeżeli nazwa należy do domeny dostawcy i wraca do tego samego adresu, robot jest prawdziwy. Jeżeli nazwa należy do innej domeny, na przykład do firmy wynajmującej serwery, mamy podszywkę. Jeżeli nazwa wygląda poprawnie, ale zwykłe zapytanie zwraca inny adres albo nie zwraca żadnego, również mamy podszywkę, tyle że staranniej przygotowaną.
Kiedy stosować zapytanie DNS, a kiedy listę adresów
Zapytanie DNS sprawdza się tam, gdzie dostawca sam opisuje tę metodę i podaje domeny, do których należą nazwy jego robotów. Tak jest w przypadku Google i Binga. W dokumentacji OpenAI, Perplexity i Anthropic, którą otworzyliśmy przy pracy nad tym wpisem, jako sposób rozpoznania wskazane są opublikowane pliki z adresami, a nie domeny nazw zwrotnych. Dla robotów tych trzech dostawców podstawą weryfikacji powinna więc być lista adresów.
Obie metody różnią się też kosztem. Zapytanie DNS trwa chwilę i wymaga połączenia z zewnętrznym serwerem nazw, dlatego nie nadaje się do wykonywania przy każdym żądaniu. Porównanie z listą odbywa się lokalnie i jest natychmiastowe, ale wymaga dbania o aktualność listy. W praktyce agencji zapytanie DNS służy do ręcznego wyjaśniania wątpliwych przypadków, a listy do stałych reguł zapory.
Jak ustawić reguły zapory, żeby nie wpuścić podszywki i nie odciąć prawdziwych robotów
Reguła powinna łączyć dwa warunki: nazwę robota w nagłówku i adres źródłowy z opublikowanego zakresu. Żądanie spełniające oba warunki jest przepuszczane. Żądanie, które nosi nazwę robota, ale przychodzi spoza zakresu, jest traktowane jak podszywka. Taki układ zaleca Perplexity, opisując konfigurację zapory aplikacyjnej, czyli zabezpieczenia filtrującego ruch do strony, często oznaczanego skrótem WAF.
Z tej samej dokumentacji wynikają trzy dalsze wskazania. Reguły przepuszczające zweryfikowane roboty powinny mieć wyższy priorytet niż reguły blokujące, bo inaczej ogólna blokada zadziała wcześniej i prawdziwy robot nie dotrze do strony. Listy adresów należy odświeżać automatycznie. Po wprowadzeniu zmian trzeba obserwować dziennik, ponieważ nowe reguły mogą zacząć działać z opóźnieniem.
Reguła 1 (najwyższy priorytet): PRZEPUŚĆ
  jeżeli nagłówek User-Agent zawiera "GPTBot"
  ORAZ adres źródłowy należy do listy z pliku gptbot.json

Reguła 2: ZABLOKUJ
  jeżeli nagłówek User-Agent zawiera "GPTBot"
  ORAZ adres źródłowy NIE należy do listy z pliku gptbot.json

Reguła 3 i dalsze: ogólne zabezpieczenia przed automatami
Dla każdego robota tworzy się osobną parę reguł i osobną listę adresów. Nie należy łączyć list różnych dostawców w jedną, bo wtedy program podpisany nazwą jednego robota mógłby przejść z adresu należącego do innego. Przy Google trzeba ponadto dobrać właściwy plik: Googlebot należy do listy typowych robotów, a nie do listy modułów uruchamianych przez użytkownika.
Co zrobić z ruchem rozpoznanym jako podszywka
Ruch rozpoznany jako podszywka można bezpiecznie odrzucić, ponieważ nie pochodzi od dostawcy, którego nazwę nosi, i jego zablokowanie nie wpływa na obecność strony w wyszukiwarce ani w odpowiedziach asystentów. Najprostszą reakcją jest odmowa dostępu. Część zapór pozwala zamiast tego wyświetlić zadanie sprawdzające, czy po drugiej stronie jest człowiek.
Inaczej należy postąpić z prawdziwym robotem, którego wizyty są zbyt częste. Tu właściwym narzędziem nie jest zapora, tylko mechanizmy przewidziane przez dostawcę. Anthropic informuje, że jego roboty respektują plik robots.txt i obsługują rozszerzenie Crawl-delay, czyli regułę ustalającą odstęp między żądaniami. Zarazem odradza blokowanie adresów IP jako sposobu rezygnacji z odwiedzin, ponieważ taka blokada uniemożliwia robotom odczytanie pliku robots.txt i może nie działać trwale. OpenAI z kolei podaje, że po zmianie pliku robots.txt jego systemy potrzebują około doby na dostosowanie.
W przypadku Google na krótkie ograniczenie ruchu przewidziano kody odpowiedzi 500, 503 i 429. Strona pomocy o zmniejszaniu szybkości indeksowania zastrzega, że jest to rozwiązanie na kilka godzin albo jeden lub dwa dni. Adresy, pod którymi Googlebot przez kilka dni napotyka takie kody, mogą zostać usunięte z indeksu. Reguła zapory, która przez dłuższy czas odpowiada prawdziwemu Googlebotowi kodem 429, jest więc poważnym zagrożeniem dla widoczności.
Roboty działające na polecenie użytkownika i inne przypadki graniczne
Programy uruchamiane przez użytkownika weryfikuje się tak samo jak roboty indeksujące, ale korzystają one z innych adresów i innych plików. Kto porówna ich adres z listą robota indeksującego, uzna prawdziwe żądanie za podszywkę. To jedna z częstszych przyczyn fałszywych alarmów.
Chodzi o programy, które odwiedzają stronę w chwili, gdy ktoś zadaje asystentowi pytanie albo prosi o otwarcie konkretnego adresu. U OpenAI jest to ChatGPT-User, u Perplexity Perplexity-User, u Anthropic Claude-User. Google prowadzi osobną stronę o modułach pobierania uruchamianych przez użytkownika, na której wymienia między innymi Google-Agent, czyli agenty przeglądające sieć i wykonujące działania na prośbę użytkownika, z własnym plikiem zakresów user-triggered-agents.json.
Te programy łączy stosunek do pliku robots.txt. Google podaje, że jego moduły uruchamiane przez użytkownika zwykle ignorują reguły robots.txt, bo żądanie pochodzi od człowieka. Perplexity pisze to samo o Perplexity-User, a OpenAI zaznacza, że w przypadku ChatGPT-User reguły robots.txt mogą nie mieć zastosowania. Wizyta takiego programu na adresie wykluczonym w robots.txt nie jest więc dowodem podszywki. Rozstrzyga, jak zawsze, adres źródłowy.
Google-Extended nie pojawia się w dzienniku
Google-Extended nie ma osobnego podpisu w żądaniach HTTP. Według dokumentacji Google jest to wyłącznie nazwa używana w pliku robots.txt do określenia, czy treści mogą służyć do trenowania modeli Gemini i do przekazywania treści z indeksu do modelu w chwili zapytania. Samo pobieranie odbywa się z użyciem dotychczasowych podpisów robotów Google. Jeżeli w dzienniku pojawia się program przedstawiający się w nagłówku jako Google-Extended, nie jest to robot Google.
Wiele adresów i ruch z innych krajów
Wizyty jednego robota z wielu adresów nie są niczym podejrzanym. Google wyjaśnia, że jego roboty działają w wielu centrach danych, więc w dzienniku mogą pojawiać się różne adresy. Żądania wysyłane są głównie z adresów w Stanach Zjednoczonych, a gdy Googlebot wykryje, że witryna blokuje żądania z tego kraju, może spróbować pobrać ją z adresów w innych krajach. Blokada geograficzna ustawiona dla ochrony przed automatami potrafi więc uderzyć w robota wyszukiwarki, mimo że nikt nie miał takiego zamiaru.
Typowe pomyłki, które odcinają prawdziwe roboty
Najwięcej szkód powodują reguły zbyt szerokie albo oparte na nieaktualnych danych. Podszywka zwykle obciąża serwer, natomiast źle ustawiona blokada może niezauważenie wyłączyć stronę z wyszukiwarki lub ze źródeł asystenta, a skutki widać dopiero po czasie.
Pierwsza pomyłka to blokowanie całych sieci dostawców serwerów. Podszywki często działają z wynajętych maszyn, więc pokusa odcięcia całego dostawcy jest duża. Z tych samych sieci mogą jednak korzystać prawdziwe roboty i zwykłe usługi, z których korzystają klienci. Druga pomyłka to lista skopiowana raz i nieodświeżana. Trzecia to mylenie plików: sprawdzanie programu uruchamianego przez użytkownika na liście robota indeksującego. Czwarta to poprzestanie na odwrotnym zapytaniu DNS bez potwierdzenia w drugą stronę.
Osobną kategorią są decyzje podejmowane pod wpływem samej liczby żądań. Hipotetyczna kancelaria z Krakowa, widząc w dzienniku nagły wzrost wizyt podpisanych nazwą robota AI, mogłaby uznać, że dostawca nadużywa jej zasobów, i wykluczyć go w robots.txt. Gdyby okazało się, że żądania przychodziły spoza opublikowanych zakresów, wykluczenie nie zatrzymałoby podszywki, która pliku robots.txt i tak nie czyta, a zamknęłoby drogę prawdziwemu robotowi.
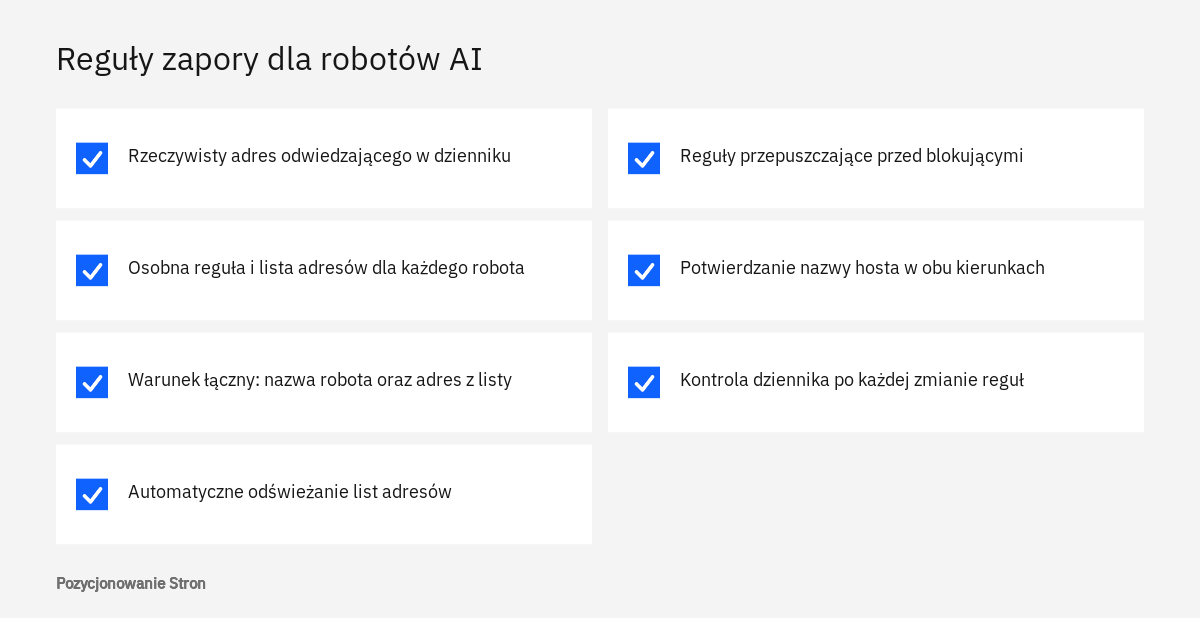
- W dzienniku widoczny jest rzeczywisty adres odwiedzającego, a nie adres serwera pośredniczącego.
- Każdy robot ma własną regułę i własną listę adresów pobraną ze strony dostawcy.
- Listy adresów odświeżają się automatycznie, a data ostatniego pobrania jest kontrolowana.
- Reguły przepuszczające zweryfikowane roboty mają wyższy priorytet niż reguły blokujące.
- Nazwa zwrotna jest zawsze potwierdzana zwykłym zapytaniem DNS.
- Programy uruchamiane przez użytkownika są sprawdzane na właściwych dla nich listach.
- Blokady geograficzne nie obejmują adresów, z których pobierają roboty wyszukiwarek.
- Po każdej zmianie reguł przez kilka dni przeglądany jest dziennik serwera.
Kiedy warto powierzyć weryfikację specjalistom
Pomoc jest potrzebna wtedy, gdy strona działa za kilkoma warstwami pośredników, gdy ruch robotów jest duży albo gdy po zmianie zabezpieczeń spada liczba zaindeksowanych adresów. W takich sytuacjach pojedyncze polecenie w terminalu nie wystarcza: trzeba ustalić, na której warstwie zapada decyzja o odrzuceniu żądania, i przejrzeć reguły w kolejności, w jakiej są stosowane.
Przy okazji audytu SEO sprawdzamy, czy zapora nie odrzuca zweryfikowanych robotów, a w ramach usługi SEO techniczne porządkujemy reguły wspólnie z administratorem serwera. Firmom, którym zależy na obecności w odpowiedziach asystentów, pomagamy także w ramach usługi pozycjonowanie AI, w której dostęp właściwych robotów do treści jest warunkiem wyjściowym.
Jeśli chcą Państwo zamówić SEO techniczne, zachęcamy do kontaktu: tel. 222 500 844 lub mailowo: biuro@pozycjonowaniestron.pl
Najczęstsze pytania
Czy da się podrobić adres IP tak samo łatwo jak nazwę robota?
Nie. Nazwę w nagłówku ustawia nadawca, natomiast adres źródłowy wynika z tego, skąd faktycznie nawiązano połączenie i dokąd serwer odsyła odpowiedź. Dlatego dostawcy opierają weryfikację na adresach i nazwach hostów, a nie na podpisie programu.
Czy wystarczy ustalić, że nazwa hosta kończy się na googlebot.com?
Nie wystarczy. Google wymaga dwóch czynności: odwrotnego zapytania DNS oraz zwykłego zapytania o otrzymaną nazwę, które musi zwrócić ten sam adres IP. Nazwę zwrotną ustawia właściciel adresu, więc bez potwierdzenia w drugą stronę nie jest ona dowodem.
Jak często należy odświeżać listy adresów robotów?
Dostawcy nie podają jednego terminu. Perplexity informuje, że jego pliki są regularnie aktualizowane, i zaleca automatyczne, okresowe odświeżanie reguł zapory. Najbezpieczniej jest pobierać listy automatem i kontrolować, czy pobranie się powiodło.
Czy plik robots.txt chroni przed fałszywymi robotami?
Nie. Plik robots.txt jest zbiorem reguł, których przestrzegają programy działające w dobrej wierze. Podszywka nie ma powodu go czytać ani stosować, dlatego przed nią chroni wyłącznie zapora oparta na weryfikacji adresu.
Co oznacza wpis z nazwą Google-Extended w dzienniku serwera?
Według dokumentacji Google nazwa Google-Extended nie ma osobnego podpisu w żądaniach HTTP i służy wyłącznie jako reguła w pliku robots.txt. Żądanie przedstawiające się tą nazwą w nagłówku nie pochodzi więc od Google.
Czy zablokowanie podszywki może zaszkodzić widoczności strony?
Samo odrzucenie ruchu spoza opublikowanych zakresów nie szkodzi, bo nie jest to ruch dostawcy. Ryzyko pojawia się wtedy, gdy reguła jest zbyt szeroka albo oparta na nieaktualnej liście i zaczyna odrzucać prawdziwe roboty. Stąd potrzeba obserwowania dziennika po każdej zmianie.
Źródła
- Weryfikowanie żądań od robotów i modułów pobierania Google, Google Search Central
- Omówienie robotów (klientów użytkownika) Google, Google for Developers
- Typowe roboty Google, Google for Developers
- Moduły pobierania Google uruchamiane przez użytkownika, Google for Developers
- Zmniejszanie szybkości indeksowania przez Google, Google for Developers
- Overview of OpenAI Crawlers, OpenAI
- Perplexity Crawlers, Perplexity
- Does Anthropic crawl data from the web, and how can site owners block the crawler?, Anthropic
- How to Verify that Bingbot is Bingbot, Bing Webmaster Blog
Funkcje wyszukiwarek i asystentów AI zmieniają się szybko, dlatego wpis aktualizujemy po większych zmianach.