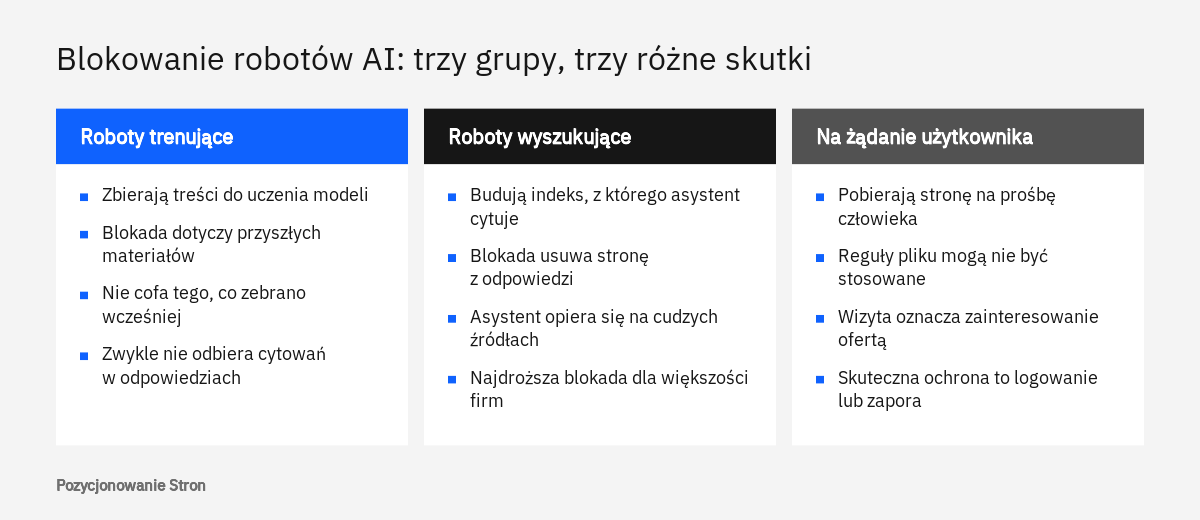
Nie ma jednej odpowiedzi dla wszystkich, ponieważ pod nazwą „roboty AI” kryją się trzy różne grupy programów, a zamknięcie każdej z nich kosztuje coś innego. Blokada robotów trenujących zwykle nie odbiera firmie klientów, blokada robotów wyszukujących usuwa stronę z odpowiedzi asystentów, a blokada robotów działających na żądanie użytkownika bywa po prostu nieskuteczna. Poniżej opisujemy ten rachunek osobno dla firmy usługowej, sklepu i serwisu z płatnymi treściami.
Na czym naprawdę polega decyzja o blokowaniu robotów AI
Decyzja polega na tym, by dla każdej z trzech grup robotów osobno odpowiedzieć na pytanie, czy firma chce, aby jej treści służyły danemu celowi. Pytanie „blokować czy nie” zadane ogólnie prowadzi zwykle do złego wyniku: albo firma otwiera wszystko bez zastanowienia, albo jednym wpisem zamyka wszystko i po pewnym czasie odkrywa, że asystenci przestali ją wymieniać.
Pierwsza grupa to roboty trenujące. Zbierają one treści, które mogą posłużyć do uczenia modeli językowych. OpenAI opisuje w ten sposób robota GPTBot, a Anthropic robota ClaudeBot. Druga grupa to roboty wyszukujące, które budują indeks potrzebny asystentowi do znajdowania i cytowania stron, gdy użytkownik zada pytanie wymagające aktualnych informacji. Należą do niej OAI-SearchBot, PerplexityBot i Claude-SearchBot. Trzecia grupa to programy uruchamiane na żądanie użytkownika: ktoś wkleja w rozmowie adres strony albo prosi asystenta o sprawdzenie konkretnej oferty i dopiero wtedy program odwiedza stronę. Tak działają ChatGPT-User, Perplexity-User i Claude-User.
Istotne jest to, że dostawcy sami rozdzielają te funkcje. W przeglądzie robotów OpenAI znajduje się wprost informacja, że każde ustawienie jest niezależne od pozostałych. Podobnie Anthropic opisuje trzy osobne roboty i dla każdego podaje inny skutek blokady. Właściciel strony nie musi więc wybierać między pełnym otwarciem a pełnym zamknięciem.
| Grupa robotów | Do czego służy | Co firma zyskuje, blokując | Co firma traci, blokując |
|---|---|---|---|
| Trenujące | Zbieranie treści, które mogą trafić do zbiorów uczących modele | Sygnał, że przyszłe treści nie powinny służyć do trenowania | Możliwy udział własnych treści w wiedzy przyszłych modeli |
| Wyszukujące | Indeks, z którego asystent wybiera i cytuje strony | Brak cytowania treści w odpowiedziach, mniej odwiedzin robotów | Obecność w odpowiedziach z wyszukiwaniem i linki do strony |
| Na żądanie użytkownika | Pobranie jednej strony, o którą poprosił konkretny człowiek | Często niewiele, bo reguły pliku robots.txt mogą nie być stosowane | Możliwość, by asystent przeczytał ofertę zamiast zgadywać |
Listy nazw i sposobu zapisu reguł w pliku robots.txt tutaj nie powtarzamy. Zajmujemy się tym, co poprzedza wpis w pliku, czyli decyzją biznesową.
Co daje, a co odbiera zamknięcie robotów trenujących
Zamknięcie robotów trenujących daje przede wszystkim jasny sygnał woli: treści publikowane od tej chwili nie powinny trafiać do zbiorów uczących modele. Nie odbiera natomiast widoczności w odpowiedziach z wyszukiwaniem, o ile roboty wyszukujące pozostają dopuszczone.
OpenAI podaje, że wykluczenie robota GPTBot oznacza, iż treści serwisu nie powinny być używane do trenowania generatywnych modeli. Anthropic opisuje skutek blokady robota ClaudeBot podobnie, z ważnym zastrzeżeniem: chodzi o przyszłe materiały. Blokada nie cofa więc czasu. To, co zostało zebrane wcześniej, nie znika z modeli dlatego, że w pliku pojawił się nowy wpis.
Kiedy blokada trenowania ma sens
Blokada ma największy sens tam, gdzie treść sama jest produktem. Serwis z płatnymi analizami, wydawca branżowy, autor kursów czy firma publikująca własne badania zarabiają na tym, że czytelnik musi przyjść po treść do nich. Jeżeli model nauczy się tej treści i będzie ją streszczał bez odesłania do źródła, wydawca ponosi koszt wytworzenia, a nie otrzymuje ani ruchu, ani zapłaty.
Sens ma również wtedy, gdy firma po prostu nie życzy sobie takiego wykorzystania swoich tekstów i zdjęć. Taka decyzja nie musi być uzasadniona rachunkiem ruchu. Kwestie prawne związane z trenowaniem modeli na cudzych treściach są złożone, dlatego opisujemy je ogólnie we wpisie o tym, co prawo autorskie mówi o treściach z AI i trenowaniu na cudzych stronach, a w konkretnej sprawie odsyłamy do prawnika.
Kiedy blokada trenowania może szkodzić
Firma, która żyje z tego, że klienci ją znają, znajduje się w innym położeniu. Dla biura rachunkowego, producenta okien czy gabinetu fizjoterapii treść strony nie jest towarem, tylko wizytówką. Takiej firmie zależy, żeby jej nazwa, zakres usług i miasta, w których działa, były znane możliwie szeroko. Żaden dostawca nie obiecuje, że dopuszczenie robota trenującego sprawi, iż model zapamięta daną firmę, więc nie należy traktować tego jako pewnej korzyści. Jest to jednak szansa, z której blokada rezygnuje, nie dając firmie usługowej wiele w zamian.
Ile kosztuje zamknięcie robotów wyszukujących
Zamknięcie robotów wyszukujących kosztuje obecność w odpowiedziach, w których asystent przeszukuje sieć i podaje źródła. To najdroższa z trzech blokad i dla większości firm nieopłacalna, ponieważ właśnie z tych odpowiedzi pochodzą wzmianki o marce i przejścia na stronę.
Dostawcy opisują ten skutek bez niedomówień. Według OpenAI serwisy, które wykluczyły robota OAI-SearchBot, nie będą pokazywane w odpowiedziach wyszukiwania w ChatGPT, choć mogą nadal pojawiać się jako linki nawigacyjne. Anthropic podaje, że zablokowanie robota Claude-SearchBot uniemożliwia indeksowanie treści na potrzeby wyszukiwania i może zmniejszyć widoczność strony oraz trafność informacji w wynikach pokazywanych użytkownikom. Perplexity w opisie swoich robotów zaleca dopuszczenie robota PerplexityBot, jeżeli strona ma pojawiać się w wynikach, i zaznacza, że nie służy on do zbierania treści na potrzeby modeli bazowych.
W określeniu „trafność informacji” kryje się koszt, o którym łatwo zapomnieć. Asystent zapytany o firmę i tak odpowie. Jeżeli nie ma dostępu do jej strony, oprze się na tym, co znajdzie gdzie indziej: na starych katalogach, wpisach osób trzecich, niepełnych wizytówkach. Blokada nie usuwa więc firmy z rozmów, tylko odbiera jej głos we własnej sprawie. Zjawisko to opisujemy szerzej we wpisie o tym, skąd biorą się błędne informacje o firmie w odpowiedziach AI.
Czy są sytuacje, w których warto je zamknąć
Są, ale należą do rzadkości. Wydawca, który uznaje, że streszczenie jego tekstu w odpowiedzi asystenta zastępuje wizytę w serwisie i nie przynosi przejść, może świadomie zrezygnować z obecności w tych odpowiedziach. Warto jednak rozważyć rozwiązanie pośrednie: zamknąć dla robotów wyszukujących wyłącznie część płatną lub archiwum, a strony ofertowe, opisy pakietów i teksty promocyjne pozostawić otwarte. Asystent nadal potrafi wtedy powiedzieć, czym jest serwis i jak wykupić dostęp, a nie potrafi streścić tego, za co czytelnik płaci.
Po każdej zmianie trzeba uwzględnić opóźnienie. OpenAI informuje, że dostosowanie wyników wyszukiwania do zmienionego pliku robots.txt może zająć około 24 godzin, a Perplexity podaje podobny okres dla swoich systemów. Jak asystenci dobierają cytowane strony, opisujemy we wpisach o tym, jak wyszukuje ChatGPT Search, oraz o tym, co decyduje o cytowaniu strony w Perplexity.
Co z robotami działającymi na żądanie użytkownika
Tych programów w większości przypadków nie warto blokować, a w części przypadków plikiem robots.txt nie da się tego zrobić skutecznie. Odwiedzają one stronę tylko wtedy, gdy poprosi o to konkretny człowiek, więc bliżej im do przeglądarki obsługiwanej przez pomocnika niż do robota przeczesującego sieć.
Dostawcy różnią się tu podejściem. OpenAI zaznacza, że skoro działania programu ChatGPT-User inicjuje użytkownik, reguły pliku robots.txt mogą nie mieć zastosowania, oraz że program ten nie służy do ustalania, czy treść może pojawić się w wyszukiwaniu. Perplexity pisze wprost, że Perplexity-User zasadniczo pomija reguły pliku robots.txt, ponieważ pobranie zlecił użytkownik. Anthropic podaje z kolei, że zablokowanie programu Claude-User uniemożliwia pobieranie treści w odpowiedzi na zapytanie użytkownika i może ograniczyć widoczność strony. Także Google w opisie modułów pobierania uruchamianych przez użytkownika wyjaśnia, że takie moduły zwykle ignorują reguły pliku robots.txt, bo żądanie pochodzi od człowieka.
Dla rachunku zysków i strat wynikają z tego dwie rzeczy. Wizyta takiego programu oznacza zwykle, że ktoś właśnie interesuje się ofertą: porównuje dostawców, sprawdza godziny otwarcia, prosi o streszczenie regulaminu. Odcięcie go przypomina zamknięcie drzwi przed klientem, który przysłał kogoś po ulotkę. Jeśli natomiast firma rzeczywiście musi wykluczyć taki ruch, potrzebuje narzędzia mocniejszego niż plik tekstowy: reguł w zaporze aplikacji internetowych albo dostępu po zalogowaniu. O programach, które nie tylko czytają, lecz także wykonują czynności w imieniu użytkownika, piszemy we wpisie o tym, co agenci AI oznaczają dla stron i sklepów.
Dlaczego Google wymaga osobnego rachunku
Google wymaga osobnego rachunku, ponieważ jego odpowiedzi generowane w wyszukiwarce korzystają z tego samego indeksu co zwykłe wyniki, a trenowanie modeli jest sterowane odrębnym znacznikiem. Błąd w tym miejscu jest najdroższy, bo może odebrać stronie ruch z wyszukiwarki, a nie tylko wzmianki w asystencie.
Znacznik Google-Extended opisany na stronie Typowe roboty Google pozwala wydawcom określić, czy treści zebrane przez Google mogą służyć do trenowania modeli Gemini oraz do osadzania odpowiedzi w źródłach w niektórych usługach. Dokumentacja zaznacza, że Google-Extended nie wpływa na uwzględnienie witryny w wyszukiwarce i nie jest czynnikiem rankingowym. Nie ma też własnej nazwy w żądaniach: strony pobierają dotychczasowe roboty Google, a znacznik działa wyłącznie jako ustawienie w pliku robots.txt.
Inaczej jest z Przeglądem od AI i Trybem AI. Według dokumentacji Google o funkcjach opartych na AI warunkiem pojawienia się w nich jako źródło jest to, by strona była zindeksowana i kwalifikowała się do wyświetlania w wyszukiwarce z fragmentem tekstu. Dodatkowych wymagań technicznych nie ma. Nie istnieje więc osobny robot, którego zamknięcie usunęłoby stronę wyłącznie z odpowiedzi generowanych, pozostawiając ją w zwykłych wynikach. Zablokowanie Googlebota w nadziei na taki efekt odbiera stronie możliwość skanowania w całości.
Narzędziem do ograniczania wykorzystania treści w tych funkcjach są ustawienia podglądu: nosnippet, data-nosnippet, max-snippet oraz noindex. W specyfikacji metatagów robots Google podaje, że reguła nosnippet zapobiega wykorzystywaniu treści jako bezpośredniego źródła danych wejściowych w Przeglądach od AI i w Trybie AI, a max-snippet ogranicza ilość treści, którą można w ten sposób wykorzystać. Cena jest wyraźna: te same reguły skracają lub usuwają opis strony w zwykłych wynikach. Ich stosowanie omawiamy we wpisie o tym, jak nosnippet, max-snippet i data-nosnippet ograniczają użycie treści w odpowiedziach AI Google.
Jest jeszcze jedna zależność, która psuje wiele dobrych zamiarów. Reguły zapisane w metatagach robot odczytuje dopiero po pobraniu strony. Jeżeli ten sam adres jest zablokowany w pliku robots.txt, robot reguł nie zobaczy i nie będzie ich przestrzegał. Nie należy więc łączyć obu metod na tych samych adresach.
Jeśli chcą Państwo zamówić pozycjonowanie AI, zachęcamy do kontaktu: tel. 222 500 844 lub mailowo: biuro@pozycjonowaniestron.pl
Firma usługowa: rachunek dla hydraulika, kancelarii i gabinetu
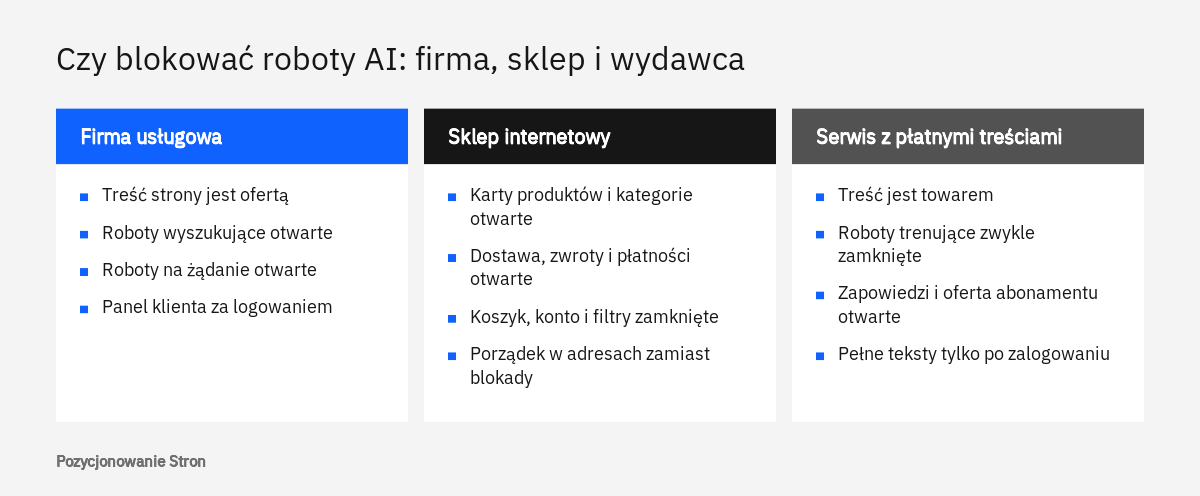
Firma usługowa w zdecydowanej większości przypadków więcej zyskuje na otwarciu niż na blokadzie. Jej strona nie sprzedaje treści, tylko przedstawia ofertę, a każdy czytelnik, także program działający w imieniu klienta, jest potencjalnym źródłem zapytania.
Posłużmy się hipotetycznym przykładem. Hydraulik z Łodzi ma stronę z opisem usług, obszarem dojazdu i numerem telefonu. Mieszkaniec pyta asystenta, kto w jego dzielnicy naprawi piec gazowy jeszcze dziś. Jeżeli roboty wyszukujące mają dostęp do strony, asystent może odczytać zakres usług i godziny pracy, a następnie podać firmę jako jedną z możliwości. Jeżeli strona jest zamknięta, asystent sięgnie po to, co znajdzie w innych miejscach, i wskaże tego, o kim wie więcej. Hydraulik nie stracił w tym scenariuszu żadnej treści, którą mógłby sprzedać, bo jej nie sprzedaje. Stracił zapytanie.
Drugi hipotetyczny przykład to kancelaria z Krakowa, która prowadzi blog z objaśnieniami przepisów. Teksty są owocem pracy prawników i ktoś mógłby uznać, że nie należy ich oddawać. Warto jednak zapytać, po co kancelaria je publikuje. Jeżeli celem jest pokazanie kompetencji i pozyskanie klientów, to cytowanie tekstu w odpowiedzi asystenta z podaniem źródła realizuje dokładnie ten cel. Rozsądne ustawienie to dopuszczenie robotów wyszukujących i działających na żądanie, a decyzja o robotach trenujących zależy od podejścia wspólników.
Co firma usługowa powinna jednak zamknąć
Zamknięcia wymagają nie roboty, lecz konkretne części serwisu. Panel klienta, dokumenty przeznaczone dla kontrahentów, wyceny pod indywidualnymi adresami i środowisko testowe nie powinny być dostępne dla żadnego programu. Tu jednak plik robots.txt nie jest właściwym narzędziem. Google w wprowadzeniu do pliku robots.txt wyjaśnia, że nie jest on mechanizmem ukrywania strony, a treści poufne należy chronić innymi metodami, na przykład hasłem. Co więcej, wpisanie adresu poufnego katalogu do publicznie dostępnego pliku samo wskazuje, gdzie go szukać.
Sklep internetowy: widoczność produktów kontra ochrona danych
Sklep internetowy powinien co do zasady pozostawić roboty wyszukujące i działające na żądanie otwarte, a uwagę skupić na tym, które części sklepu udostępnia. Asystent, który nie może odczytać karty produktu, nie poda ceny, dostępności ani parametrów, więc w porównaniu zakupowym sklep po prostu się nie pojawi.
Wyobraźmy sobie sklep z Poznania sprzedający sprzęt do domowej siłowni. Klient prosi asystenta o porównanie trzech bieżni do określonej kwoty z szybką dostawą. Odpowiedź powstaje z kart produktów, opisów dostawy i zasad zwrotów tych sklepów, do których asystent ma dostęp. Sklep z blokadą nie uczestniczy w tym porównaniu, choć mógł mieć najlepszą ofertę. W handlu internetowym strata jest więc bardziej bezpośrednia niż w usługach, bo dotyczy konkretnej transakcji.
Czego sklepy się obawiają i ile w tym racji
Najczęściej słyszymy trzy obawy. Pierwsza dotyczy kopiowania opisów produktów. Jest uzasadniona wtedy, gdy opisy są autorskie i rozbudowane, lecz te same opisy są publicznie dostępne dla każdej przeglądarki, a blokada rzetelnych robotów nie powstrzyma programów, które pliku robots.txt nie czytają. Druga dotyczy śledzenia cen przez konkurencję. Zamknięcie robotów asystentów nie utrudni pracy wyspecjalizowanym programom do monitorowania cen. Trzecia dotyczy obciążenia serwera przy dużym asortymencie i ta bywa w pełni zasadna. Rozwiązaniem nie jest jednak zamknięcie całego sklepu, tylko uporządkowanie tego, co roboty mogą odwiedzać. Zasady, które opisujemy we wpisie o tym, gdzie Googlebot traci czas w sklepie z dużym asortymentem, ograniczają zbędne odwiedziny także innych robotów. Anthropic podaje ponadto, że jego roboty obsługują niestandardową regułę Crawl-delay, która pozwala spowolnić odwiedziny bez ich zakazywania.
Rozsądny podział wygląda zwykle następująco. Karty produktów, kategorie, strony marek, informacje o dostawie, zwrotach i płatnościach pozostają otwarte. Koszyk, konto klienta, wyniki wewnętrznej wyszukiwarki i kombinacje filtrów pozostają zamknięte dla wszystkich robotów, nie tylko tych związanych z AI. O tym, jak sklepy trafiają do odpowiedzi zakupowych, piszemy we wpisie o tym, jak działają feedy produktowe i zakupy w ChatGPT oraz w Google, a prace nad widocznością asortymentu obejmuje pozycjonowanie sklepów.
Serwis z płatnymi treściami: gdzie blokada naprawdę się opłaca
Serwis z płatnymi treściami jest jedynym z trzech scenariuszy, w którym blokada robotów trenujących jest ustawieniem domyślnie uzasadnionym, a ograniczenie robotów wyszukujących bywa warte rozważenia. Tutaj treść jest towarem, a każda odpowiedź zastępująca lekturę zmniejsza powód do wykupienia dostępu.
Rachunek wydawcy ma jednak dwie strony. Po stronie strat z otwarcia znajduje się ryzyko, że streszczenie zaspokoi ciekawość czytelnika i nie dojdzie do wizyty. Po stronie strat z zamknięcia znajduje się utrata kanału, którym nowi czytelnicy w ogóle dowiadują się o istnieniu serwisu. Wydawca, którego nikt nie cytuje, przestaje być w rozmowach z asystentami źródłem, na które ktokolwiek się powołuje. Dlatego najczęściej opłaca się rozwiązanie warstwowe, a nie skrajne.
Hipotetyczny serwis branżowy z analizami rynku nieruchomości może postąpić następująco. Robotom trenującym odmawia dostępu do całego serwisu. Robotom wyszukującym pozostawia strony z zapowiedziami tekstów, opisem oferty abonamentowej, sylwetkami autorów i częścią ogólnodostępną. Pełna treść analiz jest dostępna wyłącznie po zalogowaniu, więc żaden program jej nie pobierze, niezależnie od tego, czy stosuje się do pliku robots.txt. To ostatnie zdanie jest w całym rachunku najważniejsze. Ochrona płatnej treści opiera się na logowaniu, a plik robots.txt wyraża jedynie wolę wobec części publicznej.
Płatna treść a wyszukiwarka Google
Wydawca, który udostępnia Googlebotowi pełny tekst, a czytelnikowi pokazuje zaporę płatności, powinien oznaczyć taką treść danymi strukturalnymi. Google opisuje je na stronie o uporządkowanych danych dotyczących treści płatnych i dostępnych w ramach subskrypcji i wyjaśnia, że pomagają one odróżnić treści płatne od maskowania, czyli pokazywania robotowi czegoś innego niż użytkownikowi, co narusza zasady dotyczące spamu. Służy do tego właściwość isAccessibleForFree z wartością false oraz wskazanie płatnej sekcji selektorem klasy. Jeżeli wydawca chce pozostać w zwykłych wynikach i zarazem ograniczyć wykorzystanie tekstu w odpowiedziach generowanych przez Google, atrybut data-nosnippet pozwala wyłączyć z podglądu wybrany fragment, na przykład kluczowe wnioski analizy, pozostawiając wstęp.
Jak podjąć decyzję i sprawdzić jej skutki
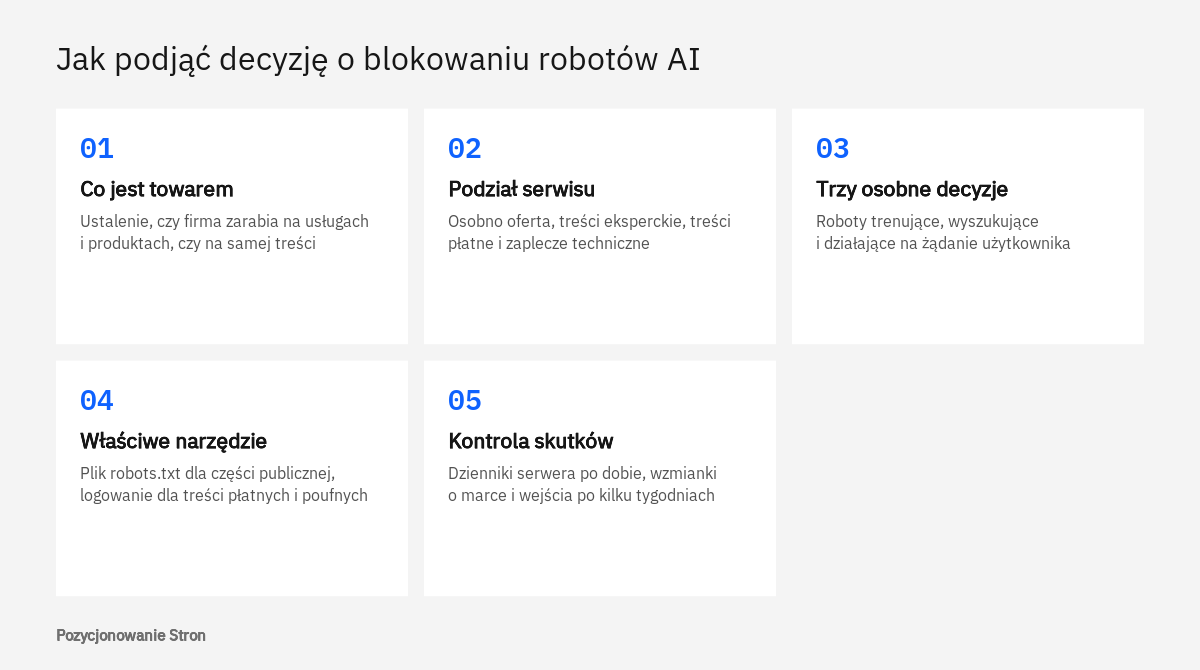
Decyzję najlepiej podjąć na piśmie, w kilku zdaniach, zanim ktokolwiek otworzy plik robots.txt: co jest w firmie towarem, skąd przychodzą klienci i które części serwisu mają pozostać publiczne. Dopiero z takiej notatki wynika ustawienie dla każdej z trzech grup robotów, a po wdrożeniu trzeba je sprawdzić w danych.
Zaczynamy od stanu obecnego, bo wiele firm blokuje roboty AI, nie wiedząc o tym. Blokada bywa włączona jednym przełącznikiem w usłudze sieci dostarczania treści, w zaporze hostingu albo we wtyczce bezpieczeństwa, a w pliku robots.txt nie ma po niej śladu. Dlatego oprócz otwarcia pliku pod adresem domeny z dopiskiem /robots.txt warto przejrzeć dzienniki serwera lub panel zapory i ustalić, jakie odpowiedzi otrzymują roboty asystentów.
- Ustalenie, co jest towarem
Jeżeli firma zarabia na usługach lub produktach, treść strony jest ofertą i powinna być czytana. Jeżeli zarabia na samej treści, część płatna wymaga ochrony.
- Podział serwisu na części
Osobno należy wypisać strony ofertowe, treści eksperckie, treści płatne oraz zaplecze techniczne, takie jak koszyk i konto klienta.
- Decyzja dla każdej grupy robotów
Dla robotów trenujących, wyszukujących i działających na żądanie użytkownika zapada osobne postanowienie.
- Dobór właściwego narzędzia
Wolę wobec części publicznej wyraża plik robots.txt, podgląd w Google ograniczają reguły w metatagach, a treści poufne i płatne chroni logowanie.
- Kontrola po wdrożeniu
Po upływie co najmniej doby warto porównać odwiedziny robotów w dziennikach serwera, a po kilku tygodniach wzmianki o marce w odpowiedziach asystentów.
Gdzie sprawdzić skutki
W przypadku Google ruch z funkcji opartych na AI nie ma osobnego raportu. Dokumentacja podaje, że jest on uwzględniany w Search Console w raporcie skuteczności, w rodzaju wyszukiwania „Sieć”, razem z pozostałym ruchem z wyników. Zmianę można więc ocenić tylko pośrednio, porównując okresy dla tych samych adresów. Pomiar dla pozostałych asystentów opisujemy we wpisie o tym, jak mierzyć widoczność marki w odpowiedziach AI.
Typowe pomyłki przy tej decyzji
- Jedna reguła zamykająca wszystkie roboty AI naraz, bez rozróżnienia robotów trenujących i wyszukujących.
- Zablokowanie Googlebota w przekonaniu, że usunie to stronę tylko z odpowiedzi generowanych.
- Traktowanie znacznika Google-Extended jako wyłącznika Przeglądu od AI i Trybu AI.
- Łączenie blokady w pliku robots.txt z regułami w metatagach na tych samych adresach.
- Ochrona treści płatnych lub poufnych wyłącznie wpisem w pliku robots.txt.
- Blokada włączona w zaporze lub we wtyczce, o której nikt w firmie nie pamięta.
- Ocena skutków w dniu zmiany, przed upływem czasu potrzebnego dostawcom na jej uwzględnienie.
Kiedy potrzebna jest pomoc
Wsparcie przydaje się wtedy, gdy serwis ma wiele subdomen, gdy ruch robotów realnie obciąża serwer, gdy blokady są rozproszone między plikiem, zaporą i wtyczkami oraz gdy firma planuje model płatnego dostępu. Decyzję warto wtedy poprzedzić przeglądem, który obejmuje SEO techniczne, a prace nad obecnością marki w odpowiedziach asystentów opisujemy na stronie usługi pozycjonowanie AI. Nie obiecujemy przy tym konkretnych miejsc w odpowiedziach, ponieważ o doborze źródeł decydują dostawcy asystentów. W sprawach licencji i roszczeń właściwym doradcą jest prawnik.
Jeśli chcą Państwo zamówić pozycjonowanie AI, zachęcamy do kontaktu: tel. 222 500 844 lub mailowo: biuro@pozycjonowaniestron.pl
Najczęstsze pytania
Czy zablokowanie robotów AI obniży pozycje strony w Google?
Zablokowanie robotów innych dostawców nie dotyczy wyszukiwarki Google. Znacznik Google-Extended według dokumentacji Google nie wpływa na obecność witryny w wyszukiwarce i nie jest czynnikiem rankingowym. Szkodę wyrządzi natomiast zablokowanie Googlebota.
Czy można zakazać trenowania, a pozostać w odpowiedziach asystentów?
Tak. Dostawcy opisują roboty trenujące i wyszukujące jako osobne programy z niezależnymi ustawieniami. Można więc odmówić dostępu pierwszym i dopuścić drugie.
Czy blokada usunie z modeli treści zebrane wcześniej?
Nie. Anthropic podaje, że blokada robota trenującego jest sygnałem dotyczącym przyszłych materiałów serwisu. Plik robots.txt nie jest narzędziem do wycofywania treści z istniejących modeli.
Czy plik robots.txt wystarczy, aby ochronić płatne treści?
Nie wystarczy. Google wyjaśnia, że plik robots.txt nie jest mechanizmem ukrywania stron i że nie wszystkie roboty stosują się do jego reguł. Treść przeznaczona tylko dla abonentów powinna znajdować się za logowaniem.
Po jakim czasie widać skutki zmiany ustawień?
OpenAI podaje, że dostosowanie wyników wyszukiwania do zmienionego pliku robots.txt może zająć około 24 godzin, a Perplexity wskazuje podobny okres. Wpływ na wzmianki o marce i wejścia na stronę warto oceniać dopiero po kilku tygodniach.
Czy da się zniknąć z Przeglądu od AI, a zostać w zwykłych wynikach Google?
Nie ma osobnego wyłącznika dla samych odpowiedzi generowanych. Google wskazuje reguły nosnippet, data-nosnippet i max-snippet jako sposób ograniczenia wykorzystania treści, lecz te same reguły skracają lub usuwają opis strony w zwykłych wynikach.
Źródła
- Overview of OpenAI Crawlers, OpenAI
- Does Anthropic crawl data from the web, and how can site owners block the crawler?, Anthropic
- Perplexity Crawlers, Perplexity
- Typowe roboty Google, Google
- Funkcje oparte na AI a Twoja witryna, Centrum wyszukiwarki Google
- Specyfikacje metatagów robots, Centrum wyszukiwarki Google
- Plik robots.txt - wprowadzenie, Centrum wyszukiwarki Google
- Moduły pobierania uruchamiane przez użytkownika w Google, Centrum wyszukiwarki Google
- Uporządkowane dane dotyczące treści płatnych i dostępnych w ramach subskrypcji, Centrum wyszukiwarki Google
- Weryfikowanie żądań od robotów i modułów pobierania Google, Google
Funkcje wyszukiwarek i asystentów AI zmieniają się szybko, dlatego wpis aktualizujemy po większych zmianach.