Deduplikacja to działanie systemów Google, które z grupy niemal identycznych stron pokazują w wynikach tylko jedną, uznaną za najbardziej trafną. Wyjaśniamy, w którym momencie zapada ta decyzja, skąd bierze się informacja o pominiętych wynikach, jak działa to przy fragmencie z odpowiedzią i jak ustalić, którą wersję strony Google uznał za główną.
Czym jest deduplikacja w wynikach Google
Deduplikacja to usuwanie z listy wyników stron, które powtarzają to samo, co wynik już pokazany. Google wymienia systemy deduplikacji wśród aktywnych systemów rankingowych w dokumencie opisującym systemy rankingowe wyszukiwarki. Z opisu wynika prosta zasada: wyszukiwarka potrafi znaleźć tysiące, a nawet miliony pasujących stron, część z nich jest do siebie bardzo podobna, więc aby uniknąć zbędnych powtórzeń, pokazywane są tylko najbardziej trafne pozycje.
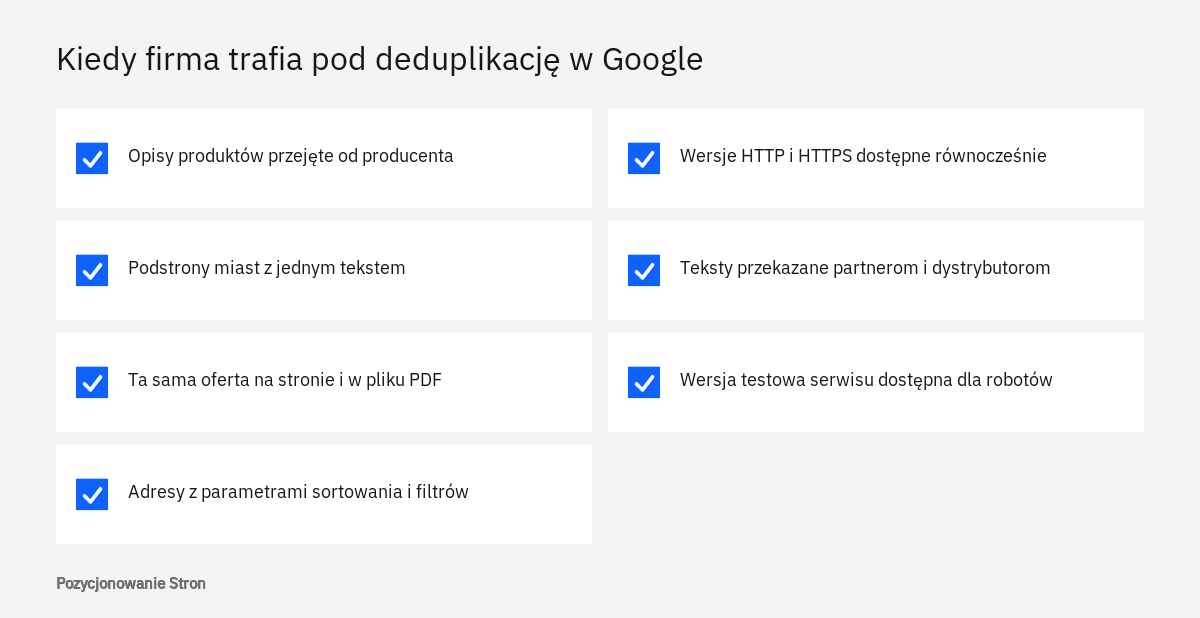
Warto od razu oddzielić to zjawisko od kar. W dokumentacji dotyczącej wyboru strony kanonicznej Google zaznacza, że powielone treści bywają czymś zwyczajnym i same w sobie nie naruszają zasad dotyczących spamu. Ta sama oferta dostępna pod adresem z protokołem HTTP i HTTPS, lista produktów po posortowaniu, osobny adres wersji mobilnej, wersja testowa serwisu, do której dotarł robot - to typowe źródła powtórzeń wymienione w tym dokumencie. Żadne z nich nie jest próbą oszukania wyszukiwarki, a mimo to każde sprawia, że jedna treść istnieje pod kilkoma adresami.
Proces, w którym Google z zestawu takich samych lub bardzo podobnych stron wybiera jedną reprezentatywną i tylko ją pokazuje w wynikach. W dokumentacji pojęcie to pojawia się obok wyboru strony kanonicznej, czyli adresu uznanego za główny w grupie duplikatów.
Dla właściciela firmy skutek jest odczuwalny w jednym miejscu: w wynikach widać inny adres niż ten, na którym firmie zależy, albo nie widać żadnej z kilku przygotowanych podstron poza jedną. Weźmy hipotetycznego producenta okien z Bydgoszczy, który tę samą ofertę ma na stronie głównej, na podstronie oferty oraz w pliku PDF. Dla człowieka to trzy różne miejsca w serwisie. Dla wyszukiwarki to trzy adresy z tą samą treścią główną, z których w wynikach zmieści się zwykle jeden.
Dwa etapy, na których Google odsiewa powtórzenia
Google odsiewa powtórzenia w dwóch różnych momentach: podczas indeksowania, gdy łączy duplikaty w grupę i wybiera adres kanoniczny, oraz podczas wyświetlania wyników, gdy z listy dla konkretnego zapytania usuwa pozycje zbyt do siebie podobne. To rozróżnienie porządkuje całą diagnozę, ponieważ każdy etap sprawdza się inaczej i inaczej się na niego wpływa. Ogólny przebieg pracy wyszukiwarki opisujemy we wpisie o tym, jak przebiega skanowanie, indeksowanie i wyświetlanie wyników.
Podczas indeksowania: grupa duplikatów i adres kanoniczny
Według dokumentacji Google podczas indeksowania ustala główną treść każdej strony i grupuje strony, które wyglądają tak samo lub mają bardzo podobną treść główną. Z takiej grupy wybierana jest strona, która na podstawie zebranych sygnałów jest najbardziej kompletna i przydatna dla szukających. To ona staje się stroną kanoniczną, czyli głównym źródłem oceny treści i jakości. Jest też skanowana najczęściej, natomiast pozostałe adresy z grupy robot odwiedza rzadziej, aby nie obciążać serwera.
Wśród sygnałów branych pod uwagę dokumentacja wymienia to, czy strona jest dostępna przez HTTP czy HTTPS, przekierowania, obecność adresu w mapie witryny oraz adnotację rel="canonical", czyli znacznik wskazujący adres uznawany przez właściciela za główny. Właściciel może więc zgłosić swoją preferencję, ale Google wprost zastrzega, że jest to wskazówka, a nie dyrektywa, i z różnych powodów wybór może paść na inny adres.
Podczas wyświetlania: filtr bardzo podobnych wyników
Drugi etap dotyczy stron, które są w indeksie jako osobne pozycje, ale dla danego zapytania niosą tę samą informację. Mechanizm ten opisuje dokumentacja wyszukiwarki programowalnej Google w części o automatycznym filtrowaniu wyników wyszukiwania. Wymienia ona dwie techniki. Pierwsza dotyczy powielonych treści: jeżeli kilka dokumentów zawiera te same informacje, w wynikach pojawia się tylko najbardziej trafny z tej grupy. Druga dotyczy nagromadzenia wyników z jednego hosta: gdy wiele pozycji pochodzi z tej samej witryny, część z nich może zostać ukryta albo pokazana niżej.
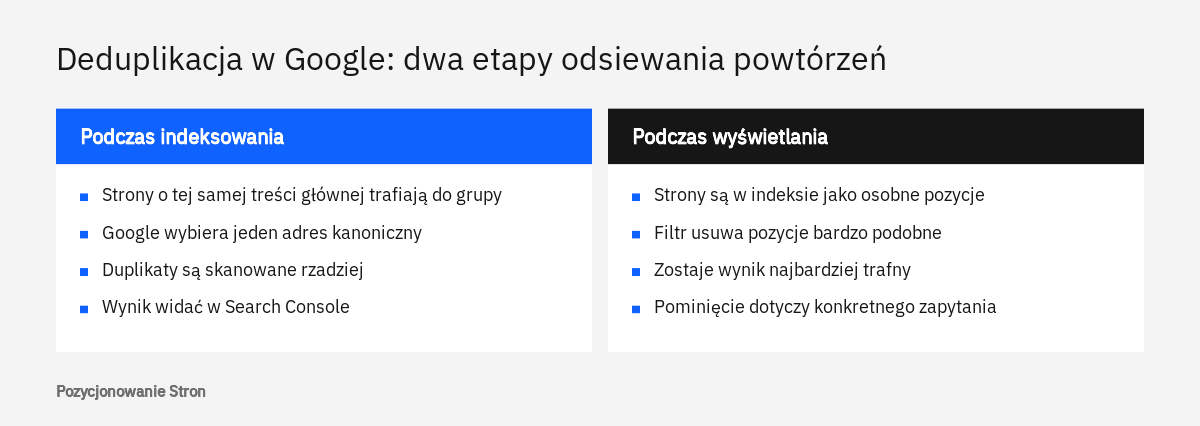
Różnica ma znaczenie praktyczne. Strona odrzucona na pierwszym etapie w ogóle nie jest indeksowana pod własnym adresem i widać to w Search Console. Strona odfiltrowana na drugim etapie jest zindeksowana, może pojawiać się przy innych zapytaniach, a pomijana jest tylko tam, gdzie konkuruje z bardzo podobną pozycją.
Co Google uznaje za tę samą treść
Punktem odniesienia jest treść główna, a nie cała strona z nagłówkiem, menu i stopką. Dobrze pokazuje to przykład wersji językowych z dokumentacji: różne wersje językowe są duplikatami tylko wtedy, gdy ich treść główna jest w tym samym języku. Jeżeli przetłumaczono wyłącznie nagłówek, stopkę i inne drobne elementy, a zasadniczy tekst pozostał bez zmian, strony nadal są traktowane jako duplikaty. Ten sam sposób myślenia warto przyłożyć do podstron ofertowych: zmiana zdjęcia w nagłówku lub jednego słowa w tytule nie tworzy nowej treści głównej.
Komunikat o pominiętych wynikach: kiedy się pojawia i co oznacza
Informacja o pominiętych wynikach pojawia się na końcu listy wtedy, gdy filtr bardzo podobnych pozycji usunął część stron pasujących do zapytania. Z naszej praktyki wynika, że wyszukiwarka informuje wówczas, że dla pokazania najbardziej trafnych wyników pominięto pozycje bardzo podobne do już wyświetlonych, i daje możliwość powtórzenia wyszukiwania z ich uwzględnieniem. Zaznaczamy uczciwie: dokładnego brzmienia tego komunikatu ani zasad jego wyświetlania nie znaleźliśmy w dokumentacji dla właścicieli witryn, dlatego opisujemy go jako obserwację, a nie cytat z Google.
Udokumentowany jest natomiast sam mechanizm. W opisie interfejsu wyszukiwarki programowalnej Google podaje, że filtrowanie jest domyślnie włączone i stosowane do wszystkich wyników w celu poprawy ich jakości, a parametr o nazwie filter przyjmuje dwie wartości: zero wyłącza filtr powielonych treści, jedynka go włącza. Opis ten dotyczy interfejsu programistycznego, a nie zwykłego okna wyszukiwarki, ale dobrze tłumaczy, czym jest powtórzenie wyszukiwania bez pominięć: to ta sama lista, tyle że bez odsiewania pozycji podobnych.
Przy jakich zapytaniach widać go najczęściej
Z naszych obserwacji wynika, że komunikat pojawia się najczęściej w dwóch sytuacjach. Pierwsza to zapytanie z operatorem site:, którym właściciel ogląda podstrony własnej domeny. Druga to wklejenie w cudzysłowie dłuższego zdania z własnego tekstu, na przykład z opisu produktu.
Przy operatorze site: potrzebna jest dodatkowa ostrożność. W dokumentacji dotyczącej operatora wyszukiwania w witrynie Google zastrzega, że lista zwróconych adresów nie zawsze jest wyczerpująca, a przy większych serwisach nie należy oczekiwać wszystkich adresów. Zapytanie tego typu bez słowa kluczowego nie ustala też rankingu: zwykle pierwszy jest najkrótszy adres, a reszta ułożona jest przypadkowo. Brak podstrony na takiej liście nie dowodzi więc, że nie ma jej w indeksie.
Deduplikacja przy fragmencie z odpowiedzią
Strona, z której Google utworzył fragment z odpowiedzią, nie jest pokazywana drugi raz jako zwykły wynik na pierwszej stronie. Wynika to wprost z opisu systemów deduplikacji: deduplikacja obejmuje także fragmenty z odpowiedzią, a jej celem jest większa przejrzystość wyników. Fragment z odpowiedzią to wyróżnione pole, w którym najpierw widać krótki wycinek treści odpowiadający na pytanie, a dopiero pod nim adres i tytuł strony. Jego miejsce wśród innych elementów listy omawiamy we wpisie o tym, z czego składa się strona wyników Google.
W praktyce oznacza to, że firma, której podstrona trafiła do takiego pola, ma na pierwszej stronie jedno miejsce, a nie dwa. Hipotetyczna kancelaria z Krakowa, której wpis o terminach w sprawach spadkowych został wybrany do fragmentu z odpowiedzią, zobaczy ten wpis w wyróżnionym polu, ale nie znajdzie go ponownie wśród zwykłych pozycji poniżej. Nie jest to spadek pozycji, tylko skutek opisanej zasady.
Na co właściciel strony ma wpływ
Według dokumentacji o fragmentach z odpowiedzią nie da się oznaczyć strony jako źródła takiego pola. Decydują o tym systemy Google. Można natomiast z fragmentów zrezygnować, w całości albo częściowo. Służą do tego trzy ustawienia, które zestawiamy poniżej.
| Ustawienie | Co blokuje | O czym warto wiedzieć |
|---|---|---|
| nosnippet | Wszystkie fragmenty z danej strony, zwykłe i z odpowiedzią | Jedyny pewny sposób rezygnacji. Gdy na stronie jest też data-nosnippet, pierwszeństwo ma nosnippet. |
| data-nosnippet | Wybrany tekst na stronie | Oznaczony tekst nie pojawi się ani we fragmencie z odpowiedzią, ani w zwykłym opisie wyniku. |
| max-snippet | Długość opisu wyniku | Im niższa wartość, tym mniejsze prawdopodobieństwo fragmentu z odpowiedzią. Google nie podaje dokładnego progu, więc nie ma tu gwarancji. |
Szczegóły składni omawiamy we wpisie o regułach nosnippet, max-snippet i data-nosnippet.
Deduplikacja a różnorodność witryn: dwa różne ograniczenia
Deduplikacja usuwa strony o podobnej treści, a system różnorodności witryn ogranicza liczbę wyników z jednej witryny bez względu na to, jak bardzo różnią się ich treści. Oba mechanizmy bywają mylone, bo dają podobny efekt: firma widzi w wynikach mniej własnych podstron, niż oczekiwała.
Według opisu systemów rankingowych system różnorodności witryn zwykle pokazuje wśród najważniejszych wyników najwyżej dwie strony z tej samej witryny, tak aby jedna witryna nie zdominowała listy. Przy zapytaniach, dla których jest to szczególnie uzasadnione, może pokazać ich więcej. Subdomeny są zasadniczo traktowane jako część domeny głównej.
Przygotowanie dziesięciu podstron pod jedno zapytanie nie daje więc dziesięciu miejsc na liście. Lepszy skutek daje jedna mocna podstrona na jedną potrzebę klienta, o czym piszemy we wpisie o podobnych produktach i kanibalizacji.
Skutki dla firm z powielonymi opisami
Firma, która używa tego samego opisu co inne serwisy albo powtarza jeden tekst na wielu własnych podstronach, konkuruje o jedno miejsce w grupie podobnych wyników, a nie o osobną pozycję dla każdej podstrony. Nie grozi jej za to kara, ale też nie ma żadnej pewności, że to właśnie jej adres zostanie uznany za najbardziej trafny.
Sklep z opisami od producenta
Hipotetyczny sklep z Poznania sprzedający sprzęt ogrodniczy wstawia do kart produktów opisy dostarczone przez producenta. Te same zdania mają dziesiątki innych sprzedawców. Gdy klient wpisuje nazwę modelu, wyszukiwarka trafia na grupę stron z tą samą informacją i zgodnie z opisaną zasadą pokazuje z niej to, co uzna za najbardziej trafne. Jak oceniać tę sytuację i od których kart zacząć zmiany, wyjaśniamy we wpisie o opisach od producenta w sklepie.
Firma usługowa z podstronami dla miast
Hipotetyczny hydraulik z Łodzi przygotowuje piętnaście podstron dla okolicznych miejscowości i na każdej umieszcza ten sam tekst z podmienioną nazwą miasta. Treść główna jest praktycznie jednakowa, więc takie podstrony mogą zostać połączone w jedną grupę już przy indeksowaniu albo odfiltrowane przy wyświetlaniu wyników. Jest też drugi, poważniejszy wymiar. W zasadach dotyczących spamu Google opisuje strony przejściowe i jako przykład podaje między innymi wiele stron lub domen ukierunkowanych na określone regiony albo miasta, które prowadzą użytkownika do jednej strony. Zasady zaznaczają przy tym, że żaden pojedynczy czynnik nie przesądza o naruszeniu. Podstrona miasta, która zawiera własne informacje o dojeździe, obsługiwanych osiedlach i warunkach usługi w danym miejscu, jest po prostu inną treścią. Budowę takich podstron prowadzimy w ramach pozycjonowania lokalnego.
Teksty przekazywane partnerom i treści skopiowane
Producent, który udostępnia swój opis dystrybutorom, albo firma, która ten sam komunikat prasowy rozsyła do kilku serwisów, sama tworzy grupę podobnych wyników. W dokumentacji o rozwiązywaniu problemów z wyborem strony kanonicznej Google odradza w takiej sytuacji poleganie na znaczniku kanonicznym u partnerów, ponieważ ich strony często różnią się od oryginału. Jako skuteczniejsze wskazuje zablokowanie indeksowania udostępnionej treści po stronie partnera. Warto zapisać to w umowie o współpracy, zanim tekst zostanie przekazany.
Ten sam dokument opisuje rzadki przypadek, w którym Google wybiera jako główną zewnętrzną witrynę, która powieliła treść bez zgody. Wskazane tam drogi to zwrócenie się do właściciela strony o usunięcie materiału albo zgłoszenie naruszenia praw autorskich. Są to kwestie prawne, które w konkretnej sprawie warto omówić z prawnikiem.
Deduplikacja wpływa także na to, co widać w danych. Dokumentacja zwraca uwagę, że jeżeli adres kanoniczny należy do usługi w Search Console, która nie jest własnością danej firmy, ruch z powielonej strony nie będzie w jej raportach widoczny. Z kolei wskazanie jednego adresu kanonicznego pozwala połączyć na nim sygnały, takie jak linki prowadzące do różnych wersji.
Jeśli chcą Państwo zamówić audyt SEO, zachęcamy do kontaktu: tel. 222 500 844 lub mailowo: biuro@pozycjonowaniestron.pl
Jak ustalić, którą wersję Google uznał za główną
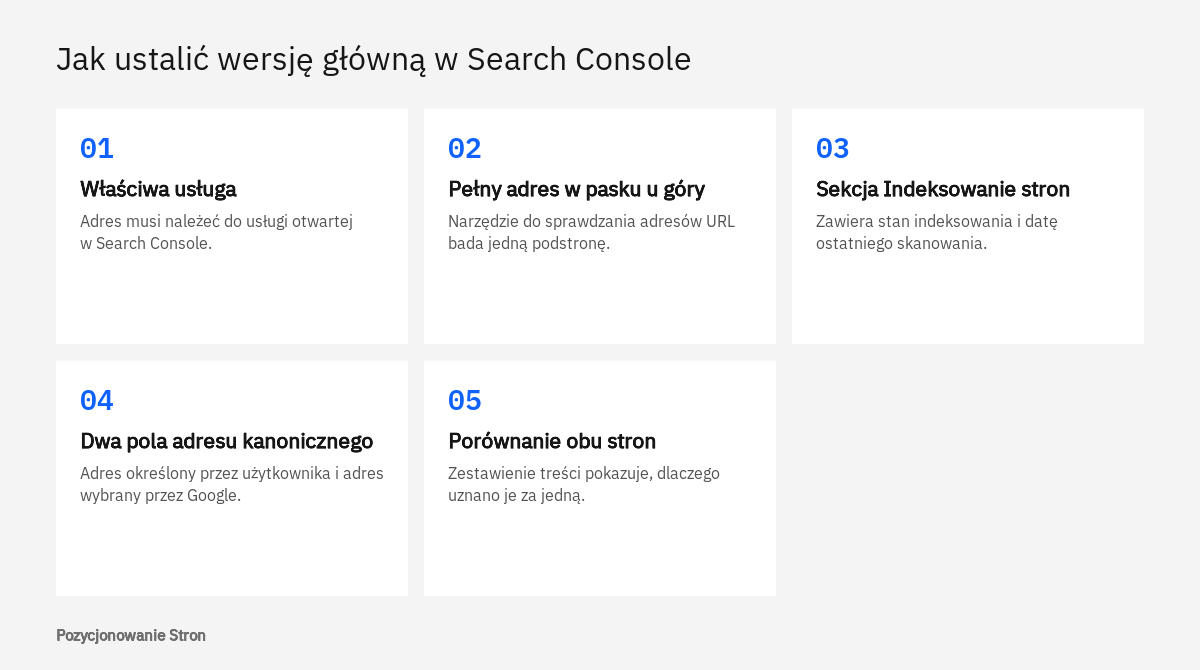
Wersję uznaną za główną pokazuje narzędzie do sprawdzania adresów URL w Search Console, w polu „Adres kanoniczny wybrany przez Google”. To miejsce, w którym Google podaje tę informację wprost dla konkretnego adresu, dlatego zgadywanie na podstawie wyników wyszukiwania warto zastąpić odczytem z panelu.
- Otwarcie właściwej usługi w Search Console
Sprawdzany adres musi należeć do usługi, która jest aktualnie otwarta.
- Wklejenie pełnego adresu w pasku u góry ekranu
Zgodnie z pomocą Search Console pełny adres wkleja się w pasku wyszukiwania widocznym u góry każdego ekranu. W większości raportów to samo narzędzie uruchamia odnośnik widoczny przy adresie strony.
- Rozwinięcie sekcji „Indeksowanie stron”
Sekcja pokazuje między innymi stan indeksowania, mapy witryn zawierające ten adres, stronę odsyłającą i datę ostatniego skanowania.
- Porównanie dwóch pól z adresem kanonicznym
Pole „Adres kanoniczny określony przez użytkownika” pokazuje adres zadeklarowany w serwisie, a gdy deklaracji nie ma, wartość „Brak”. Pole „Adres kanoniczny wybrany przez Google” pokazuje decyzję wyszukiwarki. Różnica między nimi oznacza, że deklaracja nie została przyjęta.
- Sprawdzenie adresu wskazanego przez Google
Adres z drugiego pola warto otworzyć i zbadać tym samym narzędziem. Dopiero zestawienie obu stron pokazuje, co je łączy.
Dwie rzeczy często wprowadzają w błąd. Po pierwsze, adres wybrany przez Google jest ustalany w chwili indeksowania i może zostać zaktualizowany kilka godzin po głównych danych indeksu. Po drugie, test wersji opublikowanej, czyli badanie strony w czasie rzeczywistym, nie sprawdza wyboru strony kanonicznej. Pozytywny wynik takiego testu nie mówi więc nic o tym, którą wersję wyszukiwarka uzna za główną.
Statusy w raporcie Indeksowanie stron
Dla całej witryny ten sam obraz daje raport Indeksowanie stron. W tabeli „Dlaczego strony nie są indeksowane” występują trzy przyczyny związane z duplikatami.
| Status w raporcie | Co oznacza | Zalecane postępowanie |
|---|---|---|
| Duplikat, użytkownik nie oznaczył strony kanonicznej | Strona powtarza inną i nie wskazuje wersji głównej. Google wybrał inny adres, więc ta strona nie będzie wyświetlana. | Odczytać wybór Google w narzędziu do sprawdzania adresów. Jeżeli jest błędny, wyraźnie oznaczyć adres kanoniczny. Jeżeli strona nie jest duplikatem, zadbać o wyraźnie inną treść. |
| Duplikat, wyszukiwarka Google wybrała inną stronę kanoniczną niż użytkownik | Strona jest oznaczona jako główna dla zestawu, ale Google uznał, że lepiej sprawdzi się inny adres, i to jego zindeksował. | Porównać oba pola z adresem kanonicznym. Poprawić wskazanie albo sprawić, by strony rzeczywiście się różniły. |
| Alternatywna strona zawierająca prawidłowy tag strony kanonicznej | Strona jest inną wersją strony głównej, na przykład mobilną, i poprawnie na nią wskazuje. | Nic nie trzeba robić. To zamierzony stan. |
Z naszej praktyki wynika, że w obecnym układzie panelu raport ten otwiera się z menu po lewej stronie, w grupie Indeksowanie, pod pozycją Strony. Pomoc Google zaznacza też, że Search Console nie wykrywa alternatywnych wersji językowych, więc serwisy wielojęzyczne wymagają osobnej kontroli.
Co zrobić, gdy Google wybrał inną wersję, niż wskazano
Najpierw należy ocenić, czy wybór Google nie jest po prostu lepszy dla użytkownika, a dopiero potem wzmacniać sygnały wskazujące na preferowany adres albo różnicować treść. Taką kolejność zaleca sama dokumentacja. Zdarza się, że deklaracja właściciela była pozostałością po dawnej wersji strony.
Metody wskazywania adresu kanonicznego i ich siła
Dokumentacja o tym, jak określić kanoniczny URL, szereguje metody od najsilniejszej. Można je łączyć, pod warunkiem że wszystkie wskazują ten sam adres.
| Metoda | Siła sygnału | Kiedy stosować |
|---|---|---|
| Przekierowanie | Najsilniejszy sygnał | Wyłącznie wtedy, gdy duplikat ma zostać wycofany. |
| Adnotacja rel="canonical" | Wyraźny sygnał | Gdy obie wersje mają pozostać dostępne. W kodzie strony działa tylko dla dokumentów HTML, dla plików takich jak PDF potrzebny jest nagłówek HTTP. |
| Mapa witryny | Słaby sygnał | Jako uzupełnienie. Google i tak sam ustala, które strony są duplikatami. |
<link rel="canonical" href="https://www.example.com/oferta/okna-drewniane/" />

Link: <https://www.example.com/pliki/katalog-okien.pdf>; rel="canonical"
Dokumentacja podaje też zalecenia wykonawcze. Adnotację warto umieścić również na samej stronie kanonicznej, tak aby wskazywała na siebie. Adresy powinny być bezwzględne, a linki wewnętrzne powinny konsekwentnie prowadzić do adresu uznanego za główny. Jeżeli serwis ma wersje dla różnych krajów w tym samym języku, oprócz adresu kanonicznego potrzebne są adnotacje hreflang, czyli oznaczenia wersji językowych i regionalnych. Typowy przypadek sklepowy omawiamy we wpisie o produkcie w kilku kategoriach.
Przyczyny techniczne, które warto wykluczyć
W części o rozwiązywaniu problemów Google wymienia kilka powtarzających się źródeł kłopotów. System zarządzania treścią lub wtyczka mogą wstawiać błędną adnotację kanoniczną albo niepożądane przekierowanie. Serwer może zwracać treść innej domeny albo wiele jednakowych stron błędu z kodem poprawnej odpowiedzi. Dokumentacja wymienia również włamanie, po którym w kodzie pojawiają się adnotacje wskazujące na cudzą domenę. Takie przypadki rozwiązuje się w ramach SEO technicznego.
Gdy obie strony mają pozostać osobnymi wynikami
Jeżeli podstrony mają istnieć w wynikach niezależnie, same sygnały techniczne nie wystarczą. Google podaje, że strony mogą pozostawać w jednej grupie duplikatów nawet do 2 tygodni po wprowadzeniu zmian, a wyraźne i znaczące różnice w treści zwykle przyspieszają ich rozdzielenie. Chodzi o różnice w treści głównej: inne informacje, inne przykłady, inne odpowiedzi na pytania klienta. Przygotowanie takich tekstów obejmują nasze treści SEO. Po zmianach można zgłosić prośbę o ponowne zindeksowanie w narzędziu do sprawdzania adresów, przy czym funkcja ma limity.
Typowe pomyłki i sytuacje, w których potrzebna jest pomoc
Najczęstsze pomyłki polegają na próbie ukrycia duplikatów zamiast ich uporządkowania. Dokumentacja Google wymienia kilka działań, których należy unikać.
Pierwsza pomyłka to blokowanie duplikatów w pliku robots.txt, po którym sam adres nadal może zostać zindeksowany bez zawartości. Druga to wybieranie wersji głównej narzędziem do usuwania adresów, które ukrywa wszystkie wersje naraz. Trzecia to używanie reguły noindex do wskazania strony kanonicznej, chociaż Google zaleca do tego adnotację rel="canonical". Czwarta to sprzeczne sygnały: inny adres w mapie witryny, a inny w adnotacji. Do tego dochodzą pomyłki w interpretacji: komunikat o pominiętych wynikach bywa brany za karę, a brak drugiej pozycji przy fragmencie z odpowiedzią za spadek.
- Ważne podstrony mają w Search Console zgodne pola adresu kanonicznego określonego przez użytkownika i wybranego przez Google.
- Adnotacja kanoniczna zawiera adres bezwzględny i wskazuje ten sam adres co mapa witryny.
- Linki w menu, stopce i treści prowadzą do adresów głównych, a nie do wersji z parametrami.
- Wycofane duplikaty są przekierowane, a nie zablokowane w robots.txt.
- Podstrony miast, usług i produktów różnią się treścią główną, a nie tylko nazwą w tytule.
Pomoc z zewnątrz jest zasadna, gdy status duplikatu obejmuje setki adresów, gdy Google konsekwentnie wybiera adres z innej domeny, gdy błędne adnotacje generuje szablon sklepu, a także przed zmianą domeny lub struktury adresów. W ramach audytu SEO zestawiamy dane z raportu Indeksowanie stron z rzeczywistą budową serwisu i wskazujemy, które grupy podstron połączyć, a które rozdzielić treścią. Nie gwarantujemy przy tym pozycji, ponieważ o wyborze wersji głównej ostatecznie decyduje wyszukiwarka.
Jeśli chcą Państwo zamówić audyt SEO, zachęcamy do kontaktu: tel. 222 500 844 lub mailowo: biuro@pozycjonowaniestron.pl
Najczęstsze pytania
Czy deduplikacja jest karą od Google?
Nie. Google zaznacza w dokumentacji, że powielone treści bywają czymś zwyczajnym i same w sobie nie naruszają zasad dotyczących spamu. Naruszeniem staje się dopiero masowe tworzenie stron bez wartości dla użytkownika.
Czy strona pominięta w wynikach jest usunięta z indeksu?
Niekoniecznie. Strona odfiltrowana przy wyświetlaniu wyników może być zindeksowana i pojawiać się przy innych zapytaniach. Stan indeksowania konkretnego adresu pokazuje narzędzie do sprawdzania adresów URL w Search Console.
Dlaczego po zdobyciu fragmentu z odpowiedzią zniknął zwykły wynik tej samej strony?
To skutek deduplikacji opisanej przez Google. Strona użyta do wyświetlenia fragmentu z odpowiedzią nie pojawia się równocześnie na pierwszej stronie wyników jako zwykła pozycja. Nie oznacza to spadku oceny strony.
Czy adnotacja rel="canonical" gwarantuje wybór wskazanego adresu?
Nie. Google traktuje ją jako wyraźny sygnał, ale określa jako wskazówkę, a nie dyrektywę. Jeżeli wskazany adres nie jest podobny do strony z adnotacją albo inne sygnały mówią co innego, wybór może być inny.
Ile trwa rozdzielenie stron uznanych za duplikaty?
Google podaje, że strony mogą pozostawać w jednej grupie duplikatów nawet do 2 tygodni po wprowadzeniu zmian. Wyraźne różnice w treści głównej zwykle przyspieszają rozdzielenie, ale terminu nie da się zagwarantować.
Czy warto zablokować duplikaty w pliku robots.txt?
Google to odradza, ponieważ zablokowany adres nadal może zostać zindeksowany bez zawartości. Lepszym rozwiązaniem jest przekierowanie wycofanego duplikatu albo adnotacja rel="canonical".
Źródła
- Przewodnik po systemach rankingowych wyszukiwarki Google, Centrum wyszukiwarki Google
- Co to jest wybór strony kanonicznej, Centrum wyszukiwarki Google
- Jak określić kanoniczny URL za pomocą rel="canonical" i innych metod, Centrum wyszukiwarki Google
- Rozwiązywanie problemów z wyborem strony kanonicznej, Centrum wyszukiwarki Google
- Fragmenty z odpowiedzią i Twoja witryna, Centrum wyszukiwarki Google
- Zasady dotyczące spamu w wyszukiwarce Google, Centrum wyszukiwarki Google
- Jak korzystać z operatora wyszukiwania w witrynie, Centrum wyszukiwarki Google
- Dokumentacja API JSON, Programmable Search Engine, Google for Developers
- Narzędzie do sprawdzania adresów URL, Pomoc Search Console
- Raport Indeksowanie stron, Pomoc Search Console
Funkcje wyszukiwarek i asystentów AI zmieniają się szybko, dlatego wpis aktualizujemy po większych zmianach.