Budżet indeksowania to zestaw adresów, które robot Google może i chce pobrać z danej witryny. Realnym ograniczeniem staje się dopiero w dużych serwisach, przede wszystkim w sklepach z tysiącami produktów i filtrów oraz w portalach z codziennie zmienianą treścią. Poniżej wyjaśniamy, od jakiej skali temat ma znaczenie, co zużywa wizyty robota bez pożytku i jak to uporządkować.
Czym jest budżet indeksowania
Budżet indeksowania (ang. crawl budget) to według Google zestaw adresów URL, które Googlebot, czyli robot pobierający strony dla wyszukiwarki, może i zamierza odwiedzić w danej witrynie. Nie jest to liczba, którą da się odczytać w jednym polu jakiegoś panelu. To wypadkowa dwóch rzeczy: tego, ile żądań serwer jest w stanie obsłużyć bez spowolnienia, oraz tego, ile adresów Google uznaje za warte pobrania.
Sieć jest zbyt duża, żeby wyszukiwarka mogła odwiedzać każdy adres dowolnie często. Dlatego czas i zasoby, które robot poświęca jednej witrynie, są ograniczone. Samo pobranie strony nie oznacza jeszcze, że trafi ona do wyników: po wizycie robota każda strona jest oceniana i dopiero wtedy Google decyduje, czy ją zindeksować. Bez pobrania nie ma jednak czego oceniać, więc w dużym serwisie to właśnie ten pierwszy etap bywa wąskim gardłem.
Zestaw adresów URL, które robot Google może i zamierza pobrać z jednej witryny. Wyznaczają go łącznie limit wydajności serwera i zapotrzebowanie wyszukiwarki na treści tej witryny.
Dlaczego nazwa bywa myląca
W polskiej wersji dokumentacji Google słowo „indeksowanie” oznacza w tym kontekście samo pobieranie stron przez robota, które w branży częściej nazywa się skanowaniem. Stąd „budżet indeksowania”, „limit wydajności indeksowania” i raport „Statystyki indeksowania”, choć wszystkie dotyczą wizyt robota, a nie obecności strony w wynikach. W dalszej części używamy nazw z dokumentacji tam, gdzie chodzi o konkretny raport lub pojęcie, a słowa „skanowanie” i „wizyty robota” tam, gdzie opisujemy sam ruch Googlebota.
Warto też wiedzieć, że Google liczy budżet osobno dla każdej nazwy hosta. Adres z przedrostkiem www, adres bez niego i każda subdomena, na przykład sklep albo blog wydzielony pod osobnym adresem, są traktowane jako oddzielne witryny. Szczegóły opisuje strona Optymalizacja budżetu indeksowania w dokumentacji Google, na której opieramy większość tego wpisu.
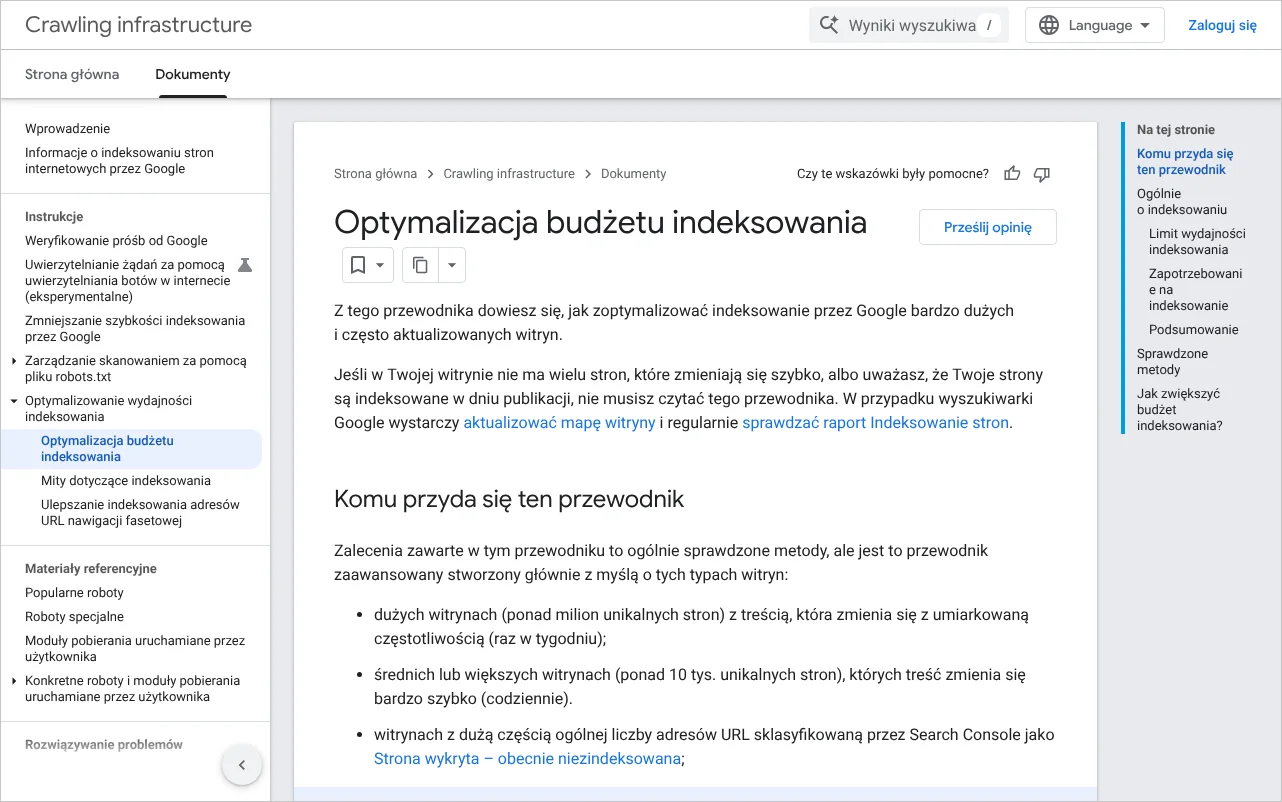
Dokumentacja jest pisana dla właścicieli dużych witryn i sama zaznacza, że to materiał zaawansowany. Większość zawartych w niej zaleceń ma jednak prostą logikę: nie kazać robotowi pobierać tego, co nie jest potrzebne, i nie utrudniać mu dotarcia do tego, co ważne.
Dwa składniki budżetu: limit wydajności i zapotrzebowanie
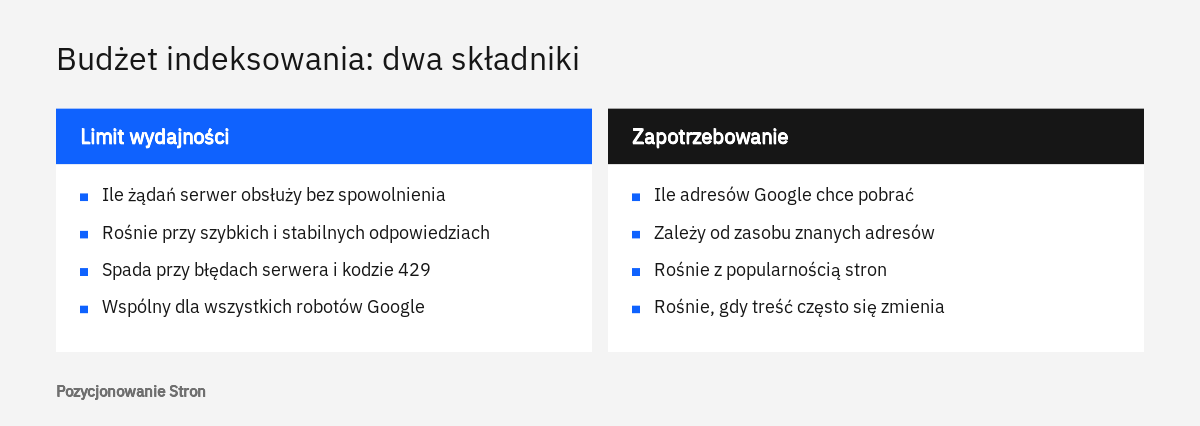
Google opisuje budżet indeksowania jako połączenie limitu wydajności, który chroni serwer przed przeciążeniem, oraz zapotrzebowania, które wynika z tego, jak bardzo wyszukiwarce zależy na treściach danej witryny. O faktycznej liczbie wizyt decyduje ten składnik, który w danej chwili jest niższy. Jeśli serwer mógłby obsłużyć znacznie więcej żądań, ale zapotrzebowanie jest małe, robot i tak przyjdzie rzadziej.
Limit wydajności, czyli ile zniesie serwer
Limit wydajności to maksymalne obciążenie, jakie Google jest gotów nałożyć na serwer, liczone liczbą równoległych połączeń i czasem ich trwania. Każda witryna zaczyna od ostrożnego poziomu, który następnie dopasowuje się do zachowania serwera. Gdy odpowiedzi przychodzą stabilnie i szybko, limit rośnie. Gdy czasy odpowiedzi się wydłużają, pojawiają się błędy serwera z grupy 5xx albo kod 429 oznaczający ograniczanie liczby żądań, limit spada i robot pobiera mniej.
Wynika z tego praktyczny wniosek: szybki i stabilny serwer nie tylko poprawia odbiór strony przez ludzi, ale też pozwala robotowi pobrać więcej adresów w tym samym czasie. O tym, co wpływa na czas odpowiedzi, piszemy osobno we wpisie o czasie odpowiedzi serwera, a o wyborze zaplecza technicznego we wpisie o hostingu i jego wpływie na indeksowanie.
Zapotrzebowanie, czyli ile Google chce pobrać
Zapotrzebowanie zależy według dokumentacji od rozmiaru witryny, częstotliwości zmian, jakości stron i ich popularności w porównaniu z innymi witrynami. Dokumentacja wymienia trzy czynniki, które mają na nie największy wpływ. Pierwszy to zasób adresów, o których Google wie: bez wskazówek od właściciela robot próbuje pobrać wszystkie znane mu adresy, także duplikaty i strony, które nigdy nie powinny trafić do wyników. Google podkreśla, że właśnie na ten czynnik właściciel ma największy wpływ. Drugi to popularność: adresy chętniej odwiedzane w sieci są pobierane częściej, żeby ich wersja w indeksie była aktualna. Trzeci to aktualność: wyszukiwarka wraca do stron na tyle często, żeby zauważyć zmiany, a do treści, które się nie zmieniają, zagląda rzadziej.
Zapotrzebowanie mogą też chwilowo podnieść zdarzenia obejmujące całą witrynę, na przykład przeniesienie jej pod nowy adres, kiedy trzeba ponownie pobrać treści spod zmienionych adresów. Każdy robot Google ma przy tym własne zapotrzebowanie, natomiast limit wydajności serwera jest dla nich wspólny.
Których serwisów dotyczy budżet indeksowania
Temat dotyczy przede wszystkim witryn dużych i szybko się zmieniających. Dokumentacja Google wymienia trzy grupy: witryny mające ponad milion unikalnych stron z treścią zmienianą mniej więcej raz w tygodniu, witryny mające ponad 10 tysięcy unikalnych stron z treścią zmienianą codziennie oraz witryny, w których duża część adresów ma w Search Console status „Strona wykryta - obecnie niezindeksowana”. Google zastrzega, że liczby są orientacyjne i nie stanowią sztywnych progów.
Jeśli witryna jest mniejsza, a nowe podstrony pojawiają się w wynikach w dniu publikacji, dokumentacja mówi wprost, że jej właściciel nie musi tego materiału czytać. Wystarczy aktualna mapa witryny i regularne zaglądanie do raportu o indeksowaniu stron. Podobnie pomoc Search Console zaznacza, że raport Statystyki indeksowania jest przeznaczony dla zaawansowanych użytkowników i przy witrynie mającej mniej niż tysiąc stron zwykle nie ma potrzeby z niego korzystać.
| Rodzaj serwisu | Czy temat ma znaczenie | Na co zwrócić uwagę |
|---|---|---|
| Strona firmy usługowej, kilkadziesiąt podstron | Zwykle nie | Aktualna mapa witryny, brak przypadkowych blokad w robots.txt |
| Blog lub serwis z kilkuset wpisami | Zwykle nie | Archiwa, tagi i wyniki wyszukiwarki wewnętrznej, które mnożą adresy |
| Sklep z kilkoma tysiącami produktów i filtrami | Może mieć, zależnie od liczby adresów z filtrami | Parametry filtrów i sortowania, warianty produktów, paginacja |
| Sklep lub katalog powyżej 10 tysięcy stron z codziennymi zmianami | Tak | Statystyki indeksowania, logi serwera, czas odpowiedzi, porządek w adresach |
| Portal, serwis ogłoszeń, duża platforma | Tak | Wygasłe ogłoszenia, duplikaty, wydajność serwera, mapy witryny z datami zmian |
Liczy się liczba adresów, nie liczba produktów
Częsty błąd w ocenie polega na liczeniu tego, co widać w panelu sklepu. Sklep z wyposażeniem łazienek z Poznania może mieć w ofercie trzy tysiące produktów, a mimo to wystawiać robotowi setki tysięcy adresów, bo każda kategoria ma filtry koloru, producenta, wymiaru i ceny, które da się dowolnie łączyć, a do tego kilka sposobów sortowania. Z punktu widzenia Google to nie jest witryna na trzy tysiące stron. Odwrotnie bywa z dużą kancelarią z Krakowa albo siecią gabinetów z Łodzi: strona ma kilkaset podstron, żadnych filtrów i temat budżetu po prostu jej nie dotyczy.
Trzeci sygnał z listy Google, czyli duża liczba adresów ze statusem „Strona wykryta - obecnie niezindeksowana”, oznacza, że wyszukiwarka zna adres, ale jeszcze go nie pobrała. Pojedyncze takie adresy są czymś zwykłym. Gdy jest ich bardzo dużo i liczba nie maleje, warto zbadać, czy robot nie traci czasu gdzie indziej. Znaczenie poszczególnych statusów omawiamy we wpisie o tym, dlaczego Google nie indeksuje strony.
Co pożera wizyty robota
Najwięcej wizyt robota marnują adresy, które nie wnoszą nowej treści: kombinacje filtrów i sortowania, adresy z parametrami, duplikaty, strony z pozornym błędem 404 oraz przekierowania ułożone w łańcuchy. Dokumentacja zalicza je do zasobu adresów, które Google chce pobrać, jeśli właściciel nie da mu innych wskazówek, i podkreśla, że to obszar, nad którym ma on największą kontrolę.
Filtry, sortowanie i nawigacja fasetowa
Nawigacja fasetowa to zawężanie listy produktów lub ogłoszeń za pomocą filtrów. Jeśli każdy wybór filtra tworzy nowy adres z parametrami, liczba możliwych adresów rośnie bardzo szybko i w praktyce nie ma końca. Google w osobnej stronie dokumentacji o adresach nawigacji fasetowej opisuje dwa skutki: robot odwiedza wiele takich adresów, zanim ustali, że nie mają wartości, a przez to wolniej odkrywa nowe, przydatne strony. W dokumencie o zmniejszaniu szybkości skanowania Google wymienia filtrowanie i sortowanie jako najczęstszą przyczynę nagłego wzrostu liczby żądań, obok kalendarzy tworzących osobny adres dla każdej daty.
Parametry w adresach i duplikaty
Podobnie działają parametry, które nie zmieniają treści: identyfikatory sesji, znaczniki kampanii reklamowych, parametry widoku listy. Ta sama strona jest wtedy dostępna pod wieloma adresami i każdy z nich robot może pobrać osobno. Do tej grupy należą też wersje do druku, wyniki wyszukiwarki wewnętrznej oraz te same produkty przypisane do kilku kategorii, jeśli każda ścieżka tworzy osobny adres. Źródła powielonych treści i sposoby ich porządkowania opisujemy szerzej we wpisie o duplikacji treści w serwisie.
Błędy i pozorne błędy 404
Pozorny błąd 404 (ang. soft 404) to sytuacja, w której serwer odpowiada kodem powodzenia, a treść strony wskazuje na błąd: jest pusta albo zawiera komunikat, że niczego nie znaleziono. Typowy przykład to wycofany produkt, którego adres nadal się otwiera i pokazuje napis o braku towaru, albo filtr, który nie zwraca żadnej pozycji. Dokumentacja o budżecie mówi krótko, że takie strony będą nadal pobierane i marnują budżet, więc należy je eliminować. Zwykły kod 404 działa inaczej: jest dla Google mocnym sygnałem, żeby do adresu nie wracać. Kiedy błąd 404 jest właściwą odpowiedzią, wyjaśniamy we wpisie o błędzie 404 i widoczności w Google.
Łańcuchy przekierowań
Każde przekierowanie to dodatkowe żądanie, zanim robot dotrze do treści. Według strony o kodach stanu HTTP Googlebot domyślnie podąża najwyżej za dziesięcioma przeskokami, a dokumentacja o budżecie zaleca unikanie długich łańcuchów, bo źle wpływają na skanowanie. Łańcuchy powstają zwykle po cichu: po zmianie struktury kategorii, po przejściu na szyfrowane połączenie, po migracji, gdy stare przekierowania prowadzą do adresów, które same zostały później przekierowane. Rodzaje przekierowań omawiamy we wpisie o przekierowaniach 301 i 302.
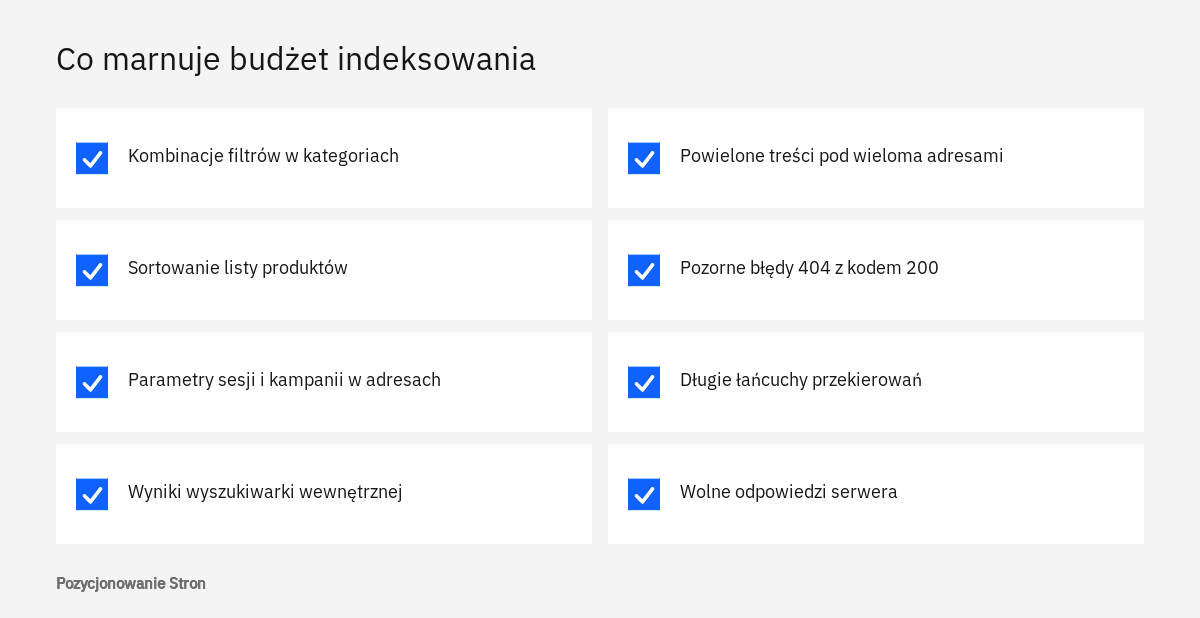
Do tej listy warto dopisać jeszcze wolny serwer. Nie tworzy on zbędnych adresów, ale obniża limit wydajności, więc z tej samej puli robot pobiera mniej stron, także tych najważniejszych.
Jeśli chcą Państwo zamówić SEO techniczne, zachęcamy do kontaktu: tel. 222 500 844 lub mailowo: biuro@pozycjonowaniestron.pl
Gdzie sprawdzić, na co robot zużywa wizyty
Podstawowym miejscem jest raport Statystyki indeksowania w Google Search Console. Otwiera się go z menu po lewej stronie: Ustawienia, a następnie pozycja Statystyki indeksowania i odnośnik otwierający raport. Jak podaje pomoc Search Console, raport jest dostępny tylko dla usług najwyższego poziomu, czyli dla całej domeny albo dla prefiksu adresu bez podkatalogu.
Trzy wykresy na górze raportu
Raport zaczyna się od trzech wartości pokazanych na wykresie w czasie: Łączna liczba żądań robota indeksującego, Całkowity rozmiar pobierania oraz Średni czas odpowiedzi. Najwięcej mówi zestawienie pierwszej i trzeciej. Jeżeli czas odpowiedzi rośnie, a liczba żądań w tych samych dniach spada, serwer najpewniej stał się ograniczeniem i robot sam zwolnił. Pomoc zaznacza, że tempo skanowania powinno być w miarę stabilne w ujęciu jednego lub dwóch tygodni, więc pojedynczy słabszy dzień nie jest powodem do niepokoju.
Stan hosta
Pole Stan hosta informuje, czy w ostatnich 90 dniach Google miał kłopot z dostępem do witryny. Po kliknięciu widać trzy składniki: Pobieranie pliku robots.txt, Rozpoznawanie nazw DNS oraz Połączenie z serwerem. Każdy ma własny wykres z przerywaną czerwoną linią, która oznacza próg uznawany za problem. Jeśli odsetek nieudanych żądań przekracza tę linię, sprawę warto przekazać administratorowi serwera lub firmie hostingowej. Szczególnie ważny jest plik robots.txt: z pomocy Search Console wynika, że gdy robot nie może go pobrać, na pierwsze kilkanaście godzin wstrzymuje skanowanie całej witryny.
Cztery podziały żądań
Niżej raport dzieli żądania na cztery sposoby i to tutaj zwykle widać marnotrawstwo. Tabela Odpowiedzi na żądania robota indeksującego pokazuje udział poszczególnych odpowiedzi serwera: OK (200), Przeniesiono na stałe (301), Przeniesiono tymczasowo (302), Nie zmodyfikowano (304), Nie znaleziono (404), Błąd serwera (5XX) i inne. Duży udział przekierowań albo błędów oznacza, że robot często trafia na adresy bez treści. Tabela Typy indeksowanych plików rozdziela żądania na HTML, obrazy, JavaScript, CSS i pozostałe. Tabela Cel indeksowania dzieli wizyty na Wykrycie, czyli adresy pobierane po raz pierwszy, oraz Odświeżenie, czyli powrót do adresów już znanych. Tabela Typ Googlebota pokazuje, który robot przychodził: Smartfon, Komputer, Obraz, Ładowanie zasobu strony, AdsBot i inne.
Każdy wiersz można kliknąć i obejrzeć przykładowe adresy. To najprostszy sposób, żeby bez dodatkowych narzędzi przekonać się, czy wśród pobieranych adresów dominują karty produktów i kategorie, czy raczej adresy z parametrami filtrów. W sklepie z częściami samochodowymi z Bydgoszczy taki przegląd potrafi pokazać, że większość przykładowych adresów z odpowiedzią 200 to kombinacje filtrów marki, modelu i rocznika, a nie karty części.
Raport Indeksowanie stron i sprawdzanie adresu
Drugim miejscem jest raport Strony w sekcji Indeksowanie. Dokumentacja o budżecie zaleca regularne przeglądanie go pod kątem dwóch powodów: pozornych błędów 404 oraz statusu „Strona wykryta - obecnie niezindeksowana”. Trzecim jest narzędzie Sprawdzanie adresu URL, dostępne z pola wyszukiwania u góry Search Console. Dokumentacja wskazuje, że jeśli Google ograniczył skanowanie z powodu obciążenia serwera, w wynikach sprawdzania może się pojawić komunikat „Przekroczono limit obciążenia hosta”.
- Czy liczba żądań jest stabilna, czy spada wraz ze wzrostem średniego czasu odpowiedzi.
- Czy Stan hosta nie zgłasza problemów z plikiem robots.txt, DNS lub połączeniem z serwerem.
- Jaki udział w odpowiedziach mają przekierowania, błędy 404 i błędy serwera.
- Jakie adresy pojawiają się w przykładach dla odpowiedzi 200: strony z ofertą czy adresy z parametrami.
- Ile adresów w raporcie Strony ma status „Strona wykryta - obecnie niezindeksowana” i czy ta liczba maleje.
- Czy nowe produkty lub wpisy trafiają do wyników w rozsądnym czasie od publikacji.
Jak nie marnować budżetu indeksowania
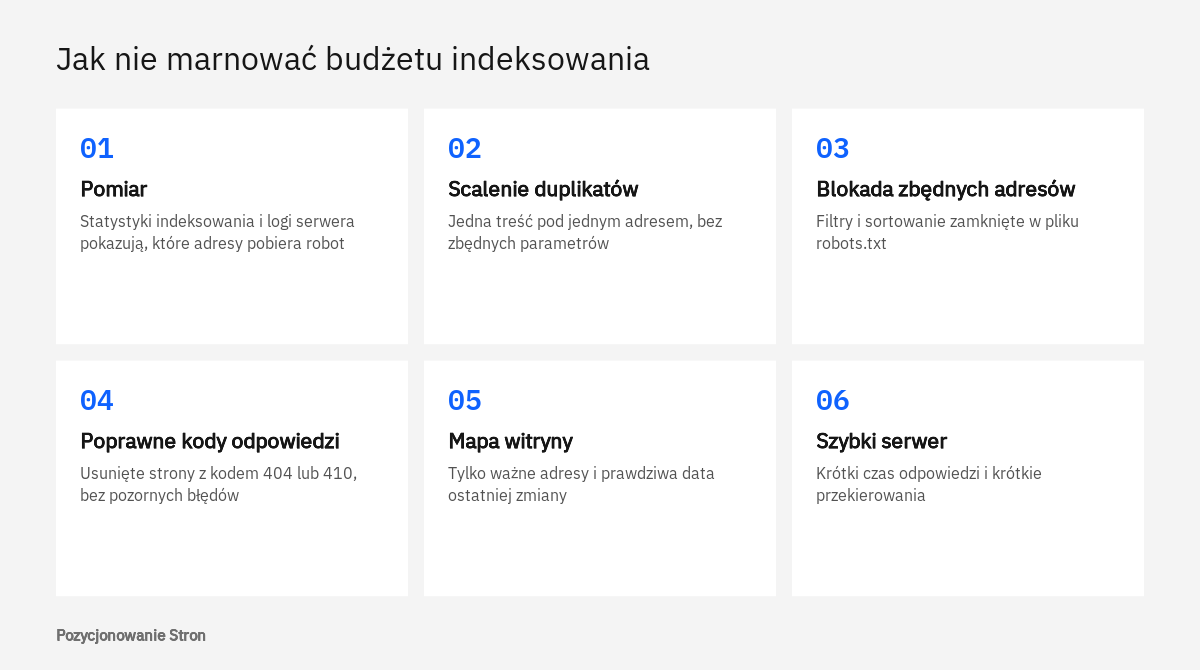
Najwięcej daje uporządkowanie zasobu adresów: połączenie duplikatów, zamknięcie przed robotem tego, co nie ma trafić do wyników, poprawne kody dla usuniętych stron, aktualna mapa witryny, krótkie przekierowania i szybki serwer. Tak wygląda w skrócie lista sprawdzonych metod z dokumentacji Google dla dużych witryn. Poniżej omawiamy ją po kolei, razem z dwoma zastrzeżeniami, o których łatwo zapomnieć.
Duplikaty do scalenia, zbędne adresy do zablokowania
Powielone treści warto ograniczać u źródła, tak żeby robot skupiał się na unikalnych stronach, a nie na unikalnych adresach. Tam, gdzie adresy muszą istnieć dla wygody klientów, ale nie powinny pojawiać się w wynikach, na przykład sortowanie listy albo kolejne ekrany przewijanej listy powielające treść, dokumentacja zaleca blokadę w pliku robots.txt. Jak go przygotować, opisujemy we wpisie o pliku robots.txt.
Pierwsze zastrzeżenie dotyczy znacznika noindex. Dokumentacja odradza używanie go do oszczędzania budżetu: żeby odczytać znacznik, Google musi stronę pobrać, a dopiero potem ją odrzuca, więc wizyta i tak zostaje zużyta. Noindex służy do wyłączenia strony z wyników, a nie do ograniczenia ruchu robota. Różnice między tymi mechanizmami zestawiamy we wpisie o canonical, noindex i robots.txt.
Drugie zastrzeżenie dotyczy samego robots.txt. Google ostrzega, żeby nie traktować blokad jako sposobu na „przesuwanie” budżetu między częściami witryny i nie zmieniać ich co chwilę. Zablokowanie jednych adresów nie sprawi automatycznie, że robot częściej odwiedzi inne, chyba że witryna już osiągnęła limit wydajności serwera. Blokada ma sens dla stron i zasobów, których Google w ogóle nie powinien pobierać.
Usunięte strony z kodem 404 lub 410
Dla stron usuniętych na stałe dokumentacja zaleca kod 404 albo 410. Zablokowanie takiego adresu w robots.txt nie jest zamiennikiem: zablokowane adresy pozostają w kolejce robota znacznie dłużej i zostaną pobrane ponownie, gdy blokada zniknie. W praktyce dotyczy to wygasłych ogłoszeń, zakończonych wydarzeń i produktów wycofanych bez następcy. Jeśli produkt wróci do sprzedaży, strona powinna zostać; jeśli ma następcę, zwykle lepsze jest przekierowanie na niego.
Mapa witryny z prawdziwą datą zmiany
Google czyta mapę witryny regularnie, dlatego powinna zawierać wszystkie adresy, które mają być pobierane, i tylko takie. Dla stron ze zmienioną treścią dokumentacja zaleca znacznik lastmod. Ze strony o przygotowywaniu mapy witryny wynika, że Google korzysta z tej daty tylko wtedy, gdy jest konsekwentnie zgodna z rzeczywistością, a wartości priority i changefreq pomija. Data zmieniana przy każdym odświeżeniu sklepu, choć treść pozostała ta sama, przestaje być wskazówką. Jeden plik mapy może zawierać najwyżej 50 000 adresów i mieć do 50 MB po rozpakowaniu, więc duży serwis dzieli mapę na części. Więcej na ten temat we wpisie o mapie witryny XML.
Szybszy serwer i odpowiedź 304
Google pisze wprost, że jeśli strony wczytują się i renderują szybciej, robot może pobrać ich więcej. Drugim, rzadziej stosowanym ułatwieniem jest obsługa żądań warunkowych. Robot, pytając o stronę, może przekazać datę poprzedniego pobrania w nagłówku If-Modified-Since albo znacznik wersji w nagłówku If-None-Match. Jeśli treść się nie zmieniła, serwer może odpowiedzieć kodem 304 (Not Modified) bez przesyłania całej strony. Oszczędza to czas i zasoby po obu stronach. Dokumentacja o kodach stanu podaje, że sam kod 304 nie wpływa na indeksowanie: informuje jedynie, że treść jest taka sama jak przy poprzedniej wizycie.
Jak ograniczyć skanowanie filtrów w sklepie
Jeśli adresy z filtrami nie mają pojawiać się w wynikach, Google zaleca przede wszystkim zablokowanie ich w pliku robots.txt, tak żeby robot pobierał karty produktów i listy bez filtrów. Przykład wzorowany na dokumentacji wygląda następująco:
User-agent: Googlebot
Disallow: /*?*kolor=
Disallow: /*?*rozmiar=
Disallow: /*?*sortuj=
Dokumentacja wymienia też zapisywanie filtrów po znaku # w adresie oraz znacznik rel=canonical i atrybut rel=nofollow, przy czym dwie ostatnie metody ocenia jako mniej skuteczne na dłuższą metę niż blokada w robots.txt.
Bywa, że część stron z filtrami ma wartość, bo odpowiada na konkretne zapytania, na przykład kategoria zawężona do jednego producenta. Dla adresów, które mają być skanowane, dokumentacja podaje trzy zasady: parametry rozdzielać standardowym znakiem &, a nie przecinkami czy średnikami; przy filtrach zapisanych w ścieżce zachować zawsze tę samą kolejność i nie dopuszczać do powtórzeń; dla kombinacji bez wyników zwracać kod 404 pod tym samym adresem, bez przekierowania na ogólną stronę błędu. Dobór filtrów wartych pokazania wyszukiwarce jest częścią prac, które prowadzimy w ramach pozycjonowania sklepów.
Co zrobić, gdy robot przeciąża serwer
W sytuacji awaryjnej Google dopuszcza krótkotrwałe zwracanie robotowi kodu 500, 503 lub 429 zamiast kodu 200. Według strony o zmniejszaniu szybkości indeksowania robot ogranicza wtedy liczbę żądań do całej nazwy hosta, a gdy błędy ustaną, tempo samo wraca do poprzedniego poziomu.
To rozwiązanie na kilka godzin, najwyżej na dzień lub dwa. Dokumentacja ostrzega, że przy dłuższym stosowaniu robot wykrywa mniej nowych stron, rzadziej odświeża istniejące, więc ceny i dostępność produktów mogą być w wynikach nieaktualne, a adresy zwracające błędy przez kilka dni mogą zostać usunięte z indeksu. Trwałym rozwiązaniem jest usunięcie przyczyny, którą widać w logach serwera.
Typowe pomyłki i kiedy potrzebna jest pomoc
Najczęstszą pomyłką jest zajmowanie się budżetem indeksowania w serwisie, którego ten temat nie dotyczy, na przykład na stronie z kilkudziesięcioma podstronami.
Druga pomyłka to nakładanie kilku mechanizmów na te same adresy. Jeśli adres jest zablokowany w robots.txt, robot nie pobierze strony, więc nie odczyta umieszczonego na niej znacznika noindex ani adresu kanonicznego. Trzecia to blokowanie zbyt szeroko: reguła napisana z myślą o filtrach potrafi objąć także paginację kategorii albo zasoby potrzebne do wyświetlenia strony.
Pomoc specjalisty przydaje się wtedy, gdy nowe produkty czekają na pojawienie się w wynikach tygodniami, gdy w Statystykach indeksowania dominują adresy z parametrami, gdy Stan hosta zgłasza problemy albo gdy planowana jest migracja domeny i hostingu. Analiza logów, reguł robots.txt i struktury adresów wchodzi w zakres SEO technicznego, a punktem wyjścia jest zwykle audyt SEO.
Jeśli chcą Państwo zamówić SEO techniczne, zachęcamy do kontaktu: tel. 222 500 844 lub mailowo: biuro@pozycjonowaniestron.pl
Najczęstsze pytania
Czy mała strona firmowa musi dbać o budżet indeksowania?
Zwykle nie. Dokumentacja Google kieruje ten temat do witryn mających ponad 10 tysięcy stron ze zmianami codziennymi lub ponad milion stron. Jeśli nowe podstrony pojawiają się w wynikach w dniu publikacji, wystarczy aktualna mapa witryny i przegląd raportu o indeksowaniu stron.
Gdzie sprawdzić, ile stron dziennie pobiera Googlebot?
W Search Console, w menu Ustawienia, w raporcie Statystyki indeksowania. Liczbę żądań w kolejnych dniach pokazuje wykres Łączna liczba żądań robota indeksującego.
Czy znacznik noindex oszczędza budżet indeksowania?
Nie. Żeby odczytać znacznik, robot musi stronę pobrać, więc wizyta zostaje zużyta. Google zaleca blokadę w robots.txt dla stron, które w ogóle nie powinny być pobierane, a noindex pozostawia do wyłączania stron z wyników.
Czy zablokowanie filtrów w robots.txt sprawi, że robot częściej odwiedzi produkty?
Nie zawsze. Według dokumentacji zwolnione w ten sposób wizyty nie przechodzą automatycznie na inne adresy, chyba że witryna osiągała już limit wydajności serwera. Blokada ogranicza natomiast pobieranie adresów bez wartości.
Czy można poprosić Google o częstsze skanowanie witryny?
Nie ma takiego zgłoszenia. Google przyjmuje jedynie prośby o zmniejszenie tempa. Więcej wizyt można uzyskać pośrednio: przez wydajniejszy serwer, jeśli to on jest ograniczeniem, oraz przez treści, które są przydatne i aktualizowane.
Czy szybkość strony wpływa na liczbę pobieranych adresów?
Tak. Limit wydajności rośnie, gdy serwer odpowiada szybko i stabilnie, a spada przy wydłużonych czasach odpowiedzi i błędach serwera.
Źródła
- Optymalizacja budżetu indeksowania, Google for Developers
- Raport Statystyki indeksowania, Search Console - pomoc
- Zarządzanie indeksowaniem adresów URL nawigacji fasetowej, Google for Developers
- Zmniejszanie szybkości indeksowania przez Google, Google for Developers
- Jak kody stanu HTTP wpływają na roboty Google, Google for Developers
- Przygotowywanie i przesyłanie mapy witryny, Centrum wyszukiwarki Google
Funkcje wyszukiwarek i asystentów AI zmieniają się szybko, dlatego wpis aktualizujemy po większych zmianach.