Powielona treść w zdecydowanej większości przypadków nie kończy się karą: Google grupuje takie same lub bardzo podobne strony i pokazuje w wynikach jedną z nich. Kłopot zaczyna się wtedy, gdy wyszukiwarka wybierze inną wersję, niż Państwo by chcieli, albo gdy kopiowanie jest sposobem na budowanie całego serwisu. Poniżej wyjaśniamy, jak odróżnić jedno od drugiego, gdzie to sprawdzić i kiedy tekst trzeba napisać od nowa.
Czym jest treść powielona
Treść powielona to ten sam albo niemal ten sam tekst dostępny pod więcej niż jednym adresem. Może to dotyczyć adresów w obrębie jednego serwisu albo adresów w różnych domenach. Dla wyszukiwarki liczy się przy tym główna treść strony, a nie jej oprawa: Google, jak czytamy w dokumentacji, określa główną treść każdej strony i na tej podstawie ocenia, czy strony są takie same lub bardzo podobne.
Adres, który Google uznaje za reprezentatywny dla grupy stron o tej samej treści. To on jest wersją główną i to on zwykle pojawia się w wynikach wyszukiwania.
Duplikaty wewnątrz serwisu
Większość powieleń w obrębie jednej witryny powstaje bez udziału człowieka, jako skutek uboczny działania systemu, na którym strona stoi. Dokumentacja Google wymienia kilka typowych przyczyn: tę samą stronę dostępną przez HTTP i HTTPS, osobne adresy dla wersji mobilnej i komputerowej, wyniki sortowania i filtrowania na stronach kategorii, warianty regionalne w tym samym języku oraz wersje przypadkowe, na przykład kopię testową serwisu, do której roboty mają dostęp.
W praktyce sklepu oznacza to, że jedna kategoria butów może istnieć pod adresem podstawowym, pod adresem z sortowaniem od najtańszych, pod adresem z wybranym kolorem i pod adresem z kodem kampanii reklamowej. Dla klienta to wciąż ta sama półka, dla robota cztery różne adresy. Szerzej opisujemy to we wpisie o parametrach w adresach URL.
Duplikaty między serwisami
Drugi rodzaj to ten sam tekst w różnych domenach. Najczęstsze źródła są dobrze znane: opis produktu skopiowany od producenta przez wiele sklepów, komunikat prasowy przedrukowany przez kilka portali, ten sam opis firmy wklejony do wielu katalogów, a także teksty przejęte bez zgody autora.
Warto odróżnić powielenie od podobieństwa tematu. Dwa wpisy na blogu o tym samym zagadnieniu, napisane innymi słowami, nie są duplikatami w rozumieniu tego tekstu. Mogą natomiast rywalizować ze sobą o te same zapytania, a wtedy rozwiązaniem bywa scalanie podobnych wpisów w jeden mocniejszy.
Co Google robi z duplikatami
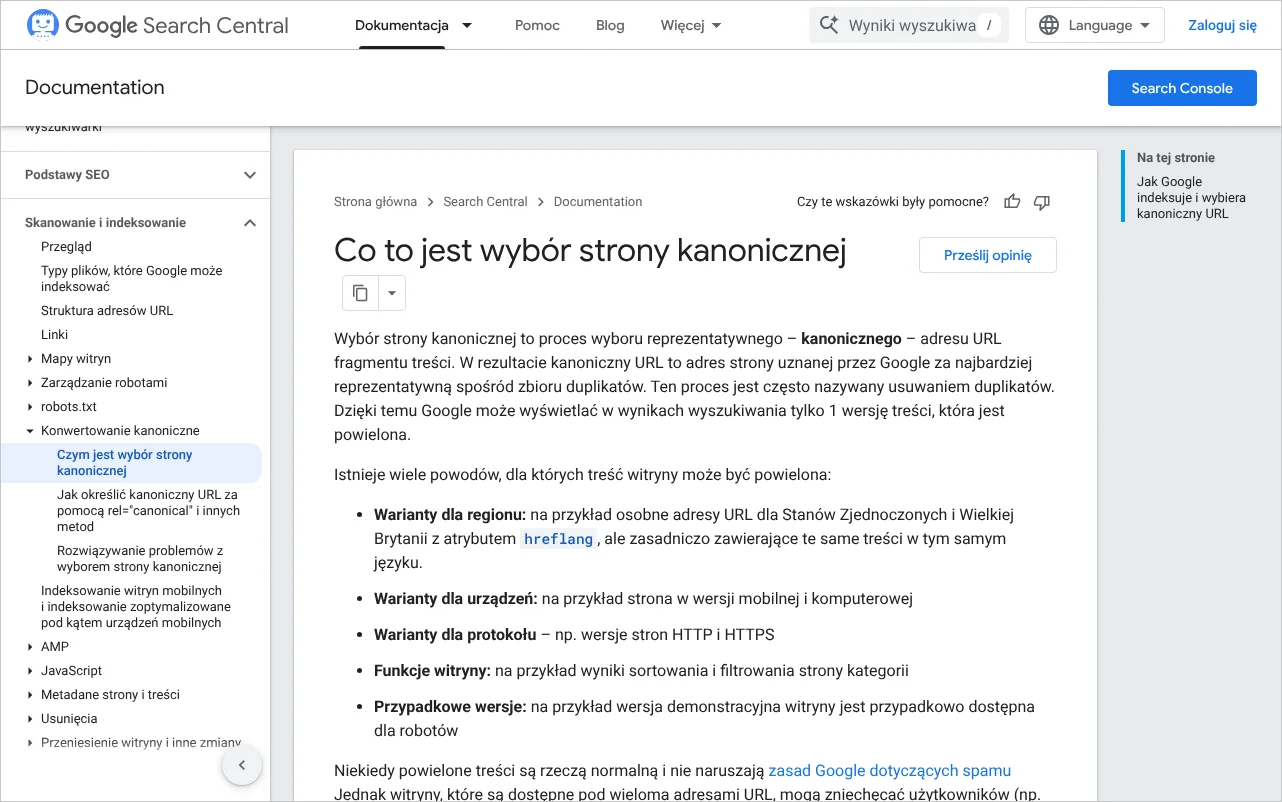
Google nie karze za duplikaty, tylko wybiera jedną wersję i ją pokazuje. Proces ten nazywa się wyborem strony kanonicznej, a dokumentacja określa go także mianem usuwania duplikatów. Na stronie Co to jest wybór strony kanonicznej Google zaznacza, że powielona treść bywa normalna i nie narusza zasad dotyczących spamu, choć wiele adresów tej samej treści może mylić użytkowników i utrudniać śledzenie wyników.
Sam wybór przebiega według stałego schematu. Wyszukiwarka grupuje strony o takiej samej lub bardzo podobnej głównej treści, a następnie wskazuje w grupie tę, którą na podstawie zebranych sygnałów uznaje za najbardziej kompletną i przydatną. Do sygnałów należą między innymi protokół (HTTPS ma pierwszeństwo przed HTTP), przekierowania, obecność adresu w mapie witryny oraz znacznik rel="canonical" w kodzie strony.
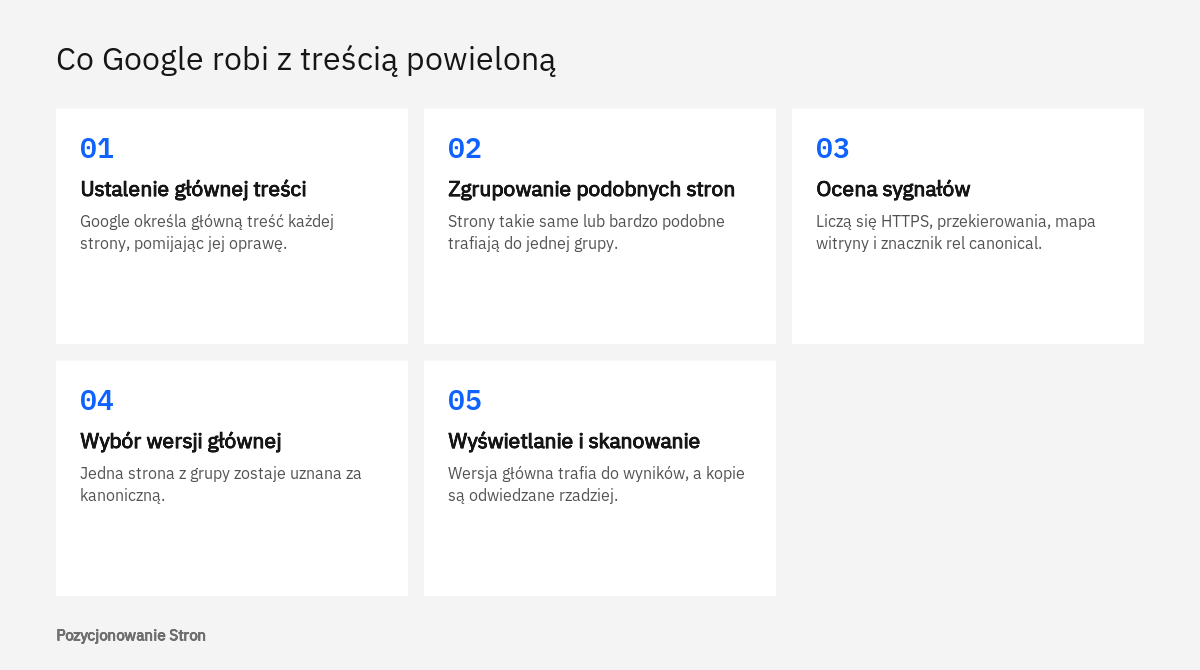
Dla pozostałych adresów z grupy skutki są dwa. Po pierwsze, Google odwiedza je rzadziej niż wersję kanoniczną, co według dokumentacji ogranicza obciążenie witryny. Po drugie, w wynikach zwykle pojawia się właśnie strona kanoniczna, choć nie zawsze: użytkownik telefonu najczęściej zobaczy wersję mobilną, nawet jeśli kanoniczna jest komputerowa.
Istotny jest jeszcze jeden szczegół. Wskazanie preferowanego adresu przez właściciela strony jest dla Google wskazówką, a nie poleceniem. Wyszukiwarka może wybrać inną stronę, jeżeli pozostałe sygnały przemawiają za inną wersją. Stąd bierze się wiele nieporozumień, do których wracamy w części o Search Console.
Tłumaczenia nie są przy tym duplikatami. Google traktuje wersje jako powielenie tylko wtedy, gdy główna treść jest w tym samym języku, na przykład przy osobnych adresach dla dwóch krajów posługujących się tym samym językiem.
Kiedy duplikaty są rzeczywistym problemem
Powielona treść staje się problemem w dwóch sytuacjach: gdy przeszkadza w osiągnięciu celu, jakim jest widoczność konkretnej podstrony, oraz gdy kopiowanie jest metodą budowania serwisu, a nie skutkiem ubocznym. Pierwsza sytuacja jest kłopotem technicznym i organizacyjnym. Druga podpada pod zasady Google dotyczące spamu i dopiero tutaj można mówić o sankcjach.
Skutki praktyczne, które nie są karą
Dokumentacja Google podaje cztery powody, dla których warto samodzielnie wskazać wersję główną, i każdy z nich opisuje zarazem koszt bałaganu. Chodzi o kontrolę nad tym, który adres widzi użytkownik w wynikach, o zebranie sygnałów, takich jak linki, w jednym adresie zamiast w kilku, o łatwiejsze śledzenie danych o jednej treści oraz o to, by roboty nie traciły czasu na wielokrotne odwiedzanie tej samej strony.
Przełóżmy to na hipotetyczny przykład. Sklep z Poznania ma kategorię dostępną pod adresem podstawowym i pod adresem z parametrem sortowania. Jeżeli Google uzna za główną wersję z sortowaniem, w wynikach pojawi się mniej czytelny adres, a statystyki tej kategorii rozłożą się na dwa wiersze raportu. Nikt nie nałożył sankcji, a mimo to ocena efektów staje się trudniejsza. W dużych serwisach dochodzi kwestia skanowania: Google ostrzega w zaleceniach dla sklepów, że wiele adresów tej samej strony powoduje zbędne pobieranie i obciążenie serwera.
Jest też skutek dotyczący powieleń między serwisami. Skoro spośród identycznych tekstów użytkownik ma zobaczyć jeden, to podstrona z opisem skopiowanym z cudzej witryny rywalizuje o jedno miejsce z jego źródłem i z każdym, kto zrobił to samo. To już nasza obserwacja z praktyki, a nie cytat z dokumentacji: nowej lub niewielkiej stronie trudno wygrać taki wybór z serwisem, który opublikował tekst wcześniej i ma mocniejszą pozycję.
Kiedy wchodzą w grę zasady dotyczące spamu
Zasady dotyczące spamu w wyszukiwarce Google nie zawierają pozycji "duplikaty", ale opisują kilka praktyk, w których powielanie odgrywa główną rolę. Pierwsza to ekstrakcja danych, czyli pobieranie treści z innych witryn, często automatycznie, i publikowanie ich po to, by wpływać na pozycje. Google wymienia tu ponowne publikowanie cudzych tekstów bez własnej wartości, kopiowanie z drobnymi zmianami, takimi jak podmiana synonimów, oraz powielanie cudzych kanałów treści bez korzyści dla użytkownika.
Druga praktyka to nadużywanie treści na dużą skalę: tworzenie wielu stron głównie po to, by oddziaływać na ranking, niezależnie od tego, czy powstają ręcznie, czy automatycznie. Trzecia to strony przejściowe, wśród których zasady wymieniają wiele stron lub domen przygotowanych dla poszczególnych regionów i miast, kierujących użytkownika w to samo miejsce. Czwarta dotyczy programów partnerskich: stron, na których opisy i opinie o produktach są przeniesione wprost od sprzedawcy, bez oryginalnej treści i wartości dodanej.
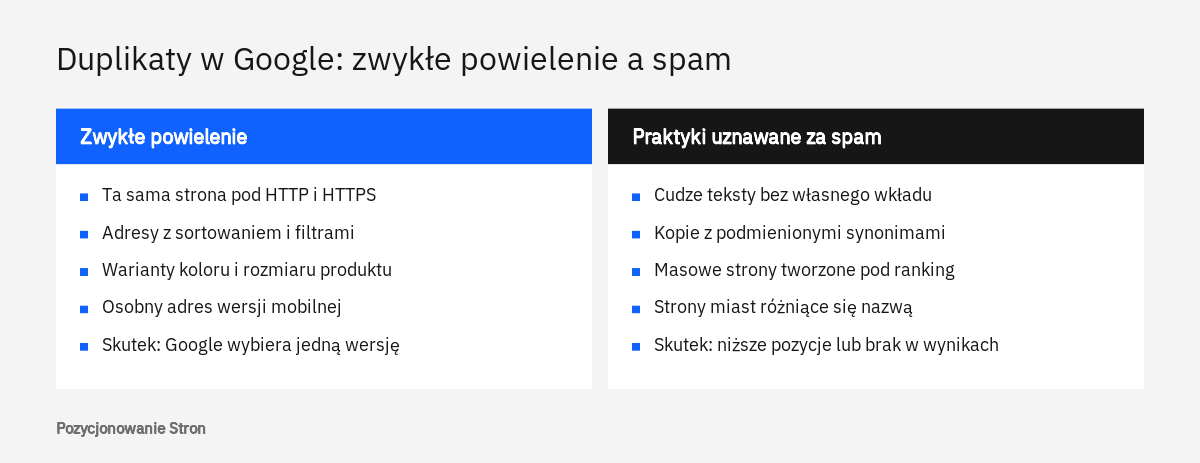
Konsekwencje są opisane jednoznacznie. Strony naruszające zasady mogą zajmować niższe pozycje albo w ogóle nie pojawiać się w wynikach, a naruszenia wykrywają zarówno systemy automatyczne, jak i weryfikatorzy, którzy mogą nałożyć ręczne działanie. Całość omawiamy we wpisie o zasadach Google dotyczących spamu.
Gdzie sprawdzić duplikaty w Search Console
Stan duplikatów pokazują dwa miejsca w Google Search Console: raport Indeksowanie stron, który daje obraz całej witryny, oraz narzędzie do sprawdzania adresów URL, które odpowiada na pytanie o pojedynczy adres. Oba są dostępne bez opłat dla każdego właściciela zweryfikowanej witryny.
Raport Indeksowanie stron
Raport znajduje się w menu po lewej stronie, w grupie poświęconej indeksowaniu, pod pozycją Strony. Poniżej wykresu widać tabelę z przyczynami, dla których adresy nie zostały zindeksowane. Kliknięcie wiersza otwiera listę przykładowych adresów. Zgodnie z pomocą Search Console z powieleniem wiążą się cztery przyczyny.
| Przyczyna w raporcie | Co oznacza | Co zrobić |
|---|---|---|
| Alternatywna strona zawierająca prawidłowy tag strony kanonicznej | Adres poprawnie wskazuje wersję główną, a wersja główna jest w indeksie. | Nic. To dowód, że oznaczenie działa. |
| Duplikat, użytkownik nie oznaczył strony kanonicznej | Strona powiela inną, nie ma deklaracji wersji głównej, a Google wybrał inny adres. | Ustalić, który adres wybrał Google. Jeśli wybór jest błędny, oznaczyć wersję główną. Jeśli strona nie miała być duplikatem, zadbać o wyraźnie inną treść. |
| Duplikat, wyszukiwarka Google wybrała inną stronę kanoniczną niż użytkownik | Właściciel wskazał jeden adres, a Google uznał za główny inny. | Porównać oba adresy i ich treść, a potem uporządkować sprzeczne sygnały. |
| Strona zawierająca przekierowanie | Adres przenosi na inną stronę i sam nie trafia do indeksu. | Nic, o ile przekierowanie jest zamierzone. |
Najważniejszy wniosek z tej tabeli jest uspokajający: duża liczba adresów przy pierwszej i czwartej przyczynie to oznaka porządku, a nie awarii. Niepokoić powinny dopiero dwie środkowe, i to wyłącznie wtedy, gdy na liście znajdują się adresy, które miały samodzielnie zdobywać ruch.
Narzędzie do sprawdzania adresów URL
Aby zbadać konkretny adres, wystarczy wpisać go w pasek wyszukiwania u góry Search Console albo użyć ikony sprawdzania przy adresie na liście w raporcie. W wyniku, w sekcji Indeksowanie stron, znajdują się dwa pola opisane w pomocy narzędzia: Adres kanoniczny określony przez użytkownika oraz Adres kanoniczny wybrany przez Google.
Pierwsze pole pokazuje, co deklaruje sama strona. Drugie pokazuje, co wyszukiwarka faktycznie uznała za wersję główną. Gdy oba adresy są takie same, sprawa jest zamknięta. Gdy się różnią, warto otworzyć obie strony i porównać ich treść, bo pomoc Google podkreśla, że duplikat musi być podobny do strony kanonicznej. Trzeba też wiedzieć, że test wersji opublikowanej nie pokazuje adresu wybranego przez Google i nie przewiduje, który adres zostanie uznany za kanoniczny. Więcej o odczytywaniu wyniku piszemy we wpisie o sprawdzaniu adresu URL w Search Console.
Jeśli chcą Państwo zamówić audyt SEO, zachęcamy do kontaktu: tel. 222 500 844 lub mailowo: biuro@pozycjonowaniestron.pl
Opisy od producenta w sklepie internetowym
Opis przeniesiony z materiałów producenta nie łamie zasad Google, jeśli sklep rzeczywiście sprzedaje dany towar, ale sprawia, że karta produktu niczym nie różni się od kart w dziesiątkach innych sklepów. Zasady dotyczące spamu opisują skopiowane opisy jako problem w kontekście stron partnerskich, które nie wnoszą nic własnego. Zwykły sklep jest w innym położeniu, ponieważ daje klientowi cenę, dostępność, warunki dostawy i obsługę.
Mimo to skutek praktyczny pozostaje. Gdy ten sam opis stoi w wielu serwisach, wyszukiwarka nie ma powodu pokazywać ich wszystkich na to samo zapytanie. Wskazanie adresu kanonicznego niczego tu nie załatwia, bo nie chodzi o dwa adresy tej samej karty, tylko o to, że karta nie ma własnej treści.
Przepisywanie całego asortymentu rzadko jest potrzebne i rzadko jest wykonalne. Rozsądniej jest ustalić kolejność. Hipotetyczny sklep z osprzętem ogrodowym, który ma kilka tysięcy produktów, może zacząć od towarów o najwyższej marży i od tych, które już teraz pojawiają się w wynikach na dalszych pozycjach. Dla pozostałych wystarczy opis producenta uzupełniony o to, czego producent nie napisał.
Tym uzupełnieniem jest wszystko, co sklep wie z własnego doświadczenia: do czego produkt pasuje, a do czego nie, czym różni się od sąsiedniego modelu, jakie pytania zadają klienci przed zakupem, jak wygląda montaż i serwis. Wytyczne Google o tworzeniu przydatnych treści zawierają pytanie kontrolne, które dobrze tu pasuje: jeżeli treść czerpie z innych źródeł, czy nie jest po prostu ich skopiowaną lub przeredagowaną wersją. Podmiana słów w opisie producenta na synonimy nie spełnia tego warunku, a zasady dotyczące spamu wymieniają ją wprost jako przykład kopiowania.
Warianty produktu
Osobnym źródłem powieleń są warianty: ta sama koszulka w pięciu kolorach i czterech rozmiarach. Zalecenia Google dla witryn e-commerce mówią, że każdy wariant powinien mieć własny adres, a jeśli warianty mają wspólną wersję kanoniczną, najlepiej wybrać na nią adres bez opcjonalnego parametru, czyli bez wskazanego koloru. Na stronach wariantów umieszcza się wtedy znacznik prowadzący do adresu głównego produktu. To klasyczny przypadek, w którym pisanie osobnych tekstów nie ma sensu, a wystarczy porządek techniczny. Pokrewną sytuację omawiamy we wpisie o produkcie w kilku kategoriach.
Powtarzane bloki i teksty z szablonu
Stałe elementy powtarzane na wszystkich podstronach, takie jak menu, stopka, dane kontaktowe czy informacja o dostawie, nie czynią stron duplikatami, o ile każda ma własną główną treść. Wynika to z opisu samego mechanizmu: Google grupuje strony według głównej treści, a nie według tego, co je otacza. Inaczej jest wtedy, gdy powtarzany blok stanowi niemal cały tekst podstrony.
Gdy blok jest większy niż treść
Przykład hipotetyczny: kancelaria z Krakowa ma osiem podstron specjalizacji, a na każdej dwa zdania o danej dziedzinie prawa i ten sam długi fragment o zespole, sposobie pracy i przebiegu pierwszego spotkania. Formalnie są to różne strony, w rzeczywistości jedna strona z ośmioma nagłówkami. W raporcie Indeksowanie stron takie adresy mogą trafić do przyczyny "Duplikat, użytkownik nie oznaczył strony kanonicznej", a pomoc Search Console radzi wówczas zadbać o wyraźnie inną treść, jeśli strona nie miała być duplikatem.
Rozwiązanie polega na odwróceniu proporcji. Wspólny fragment warto skrócić do kilku zdań z odnośnikiem do osobnej podstrony, na której jest opisany w całości, a zwolnione miejsce przeznaczyć na to, co dla danej usługi swoiste: typowe sprawy, przebieg, potrzebne dokumenty, pytania klientów.
Strony miast z jednego szablonu
Najbardziej ryzykowną odmianą tekstu z szablonu są podstrony lokalne, na których zmienia się wyłącznie nazwa miejscowości. Hydraulik z Łodzi, który chce docierać do klientów z okolicznych miast, tworzy dwadzieścia stron o brzmieniu różniącym się jednym słowem. Technicznie mogą one zostać zgrupowane jako duplikaty. Poważniejsze jest to, że zasady dotyczące spamu wymieniają wiele stron dla regionów i miast kierujących użytkownika w to samo miejsce jako przykład stron przejściowych.
Nie oznacza to, że strony lokalne są zakazane. Mają rację bytu wtedy, gdy każda niesie informacje prawdziwe tylko dla danego miejsca: obszar dojazdu i jego czas, zakres prac wykonywanych w tej okolicy, lokalne uwarunkowania, zdjęcia własnych realizacji z opisem. Jeżeli firma nie ma nic odrębnego do powiedzenia o danej miejscowości, lepsza jest jedna rzetelna strona z listą obsługiwanych miast niż seria kopii. To samo dotyczy tekstów generowanych seryjnie z tabeli danych, które zasady Google zaliczają do nadużywania treści na dużą skalę, gdy nie wnoszą wartości dla użytkownika.
Jak wskazać Google wersję główną
Wersję główną wskazuje się trzema metodami, które dokumentacja Google porządkuje według siły: przekierowaniem, znacznikiem rel="canonical" oraz wpisem w mapie witryny. Strona Jak określić kanoniczny URL za pomocą rel="canonical" i innych metod zaznacza przy tym, że wskazanie nie jest obowiązkowe. Bez niego Google sam wybierze wersję, tyle że niekoniecznie tę, na której Państwu zależy.
Przekierowanie jest wyraźnym sygnałem i stosuje się je wtedy, gdy zbędny adres ma przestać istnieć, na przykład stara wersja bez HTTPS. Znacznik rel="canonical" to również wyraźny sygnał, właściwy wtedy, gdy oba adresy mają pozostać dostępne dla użytkowników, jak kategoria z sortowaniem. Mapa witryny jest sygnałem słabszym, za to łatwym do utrzymania w dużych serwisach. Metody wolno łączyć, co zwiększa szansę na wybór właściwego adresu.
<link rel="canonical" href="https://www.przyklad.pl/buty-trekkingowe/">Dokumentacja zaleca kilka zasad, których w praktyce brakuje najczęściej. Adres w znaczniku powinien być bezwzględny, czyli pełny, razem z protokołem i domeną. Strona główna powinna wskazywać samą siebie. Linki wewnętrzne powinny prowadzić do adresu kanonicznego, a nie do jego kopii. Dla plików innych niż HTML, na przykład dokumentów PDF, to samo wskazanie można przekazać w nagłówku odpowiedzi serwera.
Link: <https://www.przyklad.pl/pliki/katalog.pdf>; rel="canonical"Czego nie stosować do porządkowania duplikatów
Ta sama strona dokumentacji wylicza metody, które wyglądają na skuteczne, a szkodzą. Plik robots.txt nie służy do wskazywania wersji głównej. Znacznik noindex całkowicie wyłącza stronę z wyszukiwarki, dlatego do wyboru wersji kanonicznej Google zaleca rel="canonical". Narzędzie do usuwania adresów ukrywa wszystkie wersje, łącznie z tą właściwą. Nie należy też podawać różnych adresów głównych różnymi metodami ani wskazywać adresu z fragmentem po znaku krzyżyka. W serwisach opartych na JavaScripcie znacznik powinien znajdować się w kodzie HTML i nie być później zmieniany przez skrypt.
Kiedy pisać od nowa, a kiedy wystarczy wskazać wersję główną
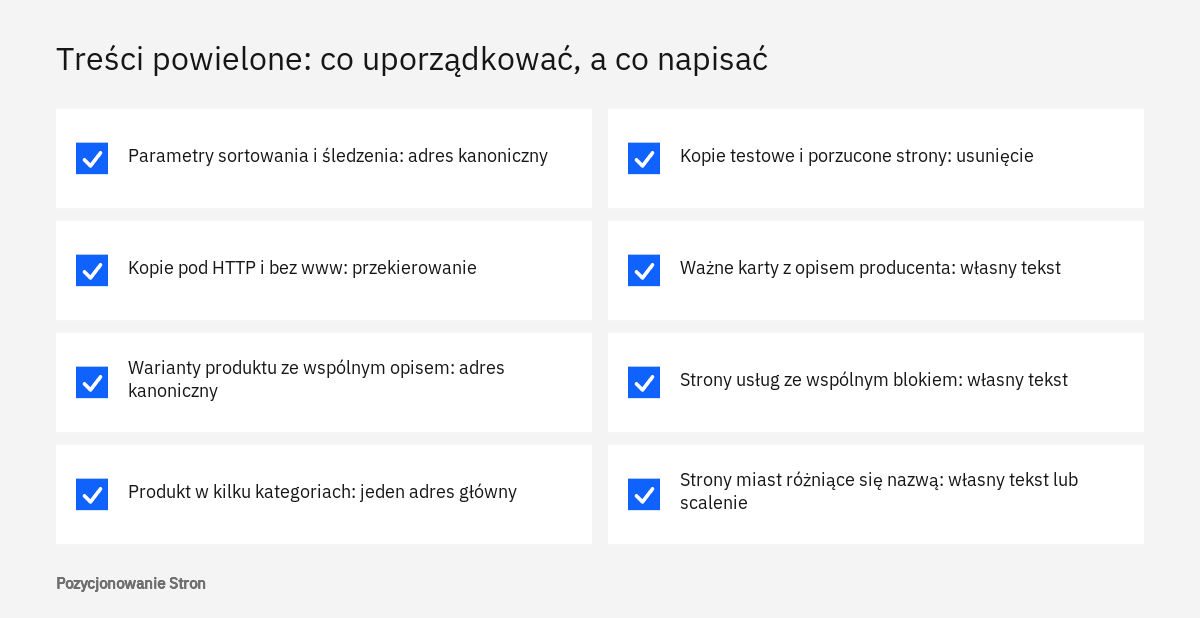
O wyborze decyduje jedno pytanie: czy dana podstrona ma samodzielnie pojawiać się w wynikach na własne zapytania. Jeżeli nie, bo jest tylko innym adresem tej samej treści, wystarczy przekierowanie albo adres kanoniczny. Jeżeli tak, a jej tekst istnieje już gdzie indziej, żadne oznaczenie techniczne nie pomoże i potrzebna jest własna treść.
Do pierwszej grupy należą adresy z parametrami sortowania i śledzenia kampanii, wersje z ukośnikiem na końcu i bez niego, kopie pod HTTP, wersje do druku, warianty produktu o wspólnym opisie oraz ten sam produkt osiągalny przez kilka kategorii.
Do drugiej grupy należą karty produktów z opisem producenta, na których sklepowi szczególnie zależy, strony usług złożone głównie ze wspólnego bloku, strony miast różniące się jedną nazwą oraz teksty przeniesione z innych serwisów. Stare kopie testowe i porzucone wersje ofert lepiej po prostu przekierować lub usunąć, zamiast je oznaczać.
Kolejność pracy z duplikatami
- Spis adresów z raportu
Z raportu Indeksowanie stron warto wyeksportować adresy z obu przyczyn zaczynających się od słowa "Duplikat" i podzielić je na typy: parametry, warianty, strony z szablonu, pozostałe.
- Ocena przeznaczenia każdego typu
Przy każdym typie trzeba rozstrzygnąć, czy takie strony mają zdobywać ruch, czy są wyłącznie kopią techniczną albo zbędną pozostałością.
- Porządek techniczny
Kopie techniczne otrzymują przekierowanie lub adres kanoniczny, a linki wewnętrzne i mapa witryny zostają ujednolicone tak, by wskazywały wersję główną.
- Własna treść tam, gdzie to się opłaca
Podstrony, które mają rywalizować w wynikach, dostają tekst oparty na wiedzy firmy, w kolejności wynikającej z ich znaczenia dla sprzedaży.
- Ponowna kontrola
Po zmianach narzędzie do sprawdzania adresów URL pokaże, czy adres wybrany przez Google zgadza się z zadeklarowanym.
Typowe pomyłki
Najczęstszy błąd to sprzeczne sygnały. Znacznik wskazuje jeden adres, mapa witryny zawiera drugi, a menu prowadzi do trzeciego. Google otrzymuje wtedy trzy różne podpowiedzi i rozstrzyga sam, co kończy się przyczyną "Duplikat, wyszukiwarka Google wybrała inną stronę kanoniczną niż użytkownik". Druga pomyłka to wskazanie jako wersji głównej strony, która nie jest podobna do kopii, na przykład skierowanie wszystkich produktów na stronę główną. Trzecia to użycie noindex lub blokady w robots.txt zamiast adresu kanonicznego. Czwarta ma charakter redakcyjny: uznanie, że lekkie przeredagowanie cudzego tekstu czyni go własnym.
- Każda strona przeznaczona do indeksowania wskazuje znacznikiem rel="canonical" samą siebie, pełnym adresem.
- Wersje z HTTP oraz z www lub bez www przekierowują do jednej wybranej postaci adresu.
- Mapa witryny zawiera wyłącznie adresy główne.
- Menu, okruszki i linki w treści prowadzą do adresów głównych, bez parametrów śledzenia.
- Kopia testowa serwisu jest niedostępna dla robotów.
- Najważniejsze karty produktów i strony usług mają tekst, którego nie ma w innych serwisach.
- Wspólne bloki zajmują mniejszą część podstrony niż jej własna treść.
Kiedy potrzebna jest pomoc
Pojedyncze duplikaty w małej witrynie da się uporządkować samodzielnie, korzystając z ustawień systemu zarządzania treścią. Wsparcie specjalisty przydaje się wtedy, gdy liczba adresów z przyczynami dotyczącymi duplikatów rośnie z miesiąca na miesiąc, gdy Google uparcie wybiera inną wersję niż zadeklarowana, gdy sklep ma rozbudowane filtry lub gdy w Search Console pojawiło się ręczne działanie. W takich przypadkach przyczyna leży zwykle w konstrukcji serwisu, a jej ustalenie jest zadaniem z zakresu SEO technicznego. Punktem wyjścia jest audyt SEO, który oddziela kopie techniczne od stron wymagających nowej treści. Przygotowanie samych tekstów, na przykład opisów produktów, wchodzi w zakres copywritingu, a w sklepach całość łączy się z pozycjonowaniem sklepów internetowych.
Jeśli chcą Państwo zamówić audyt SEO, zachęcamy do kontaktu: tel. 222 500 844 lub mailowo: biuro@pozycjonowaniestron.pl
Najczęstsze pytania
Czy Google nakłada karę za powieloną treść?
Za samo powielenie nie. Dokumentacja Google stwierdza, że powielona treść bywa normalna i nie narusza zasad dotyczących spamu. Sankcje grożą za praktyki opisane w tych zasadach, takie jak kopiowanie cudzych treści bez własnej wartości czy masowe tworzenie stron pod wyszukiwarkę.
Ile procent tekstu musi być unikalne?
Dokumentacja Google, z której korzystaliśmy, nie podaje żadnego progu procentowego. Opisuje jedynie, że wyszukiwarka grupuje strony o takiej samej lub bardzo podobnej głównej treści. Zamiast liczyć procenty, lepiej ocenić, czy podstrona mówi czytelnikowi coś, czego nie znajdzie na innych stronach serwisu.
Czy regulamin i polityka prywatności podobne do innych stron szkodzą witrynie?
Nie ma podstaw, by tak sądzić. Są to strony informacyjne, które nie mają zdobywać ruchu z wyszukiwarki, więc ich powtarzalność nie jest wadą. Ważne jest co innego: by dokument odpowiadał temu, jak firma rzeczywiście działa, co warto potwierdzić u prawnika.
Co zrobić, gdy ktoś skopiował tekst z naszej strony?
Najpierw warto zabezpieczyć dowody i zwrócić się do właściciela serwisu o usunięcie treści. Zasady Google wspominają o żądaniach usunięcia treści z powodu naruszenia praw autorskich, a duża liczba zasadnych żądań wobec jednej witryny może obniżyć jej pozycje. Dalsze kroki prawne należy omówić z prawnikiem.
Dlaczego Google wybrał inny adres kanoniczny niż wskazany na stronie?
Ponieważ znacznik rel="canonical" jest wskazówką, a nie poleceniem. Jeśli przekierowania, mapa witryny lub linki wewnętrzne przemawiają za innym adresem, wyszukiwarka może pójść za nimi. Pomaga ujednolicenie wszystkich sygnałów tak, by wskazywały tę samą wersję.
Jak długo trwa znikanie duplikatów z raportu w Search Console?
Nie ma jednego terminu. Zmiana stanu wymaga ponownego odwiedzenia adresów przez roboty, a dokumentacja zaznacza, że duplikaty są odwiedzane rzadziej niż wersje główne. Przy pojedynczych, ważnych adresach postęp można śledzić w narzędziu do sprawdzania adresów URL.
Źródła
- Co to jest wybór strony kanonicznej, Centrum wyszukiwarki Google
- Jak określić kanoniczny URL za pomocą rel="canonical" i innych metod, Centrum wyszukiwarki Google
- Zasady dotyczące spamu w wyszukiwarce Google, Centrum wyszukiwarki Google
- Tworzenie treści przydatnych, rzetelnych i ukierunkowanych na użytkowników, Centrum wyszukiwarki Google
- Sprawdzone metody projektowania struktury adresów URL na potrzeby witryn e-commerce, Centrum wyszukiwarki Google
- Raport Indeksowanie stron, Search Console - pomoc
- Narzędzie do sprawdzania adresów URL, Search Console - pomoc
Funkcje wyszukiwarek i asystentów AI zmieniają się szybko, dlatego wpis aktualizujemy po większych zmianach.