Kopię zapasową strony firmowej warto wykonywać tak często, jak często zmienia się jej treść: przy rzadkich zmianach raz w tygodniu, przy codziennych zamówieniach i wpisach - codziennie. Sama kopia to jednak dopiero połowa zabezpieczenia. Drugą połową jest przechowywanie jej poza serwerem oraz regularne próbne odtwarzanie, które pokazuje, czy stronę rzeczywiście da się z niej podnieść.
Z czego składa się kopia zapasowa strony
Kopia zapasowa strony to zapis dwóch osobnych rzeczy: plików leżących na serwerze oraz bazy danych. Dokumentacja WordPressa poświęcona kopiom zapasowym stwierdza wprost, że do pełnego odtworzenia typowej witryny potrzebne są obie części. Wiele firm ma tylko jedną z nich i dowiaduje się o tym w najgorszym możliwym momencie.
Pliki
Pliki to wszystko, co decyduje o wyglądzie i działaniu strony: sam system, motyw, wtyczki, zdjęcia i dokumenty wgrane przez redakcję, a także dodatkowy kod. W przypadku WordPressa dokumentacja wskazuje, że należy zachować cały katalog instalacji wraz z podkatalogami, a szczególnie katalog wp-content (motywy, wtyczki i wgrane materiały), plik wp-config.php z danymi połączenia z bazą oraz plik .htaccess. Pliki samego systemu można w razie potrzeby pobrać ponownie z oficjalnego źródła, natomiast zdjęć realizacji i własnych przeróbek motywu nikt za Państwa nie odtworzy.
Baza danych
W bazie danych zapisane są treści: wpisy, podstrony, komentarze, ustawienia, konta użytkowników, a w sklepie także produkty, zamówienia i dane klientów. Baza działa w osobnym systemie (najczęściej MySQL lub MariaDB), dlatego skopiowanie plików przez FTP jej nie obejmuje. Kopia bazy ma postać pliku eksportu z rozszerzeniem .sql, często spakowanego do .gz lub .bz2. Przy odtwarzaniu trzeba go osobno zaimportować.
Zestaw obejmujący jednocześnie pliki strony i eksport bazy danych z tego samego momentu. Tylko taki zestaw pozwala podnieść stronę od zera na pustym serwerze.
Skutki braku jednej części łatwo przewidzieć. Kopia samych plików oddaje po awarii wygląd strony bez żadnej treści. Kopia samej bazy przywraca teksty, lecz z pustymi miejscami po grafikach - dokumentacja WordPressa przypomina, że eksport bazy nie zawiera motywów, wtyczek, wgranych plików ani pliku konfiguracyjnego.
Liczy się też kolejność. Według dokumentacji przy tworzeniu kopii najpierw zapisuje się bazę, a potem pliki. Przy odtwarzaniu jest odwrotnie: najpierw pliki, następnie import bazy, a jeśli zmieniły się dane dostępu do bazy, na końcu poprawia się plik wp-config.php.
Jak często robić kopie zapasowe
Kopie należy wykonywać tak często, by utrata zmian od ostatniej kopii była dla firmy do przyjęcia. Dokumentacja WordPressa podaje dwa punkty odniesienia: mniejsze strony z niewielką liczbą wpisów - raz w tygodniu, strony o dużej aktywności - codziennie. Do tego dochodzi zasada niezależna od kalendarza: kopię bazy wykonuje się zawsze przed aktualizacją systemu.
Wygodnie jest myśleć o tym za pomocą dwóch pojęć opisanych w opracowaniu amerykańskiego instytutu NIST o tworzeniu i testowaniu kopii. Pierwsze to RPO (z angielskiego Recovery Point Objective), czyli największy dopuszczalny wiek kopii, z której firma jest w stanie wznowić działanie. Drugie to RTO (Recovery Time Objective), czyli czas, w jakim strona ma wrócić do pracy, aby szkody pozostały ograniczone. Pierwsze pojęcie odpowiada na pytanie „ile pracy wolno nam stracić”, drugie na pytanie „jak długo wolno nam nie działać”.
Dobrze widać to na hipotetycznych przykładach. Hydraulik z Łodzi ma stronę z ofertą, cennikiem i formularzem, a zmiany wprowadza raz na kilka tygodni. Przy kopii tygodniowej w najgorszym razie utraci jedną poprawkę w cenniku. Sklep internetowy z Poznania przyjmuje zamówienia przez cały dzień, więc kopia tygodniowa oznaczałaby dla niego utratę zamówień i kont klientów z kilku dni, czego nie da się odtworzyć z pamięci. Kancelaria z Krakowa publikuje dwa wpisy w tygodniu i zbiera zapytania przez formularz zapisywany w bazie - tutaj kopia codzienna bazy i tygodniowa plików jest rozsądnym kompromisem.
| Rodzaj strony | Co się zmienia | Baza danych | Pliki |
|---|---|---|---|
| Wizytówka firmy, rzadkie poprawki | Pojedyncze teksty i zdjęcia | Raz w tygodniu i przed każdą aktualizacją | Raz w tygodniu lub po większej zmianie |
| Strona z blogiem i formularzami | Wpisy, zgłoszenia, komentarze | Codziennie | Raz w tygodniu |
| Sklep internetowy | Zamówienia, stany magazynowe, konta | Codziennie, a przy dużym ruchu częściej | Codziennie |
| Strona w trakcie przebudowy | Motyw, wtyczki, układ podstron | Przed każdym dniem prac | Przed każdym dniem prac |
Bazę i pliki można kopiować w różnym rytmie: baza jest zwykle niewielka i zmienia się stale, pliki zajmują znacznie więcej miejsca, ale zmieniają się głównie przy aktualizacjach i wgrywaniu nowych materiałów.
Dlaczego kopia u dostawcy hostingu nie wystarcza
Kopia u dostawcy hostingu nie wystarcza, ponieważ leży w tym samym miejscu i pod tym samym kontem co strona, a o jej zakresie, czasie przechowywania i sposobie odtworzenia decyduje ktoś inny. Jest wartościową pierwszą linią obrony, lecz nie powinna być jedyną. Dokumentacja WordPressa wymienia narzędzia dostawcy jako jeden z kilku sposobów i jednocześnie zaleca trzymanie kopii w różnych miejscach: na serwerze, w chmurze i na komputerze lokalnym.
Powodów jest kilka. Awaria sprzętu lub całej serwerowni może objąć zarówno stronę, jak i kopie przechowywane obok niej. Przejęcie konta w panelu klienta daje włamywaczowi dostęp do strony i do jej kopii jednocześnie. Zaległa płatność, pomyłka przy przedłużeniu usługi albo spór z dostawcą mogą skończyć się zamknięciem konta razem z kopiami. Kopia dostawcy bywa też wykonywana dla całego konta, więc przy kilku witrynach i poczcie na jednym koncie przywrócenie stanu sprzed trzech dni może cofnąć wszystko naraz. Zakres i warunki odtworzenia opisuje regulamin konkretnej usługi, z którym warto się zapoznać przed awarią, a nie po niej.
Przed podpisaniem umowy lub przy najbliższym kontakcie z pomocą techniczną warto zadać dostawcy kilka prostych pytań:
- Jak często wykonywane są kopie i czy obejmują zarówno pliki, jak i bazy danych.
- Przez ile dni kopie są przechowywane i ile wersji wstecz jest dostępnych.
- Czy kopie leżą na innym urządzeniu i w innej lokalizacji niż strona.
- Czy klient może sam pobrać kopię na własny dysk i sam ją przywrócić z panelu.
- Czy przywrócenie jest objęte opłatą i ile czasu zwykle zajmuje.
- Czy da się przywrócić pojedynczą stronę lub samą bazę, bez cofania całego konta.
- Co dzieje się z kopiami po wygaśnięciu lub zawieszeniu usługi.
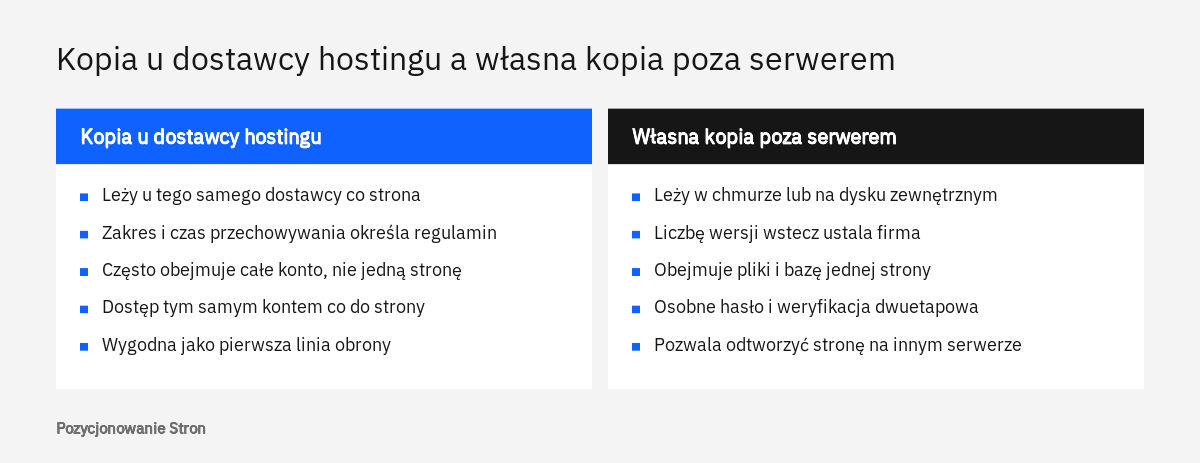
Odpowiedzi na te pytania różnią oferty bardziej niż pojemność dysku. Szerzej omawiamy je we wpisie o tym, jakie parametry hostingu mają znaczenie dla strony firmowej. Te same słabości co kopia dostawcy ma kopia zapisywana przez wtyczkę do katalogu na tym samym serwerze, a jeśli taki katalog jest dostępny z zewnątrz przez przeglądarkę, plik z eksportem bazy może trafić w niepowołane ręce.
Gdzie przechowywać kopie zapasowe
Kopie warto przechowywać w co najmniej dwóch miejscach, z których jedno znajduje się poza serwerem strony i poza siedzibą firmy. Najprostszym sposobem uporządkowania tego tematu jest zasada 3-2-1, którą amerykańska agencja do spraw cyberbezpieczeństwa CISA opisuje w zaleceniach dla małych i średnich firm: trzy kopie ważnych plików, dwa różne rodzaje nośników (na przykład dysk twardy i chmura) oraz jedna kopia przechowywana poza miejscem prowadzenia działalności.
W przełożeniu na stronę internetową może to wyglądać następująco. Pierwszym egzemplarzem jest kopia wykonywana przez dostawcę hostingu. Drugim jest własna kopia wysyłana automatycznie do magazynu w chmurze, czyli na zewnętrzne konto niezwiązane z serwerem strony, na przykład na Dysk Google. Trzecim jest egzemplarz pobierany co pewien czas na dysk zewnętrzny w firmie. Żadne z tych miejsc nie jest doskonałe, ale mało prawdopodobne, by wszystkie trzy zawiodły w tym samym dniu.
Brytyjskie centrum cyberbezpieczeństwa w zaleceniach dla małych organizacji zwraca uwagę na dwa szczegóły, które łatwo pominąć. Dysku zewnętrznego z kopią nie należy zostawiać stale podłączonego do komputera, ponieważ część złośliwego oprogramowania obejmuje także podłączone urządzenia. Konto w chmurze, na którym leżą kopie, powinno być chronione weryfikacją dwuetapową. Od siebie dodajemy trzecią uwagę: konto z kopiami powinno mieć inne hasło niż panel hostingu, a dostęp do niego powinny mieć co najmniej dwie osoby w firmie. Kopie leżące na prywatnym koncie byłego pracownika albo dawnego wykonawcy strony są w praktyce stracone.
Kopie a dane osobowe
Kopia bazy zawiera wszystko, co baza: zgłoszenia z formularzy, konta klientów, adresy i historię zamówień. Jest więc zbiorem danych osobowych i podlega tym samym zasadom co strona. Artykuł 32 RODO wymienia wśród środków bezpieczeństwa między innymi szyfrowanie danych, zdolność do szybkiego przywrócenia dostępności danych po incydencie fizycznym lub technicznym oraz regularne testowanie skuteczności przyjętych zabezpieczeń. Praktyczny wniosek: kopie warto szyfrować lub co najmniej chronić hasłem, nie przesyłać ich zwykłą pocztą i wiedzieć, u jakiego dostawcy leżą. Sposób ujęcia tego w dokumentach firmy to kwestia dla prawnika lub inspektora ochrony danych, a ogólne tło opisujemy we wpisie o tym, co musi zawierać polityka prywatności strony firmowej.
Ile wersji wstecz przechowywać
Warto przechowywać kilka kolejnych wersji, a nie jedną nadpisywaną kopię. Dokumentacja WordPressa mówi o co najmniej 3-5 ostatnich kopiach, a zalecenia CISA o możliwości cofnięcia danych o co najmniej siedem dni. Powód jest prosty: wiele uszkodzeń wychodzi na jaw z opóźnieniem.
Wyobraźmy sobie gabinet stomatologiczny z Bydgoszczy, którego strona została zainfekowana w poniedziałek, a pierwsze objawy, czyli przekierowania na obce witryny, ktoś zauważył dopiero w piątek. Jeżeli firma ma jedną kopię nadpisywaną co noc, to w piątek dysponuje wyłącznie kopią zainfekowanej strony. Jeżeli ma siedem wersji dziennych, sięga po niedzielną. Podobnie działa to przy błędach ludzkich: omyłkowo usunięta podstrona albo nadpisany cennik bywają zauważane po tygodniach.
Rozsądnym układem dla większości stron firmowych jest połączenie trzech rytmów: kilka ostatnich kopii dziennych, kilka tygodniowych i kilka miesięcznych. Wersje dzienne chronią przed świeżą awarią, tygodniowe przed problemem zauważonym z opóźnieniem, a miesięczne przed zmianą, o której wszyscy zdążyli zapomnieć. Traktujemy ten układ jako punkt wyjścia z praktyki, a nie sztywną normę.
Przy ustalaniu liczby wersji trzeba uwzględnić jeszcze dwie rzeczy. Opracowanie NIST zaleca rozpoznanie wymogów prawnych i umownych dotyczących przechowywania danych, a kopie z danymi osobowymi nie powinny leżeć bez końca. Druga sprawa to nazewnictwo: każdy plik powinien mieć w nazwie datę wykonania oraz informację, czy zawiera pliki, czy bazę. W chwili awarii nikt nie ma czasu otwierać archiwów po kolei.
Jeśli chcą Państwo zamówić stronę internetową, zachęcamy do kontaktu: tel. 222 500 844 lub mailowo: biuro@pozycjonowaniestron.pl
Jak wykonać kopię: automat i kontrola ręczna
Kopie powinny powstawać automatycznie, według harmonogramu, a człowiek powinien co pewien czas wykonać kopię ręcznie i porównać wynik. Zalecenia CISA mówią o rozwiązaniu, które działa samoczynnie i regularnie, a dokumentacja WordPressa dodaje, że obok automatu warto od czasu do czasu zrobić kopię ręczną, aby upewnić się, że proces rzeczywiście działa. Automat bez nadzoru potrafi przestać działać po zmianie hasła albo zapełnieniu dysku i przez miesiące nikt tego nie zauważa.
Automatyzację można zorganizować na trzech poziomach. Najprostszy to narzędzie w panelu dostawcy hostingu. Drugi to wtyczka do kopii zapasowych: dokumentacja WordPressa wskazuje, że takie wtyczki wykonują kopie według harmonogramu, a znaleźć je można w oficjalnym katalogu wtyczek. Przy wyborze liczy się to, czy wtyczka obejmuje pliki i bazę oraz czy wysyła kopię poza serwer. Trzeci poziom to zadanie uruchamiane cyklicznie na serwerze, stosowane przy większych stronach i sklepach.
Ręczna kopia bazy danych
Bazę najczęściej eksportuje się w narzędziu phpMyAdmin, dostępnym z panelu hostingu. Dokumentacja WordPressa o kopii bazy danych opisuje dwie ścieżki. W szybkiej wystarczy wskazać bazę strony, otworzyć zakładkę eksportu (Export), pozostawić metodę szybką (Quick) i zatwierdzić. W ścieżce niestandardowej (Custom) zaznacza się wszystkie tabele albo tylko te z przedrostkiem danej strony, ustawia kompresję zip lub gzip, format pozostawia jako SQL, a w opcjach tworzenia obiektów włącza dopisywanie instrukcji DROP TABLE, dzięki której import nadpisze istniejące tabele.
Dokumentacja zastrzega, że phpMyAdmin słabo radzi sobie z dużymi bazami i wtedy lepiej użyć wiersza poleceń: programu mysqldump albo WP-CLI, czyli narzędzia do obsługi WordPressa z wiersza poleceń. Według opisu polecenia wp db export korzysta ono z programu mysqldump i samo pobiera dane dostępu z pliku wp-config.php.
mysqldump --add-drop-table -h db01.example.net -u uzytkownik -p nazwa_bazy | gzip > kopia-bazy.sql.gz

wp db export --add-drop-table kopia-bazy.sql
Ręczna kopia plików
Pliki pobiera się programem do FTP lub SFTP na dysk lokalny. Strona dokumentacji o kopii plików WordPressa nazywa tę metodę najłatwiejszą i radzi po pobraniu spakować katalog do archiwum zip, co oszczędza miejsce i ułatwia trzymanie kilku wersji. Opisuje też synchronizację, w której program utrzymuje na dysku lustrzane odbicie zawartości serwera. To jednak jedna, stale nadpisywana wersja, więc warto łączyć ją z okresowym pakowaniem katalogu do osobnych, datowanych archiwów.
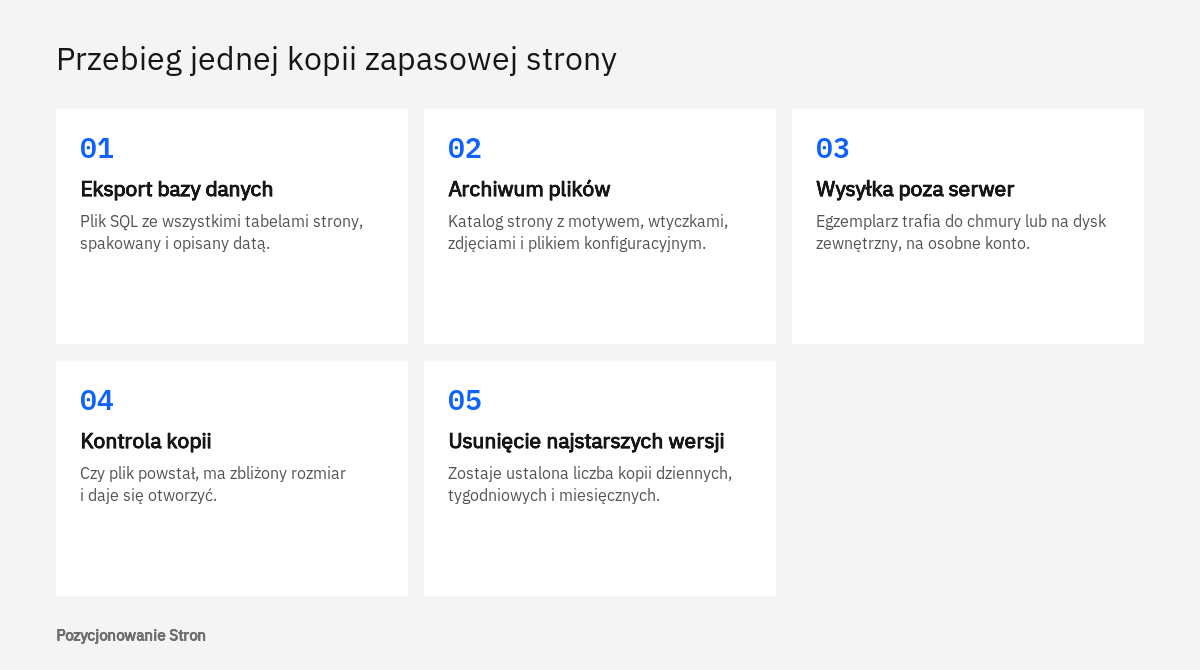
Na końcu każdej kopii przydaje się krótka kontrola: czy plik powstał, czy jego rozmiar jest zbliżony do poprzednich i czy archiwum daje się otworzyć. Bardzo mały plik bazy przy dużym sklepie jest sygnałem, że eksport został przerwany.
Jak przeprowadzić próbne przywrócenie strony w środowisku testowym
Próbne przywrócenie polega na postawieniu strony z kopii w osobnym miejscu, bez dotykania wersji działającej, i sprawdzeniu, czy wszystko działa. Jest to jedyny sposób, by dowiedzieć się, czy kopia jest kompletna i ile czasu zajmuje odtworzenie. Zalecenia CISA mówią o zaplanowanych testach odzyskiwania, które potwierdzają integralność kopii, a opracowanie NIST dodaje, że test pozwala zmierzyć czas odtwarzania i wychwycić luki techniczne oraz organizacyjne.
Osobna kopia strony pod innym adresem, na przykład w subdomenie lub na drugim koncie hostingu, niewidoczna dla klientów i wyszukiwarek. Służy do prób, których nie wolno wykonywać na stronie działającej.
Przebieg próby dla strony na WordPressie można ułożyć w następujący sposób:
- Przygotowanie pustego miejsca
Zakłada się subdomenę testową i nową, pustą bazę danych z osobnym użytkownikiem. Nie wolno używać bazy strony działającej, ponieważ import nadpisuje dotychczasową zawartość.
- Wgranie plików z kopii
Archiwum z plikami rozpakowuje się w katalogu subdomeny. Przy odtwarzaniu pliki idą jako pierwsze.
- Import bazy danych
W phpMyAdmin wskazuje się nową bazę, otwiera zakładkę importu (Import), wybiera plik kopii i format SQL, po czym zatwierdza. Duże bazy importuje się z wiersza poleceń programem mysql.
- Poprawienie konfiguracji
W pliku
wp-config.phpwpisuje się nazwę nowej bazy, użytkownika, hasło i adres serwera bazy. - Zmiana adresu strony
Adres witryny zapisany w bazie trzeba zamienić na adres testowy, inaczej kopia będzie odsyłać do strony działającej.
- Zamknięcie przed wyszukiwarkami i ludźmi
Kopię zabezpiecza się hasłem na poziomie serwera i włącza w niej prośbę o nieindeksowanie.
Zmiana adresu wymaga ostrożności. Dokumentacja WordPressa o przenoszeniu witryny podaje, że do testów można tymczasowo zmienić wartości siteurl i home w tabeli wp_options albo ustawić stałe WP_HOME i WP_SITEURL w pliku konfiguracyjnym. Ostrzega też, że proste wyszukanie i zamiana adresu w całej bazie może uszkodzić dane serializowane, w których zapisana jest długość każdego ciągu znaków. Zaleca więc narzędzie, które takie dane rozumie, na przykład polecenie search-replace w WP-CLI.
define( 'WP_HOME', 'https://test.example.pl' );
define( 'WP_SITEURL', 'https://test.example.pl' );

<meta name="robots" content="noindex">
Kopię testową trzeba zamknąć przed wyszukiwarkami, bo druga, identyczna wersja strony pod innym adresem to powielona treść i ryzyko, że klient trafi do sklepu, który niczego nie wyśle. W WordPressie służy do tego pole w sekcji Widoczność dla wyszukiwarek na ekranie Ustawienia, Czytanie. Dokumentacja tego ekranu wyjaśnia, że po jego zaznaczeniu system dopisuje w nagłówku strony znacznik robots z wartością noindex, ale nie blokuje dostępu do witryny. Google w dokumentacji reguły noindex zaznacza, że reguła działa tylko wtedy, gdy robot może stronę odczytać, więc nie należy jednocześnie blokować jej w pliku robots.txt. Najpewniejszym zabezpieczeniem pozostaje hasło na poziomie serwera.
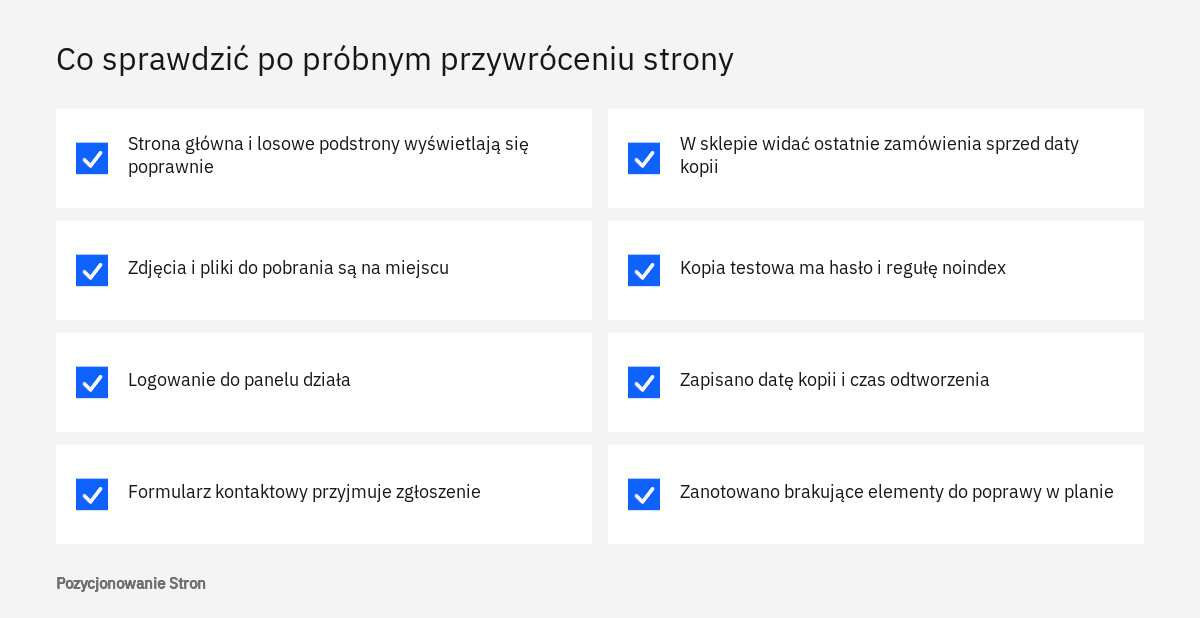
Po uruchomieniu kopii przychodzi czas na oględziny: czy strona główna i kilka losowych podstron wyświetlają się poprawnie, czy zdjęcia są na miejscu, czy działa logowanie i formularz, a w sklepie - czy widoczne są ostatnie zamówienia sprzed daty kopii. Warto zapisać, z którego dnia pochodziła kopia, ile trwało odtworzenie i czego zabrakło. Te notatki tworzą instrukcję na dzień prawdziwej awarii.
Źródła, na które się powołujemy, mówią o testach zaplanowanych i regularnych, bez wskazania odstępów. Z naszej praktyki wynika, że dla strony firmowej rozsądny jest rytm kwartalny oraz dodatkowa próba po każdej dużej zmianie: nowym hostingu, nowym narzędziu do kopii, przebudowie strony.
Awaria strony a widoczność w Google: dlaczego liczy się czas odtworzenia
Czas odtworzenia ma znaczenie nie tylko dla klientów, którzy trafiają na błąd, lecz także dla widoczności strony w wyszukiwarce. Google opisuje w dokumentacji, jak kody stanu HTTP wpływają na jego roboty: przy błędach serwera z grupy 5xx robot zwalnia odwiedzanie witryny, a adresy już zindeksowane pozostają w indeksie przez pewien czas, po czym te, które stale zwracają błąd, są z niego usuwane. Adresy zwracające kod z grupy 4xx, na przykład 404, również są usuwane z indeksu.
Wynikają z tego dwa wnioski. Krótka przerwa nie przekreśla wypracowanej widoczności, natomiast awaria ciągnąca się tygodniami, bo nikt nie potrafi znaleźć ani odtworzyć kopii, już tak. Odtworzenie strony z niepełnej kopii, w której brakuje części podstron, oznacza z kolei serię błędów 404 pod adresami, które wcześniej działały.
Jeżeli stronę trzeba na czas naprawy wyłączyć, Google w zaleceniach dotyczących tymczasowego wstrzymywania i wyłączania witryny radzi, by przy przerwie trwającej 1-2 dni strona informacyjna zwracała kod 503, najlepiej z nagłówkiem Retry-After, i by tego kodu nie zwracał plik robots.txt. Zaznacza przy tym, że całkowite wyłączenie witryny to środek radykalny, stosowany najwyżej przez kilka dni.
W dniu awarii pomaga ustalona wcześniej kolejność działań. Najpierw ustala się, co nie działa i od kiedy, bo od tego zależy wybór wersji kopii. Następnie zapisuje się obecny, uszkodzony stan strony jako osobne archiwum - przyda się do ustalenia przyczyny i odzyskania danych powstałych po ostatniej kopii. Potem odtwarza się stronę z ostatniej zdrowej wersji, zmienia hasła i aktualizuje oprogramowanie; podstawy takiego zabezpieczenia opisaliśmy we wpisie o bezpieczeństwie strony na WordPressie. Na końcu uzupełnia się ręcznie to, czego w kopii nie było, i w ramach prac z zakresu SEO technicznego sprawdza w Search Console, czy najważniejsze adresy odpowiadają poprawnie.
Typowe pomyłki i sytuacje, w których potrzebna jest pomoc
Najczęstszą pomyłką jest przekonanie, że kopie „jakoś się robią”, bez wiedzy, kto je wykonuje, gdzie leżą i czy ktokolwiek próbował je odtworzyć. Pozostałe błędy są odmianami tego samego problemu.
Pierwsza grupa to kopie niepełne: same pliki bez bazy, sama baza bez zdjęć albo pominięty plik konfiguracyjny. Druga - kopie w jednym miejscu: wyłącznie u dostawcy hostingu, w katalogu na serwerze albo na laptopie jednej osoby. Trzecia to kopie bez historii, czyli jeden plik nadpisywany co noc. Czwarta to kopie, do których nie ma dostępu, bo hasło znał były pracownik, a klucz szyfrujący nie został nigdzie zapisany. Piąta to kopie nigdy niesprawdzone, w których dopiero awaria ujawnia, że eksport bazy od miesięcy kończył się błędem. Szósta to środowisko testowe pozostawione bez opieki: nieaktualizowane, z prawdziwymi danymi klientów, bez hasła i bez reguły noindex.
Większość opisanych tu czynności właściciel małej strony wykona samodzielnie albo z pomocą osoby, która na co dzień opiekuje się witryną. Pomoc specjalisty jest uzasadniona, gdy baza sklepu jest zbyt duża na eksport przez przeglądarkę, gdy strona działa jako sieć wielu witryn, gdy trzeba ją odtworzyć po włamaniu i ustalić, która wersja była jeszcze czysta, a także gdy firma zmienia dostawcę hostingu. W tym ostatnim przypadku plan kopii warto ustalić jako część migracji domeny i hostingu, ponieważ przeniesienie strony to w istocie to samo ćwiczenie co odtworzenie jej z kopii.
Najmniej kłopotów sprawiają kopie zaplanowane już przy budowie serwisu. Podczas tworzenia stron ustalamy z klientem, kto odpowiada za kopie, gdzie trafiają i jak wygląda odtworzenie, a przy sklepach internetowych dodatkowo, jak często zapisywana jest baza zamówień.
Jeśli chcą Państwo zamówić stronę internetową, zachęcamy do kontaktu: tel. 222 500 844 lub mailowo: biuro@pozycjonowaniestron.pl
Najczęstsze pytania
Czy kopia wykonywana przez hosting wystarczy małej firmie?
Jako jedyne zabezpieczenie - nie. Taka kopia leży u tego samego dostawcy i pod tym samym kontem co strona. Warto mieć przynajmniej jeden własny egzemplarz poza serwerem.
Jak często robić kopię strony, na której prawie nic się nie zmienia?
Dokumentacja WordPressa podaje dla mniejszych stron rytm tygodniowy. Niezależnie od tego kopię należy wykonać przed każdą aktualizacją systemu, motywu i wtyczek.
Ile kopii wstecz warto trzymać?
Dokumentacja WordPressa mówi o co najmniej 3-5 ostatnich kopiach, a zalecenia CISA o możliwości cofnięcia danych o co najmniej siedem dni. W praktyce dobrze sprawdza się połączenie wersji dziennych, tygodniowych i miesięcznych.
Czy wystarczy skopiować pliki strony przez FTP?
Nie. Pliki nie zawierają bazy danych, w której zapisane są treści, ustawienia, konta i zamówienia. Do pełnego odtworzenia potrzebne są pliki oraz eksport bazy wykonany w zbliżonym czasie.
Czy próbne odtworzenie może zaszkodzić działającej stronie?
Nie, pod warunkiem że odbywa się w osobnym katalogu lub na innym koncie i z osobną, pustą bazą danych. Zagrożeniem jest import do bazy strony działającej, który nadpisuje jej zawartość.
Czy kopie zapasowe podlegają przepisom o danych osobowych?
Kopia bazy zawiera te same dane co strona, a więc także zgłoszenia z formularzy i dane klientów. RODO wymienia wśród środków bezpieczeństwa szyfrowanie oraz zdolność do szybkiego przywrócenia dostępności danych. Szczegółowe obowiązki warto omówić z prawnikiem.
Źródła
- Backups - Advanced Administration Handbook, WordPress.org
- Backing Up Your Database - Advanced Administration Handbook, WordPress.org
- Backing Up Your WordPress Files - Advanced Administration Handbook, WordPress.org
- Migrating WordPress - Advanced Administration Handbook, WordPress.org
- wp db export - WP-CLI Command, WordPress.org
- Settings Reading screen, WordPress.org
- Back Up Business Data, CISA
- A Guide for Managed Service Providers to Conduct, Maintain and Test Backup Files, NIST
- Small organisations guide to cyber security: Backing up your data, National Cyber Security Centre
- Art. 32 GDPR - Security of processing, tekst RODO w serwisie gdpr-info.eu
- Jak kody stanu HTTP wpływają na roboty Google, Google
- Tymczasowe wstrzymywanie i wyłączanie witryny, Centrum wyszukiwarki Google
- Blokowanie indeksowania przez wyszukiwarki za pomocą tagu noindex, Centrum wyszukiwarki Google
Funkcje wyszukiwarek i asystentów AI zmieniają się szybko, dlatego wpis aktualizujemy po większych zmianach.