Plik llms.txt to propozycja prostego pliku tekstowego, który ma podpowiadać asystentom AI, gdzie na stronie znajdują się najważniejsze informacje. Nie jest standardem, wyszukiwarka Google go ignoruje, a mimo to w części serwisów jego przygotowanie ma sens. Poniżej wyjaśniamy, jak plik wygląda, kto faktycznie po niego sięga i jak ocenić, czy Państwa firma go potrzebuje.
Czym jest plik llms.txt
Plik llms.txt to krótki dokument tekstowy, który w uporządkowany sposób przedstawia serwis programom opartym na dużych modelach językowych: mówi, czyja to strona, czym się zajmuje i pod jakimi adresami leżą materiały warte przeczytania. Pomysł zgłosił Jeremy Howard, a jego opis jest dostępny w specyfikacji propozycji llms.txt. Skrót LLM pochodzi od angielskiego określenia dużego modelu językowego, czyli technologii, na której działają ChatGPT, Gemini, Claude czy Copilot.
Autor uzasadnia propozycję w prosty sposób. Strony internetowe powstają dla ludzi, dlatego właściwa treść jest w nich otoczona nawigacją, reklamami i skryptami. Program, który ma na podstawie takiej strony odpowiedzieć użytkownikowi na pytanie, musi najpierw wyłuskać z kodu czysty tekst, co bywa trudne i nieprecyzyjne. Do tego model może jednorazowo przetworzyć ograniczoną ilość tekstu, więc cały serwis zwykle się w tym limicie nie mieści. Zwięzły spis treści z krótkimi opisami ma ten kłopot zmniejszyć: asystent czyta jeden mały plik, wybiera z niego to, czego potrzebuje, i dopiero wtedy pobiera wskazane strony.
Prosty sposób zapisu tekstu, w którym nagłówki, listy i odnośniki oznacza się zwykłymi znakami z klawiatury, na przykład krzyżykiem przed tytułem. Taki plik da się przeczytać w zwykłym notatniku i jednocześnie łatwo przetworzyć programem.
Propozycja ma dziś drugą wersję. W opisie zmian autor przyznaje, że pierwsza powstawała wtedy, gdy czytanie stron przez modele językowe było jeszcze przewidywaniem, a nowa uwzględnia doświadczenia z dwóch lat stosowania. Według specyfikacji plik publikują tysiące serwisów, część platform do tworzenia dokumentacji generuje go automatycznie, a najczęściej korzystają z niego agenci programistyczni, czyli asystenci pomagający pisać kod, którzy szukają w ten sposób opisów bibliotek i instrukcji.
Propozycja, a nie standard
Słowo „standard” pojawia się przy llms.txt często, ale na wyrost. Specyfikacja sama nazywa siebie propozycją, a dokumentacja narzędzia Lighthouse w przeglądarce Chrome określa plik jako powstającą konwencję i zaznacza, że jego udostępnianie jest obecnie opcjonalne. W praktyce oznacza to, że nikt nie ma obowiązku pliku publikować ani czytać, a zasady jego budowy mogą się jeszcze zmieniać, tak jak zmieniły się między pierwszą a drugą wersją. Warto więc traktować plik jako rozwiązanie pomocnicze, a nie fundament widoczności w odpowiedziach AI. Z czego ta widoczność naprawdę wynika, opisujemy we wpisie o tym, jak trafić do odpowiedzi asystentów AI.
Jak wygląda składnia pliku llms.txt
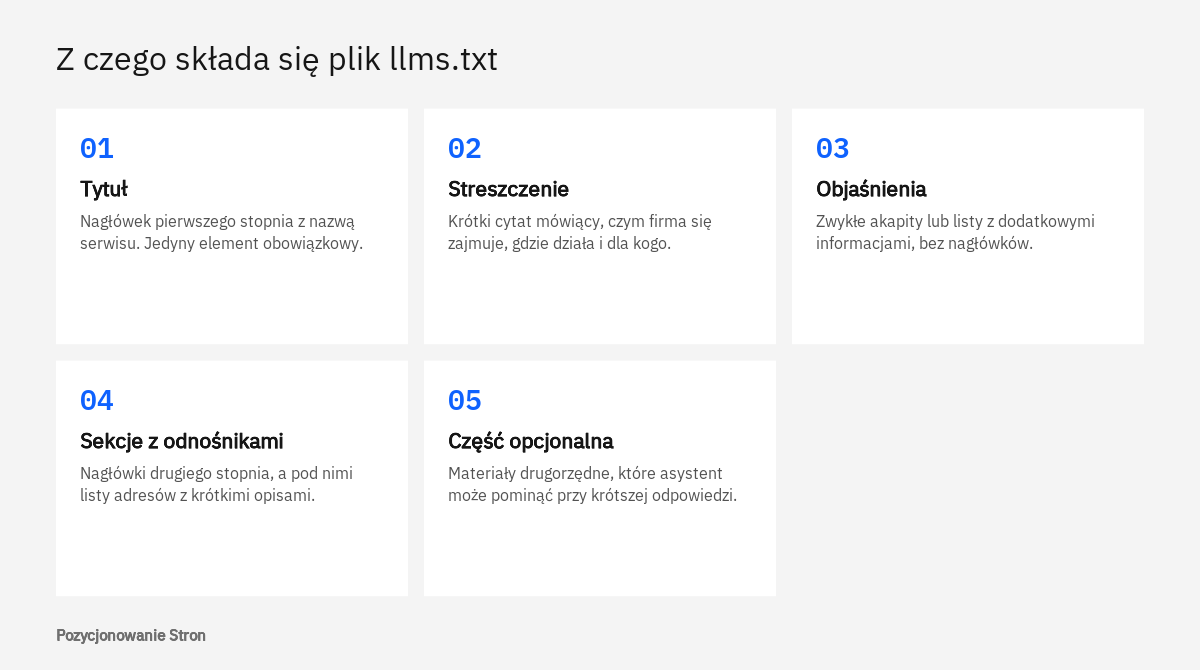
Plik llms.txt składa się z kilku elementów ułożonych w ściśle określonej kolejności: tytułu, krótkiego streszczenia, opcjonalnych objaśnień i list odnośników pogrupowanych pod nagłówkami. Obowiązkowy jest tylko pierwszy z nich, czyli nagłówek pierwszego stopnia z nazwą serwisu lub projektu. Całość zapisuje się w formacie Markdown, a plik nosi nazwę llms.txt i leży w katalogu głównym witryny albo w dowolnym podkatalogu.
Po tytule specyfikacja przewiduje krótkie streszczenie zapisane jako cytat, czyli wiersz zaczynający się od znaku większości. Powinno ono zawierać informacje niezbędne do zrozumienia reszty pliku. Dalej mogą się znaleźć zwykłe akapity lub listy z dodatkowymi wyjaśnieniami, byle bez kolejnych nagłówków. Na końcu umieszcza się sekcje otwierane nagłówkami drugiego stopnia. Każda z nich zawiera listę, w której pojedyncza pozycja to odnośnik z nazwą i adresem, a po dwukropku można dopisać krótką uwagę o tym, co pod tym adresem się znajduje.
# Gabinet fizjoterapii w Bydgoszczy

> Gabinet prowadzi rehabilitację po urazach i operacjach ortopedycznych oraz terapię bólu kręgosłupa u dorosłych. Przyjmuje od poniedziałku do piątku, zapisy telefoniczne i przez formularz na stronie.

Ceny podane na stronie cennika są cenami brutto. Gabinet nie ma umowy z publicznym ubezpieczycielem.

## Oferta

- [Rehabilitacja po operacji kolana](https://example.pl/rehabilitacja-kolana/): przebieg terapii, czas trwania, przeciwwskazania
- [Terapia bólu kręgosłupa](https://example.pl/bol-kregoslupa/): dla kogo, jak wygląda pierwsza wizyta

## Informacje praktyczne

- [Cennik](https://example.pl/cennik/): aktualne ceny wizyt i pakietów
- [Kontakt i dojazd](https://example.pl/kontakt/): adres, godziny otwarcia, parking

## Optional

- [Blog](https://example.pl/blog/): teksty o ćwiczeniach i profilaktyce
Ostatnia sekcja przykładu nosi angielską nazwę Optional, czyli „opcjonalne”. Zgodnie ze zwyczajem opisanym w specyfikacji trafiają tam materiały drugorzędne, które asystent może pominąć, gdy potrzebuje krótszego zestawu informacji.
Wersje Markdown podstron i wskazywanie pliku
Propozycja nie kończy się na samym spisie. Jej druga część zakłada, że strony z informacjami przydatnymi agentom mają także czystą wersję w formacie Markdown, dostępną pod tym samym adresem z dopisanym rozszerzeniem .md albo z rozszerzeniem zamienionym na .md. Odnośniki w pliku llms.txt powinny prowadzić właśnie do takich wersji, bo to one są wygodne dla modelu. Typowa strona firmowa na WordPressie zwykle takich wersji nie ma i plik kieruje wtedy po prostu do zwykłych podstron. Warto mieć świadomość, że realizuje się w ten sposób tylko połowę pomysłu.
Druga wersja specyfikacji dodaje też sposób na to, by program nie musiał zgadywać, gdzie plik leży. Służą do tego znane z HTML relacje odnośników: relacja alternate z typem text/markdown wskazuje wersję Markdown danej strony, a relacja describedby wskazuje plik llms.txt, który tę stronę obejmuje. Można je podać w nagłówku strony jako element link albo w nagłówku odpowiedzi serwera, bez zmian w samych podstronach.
Jeżeli plik leży w podkatalogu, na przykład w katalogu z dokumentacją, obejmuje strony znajdujące się pod tą ścieżką. Specyfikacja zaleca przy tym zwięzły i jednoznaczny język, krótkie opisy przy odnośnikach i unikanie niewyjaśnionego żargonu.
Czym llms.txt różni się od robots.txt i mapy witryny
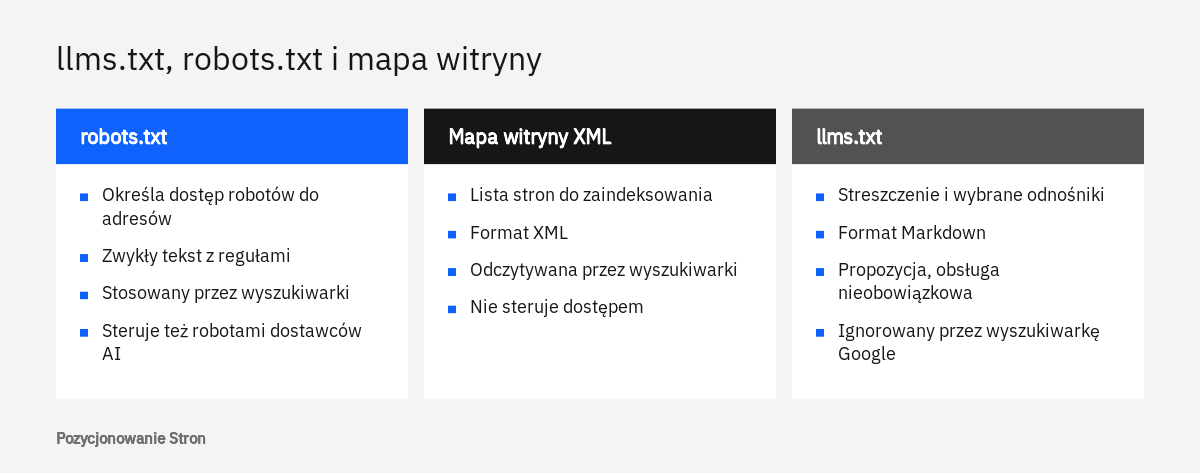
Te trzy pliki łączy tylko to, że leżą pod stałymi adresami w domenie. Plik robots.txt mówi robotom, do których adresów mogą sięgać, mapa witryny podaje wyszukiwarkom listę stron przeznaczonych do zaindeksowania, a llms.txt jest skróconym, opisowym spisem treści dla programów, które odpowiadają na pytania użytkowników. Żaden z nich nie zastępuje pozostałych.
Najczęstsze nieporozumienie dotyczy sterowania dostępem. Plik llms.txt nie zawiera żadnych poleceń zezwalania ani zakazywania i nie da się nim nikogo zablokować. Specyfikacja opisuje tę różnicę wprost: robots.txt informuje automaty, jaki dostęp do witryny jest akceptowany, natomiast informacje z llms.txt mają być używane na żądanie, w chwili gdy agent pomaga użytkownikowi i potrzebuje wiedzy na dany temat. Autor zakładał, że plik przyda się głównie przy udzielaniu odpowiedzi, a nie przy trenowaniu modeli.
Z kolei dokumentacja Google o pliku robots.txt przypomina, że służy on głównie do zarządzania ruchem robotów, tak aby serwer nie był przeciążony żądaniami, i nie jest mechanizmem ukrywania stron przed wyszukiwarką. Do wykluczania stron z wyników służy dyrektywa noindex, którą omawiamy we wpisie o znaczniku meta robots.
| Cecha | robots.txt | Mapa witryny XML | llms.txt |
|---|---|---|---|
| Do czego służy | Określa, do których adresów roboty mogą sięgać | Podaje wyszukiwarkom listę ważnych stron i plików | Streszcza serwis i wskazuje wybrane treści |
| Dla kogo | Roboty wyszukiwarek i roboty dostawców AI | Wyszukiwarki | Asystenci i agenci AI, w praktyce głównie programistyczni |
| Format | Zwykły tekst z regułami | XML | Markdown |
| Zakres | Adresy, do których roboty mają lub nie mają dostępu | W zamyśle wszystkie strony do zaindeksowania | Ręcznie dobrany wycinek, także adresy spoza domeny |
| Czy steruje dostępem | Tak | Nie | Nie |
| Status | Powszechnie obsługiwany | Powszechnie obsługiwany | Propozycja, obsługa nieobowiązkowa |
| Wyszukiwarka Google | Stosuje | Stosuje | Ignoruje |
Różnica wobec mapy witryny jest subtelniejsza. Google opisuje mapę jako plik z informacjami o stronach, filmach i innych plikach w witrynie, który pomaga skuteczniej ją indeksować. Autor llms.txt zwraca uwagę, że taka mapa nie nadaje się na podpowiedź dla modelu z trzech powodów: zwykle nie zawiera wersji stron wygodnych dla programów, nie obejmuje adresów zewnętrznych, które mogłyby pomóc w zrozumieniu tematu, a wszystkie wymienione w niej dokumenty razem są za duże, by model przeczytał je za jednym razem. Mapa jest więc pełnym spisem, a llms.txt świadomym wyborem. Jak przygotować samą mapę, opisujemy we wpisie o mapie witryny XML.
Co o obsłudze llms.txt mówi Google
Stanowisko Google jest jednoznaczne: wyszukiwarka nie korzysta z plików llms.txt i ich obecność nie ma wpływu na widoczność strony. W wytycznych dotyczących funkcji generatywnej AI w wyszukiwarce plik został wymieniony na liście rzeczy, których robić nie trzeba. Google wyjaśnia tam, że aby pojawiać się w wyszukiwarce, także w jej funkcjach opartych na AI, nie trzeba tworzyć nowych plików czytelnych dla maszyn, plików tekstowych dla AI, specjalnych znaczników ani wersji Markdown.
W tym samym miejscu znajdują się dwa ważne zastrzeżenia. Po pierwsze Google może wykrywać i indeksować różne rodzaje plików, nie tylko HTML, ale nie oznacza to, że dany plik jest traktowany w szczególny sposób. Po drugie firma nie odradza samego pliku: jeśli właściciel strony chce go utrzymywać na potrzeby innych usług, może to robić, a wyszukiwarce ani to nie zaszkodzi, ani nie pomoże. Podobne zdanie pada na stronie o funkcjach AI w wyszukiwarce: aby strona mogła zostać pokazana jako źródło w Przeglądzie od AI lub w Trybie AI, musi być zaindeksowana i spełniać zwykłe wymagania techniczne wyszukiwarki, a dodatkowych wymagań nie ma.
Wniosek dla firmy jest prosty. Jeśli celem jest obecność w odpowiedziach generowanych przez Google, plik llms.txt nie jest do tego narzędziem. Liczą się te same podstawy co w klasycznym pozycjonowaniu. Mechanizm doboru źródeł opisujemy osobno we wpisie o tym, jak działa Przegląd od AI.
Dlaczego plik pojawia się w raporcie Lighthouse
Pewne zamieszanie wprowadza to, że plik llms.txt ma własny test w Lighthouse, czyli narzędziu do audytu stron wbudowanym w przeglądarkę Chrome. Test należy do grupy audytów przeglądania agentowego, a więc dotyczy przygotowania strony na wizyty agentów AI, nie zaś pozycji w wyszukiwarce. Nie ma tu sprzeczności: wytyczne wyszukiwarki opisują, czego używa ona sama, a dokumentacja Lighthouse to, co może ułatwić pracę programom poruszającym się po stronie w imieniu użytkownika.
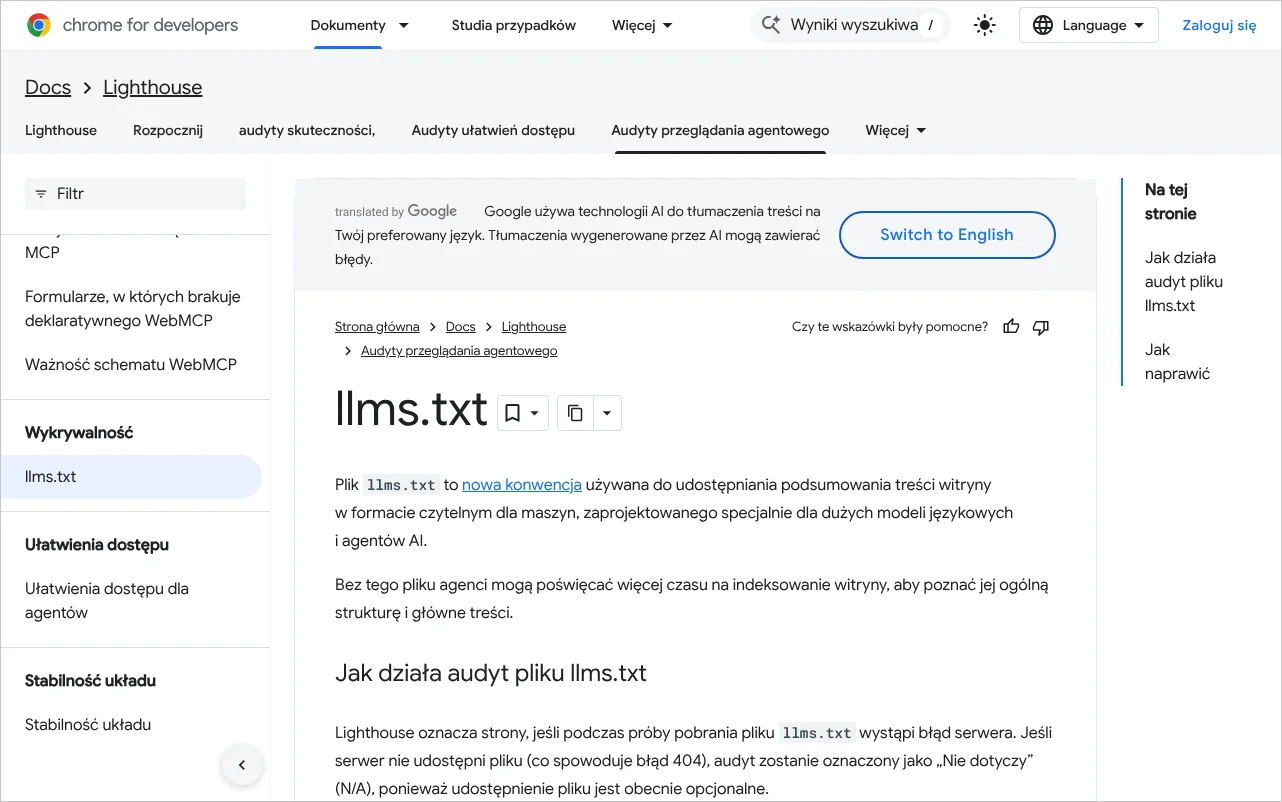
Warto dokładnie przeczytać, co ten audyt sprawdza. Zgodnie z dokumentacją audytu llms.txt Lighthouse zgłasza problem wtedy, gdy przy próbie pobrania pliku serwer zwraca błąd. Jeżeli pliku po prostu nie ma i serwer odpowiada kodem 404, audyt otrzymuje oznaczenie „Nie dotyczy”, ponieważ udostępnianie pliku jest opcjonalne. Brak llms.txt nie jest więc zgłaszany jako błąd. Dokumentacja dodaje, że bez takiego pliku agenci mogą poświęcać więcej czasu na poznanie struktury witryny, i zaleca, by plik był zwięzłym podsumowaniem celu serwisu z najważniejszymi odnośnikami.
Co o llms.txt mówią dostawcy asystentów AI
Dostawcy asystentów publikują opisy swoich robotów i zasady sterowania nimi, ale w dokumentach, które przeanalizowaliśmy, nie ma zobowiązania do czytania plików llms.txt. Zarówno OpenAI, jak i Anthropic opisują tam sterowanie dostępem przez robots.txt, a o llms.txt nie wspominają. Jedyne, co da się uczciwie powiedzieć o ich stosunku do propozycji, to fakt odnotowany w specyfikacji: firmy te, podobnie jak Google w przypadku Gemini, publikują pliki llms.txt dla własnej dokumentacji przeznaczonej dla programistów. Potwierdza to przydatność formatu w dokumentacji technicznej, ale nie oznacza, że asystenci sięgają po cudze pliki przy udzielaniu odpowiedzi ani że plik wpływa na to, czy polecą daną firmę.
Jakie roboty odwiedzają strony
Zanim plik w ogóle zostanie rozważony, roboty odpowiedzialne za wyszukiwanie muszą mieć dostęp do serwisu, a po ich nazwach rozpoznaje się wizyty w logach. OpenAI opisuje między innymi trzy programy. OAI-SearchBot służy do wyszukiwania i od niego zależy, czy strona może pojawiać się w wynikach wyszukiwania ChatGPT. GPTBot zbiera treści, które mogą posłużyć do trenowania modeli. ChatGPT-User pojawia się wtedy, gdy użytkownik zada pytanie, a asystent w jego imieniu odwiedza konkretną stronę. Ustawienia poszczególnych robotów są od siebie niezależne, więc można dopuścić robota wyszukiwania i jednocześnie nie zgodzić się na wykorzystanie treści do trenowania.
Anthropic wymienia analogiczną trójkę: ClaudeBot zbiera treści, które mogą trafić do trenowania modeli, Claude-SearchBot przegląda sieć na potrzeby wyników wyszukiwania, a Claude-User pobiera strony na polecenie użytkownika. Firma zaznacza, że wyłączenie dwóch ostatnich może ograniczyć widoczność serwisu w odpowiedziach. Szerzej o tym, jak te mechanizmy wyglądają w przypadku ChatGPT, piszemy we wpisie o tym, jak wyszukuje ChatGPT Search.
| Nazwa w logach | Dostawca | Zadanie według dokumentacji |
|---|---|---|
| OAI-SearchBot | OpenAI | Wyszukiwanie w ChatGPT |
| GPTBot | OpenAI | Zbieranie treści do trenowania modeli |
| ChatGPT-User | OpenAI | Wizyta na stronie w imieniu użytkownika |
| Claude-SearchBot | Anthropic | Przeglądanie sieci na potrzeby wyszukiwania |
| ClaudeBot | Anthropic | Zbieranie treści do trenowania modeli |
| Claude-User | Anthropic | Wizyta na stronie w imieniu użytkownika |
Jeśli chcą Państwo zamówić pozycjonowanie AI, zachęcamy do kontaktu: tel. 222 500 844 lub mailowo: biuro@pozycjonowaniestron.pl
Jak sprawdzić w logach, czy ktokolwiek pobiera plik
Jedynym wiarygodnym sposobem jest przejrzenie dziennika dostępu serwera, czyli pliku, w którym serwer zapisuje każde żądanie: adres IP, godzinę, żądany adres, kod odpowiedzi i nazwę programu, który o stronę poprosił. Wystarczy odfiltrować z niego wiersze zawierające ścieżkę /llms.txt i sprawdzić, kto oraz jak często po nią sięga. Narzędzia analityczne oparte na skrypcie w przeglądarce, takie jak Google Analytics, z naszego doświadczenia tych wizyt nie pokazują, ponieważ program pobierający plik tekstowy takiego skryptu nie uruchamia.
Dziennik dostępu udostępnia większość firm hostingowych. Zwykle znajduje się w panelu zarządzania kontem, w części poświęconej logom lub statystykom, albo w katalogu z logami dostępnym przez FTP lub SSH. Nazwy pozycji w menu różnią się u poszczególnych dostawców, dlatego w razie wątpliwości najprościej poprosić o wskazanie tego miejsca pomoc techniczną hostingu.
- Opublikowanie pliku i odczekanie
Bez pliku pod adresem /llms.txt w logach będą widoczne najwyżej próby zakończone kodem 404. One też są informacją, bo pokazują, czy ktokolwiek o plik pyta, ale pełny pomiar wymaga kilku tygodni od publikacji.
- Pobranie dziennika dostępu
Potrzebny jest plik z całego badanego okresu. Hosting często przechowuje logi tylko przez ograniczony czas, więc warto zapisywać je regularnie.
- Odfiltrowanie żądań o plik
Z dziennika wybiera się wiersze zawierające ścieżkę /llms.txt, a następnie grupuje je według nazwy programu.
- Rozpoznanie, kto pytał
Nazwy robotów porównuje się z dokumentacją dostawców. Pozostałe wpisy to najczęściej narzędzia do audytu, skanery i zwykłe przeglądarki.
- Porównanie z ruchem na pozostałych stronach
Na koniec sprawdza się, czy te same roboty odwiedzają zwykłe podstrony i w jakiej skali. Dopiero to zestawienie pokazuje, czy plik ma jakiekolwiek znaczenie.
grep "/llms.txt" access.log

192.0.2.10 - - [data i godzina] "GET /llms.txt HTTP/1.1" 200 1432 "-" "Mozilla/5.0 AppleWebKit/537.36 (KHTML, like Gecko); compatible; ChatGPT-User/1.0; +https://openai.com/bot"

grep "/llms.txt" access.log | grep -c "ChatGPT-User"
Co oznaczają wyniki
Kod 200 w wierszu oznacza, że plik został wydany, a kod 404, że program o niego zapytał, lecz go nie znalazł. Kody z grupy 500 świadczą o błędzie serwera i to właśnie taką sytuację zgłasza audyt Lighthouse.
Ważniejsze od liczby wierszy jest to, kto za nimi stoi. Wizyta programu działającego w imieniu użytkownika, takiego jak ChatGPT-User czy Claude-User, oznacza, że plik został pobrany w związku z czyjąś rozmową z asystentem. Wizyta robota zbierającego treści mówi tylko tyle, że plik został znaleziony jak każdy inny adres. Pojedyncze żądania z programów o nieznanych nazwach to z naszych obserwacji zazwyczaj skanery i narzędzia sprawdzające, czy plik istnieje. Brak jakichkolwiek wpisów po kilku tygodniach jest równie wartościowym wynikiem: plik nikomu nie jest potrzebny i jego rozbudowa nie ma uzasadnienia.
Wyniki z logów najlepiej zestawić z szerszym obrazem widoczności, o którym piszemy we wpisie o tym, jak mierzyć widoczność marki w odpowiedziach AI.
Kiedy wdrożenie llms.txt ma sens mimo braku standardu
Wdrożenie ma sens wtedy, gdy z treści serwisu korzystają agenci, a nie tylko ludzie i wyszukiwarki, oraz gdy plik da się utrzymać w zgodzie ze stroną bez dodatkowej pracy. Najmocniejszym argumentem jest dokumentacja techniczna: specyfikacja podaje, że właśnie tam pliki są używane najczęściej, bo agenci programistyczni szukają przez nie opisów interfejsów i instrukcji. Producent oprogramowania, firma udostępniająca interfejs API albo sklep z rozbudowaną bazą instrukcji mają więc realny powód, by plik przygotować.
W przypadku typowej strony usługowej bilans jest inny. Hydraulik z Łodzi czy kancelaria z Krakowa mają kilkanaście podstron, a o tym, czy zostaną polecone, decydują w naszej ocenie czynniki niezwiązane z plikiem: dostęp robotów, jakość i aktualność treści, spójność danych firmy w sieci i wzmianki w innych serwisach. Plik nie zaszkodzi, ale też nie należy oczekiwać po nim efektu.
Rozsądnym kompromisem jest potraktowanie pliku jako niedrogiego eksperymentu z pomiarem. Przygotowanie krótkiego spisu zajmuje niewiele czasu, a logi po kilku tygodniach pokażą, czy ktokolwiek z niego korzysta. Sklep internetowy z Poznania, który ma setki kategorii i rozbudowany dział pomocy, może w ten sposób sprawdzić, czy agenci sięgają po taki spis, zanim zainwestuje w wersje Markdown podstron.
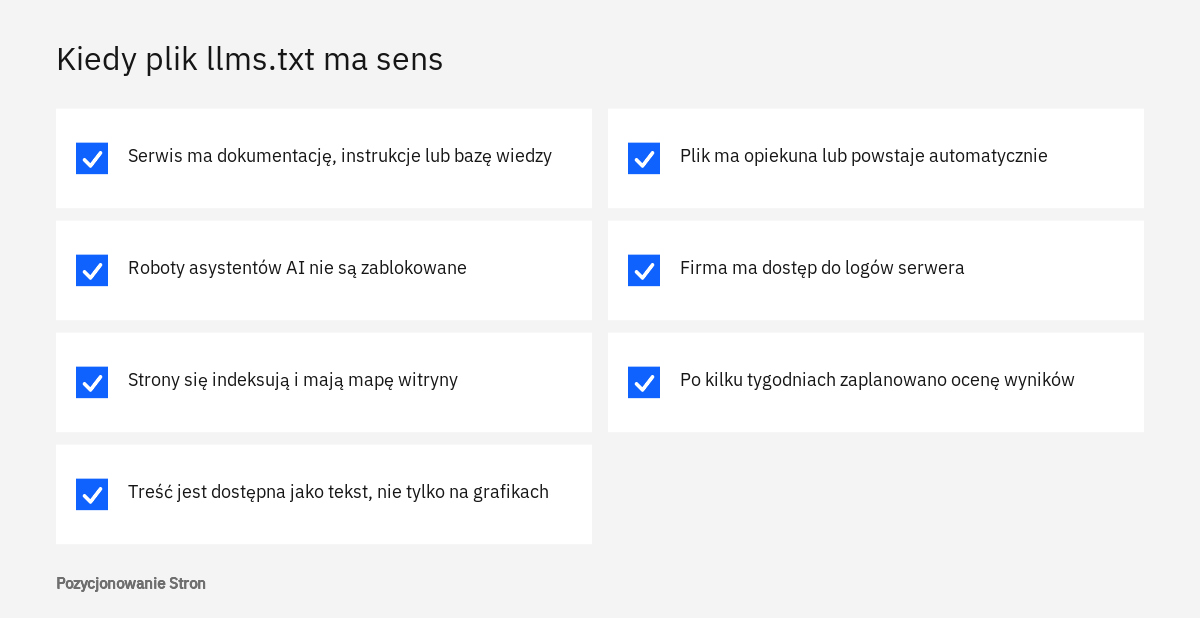
- Serwis zawiera dokumentację, instrukcje lub bazę wiedzy, z których korzystają programiści albo agenci AI.
- Roboty dostawców asystentów nie są zablokowane w robots.txt ani przez zabezpieczenia serwera.
- Podstawy są uporządkowane: strony się indeksują, mają poprawną mapę witryny i treść dostępną w formie tekstu.
- Plik może powstawać automatycznie lub ma wyznaczoną osobę, która aktualizuje go przy każdej zmianie oferty.
- Firma ma dostęp do logów serwera i zamierza po kilku tygodniach ocenić, czy plik jest pobierany.
- Nikt w firmie nie oczekuje, że sam plik poprawi pozycje w Google lub liczbę poleceń w asystentach.
Jeżeli większość tych warunków nie jest spełniona, czas lepiej przeznaczyć na SEO techniczne i treści, bo od nich zależy zarówno klasyczna widoczność, jak i obecność w odpowiedziach generowanych przez AI.
Jak przygotować plik i jakich pomyłek unikać
Dobry plik llms.txt jest krótki, napisany ręcznie lub starannie przejrzany i prowadzi wyłącznie do stron, które są aktualne i publicznie dostępne. Pracę warto zacząć od odpowiedzi na pytanie, o co klienci pytają najczęściej, i dobrać kilka do kilkunastu adresów, które na te pytania odpowiadają: ofertę, cennik, warunki współpracy, kontakt, najważniejsze instrukcje. Streszczenie na początku powinno jednym lub dwoma zdaniami mówić, czym firma się zajmuje, gdzie działa i dla kogo.
Gotowy plik zapisuje się jako zwykły tekst i umieszcza w katalogu głównym domeny, tak aby otwierał się pod adresem kończącym się na /llms.txt i zwracał kod 200. W WordPressie plik można wgrać na serwer ręcznie albo wygenerować wtyczką. Specyfikacja odnotowuje, że część wtyczek SEO i gotowych kreatorów stron tworzy go automatycznie. Przy automacie należy koniecznie przejrzeć wynik, bo z naszych obserwacji generator często wypisuje wszystkie wpisy i podstrony, czyli powiela mapę witryny zamiast dokonać wyboru.
Po publikacji warto wykonać test zalecany przez autora propozycji: przekazać asystentowi sam plik jako punkt wyjścia i zadać kilka pytań, jakie zadałby klient. Jeżeli odpowiedzi są błędne lub niepełne, zwykle zawodzi streszczenie albo opisy przy odnośnikach. Błędne informacje o firmie w odpowiedziach AI mają zresztą najczęściej inne źródła niż brak pliku, co opisujemy we wpisie o błędnych informacjach o firmie w AI.
Typowe pomyłki
Pierwszą pomyłką jest traktowanie pliku jak narzędzia do blokowania. Wpisanie do niego prośby, by nie używać treści do trenowania modeli, nie ma żadnego umocowania w dokumentacji dostawców. Do tego służą reguły w robots.txt dla konkretnych robotów, a w przypadku systemów Google także mechanizm Google-Extended wskazany w dokumentacji wyszukiwarki.
Druga pomyłka to rozbieżność między plikiem a stroną. Plik przygotowany raz i zapomniany po roku prowadzi do nieistniejących podstron, podaje stare godziny otwarcia albo nieaktualny zakres usług. Asystent, który z niego skorzysta, może przekazać klientowi błędne dane. Sam plik ma streszczać stronę, a nie ją zastępować, dlatego nie powinien zawierać niczego, czego nie ma w serwisie.
Trzecia pomyłka dotyczy kolejności. Zdarza się, że firma wdraża llms.txt, a jednocześnie ma zablokowane roboty wyszukiwania asystentów, treść ładowaną wyłącznie skryptami albo kluczowe informacje zapisane na grafikach. W takiej sytuacji plik niczego nie naprawi. Najpierw warto zlecić audyt SEO, uporządkować dostęp i treści, a dopiero potem dodawać rozwiązania pomocnicze.
Gdy trzeba odczytać logi z kilku źródeł albo ustalić reguły dla wielu robotów, plik llms.txt staje się jednym z elementów szerszego planu, który opisujemy na stronie usługi pozycjonowanie AI.
Jeśli chcą Państwo zamówić pozycjonowanie AI, zachęcamy do kontaktu: tel. 222 500 844 lub mailowo: biuro@pozycjonowaniestron.pl
Najczęstsze pytania
Czy plik llms.txt poprawia pozycję strony w Google?
Nie. Google podaje w swojej dokumentacji, że wyszukiwarka nie używa takich plików, także w funkcjach opartych na generatywnej AI. Obecność pliku ani nie pomaga, ani nie szkodzi widoczności i pozycjom.
Czy brak pliku llms.txt jest błędem w audycie Lighthouse?
Nie. Jeśli pliku nie ma i serwer odpowiada kodem 404, audyt otrzymuje oznaczenie „Nie dotyczy”, bo udostępnianie pliku jest opcjonalne. Problem jest zgłaszany dopiero wtedy, gdy przy próbie pobrania pliku wystąpi błąd serwera.
Czy plikiem llms.txt można zakazać trenowania modeli na treściach strony?
Nie. Plik nie zawiera reguł dostępu i dostawcy asystentów nie opisują go jako sposobu wyrażania sprzeciwu. OpenAI i Anthropic wskazują do tego reguły w robots.txt dla odpowiednich robotów. Kwestie praw autorskich i licencji warto dodatkowo omówić z prawnikiem.
Gdzie dokładnie umieścić plik?
Najczęściej w katalogu głównym domeny, tak aby był dostępny pod adresem kończącym się na /llms.txt. Specyfikacja dopuszcza też umieszczenie pliku w podkatalogu, a wtedy obejmuje on strony znajdujące się pod tą ścieżką.
Jak długi powinien być plik?
Specyfikacja nie podaje limitu, ale zakłada, że plik ma być na tyle mały, by model przeczytał go w całości, a szczegóły znajdowały się pod odnośnikami. W praktyce dla strony firmowej wystarcza streszczenie i od kilku do kilkunastu starannie opisanych adresów.
Czy plik trzeba gdzieś zgłaszać?
Specyfikacja nie przewiduje żadnego zgłaszania. Programy, które z pliku korzystają, szukają go pod stałym adresem albo znajdują dzięki relacjom odnośników opisanym w specyfikacji. To, czy rzeczywiście go pobierają, pokazują wyłącznie logi serwera.
Źródła
- The /llms.txt file, v2, llmstxt.org (Jeremy Howard)
- Przewodnik Google po optymalizacji pod kątem funkcji generatywnej AI w wyszukiwarce Google, Centrum wyszukiwarki Google
- AI Features and Your Website, Google Search Central
- llms.txt | Lighthouse, Chrome for Developers
- Plik robots.txt - wprowadzenie i przewodnik, Centrum wyszukiwarki Google
- Co to jest mapa witryny, Centrum wyszukiwarki Google
- Overview of OpenAI Crawlers, OpenAI
- Does Anthropic crawl data from the web, and how can site owners block the crawler?, Anthropic
Funkcje wyszukiwarek i asystentów AI zmieniają się szybko, dlatego wpis aktualizujemy po większych zmianach.