Przy błędzie 500 Googlebot nie dostaje treści strony, tylko informację, że serwer nie poradził sobie z żądaniem. Najpierw zwalnia skanowanie, przez pewien czas zostawia adresy w indeksie, a przy awarii trwającej kilka dni zaczyna je usuwać. Poniżej opisujemy, jak ten proces przebiega, gdzie go zobaczyć w Search Console, jak znaleźć przyczynę w logach i co zrobić po naprawie.
Co widzi Googlebot, gdy strona zwraca błąd 500
Googlebot widzi wyłącznie kod odpowiedzi z grupy 5xx i na tej podstawie uznaje, że adresu nie udało się pobrać. Nie ocenia treści, nie czyta nagłówków ani tekstu, nie aktualizuje tytułu i opisu. Dokumentacja Google mówi wprost, że treści otrzymane z adresów zwracających kod 5xx są ignorowane.
Ogólna odpowiedź serwera oznaczająca, że podczas obsługi żądania wystąpił nieoczekiwany problem po stronie serwera lub aplikacji. Sam kod nie mówi, co się zepsuło - przyczyny trzeba szukać w logach.
Ma to praktyczne konsekwencje. Ładnie zaprojektowana strona błędu z przeprosinami i numerem telefonu jest potrzebna klientom, ale dla wyszukiwarki nie ma znaczenia. Liczy się tylko to, że w miejscu oferty, karty produktu czy wpisu robot nie otrzymał niczego, co mógłby zindeksować. Pomoc Search Console opisuje tę sytuację jako brak dostępu do adresu: serwer zwrócił błąd, czas oczekiwania minął albo witryna odrzuciła żądanie.
Warto też wiedzieć, że Google podobnie traktuje kilka pokrewnych zdarzeń. Kod 429, czyli sygnał zbyt wielu żądań, jest uznawany za błąd serwera i informację o przeciążeniu. Tak samo działają problemy, przy których serwer w ogóle nie zdąży odpowiedzieć: przekroczony czas oczekiwania, zerwane połączenie, błąd rozpoznawania nazwy domeny w systemie DNS. Z punktu widzenia robota efekt jest identyczny - nie ma treści, więc nie ma czego indeksować. Szersze omówienie wszystkich grup odpowiedzi znajduje się we wpisie o tym, jak Googlebot traktuje kody odpowiedzi HTTP; tutaj zajmujemy się wyłącznie awarią serwera.
Strona błędu, która udaje poprawną odpowiedź
Odwrotna sytuacja bywa gorsza od samego błędu. Zdarza się, że aplikacja wyświetla komunikat o awarii, na przykład o braku połączenia z bazą danych, ale serwer wysyła przy tym kod 200, czyli potwierdzenie poprawnej odpowiedzi. Robot nie dostaje wtedy sygnału, że coś jest nie tak, i może potraktować komunikat o awarii jako nową treść podstrony. Taki przypadek jest bliski temu, co opisujemy we wpisie o pozornym błędzie 404. Dlatego przy każdej awarii pierwszą rzeczą do ustalenia jest faktyczny kod odpowiedzi, a nie wygląd strony w przeglądarce.
curl -I https://www.example.com/oferta/

HTTP/2 500
content-type: text/html; charset=UTF-8
Polecenie curl z parametrem -I zwraca same nagłówki odpowiedzi. Tę metodę Google podaje w swojej dokumentacji jako sposób na upewnienie się, jaki kod naprawdę wysyła serwer.
Pierwsza reakcja Google: wolniejsze skanowanie
Zanim cokolwiek zmieni się w wynikach wyszukiwania, Google ogranicza liczbę wizyt robota. Według dokumentacji błędy 5xx i kod 429 informują roboty, że na jakiś czas należy zwolnić, a przy kodzie 500 spadek tempa jest proporcjonalny do liczby adresów, które zwracają błąd serwera. Jedna uszkodzona podstrona w serwisie liczącym kilkaset adresów niewiele zmieni; awaria obejmująca cały serwis wyhamuje skanowanie wyraźnie.
Mechanizm ten jest częścią tego, co Google nazywa limitem wydajności indeksowania. Gdy serwer odpowiada stabilnie i szybko, limit rośnie. Gdy czas odpowiedzi się wydłuża albo pojawiają się błędy 5xx, limit maleje i robot odwiedza witrynę rzadziej. Chodzi o to, żeby wyszukiwarka nie dobijała serwera, który i tak ma kłopoty. Szerzej opisujemy to we wpisie o budżecie indeksowania.
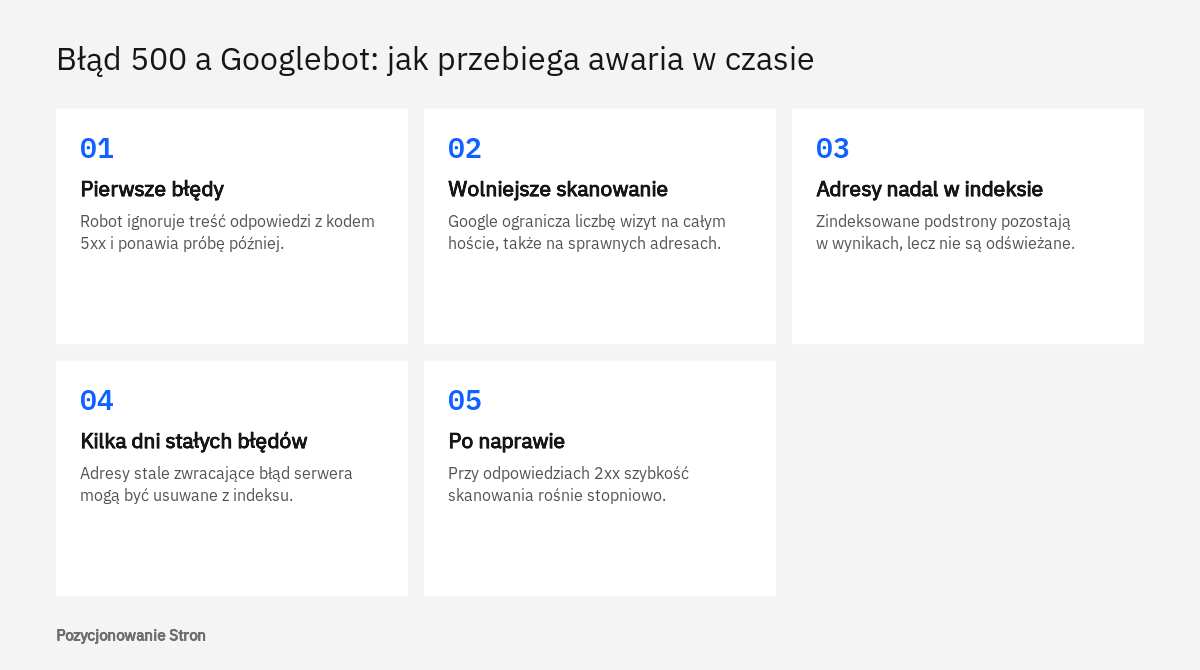
Ważny szczegół: ograniczenie dotyczy całej nazwy hosta, a nie tylko zepsutych adresów. Dokumentacja o zmniejszaniu szybkości indeksowania podaje, że spowolnienie obejmuje zarówno adresy zwracające błędy, jak i te, które działają poprawnie. W praktyce oznacza to, że awaria jednego modułu, na przykład wyszukiwarki wewnętrznej generującej tysiące błędnych adresów, może opóźnić odświeżanie zupełnie zdrowych podstron.
Skutki wolniejszego skanowania są mało widowiskowe, ale realne. Google wylicza je tak: robot wykrywa mniej nowych stron, istniejące odświeża rzadziej, więc zmiany cen i dostępności produktów pojawiają się w wyszukiwarce z opóźnieniem, a usunięte strony dłużej pozostają w indeksie. Dla sklepu internetowego z Poznania, który w trakcie awarii zmienił cennik, oznaczałoby to, że stare ceny mogą być widoczne w wynikach dłużej niż zwykle.
Po jakim czasie adresy znikają z indeksu
Google nie podaje jednej, sztywnej liczby dni. Dokumentacja opisuje to w dwóch zdaniach: adresy już zindeksowane zostają w indeksie, ale po pewnym czasie są z niego usuwane, a usuwane są te, które stale zwracają błąd serwera. Z pozostałych stron dokumentacji da się jednak złożyć dość wyraźny obraz skali czasu.
Po pierwsze, w materiale o zmniejszaniu szybkości indeksowania Google zaleca, by kody 500, 503 i 429 zwracać robotom najwyżej przez kilka godzin albo 1-2 dni, i ostrzega, że jeśli Googlebot przez kilka dni napotyka te kody pod tymi samymi adresami, może usunąć je z indeksu. Po drugie, w opisie błędów sieci i DNS czytamy, że zindeksowane adresy, które pozostają niedostępne, wypadają z indeksu w ciągu kilku dni. Po trzecie, w poradach o wyłączaniu witryny Google pisze, że całkowite wyłączenie powinno trwać najwyżej kilka dni, a pomoc Search Console radzi stosować kody 503 i 429 nie dłużej niż 2-3 dni.
| Czas trwania błędów | Co robi Google według dokumentacji | Co to oznacza dla firmy |
|---|---|---|
| Pojedyncze błędy, minuty | Ignoruje treść danej odpowiedzi, ponawia próbę później | Zwykle brak widocznych skutków |
| Kilka godzin do 1-2 dni | Zwalnia skanowanie hosta, adresy pozostają w indeksie | Opóźnione odświeżanie treści, strata ruchu od osób, które trafiły na błąd |
| Kilka dni stałych błędów | Może usuwać z indeksu adresy, które stale zwracają błąd | Realna utrata widoczności kolejnych podstron |
| Długa awaria całej witryny | Strony wypadają z indeksu, powrót jest trudniejszy i nie ma podanego terminu | Odbudowa widoczności po naprawie wymaga czasu |
Trzeba przy tym odróżnić dwie rzeczy, które właściciele stron często łączą w jedną. Spadek ruchu pojawia się natychmiast, bo każdy, kto kliknie wynik i zobaczy błąd, wychodzi. To strata sprzedażowa, a nie zmiana w wyszukiwarce. Zmiana w indeksie przychodzi później i zależy od tego, czy błąd jest stały. Kancelaria z Krakowa, której strona nie działała przez jedno popołudnie, straci zapytania z tego popołudnia, ale nie powinna oczekiwać trwałych skutków w wynikach. Hurtownia z Bydgoszczy, której serwis zwracał błędy przez tydzień, musi liczyć się z tym, że część podstron trzeba będzie odzyskać.
Nie każdy adres znika w tym samym momencie. Robot wraca do różnych podstron z różną częstotliwością, więc usuwanie przebiega stopniowo. Z praktyki agencji wynika, że najdłużej utrzymują się zwykle strona główna i najczęściej odwiedzane podstrony, ale to obserwacja, a nie reguła opisana przez Google.
Błąd 5xx na pliku robots.txt: osobny, groźniejszy przypadek
Jeśli błąd serwera dotyczy pliku robots.txt, Google wstrzymuje skanowanie całej witryny, nawet gdy pozostałe podstrony działają poprawnie. To jedyny element opisywanego procesu, dla którego dokumentacja podaje dokładne okresy.
Przez pierwsze 12 godzin od chwili, gdy pliku nie udaje się pobrać, Google wstrzymuje skanowanie witryny i ponawia próby pobrania. Przez kolejne 30 dni korzysta z ostatniej poprawnej wersji pliku zapisanej w pamięci podręcznej, a jeśli takiej wersji nie ma, zakłada brak ograniczeń. Po 30 dniach błędów wszystko zależy od ogólnej dostępności serwisu: jeśli witryna działa, roboty zachowują się tak, jakby pliku robots.txt nie było; jeśli ma problemy z dostępnością, skanowanie zostaje wstrzymane, a plik jest co jakiś czas sprawdzany ponownie.
Dla porównania, brak pliku, czyli odpowiedź 404, niczego nie blokuje - Google przyjmuje wtedy, że ograniczeń nie ma. Kłopot pojawia się wyłącznie wtedy, gdy plik istnieje, ale serwer nie potrafi go podać. Tak bywa na przykład po wdrożeniu zapory, która odrzuca żądania robotów, albo gdy plik jest generowany przez aplikację, a aplikacja właśnie uległa awarii. Z tego samego powodu Google odradza zwracanie kodu 503 dla pliku robots.txt podczas przerw technicznych. Jak poprawnie przygotować ten plik, opisujemy we wpisie o pisaniu robots.txt.
Gdzie w Search Console widać błędy 5xx
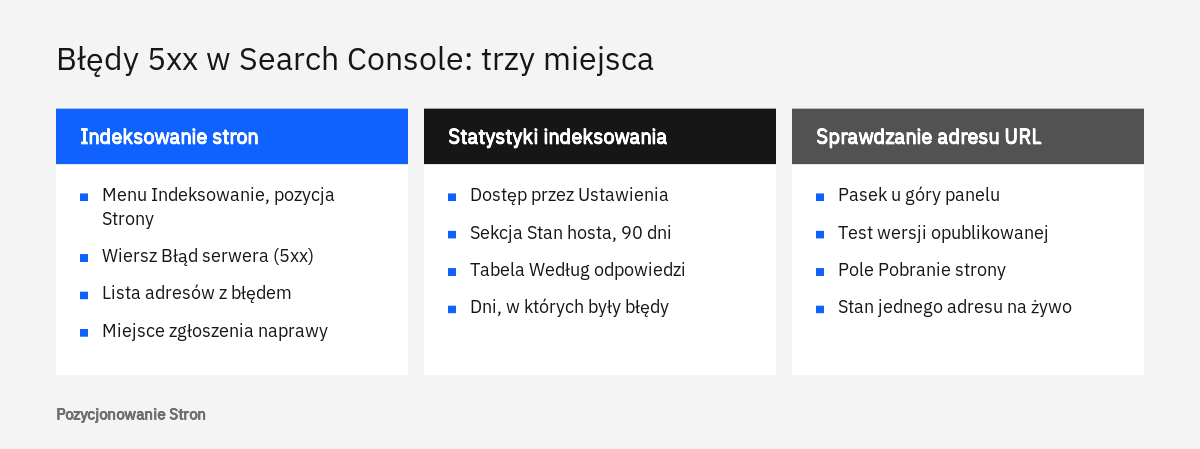
Błędy serwera pojawiają się w trzech miejscach Search Console: w raporcie Indeksowanie stron, w raporcie Statystyki indeksowania oraz w narzędziu do sprawdzania adresów URL. Każde z nich odpowiada na inne pytanie, dlatego warto przejrzeć wszystkie.
Raport Indeksowanie stron
W menu po lewej stronie, w części Indeksowanie, znajduje się pozycja Strony. Pod wykresem jest tabela zatytułowana Dlaczego strony nie są indeksowane, a w niej wiersz Błąd serwera (5xx). Kliknięcie wiersza otwiera listę przykładowych adresów oraz wykres pokazujący, od kiedy problem narasta. Ten raport mówi, których adresów błąd dotyczy i czy ich liczba rośnie. Pozostałe statusy z tej tabeli omawiamy we wpisie o tym, dlaczego Google nie indeksuje strony.
Raport Statystyki indeksowania
Drugi raport jest schowany głębiej: w menu należy otworzyć Ustawienia, a następnie w części dotyczącej indeksowania przejść do pozycji Statystyki indeksowania. Raport jest dostępny tylko dla usług najwyższego poziomu, czyli domeny lub prefiksu adresu. Pomoc Google zaznacza, że przy witrynach mających mniej niż 1000 stron zwykle nie jest potrzebny, ale przy diagnozowaniu awarii przydaje się niezależnie od wielkości serwisu.
Najważniejsza jest tu sekcja Stan hosta. Ocena obejmuje trzy kategorie: pobieranie pliku robots.txt, rozpoznawanie nazw DNS oraz połączenie z serwerem. Raport obejmuje ostatnie 90 dni i pokazuje jeden z trzech stanów: brak istotnych problemów, istotny problem sprzed ponad tygodnia albo problem z ostatnich siedmiu dni. Na wykresach każdej kategorii widać przerywaną czerwoną linię oznaczającą próg, po którego przekroczeniu Google sygnalizuje kłopot.
Niżej znajduje się tabela Według odpowiedzi z wierszem Błąd serwera (5XX). Podaje ona odsetek żądań, a nie adresów, które zakończyły się błędem, wraz z miniwykresem pokazującym, w które dni błędy wystąpiły. To najlepsze miejsce do ustalenia, kiedy dokładnie awaria się zaczęła i czy już minęła.
Narzędzie do sprawdzania adresów URL
Trzecim miejscem jest pasek wyszukiwania u góry panelu. Po wpisaniu adresu Search Console pokazuje dane z indeksu, a przycisk testu wersji opublikowanej uruchamia sprawdzenie strony na żywo. W wyniku testu, w sekcji Dostępność, znajduje się pole Pobranie strony z wartością informującą, czy pobranie się udało. Przy problemach z serwerem mogą się tam pojawić komunikaty: Brak połączenia z serwerem, Nieprawidłowa odpowiedź serwera albo Przekroczono limit obciążenia hosta. Sposób czytania całego wyniku opisujemy osobno we wpisie o sprawdzaniu adresu URL w Search Console.
Dane w Search Console pojawiają się z opóźnieniem, więc nie zastąpią bieżącego monitoringu dostępności. Pokazują jednak coś, czego nie pokaże żadne inne narzędzie: jak awarię widział sam robot Google.
Jeśli chcą Państwo zamówić SEO techniczne, zachęcamy do kontaktu: tel. 222 500 844 lub mailowo: biuro@pozycjonowaniestron.pl
Jak szukać przyczyny błędu 500 w logach serwera
Przyczynę błędu 500 pokazują dwa rodzaje logów: dziennik dostępu mówi, które żądania i kiedy zakończyły się błędem, a dziennik błędów mówi, dlaczego. Search Console wskaże adresy i daty, ale nigdy nie poda powodu, bo Google widzi tylko kod odpowiedzi.
Miejsce przechowywania logów zależy od firmy hostingowej. W panelach hostingowych zwykle znajduje się osobna pozycja o nazwie zbliżonej do Logi albo Dzienniki, często z podziałem na dziennik dostępu i dziennik błędów; na serwerach zarządzanych samodzielnie są to pliki w katalogu logów serwera WWW. Jeśli panel ich nie udostępnia, należy poprosić o nie pomoc techniczną hostingu, podając dokładną datę i godzinę wystąpienia błędu.
Dziennik dostępu: kto, kiedy i z jakim skutkiem
Każdy wiersz dziennika dostępu opisuje jedno żądanie: adres IP, datę i godzinę, żądany adres, kod odpowiedzi oraz nazwę programu, który wysłał żądanie. Wystarczy odfiltrować wiersze z kodem 500 i przyjrzeć się trzem rzeczom: których adresów dotyczą, o jakich porach występują i czy wśród odwiedzających jest Googlebot.
66.249.x.x - - [data i godzina] "GET /oferta/remonty-lazienek/ HTTP/1.1" 500 0 "-" "Mozilla/5.0 (compatible; Googlebot/2.1; +http://www.google.com/bot.html)"Układ błędów w czasie zwykle sam podpowiada kierunek poszukiwań. Błędy tylko na jednym typie podstron wskazują na szablon lub moduł. Błędy co noc o tej samej godzinie sugerują zadanie cykliczne, na przykład kopię zapasową albo import produktów, które zabiera serwerowi zasoby. Błędy rozrzucone po całym serwisie w godzinach największego ruchu oznaczają najczęściej przeciążenie. To obserwacje z naszej codziennej pracy, a nie sztywne reguły, ale w większości przypadków pozwalają szybko zawęzić pole.
Warto pamiętać, że nazwę robota w żądaniu może podać każdy program. Jeśli w logach widać nienaturalnie dużo wizyt podpisanych jako Googlebot, niekoniecznie jest to Google. Nie należy jednak z tego powodu pochopnie blokować adresów w zaporze: pomoc Search Console wymienia zbyt szerokie reguły zapory i ochrony przed atakami wśród typowych powodów, dla których prawdziwy Googlebot traci dostęp do witryny.
Dziennik błędów: co faktycznie się zepsuło
Dziennik błędów zawiera komunikaty serwera i języka, w którym napisana jest strona. Należy znaleźć w nim wpisy z tej samej minuty, w której dziennik dostępu zanotował kod 500. Typowy wpis nazywa plik i numer linii, w której wykonanie zostało przerwane, co zwykle od razu wskazuje winną wtyczkę, motyw albo własny fragment kodu.
PHP Fatal error: Allowed memory size of 268435456 bytes exhausted (tried to allocate 20480 bytes) in /wp-content/plugins/przykladowa-wtyczka/import.php on line 214W WordPressie dokumentacja wymienia kilka najczęstszych źródeł wewnętrznego błędu serwera: uszkodzony plik .htaccess, wadliwą wtyczkę, problem z motywem oraz zbyt niski limit pamięci PHP. Zaleca sprawdzanie ich po kolei: tymczasową zmianę nazwy pliku .htaccess i ponowne zapisanie ustawień bezpośrednich odnośników, wyłączenie wszystkich wtyczek, przełączenie na motyw domyślny, podniesienie limitu pamięci, a w ostateczności ponowne wgranie katalogów wp-admin i wp-includes z czystej instalacji. Na stronie produkcyjnej takie próby najlepiej wykonywać na kopii serwisu albo po zrobieniu aktualnej kopii zapasowej.
Gdy dziennik serwera niczego nie pokazuje, WordPress ma własny mechanizm zapisu błędów. Włącza się go w pliku wp-config.php, przed linią kończącą część przeznaczoną do edycji. Błędy trafiają wtedy do pliku debug.log w katalogu wp-content, a dzięki wyłączeniu wyświetlania nie pokazują się odwiedzającym.
define( 'WP_DEBUG', true );
define( 'WP_DEBUG_LOG', true );
define( 'WP_DEBUG_DISPLAY', false );
@ini_set( 'display_errors', 0 );Jeżeli logi wskazują na brak zasobów, a nie na błąd w kodzie, rozmowę trzeba przenieść do firmy hostingowej. O tym, jakie parametry serwera mają znaczenie dla dostępności, piszemy we wpisie o wpływie hostingu na SEO.
Planowana przerwa techniczna: kod 503 zamiast przypadkowego 500
Jeśli przerwa jest zaplanowana, serwer powinien zwracać kod 503 z informacją o przewidywanym czasie powrotu, a nie przypadkowy błąd 500. Google zaleca taką konfigurację przy pilnym wyłączeniu witryny na 1-2 dni i podaje kilka dobrych praktyk.
Do odpowiedzi warto dołączyć nagłówek Retry-After z najbardziej prawdopodobnym terminem lub okresem, po którym serwis wróci. Sama strona z komunikatem powinna być prostym, statycznym plikiem HTML ze stylami wpisanymi do środka, żeby nie obciążać serwera kolejnymi żądaniami. Dla klientów powinny się na niej znaleźć przewidywany termin powrotu i sposób kontaktu z firmą. Google przypomina też, że w czasie zwracania kodu 503 nie odświeża tytułów, opisów ani danych strukturalnych.
Równie ważna jest lista rzeczy, których Google odradza. Nie należy blokować całej witryny w pliku robots.txt ani zwracać kodu 503 dla samego pliku robots.txt. Nie należy też na czas przerwy stosować kodów 403, 404 i 410 ani dyrektywy noindex, ponieważ prowadzą do usunięcia adresów z wyszukiwarki. Nie służy do tego również narzędzie do tymczasowego usuwania adresów w Search Console.
Jeśli przerwa ma trwać dłużej niż kilka dni, Google proponuje inne podejście: zostawić witrynę dostępną i ograniczyć jej funkcje, na przykład wyłączyć koszyk i dodać widoczną informację o przerwie w realizacji zamówień. Przy przenosinach na inny serwer dobrze zaplanowana migracja domeny i hostingu pozwala w ogóle uniknąć okresu niedostępności.
Co zrobić po przywróceniu działania strony
Po naprawie Google samodzielnie wraca do normalnego skanowania, a rolą właściciela jest upewnić się, że naprawa jest pełna, i zgłosić ją w Search Console. Dokumentacja mówi, że gdy serwer zaczyna odpowiadać kodem z grupy 2xx, szybkość skanowania rośnie stopniowo. Nie ma przycisku, który przywraca ją od razu, i nie da się poprosić Google o szybsze skanowanie.
- Potwierdzenie kodu odpowiedzi
Najpierw warto sprawdzić kod odpowiedzi kilku różnych typów podstron: strony głównej, kategorii, produktu lub usługi, wpisu oraz pliku robots.txt i mapy witryny. Działająca strona główna nie dowodzi, że działa cały serwis.
- Test wersji opublikowanej w Search Console
W narzędziu do sprawdzania adresów URL należy uruchomić test na żywo dla najważniejszych adresów i upewnić się, że pole Pobranie strony pokazuje powodzenie. Ten test wykonuje infrastruktura Google, więc ujawnia także blokady na poziomie zapory.
- Zgłoszenie naprawy w raporcie Indeksowanie stron
Po otwarciu wiersza Błąd serwera (5xx) dostępny jest przycisk rozpoczynający weryfikację poprawki. Google zaleca użyć go dopiero po naprawieniu wszystkich wystąpień, bo jedno pozostawione zatrzymuje weryfikację. Trwa ona zazwyczaj do dwóch tygodni, czasem dłużej.
- Prośba o ponowne zindeksowanie kluczowych adresów
Dla kilku najważniejszych podstron można w narzędziu do sprawdzania adresów URL skorzystać z przycisku z prośbą o zindeksowanie. Obowiązuje dzienny limit takich próśb, więc dla większej liczby adresów Google poleca aktualną mapę witryny.
Adresy, które zdążyły wypaść z indeksu, wracają po ponownym odwiedzeniu przez robota. Google otwarcie przyznaje, że po dłuższej niedostępności przywrócenie widoczności jest trudniejsze i że nie potrafi podać terminu ani sposobu przyspieszenia tego procesu. Przez kolejne tygodnie warto zaglądać do raportu Statystyki indeksowania i sprawdzać, czy błędy 5xx nie wracają.
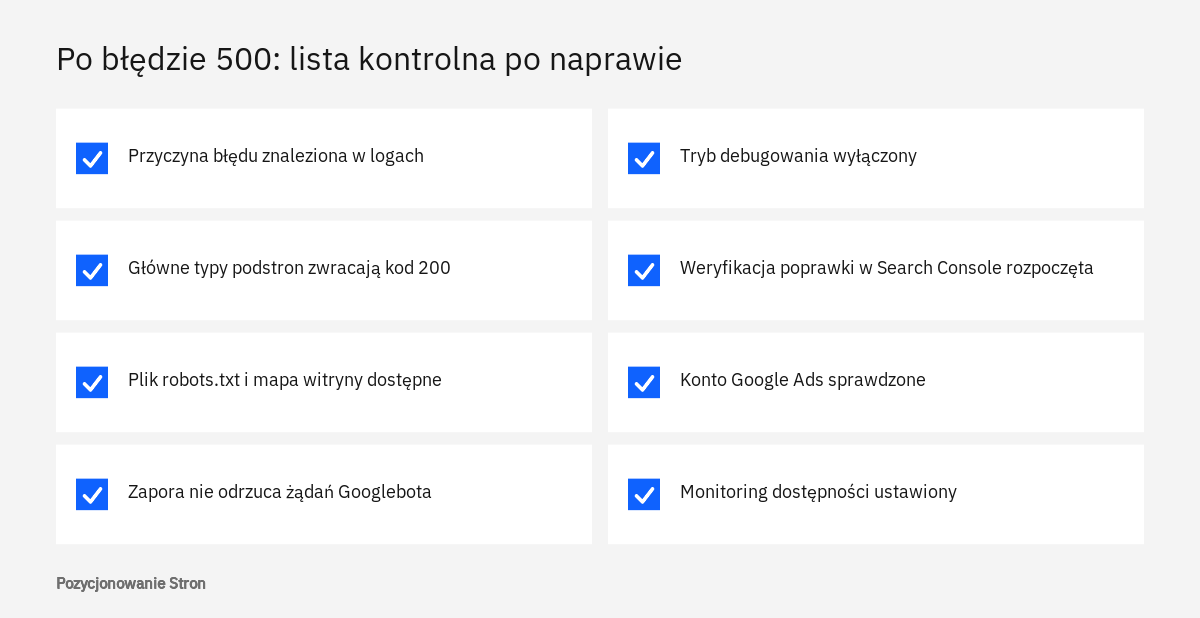
Lista kontrolna po awarii
- Przyczyna błędu jest znana i opisana, a nie tylko ustąpiła sama.
- Strona główna, kategorie, produkty lub usługi i wpisy zwracają kod 200.
- Plik robots.txt i mapa witryny są dostępne i zwracają kod 200.
- Zapora i ochrona przed atakami nie odrzucają żądań Googlebota.
- Tryb debugowania został wyłączony, a plik z zapisem błędów usunięty.
- W raporcie Indeksowanie stron rozpoczęto weryfikację poprawki.
- Sprawdzono konto Google Ads, jeśli kampanie kierowały na niedziałające adresy.
- Ustawiono monitoring dostępności, który powiadomi o kolejnej awarii.
Typowe pomyłki i sytuacje, w których potrzebna jest pomoc
Najczęstszą pomyłką jest uznanie sprawy za zamkniętą w chwili, gdy strona znów otwiera się w przeglądarce. Błąd, który ustąpił bez znalezienia przyczyny, zwykle wraca, często przy kolejnym wzroście ruchu albo kolejnej aktualizacji.
Druga pomyłka to ocenianie dostępności wyłącznie własnym okiem. Właściciel firmy odwiedza stronę w dzień, z jednego miejsca, często z pamięcią podręczną przeglądarki. Robot Google przychodzi o różnych porach i, jak podaje dokumentacja, skanuje głównie z adresów w Stanach Zjednoczonych. Serwer, który blokuje ruch z zagranicy albo nie wytrzymuje nocnych zadań, może dla właściciela wyglądać na w pełni sprawny, a dla robota regularnie zwracać błędy.
Pomoc z zewnątrz jest potrzebna wtedy, gdy błędy wracają mimo napraw, gdy dotyczą tylko robotów, a zwykli użytkownicy ich nie widzą, gdy logi są niedostępne albo nieczytelne, oraz gdy po kilku tygodniach od naprawy widoczność nie wraca. W takich sytuacjach analizujemy logi i raporty Search Console w ramach usługi SEO technicznego, a gdy awaria odsłoniła więcej zaniedbań, punktem wyjścia bywa kompleksowy audyt SEO.
Jeśli chcą Państwo zamówić SEO techniczne, zachęcamy do kontaktu: tel. 222 500 844 lub mailowo: biuro@pozycjonowaniestron.pl
Najczęstsze pytania
Czy jednorazowy błąd 500 obniża pozycje strony w Google?
Dokumentacja Google mówi o usuwaniu z indeksu adresów, które zwracają błąd serwera stale. Pojedyncza nieudana próba oznacza jedynie, że robot zignoruje tę odpowiedź i wróci później. Krótkie awarie wpływają głównie na tempo skanowania.
Ile dni może trwać awaria, zanim strona zniknie z wyników?
Google nie podaje jednej liczby. Zaleca, by kody 5xx trafiały do robotów najwyżej przez kilka godzin albo 1-2 dni, i ostrzega, że po kilku dniach błędów pod tymi samymi adresami może je usunąć z indeksu. Ostrożnie jest więc przyjąć, że każda awaria dłuższa niż dwa dni niesie realne ryzyko.
Czym różni się błąd 500 od 503 z punktu widzenia wyszukiwarki?
Oba należą do błędów serwera i oba spowalniają skanowanie. Kod 503 jest jednak zalecany przez Google przy planowanych, krótkich przerwach, najlepiej z nagłówkiem Retry-After wskazującym termin powrotu. Kod 500 oznacza zwykle nieplanowaną usterkę aplikacji lub konfiguracji.
Search Console pokazuje błąd 5xx, a strona działa. Co to oznacza?
Najczęściej błąd był przejściowy i wystąpił w chwili wizyty robota. Warto uruchomić test wersji opublikowanej w narzędziu do sprawdzania adresów URL oraz zajrzeć do raportu Statystyki indeksowania, by ocenić, czy problem się powtarza.
Czy po naprawie trzeba zgłaszać każdy adres osobno?
Nie. Google wraca do adresów samodzielnie, a szybkość skanowania rośnie stopniowo. Ręczną prośbę o zindeksowanie warto ograniczyć do kilku najważniejszych podstron, a dla pozostałych zadbać o aktualną mapę witryny i rozpocząć weryfikację poprawki w raporcie Indeksowanie stron.
Czy zablokowanie strony w robots.txt na czas awarii chroni widoczność?
Nie, Google wprost odradza takie rozwiązanie, ponieważ może ono doprowadzić do zniknięcia treści z wyszukiwarki. Na czas krótkiej, planowanej przerwy zalecany jest kod 503, a sam plik robots.txt powinien pozostać dostępny.
Źródła
- Jak kody stanu HTTP wpływają na roboty Google, Google for Developers
- Debugowanie błędów sieci i błędów DNS w przypadku robotów Google, Google for Developers
- Zmniejszanie szybkości indeksowania przez Google, Google for Developers
- Jak Google interpretuje specyfikację pliku robots.txt, Google for Developers
- Tymczasowe wstrzymywanie i wyłączanie witryny, Centrum wyszukiwarki Google
- Zarządzanie budżetem indeksowania, Google for Developers
- Raport Indeksowanie stron, Search Console - pomoc
- Raport Statystyki indeksowania, Search Console - pomoc
- Narzędzie do sprawdzania adresów URL, Search Console - pomoc
- Common WordPress errors, WordPress.org
- Debugging in WordPress, WordPress.org
Funkcje wyszukiwarek i asystentów AI zmieniają się szybko, dlatego wpis aktualizujemy po większych zmianach.