Status „Duplikat, wyszukiwarka Google wybrała inną stronę kanoniczną niż użytkownik” oznacza, że Państwa strona wskazała jeden adres jako główny, a Google po zestawieniu wszystkich sygnałów zindeksował inny. Wyjaśniamy, skąd bierze się taka rozbieżność, jak odnaleźć sygnały, które sobie przeczą, oraz w jakich sytuacjach decyzję wyszukiwarki można spokojnie zostawić bez zmian.
Co oznacza status „Google wybrał inną stronę kanoniczną niż użytkownik”
Status ten informuje, że dany adres został w witrynie oznaczony jako główny dla grupy podobnych stron, ale Google uznał, że inny adres lepiej nadaje się do tej roli, i to ten inny adres trafił do indeksu. Tak opisuje go pomoc Search Console poświęcona raportowi „Indeksowanie stron”. Nie jest to kara ani sygnał problemu z jakością całej witryny. To informacja o tym, że deklaracja właściciela i ocena wyszukiwarki się rozeszły.
Adres, który wyszukiwarka uznaje za najbardziej reprezentatywny spośród stron o takiej samej lub bardzo podobnej treści. To on zwykle pojawia się w wynikach wyszukiwania.
Status pojawia się w raporcie „Indeksowanie stron”, w tabeli „Dlaczego strony nie są indeksowane”. Sama nazwa tabeli bywa myląca, ponieważ sugeruje, że treść zniknęła z Google. W rzeczywistości z indeksu wypadł tylko ten jeden adres, a treść jest reprezentowana przez adres, który wybrała wyszukiwarka. Jak wyjaśnia dokumentacja Google, duplikaty nie są też porzucane: nadal są odwiedzane przez robota, tylko rzadziej niż strona kanoniczna, co ogranicza obciążenie serwera.
Czym różni się od sąsiednich statusów
W tej samej tabeli znajdują się dwa podobnie brzmiące wiersze i łatwo je pomylić. Pierwszy to status opisujący sytuację, w której strona w ogóle nie wskazała adresu głównego - omawiamy go osobno we wpisie o tym, co oznacza duplikat bez wybranej strony kanonicznej. Drugi to „Alternatywna strona zawierająca prawidłowy tag strony kanonicznej”, czyli przypadek, w którym deklaracja i decyzja Google są zgodne i według pomocy Search Console nie trzeba nic robić.
Omawiany status leży pomiędzy nimi: deklaracja istnieje, ale nie została przyjęta. Dlatego praca nad nim nie polega na dopisaniu brakującego znacznika, tylko na ustaleniu, co przemawia za innym adresem mocniej niż Państwa wskazanie.
Co z tego wynika dla firmy
Skutki zależą od tego, jaki adres wybrał Google. Jeśli różni się on od zadeklarowanego tylko ukośnikiem na końcu albo przedrostkiem www, klient trafi na tę samą treść i w praktyce nic nie traci. Kłopot zaczyna się wtedy, gdy w wynikach pojawia się adres z parametrami kampanii, wersja bez szyfrowania, strona z innej domeny albo podstrona o nieco innej ofercie niż ta, którą firma chciała pokazywać. Wtedy rozbieżność wpływa na to, co widzi klient, oraz na to, jak czytelne są dane w raportach, ponieważ ruch przypisywany jest do adresu, którego nikt nie planował promować.
Dlaczego wskazany adres kanoniczny jest podpowiedzią, a nie poleceniem
Google traktuje wskazanie adresu kanonicznego jako jeden z kilku sygnałów, a nie jako instrukcję do wykonania. Dokumentacja Centrum wyszukiwarki Google mówi o tym wprost: określenie preferowanego adresu to wskazówka, a nie reguła, i wyszukiwarka może z różnych powodów wybrać inną stronę. Szerzej opisuje to strona o wyborze strony kanonicznej.
Mechanizm wygląda następująco. Podczas indeksowania Google ustala główną treść każdej strony. Gdy kilka adresów zawiera to samo lub niemal to samo, łączy je w grupę i wybiera z niej jeden adres - ten, który według dokumentacji jest najbardziej kompletny i przydatny dla osób korzystających z wyszukiwarki. Dopiero na tym etapie pod uwagę brane są deklaracje właściciela witryny oraz pozostałe sygnały.
Takie podejście ma praktyczne uzasadnienie, które wynika z samej dokumentacji. Deklaracje bywają błędne: system zarządzania treścią albo wtyczka potrafi ustawić znacznik kanoniczny nieprawidłowo, serwer może być źle skonfigurowany, a po włamaniu ktoś może celowo dopisać wskazanie na obcą domenę. Gdyby wyszukiwarka wykonywała każde takie wskazanie bez weryfikacji, jeden błąd w szablonie wystarczyłby do usunięcia z wyników całego serwisu.
Metody, które się sumują
Dokumentacja o określaniu kanonicznego adresu URL podkreśla, że poszczególne metody wskazywania adresu głównego kumulują się. Zastosowanie co najmniej dwóch z nich zwiększa szansę, że w wynikach pojawi się preferowany adres. Z tego samego zdania wynika wniosek odwrotny: gdy metody wskazują różne adresy, wzajemnie się osłabiają, a decyzja przechodzi w ręce wyszukiwarki.
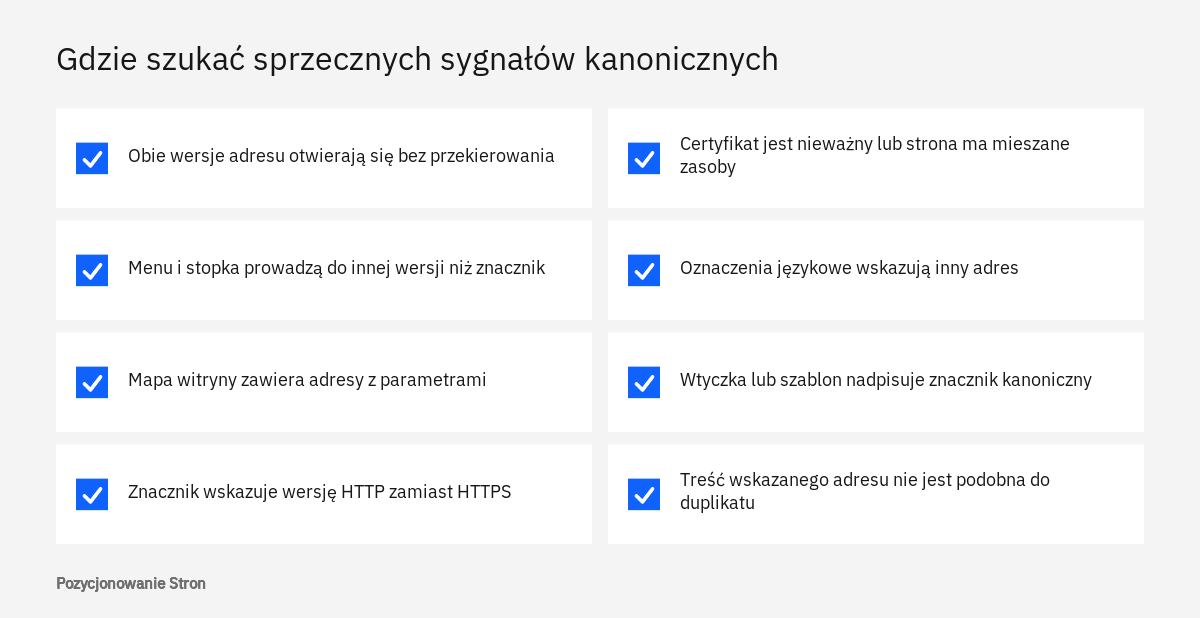
Przyjmijmy hipotetyczny przykład kancelarii z Krakowa. Znacznik kanoniczny na stronie usługi wskazuje adres z przedrostkiem www, ale menu, stopka i mapa witryny prowadzą do wersji bez tego przedrostka, a obie wersje otwierają się bez przekierowania. Jedna deklaracja mówi jedno, wszystkie pozostałe elementy serwisu mówią drugie. W takiej sytuacji trudno oczekiwać, że Google oprze się wyłącznie na znaczniku.
Jakie sygnały Google bierze pod uwagę przy wyborze adresu
Dokumentacja Google wymienia kilka sygnałów: protokół, czyli to, czy strona działa przez HTTP, czy HTTPS, przekierowania, obecność adresu w mapie witryny oraz adnotację rel="canonical" (znacznik, którym właściciel wskazuje adres główny). Do tego dochodzą linki wewnętrzne, przynależność do grupy wersji językowych i samo podobieństwo treści. Sygnały te nie mają jednakowej siły, a dokumentacja podaje ich kolejność.
| Sygnał | Jak opisuje go Google | Na co zwrócić uwagę |
|---|---|---|
| Przekierowanie | Wyraźny sygnał, że adres docelowy powinien być kanoniczny | Stosowane wtedy, gdy duplikat ma zostać wycofany |
| Znacznik rel="canonical" | Silny sygnał, że wskazany adres ma być kanoniczny | W kodzie HTML działa tylko dla stron HTML; dla plików takich jak PDF służy nagłówek HTTP |
| Mapa witryny | Sygnał słabszy niż znacznik kanoniczny | Google nadal sam musi ustalić, które strony są duplikatami |
| Protokół HTTPS | Wersja szyfrowana jest domyślnie preferowana | Przewaga znika przy nieprawidłowym certyfikacie lub przekierowaniu na HTTP |
| Linki wewnętrzne | Spójne linkowanie do adresu kanonicznego pomaga odczytać preferencje | Menu, stopka i odnośniki w treści powinny prowadzić do jednej wersji |
| Grupa hreflang | Preferowane są adresy należące do grupy wersji językowych | Adres pominięty w oznaczeniach językowych ma słabszą pozycję |
Przekierowania i znacznik kanoniczny
Przekierowanie jest najmocniejszym sygnałem, ponieważ usuwa wątpliwość: stary adres przestaje wyświetlać treść i odsyła pod nowy. Znacznik kanoniczny jest silny, ale pozostawia oba adresy dostępne, więc Google wciąż może je porównywać. Jak poprawnie przygotować samo oznaczenie, opisujemy we wpisie o tym, czym jest adres kanoniczny i znacznik rel=canonical.
HTTPS i mapa witryny
Google domyślnie woli wersję szyfrowaną od nieszyfrowanej. Dokumentacja wymienia jednak sytuacje, w których ta przewaga przestaje działać: nieprawidłowy certyfikat, niezabezpieczone zasoby wczytywane na stronie, przekierowanie z HTTPS na HTTP albo znacznik kanoniczny wskazujący wersję HTTP. Jeżeli więc wyszukiwarka wybrała adres bez szyfrowania, przyczyna zwykle leży w jednym z tych czterech punktów. Mapa witryny jest sygnałem słabszym, lecz łatwym do utrzymania, o ile zawiera wyłącznie adresy, które firma faktycznie chce mieć w indeksie.
Podobieństwo treści
Pomoc Search Console zwraca uwagę na warunek, o którym często się zapomina: zduplikowana strona musi być podobna do kanonicznej. Jeżeli adres wskazany przez Państwa nie przypomina treścią strony, na której umieszczono wskazanie, Google go nie wybierze. Dotyczy to między innymi sklepów, w których wszystkie warianty kierują znacznikiem na stronę kategorii, oraz serwisów, w których każda podstrona wskazuje stronę główną. Warto też wiedzieć, że według dokumentacji wersje językowe są uznawane za duplikaty tylko wtedy, gdy główna treść jest w tym samym języku - przetłumaczony nagłówek i stopka przy niezmienionym tekście nie wystarczą, aby strony uznać za odrębne.
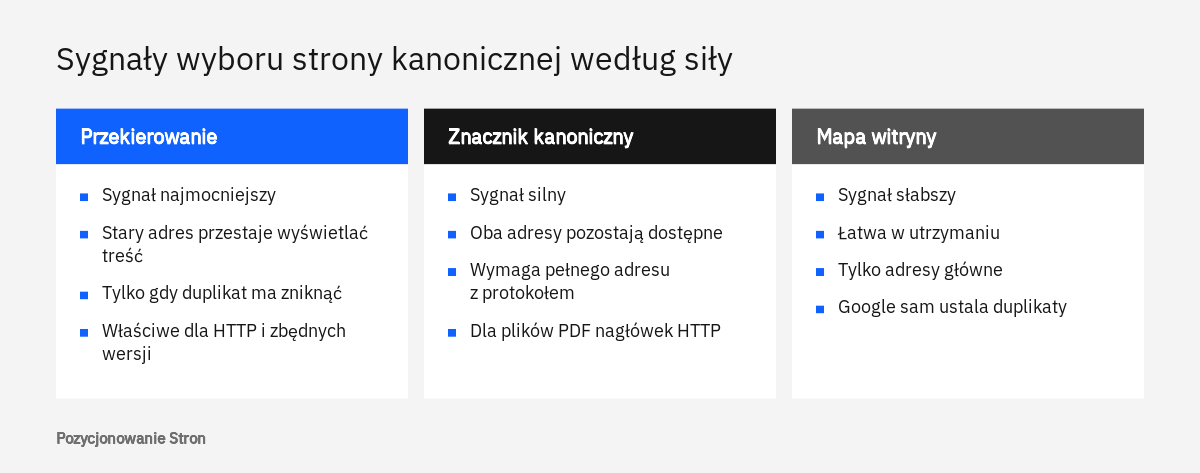
Zestawienie pokazuje, dlaczego sama poprawka znacznika często nie zmienia decyzji wyszukiwarki. Znacznik jest jednym głosem, a pozostałe elementy serwisu mogą głosować inaczej.
Gdzie sprawdzić, który adres wybrał Google
Adres wybrany przez wyszukiwarkę widać w Search Console w dwóch miejscach: lista adresów ze statusem znajduje się w raporcie „Indeksowanie stron”, a szczegóły konkretnego adresu w narzędziu do sprawdzania adresów URL. Raport odpowiada na pytanie, ilu stron dotyczy problem, a narzędzie pokazuje, który adres Google uznał za główny.
- Otwarcie raportu „Indeksowanie stron”
W menu Search Console raport znajduje się w grupie dotyczącej indeksowania. Poniżej wykresu widoczna jest tabela „Dlaczego strony nie są indeksowane” z kolumnami opisującymi przyczynę, źródło i stan weryfikacji.
- Wejście w wiersz ze statusem
Po kliknięciu wiersza „Duplikat, wyszukiwarka Google wybrała inną stronę kanoniczną niż użytkownik” otwiera się lista przykładowych adresów. Listę można wyeksportować i przejrzeć pod kątem powtarzających się wzorców.
- Sprawdzenie pojedynczego adresu
Kliknięcie adresu z listy i wybranie ikony lupy uruchamia narzędzie do sprawdzania adresów URL. Ten sam efekt daje wklejenie adresu w pole wyszukiwania u góry ekranu.
- Porównanie dwóch pól
W części poświęconej indeksowaniu strony znajdują się pola „Adres kanoniczny określony przez użytkownika” oraz „Adres kanoniczny wybrany przez Google”. Różnica między nimi jest sednem całego statusu.
- Odczytanie pól pomocniczych
Pole „Strona odsyłająca” wskazuje stronę, z której Google prawdopodobnie poznał adres, a pole „Mapy witryn” pokazuje zgłoszone mapy zawierające ten adres. Oba pomagają ustalić, skąd płyną sprzeczne sygnały.
Szczegółowy opis wszystkich pól tego narzędzia zawiera nasz wpis o tym, jak czytać sprawdzanie adresu URL w Search Console. Tutaj ważne są dwa zastrzeżenia z pomocy Google na temat tego narzędzia. Po pierwsze, test wersji opublikowanej nie potrafi przewidzieć, czy strona zostanie uznana za kanoniczną, ponieważ decyzja zapada dopiero przy indeksowaniu. Po drugie, wartość „Brak” w polu z adresem określonym przez użytkownika jest poprawna, jeżeli strona nie ma duplikatów.
Dokumentacja Google opisuje własną kolejność diagnozy: ustalenie adresu uznanego za kanoniczny, poszukiwanie problemów technicznych, zadbanie o wyraźne różnice między stronami i dopiero na końcu prośba o ponowne zindeksowanie.
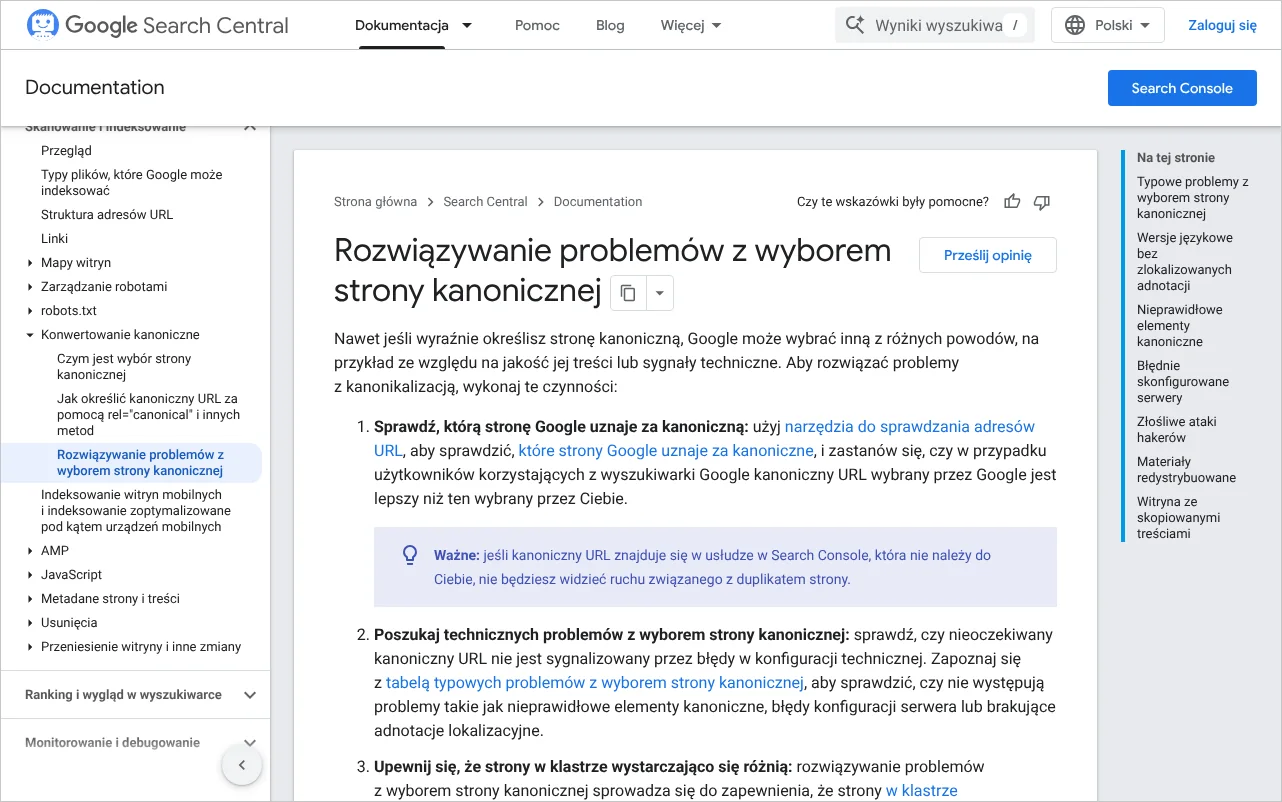
Na tej stronie dokumentacji znajduje się również wykaz typowych problemów, do którego wracamy w kolejnej części.
Jeśli chcą Państwo zamówić audyt SEO, zachęcamy do kontaktu: tel. 222 500 844 lub mailowo: biuro@pozycjonowaniestron.pl
Skąd biorą się sprzeczne sygnały
Sprzeczne sygnały powstają najczęściej wtedy, gdy różne części serwisu były budowane w różnym czasie i przez różne osoby, a każda z nich wskazuje inną wersję tego samego adresu. Znacznik kanoniczny generuje wtyczka, mapę witryny inne rozszerzenie, menu ułożono ręcznie, a przekierowania ustawiono na serwerze przy okazji dawnej zmiany. Każdy z tych elementów osobno działa poprawnie, ale razem nie mówią jednym głosem.
Wersje tego samego adresu
Dokumentacja wymienia kilka powodów, dla których ta sama treść jest dostępna pod wieloma adresami: warianty protokołu, czyli HTTP i HTTPS, warianty dla urządzeń, warianty regionalne, funkcje witryny takie jak sortowanie i filtrowanie na stronach kategorii oraz przypadkowo dostępne wersje testowe. Z praktyki agencji dodajemy do tej listy adresy z przedrostkiem www i bez niego, z ukośnikiem na końcu i bez niego oraz różniące się wielkością liter. Jeżeli w serwisie nie ustalono jednej wersji, warto zacząć od uporządkowania podstaw, które opisujemy we wpisach o adresie z www i bez www oraz o przejściu z HTTP na HTTPS.
Parametry i filtry w sklepach
W sklepach internetowych źródłem rozbieżności są zwykle parametry. Przyjmijmy hipotetyczny sklep z Poznania, w którym strona kategorii ma kilkanaście wariantów sortowania. Każdy wariant wskazuje znacznikiem adres bez parametru, ale przyciski sortowania są zwykłymi linkami, a część wariantów trafiła do mapy witryny. Znacznik mówi „adres czysty”, linki wewnętrzne i mapa mówią „adres z parametrem”. Więcej o tym zjawisku piszemy we wpisie poświęconym parametrom w adresach URL.
Błędy systemu, serwera i wersji językowych
Strona dokumentacji o rozwiązywaniu problemów z wyborem strony kanonicznej opisuje przyczyny, które trudniej zauważyć samodzielnie. Pierwsza to nieprawidłowe elementy kanoniczne: niektóre systemy zarządzania treścią i wtyczki ustawiają znacznik albo przekierowania błędnie, dlatego Google zaleca obejrzenie kodu HTML w narzędziach deweloperskich przeglądarki. Druga to źle skonfigurowany serwer, który zwraca treść z innej domeny albo wyświetla identyczne strony błędu z kodem powodzenia. Trzecia to wersje językowe o niemal identycznej treści przeznaczone dla różnych krajów, przy których pomagają oznaczenia hreflang dla wersji językowych.
Osobną grupę stanowią sytuacje, w których wybrany adres należy do innej domeny. Dokumentacja wymienia tu trzy scenariusze: włamanie, po którym na stronie pojawiają się przekierowania lub wskazania kanoniczne na obce domeny, treści przekazywane partnerom do ponownej publikacji oraz serwisy, które skopiowały treść bez zgody. W ostatnim przypadku Google wskazuje możliwość zwrócenia się do właściciela kopii o jej usunięcie albo złożenia zgłoszenia dotyczącego praw autorskich. Są to sprawy o charakterze prawnym, dlatego przed podjęciem kroków warto skonsultować je z prawnikiem.
Jak ujednolicić sygnały, aby wskazywały jeden adres
Ujednolicenie polega na tym, aby każdy element serwisu - przekierowania, znacznik kanoniczny, linki wewnętrzne, mapa witryny i oznaczenia językowe - prowadził do dokładnie tego samego adresu, zapisanego co do znaku tak samo. Kolejność prac warto ułożyć od sygnału najmocniejszego do najsłabszego, zgodnie z hierarchią opisaną w dokumentacji.
Przekierowania tam, gdzie duplikat jest zbędny
Jeżeli druga wersja adresu nie jest nikomu potrzebna, najskuteczniejsze jest przekierowanie. Dotyczy to wersji bez szyfrowania, wersji z niewłaściwym przedrostkiem oraz starych adresów po przebudowie serwisu. Dokumentacja zastrzega, że przekierowania należy stosować tylko wtedy, gdy duplikat ma zostać wycofany. Strony sortowania czy wersji do druku, z których klienci korzystają, powinny pozostać dostępne i otrzymać znacznik kanoniczny.
Znacznik zapisany poprawnie
Google zaleca stosowanie pełnych adresów bezwzględnych, z protokołem i domeną. Adresy względne są obsługiwane, ale mogą prowadzić do kłopotów, na przykład do przypadkowego dopuszczenia do indeksu wersji testowej. Znacznik powinien znajdować się także na samej stronie głównej dla danej grupy i wskazywać ją samą. Nie należy wskazywać adresu z fragmentem, czyli częścią po znaku krzyżyka, ponieważ Google zasadniczo nie obsługuje fragmentów.
<link rel="canonical" href="https://example.com/sukienki/zielone-sukienki" />

Link: <https://www.example.com/pliki/raport.pdf>; rel="canonical"
Linki wewnętrzne, mapa witryny i oznaczenia językowe
Linki w menu, stopce, okruszkach i treści powinny prowadzić do wersji kanonicznej, a nie do duplikatów. Dokumentacja wskazuje, że taka spójność pomaga Google zrozumieć preferencje właściciela. Mapa witryny powinna zawierać wyłącznie adresy główne, a nie ich warianty; zasady jej przygotowania opisujemy we wpisie o tym, jak przygotować mapę witryny XML. Ani w mapie, ani w oznaczeniach hreflang nie należy podawać wersji HTTP, jeśli istnieje wersja HTTPS. Przy wersjach językowych adres kanoniczny powinien wskazywać stronę w tym samym języku.
- Wszystkie zbędne wersje adresu przekierowują trwale na jedną wersję główną.
- Znacznik kanoniczny zawiera pełny adres z protokołem HTTPS i właściwą domeną.
- Strona główna dla danej grupy wskazuje znacznikiem samą siebie.
- Menu, stopka i odnośniki w treści prowadzą do adresu kanonicznego.
- Mapa witryny zawiera tylko adresy główne, bez parametrów i wariantów.
- Oznaczenia językowe i znacznik kanoniczny nie wskazują różnych adresów.
- Certyfikat jest ważny, a strona nie wczytuje niezabezpieczonych zasobów.
- Treść strony z duplikatem jest podobna do treści adresu wskazanego jako główny.
Czego nie robić, próbując wymusić wybór adresu
Nie należy sięgać po narzędzia służące do blokowania lub usuwania stron, ponieważ nie są one sposobem wskazywania adresu głównego i mogą wyrządzić więcej szkody niż sama rozbieżność. Dokumentacja Google wymienia kilka takich pomyłek wprost.
Pierwszą jest blokowanie duplikatów w pliku robots.txt. Google może zindeksować zablokowany adres bez jego treści, a robot, który nie może pobrać strony, nie odczyta też umieszczonego na niej znacznika kanonicznego. Drugą jest użycie narzędzia do usuwania adresów URL - ukrywa ono w wyszukiwarce wszystkie wersje adresu, a więc także tę, na której firmie zależy. Trzecią jest dyrektywa noindex stosowana po to, aby wykluczyć stronę z wyboru. Google nie zaleca tego rozwiązania w obrębie jednej witryny i wskazuje znacznik kanoniczny jako właściwszy. Różnice między tymi mechanizmami wyjaśniamy we wpisie o tym, czym różnią się canonical, noindex i robots.txt.
Czwartą pomyłką jest mieszanie metod, czyli podanie jednego adresu w mapie witryny, a innego w znaczniku kanonicznym tej samej strony. Piątą - wielokrotne proszenie o zindeksowanie bez usunięcia przyczyny. Liczba takich zgłoszeń jest ograniczona, a samo zgłoszenie nie zmienia sygnałów, na podstawie których Google podejmuje decyzję.
Kiedy decyzję wyszukiwarki warto po prostu przyjąć
Decyzję Google warto przyjąć wtedy, gdy wybrany adres jest poprawny technicznie, prowadzi do tej samej treści i nie szkodzi klientowi ani raportom. Dokumentacja sama zachęca do takiej oceny: pierwszym etapem diagnozy jest zastanowienie się, czy adres wybrany przez wyszukiwarkę nie jest dla użytkowników lepszy od zadeklarowanego.
Tak bywa częściej, niż się wydaje. Jeżeli Google wybrał wersję z szyfrowaniem zamiast wskazanej wersji HTTP, to deklaracja była przestarzała, a nie decyzja błędna. Jeżeli wybrał adres, do którego prowadzą wszystkie linki w serwisie, a znacznik wskazuje wariant, którego nikt nie używa, prościej poprawić znacznik. W obu przypadkach właściwym działaniem jest dostosowanie własnych oznaczeń do stanu faktycznego.
Hipotetyczny przykład: hydraulik z Łodzi ma na stronie dwie niemal identyczne podstrony tej samej usługi, różniące się jednym zdaniem i nazwą dzielnicy. Znacznik na pierwszej wskazuje ją samą, lecz Google uznał obie za duplikaty i zindeksował drugą. Spór o to, która ma być główna, niewiele da. Lepszy efekt przyniesie decyzja merytoryczna: połączenie obu stron w jedną albo rozbudowanie każdej tak, aby rzeczywiście się różniły. Dokumentacja potwierdza, że strony rozdzielają się szybciej, gdy nowa treść wyraźnie i znacząco odbiega od pozostałych.
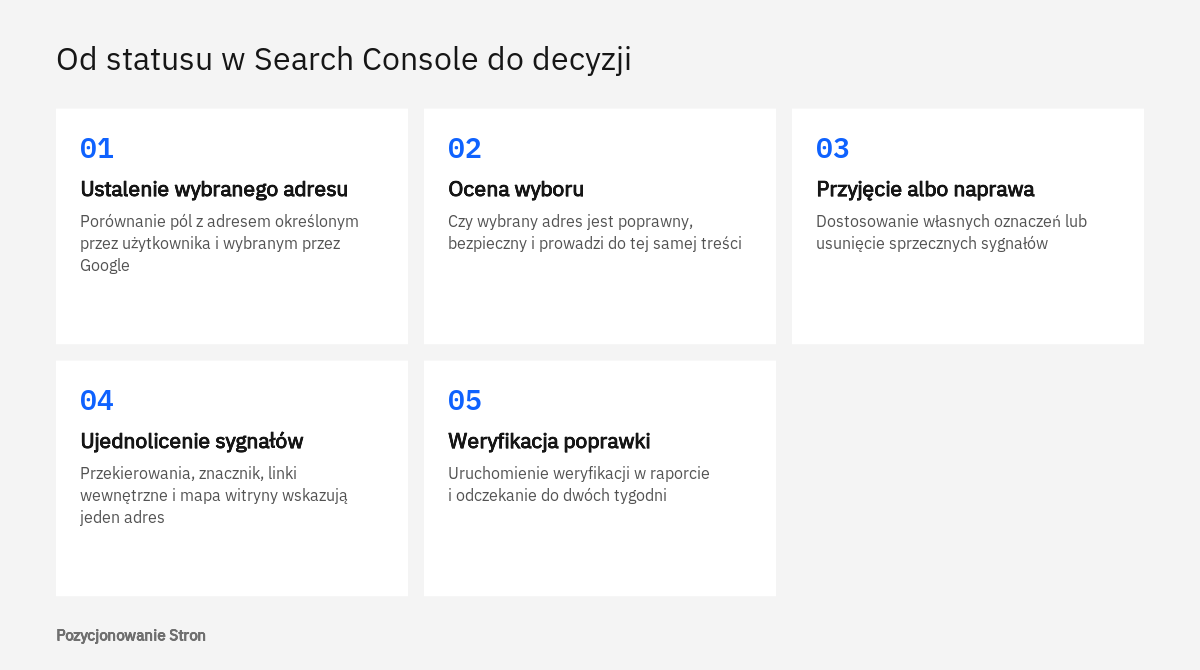
Decyzji wyszukiwarki nie należy natomiast przyjmować, gdy wybrany adres prowadzi do obcej domeny, do wersji testowej, do adresu z parametrami kampanii reklamowej albo do strony o innej ofercie, cenie lub języku. W tych sytuacjach rozbieżność zmienia to, co widzi klient, i wymaga naprawy.
Co zrobić po poprawkach i ile trwa zmiana
Po ujednoliceniu sygnałów należy dać wyszukiwarce czas i potwierdzić efekt w Search Console, zamiast oceniać go następnego dnia. Dokumentacja podaje, że Google może utrzymywać strony w grupie duplikatów do dwóch tygodni po usunięciu problemów, a weryfikacja poprawki uruchamiana w raporcie zwykle trwa również do dwóch tygodni.
W praktyce kolejność wygląda tak. Najważniejsze adresy można zgłosić do ponownego zindeksowania w narzędziu do sprawdzania adresów URL, przy czym limity są niskie, a Google zaleca tę funkcję tylko dla kluczowych stron. Następnie na stronie szczegółów problemu w raporcie „Indeksowanie stron” uruchamia się weryfikację poprawki. Search Console sprawdza najpierw kilka stron; jeśli problem nadal na nich występuje, weryfikacja kończy się niepowodzeniem. W przeciwnym razie sprawdzana jest cała lista znanych adresów, a o wyniku informuje wiadomość e-mail. Według pomocy Google przycisku weryfikacji nie należy klikać ponownie, dopóki trwający proces się nie zakończy.
Kiedy potrzebna jest pomoc specjalisty
Samodzielnie da się zwykle poprawić pojedynczy znacznik, mapę witryny czy linki w menu. Pomoc jest potrzebna wtedy, gdy status obejmuje setki adresów o różnych wzorcach, gdy źródłem kłopotu jest konfiguracja serwera lub szablonu, gdy sklep ma rozbudowane filtry, a także wtedy, gdy wybrany adres należy do obcej domeny. W takich przypadkach diagnoza wymaga przejrzenia przekierowań, nagłówków odpowiedzi serwera i kodu po wyrenderowaniu, co wchodzi w zakres prac SEO technicznego. Jeżeli rozbieżność jest jednym z wielu sygnałów nieładu w adresach, lepszym punktem wyjścia bywa kompleksowy audyt SEO, który porządkuje wszystkie przyczyny jednocześnie i ustala kolejność prac.
Jeśli chcą Państwo zamówić audyt SEO, zachęcamy do kontaktu: tel. 222 500 844 lub mailowo: biuro@pozycjonowaniestron.pl
Najczęstsze pytania
Czy ten status oznacza, że strona zniknęła z Google?
Nie. Z indeksu wypadł tylko adres, który firma wskazała jako główny, a treść jest reprezentowana przez adres wybrany przez wyszukiwarkę. Trzeba jedynie ustalić, czy ten wybrany adres jest dla firmy do przyjęcia.
Czy poprawny znacznik kanoniczny gwarantuje, że Google wybierze wskazany adres?
Nie gwarantuje. Dokumentacja Google określa wskazanie adresu kanonicznego jako wskazówkę, a nie regułę. Znacznik jest silnym sygnałem, ale wyszukiwarka zestawia go z przekierowaniami, mapą witryny, protokołem i linkami wewnętrznymi.
Gdzie widać adres, który Google uznał za główny?
W narzędziu do sprawdzania adresów URL w Search Console, w części dotyczącej indeksowania strony. Znajdują się tam dwa pola: „Adres kanoniczny określony przez użytkownika” oraz „Adres kanoniczny wybrany przez Google”. Test wersji opublikowanej tej informacji nie pokaże.
Ile trwa zmiana statusu po poprawkach?
Według dokumentacji Google strony mogą pozostawać w grupie duplikatów do dwóch tygodni po usunięciu problemów. Weryfikacja poprawki w raporcie również zwykle trwa do dwóch tygodni.
Czy można zablokować duplikat w pliku robots.txt, aby Google wybrał właściwy adres?
Google odradza takie rozwiązanie. Zablokowany adres może zostać zindeksowany bez treści, a robot nie odczyta znajdującego się na nim znacznika kanonicznego. Do wskazywania adresu głównego służą przekierowania, znacznik kanoniczny i mapa witryny.
Co zrobić, gdy Google wybrał adres z innej domeny?
Najpierw należy wykluczyć włamanie i błędną konfigurację serwera, ponieważ dokumentacja wymienia je wśród przyczyn. Jeśli treść została skopiowana bez zgody, Google wskazuje możliwość zwrócenia się do właściciela kopii lub zgłoszenia naruszenia praw autorskich. W sprawach prawnych warto skorzystać z pomocy prawnika.
Źródła
- Co to jest wybór strony kanonicznej, Centrum wyszukiwarki Google
- Jak określić kanoniczny URL za pomocą rel="canonical" i innych metod, Centrum wyszukiwarki Google
- Rozwiązywanie problemów z wyborem strony kanonicznej, Centrum wyszukiwarki Google
- Raport Indeksowanie stron, Pomoc Search Console
- Narzędzie do sprawdzania adresów URL, Pomoc Search Console
Funkcje wyszukiwarek i asystentów AI zmieniają się szybko, dlatego wpis aktualizujemy po większych zmianach.