Status ten oznacza, że Google znalazł w Państwa serwisie adres o treści takiej samej lub bardzo podobnej jak pod innym adresem, nie dostał od strony żadnej wskazówki, który z nich jest główny, i sam wybrał jeden. Sprawdzony adres do indeksu nie trafił, bo pokazywany jest ten drugi. Poniżej wyjaśniamy, gdzie odczytać, który adres wygrał, kiedy komunikat można zostawić w spokoju, a kiedy świadczy o nieporządku w adresach i jak go wtedy usunąć.
Co dokładnie oznacza ten status
Komunikat informuje o dwóch rzeczach jednocześnie: dany adres jest kopią innej strony oraz nie zawiera żadnej deklaracji, która wersja ma być główna. W takiej sytuacji decyzję podejmuje wyszukiwarka. Wybiera jeden adres jako reprezentanta całej grupy, a pozostałe pomija w indeksie. Adres z tym statusem należy właśnie do pominiętych.
Warto od razu wyjaśnić sprawę nazwy. W rozmowach i na forach status funkcjonuje jako „Duplikat, użytkownik nie wybrał strony kanonicznej”, natomiast w polskiej wersji pomocy Search Console zapisano go jako „Duplikat, użytkownik nie oznaczył strony kanonicznej”. Chodzi o ten sam wiersz raportu. Słowo „użytkownik” oznacza tu właściciela witryny, czyli Państwa, a nie osobę odwiedzającą stronę.
Adres, który wyszukiwarka uznaje za reprezentatywny dla treści dostępnej pod kilkoma adresami. To on trafia do indeksu i zwykle on pojawia się w wynikach.
Google opisuje ten mechanizm w dokumentacji zatytułowanej Co to jest wybór strony kanonicznej. Wyszukiwarka ustala główną treść każdej strony, łączy w grupy strony takie same lub bardzo podobne, a następnie z każdej grupy wybiera adres, który na podstawie zebranych sygnałów jest najbardziej kompletny i przydatny dla użytkowników. Wśród sygnałów dokumentacja wymienia między innymi protokół (HTTP lub HTTPS), przekierowania, obecność adresu w mapie witryny oraz adnotacje rel="canonical". Jeżeli właściciel nie podał żadnej wskazówki, zostają tylko sygnały pośrednie i stąd bierze się omawiany komunikat.
Z tej samej dokumentacji wynika jeszcze jedna ważna rzecz: powielona treść w obrębie serwisu sama w sobie nie narusza zasad dotyczących spamu. Google nazywa ją zjawiskiem normalnym. Zwraca jedynie uwagę, że kopie mogą mylić odbiorców i utrudniać śledzenie, jak dana treść radzi sobie w wynikach.
Trzy podobnie brzmiące statusy
W raporcie występują obok siebie trzy komunikaty związane z kopiami i łatwo je pomylić. Różnią się tym, czy na stronie jest deklaracja wersji głównej i czy Google się z nią zgodził.
| Status w raporcie | Deklaracja na stronie | Co zrobił Google |
|---|---|---|
| Duplikat, użytkownik nie oznaczył strony kanonicznej | Brak wskazania wersji głównej | Sam wybrał inny adres jako główny, ten pominął |
| Duplikat, wyszukiwarka Google wybrała inną stronę kanoniczną niż użytkownik | Strona wskazana jako główna | Uznał, że inny adres lepiej nadaje się na główny, i zaindeksował tamten |
| Alternatywna strona zawierająca prawidłowy tag strony kanonicznej | Strona poprawnie wskazuje inny adres | Zaindeksował wskazany adres, działań zwykle nie trzeba |
Trzeci status jest stanem docelowym: deklaracja została odczytana i przyjęta. Szerszy przegląd pozostałych powodów braku indeksacji opisaliśmy we wpisie o tym, dlaczego Google nie indeksuje strony.
Gdzie znaleźć ten status w Search Console
Status znajduje się w raporcie Indeksowanie stron, w tabeli zatytułowanej „Dlaczego strony nie są indeksowane”. Po zalogowaniu do Search Console i otwarciu właściwej usługi raport jest dostępny w menu po lewej stronie, w części poświęconej indeksowaniu, pod pozycją Strony. Na górze widać wykres z liczbą stron zaindeksowanych i niezaindeksowanych, a niżej tabelę z powodami.
Każdy wiersz tabeli to jeden powód. Obok nazwy znajduje się kolumna Źródło, która według pomocy Search Console pokazuje, czy przyczyna leży po stronie witryny, czy po stronie Google, oraz liczba adresów objętych danym powodem. Kliknięcie wiersza otwiera szczegóły: historię problemu na wykresie oraz listę przykładowych adresów.
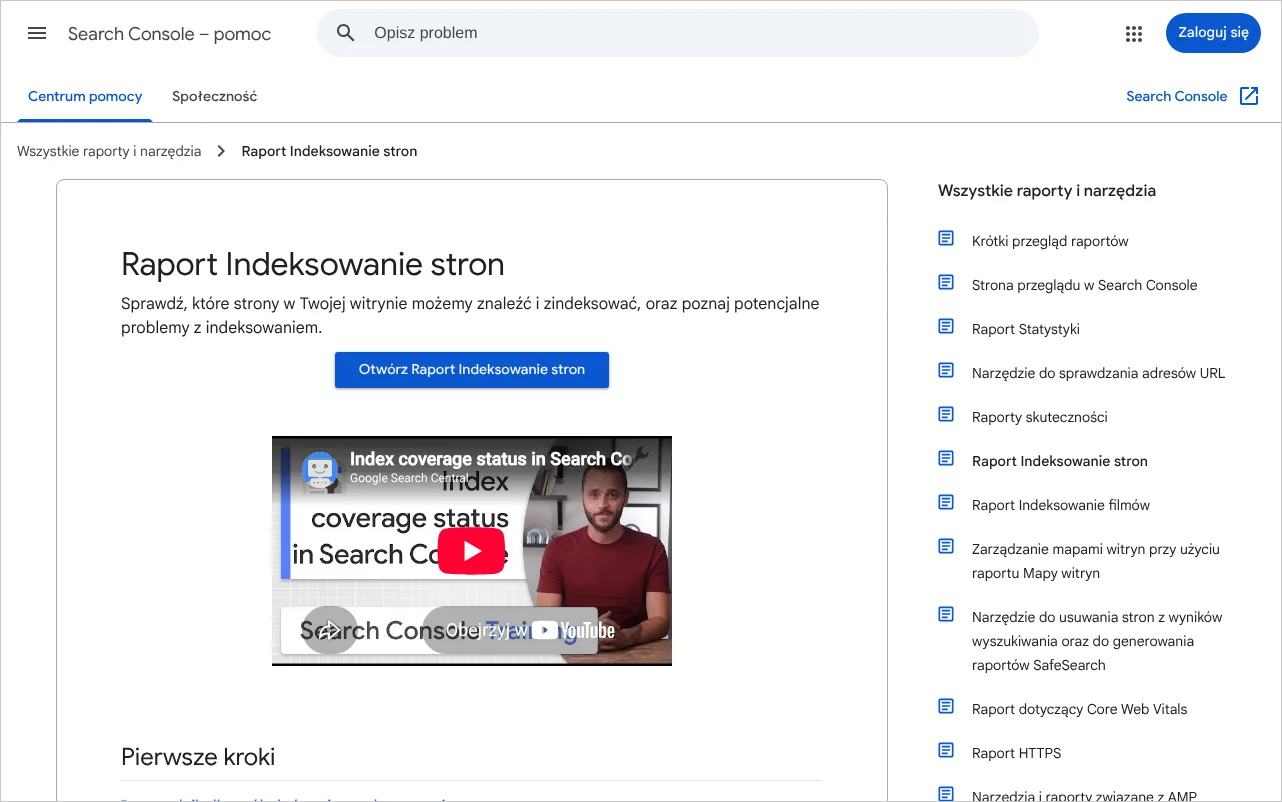
Przy czytaniu listy przykładów warto mieć na uwadze ograniczenie opisane w pomocy: lista liczy najwyżej 1000 wierszy i nie musi zawierać wszystkich adresów z danym statusem. Do oceny skali służy więc liczba i wykres, a lista pokazuje wzorce. Z naszej praktyki wynika, że najwięcej mówią powtarzające się fragmenty adresów: jeżeli większość przykładów zawiera ten sam parametr po znaku zapytania albo ten sam katalog, źródło kopii jest jedno i wystarczy jedna poprawka w szablonie.
Nad wykresem znajduje się filtr, który zmienia zakres danych. Domyślnie raport obejmuje wszystkie znane strony. Można go zawęzić do wszystkich przesłanych stron, czyli adresów zgłoszonych w mapie witryny, do stron nieprzesłanych albo do adresów z jednej konkretnej mapy. To ustawienie ma duże znaczenie przy ocenie, czy sprawa wymaga działania.
Jak sprawdzić, który adres wygrał
Zwycięski adres pokazuje narzędzie do sprawdzania adresów URL, w polu „Adres kanoniczny wybrany przez Google”. Narzędzie otwiera się na dwa sposoby: przez wpisanie pełnego adresu w pasku wyszukiwania u góry dowolnego ekranu Search Console albo przez ikonę sprawdzania widoczną przy adresie na liście przykładów w raporcie, czasem dopiero po najechaniu kursorem na wiersz.
Wynik ma kilka części. Na górze widać ogólny stan strony, a poniżej rozwijaną sekcję Indeksowanie stron. To w niej znajdują się informacje potrzebne do oceny omawianego statusu. Pomoc narzędzia do sprawdzania adresów URL opisuje je następująco:
- Adres kanoniczny określony przez użytkownika - wersja główna zadeklarowana przez właściciela strony, na przykład znacznikiem w kodzie. Przy omawianym statusie pole ma wartość „Brak”.
- Adres kanoniczny wybrany przez Google - adres, który wyszukiwarka faktycznie uznała za główny. To jest odpowiedź na pytanie, kto wygrał.
- Strona odsyłająca - strona, przez którą Google prawdopodobnie trafił na sprawdzany adres. Pole bywa puste, gdy narzędzie nie ma takich danych.
- Mapy witryn - informacja, czy adres znajduje się w którejś ze zgłoszonych map.
- Ostatnie skanowanie - moment ostatniego pobrania strony. Wszystkie dane w wyniku pochodzą z tej właśnie wersji.
Pole ze stroną odsyłającą jest często niedoceniane. Jeżeli kopia jest adresem z parametrem, a jako strona odsyłająca widnieje kategoria sklepu, to znaczy, że odnośnik do kopii znajduje się w Państwa własnym szablonie. Robot nie wymyślił tego adresu, tylko dostał go od strony.
Dwie uwagi z pomocy pozwalają uniknąć błędnych wniosków. Pole z adresem wybranym przez Google aktualizuje się czasem z opóźnieniem, więc bezpośrednio po zmianie w kodzie może jeszcze pokazywać stary stan. Z kolei test wersji opublikowanej, czyli sprawdzenie strony na żywo, nie obejmuje wyboru wersji kanonicznej: potwierdza dostęp Google do strony, a nie zmianę decyzji. Obsługę całego narzędzia opisaliśmy we wpisie o sprawdzaniu adresu URL w Search Console.
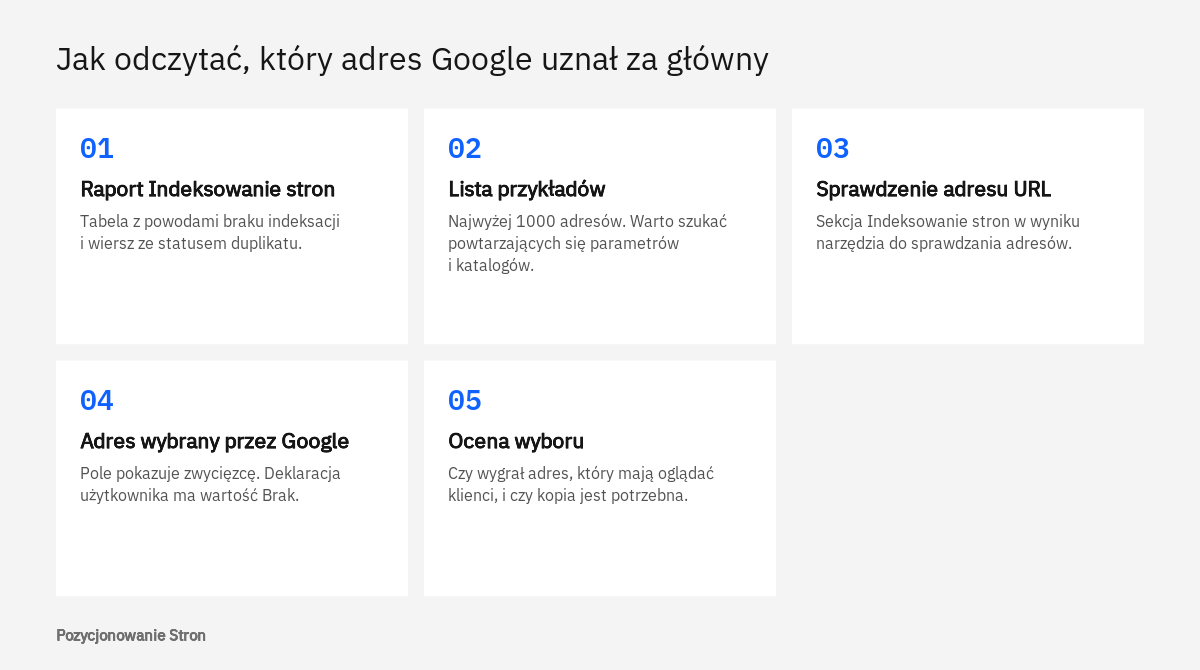
Po odczytaniu obu pól wystarczy odpowiedzieć na dwa pytania. Czy adres wybrany przez Google jest tym, który chcą Państwo pokazywać klientom? Czy sprawdzana kopia jest w ogóle potrzebna jako osobny adres? Jeśli wygrał właściwy adres, a kopia jest technicznym wariantem, sytuacja jest poprawna. Jeśli wygrał adres przypadkowy albo kopia miała być pełnoprawną podstroną, potrzebna jest poprawka.
Skąd biorą się adresy z tym statusem
Kopie powstają najczęściej bez udziału właściciela: wytwarza je system, na którym działa strona, albo sposób, w jaki do strony prowadzą odnośniki. Dokumentacja Google wymienia kilka typowych przyczyn: osobne adresy dla regionów z tą samą treścią w tym samym języku, osobne wersje dla telefonów i komputerów, równoległe wersje HTTP i HTTPS, funkcje witryny takie jak sortowanie i filtrowanie list oraz wersje przypadkowe, na przykład kopię testową serwisu dostępną dla robotów.
Do tego dochodzą kwestie opisane w zaleceniach Google dotyczących struktury adresów URL. W adresach rozróżniana jest wielkość liter, więc ta sama ścieżka zapisana wielkimi i małymi literami to dla wyszukiwarki dwa różne adresy. Parametry, które nie zmieniają treści, takie jak oznaczenia źródła wejścia czy identyfikatory sesji, tworzą kolejne warianty tej samej strony, a dokładanie filtrów potrafi zwiększać liczbę adresów lawinowo.
| Źródło kopii | Jak wygląda na liście przykładów | Typowe rozwiązanie |
|---|---|---|
| Parametry kampanii i śledzenia | Adres strony z dopiskiem po znaku zapytania | Znacznik rel="canonical" wskazujący adres bez parametrów |
| Sortowanie i filtry listy | Kategoria z parametrem kolejności lub zakresu | Znacznik rel="canonical" do kategorii podstawowej |
| Wersje HTTP i HTTPS, z www i bez www | Ta sama ścieżka w kilku wariantach początku adresu | Trwałe przekierowanie do jednej wersji |
| Wielkość liter w adresie | Ta sama ścieżka zapisana różnie | Jeden zapis w odnośnikach, przekierowanie pozostałych |
| Ten sam produkt w kilku kategoriach | Kilka ścieżek kończących się tą samą nazwą produktu | Jeden adres produktu jako główny, znacznik na pozostałych |
| Bardzo podobne podstrony ofertowe | Różne adresy, niemal ten sam tekst | Scalenie albo napisanie odrębnej treści |
Ostatni wiersz tabeli różni się od pozostałych. We wcześniejszych chodzi o tę samą stronę widoczną pod kilkoma adresami. W ostatnim są to rzeczywiście osobne podstrony, tyle że tak do siebie podobne, że Google połączył je w jedną grupę. Hipotetyczny przykład: hydraulik z Łodzi przygotowuje osobne podstrony dla kilkunastu dzielnic, różniące się wyłącznie nazwą dzielnicy w nagłówku. Dla czytelnika to jedna i ta sama oferta, więc wyszukiwarka może potraktować je podobnie. Tu znacznik w kodzie niczego nie załatwia, bo problemem jest treść, a nie adres.
Poszczególne źródła omawiamy w osobnych wpisach: o parametrach w adresach URL, o wyborze między adresem z www i bez www oraz o tym, jak uporządkować filtry w sklepie.
Kiedy status jest nieszkodliwy, a kiedy pokazuje bałagan
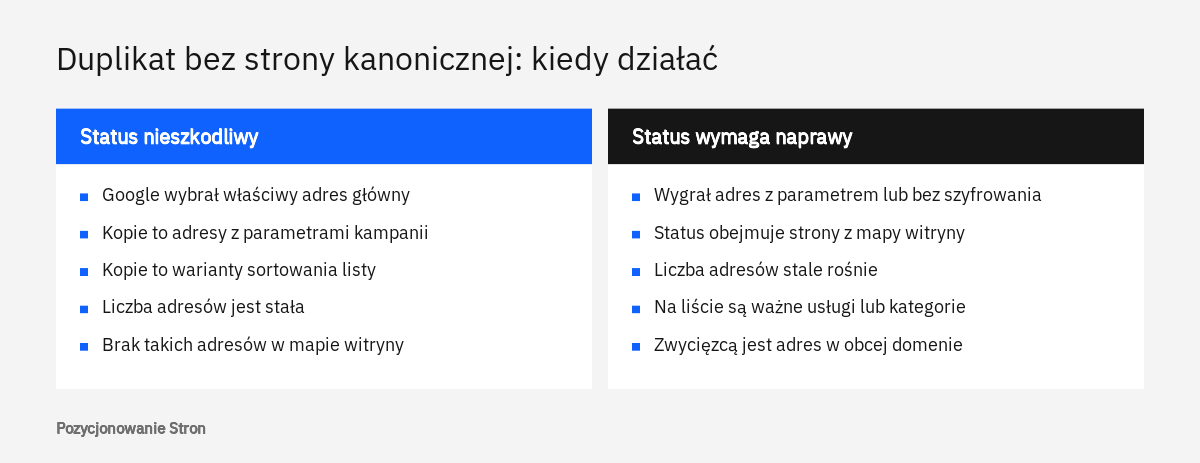
Status jest nieszkodliwy wtedy, gdy Google wybrał ten adres, który sami uznaliby Państwo za główny, a kopie są wariantami technicznymi. Pomoc Search Console mówi wprost, że stan braku indeksacji niekoniecznie jest czymś złym, a przy kopiach pomijanie ich w indeksie to działanie zgodne z zamierzeniami. Dokumentacja o wskazywaniu wersji głównej przyznaje zresztą, że strony kanonicznej zwykle nie trzeba ustawiać, bo bez wskazania Google sam dobiera najlepszy adres.
Niepokój jest uzasadniony w kilku sytuacjach. Pierwsza: wygrał niewłaściwy adres, na przykład wersja z parametrem zamiast czystego adresu kategorii albo wersja bez szyfrowania. Druga: status dotyczy adresów zgłoszonych w mapie witryny. Mapa powinna zawierać wyłącznie adresy, które mają być w indeksie, więc jeśli po przełączeniu filtra raportu na przesłane strony status nadal obejmuje wiele pozycji, w mapie znajdują się kopie. Trzecia: liczba adresów na wykresie rośnie w sposób ciągły, co zwykle oznacza, że serwis stale wytwarza nowe warianty. Czwarta: wśród przykładów są podstrony, które miały zdobywać ruch, czyli usługi, kategorie lub produkty.
Jest też powód mniej widoczny. Według dokumentacji strona kanoniczna jest odwiedzana przez robota najczęściej, a jej kopie rzadziej, ale nadal są odwiedzane. W małym serwisie nie ma to praktycznego znaczenia. W sklepie z dziesiątkami tysięcy wariantów adresów robot poświęca część pracy na strony, które i tak nie trafią do indeksu, o czym piszemy we wpisie o budżecie indeksowania.
Jeśli chcą Państwo zamówić audyt SEO, zachęcamy do kontaktu: tel. 222 500 844 lub mailowo: biuro@pozycjonowaniestron.pl
Naprawa znacznikiem rel="canonical"
Znacznik rel="canonical" jest właściwym rozwiązaniem wtedy, gdy kopia musi pozostać dostępna dla odwiedzających, ale w wynikach ma się pojawiać adres główny. Dotyczy to przede wszystkim adresów z parametrami kampanii, sortowania i filtrów: klient ma móc ustawić produkty od najtańszych, a Google ma wiedzieć, że to nadal ta sama kategoria. Po odczytaniu znacznika adres powinien przejść do statusu „Alternatywna strona zawierająca prawidłowy tag strony kanonicznej”, czyli do stanu pożądanego.
W dokumentacji o określaniu kanonicznego adresu URL Google zalicza ten znacznik do wyraźnych sygnałów. Umieszcza się go w części nagłówkowej kodu strony będącej kopią i podaje w nim pełny adres wersji głównej.
<link rel="canonical" href="https://www.example.com/buty-damskie/" />Z tej samej dokumentacji wynika kilka zasad, które decydują o tym, czy znacznik zadziała. Adres powinien być bezwzględny, czyli zapisany w całości, razem z protokołem i domeną. Znacznik warto umieścić także na samej wersji głównej, gdzie wskazuje sam siebie. Dzięki temu każdy wariant z dopisanym parametrem dziedziczy poprawne wskazanie, bo szablon wypisuje ten sam czysty adres niezależnie od dopisków. Nie należy wskazywać adresów z fragmentem, czyli częścią po znaku krzyżyka, ponieważ Google zasadniczo takich fragmentów nie obsługuje. W serwisach budujących stronę w przeglądarce za pomocą JavaScriptu znacznik powinien znajdować się w źródłowym kodzie HTML i nie być później podmieniany skryptem. Dla plików bez części nagłówkowej, takich jak dokumenty PDF, to samo wskazanie można przekazać w nagłówku HTTP wysyłanym przez serwer.
W WordPressie, WooCommerce i innych popularnych systemach znacznik wypisuje zwykle sam system lub wtyczka do SEO, więc zadanie sprowadza się do sprawdzenia, co faktycznie znajduje się w kodzie kopii, i do poprawienia ustawień. Dokumentacja o rozwiązywaniu problemów zwraca uwagę, że systemy zarządzania treścią i ich wtyczki potrafią wskazywać niepożądane adresy, dlatego kod warto obejrzeć w narzędziach deweloperskich przeglądarki zamiast polegać na samym panelu. Szczegóły wdrożenia opisaliśmy we wpisie o adresie kanonicznym.
Znacznik jest wskazówką, nie poleceniem
Google traktuje preferencje właściciela jako wskazówkę i może wybrać inną stronę. Dlatego znacznik powinien być zgodny z pozostałymi sygnałami. Dokumentacja wymienia dwa, o które najłatwiej zadbać: odnośniki wewnętrzne powinny prowadzić do adresu uznawanego za główny, a mapa witryny powinna zawierać ten sam adres, który wskazuje znacznik. Jeśli menu sklepu prowadzi do kategorii z parametrem, a znacznik wskazuje adres bez parametru, strona wysyła dwa różne komunikaty.
Naprawa przekierowaniem lub scaleniem podstron
Przekierowanie stosuje się wtedy, gdy kopia nie jest nikomu potrzebna jako osobny adres. Dokumentacja Google zastrzega, że jest to metoda na wycofanie duplikatu, czyli sytuację, w której odwiedzający ma trafić od razu na wersję główną. Tak postępuje się z równoległymi wersjami HTTP i HTTPS, z wariantem z www lub bez www, z adresami zapisanymi inną wielkością liter oraz ze starymi ścieżkami po przebudowie serwisu.
Znaczenie ma rodzaj przekierowania. Według dokumentacji Przekierowania a wyszukiwarka Google przekierowania trwałe, czyli kody 301 i 308, są sygnałem, że adres docelowy ma być kanoniczny, i to on pokazuje się w wynikach. Przekierowania tymczasowe, czyli kody 302, 303 i 307, takiego sygnału nie niosą, a w wynikach pozostaje strona źródłowa. Google najlepiej interpretuje przekierowania ustawione po stronie serwera, a rozwiązania oparte na znaczniku odświeżania lub na JavaScripcie traktuje jako wyjścia zastępcze. Różnice między kodami omawiamy we wpisie przekierowanie 301 a 302. Po wdrożeniu adres przechodzi do wiersza opisanego w pomocy jako strona zawierająca przekierowanie, co również jest stanem prawidłowym.
Osobnej uwagi wymaga protokół. Google domyślnie preferuje wersję szyfrowaną, ale dokumentacja wymienia sytuacje, w których może wybrać HTTP: nieprawidłowy certyfikat, przekierowanie z HTTPS na HTTP oraz znacznik kanoniczny na stronie HTTPS wskazujący wersję HTTP.
Scalenie podobnych podstron
Scalenie jest rozwiązaniem dla podstron, które są osobnymi dokumentami, ale mówią to samo. Wróćmy do hipotetycznego hydraulika z Łodzi i jego podstron dla dzielnic. Są dwie uczciwe drogi. Pierwsza to połączenie ich w jedną, pełną podstronę usługi z listą obsługiwanych dzielnic i trwałe przekierowanie starych adresów na nową. Druga to pozostawienie osobnych podstron tylko tam, gdzie da się napisać coś rzeczywiście odrębnego: inny zakres prac, inny czas dojazdu, inne typowe usterki w danej zabudowie.
Dokumentacja o rozwiązywaniu problemów z wyborem strony kanonicznej opisuje to wprost: strony w jednej grupie muszą się od siebie wystarczająco różnić, a wyraźna, znacząca różnica w treści zwykle przyspiesza ich rozdzielenie. Zmiana jednego słowa w nagłówku taką różnicą nie jest. Podobny kłopot miewają serwisy z wersjami dla kilku krajów w tym samym języku, dla których Google zaleca połączenie wskazania wersji kanonicznej z oznaczeniami hreflang, czyli informacją o języku i regionie danej wersji. Tłumaczenia tej samej strony na różne języki nie są natomiast traktowane jako kopie.
Typowe pomyłki przy usuwaniu tego statusu
Najczęstsza pomyłka to sięganie po narzędzia, które kopię ukrywają, zamiast wskazać wersję główną. Dokumentacja Google wymienia trzy takie sposoby i wszystkie odradza.
Pierwszy to blokada w pliku robots.txt. Robot nie pobierze zablokowanej strony, więc nie zobaczy na niej ani znacznika, ani przekierowania, a sam adres może mimo to trafić do indeksu, tyle że bez treści. Drugi to dyrektywa noindex stosowana po to, by rozstrzygnąć, która wersja ma być główna w obrębie jednej witryny. Google wskazuje, że lepszym wyborem jest tu znacznik kanoniczny. Trzeci to narzędzie do usuwania adresów w Search Console, które ukrywa w wynikach wszystkie wersje strony, a więc także tę właściwą. Różnice między tymi mechanizmami wyjaśniamy we wpisie canonical, noindex i robots.txt.
Druga grupa pomyłek to sprzeczne sygnały. Znacznik wskazuje jeden adres, mapa witryny zawiera inny, a odnośniki w menu prowadzą do trzeciego. Dokumentacja zaleca, by nie podawać różnych adresów kanonicznych dla tej samej strony różnymi metodami. Porządkowanie warto więc zacząć od ustalenia jednej postaci adresu dla całego serwisu: z jednym protokołem, jednym wariantem domeny i jednym sposobem zapisu ścieżki, a dopiero potem dopasować do niej znaczniki, mapę i linkowanie.
Trzecia pomyłka to wskazywanie wersji głównej tam, gdzie strony wcale nie są kopiami. Zdarza się, że właściciel chce pozbyć się komunikatu i ustawia na kilkunastu różnych podstronach znacznik prowadzący do strony głównej serwisu. Komunikat może zniknąć, ale razem z nim mogą zniknąć z wyników podstrony, które przyciągały klientów. Znacznik służy do łączenia wersji tej samej treści, a nie do porządkowania raportu.
Co zrobić po naprawie i ile to trwa
Po wdrożeniu poprawek należy potwierdzić, że Google je widzi, a następnie zgłosić zmianę w raporcie i poczekać na ponowne skanowanie. Kolejność ma znaczenie, ponieważ zgłoszenie poprawki, której robot nie jest w stanie odczytać, kończy się niepowodzeniem weryfikacji.
- Kontrola kodu kopii
Na kilku adresach z listy przykładów warto obejrzeć źródło strony i potwierdzić, że znacznik zawiera pełny, poprawny adres wersji głównej albo że adres przekierowuje jednym krokiem.
- Test wersji opublikowanej
W narzędziu do sprawdzania adresów URL test na żywo pokaże, czy Google ma dostęp do poprawionej strony. Decyzji o wyborze wersji głównej ten test nie obejmuje.
- Zgłoszenie poprawki w raporcie
W szczegółach statusu znajduje się przycisk uruchamiający weryfikację poprawki. Pomoc zaleca użyć go dopiero po naprawieniu wszystkich wystąpień i nie klikać ponownie przed zakończeniem weryfikacji.
- Prośba o zindeksowanie najważniejszych adresów
Dla kilku kluczowych stron można złożyć prośbę o ponowne zindeksowanie. Liczba zgłoszeń jest ograniczona, więc przy większej liczbie adresów lepiej przesłać zaktualizowaną mapę witryny.
Co do czasu: pomoc Search Console podaje, że weryfikacja poprawki trwa zazwyczaj do około dwóch tygodni, a w niektórych przypadkach znacznie dłużej, i kończy się powiadomieniem o wyniku. Dokumentacja o rozwiązywaniu problemów dodaje, że Google może utrzymywać strony w jednej grupie nawet do dwóch tygodni po naprawie. Raport zmienia się dopiero po ponownym odwiedzeniu adresów przez robota, dlatego cofanie poprawnej zmiany po kilku dniach tylko wydłuża cały proces. Zasady przygotowania mapy opisujemy we wpisie o mapie witryny XML.
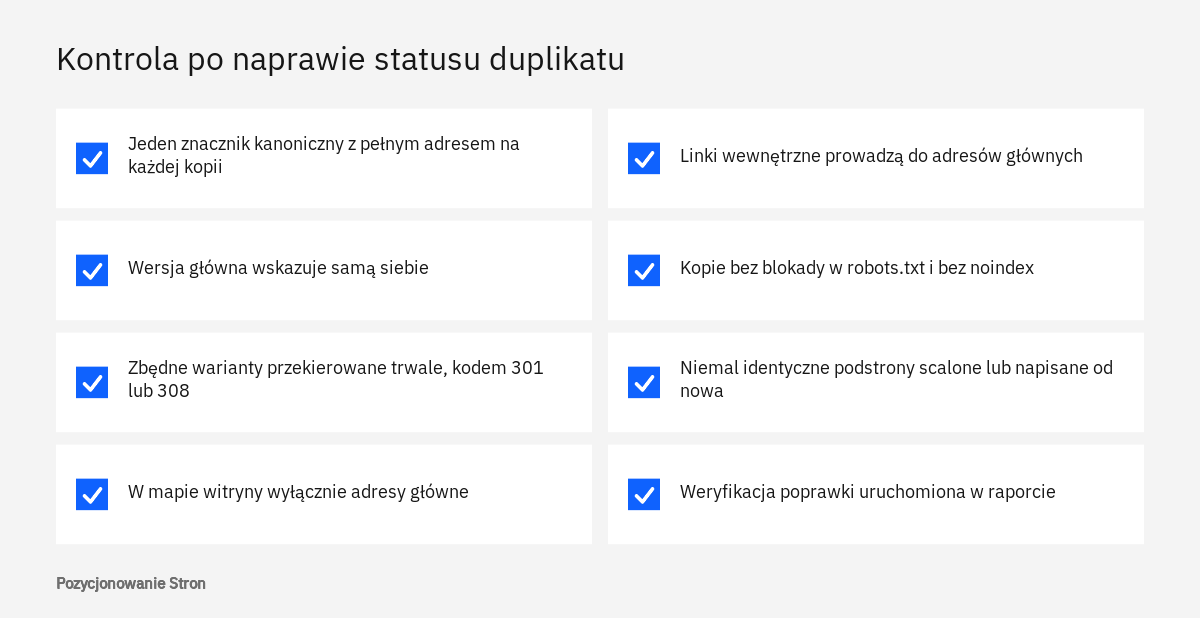
- Na każdej kopii, która ma pozostać dostępna, znajduje się jeden znacznik rel="canonical" z pełnym adresem wersji głównej.
- Wersja główna zawiera znacznik wskazujący samą siebie.
- Zbędne warianty adresu przekierowują trwale, kodem 301 lub 308.
- Mapa witryny zawiera wyłącznie adresy główne, w wersji szyfrowanej.
- Menu, stopka i odnośniki w treści prowadzą do adresów głównych.
- Kopie nie są zablokowane w pliku robots.txt ani oznaczone dyrektywą noindex.
- Podstrony o niemal identycznej treści zostały scalone albo napisane od nowa.
Celem nie jest pusty wiersz w raporcie. W serwisie z filtrami, sortowaniem i kampaniami reklamowymi adresy pomijane jako kopie będą występować zawsze i jest to stan poprawny. Chodzi o to, by każda ważna treść miała jeden adres główny i by wybrał go właściciel, a nie przypadek.
Kiedy potrzebna jest pomoc specjalisty
Pojedyncze adresy z parametrami w małym serwisie firmowym da się zwykle opanować samodzielnie, ustawieniami systemu lub wtyczki. Wsparcie przydaje się, gdy status obejmuje tysiące adresów i ich liczba rośnie, gdy źródłem są filtry sklepu i trzeba zdecydować, które kombinacje mają być osobnymi stronami, gdy zwycięskim adresem jest obca domena albo gdy mimo poprawnego znacznika Google konsekwentnie wybiera inny adres.
Porządkowanie adresów jest częścią prac, które prowadzimy w ramach SEO technicznego, a pełny obraz przyczyn daje audyt SEO, w którym dane z raportu zestawiamy ze skanem całej witryny. W sklepach uwzględniamy to zagadnienie również przy pozycjonowaniu sklepów.
Jeśli chcą Państwo zamówić audyt SEO, zachęcamy do kontaktu: tel. 222 500 844 lub mailowo: biuro@pozycjonowaniestron.pl
Najczęstsze pytania
Czy ten status oznacza karę od Google?
Nie. Dokumentacja Google stwierdza, że powielona treść w serwisie jest zjawiskiem normalnym i sama w sobie nie narusza zasad dotyczących spamu. Status informuje jedynie, że z grupy podobnych adresów do indeksu trafił inny niż sprawdzany.
Czy trzeba naprawiać każdy adres z tym statusem?
Nie trzeba. Jeżeli Google wybrał właściwy adres główny, a kopie są wariantami technicznymi, sytuacja jest poprawna. Działanie jest potrzebne, gdy wygrał niewłaściwy adres, gdy status dotyczy stron z mapy witryny albo gdy liczba kopii stale rośnie.
Gdzie widać, który adres Google uznał za główny?
W narzędziu do sprawdzania adresów URL w Search Console, w sekcji Indeksowanie stron. Zwycięski adres pokazuje pole „Adres kanoniczny wybrany przez Google”, a pole z adresem określonym przez użytkownika ma przy tym statusie wartość „Brak”.
Czym ten status różni się od komunikatu, że Google wybrał inną stronę kanoniczną niż użytkownik?
Różnica dotyczy deklaracji. Przy omawianym statusie na stronie nie ma żadnego wskazania wersji głównej. Przy drugim komunikacie wskazanie istnieje, ale Google uznał, że inny adres lepiej nadaje się na główny.
Czy wystarczy zablokować kopie w pliku robots.txt?
Google odradza tę metodę. Zablokowany adres nadal może znaleźć się w indeksie, tylko bez treści, a robot nie odczyta na nim znacznika ani przekierowania. Do wskazania wersji głównej służą znacznik rel="canonical" i trwałe przekierowanie.
Czy znacznik kanoniczny gwarantuje, że Google wybierze wskazany adres?
Nie gwarantuje. Google traktuje go jako wyraźny sygnał, ale nadal jako wskazówkę, i bierze pod uwagę także przekierowania, protokół oraz mapę witryny. Im bardziej te sygnały są ze sobą zgodne, tym większa szansa, że wybór będzie taki sam jak Państwa.
Źródła
- Raport Indeksowanie stron, Search Console - pomoc
- Narzędzie do sprawdzania adresów URL, Search Console - pomoc
- Co to jest wybór strony kanonicznej, Centrum wyszukiwarki Google
- Jak określić kanoniczny URL za pomocą rel="canonical" i innych metod, Centrum wyszukiwarki Google
- Rozwiązywanie problemów z wyborem strony kanonicznej, Centrum wyszukiwarki Google
- Przekierowania a wyszukiwarka Google, Centrum wyszukiwarki Google
- Sprawdzone metody tworzenia struktury adresów URL na potrzeby wyszukiwarki Google, Centrum wyszukiwarki Google
Funkcje wyszukiwarek i asystentów AI zmieniają się szybko, dlatego wpis aktualizujemy po większych zmianach.