Google ocenia i zapisuje w indeksie przede wszystkim to, co pobierze robot udający telefon. Jeśli na wersji mobilnej brakuje akapitu, nagłówka, zdjęcia albo znacznika, dla wyszukiwarki tego elementu po prostu nie ma - nawet gdy na komputerze wszystko wygląda wzorowo. Poniżej opisujemy, co musi znaleźć się na wersji na telefon, jak ustalić, którym robotem Google odwiedza Państwa witrynę, i jakie braki najczęściej kosztują widoczność.
Czym jest indeksowanie mobilne i co z niego wynika
Indeksowanie mobilne oznacza, że Google bierze pod uwagę przede wszystkim tę wersję strony, którą dostaje telefon. W dokumentacji Google Search Central zapisano to wprost: do indeksowania i do rankingu wyszukiwarka używa mobilnej wersji treści witryny, zeskanowanej przez klienta udającego smartfon. Google nazywa to indeksowaniem zoptymalizowanym pod kątem urządzeń mobilnych, a w branży spotyka się także angielskie określenie mobile-first indexing, czyli indeksowanie z pierwszeństwem wersji mobilnej.
Sposób działania Google, w którym podstawą do zapisania strony w indeksie i do ustalenia jej pozycji jest treść widoczna dla robota udającego telefon, a nie treść wersji na komputer.
Skoro podstawą oceny jest wersja mobilna, skutki jej braków nie ograniczają się do osób szukających na telefonach. To najważniejsza konsekwencja całej zasady: skrócenie tekstu na małym ekranie może odbić się na widoczności całej podstrony.
Robot Google, czyli Googlebot, występuje w dwóch odmianach. Według strony opisującej Googlebota jedna symuluje użytkownika urządzenia mobilnego, druga użytkownika komputera, przy czym większość żądań wykonuje odmiana na smartfony, a mniejszość odmiana komputerowa. Wizyty robota komputerowego w logach serwera nie są więc niczym niepokojącym - pojawiają się nadal, tylko rzadziej.
Google zdecydowanie zaleca posiadanie wersji przystosowanej do telefonów, ale dokumentacja zaznacza też, że strony bez takiej wersji również mogą pojawiać się w wynikach. Brak wersji mobilnej nie oznacza zatem automatycznego usunięcia z wyszukiwarki. Oznacza natomiast, że robot udający telefon ogląda stronę zaprojektowaną dla dużego ekranu.
Warto od razu oddzielić dwie sprawy, które często się mylą. Wygoda korzystania ze strony na telefonie, czyli wielkość przycisków, czytelność pisma czy układ menu, to temat projektowy. Indeksowanie mobilne dotyczy czegoś innego: kompletności tego, co wersja na telefon zawiera w kodzie. Strona może być wygodna i ładna, a jednocześnie pozbawiona połowy opisów, które widać na komputerze.
Trzy sposoby budowy wersji na telefon i ryzyko każdego z nich
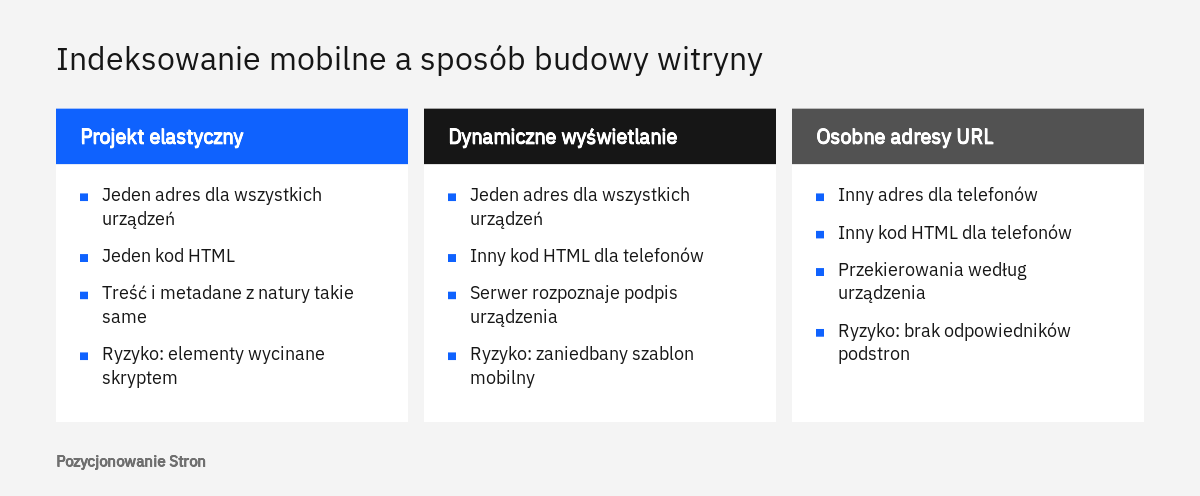
Ryzyko rozbieżności między wersjami zależy od tego, jak witryna została zbudowana. Dokumentacja Google wymienia trzy konfiguracje: projekt elastyczny, dynamiczne wyświetlanie treści oraz osobne adresy URL. W pierwszej z nich treść i metadane są z natury takie same, a szczegółowe zalecenia Google dotyczą przede wszystkim dwóch pozostałych.
Projekt elastyczny, nazywany też responsywnym, wysyła ten sam kod HTML pod tym samym adresem każdemu urządzeniu, a arkusze stylów jedynie inaczej układają elementy na ekranie. Google zaleca właśnie to rozwiązanie jako najłatwiejsze we wdrożeniu i utrzymaniu. Dynamiczne wyświetlanie treści zachowuje jeden adres, ale serwer rozpoznaje urządzenie po nagłówku user-agent, czyli podpisie przeglądarki, i wysyła telefonom inny kod niż komputerom. Trzeci wariant to osobny adres dla telefonów, zwykle w subdomenie zaczynającej się od litery m, na który serwer przekierowuje odwiedzających z urządzeń mobilnych.
| Konfiguracja | Adres i kod | Skąd biorą się braki |
|---|---|---|
| Projekt elastyczny | Jeden adres, jeden kod HTML dla wszystkich urządzeń | Elementy wycinane skryptem na wąskim ekranie albo treść doładowywana dopiero po działaniu użytkownika |
| Dynamiczne wyświetlanie treści | Jeden adres, inny kod HTML zależnie od urządzenia | Szablon mobilny rozwijany osobno i z opóźnieniem względem komputerowego |
| Osobne adresy URL | Inny adres i inny kod dla telefonów | Brak odpowiedników podstron, błędne przekierowania, inne znaczniki i reguły dla robotów |
Projekt elastyczny nie zwalnia jednak z kontroli. Zdarza się, że motyw strony zawiera dwa osobne bloki dla tej samej sekcji, jeden dla dużych ekranów i jeden dla małych, a redaktor uzupełnia tylko ten pierwszy. Zdarza się też, że dodatek do sklepu usuwa z kodu długi opis kategorii, gdy wykryje wąski ekran. Adres jest wtedy jeden, a mimo to robot mobilny dostaje uboższą stronę. Ustalenie, którą konfigurację ma dana witryna i gdzie powstają różnice, jest jednym z elementów, które obejmuje audyt SEO.
Ta sama treść i te same nagłówki na telefonie i na komputerze
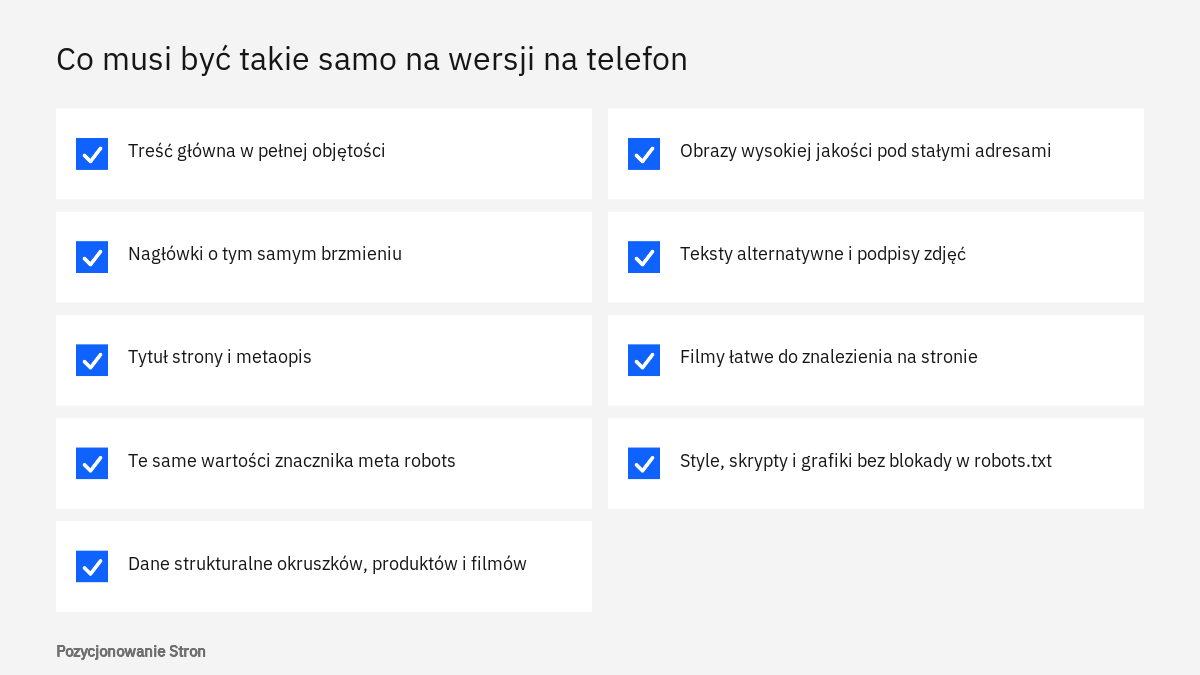
Wersja mobilna powinna zawierać tę samą treść główną co wersja na komputer. Dokumentacja Google ostrzega wprost: jeśli wersja mobilna ma mniej treści niż komputerowa, trzeba liczyć się ze spadkiem ruchu, ponieważ wyszukiwarka nie uzyska z niej tylu informacji co wcześniej. Indeksowane jest wyłącznie to, co pokazano na wersji mobilnej.
Nie oznacza to, że układ musi być identyczny. Google dopuszcza przeniesienie treści do zakładek i rozwijanych bloków, tak zwanych akordeonów, jeśli pomaga to zmieścić materiał na małym ekranie. Warunek jest jeden: tekst ma być obecny w kodzie strony od razu po jej załadowaniu, a kliknięcie ma go jedynie odsłaniać. Zupełnie inaczej wygląda sytuacja, w której kliknięcie dopiero pobiera tekst z serwera - o tym piszemy niżej.
Dla zobrazowania można wyobrazić sobie kancelarię z Krakowa, której podstrona o prawie spadkowym ma na komputerze kilkanaście akapitów, a na telefonie trzy zdania i przycisk z numerem telefonu, bo ktoś uznał, że na małym ekranie nikt nie czyta. W indeksie Google taka podstrona składa się z trzech zdań. Podobnie hipotetyczny sklep z Poznania, który na telefonie ukrywa tabelę parametrów produktu i sekcję pytań kupujących, sam odbiera sobie szansę na wyświetlenia przy zapytaniach o te parametry.
Nagłówki
Google zaleca, by na wersji mobilnej stosować te same czytelne i treściwe nagłówki co na komputerze. W praktyce różnice powstają na dwa sposoby. Pierwszy to skracanie nagłówków, żeby zmieściły się w jednym wierszu, przez co znika z nich nazwa usługi lub miejscowość. Drugi to zamiana znaczników nagłówków na zwykłe bloki tekstu w szablonie mobilnym, przez co strona traci czytelną strukturę. Jeżeli nagłówek jest za długi na mały ekran, lepiej zmniejszyć stopień pisma w arkuszu stylów, niż zmieniać jego brzmienie.
Co wolno uprościć
Zalecenie Google mówi o treści głównej, czyli o tym, po co użytkownik przychodzi na daną podstronę. Z naszej praktyki wynika, że bez szkody dla widoczności można zmieniać formę elementów pobocznych: zwinąć menu do ikony, przenieść pasek boczny pod tekst, zamienić szeroką tabelę na przewijaną w poziomie. To obserwacja agencji, a nie zapis z dokumentacji. Bezpieczna zasada brzmi: zmienia się układ i sposób prezentacji, nie zasób informacji.
Metadane, dyrektywy dla robotów i dostęp do zasobów
Tytuł strony i metaopis muszą być równoważne w obu wersjach, a znaczniki sterujące robotami - takie same. To wymaganie dotyczy elementów, których nie widać na ekranie, dlatego rozbieżności potrafią trwać miesiącami niezauważone.
Element title oraz znacznik meta description w szablonie mobilnym powinny mieć to samo brzmienie co w komputerowym. Wśród błędów opisanych przez Google znajdują się dwa osobne przypadki: brak tytułu strony i brak metaopisu w wersji mobilnej. Spotyka się je głównie tam, gdzie wersja na telefon ma własny, uproszczony szablon nagłówka dokumentu.
Najgroźniejsza pomyłka dotyczy znacznika meta robots. Google wymaga tych samych wartości w obu wersjach i ostrzega, że dyrektywa noindex lub nofollow umieszczona tylko w wersji mobilnej może sprawić, że strona nie zostanie zeskanowana ani zindeksowana. Typowy scenariusz: wersja mobilna powstawała jako testowa, dostała blokadę indeksowania, a po uruchomieniu nikt jej nie zdjął. Działanie poszczególnych dyrektyw opisujemy we wpisie o znaczniku meta robots.
Kod wysłany komputerowi:
<meta name="robots" content="index, follow">

Kod wysłany telefonowi:
<meta name="robots" content="noindex, nofollow">
Plik robots.txt
Google prosi, by nie blokować w pliku robots.txt zasobów potrzebnych do wyświetlenia strony, zwłaszcza gdy wersja mobilna pobiera arkusze stylów, skrypty lub obrazy z innych adresów niż komputerowa. Zablokowany arkusz stylów albo skrypt sprawia, że robot widzi stronę inaczej niż człowiek, a zablokowany katalog z miniaturami odcina obrazy.
Warto też wiedzieć, że obie odmiany Googlebota posługują się w robots.txt tym samym oznaczeniem. Jak podaje opis Googlebota, nie da się napisać reguły wyłącznie dla robota na smartfony albo wyłącznie dla komputerowego. Każdy zakaz dla Googlebota dotyczy więc obu naraz. Szerzej o budowie tego pliku piszemy w tekście o tym, jak napisać plik robots.txt.
Treść ładowana dopiero po działaniu użytkownika
Google nie pobierze treści, która pojawia się dopiero po przesunięciu palcem, kliknięciu lub wpisaniu tekstu. Dokumentacja indeksowania mobilnego zakazuje leniwego ładowania treści głównej po interakcji, a osobna strona o naprawianiu leniwie ładującej się zawartości wyjaśnia powód: wyszukiwarka nie przewija strony i nie klika w jej elementy.
Poprawne leniwe ładowanie wczytuje treść w chwili, gdy znajdzie się ona w widocznym obszarze, a nie w reakcji na gest. Google wymienia trzy bezpieczne sposoby: mechanizm wbudowany w przeglądarkę dla obrazów i ramek, interfejs IntersectionObserver, który pozwala skryptowi wykryć wejście elementu w pole widzenia, oraz bibliotekę JavaScript obsługującą ładowanie danych z widocznego obszaru. Na telefonach problem jest częstszy niż na komputerach, bo to właśnie w szablonach mobilnych projektanci chętnie dodają przyciski doczytujące dalszą część opisu czy kolejne opinie. Techniczne szczegóły omówiliśmy we wpisie o leniwym ładowaniu obrazów i ramek.
Jest jeszcze ograniczenie wielkości. Googlebot pobiera pierwsze 2 MB pliku HTML liczone bez kompresji, a po przekroczeniu tej granicy przerywa pobieranie i przekazuje do indeksowania tylko pobraną część. Strony mobilne, które wklejają w kod ogromne bloki stylów, skryptów i grafik zapisanych jako tekst, potrafią zbliżyć się do tej wartości, przez co właściwa treść z końca dokumentu może nie zostać odczytana.
Jeśli chcą Państwo zamówić SEO techniczne, zachęcamy do kontaktu: tel. 222 500 844 lub mailowo: biuro@pozycjonowaniestron.pl
Dane strukturalne, obrazy i filmy na wersji mobilnej
Dane strukturalne, obrazy i filmy podlegają tej samej regule co tekst: liczą się te, które są na wersji na telefon. Znaczniki obecne tylko w szablonie komputerowym przestają działać, a zdjęcia pominięte na telefonie nie trafiają do wyszukiwarki grafiki.
Dane strukturalne
Dane strukturalne to opis zawartości strony zapisany w kodzie w sposób zrozumiały dla wyszukiwarki, najczęściej w formacie JSON-LD, który Google wskazuje jako zalecany we wprowadzeniu do uporządkowanych danych. Obie wersje strony powinny zawierać te same znaczniki. Gdyby trzeba było ustalić kolejność uzupełniania, dokumentacja indeksowania mobilnego podaje trzy typy, od których należy zacząć: Breadcrumb, czyli okruszki nawigacyjne, Product, czyli produkt, oraz VideoObject, czyli film.
Drugi wymóg dotyczy adresów zapisanych wewnątrz znaczników. Na wersji mobilnej mają one prowadzić do adresów mobilnych. Ma to znaczenie wyłącznie przy osobnych adresach dla telefonów, ale tam bywa źródłem błędów, bo kod danych strukturalnych często jest kopiowany z szablonu komputerowego bez zmian. Dobór typów dla firmy opisaliśmy we wpisie o danych strukturalnych schema.org.
Obrazy
Google oczekuje na wersji mobilnej obrazów wysokiej jakości, w obsługiwanym formacie i osadzonych obsługiwanym znacznikiem. Obrazy zbyt małe lub o niskiej rozdzielczości są traktowane jako problem jakości. Adres obrazu nie powinien zmieniać się przy każdym wczytaniu strony, bo wyszukiwarka nie jest wtedy w stanie poprawnie przetworzyć i zindeksować pliku. Tekst alternatywny, tytuły, podpisy i nazwy plików mają być tak samo opisowe jak na komputerze.
Jeśli wersja mobilna pobiera obrazy z innych adresów niż komputerowa, Google uprzedza o możliwym przejściowym spadku ruchu z wyszukiwarki grafiki, ponieważ nowe adresy są dla wyszukiwarki nowymi plikami i potrzebuje ona czasu, by je poznać. Stosowanie tych samych adresów obrazów w obu wersjach usuwa ten kłopot. Więcej o opisach i formatach plików znajdą Państwo w tekście o obrazach na stronie a SEO.
Filmy i reklamy
Dla filmów zalecenia są analogiczne: stały adres pliku, obsługiwany format i znacznik oraz te same dane strukturalne w obu wersjach. Dochodzi jedna rzecz typowa dla telefonów, czyli położenie. Film powinien być łatwy do znalezienia na stronie mobilnej, a jeśli odwiedzający musi długo przewijać, zanim do niego dotrze, może to zaszkodzić pozycji filmu. Google zwraca też uwagę na reklamy: duża reklama u góry strony zajmuje na telefonie znacznie większą część ekranu niż na komputerze, dlatego rozmieszczenie reklam nie może szkodzić ocenie wersji mobilnej.
Przy pierwszej kontroli wystarczy porównać po jednej podstronie każdego rodzaju: stronę główną, kategorię, kartę produktu lub usługi i wpis na blogu. Rozbieżności wynikają z szablonu, więc błąd znaleziony na jednej karcie produktu zwykle dotyczy wszystkich.
Jak sprawdzić, którym robotem Google odwiedza witrynę
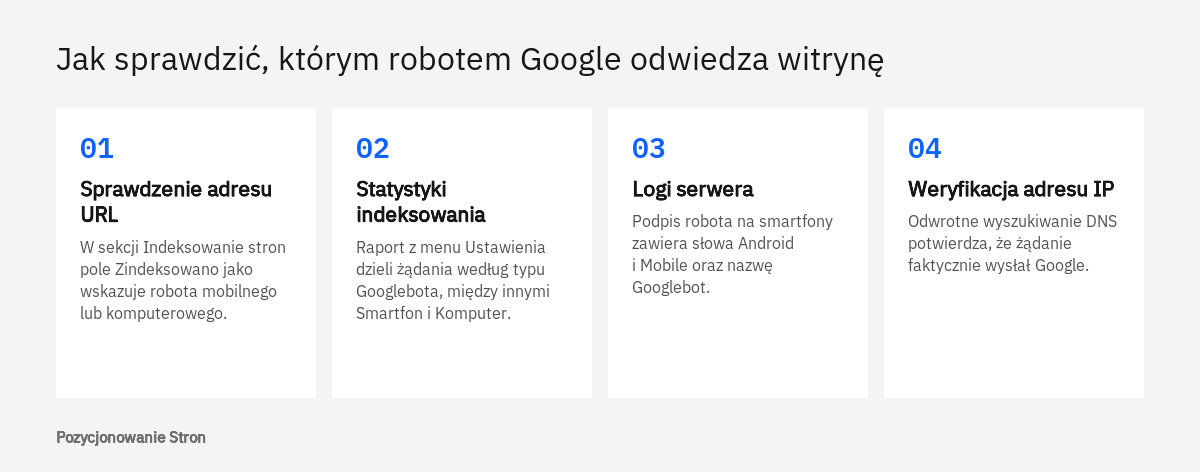
Rodzaj robota można odczytać w trzech miejscach: w narzędziu do sprawdzania adresów URL w Search Console, w raporcie Statystyki indeksowania oraz w logach serwera. Dwa pierwsze wymagają jedynie dostępu do konta Search Console, trzecie - dostępu do hostingu.
Pole Zindeksowano jako
W Search Console należy wkleić adres podstrony w pole wyszukiwania na górze ekranu. Według pomocy narzędzia do sprawdzania adresów URL w sekcji Indeksowanie stron znajduje się pole Zindeksowano jako, które pokazuje, czy stronę pobrał robot komputerowy, czy mobilny. W tej samej sekcji widać także pola Ostatnie skanowanie, Czy skanowanie jest dozwolone, Pobranie strony oraz Czy indeksowanie jest dozwolone. Całe narzędzie omawiamy we wpisie o sprawdzaniu adresu URL w Search Console.
Raport Statystyki indeksowania
Pojedynczy adres pokazuje jedną wizytę, a raport Statystyki indeksowania pokazuje całość ruchu robotów. Otwiera się go z menu Ustawienia w Search Console. Pomoc Search Console podaje, że raport jest dostępny dla usług domeny oraz usług z prefiksem adresu na najwyższym poziomie. Jedno z zestawień dzieli żądania według typu Googlebota: Smartfon, Komputer, Obraz, Wideo, Ładowanie zasobu strony, AdsBot, StoreBot oraz Inny typ klienta. Przy indeksowaniu mobilnym pozycja Smartfon powinna wyraźnie przeważać nad pozycją Komputer.
Logi serwera
W logach serwera każda wizyta ma zapisany podpis przeglądarki lub robota. Lista typowych robotów Google podaje pełne brzmienie obu podpisów Googlebota.
Googlebot na smartfony:
Mozilla/5.0 (Linux; Android 6.0.1; Nexus 5X Build/MMB29P) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/W.X.Y.Z Mobile Safari/537.36 (compatible; Googlebot/2.1; +http://www.google.com/bot.html)

Googlebot na komputery:
Mozilla/5.0 AppleWebKit/537.36 (KHTML, like Gecko; compatible; Googlebot/2.1; +http://www.google.com/bot.html) Chrome/W.X.Y.Z Safari/537.36
Odmianę mobilną odróżniają słowa Android i Mobile. Numer wersji Chrome w podpisie zmienia się wraz z aktualizacjami robota, dlatego przy przeszukiwaniu logów Google radzi stosować symbole wieloznaczne zamiast konkretnego numeru. Podpis można sfałszować, więc sam napis Googlebot niczego nie dowodzi. Pewność daje dopiero odwrotne wyszukiwanie DNS adresu IP, z którego przyszło żądanie, albo porównanie go z opublikowanymi przez Google zakresami adresów.
Jeżeli pole Zindeksowano jako wskazuje robota na smartfony, a w statystykach przeważa Smartfon, witryna jest oceniana na podstawie wersji mobilnej i każdy brak w tej wersji ma bezpośrednie skutki. Jeżeli wskazany jest robot komputerowy, warto sprawdzić, czy strona w ogóle wyświetla się na telefonie i czy serwer nie odrzuca żądań z podpisem mobilnym.
Jak porównać to, co Google widzi na telefonie, z wersją na komputer
Najpewniejszy obraz daje test wersji opublikowanej w narzędziu do sprawdzania adresów URL, ponieważ pokazuje kod strony po wykonaniu skryptów, tak jak odbiera go robot. Oglądanie strony na własnym telefonie nie wystarcza: człowiek przewija i klika, a robot tego nie robi.
- Uruchomienie testu wersji opublikowanej
Po sprawdzeniu adresu w Search Console w prawym górnym rogu wyniku znajduje się przycisk uruchamiający test adresu w wersji opublikowanej. W sekcji Dostępność pojawi się pole Zindeksowano jako z typem robota użytego w teście.
- Otwarcie przetestowanej strony
Odnośnik służący do wyświetlenia przetestowanej strony otwiera panel z kodem HTML, zrzutem ekranu oraz listą załadowanych zasobów.
- Wyszukanie fragmentów w kodzie
W kodzie HTML warto wyszukać zdanie z końca opisu, treść nagłówków, słowo robots, nazwę typu danych strukturalnych oraz adresy najważniejszych zdjęć.
- Porównanie ze źródłem strony na komputerze
Te same fragmenty należy odnaleźć w źródle strony otwartej na komputerze. Każdy element obecny tylko tam jest brakiem do uzupełnienia.
Zrzut ekranu jest dostępny wyłącznie w teście wersji opublikowanej zakończonym powodzeniem, a nie dla wersji zapisanej w indeksie. Dla obrazów i filmów ładowanych leniwie Google podaje prosty sprawdzian: jeśli ich adresy widnieją w atrybucie src w wyrenderowanym kodzie, ładowanie działa prawidłowo.
Dane strukturalne wygodnie sprawdza się w Teście wyników z elementami rozszerzonymi. Jak podaje pomoc tego narzędzia, pod polem na adres znajduje się opcjonalny wybór klienta użytkownika, czyli smartfona lub komputera, a domyślnie ustawiony jest smartfon. Dwa testy tej samej podstrony, po jednym dla każdego klienta, pokazują, czy wersja mobilna ma komplet znaczników.
- Ostatni akapit opisu jest obecny w kodzie wersji mobilnej bez klikania i przewijania.
- Nagłówki mają to samo brzmienie i te same znaczniki co na komputerze.
- Tytuł strony, metaopis i znacznik meta robots są zgodne w obu wersjach.
- Dane strukturalne występują w obu wersjach i przechodzą test bez błędów.
- Zdjęcia mają te same adresy i teksty alternatywne.
- Lista załadowanych zasobów nie zawiera plików zablokowanych w robots.txt.
Osobne adresy mobilne: dodatkowe zasady
Witryna z osobnym adresem dla telefonów musi spełnić wszystkie opisane wyżej wymagania i kilka dodatkowych, bo utrzymuje w praktyce dwa serwisy, które mają być swoim lustrzanym odbiciem. Podstawą jest wzajemne powiązanie obu wersji: strona komputerowa wskazuje samą siebie jako adres kanoniczny i informuje o odpowiedniku mobilnym, a strona mobilna wskazuje jako kanoniczny adres komputerowy.
Na stronie https://example.com/:
<link rel="canonical" href="https://example.com/">
<link rel="alternate" media="only screen and (max-width: 640px)" href="https://m.example.com/">

Na stronie https://m.example.com/:
<link rel="canonical" href="https://example.com/">
Kolejne zalecenia dotyczą zgodności zachowania obu wersji. Stan błędu ma być taki sam: jeżeli adres komputerowy zwraca normalną treść, a mobilny stronę błędu, podstrona nie trafi do indeksu. Adresy mobilne nie powinny zawierać fragmentów, czyli części po znaku kratki, ponieważ takie adresy zwykle nie są indeksowane. Każda strona komputerowa z odrębną treścią potrzebuje własnego odpowiednika mobilnego. Gdy wiele adresów komputerowych przekierowuje telefony na jedną stronę mobilną, na przykład na stronę główną, wszystkie te podstrony mogą zostać pominięte w indeksie.
Reguły w pliku robots.txt powinny działać jednakowo dla obu adresów. Przy wersjach językowych znaczniki hreflang łączą strony mobilne z mobilnymi, a komputerowe z komputerowymi - o samym mechanizmie piszemy w tekście o hreflang i wersjach językowych. Google radzi też obserwować w Search Console obie wersje oraz zadbać o wydajność serwera obsługującego adres mobilny, bo to on przyjmuje większość wizyt robota.
Najczęstsze braki, które obniżają widoczność
Najczęściej szkodzą nie spektakularne awarie, lecz ciche różnice między szablonami: krótszy opis, brak znaczników, zablokowany plik. Google zebrał je w dokumentacji w sekcji o rozwiązywaniu problemów, a tabela porządkuje najważniejsze z nich.
| Brak na wersji mobilnej | Skutek | Co zrobić |
|---|---|---|
| Skrócona treść główna | Mniej informacji w indeksie, możliwy spadek ruchu | Przywrócić pełny tekst, w razie potrzeby w rozwijanych blokach |
| Dyrektywa noindex | Podstrona nie trafia do indeksu | Ujednolicić znaczniki meta robots |
| Brak danych strukturalnych | Utrata podstaw do wyników z elementami rozszerzonymi | Przenieść te same znaczniki do szablonu mobilnego |
| Zasoby zablokowane w robots.txt | Robot widzi stronę niepełną lub bez obrazów | Usunąć zakazy dla stylów, skryptów i grafik |
| Treść ładowana po kliknięciu | Robot jej nie pobiera | Ładować treść w kodzie lub po wejściu w widoczny obszar |
| Przekierowanie telefonów na stronę główną | Podstrony pomijane w indeksie | Przygotować mobilny odpowiednik każdej podstrony |
Samodzielnie da się sprawdzić pole Zindeksowano jako, obejrzeć kod przetestowanej strony i uzupełnić brakujące teksty w systemie zarządzania treścią. Pomoc specjalisty przydaje się wtedy, gdy różnice wynikają z kodu szablonu, z działania skryptów, z konfiguracji serwera rozpoznającego urządzenia albo z przekierowań między adresem komputerowym i mobilnym. Takie prace wchodzą w zakres usługi SEO techniczne. Nie da się uczciwie obiecać, że wyrównanie wersji podniesie pozycje, natomiast usuwa ono przeszkodę, przez którą Google ocenia stronę na podstawie niepełnych danych.
Jeśli chcą Państwo zamówić SEO techniczne, zachęcamy do kontaktu: tel. 222 500 844 lub mailowo: biuro@pozycjonowaniestron.pl
Najczęstsze pytania
Czy strona bez wersji mobilnej zniknie z Google?
Nie musi. Dokumentacja Google podaje, że strony bez wersji mobilnej również mogą pojawiać się w wynikach, choć wersja przystosowana do telefonów jest zdecydowanie zalecana.
Czy tekst schowany w zakładkach i rozwijanych blokach jest indeksowany?
Tak, pod warunkiem że znajduje się w kodzie strony od razu po jej załadowaniu. Problem pojawia się dopiero wtedy, gdy kliknięcie pobiera tekst z serwera, bo robot nie klika.
Gdzie w Search Console widać, który robot zindeksował stronę?
W wyniku sprawdzenia adresu URL, w sekcji Indeksowanie stron, znajduje się pole Zindeksowano jako. Obraz całej witryny daje raport Statystyki indeksowania dostępny z menu Ustawienia.
Czy w robots.txt można ustawić inne reguły dla robota mobilnego i komputerowego?
Nie. Obie odmiany Googlebota posługują się w pliku robots.txt tym samym oznaczeniem, więc reguła dla Googlebota obowiązuje obie jednocześnie.
Czy strona responsywna może mieć problem z indeksowaniem mobilnym?
Może, choć zdarza się to rzadziej. Skrypty i dodatki potrafią usuwać elementy na wąskim ekranie albo ładować je dopiero po działaniu użytkownika. Test wersji opublikowanej pokazuje, co faktycznie dociera do robota.
Czy wizyty Googlebota na komputery w logach oznaczają błąd?
Nie. Według Google większość żądań wykonuje robot na smartfony, a mniejszość robot komputerowy, więc oba podpisy będą widoczne w logach.
Źródła
- Sprawdzone metody dotyczące witryn mobilnych i indeksowania zoptymalizowanego pod kątem urządzeń mobilnych, Google Search Central
- Co to jest Googlebot, Google Search Central
- Typowe roboty Google, Google for Developers
- Naprawianie leniwie ładującej się zawartości witryny, Google Search Central
- Jak działają znaczniki uporządkowanych danych - wprowadzenie, Google Search Central
- Narzędzie do sprawdzania adresów URL, Search Console - pomoc
- Raport Statystyki indeksowania, Search Console - pomoc
- Test wyników z elementami rozszerzonymi, Search Console - pomoc
Funkcje wyszukiwarek i asystentów AI zmieniają się szybko, dlatego wpis aktualizujemy po większych zmianach.