Stronę zamykaną na czas prac należy oddać robotom z kodem 503 i nagłówkiem Retry-After, a ludziom pokazać krótką stronę z informacją, kiedy serwis wróci. Taki stan Google traktuje jako chwilową niedostępność, pod warunkiem że trwa godziny lub najwyżej dzień, dwa. Poniżej opisujemy, jak przygotować przerwę, czego nie ruszać w pliku robots.txt i jak wstrzymać sprzedaż w sklepie bez wyłączania całej witryny.
Czym jest kod 503 i co oznacza dla Google
Kod 503 to odpowiedź serwera oznaczająca, że usługa jest chwilowo niedostępna i żądanie nie zostanie teraz obsłużone. Dla robota wyszukiwarki to sygnał, że nic trwałego się nie stało i że pod ten sam adres warto wrócić później. Z tego powodu właśnie ten kod nadaje się na planowaną przerwę techniczną.
Kod stanu HTTP z grupy błędów serwera. Informuje, że serwer nie jest gotowy do obsługi żądania, zwykle z powodu prac konserwacyjnych albo przeciążenia, i że jest to stan przejściowy.
Opis kodu w dokumentacji MDN wymienia dwie typowe przyczyny. Pierwsza to prace konserwacyjne, podczas których administrator kieruje cały ruch na jedną stronę z komunikatem albo dzieje się to samoczynnie przy aktualizacji oprogramowania. Druga to przeciążenie, kiedy aplikacja odrzuca część żądań, żeby nie wyczerpać pamięci lub puli połączeń. W obu sytuacjach chodzi o stan tymczasowy, dlatego do odpowiedzi należy w miarę możliwości dołączyć nagłówek z przewidywanym czasem powrotu oraz czytelną stronę wyjaśniającą, co się dzieje.
Google opisuje swoje zachowanie w dokumencie o wpływie kodów stanu HTTP na roboty. Wynikają z niego trzy rzeczy ważne przy planowaniu przerwy. Błędy serwera z grupy 5xx oraz kod 429 informują roboty, że na jakiś czas należy zwolnić skanowanie. Treść otrzymana z adresu, który odpowiada kodem 5xx, jest ignorowana, więc komunikat o pracach nie zastąpi w indeksie właściwej zawartości podstrony. Adresy już zaindeksowane są zachowywane, ale po pewnym czasie zostają z indeksu usunięte. Dokument nie podaje, po ilu dniach to następuje, dlatego bezpieczny czas przerwy trzeba ustalać na podstawie innych zaleceń Google, do których wracamy w dalszej części.
Ogólne omówienie wszystkich grup odpowiedzi serwera znajduje się w osobnym wpisie o tym, jak Googlebot traktuje kody odpowiedzi HTTP. Tutaj zajmujemy się wyłącznie sytuacją, w której właściciel serwisu sam, świadomie zamyka stronę na czas prac.
Dlaczego nie kod 200 ani 404
Kod 200 oznacza dla robota normalną stronę z treścią, a kod 404 stronę, której nie ma, i żaden z nich nie opisuje chwilowej przerwy. Pierwszy grozi tym, że Google potraktuje komunikat o pracach jak nową zawartość podstrony. Drugi mówi wyszukiwarce, że adres przestał istnieć.
Najczęstsza pomyłka wygląda niewinnie. Wtyczka albo ustawienie serwera podmienia wszystkie podstrony na estetyczną planszę z napisem o przerwie technicznej, ale serwer nadal odpowiada kodem 200. Według dokumentacji Google treść otrzymana z kodem 200 przechodzi do dalszego przetwarzania, czyli może zostać zaindeksowana. W praktyce oznacza to, że pod adresem oferty, cennika i kontaktu robot widzi ten sam krótki komunikat. Google potrafi też rozpoznać stronę, która przy kodzie 200 wygląda jak błąd albo jest pusta, i zgłasza ją wtedy w Search Console jako pozorny błąd 404. Mechanizm ten opisujemy we wpisie o tym, dlaczego Google uznaje istniejącą stronę za pustą.
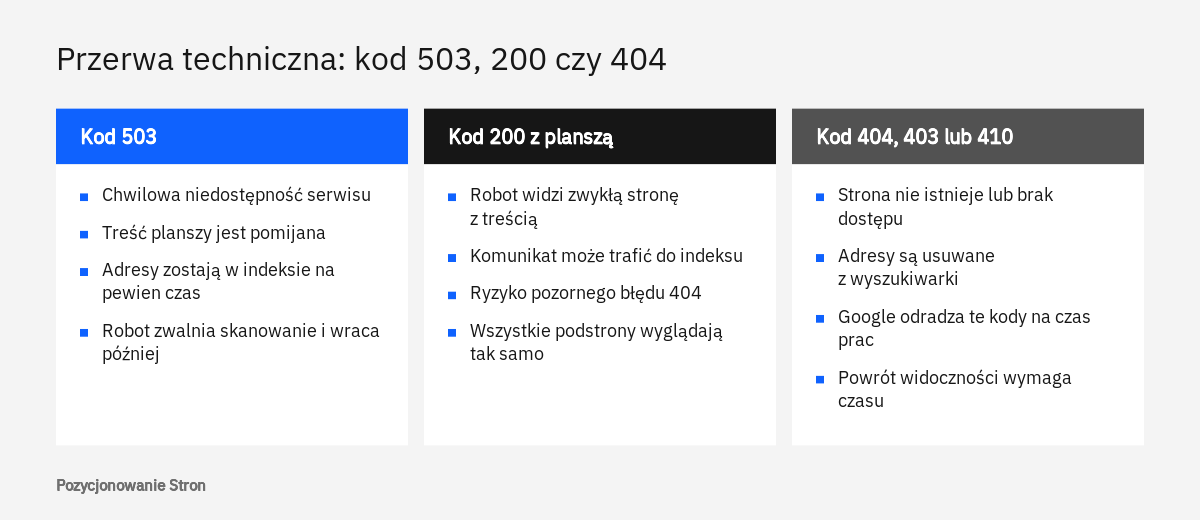
Druga pomyłka to odpowiadanie kodem 404, 403 albo 410, czasem przez przypadek, gdy na czas prac usuwa się pliki z serwera lub zakłada blokadę dostępu hasłem. Google w zaleceniach dotyczących wstrzymywania działalności wprost odradza te kody, podobnie jak dyrektywę noindex w kodzie strony i nagłówek X-Robots-Tag, ponieważ wszystkie prowadzą do usunięcia adresów z wyszukiwarki. O tym, jak działają same dyrektywy, piszemy przy okazji znacznika meta robots.
| Odpowiedź podczas prac | Jak odczytuje ją Google | Skutek dla widoczności |
|---|---|---|
| 503 z nagłówkiem Retry-After | Chwilowa niedostępność, treść odpowiedzi jest pomijana | Adresy zostają w indeksie przez pewien czas, skanowanie zwalnia |
| 200 z planszą o przerwie | Zwykła strona z nową treścią albo pozorny błąd 404 | Komunikat może zastąpić właściwą treść lub adres zostanie uznany za pusty |
| 404 lub 410 | Strona nie istnieje | Adresy są usuwane z wyszukiwarki |
| 403 lub blokada hasłem | Brak dostępu | Adresy są usuwane z wyszukiwarki |
Nagłówek Retry-After: kiedy robot ma wrócić
Nagłówek Retry-After to dodatkowa linia odpowiedzi serwera, która mówi, po jakim czasie warto ponowić żądanie. Przy kodzie 503 oznacza przewidywany czas niedostępności usługi. Google zaleca, aby podczas przerwy podawać w nim najbardziej prawdopodobną datę powrotu lub okres.
Według opisu nagłówka w dokumentacji MDN wartość można zapisać na dwa sposoby. Pierwszy to liczba sekund, czyli nieujemna liczba całkowita określająca opóźnienie liczone od chwili otrzymania odpowiedzi. Drugi to pełna data i godzina w formacie stosowanym w nagłówkach HTTP, po której warto spróbować ponownie. Ta sama dokumentacja zaznacza, że obsługa nagłówka bywa niejednolita, ale część robotów, w tym Googlebot, bierze go pod uwagę, a wysłanie go razem z kodem 503 pomaga wyszukiwarkom wrócić do skanowania po zakończeniu przerwy.
HTTP/1.1 503 Service Unavailable
Retry-After: 3600
Content-Type: text/html; charset=utf-8

<!doctype html>
<html lang="pl">
<head><title>Przerwa techniczna</title></head>
<body>
<h1>Trwają prace techniczne</h1>
<p>Serwis wróci dziś około godziny 6 rano.</p>
</body>
</html>
Zapis w sekundach jest wygodniejszy przy krótkich pracach, ponieważ nie wymaga przeliczania stref czasowych. Godzina to 3600 sekund, sześć godzin to 21600. Data sprawdza się wtedy, gdy termin zakończenia jest ustalony z góry. Wartość powinna być realistyczna, bo nagłówek jest wskazówką, a nie poleceniem. Osobną sprawą jest pamięć podręczna: MDN zwraca uwagę, że odpowiedź 503 zwykle nie powinna być buforowana, ponieważ użytkownicy mogą otrzymywać nieaktualną stronę błędu jeszcze po przywróceniu serwisu. Jeśli Państwa strona korzysta z sieci dostarczania treści albo z pamięci podręcznej po stronie serwera, przed przerwą warto ustalić z administratorem, jak te warstwy zachowają się wobec odpowiedzi 503.
Strona informacyjna dla klientów podczas przerwy
Strona wyświetlana podczas przerwy powinna w kilku zdaniach powiedzieć, co się dzieje, kiedy serwis wróci i jak w tym czasie skontaktować się z firmą. Kod 503 jest informacją dla robotów, a treść strony jest informacją dla ludzi, i obie muszą być przygotowane równie starannie.
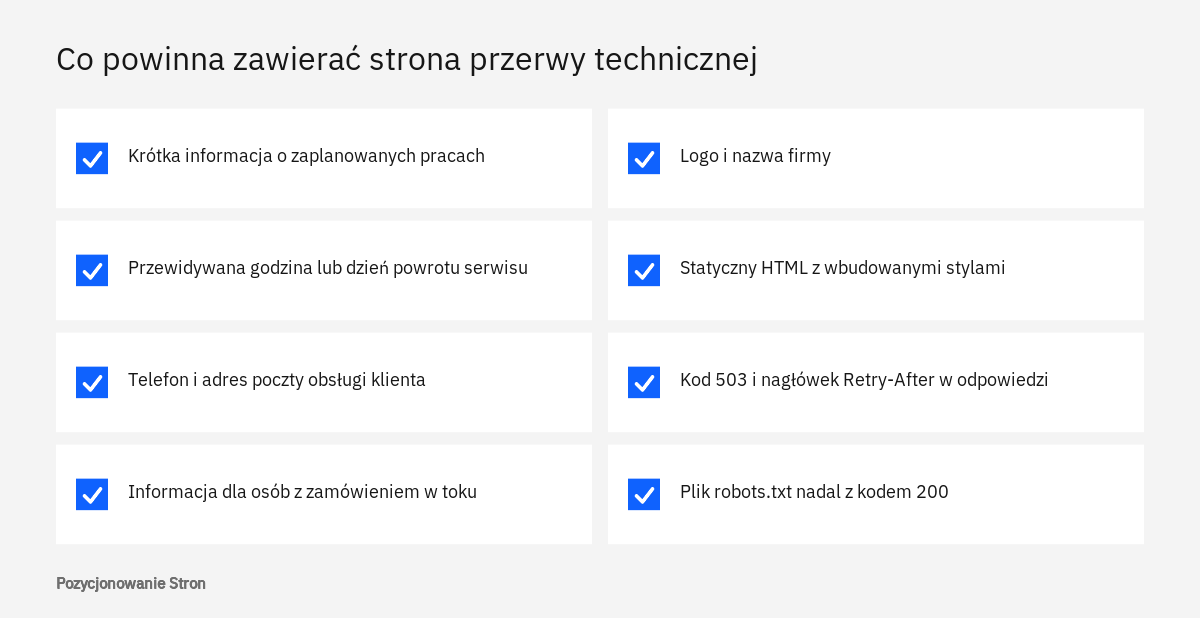
Zalecenia Google dla strony błędu 503 są konkretne. Powinna zawierać linki do miejsc, w których użytkownik znajdzie informacje, przewidywaną datę powrotu i sposób kontaktu z obsługą. Od strony technicznej Google radzi zbudować ją jako statyczny HTML z wbudowanym arkuszem stylów i obrazami zapisanymi bezpośrednio w kodzie w postaci Base64, tak aby jej wyświetlenie nie obciążało serwera, na którym trwają prace. To ważne z prostego powodu: plansza odwołująca się do bazy danych, motywu i kilkunastu skryptów przestaje działać dokładnie wtedy, gdy jest potrzebna.
- Jedno zdanie wyjaśniające, że trwają zaplanowane prace, bez technicznych szczegółów.
- Przewidywana godzina lub dzień powrotu, zgodne z wartością nagłówka Retry-After.
- Telefon i adres poczty obsługi klienta zapisane zwykłym tekstem.
- Informacja dla osób z zamówieniem w toku: czy realizacja trwa i gdzie pytać o status.
- Odnośniki do miejsc, które działają niezależnie od serwisu, na przykład do profilu firmy w mediach społecznościowych.
- Logo i nazwa firmy, żeby odwiedzający miał pewność, że trafił pod właściwy adres.
Przyjmijmy hipotetyczny przykład. Gabinet stomatologiczny z Bydgoszczy przenosi stronę na nowy serwer w nocy z soboty na niedzielę. Pacjent, który w tym czasie szuka numeru telefonu, powinien zobaczyć nazwę gabinetu, informację, że strona wróci rano, oraz numer do rejestracji i godziny jej pracy. Formularz zapisów, galeria czy mapa nie są na takiej planszy potrzebne, bo każdy z tych elementów wymaga działającego serwisu.
Jak długo wolno utrzymywać kod 503
Bezpieczny czas przerwy z kodem 503 to godziny, a w dokumentacji Google górną granicą są jeden, dwa dni. Dłuższe zamknięcie może skutkować usunięciem adresów z indeksu, a powrót do wcześniejszej widoczności nie ma wtedy określonego terminu.
Google podaje tę granicę w kilku miejscach i w zbliżonym brzmieniu. W zaleceniach o wstrzymywaniu działalności stronę informacyjną z kodem 503 przewiduje jako rozwiązanie na jeden, dwa dni. W dokumencie o zmniejszaniu szybkości indeksowania zwracanie kodów 500, 503 lub 429 jest opisane jako sposób na krótki czas, na przykład kilka godzin lub jeden, dwa dni, z zastrzeżeniem, że jeśli robot przez kilka dni otrzymuje te kody pod tymi samymi adresami, może usunąć je z indeksu. Pomoc Search Console do raportu statystyk indeksowania mówi z kolei, że kodów 503 i 429 nie należy zwracać dłużej niż dwa lub trzy dni, ponieważ może to trwale ograniczyć częstotliwość odwiedzin robota.
Z tych zapisów wynika praktyczny wniosek: przerwę planuje się tak, aby zmieściła się w jednej nocy, a zapas jednego, dwóch dni traktuje się jako bufor na nieprzewidziane trudności, nie jako plan. Jeśli prace mają trwać dłużej, nie należy zamykać działającej witryny. Lepszym wyjściem jest prowadzenie zmian na kopii roboczej, niedostępnej dla wyszukiwarek, i przełączenie gotowej wersji w krótkim oknie. Tak właśnie układa się harmonogram przy migracji strony i przy przenoszeniu domeny lub hostingu.
Na wypadek, gdy dłuższe wyłączenie jest nieuniknione, Google wskazuje inne rozwiązanie niż przedłużanie kodu 503: pozostawienie strony głównej odpowiadającej kodem 200 jako tymczasowego, możliwego do zaindeksowania zastępstwa. Samo wyłączenie całej witryny Google określa jako znaczącą zmianę, po której przywracanie stanu w wyszukiwarce może trwać długo i nie da się go przyspieszyć.
Są też skutki niezależne od długości przerwy. Dopóki strona zwraca kod 503, Google nie odświeża jej tytułów, opisów, metadanych ani danych strukturalnych, a wolniejsze skanowanie oznacza, że zmiany cen i dostępności produktów trafiają do wyników z opóźnieniem. Dokumentacja wspomina również o reklamach: przy błędach serwera kampanie Google Ads mogą zostać wstrzymane, a reklamy mogą przestać się wyświetlać. Jeżeli prowadzą Państwo kampanie, na czas przerwy warto je wstrzymać samodzielnie, żeby nie kierować płatnego ruchu na planszę z komunikatem.
Jeśli chcą Państwo zamówić SEO techniczne, zachęcamy do kontaktu: tel. 222 500 844 lub mailowo: biuro@pozycjonowaniestron.pl
Czego nie robić z plikiem robots.txt
Podczas przerwy technicznej plik robots.txt powinien pozostać bez zmian i odpowiadać tak jak zawsze. Nie należy dopisywać w nim blokady całej witryny ani pozwalać, aby sam plik zwracał kod 503. Google wymienia oba te błędy wprost w zaleceniach dotyczących kodu 503.
Kod 503 dla samego pliku
Reguła zamykająca serwis, ustawiona na poziomie serwera, obejmuje zwykle wszystkie adresy, a więc także adres pliku robots.txt. Tymczasem robot przed pobraniem jakiejkolwiek podstrony sprawdza właśnie ten plik. W opisie tego, jak Google interpretuje specyfikację robots.txt, przebieg zdarzeń jest rozpisany dokładnie. Gdy plik odpowiada błędem serwera, przez pierwsze 12 godzin Google przestaje skanować witrynę i ponawia próby pobrania pliku. Następnie przez kolejne 30 dni korzysta z ostatniej prawidłowej wersji zapisanej w pamięci podręcznej. Jeśli po tym okresie błąd trwa, a witryna jest ogólnie dostępna, robot zachowuje się tak, jakby pliku nie było; jeśli witryna ma problemy z dostępnością, skanowanie zostaje wstrzymane.
Dla właściciela strony oznacza to, że niedostępny robots.txt zatrzymuje wszystko naraz, łącznie z podstronami, które podczas prac mogłyby działać. Dlatego w regule przerwy trzeba zrobić wyjątek dla adresu tego pliku, tak aby nadal odpowiadał kodem 200 i oddawał dotychczasową treść.
Blokada całej witryny regułą Disallow
Drugi błąd polega na dopisaniu na czas prac reguły zakazującej robotom wstępu do całego serwisu. Intencja jest zrozumiała, ale skutek odwrotny do zamierzonego. Robot, który nie może wejść na stronę, nie zobaczy kodu 503 ani nagłówka Retry-After, czyli nie dowie się, że przerwa jest chwilowa. Dochodzi do tego kwestia pamięci podręcznej: Google przechowuje treść pliku zwykle do 24 godzin, więc blokada wpisana na dwie godziny może obowiązywać robota znacznie dłużej, niż trwały same prace. Jak czytać i pisać reguły tego pliku, wyjaśniamy we wpisie o tym, jak napisać robots.txt, żeby nie zablokować ważnych podstron.
Trzecia pokusa to ukrycie strony w wynikach na czas prac za pomocą narzędzia do tymczasowego usuwania adresów w Search Console. Google wprost zaleca, aby nie używać go do zamykania witryny. Właściwe zastosowania tego narzędzia opisujemy we wpisie o usuwaniu strony z wyników Google.
Jak wstrzymać sprzedaż w sklepie bez wyłączania serwisu
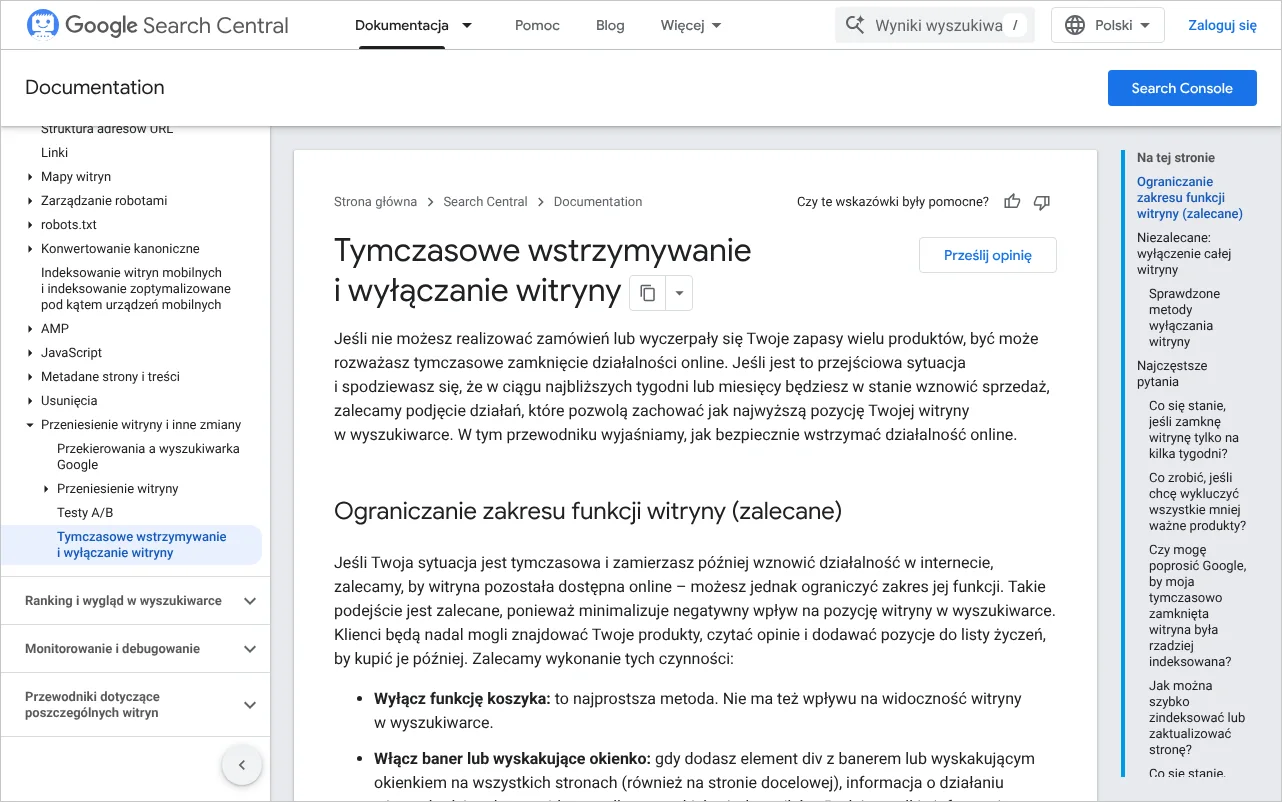
Sklep, który chwilowo nie przyjmuje lub nie wysyła zamówień, powinien pozostać w sieci z ograniczonymi funkcjami, a nie z kodem 503 na wszystkich adresach. Google zaleca takie podejście jako podstawowe, ponieważ nie wpływa ono na widoczność w wyszukiwarce, a klienci nadal znajdują informacje o produktach i firmie.
Dokument o tymczasowym wstrzymywaniu i wyłączaniu witryny wymienia kilka działań, które można łączyć. Najprostsze to wyłączenie koszyka, czyli samej możliwości złożenia zamówienia, przy zachowaniu kart produktów, kategorii i treści. Drugie to baner lub wyskakujące okno na wszystkich stronach z informacją o przerwie, opóźnieniach, czasie wysyłki albo możliwościach odbioru. Treść takiego komunikatu można oznaczyć atrybutem data-nosnippet, dzięki czemu nie trafi do opisu strony w wynikach wyszukiwania. Trzecie to aktualizacja danych strukturalnych, tak aby dostępność produktów odpowiadała stanowi faktycznemu, a w przypadku firm z lokalem także godzin otwarcia. Jeśli oferta jest przesyłana do Merchant Center, należy zadbać o zgodny z prawdą atrybut dostępności. Na koniec Google radzi poinformować wyszukiwarkę o zmianach: przy kilku stronach przez prośbę o ponowne zaindeksowanie w Search Console, przy większej liczbie przez mapę witryny.
Hipotetyczna sytuacja dobrze pokazuje różnicę. Sklep z ceramiką z Poznania zamyka magazyn na dwa tygodnie inwentaryzacji i urlopów. Gdyby na ten czas wystawił kod 503 na całej witrynie, przekroczyłby wielokrotnie okres, który Google uznaje za bezpieczny, i ryzykowałby usunięcie kart produktów z indeksu tuż przed powrotem do pracy. Wystarczy natomiast wyłączyć składanie zamówień, umieścić na górze każdej strony komunikat z datą wznowienia wysyłek i pozostawić całą resztę bez zmian. Klient, który w tym czasie trafi na produkt z wyszukiwarki, może go obejrzeć i wrócić po przerwie.
Google odpowiada w tym samym dokumencie na pytania zadawane przez właścicieli sklepów. Zamknięcie witryny na kilka tygodni może negatywnie wpłynąć na jej indeksowanie, dlatego lepiej ograniczyć funkcje. Produktów chwilowo niedostępnych nie należy usuwać z wyników narzędziem do usuwania adresów, tylko oznaczyć jako niedostępne, aby klient rozumiał sytuację.
Kod 503 ma w sklepie jedno uzasadnione zastosowanie: krótkie okno wdrożeniowe, na przykład nocna aktualizacja platformy albo przełączenie bazy danych, kiedy składanie zamówień byłoby ryzykowne dla spójności danych. Więcej o widoczności sklepów piszemy na stronie usługi pozycjonowania sklepów internetowych.
Tryb konserwacji w WordPressie a kod 503
WordPress ma wbudowany tryb konserwacji, który sam wysyła kod 503 i nagłówek Retry-After, ale jest on przeznaczony do krótkich aktualizacji, a nie do wielogodzinnych prac. Przy dłuższej przerwie potrzebne jest rozwiązanie na poziomie serwera albo wtyczka, której odpowiedź trzeba zweryfikować.
Z dokumentacji funkcji wp_maintenance wynika, że gdy tryb konserwacji jest aktywny, system kończy obsługę żądania komunikatem o krótkiej niedostępności, przekazuje kod 503 i ustawia nagłówek Retry-After na 600 sekund, czyli dziesięć minut. O tym, czy tryb jest aktywny, decyduje funkcja wp_is_maintenance_mode: sprawdza ona, czy w głównym katalogu instalacji istnieje plik o nazwie .maintenance, i odczytuje z niego znacznik czasu. Jeśli plik ma dziesięć minut lub więcej, system uznaje konserwację za zakończoną i wraca do normalnej pracy. Ten bezpiecznik chroni przed sytuacją, w której przerwana aktualizacja zostawia stronę zamkniętą na stałe, ale oznacza też, że wbudowanego trybu nie da się po prostu włączyć na całą noc.
Domyślny komunikat nie zawiera żadnych danych kontaktowych. Dokumentacja przewiduje możliwość zastąpienia go własnym plikiem maintenance.php umieszczonym w katalogu wp-content. Gdy taki plik istnieje, WordPress wczytuje go i kończy działanie, zanim sam ustawi kod odpowiedzi. Własny plik powinien więc samodzielnie wysłać kod 503 i nagłówek Retry-After, w przeciwnym razie plansza zostanie oddana z kodem 200.
<?php
http_response_code(503);
header('Retry-After: 600');
header('Content-Type: text/html; charset=utf-8');
?>
<!doctype html>
<html lang="pl">
<head><title>Przerwa techniczna</title></head>
<body>
<h1>Aktualizujemy stronę</h1>
<p>Prosimy wrócić za kilka minut. Telefon do biura: ...</p>
</body>
</html>
Wtyczki do trybu konserwacji działają różnie. Część pozwala wybrać kod odpowiedzi, część domyślnie oddaje planszę z kodem 200. To obserwacja z naszej praktyki, nie zapis z dokumentacji, dlatego jedyną pewną metodą jest sprawdzenie odpowiedzi serwera po włączeniu wtyczki oraz upewnienie się, że przerwa nie obejmuje adresu pliku robots.txt.
Jak sprawdzić, czy przerwa działa poprawnie, i co zrobić po jej zakończeniu
Poprawność przerwy sprawdza się przez odczytanie nagłówków odpowiedzi serwera, a nie przez obejrzenie planszy w przeglądarce. Plansza wygląda identycznie przy kodzie 200 i przy kodzie 503, a różnica jest widoczna dopiero w nagłówkach. Google zaleca sprawdzenie kodu lokalnie, na przykład poleceniem curl z parametrem wyświetlającym same nagłówki.
curl -I https://www.example.com/oferta/

HTTP/2 503
retry-after: 3600
content-type: text/html; charset=utf-8

curl -I https://www.example.com/robots.txt

HTTP/2 200
content-type: text/plain
To samo można odczytać w przeglądarce, w narzędziach dla programistów otwieranych klawiszem F12, na karcie z listą żądań sieciowych. Sprawdzenie warto powtórzyć dla kilku adresów: strony głównej, podstrony usługi lub produktu oraz pliku robots.txt, i wykonać je bez zalogowania do panelu, ponieważ zalogowany administrator zwykle widzi normalną stronę.
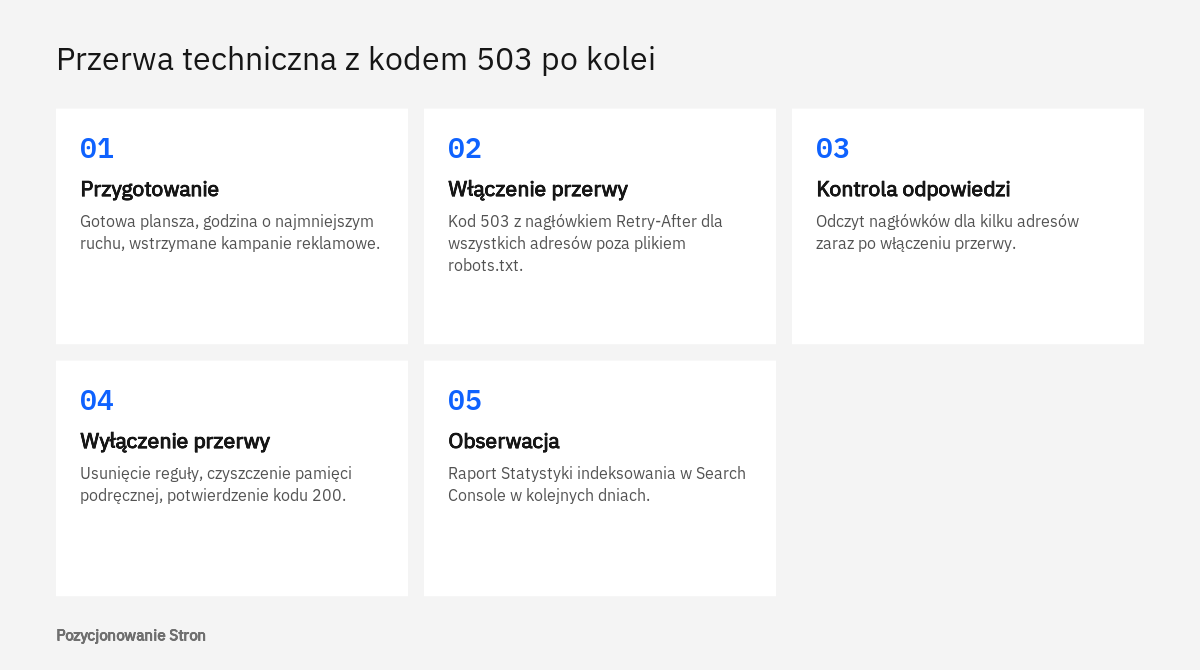
- Przygotowanie przed przerwą
Gotowa plansza w statycznym HTML, godzina rozpoczęcia w porze najmniejszego ruchu, wstrzymane kampanie reklamowe i kopia bieżącej wersji pliku robots.txt.
- Włączenie przerwy
Reguła zwracająca kod 503 z nagłówkiem Retry-After dla wszystkich adresów z wyjątkiem pliku robots.txt oraz adresów potrzebnych zespołowi do pracy.
- Kontrola odpowiedzi
Odczytanie nagłówków dla kilku adresów zaraz po włączeniu przerwy, najlepiej z innego łącza niż sieć firmowa, która może być wyłączona z blokady.
- Wyłączenie przerwy
Usunięcie reguły, wyczyszczenie pamięci podręcznej, ponowne odczytanie nagłówków i potwierdzenie kodu 200 na tych samych adresach.
- Obserwacja w Search Console
Przegląd raportu statystyk indeksowania w kolejnych dniach oraz wznowienie kampanii reklamowych po potwierdzeniu, że serwis działa.
Gdzie w Search Console widać skutki przerwy
Ślad po przerwie znajduje się w raporcie Statystyki indeksowania. Według pomocy Search Console otwiera się go z poziomu ustawień usługi: ikona Ustawienia w menu bocznym, a następnie pozycja Statystyki indeksowania. Raport pokazuje łączną liczbę żądań robota, całkowity rozmiar pobierania i średni czas odpowiedzi, a także sekcję Stan hosta z trzema polami: Pobieranie pliku robots.txt, Rozpoznawanie nazw DNS oraz Połączenie z serwerem.
Stan hosta opisuje dostępność witryny w ostatnich 90 dniach. Oznaczenie zielone mówi, że w tym okresie nie wykryto istotnych problemów. Po krótkiej, poprawnie przeprowadzonej przerwie w polu dotyczącym pliku robots.txt nie powinno być zastrzeżeń, co potwierdza, że wyjątek dla tego pliku zadziałał. W tabeli Odpowiedzi na żądania robota indeksującego przerwa będzie widoczna jako wiersz Błąd serwera (5XX), a daty przykładowych adresów można porównać z godzinami prac. Jeśli błędy 5XX pojawiają się poza oknem przerwy, mamy do czynienia z niezaplanowanymi awariami i wtedy warto przyjrzeć się temu, jak hosting wpływa na dostępność strony.
Po powrocie serwisu Google zwiększa tempo skanowania stopniowo, wraz z kolejnymi odpowiedziami z kodem 2xx, więc przez pewien czas robot może odwiedzać witrynę rzadziej niż zwykle.
Kiedy warto skorzystać z pomocy
Krótką przerwę na małej stronie firmowej administrator przeprowadzi samodzielnie, jeśli zna opisane zasady. Wsparcie przydaje się w sytuacjach bardziej złożonych: gdy serwis stoi za siecią dostarczania treści i kilkoma warstwami pamięci podręcznej, gdy przerwa łączy się ze zmianą adresów lub platformy albo gdy po wcześniejszych pracach widoczność spadła i trzeba ustalić przyczynę. W ramach usługi SEO technicznego planujemy takie prace razem z zespołem wdrożeniowym i sprawdzamy odpowiedzi serwera przed przerwą, w jej trakcie i po niej.
Jeśli chcą Państwo zamówić SEO techniczne, zachęcamy do kontaktu: tel. 222 500 844 lub mailowo: biuro@pozycjonowaniestron.pl
Najczęstsze pytania
Czy godzinna przerwa z kodem 503 obniży pozycje strony?
Dokumentacja Google opisuje kod 503 jako rozwiązanie na krótki czas, liczony w godzinach lub najwyżej w jednym, dwóch dniach. W takim okresie zaindeksowane adresy pozostają w indeksie, a robot jedynie zwalnia skanowanie. Nikt nie może zagwarantować pozycji, ale krótka, poprawnie przeprowadzona przerwa jest zgodna z zaleceniami wyszukiwarki.
Co wpisać w nagłówku Retry-After, jeśli nie wiadomo, ile potrwają prace?
Google zaleca podanie najbardziej prawdopodobnej daty lub okresu. Rozsądnie jest przyjąć ostrożny szacunek z niewielkim zapasem i wyrazić go w sekundach. Jeśli prace się przedłużają, wartość można zmienić w trakcie przerwy.
Czy podczas przerwy plik robots.txt też powinien zwracać kod 503?
Nie. Google wprost odradza zwracanie kodu 503 dla pliku robots.txt, ponieważ blokuje to skanowanie całej witryny. Plik powinien przez cały czas odpowiadać kodem 200 i zawierać dotychczasowe reguły, bez dopisanej blokady.
Strona będzie przebudowywana przez miesiąc. Czy można na ten czas ustawić kod 503?
Nie jest to dobre rozwiązanie. Według Google adresy, które przez kilka dni zwracają błędy serwera, mogą zostać usunięte z indeksu. Przebudowę prowadzi się na kopii roboczej, a dotychczasowa strona działa do chwili przełączenia.
Czy sklep na czas urlopu powinien wyświetlać przerwę techniczną?
Google zaleca w takiej sytuacji ograniczenie funkcji, a nie wyłączanie witryny. Wystarczy wyłączyć koszyk, umieścić na wszystkich stronach komunikat o terminie wznowienia wysyłek i zaktualizować informacje o dostępności produktów.
Czy podczas przerwy Google aktualizuje tytuły i opisy strony w wynikach?
Nie. Dopóki strona zwraca kod 503, Google nie może odświeżać jej tytułów, opisów, metadanych ani danych strukturalnych. Zmiany zostaną odczytane dopiero po powrocie serwisu i ponownych odwiedzinach robota.
Źródła
- Tymczasowe wstrzymywanie i wyłączanie witryny, Google Search Central
- Jak kody stanu HTTP wpływają na roboty Google, Google for Developers
- Jak Google interpretuje specyfikację pliku robots.txt, Google for Developers
- Zmniejszanie szybkości indeksowania przez Google, Google for Developers
- Raport Statystyki indeksowania, Search Console - pomoc
- 503 Service Unavailable, MDN Web Docs
- Retry-After header, MDN Web Docs
- wp_maintenance(), WordPress Developer Resources
- wp_is_maintenance_mode(), WordPress Developer Resources
Funkcje wyszukiwarek i asystentów AI zmieniają się szybko, dlatego wpis aktualizujemy po większych zmianach.