Nawigacja fasetowa to zestaw filtrów, którymi klient zawęża listę produktów, a każda kombinacja filtrów może stać się osobnym adresem do pobrania przez robota. Opanowanie jej polega na decyzji technicznej: które adresy w ogóle powstają, które robot ma prawo pobrać i jak są zbudowane te nieliczne, które mają trafić do wyszukiwarki. Poniżej opisujemy mechanizm powstawania adresów, sposoby ich ograniczania zalecane przez Google oraz miejsca, w których warto to sprawdzić.
Czym jest nawigacja fasetowa i skąd biorą się miliony adresów
Nawigacja fasetowa to sposób przeglądania oferty, w którym klient łączy ze sobą niezależne cechy produktu, a sklep po każdym wyborze pokazuje zawężoną listę. Miliony adresów biorą się stąd, że większość sklepów zapisuje wybrane filtry w adresie strony, najczęściej jako parametry po znaku zapytania, i każdy inny zestaw parametrów jest dla robota inną stroną.
Pojedyncza cecha, według której można zawęzić listę, na przykład kolor, rozmiar, marka albo przedział ceny. Nawigacja fasetowa pozwala łączyć kilka takich cech jednocześnie i w dowolnej kolejności.
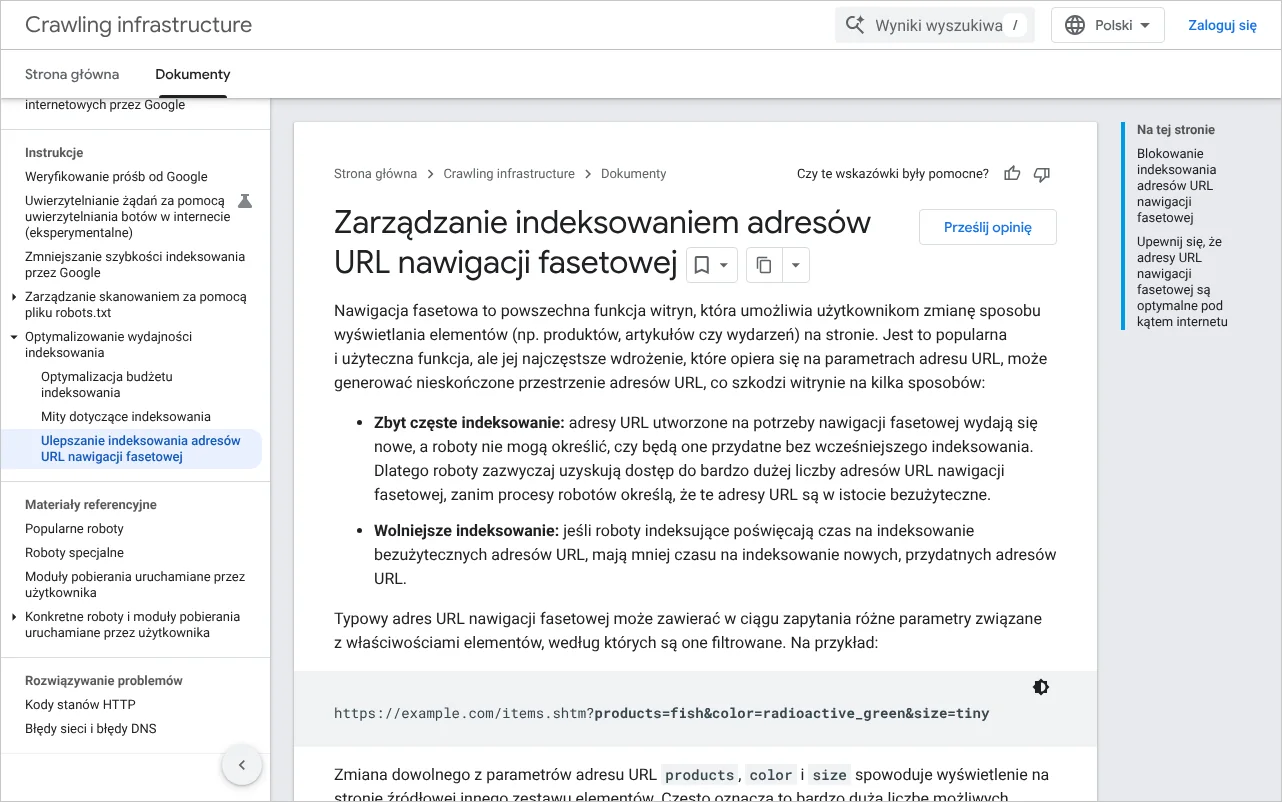
Google opisuje to zjawisko w dokumencie poświęconym adresom nawigacji fasetowej: najczęstsza realizacja, oparta na parametrach adresu, może wytworzyć nieskończoną liczbę adresów, ponieważ zmiana każdego parametru daje inny zestaw wyników. Dokumentacja dotycząca struktury adresów URL nazywa ten mechanizm filtrowaniem addytywnym i zwraca uwagę, że robot potrzebuje zaledwie kilku list, aby dotrzeć do wszystkich produktów, tymczasem dostaje ogromną liczbę list niemal identycznych.
Rachunek, który warto wykonać dla własnego sklepu
Skalę najłatwiej pokazać na wymyślonym przykładzie. Przyjmijmy sklep odzieżowy z Poznania, w którym jedna kategoria ma osiem kolorów, dwanaście rozmiarów, sześć przedziałów ceny i dwadzieścia marek, a listę da się ułożyć na cztery sposoby. Jeśli w każdej fasecie wolno zaznaczyć jedną wartość albo żadną, liczba możliwych widoków jednej kategorii to iloczyn 9 x 13 x 7 x 21 x 4, czyli 68 796 adresów. Przy stu pięćdziesięciu kategoriach daje to ponad dziesięć milionów adresów, choć sklep sprzedaje może kilka tysięcy produktów. To zwykła arytmetyka, a nie dane z badań, i w każdym sklepie wynik będzie inny.
Rachunek rośnie jeszcze szybciej, gdy w jednej fasecie można zaznaczyć kilka wartości naraz albo gdy sklep tworzy inny adres dla układu kolor i rozmiar, a inny dla układu rozmiar i kolor. O samych parametrach sortowania piszemy osobno we wpisie o sortowaniu i parametrach w adresach sklepu, dlatego tutaj skupiamy się na budowie samych filtrów.
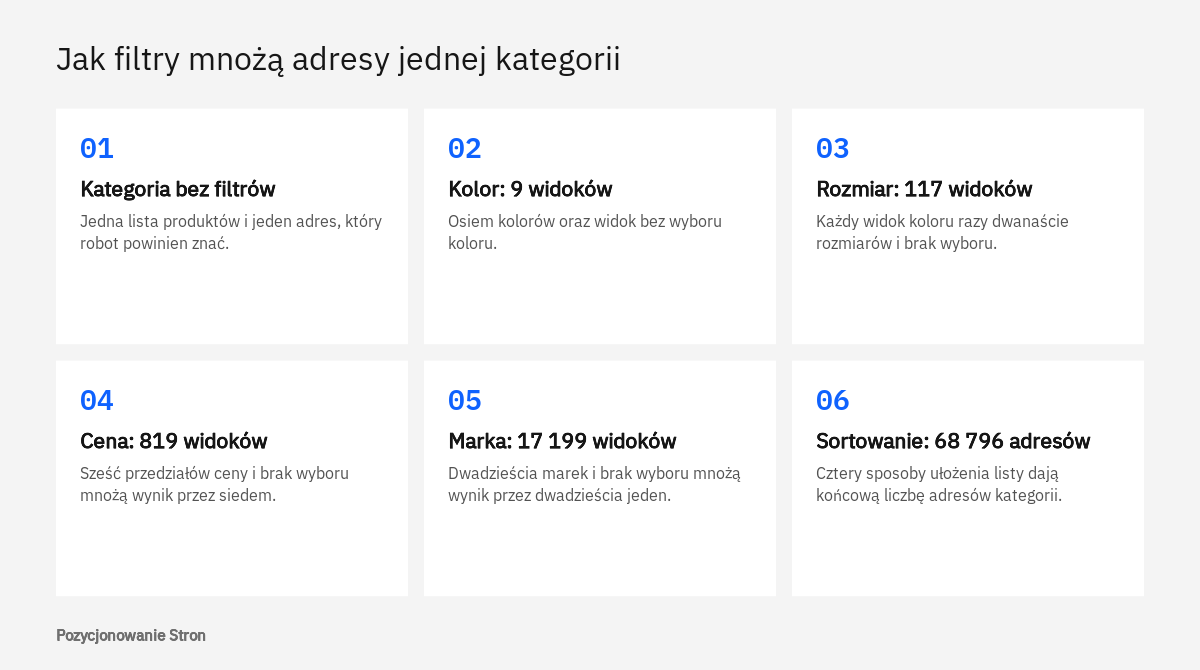
Warto też wiedzieć, skąd robot w ogóle zna te adresy. Zwykle nie zgaduje ich, tylko znajduje gotowe linki w panelu filtrów. Jeśli każda wartość filtra jest odnośnikiem prowadzącym do nowego adresu, to każda pobrana lista odsłania kolejne dziesiątki linków do następnych kombinacji i sieć adresów rozrasta się sama.
Co nadmiar adresów oznacza dla skanowania sklepu
Nadmiar adresów z filtrami oznacza dwie rzeczy: robot pobiera bardzo dużo stron bez wartości, a nowe i ważne strony trafiają do niego później. Tak właśnie ujmuje to Google, wymieniając nadmierne skanowanie oraz wolniejsze wykrywanie treści jako główne skutki źle zaprojektowanej nawigacji fasetowej.
Przyczyna jest prosta. Robot nie potrafi ocenić, czy nowy adres jest przydatny, dopóki go nie odwiedzi, więc odwiedza. Według dokumentacji pobieranie takich adresów zwykle mocno obciąża zasoby, zarówno ze względu na ich liczbę, jak i koszt przetworzenia każdej strony. Czas, który robot spędza na liście czerwonych koszulek w rozmiarze M posortowanej od najtańszej, to czas, którego nie poświęci nowej karcie produktu.
W tym miejscu pojawia się pojęcie budżetu indeksowania. W dokumencie Google o zarządzaniu budżetem indeksowania jest on opisany jako zestaw adresów, które robot może i zamierza pobrać. Zależy od tego, ile wytrzyma serwer, oraz od zapotrzebowania wyszukiwarki na treści danej witryny. Dokument jest przeznaczony przede wszystkim dla witryn liczących ponad milion unikalnych stron oraz dla witryn powyżej dziesięciu tysięcy stron z treścią zmienianą codziennie, przy czym liczby te są orientacyjne. Sklep z rozbudowanymi filtrami łatwo przekracza te progi nie liczbą produktów, lecz liczbą adresów. Szerzej tłumaczymy to we wpisie o budżecie indeksowania.
Jak sprawdzić, czy filtry już zalewają robota
Skalę problemu pokazują dwa raporty Google Search Console: Statystyki indeksowania oraz Indeksowanie stron. Pierwszy mówi, co robot faktycznie pobiera, drugi, co z pobranymi i wykrytymi adresami stało się dalej.
Raport Statystyki indeksowania otwiera się z poziomu ustawień usługi: w menu Search Console należy wejść w Ustawienia, a następnie w pozycję Statystyki indeksowania. Zgodnie z pomocą Search Console raport jest dostępny tylko dla usług najwyższego poziomu, czyli usługi domeny albo prefiksu adresu bez podkatalogu. Pokazuje łączną liczbę żądań robota, całkowity rozmiar pobierania i średni czas odpowiedzi, a poniżej cztery zestawienia: odpowiedzi na żądania, typy plików, cel oraz typ Googlebota. Po kliknięciu dowolnego wiersza wyświetla się próbka przykładowych adresów. Nie jest to pełna lista, ale zwykle wystarcza, aby zauważyć, że wśród pobieranych stron dominują adresy z parametrami filtrów.
Szczególnie przydatne jest zestawienie według celu. Raport rozróżnia tam dwie grupy: „Wykrycie”, czyli pobranie adresu, którego Google wcześniej nie znał, oraz „Odświeżenie”, czyli ponowną wizytę na znanej stronie. Jeśli w sklepie o stałym asortymencie w próbce adresów z grupy „Wykrycie” widać niemal wyłącznie kombinacje filtrów, robot odkrywa przestrzeń adresów, a nie ofertę.
W raporcie Indeksowanie stron, w części dotyczącej stron niezindeksowanych, warto szukać kilku powodów opisanych w pomocy do tego raportu.
| Powód w raporcie | Co oznacza przy filtrach |
|---|---|
| Strona wykryta - obecnie niezindeksowana | Google zna adres, ale jeszcze go nie pobrał. Duża liczba adresów z filtrami pokazuje kolejkę, która wyprzedza możliwości skanowania. |
| Duplikat, użytkownik nie oznaczył strony kanonicznej | Lista z filtrem została uznana za kopię innej, a sklep nie wskazał wersji podstawowej. |
| Alternatywna strona zawierająca prawidłowy tag strony kanonicznej | Canonical działa, lecz strona i tak została pobrana. |
| Pozorny błąd 404 | Lista bez produktów odpowiada kodem 200, choć nie ma na niej treści. |
| URL zablokowany przez plik robots.txt | Reguła blokująca działa. Liczba adresów pokazuje, ile kombinacji robot poznał z linków. |
Trzecim źródłem są dzienniki serwera, w których widać każde żądanie robota wraz z pełnym adresem. Z naszej praktyki wynika, że dają pełny obraz tam, gdzie Search Console pokazuje tylko próbkę. Taki przegląd wchodzi zwykle w zakres, jaki obejmuje audyt SEO sklepu.
Dwie drogi według Google: zablokować albo uporządkować
Google stawia sprawę jasno: albo adresy z filtrami nie są potrzebne w wyszukiwarce i wtedy należy uniemożliwić ich skanowanie, albo mają się w niej znaleźć i wtedy muszą spełniać określone wymagania techniczne. Obie drogi opisuje jeden dokument, którego polska wersja jest dostępna publicznie.
W praktyce sklep rzadko wybiera tylko jedną drogę. Zdecydowana większość kombinacji nie odpowiada na żadne zapytanie i powinna zostać odcięta, a niewielka grupa filtrów ma realny popyt i zasługuje na porządne adresy. Którą kombinację zaliczyć do której grupy, opisujemy we wpisie filtry w sklepie a indeksowanie. Tutaj zajmujemy się tym, jak tę decyzję wykonać technicznie.
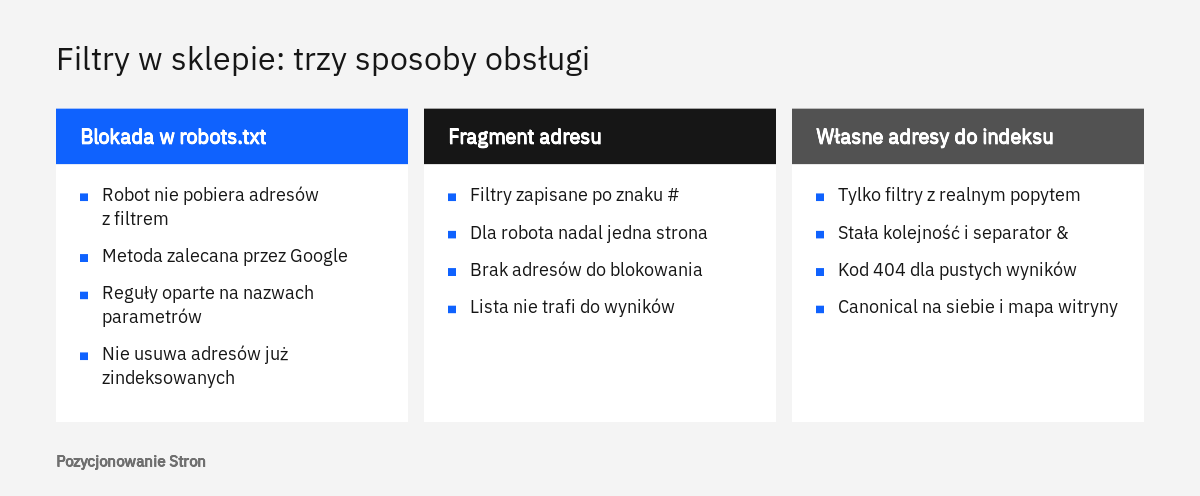
Dokumentacja wymienia cztery sposoby ograniczania skanowania: plik robots.txt, fragment adresu, znacznik rel="canonical" oraz atrybut rel="nofollow". Dwa pierwsze działają u źródła, bo robot w ogóle nie pobiera strony. Dwa ostatnie są według Google na dłuższą metę mniej skuteczne. Noindex w tym dokumencie nie występuje jako metoda ograniczania skanowania i, jak się okaże, nie bez powodu.
| Metoda | Czy robot pobiera stronę | Do czego się nadaje |
|---|---|---|
| Blokada w robots.txt | Nie | Masowe odcięcie kombinacji, które nie mają trafić do wyszukiwarki. |
| Filtry we fragmencie adresu | Nie, bo nowy adres nie powstaje | Filtry czysto użytkowe, na przykład cena lub dostępność. |
| rel="canonical" | Tak, z czasem rzadziej | Scalanie sygnałów z wariantów na wersję podstawową. |
| rel="nofollow" na linkach | Zależy od pozostałych linków | Uzupełnienie, skuteczne tylko przy pełnej konsekwencji. |
| noindex | Tak | Usunięcie z indeksu stron, które robot może pobierać. |
Blokada w robots.txt: metoda zalecana na masową skalę
Blokada w pliku robots.txt polega na dopisaniu reguł, które zabraniają robotowi pobierania adresów zawierających parametry filtrów. Google wskazuje ją jako dobry sposób na oszczędzenie zasobów, gdy filtrowane listy nie są potrzebne w wynikach, i zaleca, aby robot miał dostęp do kart produktów oraz do listy bez filtrów.
Przykład z dokumentacji opiera się na symbolu wieloznacznym. Dla sklepu, w którym filtry nazywają się kolor, rozmiar i cena, analogiczny zapis wygląda następująco.
user-agent: Googlebot
disallow: /*?*kolor=
disallow: /*?*rozmiar=
disallow: /*?*cena=
allow: /*?kolor=wszystkie$
Znaczenie symboli wyjaśnia opis interpretacji pliku robots.txt. Gwiazdka zastępuje dowolny ciąg znaków, a znak dolara oznacza koniec adresu. Zapis ze znakiem zapytania i gwiazdką przed nazwą parametru łapie parametr niezależnie od tego, czy stoi w adresie jako pierwszy, czy po innych. Gdy do jednego adresu pasuje kilka reguł, wygrywa najbardziej szczegółowa, czyli ta o najdłuższej ścieżce. Dlatego ostatnia linia przykładu, dłuższa od reguły blokującej, otwiera jeden konkretny adres.
Trzy cechy pliku mają przy filtrach znaczenie praktyczne. Ścieżki rozróżniają wielkość liter, więc reguła dla parametru zapisanego małymi literami nie obejmie tej samej nazwy pisanej wielką. Google przechowuje plik w pamięci podręcznej zwykle do doby, zatem zmiana nie działa natychmiast. Plik ma też limit rozmiaru wynoszący 500 kibibajtów, co skłania do krótkich reguł opartych na wzorcach. Ogólne zasady omawiamy we wpisie o tym, jak napisać plik robots.txt.
Jeśli chcą Państwo zamówić pozycjonowanie sklepu internetowego, zachęcamy do kontaktu: tel. 222 500 844 lub mailowo: biuro@pozycjonowaniestron.pl
Fragment adresu: filtry, które nie tworzą nowych stron
Fragment adresu to część po znaku #, której przeglądarka nie wysyła do serwera. Jeśli sklep zapisuje wybrane filtry właśnie tam, a listę przebudowuje skryptem w przeglądarce, dla robota wszystkie kombinacje pozostają jedną i tą samą stroną kategorii.
Google potwierdza to w dokumencie o nawigacji fasetowej: wyszukiwarka zasadniczo nie obsługuje fragmentów adresów przy skanowaniu i indeksowaniu, więc filtry oparte na fragmencie nie wpływają na skanowanie ani dodatnio, ani ujemnie. Nie ma adresów do blokowania, więc nie ma też reguł, które mogłyby się zestarzeć.
Parametry (osobny adres dla robota):
https://example.com/koszulki?kolor=czerwony&rozmiar=m

Fragment (dla robota nadal /koszulki):
https://example.com/koszulki#kolor=czerwony&rozmiar=m
Cena jest równie jasna. Lista zapisana we fragmencie nigdy nie będzie osobnym wynikiem wyszukiwania. Dokumentacja struktury adresów ostrzega, by nie używać fragmentów do zmiany treści, która ma być indeksowana, a w takich przypadkach zaleca interfejs History API, czyli mechanizm przeglądarki pozwalający skryptowi zmienić adres na pełnoprawny bez przeładowania strony. Wniosek jest praktyczny: fragment pasuje do filtrów, których nikt nie szuka w Google, takich jak przedział ceny czy dostępność w magazynie, a nie pasuje do filtrów, które mają zdobywać ruch.
Skoro robot nie widzi filtrowanych list, musi dotrzeć do wszystkich produktów inną drogą: przez stronicowanie kategorii, podkategorie i mapę witryny. Dokumentacja dotycząca linków przypomina, że Google korzysta z odnośników zapisanych jako element a z atrybutem href, a adresów ukrytych w zdarzeniach skryptów może nie odczytać. Jeśli więc kolejne strony listy doczytują się wyłącznie skryptem, część oferty może pozostać niewidoczna. Rozwiązania opisujemy we wpisie o paginacji w sklepie.
Canonical, noindex i nofollow: co naprawdę ograniczają
Canonical, noindex i nofollow porządkują to, co trafia do indeksu, ale skanowanie ograniczają słabo albo wcale. Każda z tych metod wymaga, aby robot najpierw pobrał stronę lub odnośnik, a właśnie pobierania jest przy filtrach za dużo.
Canonical
Znacznik rel="canonical" wskazuje wersję podstawową spośród podobnych stron. W dokumencie o nawigacji fasetowej Google podaje przykład listy z trzema filtrami, która wskazuje jako kanoniczną listę z jednym filtrem, i dodaje, że takie oznaczenie może z czasem zmniejszyć skanowanie wersji niekanonicznych. Aby odczytać znacznik, robot musi jednak stronę pobrać, więc efekt przychodzi stopniowo.
Druga sprawa to moc sygnału. W dokumencie o wskazywaniu adresu kanonicznego Google opisuje canonical jako wyraźny sygnał, ale ostateczny wybór pozostawia sobie. Ten sam dokument odradza wybieranie wersji kanonicznej za pomocą robots.txt lub noindex, wskazywanie fragmentu adresu jako wersji kanonicznej oraz podawanie różnych adresów w mapie witryny i w znaczniku. Zaleca natomiast, aby linki wewnętrzne prowadziły do wersji kanonicznej, a nie do kopii.
Noindex
Reguła noindex usuwa stronę z wyników, lecz nie zwalnia robota z jej pobierania. Dokument o budżecie indeksowania mówi o tym wprost: przy noindex Google nadal wysyła żądanie do strony i dopiero po odczytaniu reguły ją pomija. Dla sklepu z milionami kombinacji oznacza to, że indeks będzie czysty, a obciążenie pozostanie. Noindex sprawdza się więc przy umiarkowanej liczbie adresów, które robot może pobierać, ale które nie powinny być widoczne w wynikach.
<meta name="robots" content="noindex">

HTTP/1.1 200 OK
X-Robots-Tag: noindex
Najczęstsza pomyłka polega na łączeniu noindex z blokadą w robots.txt. Według dokumentacji tagu noindex strona nie może być zablokowana w pliku robots.txt, ponieważ robot, który nie może jej odwiedzić, nigdy nie zobaczy reguły. Jeśli więc adresy z filtrami są już w indeksie i mają z niego zniknąć, kolejność ma znaczenie: najpierw noindex przy otwartym dostępie, a blokada dopiero po tym, jak adresy wypadną z wyników. Według tej samej strony ponowna wizyta robota może nastąpić nawet po kilku miesiącach. Różnice między trzema mechanizmami zestawiamy we wpisie canonical, noindex i robots.txt.
Nofollow
Atrybut rel="nofollow" na odnośnikach w panelu filtrów ma zniechęcić robota do podążania za nimi. Google dopuszcza tę metodę, ale stawia warunek trudny do spełnienia: atrybut musi mieć każdy link prowadzący do danego adresu. Wystarczy jeden odnośnik bez atrybutu, na przykład w okruszkach albo w opisie kategorii, aby warunek nie był spełniony. Z tego powodu nofollow traktujemy jako uzupełnienie, a nie podstawę rozwiązania.
Wybrane filtry jako strony docelowe: wymagania techniczne
Filtr, który ma zdobywać ruch z wyszukiwarki, musi być zwykłą, stabilną podstroną: z jednym adresem, własnym znacznikiem kanonicznym, linkami prowadzącymi do niej i poprawną odpowiedzią serwera. Google zastrzega przy tym, że skanowanie takich adresów zwiększa obciążenie serwera i może spowolnić wykrywanie nowych stron, dlatego grupa otwartych filtrów powinna być świadomie ograniczona.
Dokument o nawigacji fasetowej wymienia trzy wymagania. Pierwsze dotyczy separatora: parametry należy łączyć standardowym znakiem &, ponieważ przecinki, średniki i nawiasy kwadratowe nie są przez roboty rozpoznawane jako separatory parametrów. Dokumentacja struktury adresów dopowiada, że nazwę parametru od wartości oddziela znak równości, a kilka wartości jednego parametru można zapisać po przecinku. Wytyczne dla sklepów dodają, by nie powtarzać tego samego klucza w jednym adresie, bo robot może uwzględnić tylko jedną z wartości.
Drugie wymaganie to stała, logiczna kolejność filtrów i brak powtórzeń, gdy filtry są zapisane w ścieżce adresu. W praktyce tę samą zasadę warto zastosować do parametrów: sklep powinien sam ustawiać je w jednej kolejności niezależnie od tego, co klient kliknął najpierw. Do tego dochodzi jednolita wielkość liter, bo Google traktuje adresy różniące się wielkością liter jako różne.
Zalecane:
/koszulki?kolor=czerwony&rozmiar=m
/koszulki?kolor=czerwony,bialy

Niezalecane:
/koszulki?rozmiar=m&kolor=czerwony   (druga kolejność tej samej listy)
/koszulki?kolor=czerwony;rozmiar=m       (średnik zamiast &)
/koszulki?kolor=czerwony&kolor=bialy (powtórzony klucz)
Trzecie wymaganie dotyczy pustych wyników. Gdy kombinacja filtrów nie zwraca żadnego produktu, serwer powinien odpowiedzieć kodem 404. To samo dotyczy powtórzonych filtrów, kombinacji pozbawionych sensu oraz nieistniejących numerów stron listy. Google zaznacza, że nie należy przekierowywać takich adresów na ogólną stronę błędu: kod 404 ma pojawić się pod tym adresem, pod którym wystąpił problem. Sklep, który zamiast tego pokazuje komunikat o braku produktów z kodem 200, zobaczy w Search Console pozorne błędy 404, a według dokumentu o budżecie indeksowania takie strony są nadal odwiedzane i zużywają zasoby. O samym kodzie piszemy we wpisie o błędzie 404.
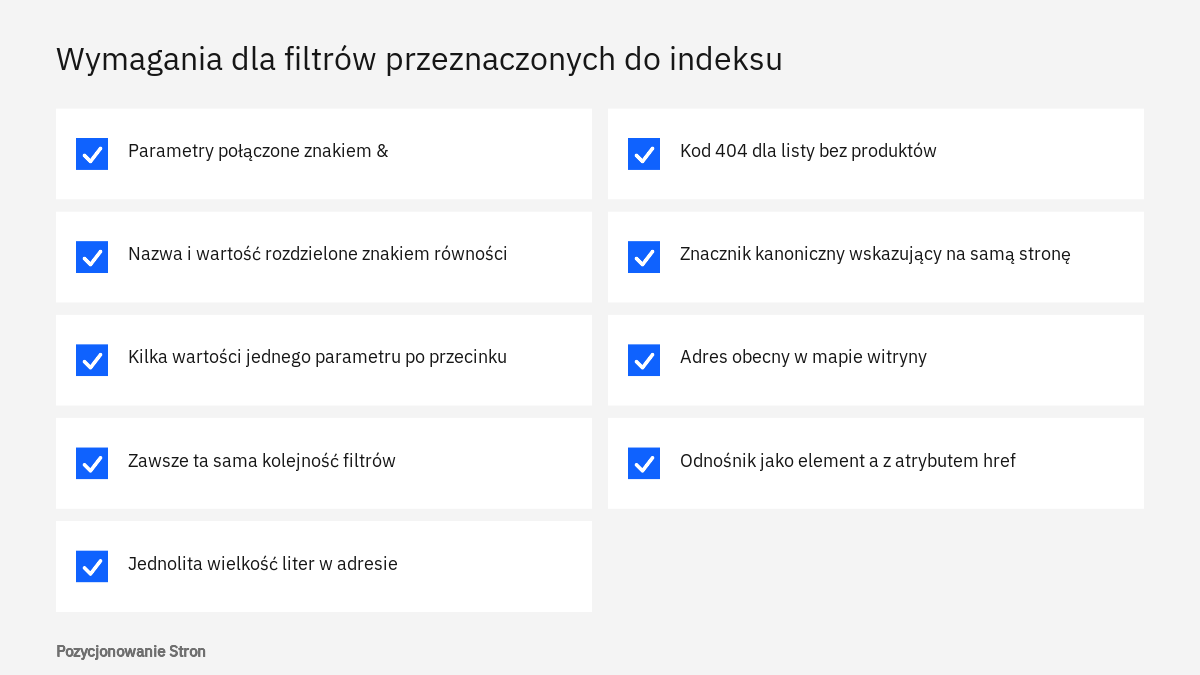
Pozostałe elementy wynikają z ogólnych wytycznych dla sklepów. Strona przeznaczona do indeksu powinna mieć znacznik kanoniczny wskazujący na nią samą i znaleźć się w mapie witryny, a ten sam adres powinien występować w linkach wewnętrznych, w mapie i w znaczniku. Odnośnik do niej musi być zwykłym elementem a z atrybutem href, najlepiej z opisowym tekstem.
Na koniec trzeba pogodzić otwarte filtry z blokadą pozostałych. Jeśli kolor ma być indeksowany, a rozmiar i cena nie, reguły robots.txt obejmują tylko parametry rozmiaru i ceny. Wówczas lista czerwonych koszulek jest dostępna, a ta sama lista zawężona do rozmiaru M już nie. Ogólne zasady budowy adresów opisujemy we wpisie o strukturze adresów URL.
Kolejność prac i typowe pomyłki
Porządkowanie nawigacji fasetowej warto zacząć od spisu faset i pomiaru, a dopiero potem zmieniać konfigurację. Zmiany wprowadzone bez spisu kończą się zwykle albo zablokowaniem stron, które przynosiły ruch, albo pozostawieniem furtki, przez którą robot nadal odkrywa kombinacje.
- Spis faset i parametrów
Nazwa parametru, liczba wartości, możliwość wielokrotnego wyboru i sposób zapisu w adresie. Z tego spisu wynika rachunek kombinacji.
- Pomiar stanu obecnego
Raporty Statystyki indeksowania i Indeksowanie stron oraz dzienniki serwera pokazują, ile żądań robota przypada na filtry.
- Podział faset na grupy
Każda faseta trafia do jednej z trzech grup: własne adresy do indeksu, fragment adresu albo parametry zablokowane w robots.txt.
- Uporządkowanie adresów otwartych
Stała kolejność, separator &, kod 404 dla pustych wyników, znacznik kanoniczny i wpis w mapie witryny.
- Wycofanie adresów zbędnych
Jeśli są już w indeksie, najpierw noindex przy otwartym dostępie, a blokada w robots.txt po ich zniknięciu z wyników.
- Kontrola po wdrożeniu
Po kilku tygodniach warto wrócić do tych samych raportów i porównać próbki pobieranych adresów.
Wśród pomyłek powtarza się kilka. Blokada w robots.txt obejmuje parametr, którego używa również stronicowanie, i robot traci dostęp do dalszych stron kategorii. Mapa witryny zawiera adresy z filtrami, które jednocześnie są zablokowane. Canonical filtrowanych list wskazuje kategorię, ale linki w menu i na banerach prowadzą do wersji z parametrami. Wreszcie moduł filtrów po aktualizacji zmienia nazwy parametrów i dotychczasowe reguły przestają pasować. WooCommerce, PrestaShop czy Shopify zapisują filtry na własne sposoby, zależne dodatkowo od motywu i dodatków, dlatego gotowych reguł nie należy przenosić między sklepami bez sprawdzenia rzeczywistych adresów.
- Każda faseta ma przypisaną jedną z trzech grup i nie należy do dwóch naraz.
- Ta sama lista ma dokładnie jeden adres, niezależnie od kolejności kliknięć.
- Reguły robots.txt nie obejmują stronicowania, kart produktów ani listy bez filtrów.
- Kombinacje bez produktów odpowiadają kodem 404 pod własnym adresem.
- Strony z noindex nie są jednocześnie zablokowane w robots.txt.
- Mapa witryny, linki wewnętrzne i znaczniki kanoniczne podają te same adresy.
- Wszystkie produkty są osiągalne przez odnośniki bez użycia filtrów.
Pomoc specjalisty jest potrzebna zwłaszcza wtedy, gdy zmiana wymaga ingerencji w kod sklepu albo gdy adresy z filtrami przynoszą już ruch i trzeba je przenieść bez strat. Jest to zakres, który obejmuje SEO techniczne. Gdy sklep dopiero powstaje, wymagania te warto uwzględnić już w projekcie, jaki poprzedza budowę sklepu internetowego, a długofalową pracę nad widocznością kategorii i filtrów prowadzimy w ramach usługi pozycjonowania sklepów.
Jeśli chcą Państwo zamówić pozycjonowanie sklepu internetowego, zachęcamy do kontaktu: tel. 222 500 844 lub mailowo: biuro@pozycjonowaniestron.pl
Najczęstsze pytania
Czy mały sklep też powinien zajmować się nawigacją fasetową?
Tak, jeśli filtry tworzą osobne adresy. Liczba kombinacji zależy od liczby faset i ich wartości, a nie od liczby produktów, więc nawet niewielki asortyment może dać dziesiątki tysięcy adresów.
Czy sam canonical wystarczy, aby rozwiązać problem filtrów?
Zwykle nie. Canonical z czasem może zmniejszyć skanowanie kopii, ale robot musi każdą stronę pobrać, aby go odczytać. Google ocenia tę metodę jako na dłuższą metę mniej skuteczną od blokady w robots.txt.
Czy można jednocześnie użyć noindex i blokady w robots.txt?
Nie na tej samej stronie. Robot, który nie może pobrać strony, nie zobaczy reguły noindex, więc adres może pozostać w wynikach. Obie metody stosuje się kolejno: najpierw noindex, a blokadę po usunięciu adresów z indeksu.
Czy filtry zapisane po znaku # szkodzą pozycjom sklepu?
Według Google nie wpływają na skanowanie ani dodatnio, ani ujemnie, ponieważ fragment adresu jest zasadniczo pomijany. Lista zapisana w ten sposób nie stanie się jednak osobnym wynikiem wyszukiwania, a produkty muszą być osiągalne inną drogą.
Co zrobić z kombinacją filtrów, która nie zwraca produktów?
Serwer powinien odpowiedzieć kodem 404 pod tym samym adresem, bez przekierowania na ogólną stronę błędu. Wytyczne Google dla sklepów zalecają też, aby nie tworzyć linków do stron bez przydatnej treści.
Czy blokada filtrów przeniesie budżet robota na inne strony?
Niekoniecznie. Google zastrzega, że zwolnione zasoby nie są automatycznie przesuwane na inne strony, chyba że witryna osiągała już limit wydajności serwera. Blokada zmniejsza liczbę żądań kierowanych do filtrów, ale nie jest obietnicą częstszych wizyt na kartach produktów.
Źródła
- Zarządzanie indeksowaniem adresów URL nawigacji fasetowej, Google for Developers
- Zarządzanie budżetem indeksowania, Google for Developers
- Sprawdzone metody projektowania struktury adresów URL na potrzeby witryn e-commerce, Centrum wyszukiwarki Google
- Sprawdzone metody tworzenia struktury adresów URL na potrzeby wyszukiwarki Google, Centrum wyszukiwarki Google
- Jak Google interpretuje specyfikację pliku robots.txt, Google for Developers
- Plik robots.txt - wprowadzenie i przewodnik, Centrum wyszukiwarki Google
- Jak określić kanoniczny URL za pomocą rel="canonical" i innych metod, Centrum wyszukiwarki Google
- Blokowanie indeksowania przez wyszukiwarki za pomocą tagu noindex, Centrum wyszukiwarki Google
- Sprawdzone metody dotyczące linków i SEO, Centrum wyszukiwarki Google
- Raport Statystyki indeksowania, Search Console - pomoc
- Raport Indeksowanie stron, Search Console - pomoc
Funkcje wyszukiwarek i asystentów AI zmieniają się szybko, dlatego wpis aktualizujemy po większych zmianach.