Każda opcja sortowania, każda liczba produktów na stronie i każdy przełącznik widoku listy potrafi utworzyć w sklepie osobny adres z tą samą treścią. Wyjaśniamy, jak rozpoznać taki nadmiar adresów w Search Console i jak go uporządkować adresem kanonicznym oraz regułami w pliku robots.txt, żeby roboty Google zajmowały się ofertą, a nie jej kopiami.
Skąd w sklepie biorą się tysiące zduplikowanych adresów
Zduplikowane adresy powstają wtedy, gdy sklep zapisuje wybór klienta w adresie strony, a ten wybór nie zmienia oferty, tylko sposób jej pokazania. Klient ustawia sortowanie od najniższej ceny, zmienia liczbę produktów na stronie z dwudziestu na sześćdziesiąt, przełącza siatkę na listę, a oprogramowanie sklepu za każdym razem dopisuje do adresu kolejny parametr po znaku zapytania. Dla człowieka to wciąż ta sama kategoria. Dla robota wyszukiwarki każdy taki adres jest osobną stroną, dopóki jej nie pobierze i nie porówna z innymi.
Para w postaci nazwa=wartość dopisana do adresu po znaku zapytania, na przykład ?sort=cena. Kolejne parametry łączy się znakiem &.
W praktyce sklepów internetowych powtarzają się cztery rodzaje parametrów, które nie wnoszą nowej treści. Pierwszy to sortowanie: według ceny rosnąco i malejąco, nazwy, daty dodania, popularności. Drugi to liczba produktów na stronie listy. Trzeci to widok, czyli siatka lub lista. Czwarty, najbardziej kłopotliwy, to identyfikator sesji oraz inne wartości tymczasowe, które są inne dla każdego odwiedzającego. Nazwy parametrów zależą od oprogramowania: z naszych obserwacji wynika, że w różnych sklepach to samo sortowanie bywa zapisane jako sort, order, orderby albo dir, a liczba produktów jako limit lub per_page. Nazwy obowiązujące w konkretnym sklepie najłatwiej ustalić, klikając kolejno opcje nad listą produktów i obserwując pasek adresu.
Jak mnożą się kombinacje
Skalę najlepiej pokazuje proste mnożenie. Sklep z Poznania sprzedający wyposażenie łazienek ma dwieście kategorii. Nad listą produktów daje pięć sposobów sortowania, trzy warianty liczby produktów na stronie i dwa widoki. Pięć razy trzy razy dwa to trzydzieści wersji każdej strony listy. Dwieście kategorii daje więc sześć tysięcy adresów, zanim policzymy kolejne strony listy. Jeśli kategoria ma średnio pięć stron, liczba rośnie do trzydziestu tysięcy adresów, choć sklep ma nadal dwieście kategorii i ten sam asortyment. To tylko rachunek możliwych kombinacji, a nie pomiar, ale dobrze tłumaczy, dlaczego w raportach pojawiają się liczby wielokrotnie większe niż liczba rzeczywistych stron.
Osobną sprawą jest kolejność parametrów. Adres z sortowaniem na pierwszym miejscu i limitem na drugim oraz adres z odwrotną kolejnością prowadzą do tej samej strony, ale są dwoma różnymi ciągami znaków. Dokumentacja Google dotycząca budżetu indeksowania wymienia właśnie różnie uporządkowane wersje tej samej strony jako przykład adresów, które warto ograniczyć.
Identyfikatory sesji i wartości tymczasowe
Identyfikator sesji w adresie jest groźniejszy od sortowania, ponieważ liczba jego wartości nie ma końca. Google w zaleceniach dotyczących struktury adresów URL w witrynach e-commerce radzi unikać linków wewnętrznych z parametrami tymczasowymi, takimi jak identyfikatory sesji, kody śledzenia, wartości zależne od użytkownika czy bieżący czas. W tym samym dokumencie znajduje się przestroga, że stale zmieniające się wartości mogą sprawić, iż Google uzna witrynę za zbiór o nieskończonej liczbie stron. Sortowanie tworzy skończoną liczbę kopii, sesja w adresie tworzy nową kopię przy każdej wizycie robota.
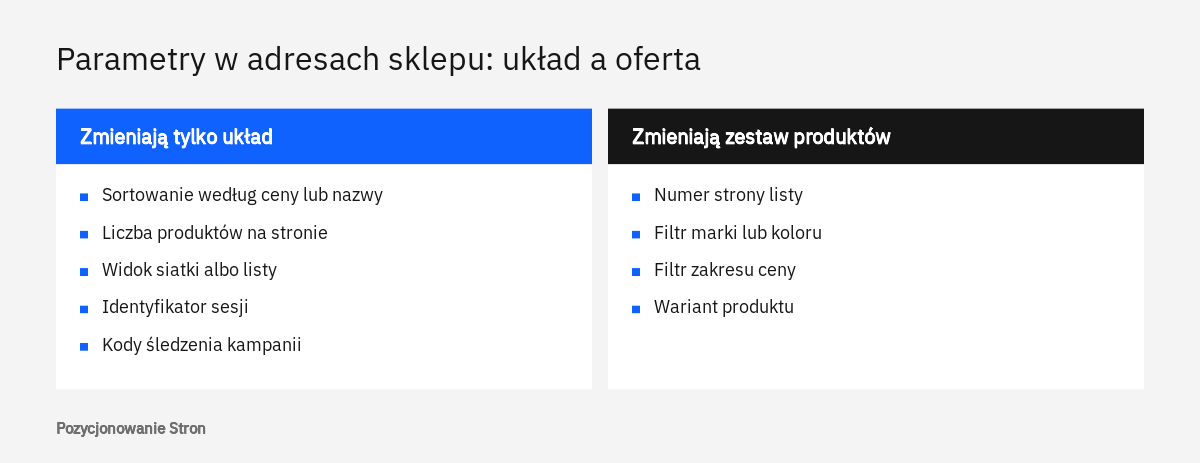
Warto od razu oddzielić parametry, które zmieniają zawartość listy, od tych, które zmieniają tylko jej układ. Numer strony listy i filtr zawężający ofertę pokazują inny zestaw produktów, więc wymagają osobnej decyzji. O filtrach piszemy szerzej we wpisie o tym, które kombinacje filtrów pokazać Google, a które zablokować. Tutaj zajmujemy się parametrami, które nigdy nie powinny tworzyć osobnej strony w wynikach wyszukiwania.
Dlaczego nadmiar adresów szkodzi widoczności sklepu
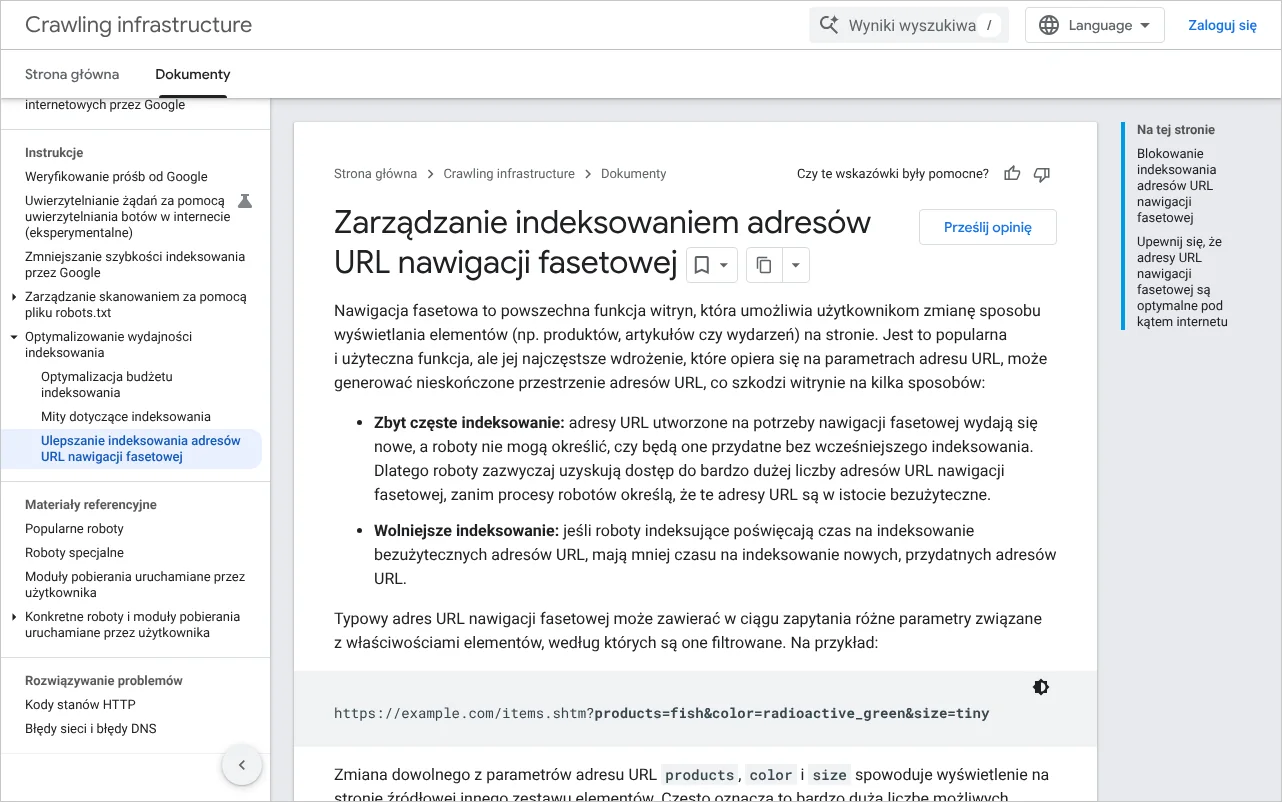
Nadmiar adresów z parametrami szkodzi przede wszystkim dlatego, że zajmuje robota pracą, z której nic nie wynika. Google opisuje to wprost w dokumencie o zarządzaniu indeksowaniem adresów URL nawigacji fasetowej: robot nie potrafi ocenić, czy nowy adres jest przydatny, dopóki go nie pobierze, więc często wysyła bardzo wiele żądań, zanim stwierdzi, że strony niewiele wnoszą. Dokument wymienia dwa skutki. Pierwszy to nadmierne skanowanie, czyli obciążenie serwera żądaniami o kopie. Drugi to wolniejsze wykrywanie: czas poświęcony na zbędne adresy jest czasem, którego zabrakło na nowe produkty i zmienione ceny.
Jest też skutek po stronie indeksu. Gdy kilka adresów pokazuje tę samą treść, Google sam wskazuje jeden z nich jako reprezentatywny. Jeśli sklep nie podpowie, który to ma być adres, wyszukiwarka może postawić na wersję z parametrem, a wtedy w wynikach pojawia się kategoria posortowana od najdroższych produktów zamiast jej podstawowej postaci. Szerzej opisujemy ten mechanizm we wpisie o tym, skąd bierze się duplikacja treści w serwisie.
Trzeba przy tym zachować proporcje. Google w dokumencie o zarządzaniu budżetem indeksowania zaznacza, że zagadnienie dotyczy głównie bardzo dużych witryn, liczących ponad milion unikalnych stron, oraz średnich i większych witryn z ponad dziesięcioma tysiącami stron i treścią zmienianą codziennie, a także serwisów, w których duża część adresów ma status wykrytych, lecz niezindeksowanych. Sam Google nazywa te liczby szacunkowymi. Sklep z trzystoma produktami nie straci widoczności tylko dlatego, że ma sortowanie w adresie. Uporządkowanie parametrów jest w nim kwestią porządku w indeksie i czytelnych raportów. W sklepie z dziesiątkami tysięcy produktów staje się warunkiem tego, by nowe karty w ogóle trafiały do wyszukiwarki w rozsądnym czasie. Więcej o tej zależności piszemy we wpisie o tym, których serwisów dotyczy budżet indeksowania.
Jak rozpoznać problem w raporcie Indeksowanie stron
Pierwszym miejscem, w którym widać duplikaty z parametrów, jest raport Indeksowanie stron w Google Search Console. Otwiera się go z menu po lewej stronie, w grupie Indeksowanie, pozycją Strony. Na górze znajduje się wykres z liczbą stron zindeksowanych i niezindeksowanych, a pod nim tabela zatytułowana "Dlaczego strony nie są indeksowane". Każdy wiersz tej tabeli to jedna przyczyna wraz z liczbą adresów, a kliknięcie wiersza otwiera listę przykładowych adresów. Zgodnie z pomocą Search Console dotyczącą raportu Indeksowanie stron tabela ma między innymi kolumny Przyczyna i Źródło, przy czym ta druga informuje, czy przyczyna leży po stronie witryny, czy po stronie Google.
Pierwszy sygnał to sama proporcja. Jeśli sklep ma cztery tysiące produktów i dwieście kategorii, a liczba stron niezindeksowanych sięga kilkudziesięciu tysięcy, źródłem prawie zawsze są adresy, których nikt świadomie nie tworzył. Drugi sygnał to wygląd przykładowych adresów w poszczególnych wierszach. Wystarczy przejrzeć listę i policzyć, w ilu adresach występuje znak zapytania oraz jakie nazwy parametrów się powtarzają.
| Przyczyna w raporcie | Co oznacza przy adresach z parametrami | Co zrobić |
|---|---|---|
| Alternatywna strona zawierająca prawidłowy tag strony kanonicznej | Adres z parametrem poprawnie wskazuje wersję podstawową, a Google ją zindeksował. | Zwykle nic. To oczekiwany stan przy poprawnie ustawionym adresie kanonicznym. |
| Duplikat, użytkownik nie oznaczył strony kanonicznej | Sklep nie podał preferowanej wersji, więc Google wskazał ją sam. | Uzupełnić adres kanoniczny w szablonie listy produktów. |
| Duplikat, wyszukiwarka Google wybrała inną stronę kanoniczną niż użytkownik | Adres kanoniczny jest podany, ale Google uznał inny adres za lepszy. | Sprawdzić adres w narzędziu do sprawdzania adresów URL i poszukać sprzecznych sygnałów. |
| Strona zeskanowana, ale jeszcze niezindeksowana | Google pobrał stronę, lecz nie umieścił jej w indeksie. | Ocenić, czy na liście dominują kopie list produktów. Jeśli tak, ograniczyć ich powstawanie. |
| Strona wykryta - obecnie niezindeksowana | Google zna adres, ale jeszcze go nie pobrał, najczęściej dlatego, że odłożył skanowanie, by nie przeciążyć witryny. | Przy dużej liczbie takich adresów rozważyć blokadę skanowania parametrów. |
| URL zablokowany przez plik robots.txt | Reguła w pliku robots.txt nie pozwala pobrać adresu. | Upewnić się, że blokada obejmuje wyłącznie zamierzone parametry. |
Najważniejsze jest właściwe odczytanie tych wierszy. Pomoc Search Console podkreśla, że niezindeksowany duplikat nie jest błędem, lecz działaniem zgodnym z zamierzeniami, ponieważ Google nie wyświetla zduplikowanych stron. Duża liczba w wierszu o alternatywnej stronie z prawidłowym tagiem kanonicznym świadczy więc o tym, że mechanizm działa. Niepokoić powinny dwa inne obrazy: rosnąca liczba adresów wykrytych, lecz niezindeksowanych, oraz sytuacja, w której wśród takich adresów czekają także prawdziwe karty produktów.
Co pokazują statystyki indeksowania i narzędzie do sprawdzania adresów
Raport Statystyki indeksowania pokazuje nie to, co trafiło do indeksu, lecz to, o co roboty Google faktycznie prosiły serwer. Dzięki temu widać, ile pracy robota pochłaniają adresy z parametrami. Według pomocy Search Console raport otwiera się przez Ustawienia usługi, a następnie pozycję Statystyki indeksowania. Jest dostępny tylko dla usług najwyższego poziomu, czyli usługi domeny albo usługi z prefiksem adresu URL obejmującej całą witrynę.
Na górze znajdują się trzy wykresy: łączna liczba żądań robota indeksującego, całkowity rozmiar pobierania i średni czas odpowiedzi. Poniżej żądania są pogrupowane na cztery sposoby: według odpowiedzi serwera, typu pliku, celu indeksowania i typu Googlebota. Przy szukaniu duplikatów najwięcej mówi grupa Cel indeksowania, w której Google rozróżnia Wykrycie, czyli pobranie adresu wcześniej nieznanego, oraz Odświeżenie, czyli ponowne pobranie znanej strony. Kliknięcie dowolnej pozycji otwiera listę przykładowych adresów. Jeśli na liście wykrytych adresów dominują wersje z sortowaniem, limitem lub identyfikatorem sesji, robot poznaje w sklepie głównie kopie. Pomoc zastrzega, że lista przykładów nie jest kompletna, więc służy do rozpoznania wzorca, a nie do dokładnych wyliczeń.
Warto też spojrzeć na średni czas odpowiedzi i stan hosta. Dokumentacja o budżecie indeksowania wyjaśnia, że limit wydajności skanowania rośnie, gdy serwer odpowiada stabilnie, a maleje, gdy czas odpowiedzi się wydłuża lub pojawiają się błędy serwera. Tysiące żądań o posortowane listy, które serwer musi za każdym razem wygenerować od nowa, mogą więc pośrednio spowolnić skanowanie całego sklepu.
Sprawdzanie pojedynczego adresu
Pojedynczy adres z parametrem najlepiej zbadać w narzędziu do sprawdzania adresów URL. Wystarczy wkleić pełny adres w pasek wyszukiwania u góry ekranu Search Console. Jak podaje pomoc dotycząca tego narzędzia, w szczegółach indeksowania znajdują się między innymi pola "Adres kanoniczny określony przez użytkownika", "Adres kanoniczny wybrany przez Google", "Strona odsyłająca", "Czy skanowanie jest dozwolone" oraz "Ostatnie skanowanie". Porównanie dwóch pierwszych pól od razu odpowiada na pytanie, czy Google przyjął podpowiedź sklepu. Pole ze stroną odsyłającą pokazuje z kolei, skąd robot dowiedział się o adresie, co pomaga znaleźć szablon lub moduł, który rozsiewa linki z parametrami.
Jak rozwiązać problem adresem kanonicznym
Adres kanoniczny rozwiązuje problem po stronie indeksu: informuje Google, że posortowana lub inaczej ułożona lista jest kopią strony podstawowej i to ta podstawowa ma być pokazywana w wynikach. W kodzie strony jest to jeden wiersz w sekcji head. Na adresie z parametrem sortowania wskazuje on adres tej samej kategorii bez tego parametru.
Otwarty adres:
https://example.com/umywalki/?sort=cena&view=lista

W sekcji head tej strony:
<link rel="canonical" href="https://example.com/umywalki/" />
Google w dokumencie o tym, jak określić stronę kanoniczną, podaje kilka zasad, które w sklepach bywają łamane. Adres w znaczniku powinien być bezwzględny, czyli pełny, z protokołem i domeną. Znacznik ma się znajdować w sekcji head, a strona podstawowa powinna wskazywać samą siebie. Linki wewnętrzne powinny prowadzić do wersji kanonicznej, a nie do kopii. Ten sam adres powinien stać w mapie witryny, ponieważ mieszanie metod, na przykład inny adres w mapie i inny w znaczniku, osłabia przekaz. Dokument wymienia też metody od najsilniejszej: przekierowanie, znacznik rel="canonical" i mapę witryny, przy czym mapę nazywa sygnałem słabym.
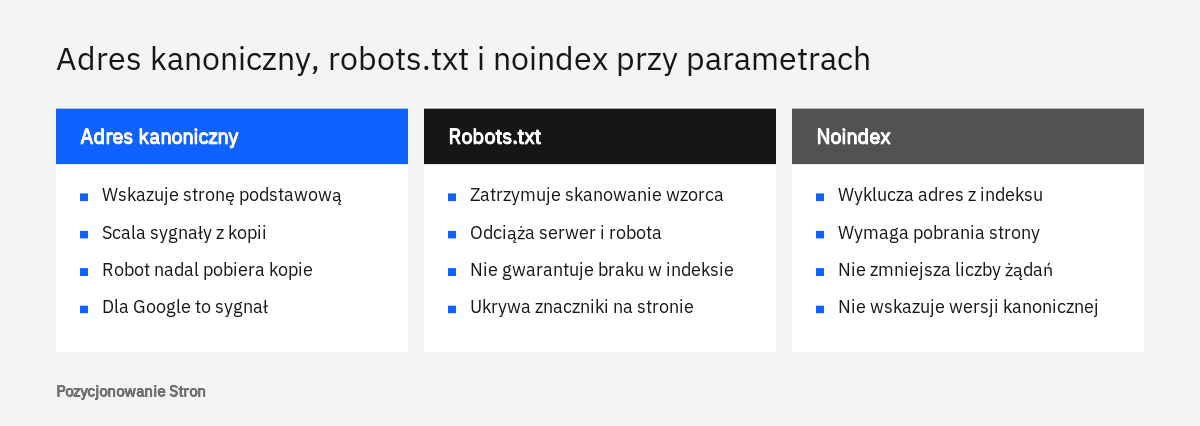
Trzeba rozumieć granice tego rozwiązania. Google nazywa adres kanoniczny sygnałem i zastrzega, że bierze pod uwagę także inne czynniki, więc może wskazać inną wersję niż podana. Poza tym robot musi pobrać kopię, żeby odczytać z niej znacznik. Dokument o nawigacji fasetowej mówi, że adres kanoniczny z czasem zmniejsza skanowanie wersji niekanonicznych, ale w dłuższej perspektywie jest pod tym względem mniej skuteczny niż blokada w robots.txt. Adres kanoniczny porządkuje więc indeks i scala sygnały, natomiast obciążenie serwera zmniejsza powoli i tylko częściowo.
Kolejne strony listy to osobny przypadek
Częstą pomyłką jest potraktowanie numeru strony listy tak samo jak sortowania. Druga i trzecia strona kategorii pokazują inne produkty niż pierwsza, więc nie są jej kopiami. Google w zaleceniach o podziale na strony pisze, by nie używać pierwszej strony sekwencji jako kanonicznej dla pozostałych i każdej stronie przypisać własny kanoniczny adres URL. W praktyce oznacza to, że adres z numerem strony i sortowaniem powinien wskazywać jako kanoniczny adres z tym samym numerem strony, ale bez sortowania. Ten sam dokument radzi, by przy filtrach i alternatywnych kolejnościach sortowania zablokować indeksowanie niepożądanych adresów wartością noindex albo wyłączyć skanowanie ich wzorców w pliku robots.txt.
Jeśli chcą Państwo zamówić SEO techniczne, zachęcamy do kontaktu: tel. 222 500 844 lub mailowo: biuro@pozycjonowaniestron.pl
Jak ograniczyć skanowanie parametrów regułami w robots.txt
Reguły w pliku robots.txt rozwiązują problem po stronie skanowania: robot w ogóle nie pobiera adresów pasujących do wzorca. Jest to rozwiązanie właściwe dla sklepów, w których kopie list produktów pochłaniają znaczną część żądań robota. Google w dokumencie o nawigacji fasetowej podaje przykład reguł, które blokują adresy zawierające określone parametry w dowolnym miejscu ciągu zapytania. Ten sam wzorzec można zastosować do parametrów sortowania, liczby produktów, widoku i sesji.
user-agent: *
disallow: /*?*sort=
disallow: /*?*limit=
disallow: /*?*view=
disallow: /*?*sid=
Znaczenie znaków opisuje dokument o tym, jak Google interpretuje specyfikację pliku robots.txt. Gwiazdka zastępuje dowolny ciąg znaków, także pusty, a znak dolara oznacza koniec adresu. Reguła z przykładu czyta się więc tak: dowolna ścieżka, potem znak zapytania, potem cokolwiek, potem nazwa parametru ze znakiem równości. Obejmuje to parametr zarówno na pierwszym, jak i na dalszym miejscu. Wartości ścieżek rozróżniają wielkość liter, więc reguła dla sort= nie obejmie adresu z zapisem Sort=. Gdy do jednego adresu pasuje reguła zezwalająca i zabraniająca, wygrywa ta o dłuższej ścieżce, a przy równej długości ta mniej restrykcyjna. Po zmianie pliku efekt nie jest natychmiastowy, ponieważ Google zwykle przechowuje robots.txt w pamięci podręcznej do dwudziestu czterech godzin.
Czego robots.txt nie załatwi
Blokada skanowania nie jest równoznaczna z usunięciem z wyników. Pomoc Search Console przy przyczynie "URL zablokowany przez plik robots.txt" zaznacza, że taka blokada nie gwarantuje braku indeksowania, ponieważ adres może trafić do indeksu na podstawie linków z innych stron. Jeśli celem jest pewne wykluczenie adresu z wyników, trzeba pozwolić robotowi go pobrać i zastosować znacznik noindex. Dostępne sposoby porównujemy we wpisie o usuwaniu strony z wyników Google.
Z tego samego powodu Google nie zaleca używania robots.txt do wskazywania strony kanonicznej. Robot, któremu zabroniono pobrać adres, nie odczyta z niego ani znacznika kanonicznego, ani znacznika noindex. Połączenie blokady w robots.txt z adresem kanonicznym na tej samej stronie nie daje więc podwójnego zabezpieczenia: działa wyłącznie blokada. Trzeba też wiedzieć, że dokument o budżecie indeksowania odradza stosowanie noindex jako sposobu na ograniczenie skanowania, bo Google i tak musi wysłać żądanie, żeby ten znacznik odczytać.
Google wymienia jeszcze dwie możliwości. Pierwsza to zapisanie wyboru klienta we fragmencie adresu, czyli po znaku krzyżyka. Google co do zasady nie uwzględnia fragmentów przy skanowaniu i indeksowaniu, więc takie adresy nie tworzą kopii. Wymaga to jednak sklepu, który zmienia układ listy po stronie przeglądarki. Druga to atrybut rel="nofollow" na linkach do wersji z parametrami, skuteczny tylko wtedy, gdy ma go każdy link prowadzący do danego adresu. Obie metody Google ocenia jako mniej skuteczne w dłuższym okresie niż blokada w robots.txt.
W jakiej kolejności wprowadzać zmiany
Kolejność ma znaczenie, ponieważ adres kanoniczny i blokada w robots.txt wzajemnie się wykluczają na tym samym adresie. Rozsądnie jest najpierw usunąć źródło zbędnych adresów, potem uporządkować indeks adresem kanonicznym, a blokadę skanowania wprowadzać dopiero wtedy, gdy dane pokazują, że jest potrzebna.
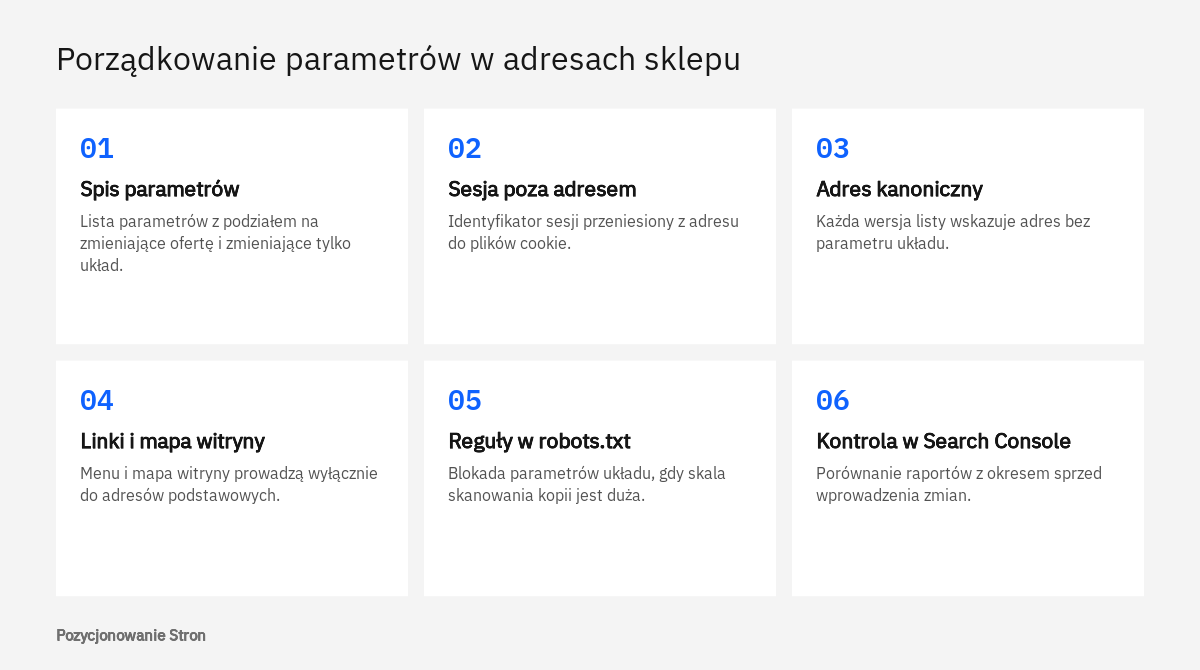
- Spis parametrów
Na podstawie eksportów z raportu Indeksowanie stron i przykładów ze statystyk indeksowania powstaje lista parametrów sklepu z oznaczeniem, czy zmieniają zestaw produktów, czy tylko ich układ.
- Usunięcie identyfikatorów sesji z adresów
Sesję klienta powinny przechowywać pliki cookie, a nie adres. To jedyny przypadek, w którym kopie warto zlikwidować u źródła, zamiast nimi zarządzać.
- Adres kanoniczny w szablonie listy
Każda wersja listy z parametrem układu wskazuje adres bez tego parametru, z zachowaniem numeru strony. Strona podstawowa wskazuje samą siebie.
- Porządek w linkach i mapie witryny
Menu, okruszki, banery i mapa witryny prowadzą wyłącznie do adresów podstawowych.
- Blokada w robots.txt przy dużej skali
Gdy mimo poprawnych adresów kanonicznych roboty nadal pobierają dziesiątki tysięcy kopii, a nowe produkty długo czekają na indeksację, reguły dla parametrów układu zastępują adres kanoniczny jako główne zabezpieczenie.
- Kontrola po kilku tygodniach
W raporcie Indeksowanie stron i w statystykach indeksowania należy porównać liczby i przykładowe adresy z okresem sprzed zmian.
Warto zadbać również o samą budowę parametrów, jeśli oprogramowanie na to pozwala. Google zaleca zapis w postaci klucz=wartość zamiast samej wartości, standardowy separator & oraz niepowtarzanie tego samego parametru w jednym adresie, ponieważ Googlebot może pominąć jedną z wartości. Ogólne zasady opisujemy we wpisie o strukturze adresów URL. Skutków nie należy oczekiwać z dnia na dzień: liczby w raportach zmieniają się stopniowo, w miarę jak robot ponownie trafia na poszczególne adresy.
Typowe pomyłki i sytuacje, w których potrzebna jest pomoc
Najczęstsza pomyłka to sięgnięcie po wszystkie zabezpieczenia jednocześnie. Sklep otrzymuje adres kanoniczny, znacznik noindex i regułę w robots.txt dla tych samych adresów, po czym okazuje się, że działa wyłącznie blokada, a dwa pozostałe elementy są dla robota niewidoczne. Druga pomyłka to zbyt szeroki wzorzec, na przykład blokada wszystkich adresów ze znakiem zapytania. Taka reguła odcina także kolejne strony list, a wraz z nimi drogę do produktów, do których robot mógł dotrzeć tylko przez dalsze strony kategorii.
Trzecia pomyłka dotyczy adresu kanonicznego, który kopiuje bieżący adres razem z parametrami. Każda posortowana lista ogłasza wtedy samą siebie jako stronę podstawową. Czwarta to adresy z parametrami w mapie witryny lub w linkach z menu, które przeczą znacznikowi kanonicznemu. Piąta to uznanie wiersza o alternatywnej stronie z prawidłowym tagiem kanonicznym za błąd, choć Google opisuje ten stan jako zgodny z zamierzeniami.
- Lista parametrów sklepu jest spisana i podzielona na zmieniające ofertę oraz zmieniające tylko układ.
- Adres sklepu nie zawiera identyfikatora sesji ani innych wartości tymczasowych.
- Posortowana lista wskazuje jako kanoniczny adres bez sortowania, z tym samym numerem strony.
- Mapa witryny i linki w menu zawierają wyłącznie adresy podstawowe.
- Reguły w robots.txt nie obejmują numeru strony listy ani filtrów, które mają być dostępne dla robota.
- Ten sam adres nie jest jednocześnie blokowany w robots.txt i oznaczony znacznikiem noindex lub kanonicznym.
Samodzielnie da się zwykle rozpoznać problem i ustalić, które parametry za niego odpowiadają. Pomoc specjalisty jest wskazana, gdy zmiana wymaga ingerencji w szablon lub silnik sklepu albo gdy w grę wchodzą jednocześnie filtry, warianty i paginacja. Takie prace prowadzimy w ramach SEO technicznego oraz pozycjonowania sklepów, a punktem wyjścia bywa audyt SEO, który pokazuje pełną listę adresów pobieranych przez roboty.
Jeśli chcą Państwo zamówić SEO techniczne, zachęcamy do kontaktu: tel. 222 500 844 lub mailowo: biuro@pozycjonowaniestron.pl
Najczęstsze pytania
Czy sortowanie w adresie sklepu obniża pozycje w Google?
Samo sortowanie w adresie nie jest powodem kary. Google opisuje skutki pośrednie: nadmierne skanowanie kopii i wolniejsze wykrywanie nowych stron. W małym sklepie jest to głównie kwestia porządku, w dużym może opóźniać pojawianie się nowych produktów w wyszukiwarce.
Co lepiej zastosować: adres kanoniczny czy robots.txt?
To zależy od celu. Adres kanoniczny porządkuje indeks, ale robot nadal pobiera kopie. Blokada w robots.txt ogranicza skanowanie, lecz nie przekazuje informacji o stronie podstawowej. Na jednym adresie stosuje się jedno z tych rozwiązań.
Czy posortowaną listę produktów oznaczyć znacznikiem noindex?
Google dopuszcza noindex dla alternatywnych kolejności sortowania jako sposób wykluczenia ich z indeksu. Nie zmniejsza to jednak liczby żądań robota, ponieważ strona musi zostać pobrana, żeby znacznik został odczytany.
Czy druga strona kategorii powinna wskazywać pierwszą jako kanoniczną?
Nie. Google zaleca, aby każda strona listy miała własny kanoniczny adres URL. Kolejne strony pokazują inne produkty, więc nie są kopiami pierwszej.
Dlaczego w raporcie nadal widać tysiące adresów z parametrami, mimo adresu kanonicznego?
Raport Indeksowanie stron pokazuje także adresy poprawnie rozpoznane jako kopie, na przykład w wierszu o alternatywnej stronie z prawidłowym tagiem kanonicznym. Pomoc Search Console opisuje to jako stan zgodny z zamierzeniami, a nie błąd.
Jak szybko Google uwzględnia zmianę w pliku robots.txt?
Google zwykle przechowuje plik robots.txt w pamięci podręcznej do dwudziestu czterech godzin, więc nowe reguły zaczynają obowiązywać z takim opóźnieniem. Zmiany w raportach Search Console są widoczne później, w miarę jak robot ponownie odwiedza poszczególne adresy.
Źródła
- Zarządzanie indeksowaniem adresów URL nawigacji fasetowej, Google for Developers
- Sprawdzone metody projektowania struktury adresów URL na potrzeby witryn e-commerce, Centrum wyszukiwarki Google
- Jak określić stronę kanoniczną za pomocą rel="canonical" i innych metod, Centrum wyszukiwarki Google
- Sprawdzone metody dotyczące podziału na strony, Centrum wyszukiwarki Google
- Jak Google interpretuje specyfikację pliku robots.txt, Google for Developers
- Zarządzanie budżetem indeksowania, Google for Developers
- Raport Indeksowanie stron, Pomoc Search Console
- Raport Statystyki indeksowania, Pomoc Search Console
- Narzędzie do sprawdzania adresów URL, Pomoc Search Console
Funkcje wyszukiwarek i asystentów AI zmieniają się szybko, dlatego wpis aktualizujemy po większych zmianach.