Słownik AI dla marketera to czterdzieści pojęć, które wracają w ofertach narzędzi, w rozmowach z wykonawcami i w dokumentacji asystentów takich jak ChatGPT, Gemini czy Copilot. Każde hasło wyjaśniamy kilkoma zdaniami i przykładem z marketingu, aby mogli Państwo swobodnie zadawać pytania dostawcy i oceniać, co kryje się za jego obietnicami.
Jak korzystać ze słownika pojęć AI w pracy marketera
Słownik jest ułożony tematycznie, a nie alfabetycznie: od podstaw, przez tokeny i polecenia, po źródła wiedzy, agentów i wyszukiwarkę. Każde kolejne hasło opiera się na poprzednich, więc całość można przeczytać raz, a później wracać do pojedynczych pojęć przed spotkaniem z wykonawcą.
Definicje opieramy na publicznej dokumentacji, przede wszystkim na słowniczku generatywnej AI prowadzonym przez Google, dokumentacji interfejsu Gemini API oraz Centrum wyszukiwarki Google. Polskie nazwy podajemy za tymi źródłami, a w nawiasie dopisujemy angielski odpowiednik, ponieważ w ofertach spotyka się obie wersje. Tam, gdzie dopowiadamy coś z własnego doświadczenia, wyraźnie to zaznaczamy.
| Grupa pojęć | Hasła | Pytanie, na które odpowiada |
|---|---|---|
| Podstawy | 1-7 | Czym jest narzędzie, które firma kupuje? |
| Powstawanie modelu | 8-13 | Skąd model ma wiedzę i czy da się go nauczyć stylu marki? |
| Tokeny i ustawienia | 14-19 | Za co się płaci i dlaczego odpowiedzi bywają różne? |
| Polecenia | 20-25 | Jak sformułować zadanie, aby wynik był przewidywalny? |
| Źródła wiedzy | 26-32 | Dlaczego model się myli i jak oprzeć go na faktach? |
| Agenci i narzędzia | 33-36 | Co model może zrobić poza napisaniem tekstu? |
| Wyszukiwarka | 37-40 | Jak AI w Google wpływa na widoczność strony? |
Podstawowe pojęcia: od sztucznej inteligencji do dużego modelu językowego
Siedem pierwszych haseł porządkuje to, o czym mowa, gdy ktoś oferuje „narzędzie z AI”. Im ogólniejsze słowo pada w ofercie, tym mniej z niego wynika, dlatego warto umieć zapytać o konkretny rodzaj modelu.
1. Sztuczna inteligencja (AI)
Według słowniczka systemów uczących się Google jest to program lub model niebędący człowiekiem, który potrafi wykonywać złożone zadania, na przykład tłumaczyć tekst. To pojęcie najszersze z całej listy. Gdy sklep z Poznania słyszy, że wyszukiwarka produktów „działa na AI”, nie wie jeszcze nic o tym, jak powstają wyniki.
2. Uczenie maszynowe (machine learning)
Ten sam słowniczek określa uczenie maszynowe jako poddziedzinę sztucznej inteligencji. W uproszczeniu chodzi o systemy, które zamiast reguł wpisanych ręcznie wyprowadzają prawidłowości z danych. Przykładem jest system, który na podstawie historii zamówień przewiduje, którzy klienci sklepu wrócą po kolejny zakup. Niczego on nie pisze, jedynie prognozuje.
3. Generatywna AI
Google przyznaje, że dziedzina nie ma formalnej definicji, ale przyjmuje się, że modele generatywne tworzą treści złożone, spójne i oryginalne: teksty, obrazy, dźwięk czy filmy. To ta gałąź trafia najczęściej do działów marketingu, gdy powstaje szkic opisu kategorii albo grafika do wpisu w mediach społecznościowych.
4. Duży model językowy (LLM)
To model językowy z bardzo dużą liczbą parametrów, a potocznie każdy model językowy zbudowany w architekturze Transformer. Google przypomina właścicielom witryn, że takie modele przewidują prawdopodobne sekwencje słów, a nie wyszukują faktów. Dla marketera to najważniejsze zdanie słownika: płynny tekst nie jest dowodem prawdziwości. Mechanikę opisaliśmy we wpisie o tym, jak działa duży model językowy.
5. Model podstawowy (foundation model)
Jest to bardzo duży model wytrenowany na ogromnym, zróżnicowanym zbiorze danych, który stanowi punkt wyjścia do dalszego dopasowywania. Z naszej praktyki wynika, że wiele narzędzi marketingowych to nakładka na cudzy model podstawowy, uzupełniona o gotowe polecenia i interfejs. Warto zapytać dostawcę, z jakiego modelu korzysta i co się stanie, gdy zostanie on zastąpiony nowszym.
6. Transformer i mechanizm uwagi
Transformer to architektura sieci neuronowej, na której bazują duże modele językowe. Jej mechanizm uwagi wskazuje, jak ważne jest dane słowo lub jego część przy przewidywaniu kolejnego tokena. Skutek dla marketera: model waży słowa polecenia względem siebie, więc doprecyzowanie odbiorcy, celu i formy realnie zmienia wynik.
7. Model multimodalny
Tak określa się model, który przyjmuje nie tylko tekst. Dokumentacja Gemini API opisuje, że na tokeny zamieniane są wszystkie dane wejściowe, w tym obrazy i inne formaty nietekstowe. W marketingu oznacza to możliwość przekazania modelowi zdjęcia witryny sklepowej albo zrzutu strony docelowej z prośbą o opis lub ocenę czytelności.
Jak powstaje i uczy się model: parametry, trenowanie i dostrajanie
Model powstaje w etapach: najpierw jest trenowany na wielkim zbiorze danych, potem bywa dopasowywany do węższych zadań, a na końcu jest już tylko używany. Sześć haseł z tej grupy pozwala odróżnić, czy dostawca rzeczywiście zmienia model, czy jedynie podaje mu dodatkowe informacje w poleceniu.
8. Parametry (wagi)
Parametry to liczby wewnątrz modelu ustalane w trakcie trenowania. W materiałach reklamowych ich liczba bywa podawana jako miara jakości. Z naszych obserwacji wynika, że bardziej miarodajny jest prosty test: te same typowe zadania zlecone dwóm narzędziom i porównanie wyników przez osobę, która zna branżę.
9. Wstępne trenowanie (pre-training)
To początkowe trenowanie modelu na dużym zbiorze danych, po którym można go dalej dopracowywać. Stąd bierze się ogólna wiedza modelu o języku i świecie. Nie wynika z niej znajomość aktualnego cennika hydraulika z Łodzi ani regulaminu promocji w Państwa sklepie.
10. Dostrajanie (fine-tuning)
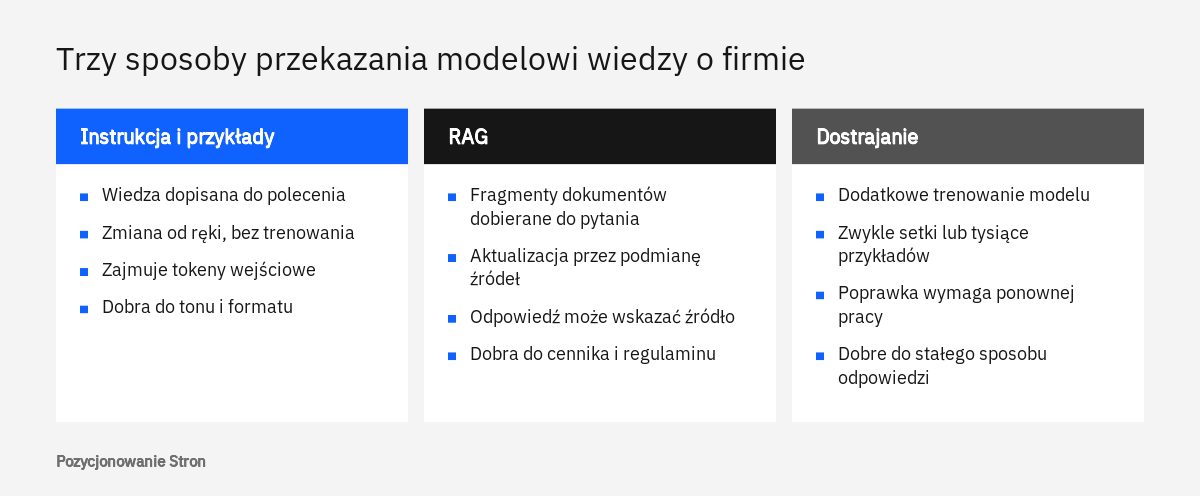
Dostrajanie to drugi etap trenowania gotowego modelu, który dopasowuje go do konkretnego zadania. Słowniczek Google zaznacza, że zwykle wymaga ono setek lub tysięcy przykładów. Gdy dostawca obiecuje „model nauczony stylu Państwa marki”, warto dopytać, czy chodzi o prawdziwe dostrajanie, czy o instrukcję i kilka przykładów dołączanych do każdego polecenia. Oba rozwiązania różnią się kosztem i tym, jak łatwo wprowadzić poprawki.
11. Destylacja
Destylacja polega na zmniejszeniu dużego modelu, nazywanego nauczycielem, do mniejszego modelu, czyli ucznia, który naśladuje jego przewidywania. Zyskiem jest szybsze działanie oraz mniejsze zużycie pamięci i energii, a ceną zwykle nieco gorsze wyniki. W cennikach widać to jako warianty „lekkie” lub „szybkie”, które wystarczają na przykład do masowego przypisywania produktów do kategorii.
12. Wnioskowanie (inference)
W przypadku dużych modeli językowych wnioskowanie oznacza użycie wytrenowanego modelu do wygenerowania odpowiedzi na polecenie. Firma korzystająca z gotowego narzędzia płaci właśnie za wnioskowanie: każdy wygenerowany opis produktu i każda odpowiedź czatu na stronie to osobne użycie modelu.
13. Granica wiedzy (knowledge cutoff)
To moment, po którym model nie ma już danych treningowych. Dokumentacja Gemini API zaleca informowanie modelu o dacie granicznej jego wiedzy i o bieżącym czasie, gdy zadanie wymaga aktualnych informacji. Nowa usługa kancelarii z Krakowa nie jest więc modelowi znana, dopóki nie sięgnie on do wyszukiwarki albo nie otrzyma opisu w poleceniu.
Tokeny, okno kontekstu i ustawienia odpowiedzi
Model nie liczy tekstu w znakach ani w stronach, tylko w tokenach, i w tokenach wyrażone są zarówno jego ograniczenia, jak i rachunek za użycie. Sześć kolejnych pojęć wyjaśnia, dlaczego długi dokument się „nie mieści”, skąd biorą się koszty i dlaczego to samo polecenie daje za każdym razem trochę inny wynik.
14. Token
Token to jednostka, na którą model dzieli dane wejściowe i wyjściowe. Może nim być pojedynczy znak albo całe słowo, a długie słowa są dzielone na kilka tokenów. Dokumentacja Gemini API podaje orientacyjnie, że jeden token to około 4 znaków, a 100 tokenów odpowiada mniej więcej 60-80 słowom w języku angielskim. Dla języka polskiego nie ma tam osobnego przelicznika, dlatego najbezpieczniej policzyć tokeny na próbce własnych tekstów.
15. Okno kontekstu
Okno kontekstu to maksymalna liczba tokenów, jaką model może przetworzyć, przy czym limit obejmuje łącznie dane wejściowe i wyjściowe. Jeśli agencja nieruchomości wklei do rozmowy kilkadziesiąt długich ofert, a potem długo dopytuje o szczegóły, wszystko to razem musi się zmieścić w oknie.
16. Tokeny wejściowe i wyjściowe
Tokeny wejściowe to wszystko, co trafia do modelu: polecenie, załączone pliki, instrukcja systemowa i opisy narzędzi. Tokeny wyjściowe to wygenerowana odpowiedź. Koszt wywołania zależy częściowo od liczby jednych i drugich. Przy narzędziu rozliczanym „za użycie” warto ustalić, czy limit dotyczy zapytań, czy tokenów, oraz czy instrukcje dodawane przez dostawcę do każdego polecenia wliczają się do Państwa puli.
17. Temperatura
Temperatura steruje losowością odpowiedzi: wyższa wartość daje wyniki bardziej zróżnicowane, niższa bardziej przewidywalne, a wartość 0 jest w dokumentacji opisana jako deterministyczna. Intuicja podpowiada wyższą temperaturę dla haseł reklamowych i niższą dla opisów technicznych. Trzeba jednak sprawdzić zalecenia dla konkretnego modelu, ponieważ dla najnowszej generacji Gemini dokumentacja radzi pozostawić wartości domyślne i ostrzega, że temperatura poniżej 1,0 może powodować zapętlanie się odpowiedzi.
18. Parametry topK i topP
Oba parametry zawężają pulę tokenów, spośród których model wybiera następny. Przy topK równym 1 model zawsze bierze token najbardziej prawdopodobny, przy wartości 3 wybiera spośród trzech. Parametr topP odcina pulę według sumy prawdopodobieństw; w dokumentacji Gemini jego wartość domyślna to 0,95. W gotowych narzędziach tych ustawień zwykle nie widać, pojawiają się przy rozwiązaniach budowanych na zamówienie.
19. Myślenie modelu (thinking, rozumowanie)
Nowsze modele przed udzieleniem odpowiedzi wewnętrznie analizują polecenie, co według dokumentacji poprawia rozumowanie i planowanie wieloetapowe. Ten etap zużywa osobne, płatne tokeny. Do prostych zadań, takich jak klasyfikacja zgłoszeń z formularza kontaktowego, dokumentacja zaleca niski poziom myślenia, a wysoki rezerwuje dla zadań złożonych.
Prompt, instrukcja systemowa i techniki formułowania poleceń
Prompt to po prostu polecenie przekazane modelowi, a jego jakość w dużej mierze decyduje o jakości wyniku. Sześć haseł z tej grupy opisuje rodzaje poleceń, z którymi marketer styka się codziennie, nawet jeśli nie zna ich nazw.
20. Prompt
Słowniczek Google definiuje prompt jako tekst wejściowy, który ukierunkowuje zachowanie modelu. Może zawierać pytania, instrukcje, przykłady, role oraz częściowe dane do uzupełnienia. Umiejętność układania poleceń nazywa się projektowaniem promptów (prompt engineering). Dobre polecenie dla tekstu ofertowego mówi, kto jest odbiorcą, co ma on zrobić po lekturze, jak długi ma być tekst i czego nie wolno w nim obiecywać.
21. Instrukcja systemowa (system prompt)
To stały zestaw poleceń nadrzędnych, który obowiązuje w całej rozmowie i którego użytkownik zwykle nie widzi. Strategie projektowania promptów w dokumentacji Gemini zalecają umieszczanie tam najważniejszych ograniczeń, definicji ról i wymagań co do formatu. Czat na stronie kancelarii z Krakowa powinien mieć w niej zapis, że nie udziela porad w indywidualnych sprawach. Warto poprosić wykonawcę o wgląd w tę instrukcję, bo to ona określa, jak asystent reprezentuje firmę.
22. Prompt bez przykładów (zero-shot)
Polecenie, które nie zawiera żadnego wzoru odpowiedzi. Model sam decyduje o formie, więc prośba o „opis fotela biurowego” da tekst poprawny językowo, ale o przypadkowej długości, tonie i układzie.
23. Prompt z kilkoma przykładami (few-shot)
Polecenie zawierające kilka przykładów, które pokazują modelowi oczekiwany sposób odpowiedzi; słowniczek Google podaje też synonim „uczenie w kontekście”. Dokumentacja Gemini zaleca dołączanie przykładów w jednolitym formacie i zastrzega, że zbyt wiele przykładów może skłonić model do nadmiernego naśladowania. Dwa lub trzy wzorcowe opisy produktów zwykle porządkują wynik skuteczniej niż długa lista zasad.
Zadanie: jedno zdanie opisu produktu, do 120 znaków, bez superlatywów.

Produkt: biurko z regulacją wysokości, blat 140 cm
Opis: Biurko z elektryczną regulacją wysokości i blatem 140 cm do pracy na siedząco i stojąco.

Produkt: lampa biurkowa LED ze ściemniaczem
Opis: Lampa LED z płynną regulacją jasności i ruchomym ramieniem.

Produkt: fotel obrotowy z podparciem lędźwi
Opis:
24. Prompt z rolą (role prompting)
Polecenie, które każe modelowi przyjąć określoną rolę. Rola ustawia słownictwo i perspektywę: inaczej odpowie „doradca klienta w hurtowni budowlanej”, a inaczej „redaktor magazynu wnętrzarskiego”. Rola nie daje jednak modelowi wiedzy, której nie ma.
25. Łańcuch myśli (chain-of-thought)
Technika polegająca na zachęceniu modelu, aby wyjaśniał rozumowanie po kolei, zamiast podawać sam wynik. Przydaje się przy podziale budżetu kampanii między kanały, bo jawny tok rozumowania ułatwia wychwycenie błędu, choć go nie wyklucza. Do rachunków dokumentacja Gemini zaleca narzędzie wykonywania kodu, a nie samo generowanie tekstu.
Jeśli chcą Państwo zamówić pozycjonowanie AI, zachęcamy do kontaktu: tel. 222 500 844 lub mailowo: biuro@pozycjonowaniestron.pl
Skąd model bierze fakty: halucynacja, grounding, RAG i osadzenia wektorowe
Model sam z siebie zna tylko to, co utrwaliło się w nim podczas trenowania, a resztę musi dostać w chwili zadania pytania. Siedem pojęć z tej grupy opisuje, skąd biorą się błędy i jaką drogą do odpowiedzi trafiają zewnętrzne źródła, w tym strony firm.
26. Halucynacja
Halucynacja to wiarygodnie brzmiąca odpowiedź, która jest niezgodna z faktami. Nie jest to awaria, tylko skutek sposobu działania modelu. Wskazówki Google dotyczące treści tworzonych z użyciem generatywnej AI zalecają z tego powodu ręczne sprawdzenie dokładności tekstu przed publikacją, a także tytułów, opisów meta i danych strukturalnych. Zmyślonym informacjom o samej firmie poświęciliśmy wpis o błędnych informacjach o firmie w AI.
27. Grounding (ugruntowanie, oparcie na źródłach)
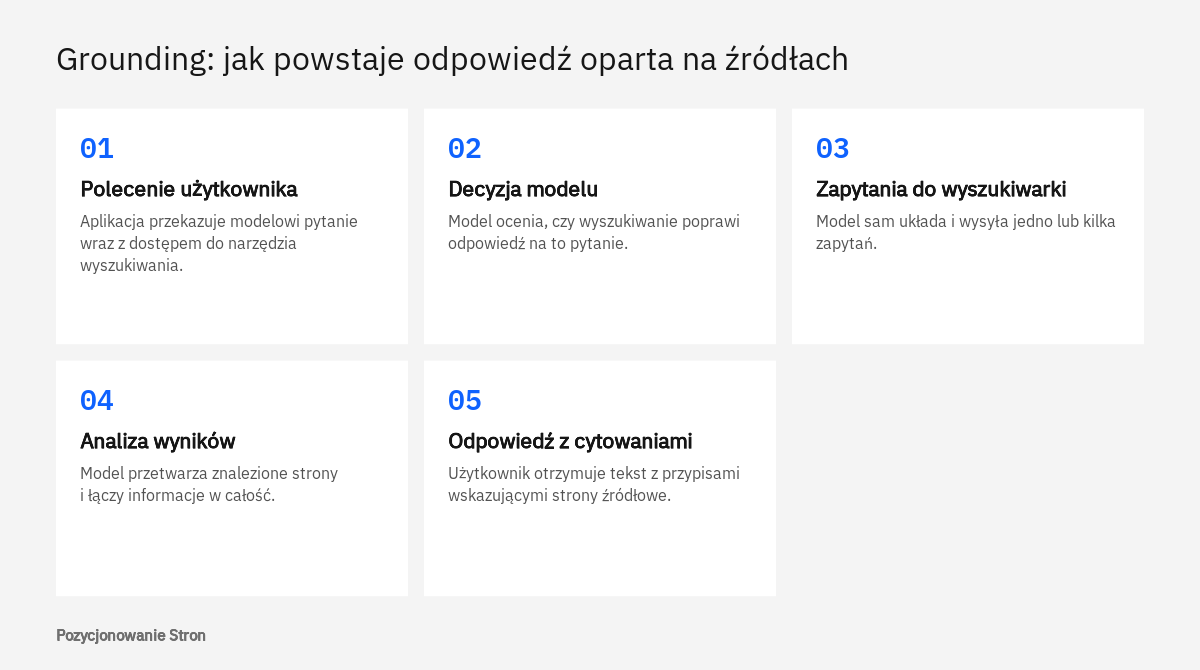
Grounding oznacza powiązanie odpowiedzi modelu z konkretnymi, sprawdzalnymi źródłami. Dokumentacja groundingu z użyciem wyszukiwarki Google wymienia trzy korzyści: większą dokładność i mniej halucynacji, dostęp do bieżących wydarzeń oraz cytowania pokazujące, skąd pochodzi dane twierdzenie. Na tym etapie strona firmy może stać się źródłem wskazanym w odpowiedzi asystenta.
28. RAG, czyli generowanie wspomagane wyszukiwaniem
RAG (retrieval-augmented generation) to według opisu Google Cloud podejście łączące tradycyjne systemy wyszukiwania informacji z możliwościami dużych modeli językowych. System najpierw wyszukuje pasujące fragmenty w zewnętrznych danych, a potem przekazuje je modelowi razem z pytaniem. Daje to dostęp do świeżych informacji, ogranicza halucynacje i zmniejsza liczbę tokenów w porównaniu z wklejaniem całych dokumentów. Typowe zastosowanie to czat odpowiadający klientom na podstawie regulaminu i cennika. Więcej we wpisie RAG i grounding: dlaczego asystenci AI cytują strony internetowe.
29. Osadzenia wektorowe (embeddings, wektory dystrybucyjne)
Osadzenie to zapis treści w postaci ciągu liczb, czyli wektora, który oddaje jej znaczenie. Dokumentacja Gemini API wymienia zastosowania osadzeń: wyszukiwanie semantyczne, klasyfikację i grupowanie, z wynikami zależnymi od kontekstu, a nie tylko od zgodności słów kluczowych. Dzięki temu pytanie „cieknie mi spod zlewu” może zostać połączone ze stroną o naprawie syfonu, choć nie pada na niej słowo „cieknie”.
30. Baza wektorowa
To baza danych przeznaczona do wydajnego przechowywania, indeksowania i pobierania osadzeń. Jest zapleczem większości wdrożeń RAG: firmowe dokumenty są dzielone na fragmenty, zamieniane na wektory i zapisywane, a przy pytaniu system szuka fragmentów najbliższych znaczeniowo. Warto ustalić z wykonawcą, jak często baza jest odświeżana po zmianie oferty.
31. Wyszukiwanie semantyczne i hybrydowe
Wyszukiwanie semantyczne dopasowuje treści według podobieństwa znaczenia, a hybrydowe łączy je z klasycznym wyszukiwaniem słów kluczowych. Ma to sens, ponieważ klienci pytają opisowo („cichy odkurzacz do mieszkania ze zwierzętami”) albo dokładnie, podając symbol modelu.
32. Ponowny ranking (re-ranking)
To dodatkowy etap, w którym osobny mechanizm ocenia wstępnie znalezione wyniki, aby na początku listy znalazły się dokumenty najbardziej trafne. Jeśli firmowy czat odpowiada poprawnie, ale nie na temat, przyczyna często leży w podziale dokumentów na fragmenty (ang. chunks) albo w ich rankingu.
Agenci i narzędzia: gdy model zaczyna działać
Model językowy sam tylko generuje tekst, a działać zaczyna dopiero wtedy, gdy otrzyma narzędzia i pozwolenie na ich użycie. Cztery hasła z tej grupy opisują przejście od asystenta, który odpowiada, do systemu, który wykonuje zadania.
33. Agent AI
Słowniczek Google definiuje agenta jako oprogramowanie, które analizuje dane wejściowe użytkownika, planuje i wykonuje działania w jego imieniu. Agentem będzie system, który po zgłoszeniu z formularza sprawdzi dostępność terminu, przygotuje wstępną wycenę i zapisze sprawę w systemie obsługi klientów. Czat, który jedynie odpowiada na pytania, agentem w tym sensie nie jest, choć w ofertach bywa tak nazywany.
34. Wywoływanie funkcji (function calling)
To mechanizm, dzięki któremu model zamiast samego tekstu wskazuje, jaką funkcję należy uruchomić i z jakimi parametrami. Dokumentacja Gemini API wymienia trzy zastosowania: wykonywanie działań w systemach zewnętrznych, sięganie po wiedzę z baz danych oraz rozszerzanie możliwości o obliczenia czy wykresy. Podkreśla też, że model nie wykonuje funkcji samodzielnie, robi to aplikacja. Zakres działań asystenta wynika więc z tego, jakie funkcje udostępnił mu wykonawca.
35. Protokół MCP (Model Context Protocol)
MCP to otwarty standard łączenia aplikacji AI z systemami zewnętrznymi: źródłami danych, narzędziami i gotowymi przepływami pracy. Dokumentacja standardu porównuje go do złącza USB-C dla aplikacji AI. Integracja przygotowana raz może dzięki temu działać z wieloma asystentami, między innymi z Claude i ChatGPT. Konsekwencje dla serwisów i sklepów opisujemy we wpisie o agentach AI i protokole MCP.
36. Uporządkowane dane wyjściowe (structured output)
To tryb, w którym model zwraca odpowiedź w z góry ustalonej strukturze, zwykle w formacie JSON zgodnym z podanym schematem. Sklep może w ten sposób wydobyć z opisów dostawców kolor, materiał i wymiary do osobnych pól karty produktu. Dokumentacja zastrzega, że gwarantowana jest poprawność składni, a nie treści, dlatego wartości trzeba weryfikować.
AI w wyszukiwarce Google: pojęcia, które dotyczą widoczności strony
W wyszukiwarce Google sztuczna inteligencja jest widoczna przede wszystkim w dwóch funkcjach, które budują odpowiedź z wielu stron i podają do nich linki. Cztery ostatnie hasła opisują te funkcje, mechanizm doboru źródeł oraz ustawienie, którym właściciel witryny decyduje o wykorzystaniu swoich treści.
37. Przegląd od AI (AI Overviews)
To blok z odpowiedzią wygenerowaną przez AI, pokazywany w wynikach wyszukiwania. Według dokumentacji Centrum wyszukiwarki Google Przeglądy pojawiają się wtedy, gdy mogą wnieść coś ponad zwykłe wyniki, i prowadzą dalej za pomocą linków. Więcej piszemy we wpisie o tym, jak działa Przegląd od AI w Google.
38. Tryb AI (AI Mode)
Tryb AI to osobny sposób korzystania z wyszukiwarki, przeznaczony do dokładnego badania, rozumienia i porównywania. Generuje obszerne odpowiedzi z linkami do stron źródłowych. Klient porównujący oferty montażu pomp ciepła może w nim przejść drogę od ogólnego pytania do listy wykonawców w jednej rozmowie. Szczegóły omawiamy we wpisie Tryb AI w Google.
39. Rozgałęzienie zapytania (query fan-out)
To technika, w której system na podstawie jednego pytania wysyła wiele powiązanych wyszukiwań dotyczących podtematów i różnych źródeł, a dopiero z ich wyników składa odpowiedź. Wniosek praktyczny: strona może zostać przywołana jako źródło dla jednego z podtematów, dlatego warto wyczerpująco opisywać zagadnienia poboczne, takie jak koszty, terminy i typowe problemy.
40. Google-Extended
To nazwa, którą wpisuje się w pliku robots.txt, aby zdecydować, czy treści witryny mogą służyć do trenowania przyszłych generacji modeli Gemini i do groundingu w niektórych systemach Google. Dokumentacja robotów Google zaznacza, że ustawienie nie wpływa na obecność witryny w wyszukiwarce i nie jest czynnikiem rankingowym. Widocznością w Przeglądach od AI i w Trybie AI steruje się tymi samymi ustawieniami co zwykłymi wynikami, między innymi dyrektywami nosnippet, max-snippet i noindex.
User-agent: Google-Extended
Disallow: /
Google podkreśla, że do pojawienia się strony w funkcjach AI nie są potrzebne dodatkowe wymagania techniczne, specjalne pliki ani osobne znaczniki. Strona musi być zindeksowana i kwalifikować się do wyświetlenia z fragmentem tekstu, a pomagają w tym podstawy: dostęp robota do treści, linkowanie wewnętrzne, ważne informacje podane tekstem oraz dane strukturalne zgodne z tym, co widać na stronie. Ruch z obu funkcji jest wliczany do raportu skuteczności w Search Console, w typie wyszukiwania „Sieć”. Więcej o pomiarze piszemy we wpisie o tym, jak mierzyć widoczność marki w odpowiedziach AI.
Jak wykorzystać słownik w rozmowie z wykonawcą lub dostawcą narzędzia
Najprostszy sposób to zamienić pojęcia na pytania i zadać je przed podpisaniem umowy. Dostawca, który rozumie własny produkt, odpowie na nie w kilku zdaniach, a wymijające odpowiedzi są sygnałem, że za efektowną nazwą kryje się mniej, niż sugeruje oferta.
- Na jakim modelu podstawowym działa narzędzie i co się stanie, gdy model zostanie zmieniony?
- Czy „nauczenie stylu marki” oznacza dostrajanie, czy instrukcję systemową z przykładami?
- Skąd narzędzie czerpie fakty: z pamięci modelu, z wyszukiwarki czy z bazy dokumentów firmy?
- Jak często odświeżana jest baza wiedzy i czy odpowiedzi wskazują źródło?
- W czym liczony jest limit: w zapytaniach czy w tokenach?
- Które działania asystent wykonuje samodzielnie, a które wymagają zatwierdzenia przez człowieka?
- Na jakich pytaniach testowano rozwiązanie przed uruchomieniem?
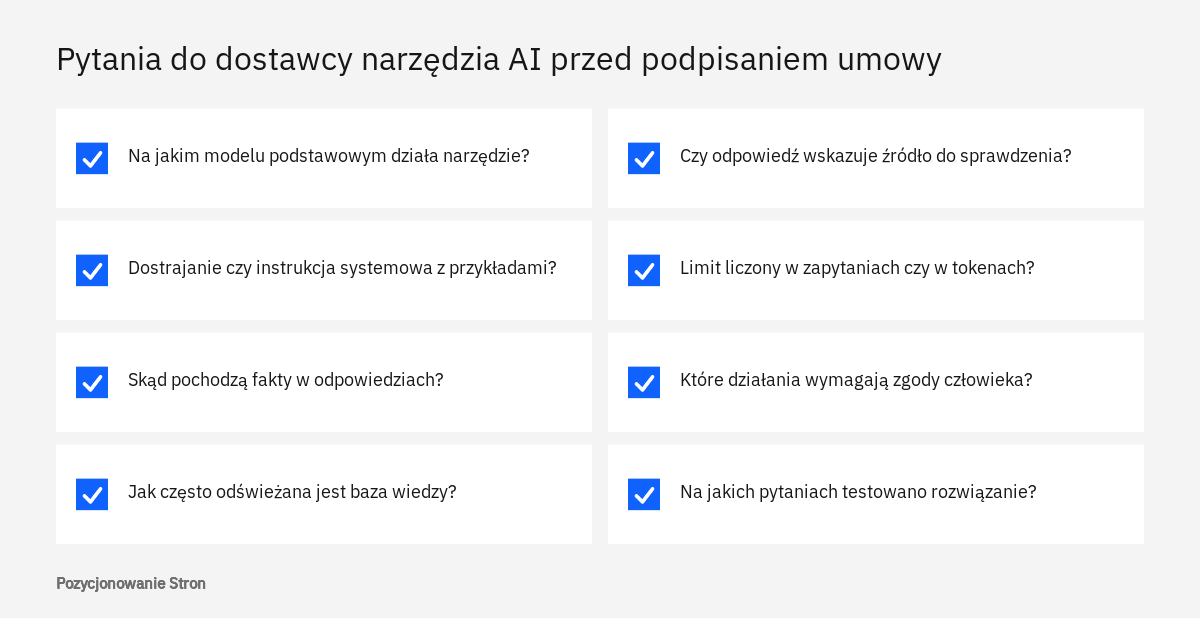
Te same pytania przydają się wewnątrz firmy. Zanim dział marketingu zacznie publikować teksty przygotowane z pomocą modelu, warto ustalić, kto sprawdza fakty i kto zatwierdza publikację. Google przypomina, że samo użycie generatywnej AI nie jest problemem, natomiast masowe tworzenie stron bez wartości dla użytkowników może naruszać zasady dotyczące spamu. Szerzej opisujemy to we wpisie o treściach pisanych przez AI a Google.
Typowe pomyłki w rozumieniu pojęć AI i sytuacje, w których potrzebna jest pomoc
Najczęstsza pomyłka to traktowanie modelu językowego jak wyszukiwarki albo bazy danych. Model bez groundingu nie sprawdza faktów, tylko układa prawdopodobny tekst, więc pytanie go o aktualną stawkę podatku bez wskazania źródła grozi błędem.
Druga pomyłka to mylenie dostrajania z RAG. Dostrajanie zmienia sposób, w jaki model odpowiada, a RAG dostarcza mu aktualnych faktów w chwili pytania. Jeśli czat ma znać bieżący cennik, właściwe jest zwykle to drugie, ponieważ cennik można podmienić w bazie bez ponownego trenowania. Trzecia dotyczy okna kontekstu mylonego z pamięcią: model „pamięta” początek rozmowy, bo cała dotychczasowa treść jest mu przekazywana ponownie. Czwarta to przekonanie, że niska temperatura usuwa halucynacje, choć zmniejsza ona tylko zmienność odpowiedzi. Piąta to wiara, że widoczność w odpowiedziach AI wymaga tajemnych znaczników. Skróty, pod którymi takie działania są sprzedawane, porządkujemy we wpisie GEO, AEO, LLMO i SEO: co znaczą te skróty.
Pomoc z zewnątrz jest zasadna, gdy asystenci podają o firmie błędne informacje, gdy strona nie jest przywoływana jako źródło mimo dobrej widoczności w zwykłych wynikach albo gdy oferta dostawcy zawiera pojęcia, których nie potrafi on wyjaśnić. Zaczynamy wtedy od sprawdzenia, czy treści są dostępne dla robotów, czy kluczowe informacje są podane tekstem i czy dane o firmie są spójne w różnych miejscach sieci. Tym zajmuje się nasza usługa pozycjonowania AI, a pojedyncze wątpliwości można omówić podczas konsultacji SEO.
Jeśli chcą Państwo zamówić pozycjonowanie AI, zachęcamy do kontaktu: tel. 222 500 844 lub mailowo: biuro@pozycjonowaniestron.pl
Najczęstsze pytania
Czy marketer musi znać wszystkie czterdzieści pojęć?
Nie. Na co dzień wystarcza kilkanaście: duży model językowy, token, okno kontekstu, prompt, instrukcja systemowa, halucynacja, grounding, RAG, dostrajanie i agent. Pozostałe przydają się, gdy firma zamawia własne wdrożenie.
Czym różni się RAG od dostrajania?
RAG dostarcza modelowi fragmenty dokumentów w chwili zadania pytania, więc wiedzę można aktualizować przez podmianę źródeł. Dostrajanie to dodatkowe trenowanie modelu, które według słowniczka Google wymaga zwykle setek lub tysięcy przykładów.
Ile tekstu to jeden token?
Dokumentacja Gemini API podaje orientacyjnie około 4 znaków na token oraz około 60-80 angielskich słów na 100 tokenów. Dla języka polskiego nie ma tam osobnego przelicznika, dlatego najpewniejsze jest policzenie tokenów na próbce własnych treści.
Czy halucynacje da się całkowicie wyeliminować?
Dokumentacja, na której się opieramy, mówi o ograniczaniu halucynacji, a nie o ich usunięciu. Grounding i RAG zmniejszają ryzyko, ale przy nietrafnych źródłach odpowiedź nadal może być błędna. Treści do publikacji powinien sprawdzić człowiek.
Czy zablokowanie Google-Extended usunie stronę z Przeglądów od AI?
Dokumentacja Google wskazuje, że Google-Extended nie wpływa na obecność witryny w wyszukiwarce. Do ograniczania tego, co pojawia się w funkcjach AI wyszukiwarki, służą te same ustawienia co dla zwykłych wyników, między innymi nosnippet, max-snippet i noindex.
Czy czat na stronie firmy to już agent AI?
Niekoniecznie. Agent w rozumieniu słowniczka Google planuje i wykonuje działania w imieniu użytkownika, na przykład rezerwuje termin. Czat, który tylko odpowiada na pytania, jest asystentem konwersacyjnym, nawet jeśli korzysta z firmowej bazy wiedzy.
Źródła
- Słowniczek systemów uczących się: generatywna AI, Google for Developers
- Słowniczek systemów uczących się, Google for Developers
- Zrozumienie i liczenie tokenów, Google AI for Developers
- Strategie projektowania promptów, Google AI for Developers
- Myślenie, Google AI for Developers
- Grounding z użyciem wyszukiwarki Google, Google AI for Developers
- Wektory dystrybucyjne, Google AI for Developers
- Wywoływanie funkcji za pomocą interfejsu Gemini API, Google AI for Developers
- Dane wyjściowe uporządkowane, Google AI for Developers
- What is Retrieval-Augmented Generation (RAG)?, Google Cloud
- What is the Model Context Protocol (MCP)?, Model Context Protocol
- Funkcje oparte na AI a Twoja witryna, Centrum wyszukiwarki Google
- Wskazówki wyszukiwarki Google dotyczące treści utworzonych za pomocą generatywnej AI w Twojej witrynie, Centrum wyszukiwarki Google
- Typowe roboty Google, Infrastruktura indeksowania Google
Funkcje wyszukiwarek i asystentów AI zmieniają się szybko, dlatego wpis aktualizujemy po większych zmianach.