Roboty asystentów AI najczęściej giną nie w pliku robots.txt, lecz warstwę wcześniej: w zaporze aplikacyjnej, w ochronie przed botami włączonej w sieci CDN albo we wtyczce bezpieczeństwa WordPressa. Właściciel strony niczego nie zakazywał, a mimo to ChatGPT, Perplexity czy Claude dostają odmowę i nie mają czego zacytować. Poniżej opisujemy, jak taką cichą blokadę rozpoznać, jak ją zdjąć i jak nie osłabić przy tym ochrony serwera.
Dlaczego zapora blokuje roboty AI, chociaż nikt tego nie zlecił
Dzieje się tak, ponieważ systemy ochronne oceniają ruch według własnych reguł, a robot asystenta AI wygląda dla nich jak każdy inny automat: nie uruchamia skryptów, pobiera wiele adresów w krótkim czasie i łączy się z centrum danych, a nie z domowego łącza. Jeżeli reguła mówi „automaty zatrzymać”, to zatrzymuje również te, na których firmie zależy.
Warto uporządkować, co stoi między robotem a treścią strony. Żądanie trafia najpierw do sieci CDN, czyli sieci serwerów pośredniczących, które podają kopie strony z miejsca bliższego odbiorcy. Tam zwykle działa zapora aplikacyjna (z angielskiego WAF, web application firewall). Dalej jest serwer hostingu z własnymi zabezpieczeniami, a na końcu WordPress z wtyczką bezpieczeństwa. Każda z tych warstw może samodzielnie odmówić dostępu i żadna nie informuje o tym pozostałych.
Filtr ustawiony przed stroną internetową, który sprawdza każde żądanie HTTP i na podstawie reguł przepuszcza je, odrzuca albo kieruje do dodatkowej weryfikacji, na przykład do strony z wyzwaniem.
Czym różni się zakaz w robots.txt od blokady w zaporze
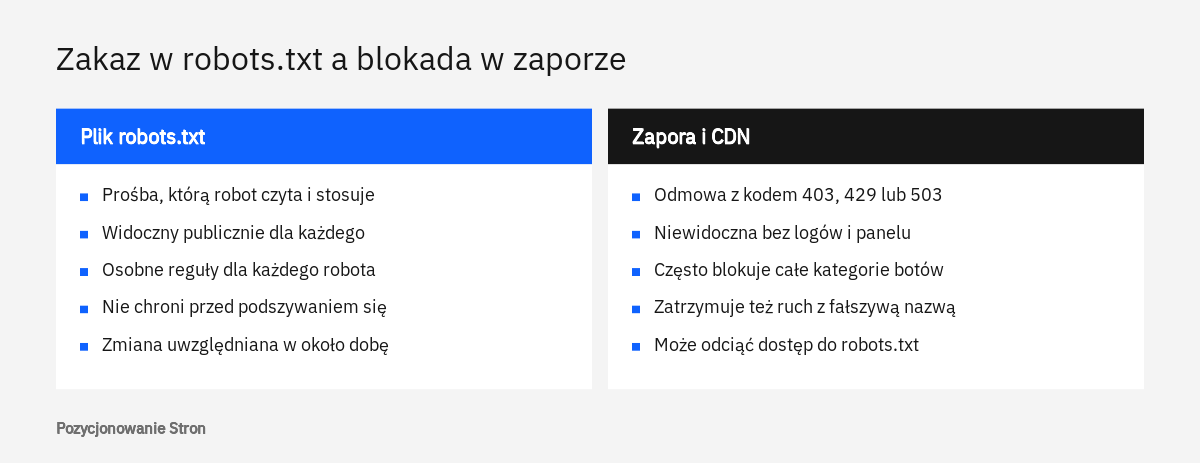
Plik robots.txt jest prośbą skierowaną do robota: operator czyta ją i sam decyduje, że danego adresu nie pobierze. Zapora jest fizyczną odmową: robot wysyła żądanie i dostaje kod błędu. Zakaz w robots.txt jest jawny i każdy może go przeczytać. Blokady w zaporze nie widać z zewnątrz, dopóki ktoś nie zajrzy do logów albo do panelu zabezpieczeń.
Druga różnica dotyczy skutków ubocznych. Zapora, która odrzuca robota po adresie IP lub po nazwie, odrzuca też jego żądanie o plik robots.txt. Firma Anthropic, operator asystenta Claude, pisze o tym w swojej pomocy dla właścicieli stron: blokowanie adresów IP nie jest zalecane, bo może uniemożliwić robotom odczytanie pliku robots.txt z preferencjami serwisu. Staranne reguły typu „robotowi uczącemu modele nie, robotowi wyszukiwania tak” przestają mieć znaczenie, jeżeli żaden robot nie jest w stanie ich pobrać.
Samą decyzję, czy i które roboty wpuszczać, omawiamy we wpisie o rachunku zysków i strat przy blokowaniu robotów AI. Tutaj zajmujemy się sytuacją, w której decyzja brzmi „wpuszczamy”, a technika robi coś odwrotnego.
Które ustawienia ochrony najczęściej odcinają asystentów
Najczęściej winne są ustawienia włączane jednym przełącznikiem: ogólna ochrona przed botami, gotowa kategoria „roboty AI” na liście blokad, wyzwanie w przeglądarce, blokada całych krajów oraz zbyt niski limit żądań. Żadne z nich nie jest błędem samo w sobie. Problem zaczyna się wtedy, gdy zostają włączone hurtowo i nikt nie sprawdza, kogo faktycznie zatrzymują.
Z naszej praktyki wynika, że takie przełączniki bywają aktywne od pierwszego dnia, ustawione domyślnie przez dostawcę usługi albo wykonawcę strony. Nazwy opcji różnią się między usługami, dlatego w tabeli opisujemy ich działanie, a nie etykiety w konkretnym panelu.
| Mechanizm ochrony | Jak działa | Skutek dla robota AI |
|---|---|---|
| Ogólna ochrona przed botami | Odrzuca ruch uznany za zautomatyzowany | Odmowa z kodem 403 lub strona z wyzwaniem |
| Gotowa kategoria „roboty AI” | Blokuje listę nazw prowadzoną przez dostawcę zabezpieczeń | Zatrzymuje naraz roboty uczące modele i roboty wyszukiwania |
| Wyzwanie w przeglądarce | Wymaga wykonania skryptu lub rozwiązania zagadki | Robot dostaje stronę zastępczą zamiast treści |
| Blokada krajów | Odrzuca żądania spoza wybranych państw | Roboty z zagranicznych centrów danych nie docierają do serwera |
| Limit liczby żądań | Po przekroczeniu progu zwraca kod 429 albo blokuje adres | Robot pobiera kilka stron, a kolejne dostają odmowę |
| Blokada po nagłówku klienta | Odrzuca żądania ze słowami „bot” lub „crawler” w nagłówku | Odmowa niezależnie od tego, czy robot jest prawdziwy |
| Czarne listy adresów IP | Blokują zakresy adresów chmur i centrów danych | Odmowa na poziomie połączenia |
Osobnego komentarza wymaga wyzwanie w przeglądarce. Dla człowieka to chwila oczekiwania, dla robota ściana. Anthropic deklaruje w cytowanej pomocy, że jego roboty nie próbują obchodzić zabezpieczeń typu CAPTCHA. Uczciwy robot po napotkaniu wyzwania odchodzi bez treści, a w statystykach zapory zapisuje się to jako „zatrzymany bot”, czyli pozorny sukces ochrony.
Zdradliwa bywa też blokada krajów. Hipotetyczny sklep z Poznania, który sprzedaje wyłącznie w Polsce, może uznać ruch spoza kraju za zbędny. Tymczasem roboty nie muszą łączyć się z polskich adresów: dokumentacja Google wspomina o skanowaniu z adresów IP w Stanach Zjednoczonych, a operatorzy asystentów publikują zakresy własnej infrastruktury. Blokada geograficzna powinna więc mieć wyjątek dla zweryfikowanych robotów.
Które roboty powinny przejść przez zaporę
Przez zaporę powinny przechodzić przede wszystkim roboty, od których zależy obecność strony w odpowiedziach: roboty wyszukiwania asystentów oraz moduły pobierające stronę na życzenie użytkownika. Robot zbierający treści do uczenia modeli to osobna decyzja, którą lepiej wyrazić w robots.txt niż w zaporze.
Operatorzy rozdzielają te role na odrębne nazwy robotów. Zgodnie z dokumentacją robotów OpenAI OAI-SearchBot służy do pokazywania stron w wyszukiwaniu ChatGPT, ChatGPT-User odwiedza stronę, gdy użytkownik o coś zapyta, a GPTBot zbiera treści, które mogą posłużyć do uczenia modeli. Ta sama dokumentacja zaleca, aby dla obecności w wynikach zezwolić robotowi OAI-SearchBot w robots.txt i przepuścić żądania z opublikowanych zakresów jego adresów IP. Podobny podział stosują Perplexity i Anthropic.
| Nazwa robota | Operator | Do czego służy |
|---|---|---|
| OAI-SearchBot | OpenAI | Wyszukiwanie w ChatGPT |
| ChatGPT-User | OpenAI | Pobranie strony na życzenie użytkownika |
| GPTBot | OpenAI | Treści, które mogą posłużyć do uczenia modeli |
| PerplexityBot | Perplexity | Pokazywanie i linkowanie stron w wynikach Perplexity |
| Perplexity-User | Perplexity | Pobranie strony przy pytaniu użytkownika |
| Claude-SearchBot | Anthropic | Poprawa trafności wyników wyszukiwania |
| Claude-User | Anthropic | Pobranie strony, gdy wymaga tego pytanie użytkownika |
| ClaudeBot | Anthropic | Treści, które mogą posłużyć do uczenia modeli |
W przypadku Google sprawa wygląda inaczej. Według dokumentacji obecnością w Przeglądzie od AI i Trybie AI steruje się regułami dla zwykłego Googlebota, więc zapora, która go przepuszcza, niczego tu nie psuje. Z kolei Google-Extended, którym steruje się wykorzystaniem treści w Gemini, nie jest osobnym robotem: jak podaje lista typowych robotów Google, nie ma on własnego ciągu klienta użytkownika w żądaniu HTTP i istnieje wyłącznie jako słowo w pliku robots.txt. Reguła zapory dopasowana do nazwy „Google-Extended” nie zadziała więc nigdy.
Jak rozpoznać blokadę po kodach 403 i wyzwaniach w logach
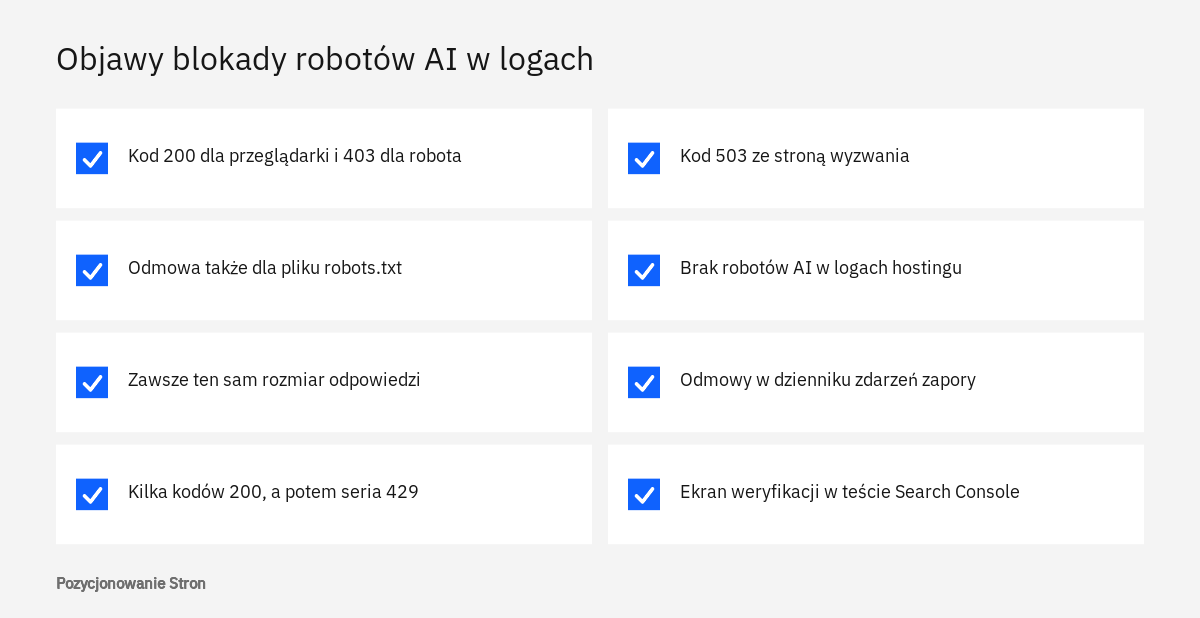
Blokadę rozpoznaje się po tym, że ten sam adres strony zwraca kod 200 zwykłej przeglądarce, a robotowi kod 403, 429 lub 503, albo kod 200 z bardzo małym, zawsze identycznym rozmiarem odpowiedzi. Wystarczy przefiltrować logi po nazwach robotów z tabeli powyżej i zestawić kody odpowiedzi.
Trzeba przy tym wiedzieć, w których logach szukać. Jeżeli odmowy udziela CDN lub zapora przed serwerem, żądanie nie dociera do hostingu i w logach serwera nie zostaje po nim ślad. Właściwe zapisy znajdują się wtedy w dzienniku zdarzeń zabezpieczeń w panelu usługi, zwykle z nazwą reguły, która zadziałała. Jak czytać same logi serwera, opisujemy we wpisie o robotach AI w logach serwera.
203.0.113.24 "GET /oferta/ HTTP/2" 200 48210 "Mozilla/5.0 (Windows NT 10.0; Win64; x64) ... Safari/537.36"
192.0.2.15   "GET /robots.txt HTTP/2" 403 5124 "... compatible; OAI-SearchBot/1.4; robots.txt; +https://openai.com/searchbot"
192.0.2.15   "GET /oferta/ HTTP/2" 403 5124 "... compatible; OAI-SearchBot/1.4; +https://openai.com/searchbot"
198.51.100.7 "GET /blog/ HTTP/2" 503 6890 "... compatible; PerplexityBot/1.0; +https://perplexity.ai/perplexitybot"
Co oznaczają poszczególne kody
Kod 403 to wprost odmowa dostępu. Jeżeli pojawia się przy wszystkich adresach pobieranych przez danego robota, łącznie z plikiem robots.txt, a rozmiar odpowiedzi jest za każdym razem taki sam, niemal na pewno jest to strona blokady wystawiona przez zaporę lub wtyczkę. Inne przyczyny tego kodu opisaliśmy we wpisie o kodzie 403 i Googlebocie.
Kod 429 oznacza przekroczenie limitu żądań: kilka poprawnych odpowiedzi 200, a po nich seria 429 dla tego samego adresu IP. Kod 503 bywa zwracany razem ze stroną wyzwania. Z naszych obserwacji wynika, że zależnie od usługi wyzwanie może mieć kod 403, 503, a czasem nawet 200. Ten ostatni przypadek zdradza rozmiar: prawdziwe podstrony różnią się wagą, a strona wyzwania ma zawsze niemal tę samą liczbę bajtów.
Dla Google skutki tych kodów są udokumentowane. Strona o wpływie kodów stanu HTTP na roboty Google podaje, że treść spod adresów zwracających kody z grupy 4xx nie jest wykorzystywana, a zaindeksowane adresy, które zaczęły zwracać taki kod, są z czasem usuwane z indeksu. Kody 5xx oraz 429 Google traktuje jako sygnał przeciążenia i spowalnia skanowanie. Zapora, która przez pomyłkę odpowiada Googlebotowi kodem 403, szkodzi więc całej widoczności w wyszukiwarce.
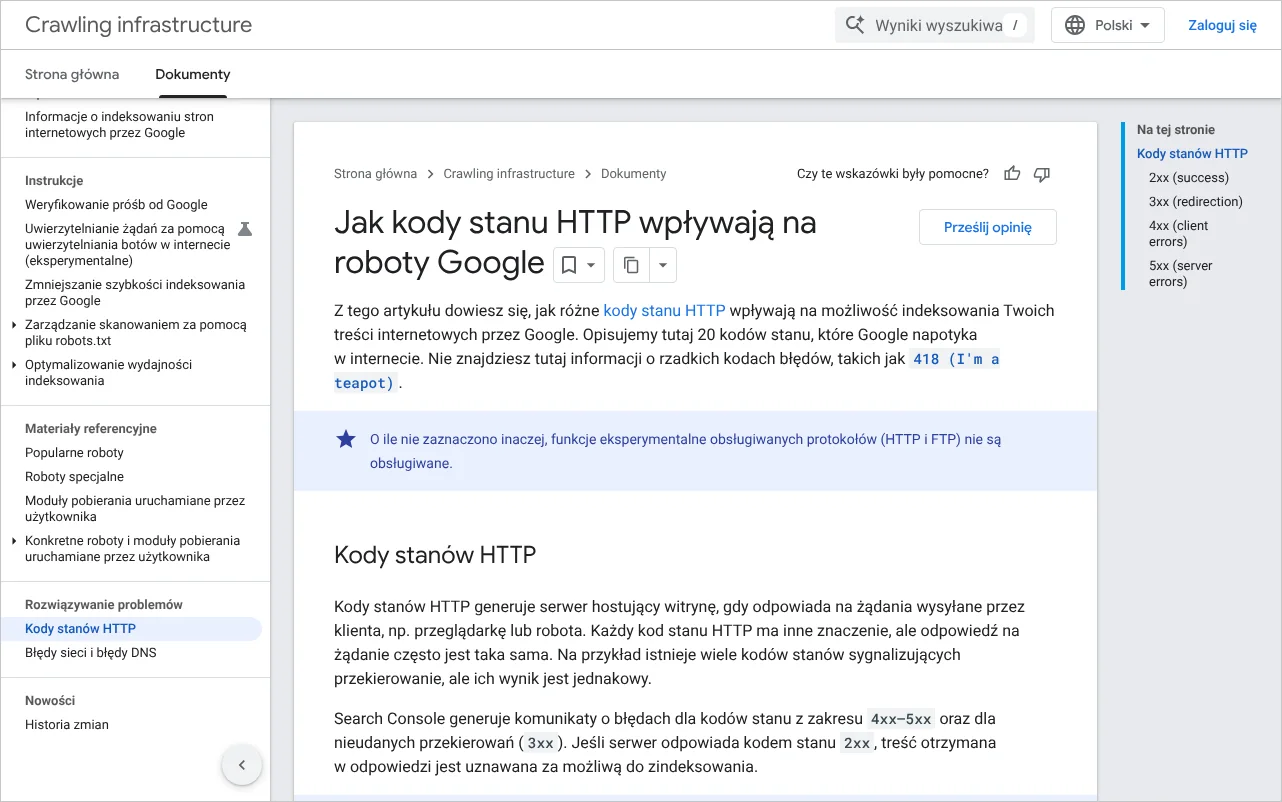
Osobno trzeba spojrzeć na plik robots.txt. Z dokumentu o interpretacji specyfikacji robots.txt przez Google wynika, że błąd z grupy 4xx (poza 429) przy pobieraniu tego pliku oznacza dla Google brak ograniczeń skanowania. Natomiast błąd 5xx powoduje, że przez pierwsze 12 godzin Google wstrzymuje skanowanie witryny, a przez kolejne 30 dni posługuje się ostatnią zapamiętaną wersją. Wyzwanie z kodem 503 na adresie robots.txt potrafi zatem zatrzymać skanowanie całego serwisu, mimo że sam plik jest poprawny.
Na koniec zastrzeżenie: nazwę robota w nagłówku każdy może wpisać dowolnie. Zanim uzna się serię odmów za błąd ochrony, należy potwierdzić, że adres IP faktycznie należy do operatora, co opisujemy we wpisie o weryfikacji adresów IP robotów AI. Odmowa dla podszywającego się automatu to poprawne działanie zapory, a nie usterka.
Jak sprawdzić blokadę, gdy nie ma dostępu do logów
Bez logów blokadę da się wykryć próbnym żądaniem z nagłówkiem robota oraz testem w Search Console. Żadna z tych metod nie zastępuje logów, ale razem dają wiarygodny obraz w kilkanaście minut.
Próbne żądanie z nagłówkiem robota
Narzędzie curl, dostępne w wierszu poleceń większości systemów, pozwala wysłać żądanie z dowolnym nagłówkiem klienta. Wystarczy porównać odpowiedź na zwykłe żądanie z odpowiedzią na żądanie podpisane nazwą robota. Jeśli pierwsze kończy się kodem 200, a drugie kodem 403, w którejś warstwie działa reguła dopasowana do nazwy.
curl -s -o /dev/null -w "%{http_code} %{size_download}\n" https://www.przyklad.pl/oferta/

curl -s -o /dev/null -w "%{http_code} %{size_download}\n" \
  -A "Mozilla/5.0 AppleWebKit/537.36 (KHTML, like Gecko); compatible; GPTBot/1.4; +https://openai.com/gptbot" \
  https://www.przyklad.pl/oferta/
Ten test ma ważne ograniczenie. Żądanie wychodzi z Państwa adresu IP, a nie z adresu operatora, więc pokazuje wyłącznie reguły oparte na nazwie. Dobrze ustawiona zapora, która wpuszcza robota tylko z oficjalnych adresów, słusznie odrzuci taką próbę. Odwrotnie też: kod 200 w teście nie wyklucza blokady opartej na adresach IP centrów danych. Wynik jest więc wskazówką, gdzie szukać, a rozstrzygnięcie daje dopiero dziennik zdarzeń zapory.
Test w Search Console
Dla Googlebota wiarygodnego testu dostarcza samo Google, bo żądanie wychodzi wtedy z prawdziwej infrastruktury. W Search Console należy wpisać adres podstrony w polu sprawdzania adresów URL u góry ekranu, a następnie użyć przycisku uruchamiającego test wersji opublikowanej. Zgodnie z pomocą narzędzia do sprawdzania adresów URL w wynikach znajduje się pole „Pobieranie strony” z wartością „Udało się” albo „Niepowodzenie” wraz z przyczyną, a podgląd przetestowanej strony pokazuje zwrócony kod HTML, nagłówki HTTP i zrzut ekranu. Jeżeli na zrzucie widać komunikat o weryfikacji przeglądarki zamiast oferty, zapora zatrzymuje nawet Googlebota.
Drugim miejscem jest raport, do którego prowadzi ścieżka Ustawienia, a dalej „Statystyki indeksowania”. Według pomocy Search Console sekcja „Odpowiedzi na żądania robota indeksującego” pokazuje udział poszczególnych kodów, a sekcja „Stan hosta” obejmuje trzy pozycje: „Pobieranie pliku robots.txt”, „Rozpoznawanie nazw DNS” i „Połączenie z serwerem”. Wzrost udziału odpowiedzi 403, który zbiega się w czasie ze zmianą ustawień zabezpieczeń, to mocna poszlaka. Google samo zwraca na to uwagę: na stronie o funkcjach opartych na AI wśród podstawowych czynności wymienia sprawdzenie, czy indeksowanie jest dozwolone w pliku robots.txt oraz przez sieć CDN lub infrastrukturę hostingową.
Jeśli chcą Państwo zamówić SEO techniczne, zachęcamy do kontaktu: tel. 222 500 844 lub mailowo: biuro@pozycjonowaniestron.pl
Jak ustawić wyjątek dla robotów AI w zaporze i sieci CDN
Wyjątek ustawia się jako regułę zezwalającą, która łączy dwa warunki naraz: nazwę robota w nagłówku klienta oraz adres źródłowy należący do zakresów opublikowanych przez operatora. Reguła musi zostać umieszczona przed regułami blokującymi, bo zapory przetwarzają je po kolei.
Taką konstrukcję zaleca wprost dokumentacja robotów Perplexity. Operator uprzedza w niej, że przy korzystaniu z WAF może być konieczne wyraźne zezwolenie dla obu jego robotów, i opisuje regułę z dwoma warunkami: nagłówek zawiera nazwę robota oraz adres IP mieści się w zakresach z oficjalnych plików JSON. Zaleca też nadać tej regule wyższy priorytet niż regułom blokującym, pobierać pliki JSON okresowo w sposób zautomatyzowany i po każdej zmianie obserwować logi.
- Ustalenie, która warstwa odmawia
W dzienniku zdarzeń zabezpieczeń należy odszukać żądania robota i odczytać nazwę reguły lub funkcji, która je zatrzymała. Bez tego łatwo ustawić wyjątek w zaporze, podczas gdy blokuje wtyczka WordPressa.
- Pobranie oficjalnych list adresów
OpenAI, Perplexity i Anthropic publikują zakresy adresów swoich robotów w plikach JSON wskazanych w dokumentacji. Z list tych tworzy się w zaporze osobne zbiory adresów.
- Utworzenie reguły z dwoma warunkami
Warunek pierwszy dotyczy nazwy robota w nagłówku, drugi przynależności adresu do zbioru. Działanie reguły to zezwolenie lub pominięcie pozostałych zabezpieczeń.
- Ustawienie kolejności
Reguła zezwalająca powinna stać wyżej niż blokada krajów, limity żądań i wyzwania. Warto sprawdzić w dokumentacji usługi, które funkcje ochronne w ogóle respektują wyjątki.
- Kontrola po wdrożeniu
Po kilku dniach należy wrócić do logów i potwierdzić, że roboty otrzymują kod 200 także dla pliku robots.txt.
WARUNEK   User-Agent zawiera "OAI-SearchBot"
          ORAZ adres IP należy do zbioru z pliku searchbot.json
DZIAŁANIE zezwolenie z pominięciem ochrony przed botami,
          blokady krajów i wyzwania

WARUNEK   User-Agent zawiera "OAI-SearchBot"
          ORAZ adres IP NIE należy do tego zbioru
DZIAŁANIE blokada (podszywanie się pod robota)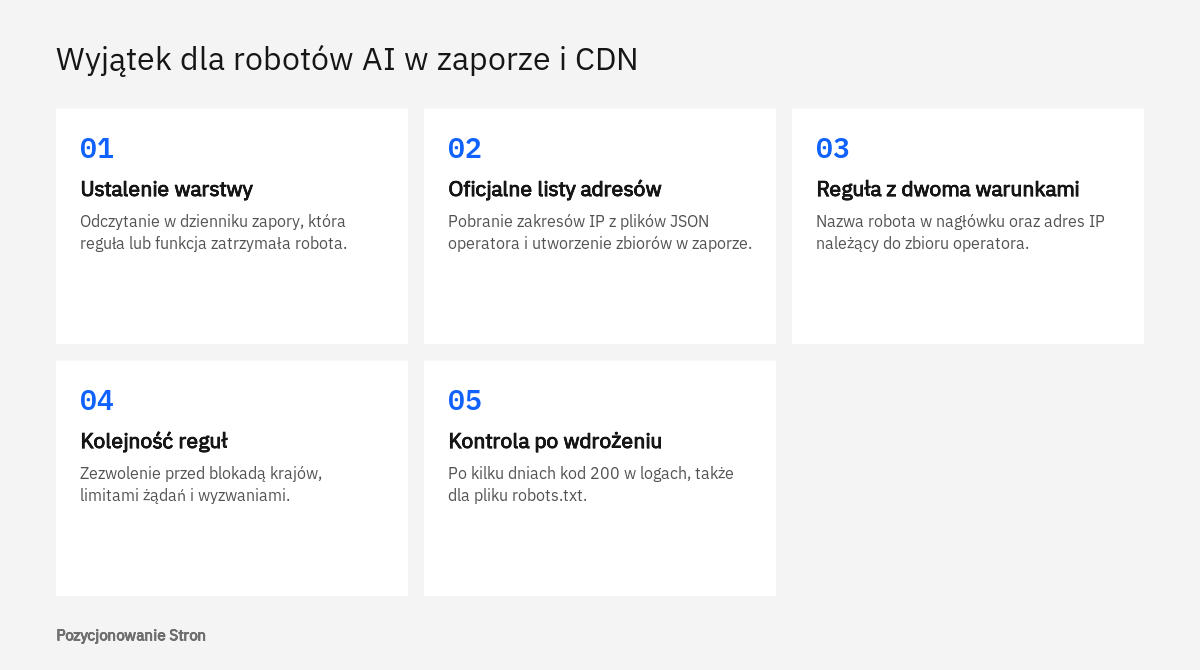
Wyjątek oparty wyłącznie na nazwie robota byłby furtką: każdy automat, który wpisze sobie „GPTBot” w nagłówku, ominąłby wszystkie zabezpieczenia. Dlatego druga reguła odrzuca znaną nazwę z obcego adresu. Po zmianie reguł efekt nie będzie natychmiastowy: OpenAI podaje, że dostosowanie wyników wyszukiwania po zmianie w robots.txt zajmuje około 24 godzin, a Perplexity mówi o okresie do 24 godzin.
Wtyczki bezpieczeństwa WordPressa i zabezpieczenia hostingu
Wtyczki bezpieczeństwa WordPressa blokują roboty AI tymi samymi metodami co zapora w CDN, tylko później: żądanie dociera do serwera, uruchamia WordPressa i dopiero wtyczka zwraca odmowę. Dzięki temu ślad zostaje w logach hostingu, ale przyczynę trzeba odszukać w ustawieniach wtyczki.
W panelu WordPressa warto przejrzeć kilka miejsc, które w różnych wtyczkach noszą podobne nazwy: listę zablokowanych nagłówków klienta, często wypełnioną gotowym zestawem „złych botów”, ograniczanie liczby żądań z osobnym progiem dla robotów, blokadę krajów oraz dziennik ruchu, w którym przy każdej odmowie podany jest powód. Ten ostatni najszybciej odpowiada na pytanie, czy wtyczka ma z problemem coś wspólnego. Osobną grupą są wtyczki z przełącznikiem, który celowo dopisuje robotom AI zakazy w wirtualnym pliku robots.txt albo odsyła im kod 403. Jeżeli obecność w odpowiedziach asystentów stała się celem firmy, taki przełącznik trzeba odszukać i wyłączyć.
Zabezpieczenia po stronie hostingu
Najtrudniejsza do wykrycia jest blokada na poziomie hostingu, ponieważ właściciel strony zwykle nie ma do niej wglądu. Firmy hostingowe stosują własne zapory serwerowe i mechanizmy, które po serii żądań czasowo blokują adres IP. Z naszych obserwacji wynika, że objawem jest odmowa widoczna w logach, której nie tłumaczy ani CDN, ani żadna wtyczka.
W takiej sytuacji pozostaje zgłoszenie do pomocy technicznej z godzinami kilku odmów, adresami IP robota, jego nazwą z nagłówka oraz odnośnikiem do oficjalnej listy adresów operatora. Prośba powinna dotyczyć wyjątku dla konkretnych zakresów, a nie wyłączenia ochrony. Hipotetyczna kancelaria z Krakowa na hostingu współdzielonym może usłyszeć, że reguł nie da się zmienić dla pojedynczego klienta. Wtedy wyjściem bywa zmiana pakietu albo dostawcy, czyli starannie zaplanowana migracja hostingu.
Jak pogodzić ochronę serwera z widocznością w odpowiedziach AI
Ochronę i widoczność godzi się przez rozdzielenie ról: robots.txt wyraża decyzję biznesową, których robotów firma sobie życzy, a zapora broni serwera przed ruchem, który się do tej decyzji nie stosuje albo podszywa pod cudze nazwy. Zweryfikowany robot nie powinien być zatrzymywany tylko dlatego, że jest automatem.
Nie oznacza to rezygnacji z kontroli obciążenia. Jeżeli robot pobiera zbyt wiele stron naraz, lepszym narzędziem niż trwała blokada jest spowolnienie. Anthropic deklaruje obsługę niestandardowej dyrektywy Crawl-delay w robots.txt, która ogranicza częstotliwość żądań jego robotów. W przypadku Google dokumentacja o rozwiązywaniu problemów ze skanowaniem dopuszcza w sytuacji awaryjnej czasowe zwracanie kodu 503 lub 429, z zastrzeżeniem, że utrzymywanie ich dłużej niż dwa dni może skończyć się usuwaniem adresów z indeksu. Kodów 401 i 403 Google odradza jako sposobu na ograniczanie tempa skanowania. O limitach piszemy szerzej we wpisie o kodzie 429.
User-agent: OAI-SearchBot
Allow: /

User-agent: PerplexityBot
Allow: /

User-agent: ClaudeBot
Crawl-delay: 5
Disallow: /koszyk/

User-agent: GPTBot
Disallow: /
Zapora ma w tym modelu dwa zadania: przepuścić wszystkie wymienione roboty do pliku robots.txt i do stron, które plik im udostępnia, oraz zatrzymać ruch, który używa tych nazw z obcych adresów. Plik musi być dostępny także dla robota, któremu zakazuje wszystkiego, ponieważ inaczej robot nie pozna zakazu. Wyjątki nie powinny też obejmować więcej, niż potrzeba: reguła zezwalająca może pomijać ochronę przed botami i wyzwanie, a mimo to pozostawiać w mocy reguły chroniące panel logowania, formularze i koszyk. Porządkowanie takich reguł jest stałym elementem prac w ramach usługi pozycjonowania AI.
Typowe pomyłki i sytuacje, w których potrzebna jest pomoc
Najczęstszą pomyłką jest szukanie przyczyny w treści strony, podczas gdy roboty w ogóle jej nie widzą. Firma przepisuje teksty i czeka na cytowania, a tymczasem każde żądanie asystenta kończy się odmową na zaporze. Dlatego kontrolę dostępu robotów zalecamy wykonać przed jakąkolwiek pracą nad treścią.
Pozostałe pomyłki powtarzają się równie często: wyłączenie całej ochrony „na próbę” i pozostawienie jej wyłączonej, wyjątek oparty na samej nazwie robota, jednorazowe przepisanie adresów IP bez mechanizmu aktualizacji, poprawienie reguł w jednej warstwie, mimo że tę samą odmowę powtarza wtyczka lub hosting, oraz test wykonany wyłącznie na stronie głównej, która bywa podawana z pamięci podręcznej CDN, podczas gdy podstrony przechodzą przez pełny zestaw reguł.
- Plik robots.txt zwraca kod 200 każdemu robotowi, także temu, któremu zakazuje dostępu.
- W dzienniku zapory nie ma odmów dla zweryfikowanych adresów robotów wyszukiwania asystentów.
- Reguła zezwalająca łączy nazwę robota z oficjalnym zakresem adresów IP i stoi przed regułami blokującymi.
- Listy adresów operatorów są odświeżane okresowo, najlepiej automatycznie.
- Blokada krajów i limity żądań mają wyjątek dla zweryfikowanych robotów.
- Wtyczka bezpieczeństwa WordPressa i hosting nie powtarzają blokady zdjętej w CDN.
- Test w Search Console pokazuje prawdziwą treść strony, a nie ekran weryfikacji.
Pomoc specjalisty jest potrzebna przede wszystkim wtedy, gdy na stronie działa kilka warstw ochrony utrzymywanych przez różne osoby, gdy serwis był w przeszłości atakowany i zespół obawia się zmieniać reguły, oraz gdy odmowy dotykają również Googlebota. Przegląd dostępności strony dla robotów wykonujemy jako część usługi SEO technicznego, a w szerszym zakresie w ramach audytu SEO. Nie obiecujemy przy tym, że po zdjęciu blokady strona zacznie być cytowana, ponieważ o doborze źródeł decydują asystenci. Dostęp dla robotów jest jedynie warunkiem koniecznym.
Jeśli chcą Państwo zamówić SEO techniczne, zachęcamy do kontaktu: tel. 222 500 844 lub mailowo: biuro@pozycjonowaniestron.pl
Najczęstsze pytania
Czy sama sieć CDN blokuje roboty AI?
Sama sieć dostarczania treści niczego nie blokuje, robią to włączone w niej funkcje ochronne: zapora, ochrona przed botami, wyzwania i limity. Warto je przejrzeć zaraz po uruchomieniu usługi, bo część bywa aktywna domyślnie.
Czy wpis Allow w robots.txt wystarczy, aby robot AI mógł pobrać stronę?
Nie wystarczy. Plik robots.txt informuje robota, co wolno mu pobierać, ale nie ma wpływu na zaporę, która działa niezależnie. Jeżeli zapora zwraca kod 403, robot nie pobierze ani strony, ani samego pliku z zezwoleniem.
Skąd wziąć adresy IP prawdziwych robotów asystentów?
Z dokumentacji operatorów. OpenAI, Perplexity i Anthropic publikują zakresy adresów w plikach JSON, a Google udostępnia listy dla swoich robotów i modułów pobierania. Adresów nie należy przepisywać z cudzych zestawień, ponieważ zakresy się zmieniają.
Czy przepuszczenie robotów AI osłabia bezpieczeństwo strony?
Nie, jeżeli wyjątek łączy nazwę robota z oficjalnym zakresem adresów IP i nie obejmuje panelu logowania ani formularzy. Ryzykowny jest wyjątek oparty wyłącznie na nazwie, którą każdy automat może sobie wpisać.
Po jakim czasie od zdjęcia blokady strona wróci do odpowiedzi asystentów?
Tego nie da się określić z góry. Ponowne pobranie podstron zależy od harmonogramu robota, a o cytowaniu decyduje asystent. Pierwszym miarodajnym sygnałem są odpowiedzi z kodem 200 dla robotów w logach.
Dlaczego w logach serwera nie widać żadnych robotów AI?
Możliwości są dwie: roboty rzeczywiście nie odwiedzają strony albo są zatrzymywane przed serwerem, w sieci CDN lub zaporze, i ich żądania nie docierają do hostingu. Rozstrzyga to dziennik zdarzeń zabezpieczeń w panelu usługi.
Źródła
- Overview of OpenAI Crawlers, OpenAI
- Perplexity Crawlers, Perplexity
- Does Anthropic crawl data from the web, and how can site owners block the crawler?, Anthropic
- Jak kody stanu HTTP wpływają na roboty Google, Google
- Jak Google interpretuje specyfikację pliku robots.txt, Google
- Typowe roboty Google, Google
- Funkcje oparte na AI a Twoja witryna, Google
- Raport Statystyki indeksowania, Pomoc Search Console
- Narzędzie do sprawdzania adresów URL, Pomoc Search Console
- Rozwiązywanie problemów z błędami indeksowania w wyszukiwarce Google, Google
Funkcje wyszukiwarek i asystentów AI zmieniają się szybko, dlatego wpis aktualizujemy po większych zmianach.