Kod 429 oznacza, że serwer odmówił obsłużenia żądania, ponieważ w krótkim czasie otrzymał ich zbyt wiele z jednego źródła. Roboty Google odczytują taką odpowiedź jako sygnał przeciążenia i zwalniają skanowanie całej witryny, a przy długotrwałych błędach usuwają adresy z indeksu. Poniżej wyjaśniamy, skąd bierze się ten kod, jak go wykryć, kiedy wolno użyć go celowo i jak ustawić limity na serwerze, aby nie odcinały Googlebota.
Co oznacza kod 429 i czym różni się od innych błędów
Kod 429, w oryginale Too Many Requests, czyli zbyt wiele żądań, to odpowiedź, którą serwer wysyła, gdy jeden odbiorca przekroczył dozwoloną liczbę zapytań w określonym czasie. Strona istnieje i działa, serwer nie uległ awarii, a mimo to konkretny odwiedzający, przeglądarka albo robot, dostaje odmowę zamiast treści. Mechanizm, który za tym stoi, nazywa się ograniczaniem liczby żądań (po angielsku rate limiting).
Kod został opisany w dokumencie RFC 6585, który uzupełnia standard protokołu HTTP o kilka dodatkowych kodów stanu. Wynika z niego kilka rzeczy ważnych dla właściciela strony. Odpowiedź powinna zawierać wyjaśnienie sytuacji. Może też zawierać nagłówek Retry-After, czyli informację, po jakim czasie warto ponowić próbę. Standard nie określa natomiast, w jaki sposób serwer ma rozpoznawać odbiorców ani jak liczyć żądania: limit może dotyczyć pojedynczego zasobu, całego serwera albo grupy serwerów, a odbiorca może być rozpoznawany na przykład po danych logowania lub pliku cookie. W praktyce oznacza to, że każdy hosting i każda zapora liczy żądania po swojemu. Odpowiedzi z kodem 429 nie wolno też zapisywać w pamięci podręcznej.
Zabezpieczenie serwera, które dopuszcza tylko określoną liczbę zapytań od jednego odbiorcy w danym przedziale czasu. Po przekroczeniu progu kolejne zapytania są odrzucane, najczęściej z kodem 429.
Przykład podany w samym standardzie pokazuje stronę, która dopuszcza 50 żądań na godzinę od jednego zalogowanego użytkownika i prosi o ponowienie próby po 3600 sekundach. Tak może wyglądać podobna odpowiedź serwera:
HTTP/1.1 429 Too Many Requests
Content-Type: text/html
Retry-After: 3600

<html>
  <head><title>Zbyt wiele żądań</title></head>
  <body>
    <p>Przekroczono dozwoloną liczbę żądań. Prosimy spróbować ponownie za godzinę.</p>
  </body>
</html>
Od pozostałych błędów z grupy 4xx kod 429 różni się tym, że nie mówi nic o samej podstronie. Kod 404 informuje, że strony nie ma, a kod 403, że dostęp do niej jest zabroniony. Kod 429 mówi wyłącznie o tempie: strona jest dostępna, ale nie teraz i nie w takiej liczbie zapytań. Z tego powodu wyszukiwarki obchodzą się z nim inaczej niż z resztą tej grupy. Ogólne zasady dla wszystkich grup opisaliśmy we wpisie o tym, jak Googlebot traktuje kody odpowiedzi HTTP, dlatego tutaj zajmujemy się wyłącznie kodem 429.
Kiedy serwer odpowiada kodem 429
Serwer odpowiada kodem 429 wtedy, gdy któryś z elementów po drodze między odwiedzającym a stroną uzna, że z jednego źródła przychodzi za dużo zapytań. Kłopot w tym, że tych elementów bywa kilka i każdy ma własne progi. Z naszej praktyki wynika, że właściciel strony zwykle nie ustawiał żadnego limitu samodzielnie: zrobił to za niego dostawca hostingu, wtyczka albo usługa pośrednicząca, a ustawienia domyślne nikt później nie przejrzał.
Pierwszym miejscem jest sam serwer. Na hostingu współdzielonym, gdzie wiele stron korzysta z tej samej maszyny, dostawca często ogranicza liczbę jednoczesnych połączeń lub procesów przypadających na jedno konto, aby jedna witryna nie zabrała zasobów pozostałym. Drugim miejscem jest zapora aplikacji internetowej, czyli filtr, który odsiewa podejrzany ruch, zanim dotrze on do strony. Trzecim bywa sieć dostarczania treści, która stoi przed serwerem i również potrafi odrzucać nadmiar zapytań. Czwartym są wtyczki bezpieczeństwa w systemach takich jak WordPress, które bronią formularza logowania i wyszukiwarki wewnętrznej przed automatami. Piątym wreszcie są interfejsy programistyczne, z których strona sama korzysta, na przykład przy pobieraniu stanów magazynowych z hurtowni.
Dla widoczności w wyszukiwarce znaczenie ma jedno pytanie: czy wśród odbiorców, którym serwer odmawia, znajdują się roboty wyszukiwarek. Limit, który zatrzymuje automat próbujący odgadnąć hasło do panelu, jest pożądany. Ten sam limit, zastosowany bez wyjątków do całej witryny, może uderzyć w Googlebota, który w dużym sklepie odwiedza w ciągu doby bardzo wiele adresów. Sprawę komplikuje to, że roboty wysyłają zapytania z niewielkiej puli adresów IP, więc dla prostego licznika wyglądają jak jeden bardzo aktywny odwiedzający.
Jak Googlebot traktuje kod 429
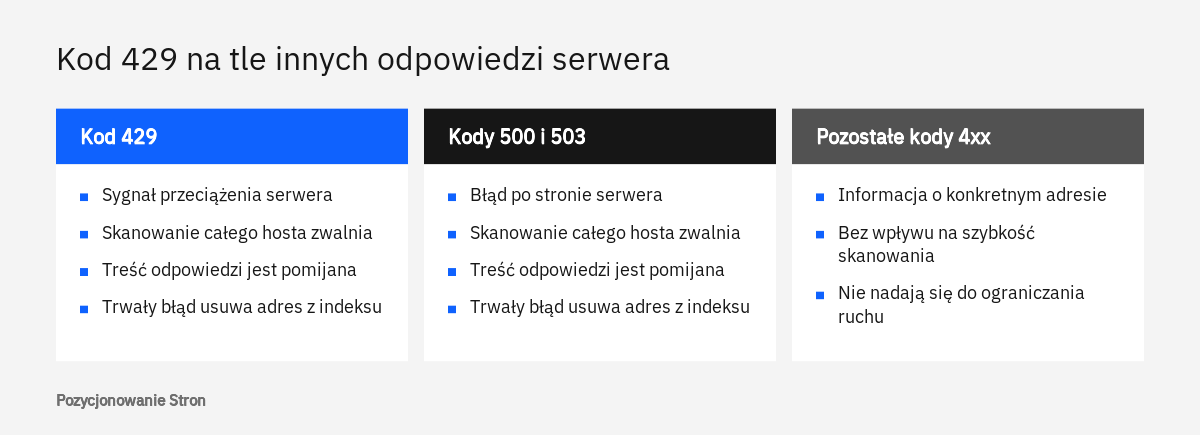
Googlebot traktuje kod 429 jako sygnał, że serwer jest przeciążony, i w odpowiedzi zwalnia skanowanie. Mówi o tym wprost dokumentacja Google poświęcona temu, jak kody stanu HTTP wpływają na roboty Google. Choć kod zaczyna się od czwórki, Google zalicza go do tej samej kategorii co błędy serwera z grupy 5xx. Pozostałe kody 4xx nie mają wpływu na szybkość skanowania, kod 429 jest tu jedynym wyjątkiem.
Z tej samej dokumentacji wynikają trzy dalsze skutki. Treść zwrócona razem z kodem 429 jest pomijana, więc nawet jeśli serwer wyśle przy okazji pełną stronę, robot jej nie wykorzysta. Adresy, które były już w indeksie, pozostają w nim przez pewien czas, ale przy utrzymujących się błędach są z niego usuwane. Dokumentacja nie podaje, po ilu dokładnie dniach to następuje, używa jedynie określenia, że dzieje się to po jakimś czasie. Wreszcie, gdy serwer znów zaczyna odpowiadać kodem z grupy 2xx, Google zwiększa szybkość skanowania stopniowo, a nie od razu do poprzedniego poziomu.
Ważny jest też zasięg reakcji. Na stronie o zarządzaniu budżetem indeksowania Google opisuje limit wydajności skanowania, nazywany również obciążeniem hosta. Każda witryna zaczyna od tego samego, ostrożnego limitu. Rośnie on, gdy serwer odpowiada stabilnie i szybko, a maleje, gdy wydłuża się czas odpowiedzi, pojawiają się błędy 5xx albo sygnały ograniczania liczby żądań, wśród których dokumentacja wymienia właśnie kod 429. Limit dotyczy całej nazwy hosta, a nie pojedynczej podstrony. Jeżeli więc serwer odrzuca zapytania do filtrów w sklepie, robot ograniczy wizyty także na stronie głównej, w kategoriach i na kartach produktów. Szerzej o tym mechanizmie piszemy we wpisie o budżecie indeksowania.
| Odpowiedź serwera | Wpływ na szybkość skanowania | Co dzieje się z adresem w indeksie |
|---|---|---|
| 429 | Google zwalnia skanowanie całej nazwy hosta | Adres zostaje przez pewien czas, przy trwałym błędzie jest usuwany |
| 500 i 503 | Google zwalnia skanowanie całej nazwy hosta | Adres zostaje przez pewien czas, przy trwałym błędzie jest usuwany |
| Pozostałe kody 4xx, na przykład 403 i 404 | Brak wpływu na szybkość skanowania | Zależy od kodu, omawiamy to w osobnych wpisach |
| 200 | Przy stabilnych odpowiedziach limit może rosnąć | Treść może zostać przetworzona i zaindeksowana |
Osobną sprawą jest nagłówek Retry-After. Standard pozwala dołączyć go do odpowiedzi 429, jednak w dokumentach Google, na których opieramy ten wpis, nie znaleźliśmy zapewnienia, że Googlebot wróci dokładnie po wskazanym czasie. Nagłówek warto wysyłać, bo jest zgodny ze standardem i korzystają z niego inne programy, lecz nie należy zakładać, że pozwala on precyzyjnie sterować robotem Google.
Skutki dla firmy są bardzo konkretne. Wolniejsze skanowanie oznacza, że nowe podstrony później trafiają do wyszukiwarki, a zmiany w istniejących, na przykład nowa cena lub informacja o braku towaru, pojawiają się w wynikach z opóźnieniem. Przy dłuższym problemie część adresów wypada z indeksu, a wraz z nimi znikają wejścia z wyszukiwarki. Podobny przebieg, tyle że dla błędu po stronie aplikacji, opisaliśmy we wpisie o tym, co widzi Googlebot przy błędzie 500.
Kod 429 przy pobieraniu pliku robots.txt
Kod 429 zwrócony na żądanie pliku robots.txt jest groźniejszy niż ten sam kod na zwykłej podstronie, ponieważ od tego pliku robot zaczyna pracę z witryną. W pomocy Search Console, w opisie raportu Statystyki indeksowania, Google wymienia odpowiedzi uznawane za prawidłowe dla pliku robots.txt: kod 200 oraz kody 403, 404 i 410. Odpowiedzi 429 i 5xx są tam zaliczone do nieprawidłowych.
W dokumencie o tym, jak Google interpretuje specyfikację pliku robots.txt, widać tę samą granicę. Wszystkie błędy 4xx z wyjątkiem 429 Google traktuje tak, jakby pliku nie było, czyli przyjmuje, że nic nie jest zablokowane. Kod 429 został z tej reguły wyłączony. Dla błędów serwera dokument opisuje następujący przebieg: przez pierwsze 12 godzin Google wstrzymuje skanowanie witryny i ponawia próby pobrania pliku, następnie przez 30 dni korzysta z ostatniej poprawnej wersji zapisanej w pamięci podręcznej, a po tym czasie, jeśli witryna jest ogólnie dostępna, zachowuje się tak, jakby pliku nie było. Dokument nie rozpisuje osobno identycznej procedury dla kodu 429, dlatego nie twierdzimy, że przebiega ona co do godziny tak samo. Skoro jednak Google w innych miejscach zalicza 429 do sygnałów przeciążenia razem z błędami 5xx, rozsądnie jest przyjąć, że odrzucanie zapytań o robots.txt może zatrzymać skanowanie całej witryny.
Ten sam dokument zawiera jeszcze jedną istotną uwagę: Google odradza używanie kodów 401 i 403 do ograniczania szybkości skanowania. Ma to znaczenie, ponieważ część zapór i usług pośredniczących po przekroczeniu limitu odpowiada kodem 403 zamiast 429. Robot odczytuje wtedy komunikat o zakazie dostępu, a nie o chwilowym przeciążeniu. Przypadek ten omawiamy osobno we wpisie o tym, dlaczego serwer odmawia dostępu Googlebotowi.
Świadome użycie kodów 429 i 503 do krótkiego ograniczenia skanowania
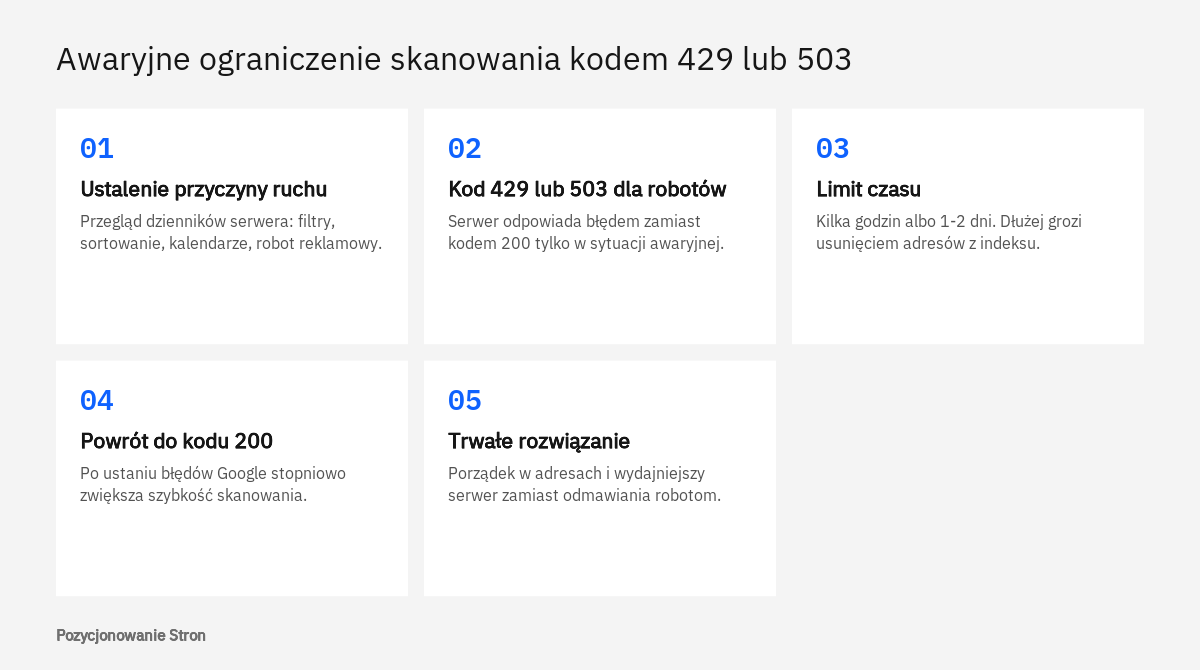
Kody 429 i 503 wolno zwracać robotom celowo, gdy skanowanie rzeczywiście zagraża działaniu serwera, ale wyłącznie jako środek doraźny. Google opisuje to na stronie o zmniejszaniu szybkości indeksowania przez Google: w sytuacji awaryjnej zamiast kodu 200 można odpowiadać kodem 500, 503 lub 429. Google zmniejsza wtedy szybkość skanowania całej nazwy hosta, a gdy liczba błędów spadnie, szybkość wraca samoczynnie.
Granica czasowa jest podana jednoznacznie. Rozwiązanie jest przeznaczone na kilka godzin albo 1-2 dni, a Google nie zaleca stosowania go dłużej. Jeżeli Googlebot przez kilka dni widzi te kody pod tymi samymi adresami, może usunąć adresy z indeksu. Pomoc Search Console przy opisie raportu Statystyki indeksowania podaje zbliżoną granicę: kodów 503 i 429 nie należy utrzymywać dłużej niż 2 lub 3 dni, ponieważ może to trwale zmniejszyć częstotliwość skanowania.
Ta sama strona dokumentacji wylicza koszty, które ponosi witryna nawet przy poprawnie przeprowadzonym ograniczeniu. Googlebot wykrywa mniej nowych podstron. Aktualizacje, w tym zmiany cen i dostępności produktów, docierają do wyszukiwarki później. Usunięte strony dłużej pozostają w indeksie. Ograniczenie może też dotknąć reklam: kampanie w Google Ads mogą zostać wstrzymane lub anulowane, a reklamy mogą przestać się wyświetlać. Firmy, które prowadzą jednocześnie pozycjonowanie i kampanie Google Ads, powinny więc traktować taką decyzję jako wspólną dla obu kanałów.
Najpierw przyczyna, potem kod błędu
Zanim serwer zacznie odmawiać robotom, Google zaleca ustalić, dlaczego ruch wzrósł. Jako typowe powody dokumentacja wymienia nieefektywną budowę adresów: nawigację fasetową, sortowanie i filtrowanie oraz kalendarze, które tworzą osobny adres dla każdej daty. Przyczyną może być także robot reklamowy AdsBot, który odwiedza stronę w związku z dynamicznymi reklamami w wyszukiwarce. Dokumentacja radzi przejrzeć dzienniki serwera razem z dostawcą hostingu. W takich przypadkach trwałym rozwiązaniem jest uporządkowanie adresów, o czym piszemy we wpisie o nawigacji fasetowej w sklepie, a nie odpowiadanie błędem.
Który kod wybrać: 429 czy 503
Dla tempa skanowania oba kody działają podobnie, bo Google wymienia je razem w tych samych zaleceniach. Różnica dotyczy tego, co chcą Państwo zakomunikować. Kod 429 pasuje do sytuacji, w której strona działa dla klientów, a odmowę dostaje tylko odbiorca wysyłający zbyt wiele zapytań. Kod 503 opisuje niedostępność usługi jako takiej i jest naturalnym wyborem na czas prac technicznych, co omawiamy we wpisie o tym, jak zamknąć stronę na czas prac.
Jeśli chcą Państwo zamówić SEO techniczne, zachęcamy do kontaktu: tel. 222 500 844 lub mailowo: biuro@pozycjonowaniestron.pl
Ryzyko związane ze zbyt ostrymi limitami na hostingu
Zbyt ostre limity na hostingu działają na Google dokładnie tak samo jak świadome ograniczenie skanowania, z tą różnicą, że nikt ich nie wyłącza po dwóch dniach. Robot nie odróżnia odmowy zaplanowanej od przypadkowej. Jeżeli serwer tydzień po tygodniu odrzuca część jego zapytań, limit skanowania całej nazwy hosta pozostaje obniżony, a adresy, które stale kończą się błędem, z czasem wypadają z indeksu.
Najtrudniejsze w tym problemie jest to, że z perspektywy właściciela wszystko wygląda poprawnie. Strona otwiera się w przeglądarce, klienci składają zamówienia, a pojedyncze sprawdzenie adresu kończy się kodem 200. Odmowy dostaje wyłącznie odbiorca, który wysyła wiele zapytań w krótkim czasie, czyli właśnie robot. Objawy pojawiają się pośrednio i z opóźnieniem: nowe wpisy długo czekają na zaindeksowanie, w wynikach pozostają nieaktualne ceny, a liczba zaindeksowanych podstron powoli maleje.
Trzy hipotetyczne przykłady pokazują, jak do tego dochodzi. Kancelaria z Krakowa utrzymuje stronę na niedrogim hostingu współdzielonym. Witryna jest mała, więc na co dzień limit kilku jednoczesnych połączeń nie przeszkadza. Po dodaniu rozbudowanego działu z poradami robot zaczyna odwiedzać stronę częściej i część jego zapytań trafia na odmowę. Hydraulik z Łodzi po włamaniu na stronę ma zainstalowaną wtyczkę bezpieczeństwa z bardzo niskim progiem liczby odsłon na minutę. Wtyczka skutecznie blokuje automaty atakujące formularz logowania, lecz tym samym progiem obejmuje roboty wyszukiwarek, których nikt nie dodał do wyjątków. Sklep z Poznania włącza z kolei kod 429 dla robotów na kilka godzin wyprzedaży, co mieści się w zaleceniach Google, po czym zapomina o tej regule na tydzień.
Warto też uwzględnić inne roboty. Obok Googlebota stronę odwiedzają roboty Binga oraz roboty asystentów AI, a ich łączny ruch potrafi przekroczyć próg ustawiony z myślą o ludziach. Decyzję, którym z nich ograniczać dostęp, lepiej podjąć świadomie, na przykład według zasad opisanych we wpisie o robotach AI i pliku robots.txt, niż zostawiać ją domyślnym ustawieniom zapory.
Gdzie sprawdzić, czy Googlebot dostaje kod 429
Najpewniejszym miejscem są dzienniki serwera, a pierwszą wskazówką raport Statystyki indeksowania w Search Console. Raport znajduje się w menu pod pozycją Ustawienia, w części Statystyki indeksowania. Według pomocy Search Console jest on dostępny tylko dla usług najwyższego poziomu, czyli dla całej domeny lub prefiksu adresu bez podkatalogu.
W raporcie warto przejrzeć cztery miejsca. Wykres Łączna liczba żądań robota indeksującego pokazuje, czy liczba wizyt nagle spadła. Wykres Średni czas odpowiedzi mówi, czy serwer zwalniał przed spadkiem. Sekcja Stan hosta obejmuje trzy kategorie: pobieranie pliku robots.txt, rozpoznawanie nazw DNS oraz połączenie z serwerem, a każda ma wykres z czerwoną przerywaną linią, której przekroczenie oznacza problem. Tabela Odpowiedzi na żądania robota indeksującego grupuje wizyty według kodu. Pomoc nie wymienia w niej osobnego wiersza dla kodu 429, dlatego należy przyjrzeć się pozycjom Inny błąd klienta (4XX) oraz Błąd serwera (5XX) i otworzyć przykładowe adresy z dokładnymi godzinami. Jeśli odmowy dotyczą pliku robots.txt, będzie to widoczne w sekcji Stan hosta.
Drugim śladem jest narzędzie do sprawdzania adresów URL. Dokumentacja budżetu indeksowania podaje, że przy przekroczeniu obciążenia hosta pojawia się w nim komunikat Przekroczono limit obciążenia hosta. Raport Indeksowanie stron wymienia z kolei przyczynę Błąd serwera (5xx), natomiast jego opis w pomocy nie wspomina o kodzie 429, więc brak tej pozycji nie dowodzi, że problemu nie ma.
Dzienniki serwera i weryfikacja robota
Rozstrzygająca odpowiedź znajduje się w dzienniku dostępu serwera, gdzie każde zapytanie ma zapisany adres IP, godzinę, adres podstrony, kod odpowiedzi i nazwę programu. Należy wybrać wiersze z kodem 429 i sprawdzić, kto je otrzymał. Sama nazwa Googlebot w dzienniku niczego nie przesądza, ponieważ inne automaty często się pod nią podszywają. Google opisuje weryfikowanie żądań od swoich robotów na dwa sposoby. Przy pojedynczych sprawdzeniach wykonuje się odwrotne wyszukiwanie DNS adresu IP, potwierdza, że nazwa kończy się na googlebot.com, google.com lub googleusercontent.com, a potem zwykłym wyszukiwaniem DNS upewnia się, że nazwa wskazuje ten sam adres. Przy większej liczbie zapytań porównuje się adresy z listami zakresów IP, które Google publikuje w plikach JSON.
host 66.249.66.1
1.66.249.66.in-addr.arpa domain name pointer crawl-66-249-66-1.googlebot.com.

host crawl-66-249-66-1.googlebot.com
crawl-66-249-66-1.googlebot.com has address 66.249.66.1
Wynik takiej analizy prowadzi do jednego z dwóch wniosków. Jeżeli kod 429 otrzymują wyłącznie automaty podszywające się pod Google, limit działa prawidłowo i nie wymaga zmian. Jeżeli otrzymuje go zweryfikowany Googlebot, limit trzeba poprawić.
Jak ustawić limity, żeby chroniły serwer i nie szkodziły widoczności
Dobrze ustawiony limit zatrzymuje nadużycia, a zweryfikowanym robotom wyszukiwarek pozwala pracować bez odmów. Osiąga się to kolejnością działań: najpierw ustalenie, który element wysyła kod 429, potem zawężenie limitu do miejsc, które naprawdę tego wymagają, a na końcu kontrola skutków w Search Console.
- Ustalenie źródła odmów
Należy sprawdzić, czy kod 429 generuje serwer, zapora, sieć dostarczania treści czy wtyczka. Pomaga w tym treść strony błędu i nagłówki odpowiedzi, a w razie wątpliwości pytanie do dostawcy hostingu.
- Wyłączenie zweryfikowanych robotów
Wyjątek powinien opierać się na zakresach IP publikowanych przez Google lub na weryfikacji DNS, a nie na samej nazwie programu, którą łatwo podrobić.
- Zawężenie limitu do wrażliwych adresów
Ostre progi mają sens przy logowaniu, wyszukiwarce wewnętrznej, koszyku i formularzach. Dla zwykłych podstron z treścią powinny być znacznie łagodniejsze.
- Usunięcie przyczyny nadmiernego ruchu
Uporządkowanie filtrów, sortowania i parametrów w adresach zmniejsza liczbę zbędnych wizyt robota bez odmawiania mu dostępu.
- Odciążenie serwera
Pamięć podręczna stron, sieć dostarczania treści albo mocniejszy pakiet sprawiają, że ten sam ruch przestaje być kłopotem. Google wprost wskazuje dodanie zasobów serwera jako rozwiązanie, jeśli ma to uzasadnienie biznesowe.
- Kontrola po zmianach
Przez kolejne tygodnie warto obserwować raport Statystyki indeksowania: liczba żądań powinna stopniowo rosnąć, a błędne odpowiedzi znikać.
Po poprawkach skanowanie nie wraca natychmiast. Dokumentacja mówi, że po powrocie odpowiedzi z grupy 2xx Google zwiększa szybkość stopniowo, dlatego przez pewien czas raport może pokazywać niższe wartości niż przed problemem. Nie jest to powód do kolejnych zmian w konfiguracji.
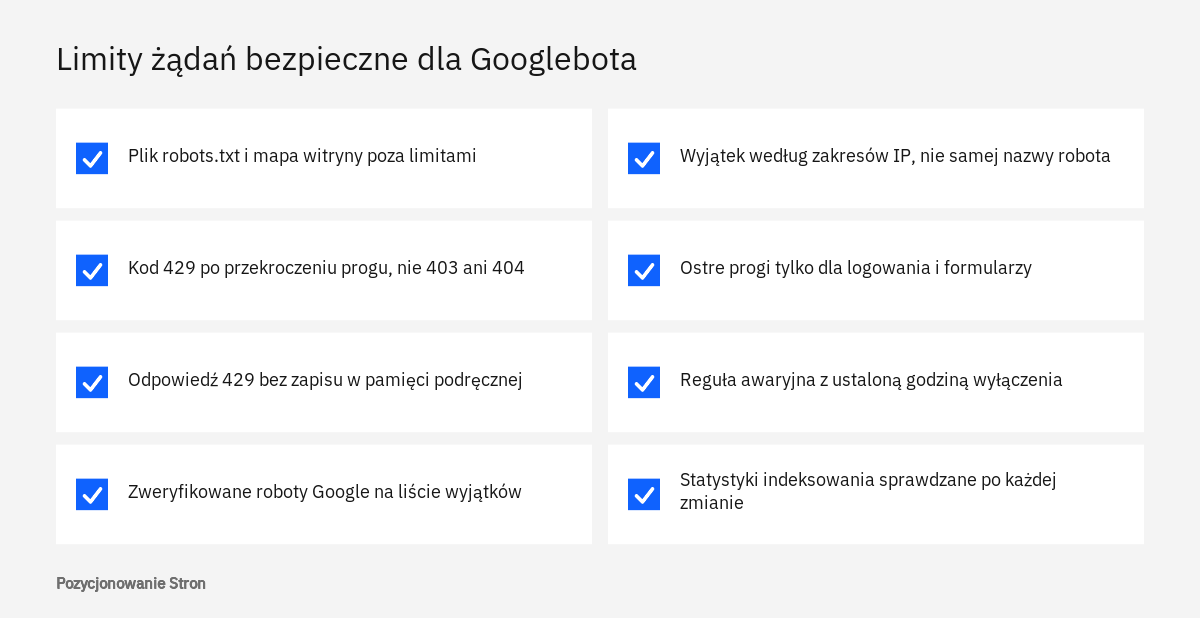
- Plik robots.txt i mapa witryny nie podlegają żadnym limitom.
- Po przekroczeniu progu serwer odpowiada kodem 429, a nie 403 lub 404.
- Odpowiedź 429 nie jest zapisywana w pamięci podręcznej serwera ani sieci dostarczania treści.
- Zweryfikowane roboty Google są dodane do wyjątków w zaporze i we wtyczce bezpieczeństwa.
- Każde celowe ograniczenie skanowania ma wyznaczoną osobę i godzinę wyłączenia.
- Raport Statystyki indeksowania jest przeglądany po każdej zmianie hostingu, zapory lub wtyczek.
Typowe pomyłki i moment, w którym potrzebna jest pomoc
Najczęściej spotykamy cztery błędy. Pierwszy to pozostawienie awaryjnej reguły na stałe, choć miała działać kilka godzin. Drugi to odpowiadanie kodem 403 lub 404 zamiast 429, przez co robot dostaje zupełnie inną informację. Trzeci to wyjątek oparty wyłącznie na nazwie Googlebot, który otwiera drzwi każdemu automatowi używającemu tej nazwy. Czwarty to ocenianie sytuacji po jednym otwarciu strony w przeglądarce, które nigdy nie przekroczy limitu.
Pomoc specjalisty przydaje się wtedy, gdy źródła kodu 429 nie da się ustalić, gdy dostawca hostingu nie udostępnia dzienników albo gdy spadek liczby zaindeksowanych podstron już nastąpił i trzeba ocenić jego skalę. Analiza dzienników serwera i ustawień zapory wchodzi w zakres naszego SEO technicznego, a szerszy obraz stanu witryny daje kompleksowy audyt SEO.
Jeśli chcą Państwo zamówić SEO techniczne, zachęcamy do kontaktu: tel. 222 500 844 lub mailowo: biuro@pozycjonowaniestron.pl
Najczęstsze pytania
Czy pojedyncze odpowiedzi 429 szkodzą pozycjom strony?
Dokumentacja Google opisuje skutki dla skanowania i indeksu, a nie bezpośrednią karę w rankingu. Sporadyczne odmowy spowalniają skanowanie na pewien czas, po czym tempo wraca. Problemem stają się błędy utrzymujące się przez kilka dni pod tymi samymi adresami, bo wtedy adresy mogą zostać usunięte z indeksu.
Jak długo wolno celowo zwracać kod 429 robotom Google?
Google przeznacza to rozwiązanie na kilka godzin albo 1-2 dni. Pomoc Search Console dodaje, że kodów 503 i 429 nie należy utrzymywać dłużej niż 2 lub 3 dni. Po tym czasie rośnie ryzyko usunięcia adresów z indeksu i trwałego zmniejszenia częstotliwości skanowania.
Czy kod 429 jest lepszy od 503 przy przeciążeniu serwera?
Dla tempa skanowania Google traktuje oba kody podobnie i wymienia je w tych samych zaleceniach. Kod 429 lepiej opisuje sytuację, w której strona działa, a odmowa dotyczy tylko zbyt aktywnego odbiorcy. Kod 503 pasuje do niedostępności całej usługi, na przykład podczas prac technicznych.
Czy Googlebot stosuje się do nagłówka Retry-After?
Standard HTTP pozwala dołączyć ten nagłówek do odpowiedzi 429. W dokumentach Google, z których korzystaliśmy, nie ma jednak zapewnienia, że robot wróci dokładnie po wskazanym czasie. Nagłówek warto wysyłać, ale nie należy na nim opierać planu ograniczenia skanowania.
Strona otwiera się normalnie, a Search Console pokazuje błędy. Jak to możliwe?
Limit liczby żądań uruchamia się dopiero przy wielu zapytaniach w krótkim czasie. Pojedynczy użytkownik w przeglądarce nigdy go nie przekroczy, a robot odwiedzający wiele podstron już tak. Dlatego stan faktyczny należy oceniać po dziennikach serwera i raporcie Statystyki indeksowania.
Czy można poprosić Google o wolniejsze skanowanie bez zwracania błędów?
Tak. Gdy infrastruktura nie pozwala zwracać robotom kodów błędów, dokumentacja Google przewiduje specjalne zgłoszenie dotyczące Googlebota z opisem problemu i pożądaną szybkością. Rozpatrzenie może potrwać kilka dni, a tą drogą nie można zamówić szybszego skanowania.
Czy mała strona firmowa też może mieć ten problem?
Tak, choć z innego powodu niż duży sklep. Na małych stronach źródłem są zwykle niskie progi na hostingu współdzielonym albo domyślne ustawienia wtyczki bezpieczeństwa. Wystarczy wtedy dodać zweryfikowane roboty do wyjątków lub złagodzić próg dla zwykłych podstron.
Źródła
- Jak kody stanu HTTP wpływają na roboty Google, Google for Developers
- Zmniejszanie szybkości indeksowania przez Google, Google for Developers
- Zarządzanie budżetem indeksowania, Google for Developers
- Jak Google interpretuje specyfikację pliku robots.txt, Google for Developers
- Weryfikowanie żądań od robotów i modułów pobierania Google, Google for Developers
- Raport Statystyki indeksowania, Search Console - pomoc
- Raport Indeksowanie stron, Search Console - pomoc
- RFC 6585: Additional HTTP Status Codes, RFC Editor
Funkcje wyszukiwarek i asystentów AI zmieniają się szybko, dlatego wpis aktualizujemy po większych zmianach.