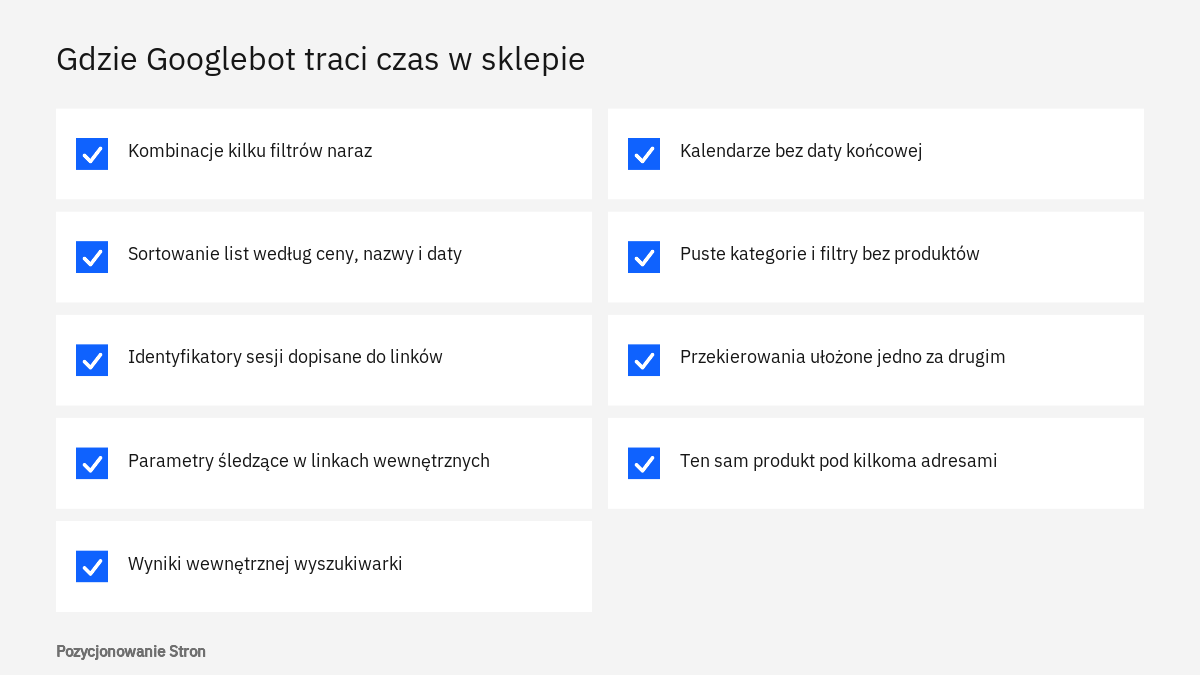
W sklepie z dużym asortymentem Googlebot traci czas przede wszystkim na adresy, które sklep sam wytwarza: kombinacje filtrów, sortowanie, parametry śledzące, wyniki wewnętrznej wyszukiwarki i stare przekierowania. Poniżej pokazujemy, jak ustalić, czy w Państwa sklepie jest to rzeczywisty kłopot, gdzie to sprawdzić w Search Console i w logach serwera oraz w jakiej kolejności porządkować adresy.
Kiedy budżet indeksowania jest w sklepie realnym problemem
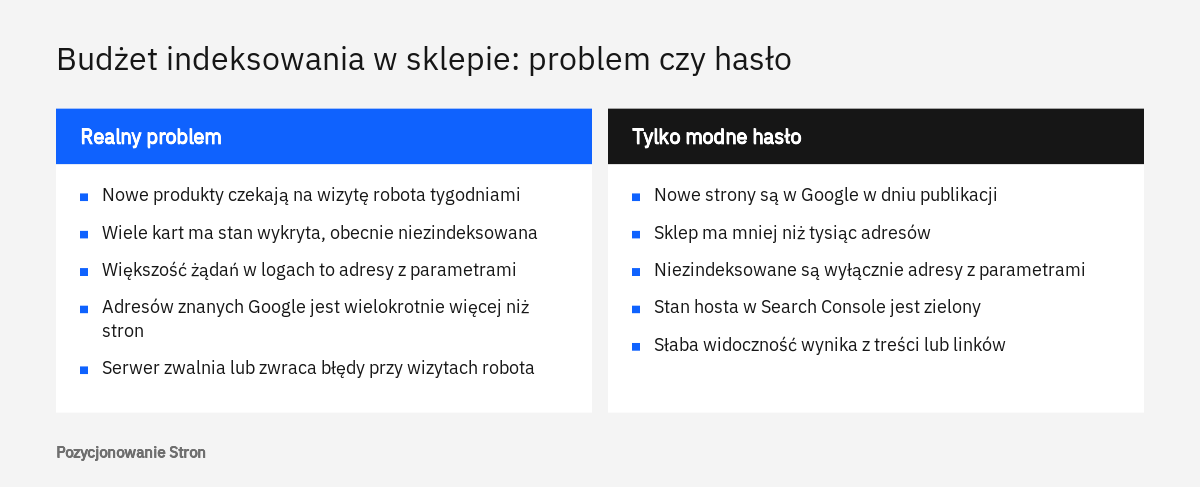
Budżet indeksowania staje się realnym problemem wtedy, gdy Google wie o znacznie większej liczbie adresów sklepu, niż jest w stanie lub chce odwiedzić, a wśród pominiętych znajdują się strony ważne dla sprzedaży. W pozostałych przypadkach jest to hasło, którym tłumaczy się kłopoty o zupełnie innym źródle, na przykład słabe opisy albo brak linków wewnętrznych.
Jedno wyjaśnienie na początek. W polskiej dokumentacji Google słowo „indeksowanie” oznacza często samo pobieranie stron przez robota, czyli to, co w branży nazywa się skanowaniem (ang. crawling). W tym tekście piszemy „skanowanie”, gdy chodzi o odwiedziny Googlebota, a „indeksowanie”, gdy chodzi o dodanie strony do bazy wyszukiwarki. Nazwę „budżet indeksowania” zostawiamy, bo tak brzmi w materiałach Google.
Dokumentacja Zarządzanie budżetem indeksowania podaje, dla kogo jest przeznaczona. Są to witryny mające ponad milion unikalnych stron z treścią zmienianą mniej więcej raz w tygodniu, witryny mające ponad 10 tys. unikalnych stron z treścią zmienianą codziennie oraz witryny, w których duża część adresów ma w Search Console stan „Strona wykryta - obecnie niezindeksowana”. Google zaznacza, że liczby są szacunkowe. Jeżeli nowe strony trafiają do wyszukiwarki w dniu publikacji, wystarczy według tej dokumentacji aktualna mapa witryny i regularne przeglądanie raportu Indeksowanie stron.
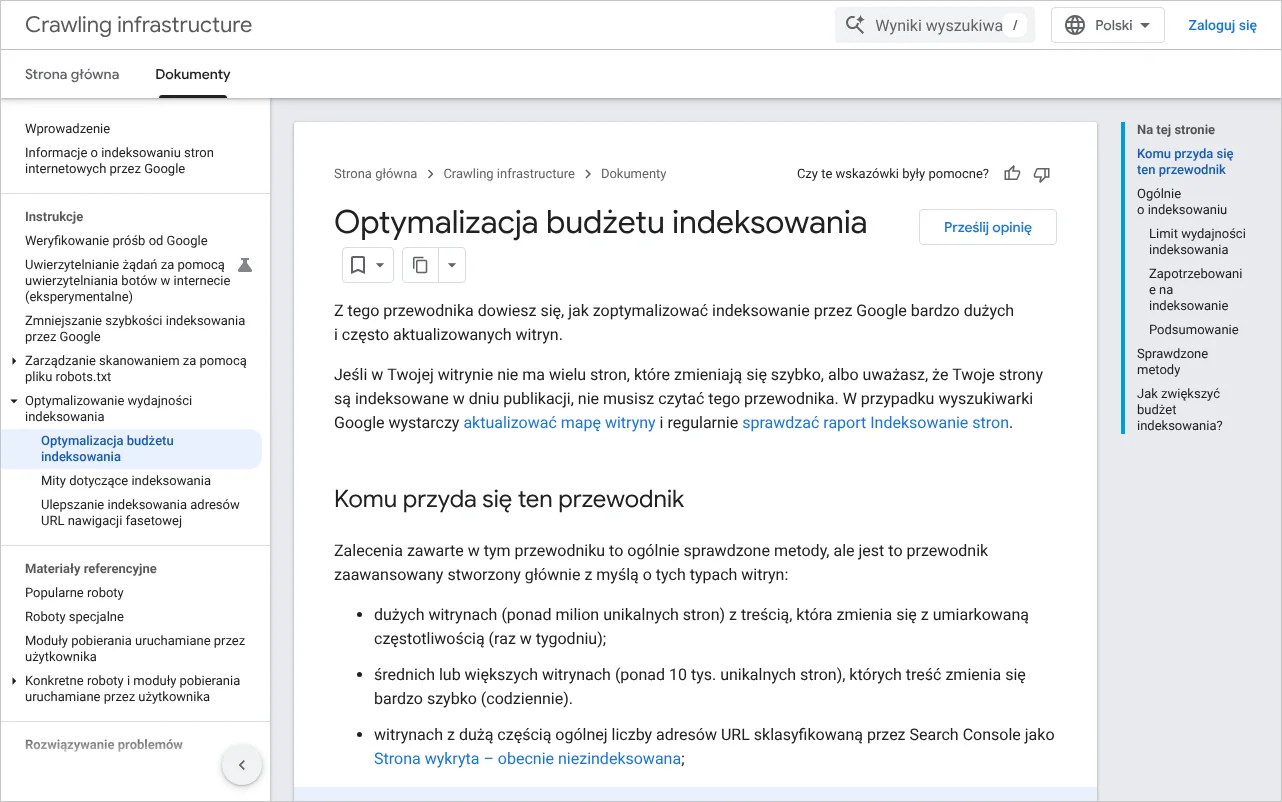
Sklep internetowy łatwo spełnia drugi warunek. Ceny, stany magazynowe, promocje i nowości zmieniają się codziennie, a dziesięć tysięcy adresów to niewiele, jeśli policzyć nie tylko karty produktów, lecz także wszystko, co sklep potrafi wygenerować. Dlatego przy dużym asortymencie pytanie nie brzmi „ile mamy produktów”, tylko „ile adresów widzi u nas robot”.
Dwa składniki budżetu: ile serwer wytrzyma i ile Google chce
Google opisuje budżet jako zestaw adresów, które Googlebot może i zamierza odwiedzić. Wynika on z dwóch rzeczy. Pierwsza to limit wydajności: robot dobiera liczbę równoległych połączeń tak, aby nie przeciążyć serwera. Limit rośnie, gdy serwer odpowiada stabilnie, a maleje, gdy czas odpowiedzi się wydłuża albo pojawiają się błędy z grupy 5xx i kod 429. Druga rzecz to zapotrzebowanie: Google ocenia, jak często warto wracać do witryny, biorąc pod uwagę jej rozmiar, częstotliwość zmian, popularność adresów oraz jakość stron.
Dla sklepu szczególnie ważny jest jeden z czynników zapotrzebowania, który dokumentacja nazywa domniemanymi zasobami. Chodzi o wszystkie adresy, o których Google wie, łącznie z duplikatami i stronami, których sklep wcale nie chce mieć w wynikach. Jeśli jest ich dużo, robot poświęca im czas, a to jest właśnie ten składnik, na który właściciel sklepu ma największy wpływ.
Jak sklep mnoży adresy: rachunek, który warto zrobić na kartce
Sklep mnoży adresy przez łączenie ze sobą opcji, które każda z osobna wygląda niewinnie. Wystarczy prosty rachunek na jednej kategorii, żeby zobaczyć skalę.
Weźmy hipotetyczny sklep z obuwiem z Poznania. Kategoria „buty do biegania” ma filtr marki z dwunastoma pozycjami, filtr rozmiaru z piętnastoma, filtr koloru z dziesięcioma i cztery sposoby sortowania. Jeśli każdy wybór zapisuje się w adresie jako parametr i można je dowolnie łączyć, to nawet przy wyborze najwyżej jednej wartości w każdym filtrze sama ta kategoria daje ponad jedenaście tysięcy możliwych adresów. Przy możliwości zaznaczenia kilku marek naraz liczba rośnie o kolejne rzędy wielkości. Kategorii jest w sklepie kilkadziesiąt, a prawie wszystkie te adresy pokazują te same produkty w innej kolejności lub w węższym wyborze.
Google opisuje to zjawisko w dokumentacji Zarządzanie indeksowaniem adresów URL nawigacji fasetowej: robot musi odwiedzić takie adresy, zanim ustali, że są bezużyteczne, przez co traci czas, który mógłby poświęcić nowym i wartościowym stronom, a serwer ponosi dodatkowe obciążenie. W dokumentacji o strukturze adresów Google dodaje, że Googlebotowi wystarczy kilka list, aby dotrzeć do wszystkich podstron.
Do filtrów dochodzą inne źródła. Ten sam produkt bywa dostępny pod adresem opisowym i pod adresem z numerem katalogowym. Linki z newslettera i reklam niosą parametry śledzące. Wewnętrzna wyszukiwarka odpowiada na każde wpisane słowo osobną stroną. Każdy z tych mechanizmów ma sens dla kupującego, ale dla robota jest to kolejna przestrzeń do przejścia. Szerzej o samych parametrach piszemy we wpisie Sortowanie i parametry w adresach sklepu.
Część witryny, w której z każdej strony da się przejść do kolejnej nowej strony bez końca, na przykład kalendarz z linkiem „następny miesiąc” albo adres ze zmieniającym się znacznikiem czasu.
Raport Statystyki indeksowania: gdzie go znaleźć i co z niego odczytać
Raport Statystyki indeksowania znajduje się w Search Console w Ustawieniach: po kliknięciu ikony koła zębatego w menu po lewej stronie należy wybrać pozycję „Statystyki indeksowania”. Pokazuje on, ile żądań Googlebot wysłał do sklepu, jak szybko serwer odpowiadał i jakie kody zwracał.
Według pomocy Search Console raport jest dostępny tylko dla usług najwyższego poziomu, czyli dla usługi domeny albo usługi z prefiksem adresu obejmującej cały host. Jeśli sklep jest dodany wyłącznie jako katalog, na przykład sama wersja językowa, raportu tam nie będzie. Google zaznacza też, że raport jest przeznaczony dla zaawansowanych użytkowników i że przy witrynie mającej mniej niż tysiąc stron zwykle nie ma potrzeby do niego zaglądać.
U góry raportu widać trzy liczby z wykresami: łączną liczbę żądań robota indeksującego, całkowity rozmiar pobierania oraz średni czas odpowiedzi. Niżej znajduje się stan hosta, który ocenia pobieranie pliku robots.txt, rozpoznawanie nazw DNS i połączenie z serwerem. Zielone oznaczenie mówi, że w ciągu 90 dni nie było istotnych problemów z dostępnością, czerwone, że istotny problem wystąpił w ostatnim tygodniu.
Najwięcej o sklepie mówią cztery tabele poniżej. Każda dzieli te same żądania w inny sposób, a kliknięcie wiersza otwiera listę przykładowych adresów. Pomoc zastrzega, że przykłady nie są pełną listą.
| Tabela w raporcie | Co pokazuje | Na co patrzeć w sklepie |
|---|---|---|
| Według odpowiedzi | Udział żądań zakończonych kodem 200, 301 lub 308, 302 lub 307, 304, 404, 5xx i innymi | Wysoki udział przekierowań i błędów 404 oznacza, że robot chodzi po nieaktualnych adresach. Kody 5xx to sygnał kłopotów z serwerem |
| Według typu pliku | Podział na HTML, obrazy, JavaScript, CSS, JSON i pozostałe | Duży udział JSON lub skryptów bywa śladem filtrów i list doładowywanych w tle |
| Według celu | „Wykrycie”, czyli adresy odwiedzane po raz pierwszy, oraz „Odświeżenie”, czyli powroty do znanych stron | Przykłady z wiersza „Wykrycie” pokazują, czy robot odkrywa nowe produkty, czy kolejne kombinacje parametrów |
| Według typu Googlebota | Smartfon, Komputer, Obraz, Ładowanie zasobu strony, AdsBot, StoreBot i inne | Roboty reklam i zakupów także obciążają serwer, a limit wydajności jest dla nich wspólny |
Ostatni wiersz ma w sklepie praktyczne znaczenie. Dokumentacja o budżecie wyjaśnia, że każdy robot Google ma własne zapotrzebowanie, ale limit pojemności serwera jest wspólny, więc duży ruch jednego z nich może ograniczyć pozostałe. Sklep, który prowadzi kampanie produktowe i ma plik produktowy w Merchant Center, przyjmuje więc więcej rodzajów odwiedzin niż zwykła witryna firmowa.
Drugi raport do pary: Indeksowanie stron
Statystyki indeksowania mówią o pracy robota, a raport Indeksowanie stron o jej wyniku. W tabeli „Dlaczego strony nie są indeksowane” warto odszukać pozycję „Strona wykryta - obecnie niezindeksowana”. Oznacza ona według pomocy Search Console, że Google zna adres, ale jeszcze go nie odwiedził, najczęściej dlatego, że uznał, iż mogłoby to przeciążyć witrynę, i odłożył wizytę na później. Jeśli na liście przykładów są tam karty produktów i kategorie, mamy do czynienia z prawdziwym objawem. Jeśli są tam wyłącznie adresy z parametrami, to znak, że Google sam odsuwa je na koniec kolejki.
Skalę zbędnych adresów pomagają oszacować pozycje „Strona zawiera przekierowanie”, „Alternatywna strona zawierająca prawidłowy tag strony kanonicznej”, „Pozorny błąd 404” oraz „URL zablokowany przez plik robots.txt”. Gdy ich suma wielokrotnie przewyższa liczbę stron zindeksowanych, sklep wytwarza znacznie więcej adresów, niż ma treści.
Logi serwera: pełny obraz tego, co odwiedza Googlebot
Logi serwera pokazują każde żądanie robota z osobna, razem z dokładnym adresem, godziną i kodem odpowiedzi, czyli to, czego Search Console nie udostępnia w całości. Dzięki nim da się policzyć, jaka część odwiedzin przypada na produkty i kategorie, a jaka na adresy techniczne.
Plik dziennika dostępu znajduje się zwykle w panelu hostingu albo udostępnia go administrator serwera. Na platformach abonamentowych dostęp do surowych logów bywa ograniczony i trzeba o niego zapytać dostawcę. Pojedynczy wpis wygląda mniej więcej tak jak poniżej.
66.249.66.1 - - [data i godzina] "GET /buty-do-biegania/?kolor=czarny&sort=cena HTTP/1.1" 200 48213 "-" "Mozilla/5.0 (compatible; Googlebot/2.1; +http://www.google.com/bot.html)"Z takiego wiersza odczytuje się adres IP, żądany adres strony, kod odpowiedzi, rozmiar odpowiedzi i nazwę klienta. Sama nazwa „Googlebot” nie wystarcza, bo każdy program może się nią przedstawić. Google opisuje dwa sposoby sprawdzenia w dokumentacji Weryfikowanie żądań od robotów i modułów pobierania Google. Przy pojedynczych adresach wykonuje się odwrotne wyszukiwanie DNS i sprawdza, czy nazwa kończy się na googlebot.com, google.com lub googleusercontent.com, a następnie zwykłe wyszukiwanie tej nazwy, które powinno zwrócić ten sam adres IP. Przy dużej liczbie wpisów porównuje się adresy z zakresami, które Google publikuje w plikach JSON.
host 66.249.66.1
1.66.249.66.in-addr.arpa domain name pointer crawl-66-249-66-1.googlebot.com.

host crawl-66-249-66-1.googlebot.com
crawl-66-249-66-1.googlebot.com has address 66.249.66.1
Co policzyć w logach sklepu
Po odfiltrowaniu prawdziwych żądań Googlebota z okresu kilku tygodni warto pogrupować adresy według typu: karty produktów, kategorie bez parametrów, adresy z parametrami filtrów, adresy z sortowaniem, wyniki wyszukiwarki, koszyk i konto klienta, pliki graficzne i skrypty. Już sam udział procentowy tych grup odpowiada na pytanie z tytułu. Jeżeli większość odwiedzin przypada na adresy ze znakiem zapytania, a karty produktów dodanych w ostatnim miesiącu nie mają żadnej wizyty, wiadomo, gdzie robot traci czas.
Drugie zestawienie to kody odpowiedzi w każdej grupie. Przekierowania wśród adresów kategorii wskazują na stare linki w menu lub w opisach, a kody 404 wśród kart produktów na ofertę wycofaną bez porządków. Trzecie zestawienie to porównanie z mapą witryny: lista adresów z mapy, których robot nie odwiedził ani razu w badanym okresie, jest najbardziej konkretnym dowodem, że problem istnieje.
Pułapki sklepów: filtry, sortowanie, parametry i kalendarze
Najwięcej zbędnych odwiedzin robota biorą na siebie cztery mechanizmy: filtrowanie z dowolnym łączeniem opcji, sortowanie list, parametry dopisywane do adresów przez sam sklep oraz moduły z datami. Każdy z nich Google wymienia wśród typowych problemów w dokumentacji Sprawdzone metody tworzenia struktury adresów URL dla wyszukiwarki Google.
Filtry i sortowanie
Filtry są potrzebne kupującym, ale większość ich kombinacji nie odpowiada na żadne zapytanie wpisywane w Google. Jeśli takie adresy nie mają trafić do wyników, Google zaleca zamknięcie ich przed robotem w pliku robots.txt regułami opartymi na nazwach parametrów. Alternatywą jest zapisanie wyboru filtra po znaku # w adresie, ponieważ wyszukiwarka co do zasady pomija tę część adresu. Sortowanie nie zmienia zestawu produktów, tylko ich kolejność, więc dokumentacja wymienia je wśród funkcji, które zazwyczaj się blokuje.
User-agent: Googlebot
Disallow: /*?*kolor=
Disallow: /*?*rozmiar=
Disallow: /*?*sort=
Disallow: /*?*sessionid=
Część filtrów warto jednak zostawić dla Google, na przykład kategorię zawężoną do jednej marki, bo takich połączeń klienci rzeczywiście szukają. Dla nich dokumentacja o nawigacji fasetowej podaje trzy warunki: parametry rozdzielane zwykłym znakiem &, stała kolejność filtrów zapisanych w ścieżce oraz kod 404 dla kombinacji, która nie zwraca żadnych produktów. Podział filtrów na indeksowane i zamknięte opisujemy we wpisie Filtry w sklepie a indeksowanie, a stronę techniczną w tekście Nawigacja fasetowa: jak opanować filtry w sklepie.
Identyfikatory sesji i parametry śledzące
Starsze silniki sklepowe i niektóre moduły dopisują do linków identyfikator sesji albo znacznik źródła wejścia. Dla robota każdy taki adres jest nowy, choć treść się nie zmienia. Google w zaleceniach dla sklepów radzi nie linkować wewnątrz witryny do adresów z parametrami tymczasowymi, takimi jak identyfikatory sesji, kody śledzenia czy bieżąca godzina, a identyfikatory sesji zastąpić plikami cookie. W praktyce oznacza to przegląd szablonu: menu, okruszki, moduły „ostatnio oglądane” i banery powinny prowadzić do czystych adresów, tych samych, które stoją w mapie witryny i w znaczniku rel="canonical".
Kalendarze i moduły z datami
Kalendarz kojarzy się z hotelem, ale w handlu pojawia się częściej, niż się wydaje: wybór terminu dostawy, rezerwacja sprzętu w wypożyczalni, harmonogram szkoleń przy sklepie z kursami, archiwum promocji dzień po dniu. Jeśli kalendarz ma linki „poprzedni” i „następny” bez daty końcowej, robot może przechodzić po nich bez końca. Google zaleca w takim przypadku atrybut nofollow przy linkach do kolejnych stron kalendarza, a w części o rozwiązywaniu problemów dodaje, że kalendarze tworzące nieskończoną przestrzeń adresów zazwyczaj się blokuje w robots.txt.
Wyniki wyszukiwarki sklepu i dalekie strony list
Dynamiczne adresy z wynikami wyszukiwania dokumentacja wymienia jako pierwszą rzecz do zamknięcia w robots.txt. Więcej o nich znajduje się we wpisie Wyszukiwarka w sklepie a SEO. Inaczej jest z paginacją: kolejne strony listy są dla robota drogą do produktów, więc nie należy ich zamykać. Dla numerów stron, które nie istnieją, Google zaleca kod 404.
Jeśli chcą Państwo zamówić SEO techniczne, zachęcamy do kontaktu: tel. 222 500 844 lub mailowo: biuro@pozycjonowaniestron.pl
Łańcuchy przekierowań, wycofane produkty i pozorne błędy 404
Duży sklep z każdym sezonem zostawia za sobą warstwę starych adresów, a każda z nich kosztuje robota dodatkowe żądania. Trzy zjawiska powtarzają się najczęściej: przekierowania ułożone jedno za drugim, produkty usunięte bez jasnego sygnału oraz strony, które istnieją, ale są puste.
Łańcuch powstaje zwykle po kolejnych zmianach: przejście na szyfrowane połączenie, zmiana struktury kategorii, nowa platforma. Stary link prowadzi wtedy przez trzy lub cztery adresy, zanim trafi na właściwą stronę. Według dokumentacji Jak kody stanu HTTP wpływają na roboty Google Googlebot domyślnie śledzi do 10 przeskoków, więc krótki łańcuch nie odcina strony od wyszukiwarki. Każdy przeskok jest jednak osobnym żądaniem, a dokumentacja o budżecie zalicza unikanie długich łańcuchów do sprawdzonych metod. Rozwiązaniem jest przekierowanie każdego starego adresu od razu na docelowy oraz poprawienie linków wewnętrznych. Sposób wyszukiwania takich ciągów opisujemy we wpisie Łańcuchy i pętle przekierowań.
Dla stron usuniętych na stałe Google zaleca kod 404 lub 410. Oba są traktowane tak samo: adres wypada z indeksu, a robot z czasem zagląda pod niego coraz rzadziej. Dokumentacja zaznacza przy tym, że adresy zablokowane w robots.txt pozostają w kolejce skanowania dłużej. Produktu wycofanego na stałe nie należy więc chować za blokadą, tylko pozwolić robotowi zobaczyć właściwy kod. Kiedy lepsze jest przekierowanie na następcę, wyjaśniamy w tekście Produkt wycofany ze sprzedaży: 301, 404 czy 410.
Trzecia grupa to pozorne błędy 404. Powstają, gdy serwer odpowiada kodem 200, a strona wygląda jak pusta lub jak komunikat o błędzie, na przykład kategoria bez produktów albo filtr z napisem „brak wyników”. Google wymienia usuwanie takich stron wśród metod oszczędzania budżetu. Dla pustych kategorii zalecenia dla sklepów są dwa: nie linkować do nich i nie dopuszczać ich do indeksu albo zwracać 404, jeśli kategoria znika po opróżnieniu. Szerzej piszemy o tym we wpisie Pozorny błąd 404.
Robots.txt, noindex czy adres kanoniczny: co naprawdę oszczędza pracę robota
Pracę robota oszczędza tylko to, co powstrzymuje go przed wysłaniem żądania, czyli blokada w robots.txt, właściwy kod błędu albo brak linków do zbędnego adresu. Znacznik noindex i adres kanoniczny porządkują indeks, ale strona nadal musi zostać pobrana, żeby robot mógł je odczytać.
| Narzędzie | Czy ogranicza skanowanie | Do czego się nadaje w sklepie |
|---|---|---|
| Reguła Disallow w robots.txt | Tak, robot nie pobiera adresu | Sortowanie, zbędne kombinacje filtrów, wyniki wyszukiwarki, kalendarze bez końca |
| Znacznik noindex | Nie, Google nadal wysyła żądanie | Pojedyncze strony, które mają być dostępne, ale niewidoczne w wynikach |
| Znacznik rel="canonical" | Z czasem ogranicza skanowanie wersji niekanonicznych | Warianty i duplikaty, których nie da się usunąć |
| Kod 404 lub 410 | Tak, robot stopniowo przestaje wracać | Produkty i kategorie usunięte na stałe, puste kombinacje filtrów |
Dwie rzeczy z dokumentacji o budżecie warto znać przy pliku robots.txt. Po pierwsze, blokada nie przenosi automatycznie zwolnionego budżetu na inne strony. Dzieje się tak tylko wtedy, gdy witryna dochodziła już do limitu wydajności serwera. Po drugie, blokada nie usuwa adresu z systemów Google. Z tego wynika częsta pomyłka: połączenie blokady w robots.txt ze znacznikiem noindex na tej samej stronie. Robot, któremu zabroniono pobrać stronę, nie zobaczy znacznika.
Google ocenia też, że adres kanoniczny i nofollow są w dłuższej perspektywie mniej skuteczne niż blokada. Dlatego dla przestrzeni rosnących w tysiące adresów wybiera się robots.txt, a adres kanoniczny zostawia dla pojedynczych duplikatów, takich jak produkt przypisany do kilku kategorii.
Mapa witryny i wydajność serwera: jak pomóc robotowi dotrzeć do nowości
Robot szybciej dociera do nowych i zmienionych produktów, gdy dostaje aktualną listę adresów i gdy serwer odpowiada szybko oraz bez błędów. Pierwsze zapewnia mapa witryny, drugie zależy od hostingu i konfiguracji sklepu.
W mapie witryny powinny znajdować się wyłącznie adresy kanoniczne, które mają być widoczne w wynikach. Dokumentacja Przygotowywanie i przesyłanie mapy witryny podaje, że jeden plik mieści najwyżej 50 000 adresów i 50 MB po rozpakowaniu, a większe zbiory dzieli się na kilka plików zebranych w indeksie map. Google korzysta z pola lastmod, jeśli jest spójne i zgodne z rzeczywistością, natomiast pola priority i changefreq pomija. Data w lastmod powinna się więc zmieniać przy istotnej zmianie treści, a nie przy każdym przeliczeniu stanów magazynowych.
Po stronie serwera dokumentacja o budżecie wskazuje krótszy czas odpowiedzi oraz obsługę kodu 304, którym serwer informuje, że strona nie zmieniła się od ostatniej wizyty. Wolne odpowiedzi, błędy 5xx i kod 429 obniżają limit wydajności, a po powrocie do poprawnych odpowiedzi Google zwiększa tempo stopniowo. Gdy robot rzeczywiście przeciąża serwer, pomoc Search Console dopuszcza awaryjne zwracanie kodu 503 lub 429, ale nie dłużej niż przez dwa, trzy dni. O tym kodzie piszemy we wpisie Kod 503: jak zamknąć stronę na czas prac.
Kolejność prac i pomyłki, które kosztują najwięcej
Prace warto prowadzić od pomiaru, przez decyzję o tym, które typy adresów mają być w Google, do blokad i porządków, a na końcu wrócić do pomiaru. Odwrócenie tej kolejności, czyli blokowanie przed ustaleniem, co przynosi ruch, jest najdroższym błędem.
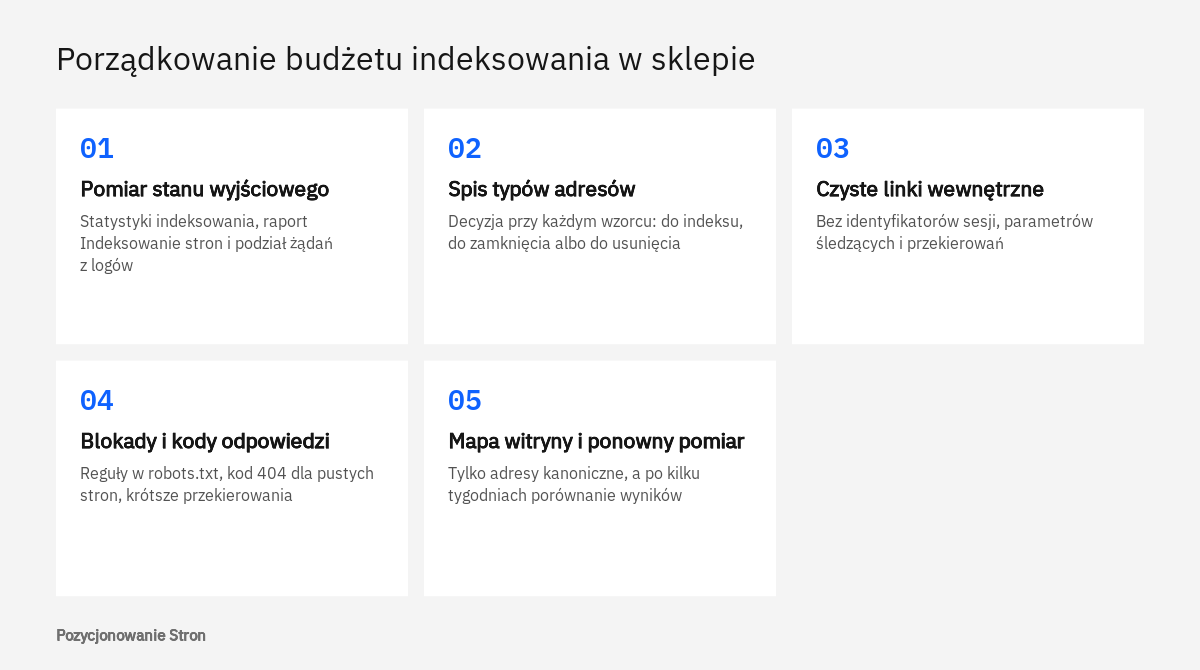
Przed wdrożeniem reguł w robots.txt należy sprawdzić w raporcie Skuteczność w Search Console, czy adresy z danym parametrem nie zbierają kliknięć. Zdarza się, że filtr marki od dawna pełni rolę strony docelowej i jego zamknięcie odebrałoby sklepowi ruch. Taki filtr lepiej zamienić na podkategorię z własnym adresem i opisem. Druga częsta pomyłka to zbyt szeroki wzorzec: reguła napisana dla parametru „sort” potrafi objąć także inne adresy zawierające ten ciąg znaków. Trzecia to oczekiwanie natychmiastowej zmiany. Pomoc Search Console podaje, że tempo skanowania stabilizuje się zwykle w ciągu jednego, dwóch tygodni.
- Nowe karty produktów są odwiedzane przez Googlebota w ciągu kilku dni od publikacji.
- Wśród adresów wykrytych i niezindeksowanych nie ma produktów ani głównych kategorii.
- Linki w menu, okruszkach i modułach produktowych prowadzą do adresów bez parametrów i bez przekierowań.
- Sortowanie, wyniki wyszukiwarki i koszyk są zamknięte w robots.txt.
- Kombinacje filtrów bez produktów oraz nieistniejące numery stron zwracają kod 404.
- Mapa witryny zawiera tylko adresy kanoniczne, a pole lastmod odpowiada rzeczywistym zmianom.
Pomoc z zewnątrz jest potrzebna zwykle wtedy, gdy sklep działa na własnym silniku lub ma kilka wersji językowych albo gdy zmiana dotyczy szablonu, którego nie da się poprawić z panelu. W takich przypadkach zaczynamy od audytu SEO z analizą logów, a wdrożenie prowadzimy w ramach SEO technicznego lub szerszego pozycjonowania sklepów. Porządek w adresach nie daje gwarancji pozycji, ale usuwa przeszkodę na drodze do wyszukiwarki.
Jeśli chcą Państwo zamówić SEO techniczne, zachęcamy do kontaktu: tel. 222 500 844 lub mailowo: biuro@pozycjonowaniestron.pl
Najczęstsze pytania
Czy sklep z kilkoma tysiącami produktów musi się martwić budżetem indeksowania?
Zwykle nie, o ile nowe strony trafiają do Google szybko. Wyjątkiem jest sklep, w którym filtry i parametry tworzą wielokrotnie więcej adresów niż produktów.
Gdzie w Search Console widać, ile stron dziennie odwiedza Googlebot?
W Ustawieniach, w raporcie Statystyki indeksowania. Wykres łącznej liczby żądań pokazuje je dzień po dniu, przy czym liczone są wszystkie żądania, także do obrazów i skryptów.
Czy znacznik noindex na stronach filtrów zmniejsza obciążenie robotem?
Nie. Google odradza używanie noindex w tym celu, ponieważ robot i tak musi pobrać stronę, żeby odczytać znacznik. Do ograniczania skanowania służy plik robots.txt.
Czy po zablokowaniu filtrów Google zacznie częściej odwiedzać produkty?
Nie ma takiej pewności. Według dokumentacji zwolniony budżet przechodzi na inne strony tylko wtedy, gdy witryna dochodziła do limitu wydajności serwera. Blokada zawsze jednak odciąża serwer.
Ile przekierowań z rzędu toleruje Googlebot?
Domyślnie Googlebot śledzi do 10 przeskoków. Każdy przeskok to jednak dodatkowe żądanie, dlatego najlepiej, gdy stary adres prowadzi do docelowego jednym krokiem.
Czy da się poprosić Google o większy budżet indeksowania?
Dokumentacja wymienia dwie drogi: większe zasoby serwera, jeśli to on ogranicza skanowanie, oraz poprawę jakości i unikalności treści. Innej metody dokumentacja nie opisuje.
Źródła
- Zarządzanie budżetem indeksowania, Google for Developers
- Raport Statystyki indeksowania, Search Console - pomoc
- Raport Indeksowanie stron, Search Console - pomoc
- Zarządzanie indeksowaniem adresów URL nawigacji fasetowej, Google for Developers
- Sprawdzone metody tworzenia struktury adresów URL dla wyszukiwarki Google, Centrum wyszukiwarki Google
- Sprawdzone metody projektowania struktury adresów URL na potrzeby witryn e-commerce, Centrum wyszukiwarki Google
- Jak kody stanu HTTP wpływają na roboty Google, Google for Developers
- Weryfikowanie żądań od robotów i modułów pobierania Google, Google for Developers
- Przygotowywanie i przesyłanie mapy witryny, Centrum wyszukiwarki Google
Funkcje wyszukiwarek i asystentów AI zmieniają się szybko, dlatego wpis aktualizujemy po większych zmianach.