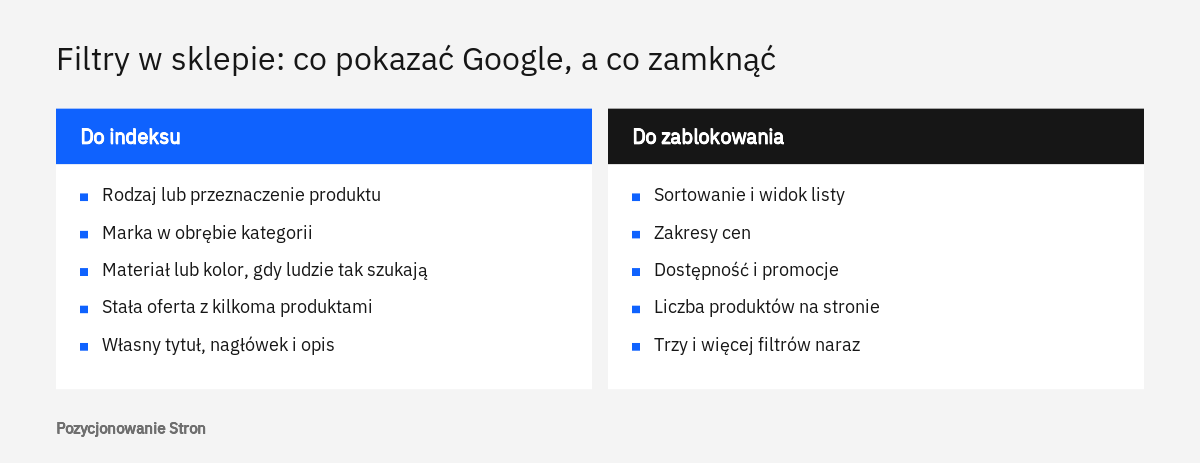
Google powinno widzieć tylko te kombinacje filtrów, które odpowiadają na zapytania wpisywane przez kupujących i mają własną, stałą ofertę, na przykład kategorię zawężoną do jednej marki albo jednego rodzaju produktu. Sortowanie, zakresy cen, dostępność i złożenia kilku filtrów naraz lepiej zamknąć przed robotem, bo tworzą tysiące adresów z tą samą treścią. Poniżej opisujemy, jak podzielić filtry na te dwie grupy i jakimi narzędziami to ustawić.
Czym jest nawigacja fasetowa i dlaczego sprawia kłopot w Google
Nawigacja fasetowa to zestaw filtrów na liście produktów, którymi kupujący zawęża ofertę: kolor, rozmiar, marka, cena, materiał. Kłopot polega na tym, że w większości sklepów każdy wybrany filtr zmienia adres strony, a filtry można łączyć dowolnie, więc z jednej kategorii powstają tysiące adresów.
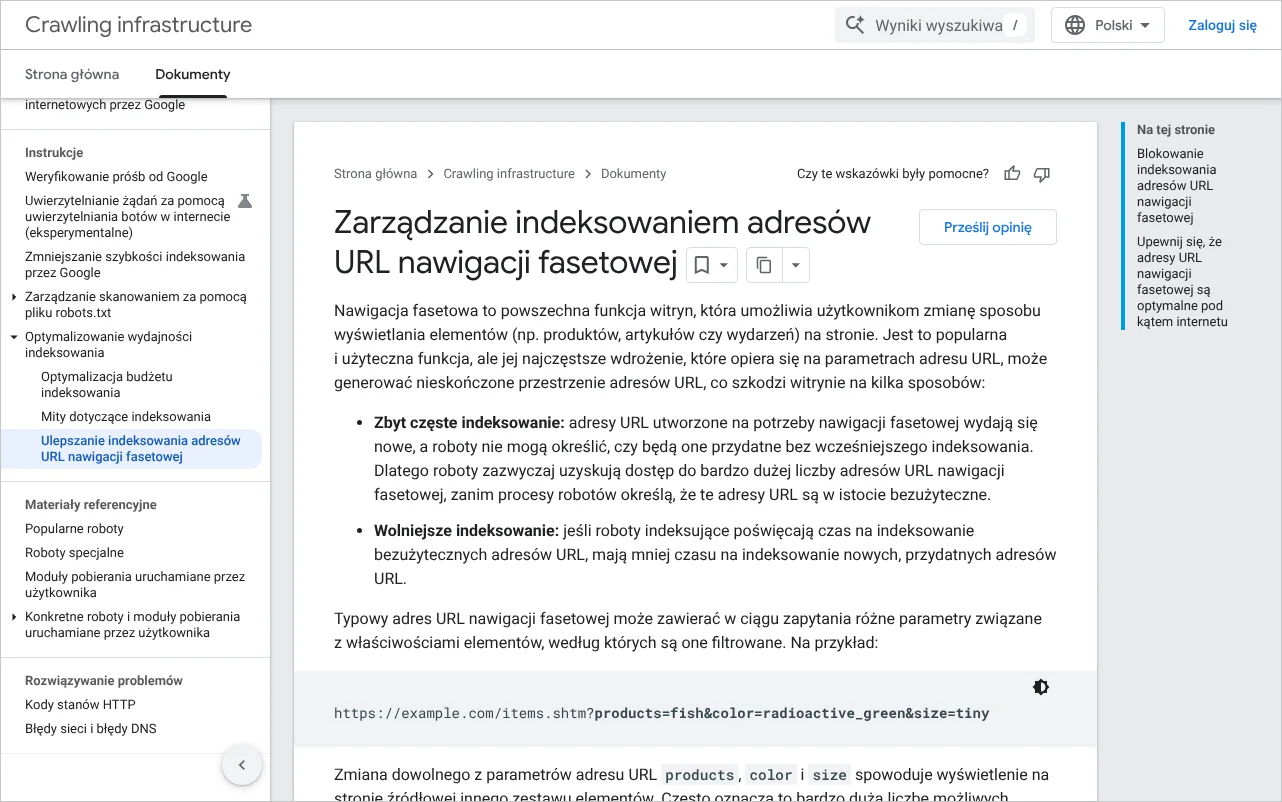
Google opisuje to zjawisko w osobnej stronie dokumentacji. Wskazuje tam, że filtry działają najczęściej na parametrach w adresie URL, a liczba możliwych kombinacji bywa ogromna. Dla człowieka to wygoda. Dla robota to długa lista adresów, które wyglądają na nowe strony, choć pokazują te same produkty w innym układzie.
Pojedyncza cecha, według której można zawęzić listę, na przykład kolor albo marka. Nawigacja fasetowa to wszystkie takie cechy razem, razem z możliwością ich łączenia.
Warto policzyć to na prostym przykładzie. Sklep z obuwiem z Poznania ma kategorię butów do biegania. Filtry obejmują dwanaście marek, dziesięć kolorów, piętnaście rozmiarów i cztery rodzaje nawierzchni. Już same pojedyncze filtry to kilkadziesiąt adresów. Gdy doliczyć pary i trójki filtrów, sortowanie po cenie i kolejne strony listy, z jednej kategorii robi się kilkadziesiąt tysięcy adresów. Sklep ma takich kategorii sto.
Dwa skutki, które Google wymienia wprost
Pierwszy skutek to nadmierne skanowanie. Według dokumentacji robot nie potrafi z góry ocenić, czy adres z filtrem jest wartościowy, więc odwiedza bardzo wiele takich adresów, zanim uzna je za zbędne. Każda taka wizyta obciąża serwer sklepu.
Drugi skutek to wolniejsze wykrywanie nowych treści. Czas, który robot poświęcił na bezużyteczne kombinacje, nie zostanie przeznaczony na nowe produkty i nowe kategorie. W dużym sklepie oznacza to, że świeżo dopisany asortyment czeka na pojawienie się w wynikach dłużej, niż mógłby. Szerzej piszemy o tym we wpisie o tym, czym jest budżet indeksowania i których serwisów dotyczy.
Do tego dochodzi trzeci kłopot, znany z codziennej pracy przy sklepach: powielona treść. Lista butów w kolorze czarnym posortowana rosnąco i ta sama lista posortowana malejąco to dla wyszukiwarki dwie niemal identyczne strony. Jak sobie z tym radzić w całym serwisie, opisujemy osobno we wpisie o duplikacji treści.
Co Google zaleca w sprawie adresów z filtrami
Google przedstawia dwie drogi i każe wybrać jedną dla danego filtra. Jeśli adresy z filtrem nie są potrzebne w wynikach wyszukiwania, należy zablokować ich skanowanie. Jeśli mają być w wynikach, trzeba zadbać, żeby były zbudowane porządnie i nie mnożyły się bez końca. Całość opisuje strona Zarządzanie indeksowaniem adresów URL nawigacji fasetowej.
Gdy filtr nie jest potrzebny w wynikach
Podstawowym sposobem jest plik robots.txt. Dokumentacja pokazuje przykład, w którym reguły zamykają przed robotem adresy z parametrami filtrów, a zostawiają otwartą listę bez zawężeń. Zwykle nie ma powodu, żeby robot skanował przefiltrowane listy, skoro każdy produkt ma własną kartę, a kategoria ma własną stronę.
Drugi sposób to zapisanie filtrów we fragmencie adresu, czyli po znaku krzyżyka. Google co do zasady nie bierze fragmentów pod uwagę przy skanowaniu i indeksowaniu, więc filtr zapisany w ten sposób nie tworzy dla robota nowej strony. Wymaga to jednak takiej budowy sklepu, w której lista odświeża się w przeglądarce bez zmiany adresu przed krzyżykiem.
Dokumentacja wymienia jeszcze adres kanoniczny i atrybut nofollow w linkach do filtrów. Zaznacza przy tym, że te dwie metody są na dłuższą metę mniej skuteczne niż robots.txt i fragmenty. Atrybut nofollow działa zresztą tylko wtedy, gdy ma go każdy link prowadzący do danego adresu, co w dużym sklepie trudno utrzymać.
Gdy filtr ma być widoczny w wyszukiwarce
Dla adresów, które mają trafić do indeksu, Google podaje krótką listę wymagań. Parametry należy rozdzielać standardowym znakiem &, bo przecinki, średniki i nawiasy kwadratowe nie są rozpoznawane jako separatory. Jeśli filtry są zapisane w ścieżce adresu, ich kolejność ma być zawsze taka sama, a ten sam filtr nie może występować dwa razy. Kombinacja bez wyników powinna zwracać kod 404, podobnie jak zdublowane filtry, zestawienia bez sensu i nieistniejące numery stron listy.
Google przypomina też, że skanowanie adresów fasetowych kosztuje serwer dużo zasobów. To zdanie warto mieć w pamięci przy każdej decyzji o otwarciu kolejnej grupy filtrów.
Które kombinacje filtrów zasługują na indeksowaną stronę
Na własną stronę w indeksie zasługuje taka kombinacja, której ludzie faktycznie szukają i dla której sklep ma stałą, sensowną ofertę. W praktyce są to najczęściej pojedyncze filtry opisujące rodzaj, markę, materiał lub przeznaczenie produktu, rzadziej pary takich filtrów. To już nasza ocena z pracy przy sklepach, a nie zapis z dokumentacji: Google mówi, jak zbudować adresy, natomiast wybór filtrów zostawia właścicielowi serwisu.
Pomocne są trzy pytania. Czy ktoś wpisuje taką frazę w wyszukiwarkę? Podpowiada to raport Skuteczność w Search Console, w którym widać zapytania prowadzące dziś do kategorii. Czy pod tym filtrem stale jest przynajmniej kilka produktów? Lista z jednym produktem niczego nie daje ponad jego kartę. Czy strona po zawężeniu różni się od kategorii czymś więcej niż liczbą pozycji, to znaczy czy da się jej nadać własny tytuł, nagłówek i krótki opis?
Sklep meblowy z Łodzi ma kategorię sof. Fraza o sofach narożnych z funkcją spania jest wpisywana często i odpowiada jej kilkadziesiąt modeli, więc taka kombinacja powinna być osobną stroną. Fraza o sofach w cenie od tysiąca do tysiąca dwustu złotych, szerokości do dwóch metrów, dostępnych w ciągu doby nie jest wpisywana przez nikogo, a zestaw produktów zmienia się z dnia na dzień. Taki adres do indeksu nie pasuje.
Filtr wart indeksu powinien wyglądać jak podkategoria
Jeżeli filtr odpowiada na realne zapytanie, najlepiej potraktować go jak zwykłą podkategorię. Oznacza to czytelny adres, własny tytuł strony i nagłówek z nazwą filtra, adres kanoniczny wskazujący na samą siebie, obecność w mapie witryny oraz zwykłe linki prowadzące do tej strony z menu, z kategorii nadrzędnej albo z opisów. Dokumentacja o adresach w sklepach zaleca używanie tego samego adresu w linkach wewnętrznych, w mapie witryny i w znaczniku kanonicznym, a linki mają być zwykłymi znacznikami z atrybutem href, bo nawigacji opartej wyłącznie na skryptach robot może nie wykryć.
O tym, co powinno się znaleźć na takiej stronie, piszemy we wpisie o budowie stron kategorii w sklepie. Samo wybieranie fraz dla kategorii i filtrów omawiamy przy okazji tematu, jakim jest dobór fraz dla sklepu internetowego. Filtry są zresztą naturalnym źródłem dłuższych, szczegółowych zapytań, na których opiera się pozycjonowanie long tail.
Które filtry i kombinacje lepiej zablokować
Zablokować warto wszystko, co zmienia jedynie kolejność lub wycinek tej samej listy, oraz wszystko, co powstaje z łączenia wielu filtrów naraz. Chodzi przede wszystkim o sortowanie, zakresy cen, dostępność w magazynie, liczbę produktów na stronie, widok listy lub kafelków oraz złożenia trzech i więcej cech.
Dokumentacja o podziale list na strony podaje przykład parametru sortowania po cenie i radzi, by odmian tej samej listy nie wpuszczać do indeksu: można użyć reguły noindex albo zamknąć wzorce adresów w pliku robots.txt. Z kolei strona o budżecie indeksowania zalicza różnie uporządkowane wersje tej samej strony do adresów o niskiej wartości.
| Rodzaj filtra | Przykład | Co zwykle robimy | Dlaczego |
|---|---|---|---|
| Rodzaj lub przeznaczenie | sofy narożne, buty na asfalt | Strona w indeksie | Ludzie wpisują takie frazy, oferta jest stała |
| Marka w kategorii | buty do biegania jednej marki | Strona w indeksie | Zapytania z nazwą marki są częste |
| Kolor lub materiał | sofy welurowe, sofy szare | Do oceny dla każdej kategorii | W jednych branżach to częsta fraza, w innych nikt tak nie szuka |
| Rozmiar | rozmiar 42 | Najczęściej blokada | Lista zmienia się wraz ze stanem magazynu |
| Zakres cen | od 200 do 300 zł | Blokada | Liczba możliwych zakresów jest nieograniczona |
| Sortowanie i widok | od najtańszych, po 48 na stronie | Blokada | Ta sama treść w innej kolejności |
| Dostępność, promocja | tylko dostępne, tylko przecenione | Blokada | Zestaw produktów zmienia się codziennie |
| Trzy i więcej filtrów naraz | marka, kolor, rozmiar, cena | Blokada | Liczba kombinacji rośnie lawinowo, a zapytań brak |
Kolumna trzecia to praktyka agencji, a nie reguła Google, i w każdym sklepie wymaga sprawdzenia na danych. Sklep z farbami może mieć bardzo popularne frazy z kolorem, a sklep z częściami samochodowymi zupełnie ich nie potrzebuje. W sklepie z odzieżą rozmiar bywa z kolei cechą wariantu produktu, a nie filtrem listy, co rozbieramy we wpisie o tym, jak mają się warianty produktu do SEO.
Robots.txt, noindex i adres kanoniczny: czym się różnią przy filtrach
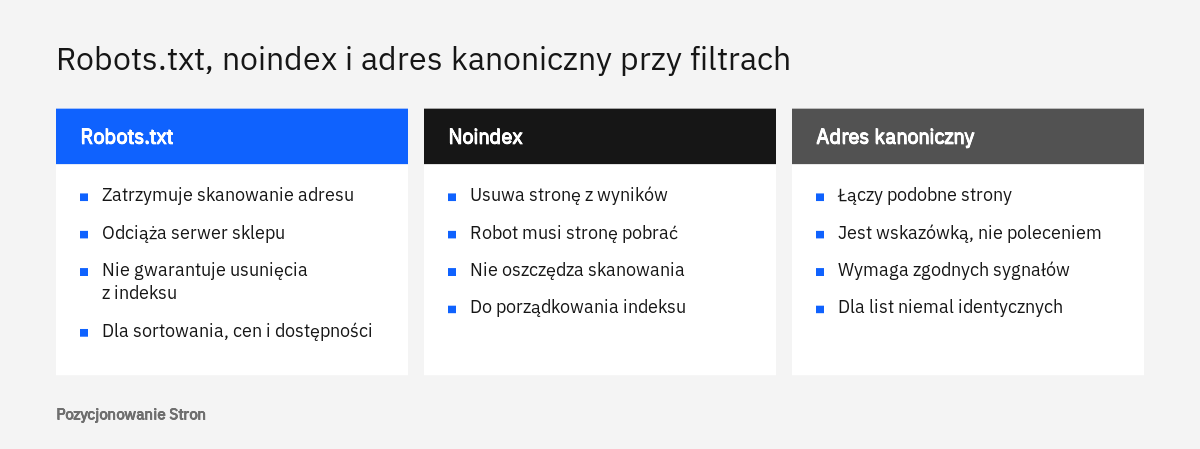
Plik robots.txt decyduje o tym, czy robot w ogóle pobierze adres. Reguła noindex decyduje o tym, czy pobrana strona trafi do wyników. Adres kanoniczny mówi, którą z podobnych stron Google ma traktować jako główną. Każde z tych narzędzi rozwiązuje inny problem i właśnie pomylenie ich ról jest najczęstszym źródłem kłopotów z filtrami.
Plik robots.txt: oszczędza pracę robota
Robots.txt to plik tekstowy w katalogu głównym domeny, w którym zapisuje się, jakich adresów roboty nie powinny pobierać. Przy filtrach jest to narzędzie pierwszego wyboru, bo jako jedyne faktycznie zatrzymuje skanowanie. W regułach można używać dwóch symboli: gwiazdka oznacza dowolny ciąg znaków, a znak dolara oznacza koniec adresu. Wielkość liter w ścieżce ma znaczenie, a gdy dwie reguły są sprzeczne, Google stosuje tę z dłuższą ścieżką.
User-agent: *
Disallow: /*?*sortuj=
Disallow: /*?*cena_od=
Disallow: /*?*cena_do=
Disallow: /*?*dostepnosc=
Disallow: /*?*rozmiar=
Disallow: /*?*na_stronie=
Zapis z dwiema gwiazdkami pochodzi z przykładu Google i obejmuje parametr niezależnie od tego, czy stoi w adresie jako pierwszy, czy po innych. Trzeba przy tym znać ograniczenie tego pliku. Zablokowany adres może mimo wszystko trafić do indeksu, jeśli prowadzą do niego linki, tyle że bez treści.
Reguła noindex: usuwa z wyników, ale nie oszczędza skanowania
Noindex to instrukcja w kodzie strony albo w nagłówku odpowiedzi serwera, po której odczytaniu Google usuwa stronę z wyników wyszukiwania.
<meta name="robots" content="noindex">Dwie rzeczy mają tu znaczenie. Po pierwsze, robot musi stronę pobrać, żeby regułę zobaczyć. Jeżeli ten sam adres jest zamknięty w robots.txt, noindex nigdy nie zostanie odczytany i strona może pozostać w wynikach. Po drugie, według Google noindex nie służy do oszczędzania budżetu indeksowania: robot i tak wysyła żądanie, a dopiero potem pomija stronę. Noindex nadaje się zatem do sprzątania indeksu, a nie do ograniczania ruchu robota.
Adres kanoniczny: łączy podobne strony
Adres kanoniczny to wskazanie w kodzie, która wersja podobnych stron jest tą właściwą. Google traktuje znacznik rel="canonical" jako wyraźny sygnał, słabszy od przekierowania i mocniejszy od wpisu w mapie witryny. Przy filtrach stosuje się go tam, gdzie przefiltrowana lista jest niemal kopią innej strony, na przykład gdy dodatkowy parametr zmienia tylko układ.
<!-- adres: /sofy/?typ=narozne&sortuj=cena -->
<link rel="canonical" href="https://example.com/sofy/?typ=narozne" />
Dokumentacja o adresach kanonicznych zawiera kilka przestróg, które wprost dotyczą filtrów. Nie należy używać pliku robots.txt ani reguły noindex do wskazywania wersji kanonicznej. Adres w znaczniku powinien być bezwzględny, czyli pełny, z protokołem i domeną. Sygnały muszą być zgodne: ten sam adres w znaczniku, w mapie witryny i w linkach wewnętrznych.
Jeśli chcą Państwo zamówić SEO techniczne, zachęcamy do kontaktu: tel. 222 500 844 lub mailowo: biuro@pozycjonowaniestron.pl
Jak zbudować adresy filtrów, żeby dało się nimi zarządzać
Adresy filtrów powinny być zbudowane według jednego, przewidywalnego wzoru: pary klucz i wartość, rozdzielone znakiem &, zawsze w tej samej kolejności. Dopiero wtedy da się napisać krótkie reguły robots.txt i jednoznacznie ustawić adresy kanoniczne.
Zalecenia Google dla sklepów zbiera strona o projektowaniu struktury adresów URL w witrynach e-commerce. Wynika z niej kilka konkretnych reguł. Parametr powinien mieć nazwę, a nie samą wartość. Tego samego parametru nie należy powtarzać w jednym adresie, bo robot może zignorować jedną z wartości; kilka wartości lepiej zapisać po przecinku w jednym parametrze.
Poprawnie:
/sofy/?typ=narozne
/sofy/?typ=narozne&material=welur
/sofy/?kolor=szary,bezowy

Do poprawy:
/sofy/?narozne                      (wartość bez nazwy parametru)
/sofy/?kolor=szary&kolor=bezowy     (powtórzony parametr)
/sofy/?material=welur&typ=narozne   (ta sama lista pod drugim adresem)
/sofy/?typ=narozne;material=welur   (średnik zamiast znaku &)
/sofy/?typ=narozne&sesja=83a1f      (identyfikator sesji w adresie)
Stała kolejność filtrów
Jeśli klient kliknie najpierw materiał, a potem typ, sklep nie powinien tworzyć innego adresu niż wtedy, gdy kliknie w odwrotnej kolejności. Dla filtrów zapisanych w ścieżce Google wymaga tego wprost: stała kolejność logiczna i brak powtórzeń. Przy parametrach zapytania stosujemy tę samą zasadę z ostrożności, bo każda zamiana kolejności podwaja liczbę adresów z tą samą treścią.
Ścieżka czy parametry
Google dopuszcza oba zapisy. W praktyce wygodnie jest je rozdzielić według roli: filtry przeznaczone do indeksu dostają czytelny adres w ścieżce, podobny do podkategorii, a wszystko, co ma pozostać zamknięte, zostaje w parametrach. Wtedy jedna reguła w robots.txt zamyka całą grupę. To rozwiązanie wynikające z naszego doświadczenia, a nie wymóg wyszukiwarki. Ogólne zasady opisujemy we wpisie o tym, jak powinna wyglądać struktura adresów URL.
Gdzie sprawdzić, co Google robi z filtrami sklepu
Stan faktyczny widać w Google Search Console, w dwóch raportach: Indeksowanie stron pokazuje, które adresy trafiły do indeksu i dlaczego pozostałe nie, a Statystyki indeksowania pokazują, ile żądań robot wysyła i do jakich adresów. Oba raporty wymagają zalogowania, więc opisujemy je słowami.
Raport Indeksowanie stron
W głównym widoku raportu znajduje się tabela Dlaczego strony nie są indeksowane. Każdy wiersz to jedna przyczyna, a po kliknięciu wyświetla się lista przykładowych adresów. Przy filtrach najwięcej mówią statusy opisane w pomocy Search Console.
- URL zablokowany przez plik robots.txt - po wdrożeniu blokady tu powinny pojawiać się adresy z zamkniętymi parametrami. To wynik oczekiwany, a nie błąd.
- URL zawiera tag noindex - adresy, na których robot odczytał regułę. Jeśli jest tu filtr przeznaczony do indeksu, szablon nadaje regułę zbyt szeroko.
- Duplikat, użytkownik nie oznaczył strony kanonicznej - Google samo uznało przefiltrowane listy za kopie. To znak, że filtry są otwarte i nie mają żadnych wskazań.
- Duplikat, wyszukiwarka Google wybrała inną stronę kanoniczną niż użytkownik - Google nie zgodziło się ze znacznikiem kanonicznym.
- Strona wykryta - obecnie niezindeksowana - Google zna adres, ale jeszcze go nie pobrało. Duża liczba takich adresów z parametrami pokazuje skalę kombinacji, o których robot już wie.
- Zindeksowana, ale zablokowana przez plik robots.txt - adres jest w indeksie mimo blokady, bo prowadzą do niego linki.
Listę przykładowych adresów z każdego statusu można wyeksportować i przefiltrować w arkuszu po znaku zapytania. W ten sposób w kilka minut widać, które parametry dominują.
Raport Statystyki indeksowania
Raport otwiera się z pozycji Ustawienia w menu, a następnie Statystyki indeksowania. Pokazuje łączną liczbę żądań robota indeksującego, całkowity rozmiar pobierania i średni czas odpowiedzi, a także podział żądań według odpowiedzi serwera, typu pliku, celu (wykrycie lub odświeżenie) i typu Googlebota. Po kliknięciu wiersza w tabeli pojawiają się przykładowe adresy. Jeżeli większość przykładów to adresy z parametrami filtrów, robot poświęca sklepowi czas w niewłaściwym miejscu. Lista przykładów nie jest pełna, więc dokładny obraz dają dopiero dzienniki serwera, które udostępnia firma hostingowa.
Pojedynczy adres można zbadać narzędziem do sprawdzania adresów URL, czyli polem wyszukiwania na górze ekranu Search Console. Pokazuje ono między innymi kod pobrany przez robota, co pozwala potwierdzić, czy reguła noindex jest dla niego widoczna. Poprawność samego pliku robots.txt sprawdza raport dotyczący tego pliku, który działa wyłącznie dla pliku już opublikowanego w serwisie.
W jakiej kolejności porządkować filtry i jakich pomyłek unikać
Prace należy zacząć od spisu filtrów i danych z Search Console, potem podjąć decyzję dla każdej grupy, a dopiero na końcu zmieniać robots.txt. Odwrotna kolejność, czyli szybka blokada wszystkiego ze znakiem zapytania, często zamyka przy okazji strony, które przynosiły ruch.
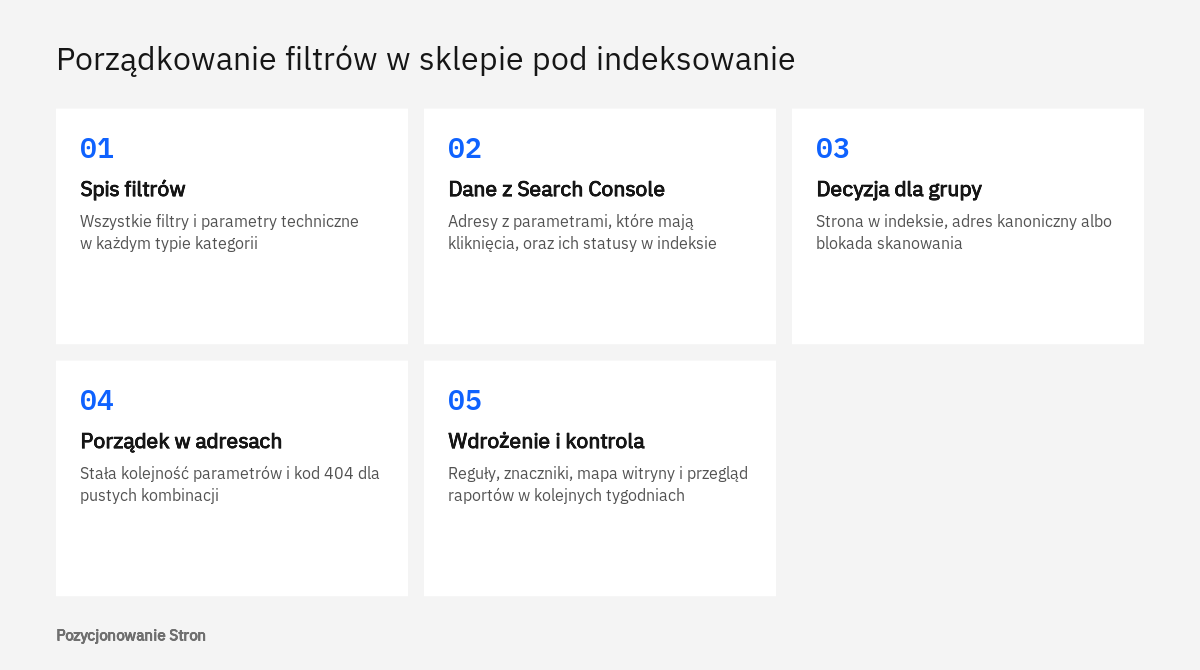
- Spis filtrów i parametrów
Lista wszystkich filtrów w każdym typie kategorii oraz parametrów technicznych: sortowanie, liczba pozycji, widok, numer strony.
- Dane o ruchu i indeksie
Z raportu Skuteczność należy wyciągnąć adresy z parametrami, które mają kliknięcia. Z raportu Indeksowanie stron - skalę adresów z filtrami w poszczególnych statusach.
- Decyzja dla każdej grupy
Strona w indeksie, adres kanoniczny do innej strony albo blokada skanowania. Jedno narzędzie na grupę.
- Uporządkowanie adresów
Stała kolejność parametrów, znak & jako separator, kod 404 dla pustych i bezsensownych kombinacji.
- Wdrożenie i obserwacja
Reguły robots.txt, znaczniki, mapa witryny z filtrami dopuszczonymi do indeksu, a potem kontrola raportów przez kolejne tygodnie.
Gdy niepotrzebne filtry są już w indeksie
Jeśli w wynikach Google znajdują się już tysiące przefiltrowanych list, kolejność ma znaczenie. Zamknięcie ich od razu w robots.txt zatrzyma skanowanie, ale adresy mogą pozostać w indeksie, bo robot nie odczyta już żadnej instrukcji. Bezpieczniej jest najpierw umieścić na nich regułę noindex lub znacznik kanoniczny, poczekać, aż raport Indeksowanie stron pokaże ich wypadnięcie, i dopiero wtedy dodać blokadę skanowania. Jak długo to potrwa, zależy od tego, jak często Google wraca do danych adresów, więc nie podajemy tu terminu.
Typowe pomyłki
Najczęstsza pomyłka to kanoniczny adres każdej przefiltrowanej listy ustawiony na kategorię główną, także dla filtrów, które miały zdobywać ruch. Strona sof narożnych nie pojawi się wówczas w wynikach, bo sama wskazuje, że jest kopią strony wszystkich sof. Podobny błąd dotyczy kolejnych stron listy: Google zaleca, aby pierwsza strona nie była kanoniczną dla następnych, tylko każda miała własny adres kanoniczny.
Druga pomyłka to puste kombinacje, które odpowiadają kodem 200 i komunikatem o braku produktów. Dla robota to tysiące stron bez treści. O tym, kiedy kod błędu jest właściwą odpowiedzią, piszemy we wpisie o błędzie 404 i widoczności w Google. Trzecia to linki w treści i w menu prowadzące do adresów z parametrami, choć istnieje czysty adres tej samej listy. Czwarta to blokada zasobów potrzebnych do wyświetlenia strony przy okazji zamykania parametrów, na przykład zbyt szeroka reguła obejmująca pliki skryptów z parametrem wersji.
- Każdy filtr ma przypisaną jedną decyzję: indeks, adres kanoniczny albo blokada.
- Filtry dopuszczone do indeksu mają własny tytuł, nagłówek, adres kanoniczny do siebie i miejsce w mapie witryny.
- Parametry stoją w adresie zawsze w tej samej kolejności i są rozdzielone znakiem &.
- Puste i nielogiczne kombinacje zwracają kod 404 pod własnym adresem.
- Żaden adres nie jest jednocześnie zamknięty w robots.txt i oznaczony regułą noindex.
- Linki wewnętrzne prowadzą do adresów kanonicznych, bez identyfikatorów sesji i kodów śledzenia.
- Po wdrożeniu raporty Indeksowanie stron i Statystyki indeksowania są przeglądane regularnie.
W małym sklepie z kilkoma filtrami większość tych ustawień da się wprowadzić w module filtrowania i w pliku robots.txt bez pomocy z zewnątrz. Pomoc przydaje się wtedy, gdy sklep ma tysiące produktów, filtry są już masowo w indeksie, a zmiana wymaga pracy programisty i analizy dzienników serwera. Taką pracę zwykle poprzedza audyt SEO, a same zmiany wchodzą w zakres usługi, jaką jest SEO techniczne, i stanowią stały element prac, które obejmuje pozycjonowanie sklepów.
Jeśli chcą Państwo zamówić SEO techniczne, zachęcamy do kontaktu: tel. 222 500 844 lub mailowo: biuro@pozycjonowaniestron.pl
Najczęstsze pytania
Czy wszystkie filtry w sklepie trzeba zablokować przed Google?
Nie. Filtry, które odpowiadają na częste zapytania i mają stałą ofertę, mogą być wartościowymi stronami w wynikach. Blokować warto te, które zmieniają tylko kolejność lub wycinek listy, oraz złożenia wielu filtrów naraz.
Co jest lepsze dla filtrów: robots.txt czy noindex?
To zależy od celu. Robots.txt zatrzymuje skanowanie i odciąża serwer, ale nie gwarantuje usunięcia adresu z indeksu. Noindex usuwa stronę z wyników, lecz robot nadal musi ją pobrać, więc według Google nie oszczędza budżetu indeksowania.
Czy można ustawić noindex i blokadę w robots.txt jednocześnie?
Nie ma to sensu. Robot, któremu zabroniono pobrania strony, nie odczyta reguły noindex, więc strona może pozostać w wynikach. Dla danego adresu należy wybrać jedno z tych rozwiązań.
Czy adres kanoniczny wystarczy, żeby Google nie skanowało filtrów?
Nie w pełni. Google podaje, że znacznik kanoniczny może z czasem ograniczyć skanowanie wersji niekanonicznych, ale jest na dłuższą metę mniej skuteczny niż robots.txt. Robot musi też pobrać stronę, żeby znacznik odczytać.
Co powinna zwracać kombinacja filtrów, która nie ma żadnych produktów?
Według zaleceń Google dla adresów fasetowych taka kombinacja powinna zwracać kod 404 pod własnym adresem, bez przekierowania na inną stronę. Dotyczy to także zdublowanych filtrów i nieistniejących numerów stron listy.
Czy sortowanie po cenie powinno być indeksowane?
Nie. Posortowana lista to ta sama treść w innej kolejności. Google radzi, by takich odmian nie wpuszczać do indeksu, za pomocą reguły noindex albo blokady wzorca adresu w pliku robots.txt.
Czy problem filtrów dotyczy małego sklepu?
W mniejszym stopniu. Google kieruje wskazówki o budżecie indeksowania głównie do dużych serwisów oraz do takich, w których wiele adresów ma status Strona wykryta - obecnie niezindeksowana. Mały sklep powinien jednak zadbać o porządek w adresach i unikać powielonych list, bo sklep rośnie, a filtrów przybywa.
Źródła
- Zarządzanie indeksowaniem adresów URL nawigacji fasetowej, Google for Developers
- Sprawdzone metody projektowania struktury adresów URL na potrzeby witryn e-commerce, Centrum wyszukiwarki Google
- Blokowanie indeksowania przez wyszukiwarki za pomocą tagu noindex, Centrum wyszukiwarki Google
- Jak określić kanoniczny URL za pomocą rel="canonical" i innych metod, Centrum wyszukiwarki Google
- Jak Google interpretuje specyfikację pliku robots.txt, Google for Developers
- Zarządzanie budżetem indeksowania, Google for Developers
- Sprawdzone metody dotyczące podziału na strony, Centrum wyszukiwarki Google
- Raport Indeksowanie stron, Pomoc Search Console
- Raport Statystyki indeksowania, Pomoc Search Console
Funkcje wyszukiwarek i asystentów AI zmieniają się szybko, dlatego wpis aktualizujemy po większych zmianach.