Status „Strona wykryta - obecnie niezindeksowana” oznacza, że Google zna adres podstrony, ale jeszcze jej nie odwiedził i odłożył wizytę na później. Poniżej wyjaśniamy, skąd bierze się to odroczenie, jak odróżnić zwykłe oczekiwanie w kolejce od sygnału kłopotów z serwerem lub budową serwisu oraz które działania rzeczywiście skracają czas oczekiwania.
Co oznacza status „Strona wykryta - obecnie niezindeksowana”
Ten status informuje, że Google dowiedział się o istnieniu adresu, lecz jeszcze nie pobrał znajdującej się pod nim strony. Pomoc Search Console w opisie raportu Indeksowanie stron wyjaśnia to krótko: strona została znaleziona, ale nie została jeszcze odwiedzona, a zwykle dzieje się tak dlatego, że wizyta mogłaby przeciążyć witrynę, więc została zaplanowana na późniejszy termin.
Aby dobrze odczytać ten komunikat, warto przypomnieć, jak strona trafia do wyników. Według dokumentu Jak działa wyszukiwarka Google całość składa się z trzech etapów. Najpierw robot odkrywa adresy i pobiera strony, czyli je skanuje. Potem analizuje ich treść i decyduje, czy umieścić je w indeksie. Na końcu, po wpisaniu zapytania przez użytkownika, wybiera z indeksu pasujące wyniki. Status „wykryta” dotyczy samego początku tej drogi: adres jest już na liście do odwiedzenia, ale wizyta jeszcze się nie odbyła.
Pobieranie strony przez robota wyszukiwarki, u Google nazywanego Googlebotem. W polskich materiałach Google ten sam etap bywa nazywany indeksowaniem, dlatego raport o wizytach robota nosi nazwę „Statystyki indeksowania”.
Z tego wynika rzecz najważniejsza dla dalszej diagnozy. Skoro robot nie pobrał strony, to Google nie zna jej treści i nie mógł jej ocenić. Odroczenie nie jest więc werdyktem na temat konkretnej podstrony, lecz decyzją o kolejności. Ta sama dokumentacja zaznacza, że Google nie gwarantuje skanowania ani indeksowania żadnej strony, a roboty same ustalają, które witryny odwiedzają, jak często i ile stron pobierają.
Gdzie sprawdzić ten status w Search Console
Listę adresów ze statusem „wykryta” pokazuje raport „Indeksowanie stron” w Google Search Console, a szczegóły pojedynczego adresu - narzędzie do sprawdzania adresów URL. Oba miejsca wymagają zalogowania się na konto, na którym witryna została dodana i potwierdzona jako usługa.
Raport „Indeksowanie stron”
Po zalogowaniu w menu po lewej stronie, w części poświęconej indeksowaniu, znajduje się pozycja „Strony”. Otwiera ona raport z wykresem stron zindeksowanych i niezindeksowanych. Pod wykresem widoczna jest tabela „Dlaczego strony nie są indeksowane”. Każdy jej wiersz to jedna przyczyna. Kolumna „Przyczyna” zawiera nazwę statusu, kolumna „Źródło” informuje, czy problem leży po stronie witryny, czy po stronie Google, a kolumna „Weryfikacja” pokazuje, czy właściciel zgłosił poprawkę do sprawdzenia.
Kliknięcie wiersza „Strona wykryta - obecnie niezindeksowana” otwiera widok szczegółowy z wykresem liczby takich adresów w czasie oraz z listą przykładów. Pomoc Search Console podaje, że lista obejmuje najwyżej 1000 wierszy, więc w dużym serwisie nie pokaże wszystkiego. Dlatego ważniejszy od samej listy jest kształt wykresu: linia, która rośnie tydzień po tygodniu, mówi coś innego niż linia stabilna albo opadająca.
Nad wykresem znajduje się filtr. Domyślnie ustawione są „Wszystkie znane strony”, ale do wyboru są także „Wszystkie przesłane strony”, „Tylko strony nieprzesłane” oraz konkretna mapa witryny. Jeśli po przełączeniu na przesłane strony liczba adresów „wykrytych” spada prawie do zera, w kolejce stoją głównie adresy, których właściciel sam nie zgłaszał: filtry, sortowania, wyniki wewnętrznej wyszukiwarki. Jeśli natomiast czekają adresy z mapy witryny, czyli te, na których firmie zależy, sprawa wymaga uwagi.
Narzędzie do sprawdzania adresów URL
Pojedynczy adres można zbadać, wpisując go w pasek wyszukiwania u góry ekranu Search Console. Zgodnie z opisem narzędzia do sprawdzania adresów URL strona, której nie ma w indeksie, otrzymuje komunikat „Adres URL nie znajduje się w Google”, a przyczynę podaje sekcja dotycząca indeksowania strony. W szczegółach widoczne są między innymi pola „Mapy witryn” i „Strona odsyłająca”, które mówią, skąd Google zna adres, oraz pole „Ostatnie skanowanie”. Przy statusie „wykryta” daty ostatniego skanowania zwykle nie ma, bo wizyta jeszcze się nie odbyła.
Jeżeli adres nie występuje w żadnej mapie witryny i nie ma strony odsyłającej z własnego serwisu, robot nie dostaje żadnej wskazówki, że podstrona jest ważna. Szerzej opisujemy to narzędzie we wpisie o sprawdzaniu adresu URL w Search Console.
Czym status „wykryta” różni się od statusu „zeskanowana”
Różnica polega na tym, czy robot był już na stronie. Przy statusie „Strona wykryta - obecnie niezindeksowana” wizyty jeszcze nie było. Przy statusie „Strona zeskanowana, ale jeszcze niezindeksowana” robot pobrał stronę, poznał jej treść, a mimo to nie umieścił jej w indeksie.
To rozróżnienie decyduje o kierunku pracy. W pierwszym przypadku pytanie brzmi: dlaczego Google nie przyszedł. Odpowiedzi szuka się w wydajności serwera, w liczbie adresów, w linkowaniu i w ogólnym obrazie serwisu. W drugim przypadku pytanie brzmi: dlaczego Google przyszedł i nie skorzystał. Wtedy bada się samą podstronę, jej treść i podobieństwo do innych stron. Poprawianie tekstu na stronie, której robot jeszcze nie widział, nie przyspieszy jego pierwszej wizyty, bo wyszukiwarka nie ma skąd wiedzieć o zmianie.
| Cecha | Strona wykryta | Strona zeskanowana |
|---|---|---|
| Czy robot pobrał stronę | Nie, wizyta została odłożona | Tak, strona została pobrana |
| Czy Google zna treść | Nie | Tak |
| Data ostatniego skanowania | Zwykle brak | Jest widoczna |
| Gdzie szukać przyczyny | Serwer, liczba adresów, linkowanie, obraz całej witryny | Treść i wartość konkretnej podstrony |
| Pierwsze miejsce diagnozy | Raport „Statystyki indeksowania” | Sama podstrona i jej odpowiedniki w serwisie |
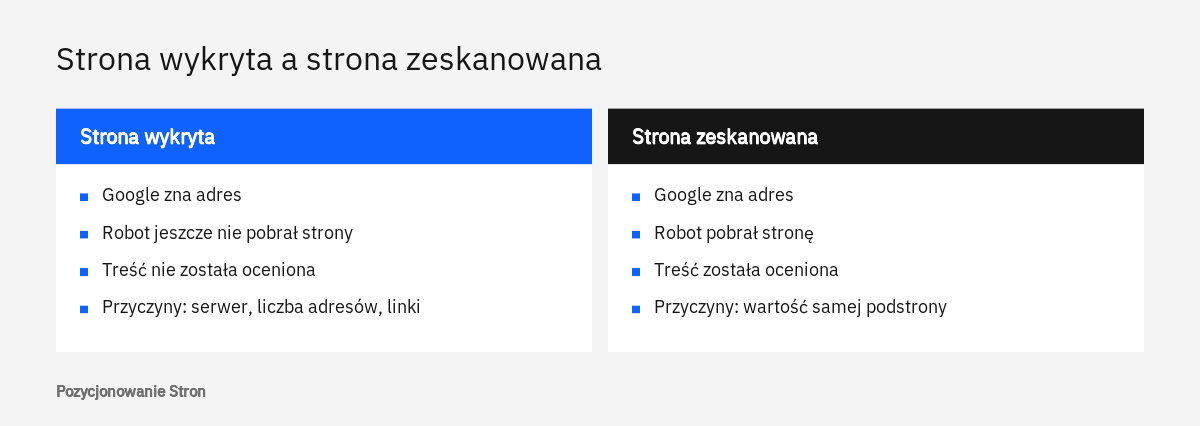
Oba statusy mają też cechę wspólną: żaden nie jest ostateczny, a adres często przechodzi przez oba po kolei, najpierw czekając na wizytę, potem na decyzję o indeksie. Drugiemu z nich poświęciliśmy osobny wpis o tym, co robić, gdy strona jest zeskanowana, ale jeszcze niezindeksowana, a przegląd pozostałych komunikatów znajduje się w tekście o tym, dlaczego Google nie indeksuje strony.
Jak wydajność serwera wpływa na odkładanie wizyt robota
Wolny lub niestabilny serwer bezpośrednio zmniejsza liczbę stron, które Google jest gotów pobrać, a więc wydłuża kolejkę adresów „wykrytych”. Dokumentacja Google o zarządzaniu budżetem indeksowania opisuje to pojęciem limitu wydajności indeksowania.
Górna granica obciążenia, jakie Googlebot nakłada na serwer: liczba równoległych połączeń i czas, przez jaki są utrzymywane.
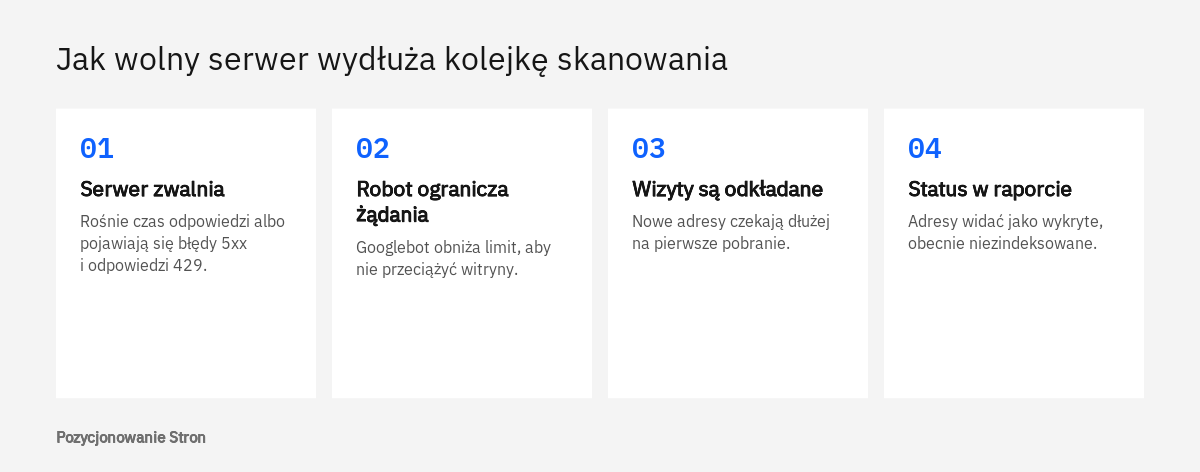
Limit nie jest stały. Według tej dokumentacji zależy od stabilności i szybkości odpowiedzi serwera, a obniżają go błędy z grupy 5xx oraz odpowiedź 429, czyli sygnał ograniczania liczby żądań. Dokument o działaniu wyszukiwarki ujmuje to jeszcze prościej: błędy z grupy 500 robot traktuje jak prośbę o zwolnienie tempa. Tak właśnie należy rozumieć zdanie z pomocy Search Console o tym, że Google mógł przeciążyć witrynę. Robot sam obserwuje reakcje serwera i sam się ogranicza.
Raport „Statystyki indeksowania”
Czy serwer rzeczywiście jest przyczyną, pokazuje raport dostępny w Search Console po kliknięciu pozycji „Ustawienia” w menu, a następnie „Statystyki indeksowania”. Zgodnie z opisem raportu Statystyki indeksowania jest on dostępny tylko dla usług najwyższego poziomu, czyli dla całej domeny albo adresu głównego, a nie dla pojedynczego katalogu.
Raport zawiera trzy wykresy: łączną liczbę żądań robota, całkowity rozmiar pobranych danych i średni czas odpowiedzi. Niżej znajduje się część „Stan hosta”, która ocenia dostępność witryny w ostatnich 90 dniach w trzech obszarach: pobieranie pliku robots.txt, rozpoznawanie nazw DNS i połączenie z serwerem. Żądania można też pogrupować według odpowiedzi serwera, typu pliku, typu Googlebota oraz celu, przy czym cel „Wykrycie” oznacza pobranie nowego adresu, a „Odświeżenie” ponowną wizytę na stronie już znanej.
Przy statusie „wykryta” warto zwrócić uwagę na cztery rzeczy. Pierwsza to średni czas odpowiedzi: pomoc Search Console wyjaśnia, że gdy witryna reaguje wolno, robot wysyła mniej żądań, aby jej nie przeciążać. Druga to udział błędów serwera i odpowiedzi 429 w grupowaniu według odpowiedzi. Trzecia to stan hosta, zwłaszcza połączenie z serwerem. Czwarta to proporcja celów: jeśli niemal wszystkie żądania służą odświeżaniu znanych stron, a na wykrywanie nowych zostaje niewiele, kolejka nowych adresów będzie się skracać powoli.
Jako ilustrację można przyjąć hipotetyczny sklep z Poznania, który działa na niedrogim hostingu współdzielonym. W godzinach szczytu strony kategorii generują się długo, a serwer co pewien czas odpowiada błędem. Właściciel dopisuje do oferty kilkaset nowych produktów i po miesiącu widzi je w raporcie jako „wykryte”. W takim scenariuszu sama treść produktów nie ma znaczenia, bo robot jej nie zna. Przyczyną jest tempo, które Google sam sobie narzucił po obserwacji serwera.
Co wtedy pomaga? Dokumentacja wymienia skrócenie czasu odpowiedzi serwera, lżejsze zasoby strony oraz obsługę buforowania po stronie protokołu, w tym odpowiedź 304 dla stron, które nie zmieniły się od poprzedniej wizyty. Jeżeli narzędzie do sprawdzania adresów pokazuje komunikat o przekroczeniu limitu obciążenia hosta, Google radzi rozważyć zwiększenie zasobów serwera. Poszczególne wątki rozwijamy w tekstach o czasie odpowiedzi serwera, o kodzie 429 oraz o tym, jak hosting wpływa na indeksowanie strony.
Jeśli chcą Państwo zamówić audyt SEO, zachęcamy do kontaktu: tel. 222 500 844 lub mailowo: biuro@pozycjonowaniestron.pl
Dlaczego liczba adresów w serwisie wydłuża kolejkę
Im więcej adresów serwis wystawia robotowi, tym dłużej każdy z nich czeka na wizytę, bo wszystkie konkurują o tę samą, ograniczoną liczbę żądań. Dokumentacja Google nazywa ten zbiór postrzeganymi zasobami i zaznacza, że jest to czynnik, na który właściciel witryny ma największy wpływ.
Budżet indeksowania, czyli zestaw adresów, które Googlebot może i chce odwiedzić, wynika z dwóch składników. Pierwszym jest opisany wyżej limit wydajności. Drugim jest zapotrzebowanie na indeksowanie, czyli to, jak bardzo Google chce poznać dany serwis. Składają się na nie rozmiar witryny, częstotliwość zmian, jakość i trafność stron. Jeżeli wśród znanych adresów jest dużo powtórzeń i stron, które nie powinny trafić do indeksu, robot traci na nie czas, a strony ważne czekają.
Warto przy tym znać skalę. Dokument o budżecie indeksowania jest adresowany do dużych witryn, liczących ponad milion unikalnych stron ze zmianami mniej więcej raz w tygodniu, do średnich i dużych witryn z ponad 10 tys. stron zmienianych codziennie oraz do witryn, w których duża część adresów ma status „Strona wykryta - obecnie niezindeksowana”. Google podkreśla, że liczby są orientacyjne. Trzeci punkt jest jednak ważny: duży udział adresów „wykrytych” sam w sobie jest sygnałem, że warto przyjrzeć się gospodarowaniu skanowaniem, nawet gdy serwis nie jest olbrzymi.
Skąd biorą się zbędne adresy
Mała strona firmowa rzadko ma ten kłopot. Pojawia się on tam, gdzie oprogramowanie samo tworzy adresy. W sklepach są to połączenia filtrów, sortowania i liczby produktów na stronie, w portalach ogłoszeniowych - wygasłe oferty i wyniki wyszukiwarki wewnętrznej, a w wielu systemach także parametry śledzące doklejane do odnośników.
Hipotetyczny przykład dobrze pokazuje skalę. Sklep z armaturą z Łodzi ma kilka tysięcy produktów, a na liście kategorii filtry koloru, producenta, średnicy i ceny. Każde połączenie filtrów tworzy osobny adres, do którego prowadzi zwykły odnośnik. Robot widzi więc nie kilka tysięcy stron, lecz wielokrotnie więcej adresów o niemal tej samej zawartości, a nowe produkty trafiają do tej samej kolejki co kombinacje filtrów. Ten mechanizm opisujemy szerzej we wpisach o nawigacji fasetowej i o parametrach w adresach URL.
Jak ograniczyć liczbę adresów zgodnie z zaleceniami Google
Dokumentacja o budżecie indeksowania podaje kilka konkretnych zaleceń. Powielone treści należy połączyć, aby robot skupiał się na stronach unikalnych. Adresy, które nie są potrzebne w wyszukiwarce, można zablokować w pliku robots.txt. Strony trwale usunięte powinny zwracać odpowiedź 404 lub 410. Trzeba usuwać pozorne błędy 404, czyli puste strony odpowiadające tak, jakby wszystko było w porządku, bo robot nadal je odwiedza. Wreszcie należy unikać długich łańcuchów przekierowań.
Dwa zastrzeżenia z tej samej dokumentacji są często pomijane. Po pierwsze, znacznik noindex nie nadaje się do oszczędzania skanowania. Aby go odczytać, robot i tak musi pobrać stronę, więc żądanie zostaje wykonane. Po drugie, zablokowanie adresów w robots.txt nie przenosi automatycznie zaoszczędzonych wizyt na inne strony, chyba że witryna dochodzi już do limitu wydajności serwera. Blokada porządkuje kolejkę, ale nie kieruje robota z dnia na dzień na nowe produkty.
Reguły blokujące wymagają ostrożności, ponieważ zbyt ogólny wzorzec potrafi zamknąć przed robotem całe kategorie. Pomoc Search Console wymienia nową, zbyt szeroką regułę w robots.txt jako jedną z przyczyn nagłego spadku skanowania. Różnice między narzędziami wyjaśniamy w tekście canonical, noindex i robots.txt, a szerszy obraz gospodarowania wizytami robota w tekście o budżecie indeksowania.
Jak jakość całej witryny i linkowanie wpływają na kolejność wizyt
Google chętniej i szybciej odwiedza adresy z serwisów, które uznaje za wartościowe i popularne, oraz te podstrony, do których prowadzą wyraźne odnośniki. Ponieważ przy statusie „wykryta” robot nie zna treści samej podstrony, o kolejności decydują sygnały dostępne przed wizytą: obraz całej witryny i miejsce adresu w jej strukturze.
Dokumentacja o budżecie indeksowania wymienia wśród czynników zapotrzebowania jakość i trafność stron oraz popularność: adresy popularne w internecie są odwiedzane częściej. Pomoc Search Console wśród powodów spadku skanowania podaje z kolei treści rzadko zmieniane lub słabej jakości. Jeśli większość stron, które robot dotąd pobrał, to powielone opisy producenta, puste kategorie albo masowo tworzone podstrony różniące się jednym słowem, wyszukiwarka ma mniej powodów, by spieszyć się po kolejne adresy z tego samego źródła. Wagi tego czynnika nie pokazuje żaden raport. Traktujemy go jako zależność opisaną przez Google ogólnie i zgodną z obserwacjami z naszej pracy, a nie jako wskaźnik, który da się zmierzyć.
Linki wewnętrzne
Google odkrywa nowe adresy przede wszystkim przez odnośniki na stronach, które już zna, oraz przez mapy witryn. Zalecenia dotyczące linków w Google mówią, że każda ważna strona powinna mieć link z co najmniej jednej innej strony w tej samej witrynie. Podstrona, która występuje wyłącznie w mapie witryny, jest dla robota adresem bez kontekstu: nie widać, do jakiego działu należy ani czy jest dla właściciela ważna.
Liczy się także sposób zapisania odnośnika. Google wyodrębnia linki tylko z elementów a z atrybutem href, który zawiera prawdziwy adres. Elementy udające link za pomocą skryptu mogą zostać pominięte.
<!-- poprawnie: element a z adresem w atrybucie href -->
<a href="/oferta/wymiana-pieca-gazowego/">Wymiana pieca gazowego</a>

<!-- niezalecane: brak adresu, działa tylko skrypt -->
<span onclick="otworz('/oferta/wymiana-pieca-gazowego/')">Wymiana pieca gazowego</span>
Nowe podstrony warto podlinkować z miejsc często odwiedzanych przez robota: ze strony głównej, ze stron kategorii, z popularnych wpisów. Hipotetyczna kancelaria z Krakowa, która publikuje dwadzieścia nowych opisów usług i umieszcza odnośniki do nich wyłącznie w rozwijanym menu budowanym skryptem, może długo oglądać je w raporcie jako „wykryte”. Te same podstrony podlinkowane zwykłymi odnośnikami z tekstu strony głównej i z powiązanych wpisów dają robotowi jasny sygnał, że są częścią serwisu.
Mapa witryny
Mapa witryny pomaga Google poznać adresy, ale nie wymusza wizyty. Dokument Co to jest mapa witryny zaznacza, że mapa nie gwarantuje skanowania ani indeksowania wszystkich elementów. Jest najbardziej przydatna w dużych serwisach oraz w nowych witrynach, do których prowadzi niewiele linków z zewnątrz, natomiast w małej witrynie do około 500 stron z dobrym linkowaniem wewnętrznym może nie być potrzebna. Przy dużej liczbie adresów „wykrytych” mapa powinna zawierać wyłącznie strony przeznaczone do indeksu i być aktualna. Budowę pliku omawiamy w tekście o mapie witryny XML.
Co można przyspieszyć własnymi działaniami
Przyspieszyć można to, co leży po stronie witryny: stabilność i szybkość serwera, porządek w adresach, linkowanie do nowych podstron i aktualność mapy witryny. Pojedynczym, ważnym adresom pomaga też prośba o zindeksowanie, choć nie rozwiązuje ona problemu w skali całego serwisu.
- Ustalenie, które adresy czekają
W raporcie „Indeksowanie stron” warto przełączyć filtr na przesłane strony i przejrzeć przykłady. Jeśli w kolejce stoją głównie adresy techniczne, zadaniem jest ich ograniczenie, a nie przyspieszanie.
- Ocena serwera
W raporcie „Statystyki indeksowania” należy sprawdzić średni czas odpowiedzi, udział błędów serwera i odpowiedzi 429 oraz stan hosta.
- Uporządkowanie zbędnych adresów
Powielone strony warto połączyć, niepotrzebne adresy wyłączyć ze skanowania, a strony usunięte oddać z odpowiedzią 404 lub 410.
- Podlinkowanie ważnych podstron
Każda nowa strona powinna mieć zwykły odnośnik z co najmniej jednej strony już znanej Google.
- Aktualizacja mapy witryny
W mapie powinny znaleźć się tylko adresy przeznaczone do indeksu.
- Prośba o zindeksowanie najważniejszych adresów
Dla kilku kluczowych podstron można użyć narzędzia do sprawdzania adresów URL.
Ostatni punkt wymaga komentarza. Dokument Google o zgłaszaniu prośby o ponowne zindeksowanie podaje, że liczba pojedynczych adresów, które można zgłosić, jest ograniczona, że wielokrotne zgłaszanie tego samego adresu nie przyspiesza sprawy i że samo zgłoszenie nie daje gwarancji umieszczenia strony w indeksie. Przy większej liczbie stron Google zaleca przesłanie mapy witryny. Prośba jest więc dobrym rozwiązaniem dla nowej strony usługi albo ważnego wpisu, a nie metodą na kilkaset produktów.
Podobnie jest z opcją weryfikacji poprawki, dostępną w widoku szczegółowym statusu. Ma ona sens dopiero po wprowadzeniu rzeczywistej zmiany, na przykład po przyspieszeniu serwera. Pomoc Search Console podaje, że weryfikacja zwykle trwa do 2 tygodni, choć może potrwać znacznie dłużej.
- Średni czas odpowiedzi w raporcie „Statystyki indeksowania” nie rośnie, a stan hosta nie zgłasza problemów.
- W odpowiedziach serwera nie ma znaczącego udziału błędów 5xx ani odpowiedzi 429.
- Filtry, sortowania i wyniki wewnętrznej wyszukiwarki nie tworzą tysięcy adresów dostępnych dla robota.
- Każda ważna podstrona ma zwykły odnośnik z innej strony serwisu.
- Mapa witryny zawiera tylko adresy przeznaczone do indeksu i jest zgłoszona w Search Console.
Na co trzeba po prostu poczekać
Poczekać trzeba na samą wizytę robota, bo jej terminu nie da się ustalić ani wymusić. Google podaje, że skanowanie nowych lub zmienionych stron może trwać od kilku dni do kilku tygodni, i zaleca obserwowanie postępów w raporcie o stanie indeksowania lub w narzędziu do sprawdzania adresów.
Są sytuacje, w których status „wykryta” jest zwykłym etapem przejściowym. Dotyczy to nowej witryny, do której prowadzi jeszcze niewiele odnośników, albo sklepu, który jednorazowo dodał dużą partię produktów. Liczba adresów „wykrytych” najpierw skacze, a potem stopniowo maleje, w miarę jak robot je odwiedza. Jeżeli wykres opada, serwer odpowiada sprawnie, a w kolejce nie ma adresów zbędnych, najlepszym działaniem jest cierpliwość.
Trzeba też pogodzić się z tym, że nie każdy adres znajdzie się w indeksie. Pomoc Search Console odradza oczekiwanie, że zindeksowane zostaną wszystkie adresy witryny. Celem jest obecność w indeksie kanonicznych wersji najważniejszych stron, a duplikaty i wersje alternatywne zwykle indeksowane być nie powinny. Sama wizyta też nie kończy drogi: dokumentacja przypomina, że nie każda zeskanowana strona musi zostać zindeksowana, dlatego po zniknięciu statusu „wykryta” warto ponownie zajrzeć do raportu.
Typowe pomyłki i sytuacje wymagające pomocy specjalisty
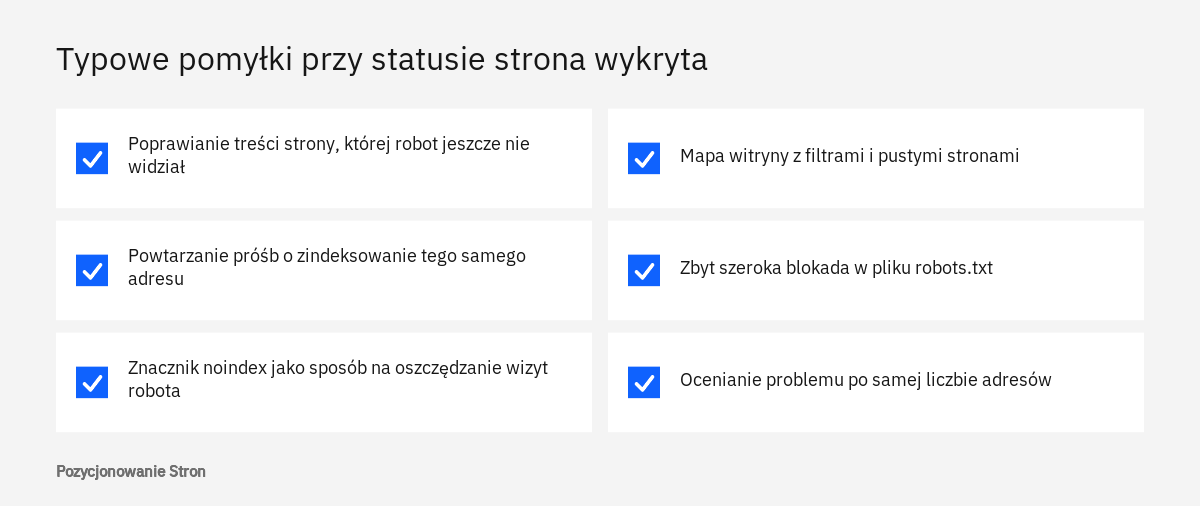
Najczęstszą pomyłką jest leczenie niewłaściwego etapu: poprawianie treści podstrony, której robot jeszcze nie widział, zamiast usunięcia przeszkody, która opóźnia wizytę. Pozostałe błędy mają podobne źródło, czyli mylenie skanowania z indeksowaniem.
Do tej grupy należy powtarzanie próśb o zindeksowanie dla tych samych adresów, stosowanie znacznika noindex w nadziei na oszczędność wizyt robota, wpisywanie do mapy witryny wszystkich adresów razem z filtrami i stronami pustymi, a także blokowanie w robots.txt zbyt szerokim wzorcem. Osobną pomyłką jest ocenianie sytuacji po samej liczbie: tysiąc „wykrytych” kombinacji filtrów nie jest zmartwieniem, a pięćdziesiąt „wykrytych” stron usług już tak.
Samodzielna diagnoza zwykle wystarcza w małej witrynie. Wsparcie specjalisty jest uzasadnione, gdy liczba adresów „wykrytych” rośnie przez wiele tygodni mimo sprawnego serwera, gdy dotyczy stron sprzedażowych z mapy witryny albo gdy problem pojawił się po zmianie systemu sklepu, szablonu lub serwera. Potrzebna jest wtedy analiza dzienników serwera, struktury adresów i linkowania, czyli zakres, który obejmuje audyt SEO, a wdrożenie zaleceń należy do prac z obszaru SEO technicznego. W sklepach z dużym asortymentem te zagadnienia są stałą częścią usługi, jaką jest pozycjonowanie sklepów. Żadna z tych prac nie daje gwarancji zindeksowania konkretnego adresu, bo o tym decyduje wyłącznie Google, natomiast usuwa przeszkody leżące po stronie witryny.
Jeśli chcą Państwo zamówić audyt SEO, zachęcamy do kontaktu: tel. 222 500 844 lub mailowo: biuro@pozycjonowaniestron.pl
Najczęstsze pytania
Czy status „Strona wykryta - obecnie niezindeksowana” oznacza błąd na stronie?
Nie musi. Oznacza, że Google zna adres, ale jeszcze go nie odwiedził. Powodem do działania jest dopiero rosnąca przez dłuższy czas liczba takich adresów wśród stron ważnych dla firmy.
Jak długo strona może mieć ten status?
Google nie podaje terminu. W dokumentacji pisze, że skanowanie może trwać od kilku dni do kilku tygodni i że nie jest gwarantowane. W serwisach z bardzo dużą liczbą adresów lub wolnym serwerem oczekiwanie bywa dłuższe.
Czy poprawienie treści podstrony przyspieszy wizytę robota?
Bezpośrednio nie, ponieważ przy tym statusie robot nie pobrał jeszcze strony i nie wie o zmianie. Treść będzie miała znaczenie po wizycie, gdy Google zdecyduje o indeksie.
Czy warto wysyłać prośbę o zindeksowanie dla każdego adresu?
Nie. Liczba próśb jest ograniczona, a ponawianie ich dla tego samego adresu według Google niczego nie przyspiesza. Prośba ma sens dla kilku najważniejszych stron, a przy większej liczbie adresów lepiej sprawdza się aktualna mapa witryny.
Czy mapa witryny usuwa status „wykryta”?
Sama mapa nie wystarczy. Informuje Google o adresach, ale nie gwarantuje ich skanowania ani indeksowania. Potrzebne są także odnośniki wewnętrzne i sprawny serwer.
Czy ten status dotyczy także małych stron firmowych?
Może się pojawić, ale zwykle na krótko i przy pojedynczych adresach. Google kieruje zalecenia o gospodarowaniu skanowaniem głównie do dużych i często zmienianych serwisów. W małej witrynie długie utrzymywanie się statusu warto zacząć wyjaśniać od linkowania do podstrony i od stanu serwera.
Źródła
- Raport Indeksowanie stron, Search Console - pomoc, Google
- Zarządzanie budżetem indeksowania, Google for Developers
- Raport Statystyki indeksowania, Search Console - pomoc, Google
- Narzędzie do sprawdzania adresów URL, Search Console - pomoc, Google
- Jak działa wyszukiwarka Google, Centrum wyszukiwarki Google
- Zgłaszanie do Google prośby o ponowne zindeksowanie witryny, Centrum wyszukiwarki Google
- Sprawdzone metody dotyczące linków i SEO, Centrum wyszukiwarki Google
- Co to jest mapa witryny, Centrum wyszukiwarki Google
Funkcje wyszukiwarek i asystentów AI zmieniają się szybko, dlatego wpis aktualizujemy po większych zmianach.