Google potrafi odczytać stronę zbudowaną w JavaScripcie, ale robi to w trzech osobnych etapach: najpierw pobiera kod, potem wykonuje skrypty w kolejce renderowania, a dopiero na końcu zapisuje treść w indeksie. Poniżej wyjaśniamy, co robot widzi od razu, co dopiero po uruchomieniu skryptów, które treści mogą po drodze przepaść i jak sprawdzić, czy Państwa strona jest odczytywana w całości.
Czym strona w JavaScripcie różni się od zwykłej strony HTML
Różnica polega na tym, gdzie powstaje treść. Na zwykłej stronie serwer wysyła gotowy dokument HTML z nagłówkami, akapitami i odnośnikami. Na stronie opartej na JavaScripcie serwer często wysyła niemal pusty szkielet i plik ze skryptem, a właściwa treść jest składana dopiero w przeglądarce odwiedzającego. Człowiek zwykle tego nie zauważa, bo przeglądarka wykonuje skrypty bardzo szybko. Dla robota wyszukiwarki to jednak dodatkowa praca do wykonania.
Dokumentacja Google nazywa taki układ modelem powłoki aplikacji: początkowy kod HTML nie zawiera rzeczywistej treści, a robot musi wykonać JavaScript, zanim zobaczy to, co skrypty generują. W ten sposób działają między innymi aplikacje jednostronicowe, czyli serwisy, w których przejście między podstronami nie przeładowuje całej strony, tylko podmienia jej zawartość.
Przetworzenie kodu strony na to, co faktycznie widać na ekranie. W przypadku stron w JavaScripcie oznacza to wykonanie skryptów i zbudowanie z nich końcowego kodu HTML.
<body>
  <div id="app"></div>
  <script src="/static/main.2bb85551.js"></script>
</body>
Jeżeli źródło strony wygląda mniej więcej tak, cała widoczność serwisu w wyszukiwarce zależy od tego, czy robot poprawnie wykona skrypt. Opisane niżej ryzyka dotyczą właśnie serwisów, w których skrypt odpowiada za wyświetlenie głównej treści: opisów usług, kart produktów, cenników czy nawigacji.
Jak przebiegają trzy etapy: skanowanie, renderowanie i indeksowanie
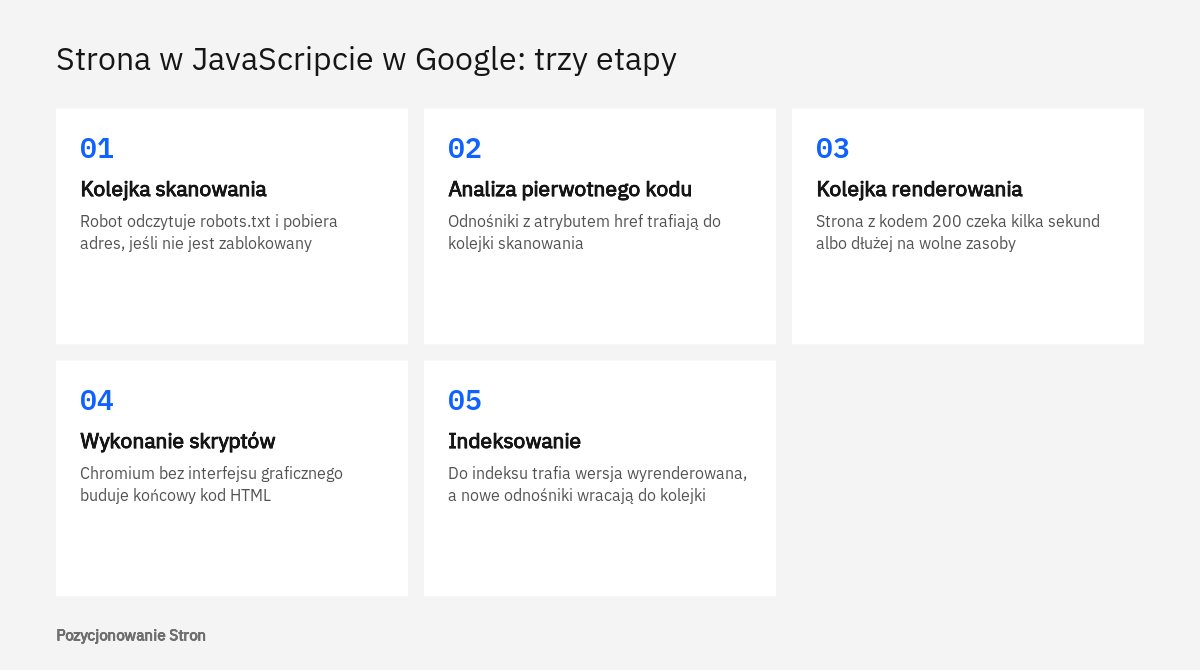
Według dokumentacji Google Search Central o podstawach JavaScriptu w SEO przetwarzanie takich stron dzieli się na trzy główne fazy: skanowanie, renderowanie i indeksowanie. Każda z nich może się zakończyć niepowodzeniem z innego powodu, dlatego warto rozumieć je osobno. Ogólny obraz pracy wyszukiwarki opisujemy we wpisie o tym, jak działa skanowanie, indeksowanie i wyświetlanie wyników, tutaj skupiamy się na tym, co zmienia obecność JavaScriptu.
Skanowanie: pobranie adresu z kolejki
Robot Google pobiera adres z kolejki skanowania i najpierw odczytuje plik robots.txt, żeby ustalić, czy wolno mu ten adres odwiedzić. Jeśli adres jest zablokowany, robot go pomija. Dokumentacja dodaje ważne zastrzeżenie: wyszukiwarka nie renderuje kodu JavaScript z zablokowanych plików ani na zablokowanych stronach. Blokada katalogu ze skryptami w robots.txt może więc sprawić, że strona zostanie pobrana, ale jej treść nigdy się nie zbuduje. Zasady pisania tego pliku omawiamy we wpisie o pliku robots.txt.
Następnie robot analizuje odpowiedź serwera i wyszukuje w niej odnośniki w atrybutach href, a znalezione adresy dopisuje do kolejki skanowania. Na zwykłej stronie ten krok w zupełności wystarcza, bo treść i odnośniki są już w pobranym kodzie. W modelu powłoki aplikacji nie ma w nim jeszcze ani treści, ani odnośników, więc wszystko zależy od następnej fazy.
Renderowanie: kolejka i wykonanie skryptów
Do kolejki renderowania trafiają strony, które odpowiedziały kodem stanu 200, o ile znacznik lub nagłówek robots nie zakazuje ich indeksowania. Dokumentacja podaje, że strona może pozostawać w tej kolejce kilka sekund albo dłużej, i nie określa górnej granicy. Gdy pozwalają na to zasoby Google, przeglądarka Chromium działająca bez interfejsu graficznego renderuje stronę i wykonuje JavaScript. W opisie działania wyszukiwarki Google zaznacza, że korzysta przy tym z aktualnej wersji Chrome.
Z kolejki wynika praktyczny wniosek. Treść obecna w pierwotnym kodzie HTML jest dostępna dla robota od razu po pobraniu, natomiast treść budowana skryptem dopiero po przejściu przez kolejkę. Przy kodach innych niż 200, na przykład 404, renderowanie może zostać pominięte.
Indeksowanie: zapis wersji wyrenderowanej
Po wykonaniu skryptów robot ponownie analizuje wyrenderowany kod HTML w poszukiwaniu odnośników i dopisuje je do kolejki skanowania. Do indeksowania strony Google używa właśnie tego wyrenderowanego kodu. To zdanie z dokumentacji jest najważniejsze dla całego tematu: liczy się to, co znalazło się w końcowym kodzie po zakończeniu pracy skryptów w środowisku robota, a nie to, co widzi człowiek po kilku kliknięciach.
Google zastrzega przy tym, że nie gwarantuje skanowania, indeksowania ani wyświetlania żadnej strony, nawet zgodnej z jego zasadami. Poprawne renderowanie jest warunkiem koniecznym, ale nie przesądza o obecności w wynikach.
Opis tego procesu znajduje się na stronie dokumentacji Google, której widok zamieszczamy poniżej.
Co robot widzi od razu, a co dopiero po wykonaniu skryptów
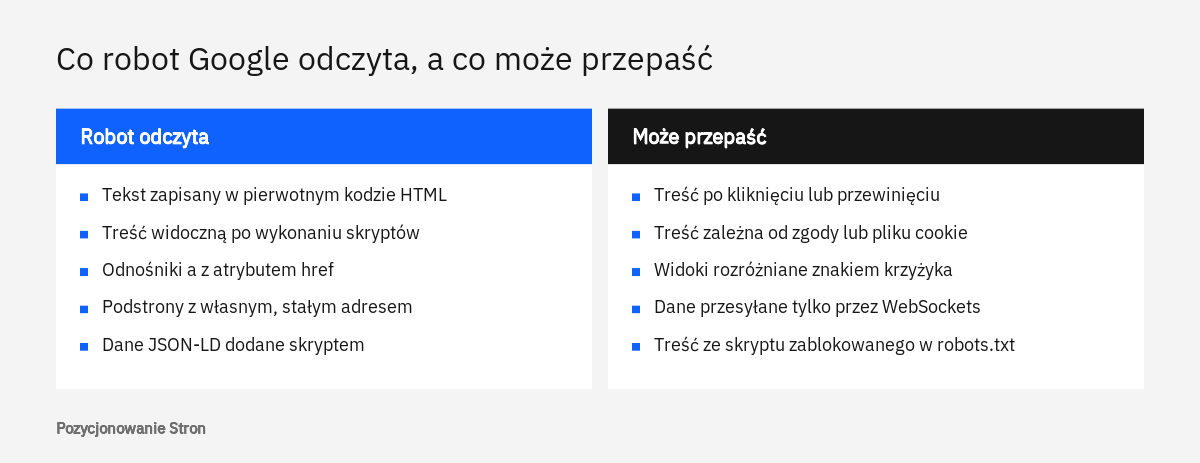
Od razu robot widzi wyłącznie to, co serwer przysłał w odpowiedzi: kod stanu HTTP, nagłówki oraz pierwotny dokument HTML z tym, co w nim zapisano. Wszystko, co skrypt dopisuje, podmienia lub pobiera z osobnego źródła danych, pojawia się dopiero w wersji wyrenderowanej.
Dla przykładu można wyobrazić sobie sklep z Poznania, w którym nazwa i opis produktu są zapisane w kodzie HTML, a cena, dostępność i opinie dociągają się skryptem z osobnego serwera. Nazwa i opis są dostępne dla robota natychmiast. Cena i opinie pojawią się w indeksie tylko wtedy, gdy renderowanie się powiedzie, a skrypt nie będzie czekał na działanie użytkownika.
| Element strony | W pierwotnym kodzie HTML | Dodany przez JavaScript |
|---|---|---|
| Tekst główny | Dostępny od razu po pobraniu strony | Dostępny po przejściu kolejki renderowania, o ile pojawi się w wyrenderowanym kodzie |
| Odnośniki | Odczytywane już podczas skanowania | Odczytywane po renderowaniu, jeśli są elementami a z atrybutem href |
| Tytuł i opis strony | Odczytywane od razu | Google dopuszcza ustawianie i zmienianie ich skryptem |
| Adres kanoniczny | Rozwiązanie zalecane przez Google | Możliwe, ale wartość nie może być sprzeczna z tą z pierwotnego kodu |
| Dyrektywa noindex | Może spowodować pominięcie renderowania | Dodanie zadziała, natomiast usunięcie skryptem może nie zadziałać |
| Dane strukturalne JSON-LD | Odczytywane od razu | Dopuszczalne, Google zaleca przetestowanie wdrożenia |
Dokumentacja zwraca też uwagę na pamięć podręczną. Robot intensywnie zapisuje pobrane zasoby, a usługa renderująca może ignorować nagłówki sterujące pamięcią podręczną, przez co zdarza się jej korzystać z nieaktualnych plików JavaScript lub CSS. Google zaleca w związku z tym umieszczanie w nazwie pliku odcisku jego zawartości, na przykład main.2bb85551.js, który zmienia się przy każdej zmianie pliku.
Istnieje jeszcze ograniczenie wielkości. Z opisu robota Google wynika, że pobiera on pierwsze 2 MB pliku obsługiwanego typu, licząc dane nieskompresowane, a każdy zasób wskazany w kodzie HTML, w tym pliki CSS i JavaScript, jest pobierany osobno i podlega temu samemu limitowi. Po jego osiągnięciu pobieranie się zatrzymuje i do dalszego przetwarzania trafia tylko pobrana część.
Jakie treści mogą przepaść podczas renderowania
Przepada wszystko, czego nie ma w wyrenderowanym kodzie w chwili, gdy robot kończy pracę nad stroną. Dokumentacja o rozwiązywaniu problemów z JavaScriptem wymienia kilka konkretnych sytuacji, w których zachowanie robota różni się od zachowania zwykłego użytkownika. Każda z nich potrafi ukryć przed wyszukiwarką fragment albo całość treści.
Treść pojawiająca się po działaniu użytkownika
Google zaznacza w zaleceniach dotyczących leniwego ładowania, że nie wchodzi w interakcję ze stroną. Robot nie przewija i nie klika. Jeżeli opinie klientów doczytują się dopiero po naciśnięciu przycisku rozwijającego listę, a kolejne produkty po przewinięciu w dół, robot ich nie zobaczy. Treść powinna ładować się wtedy, gdy znajdzie się w widocznym obszarze strony, bez oczekiwania na gest użytkownika. Google wskazuje tu wbudowane w przeglądarkę leniwe ładowanie obrazów i ramek oraz mechanizm IntersectionObserver, który wykrywa pojawienie się elementu w oknie. Szerzej opisujemy to we wpisie o leniwym ładowaniu obrazów i ramek. Przy nieskończonym przewijaniu każda porcja treści powinna mieć własny, stały adres połączony z pozostałymi zwykłymi odnośnikami.
Zgody, uprawnienia i zapamiętane dane
Robot odrzuca prośby o uprawnienia, na przykład o dostęp do kamery. Treść, która wyświetla się dopiero po udzieleniu takiej zgody, nie trafi do indeksu. Usługa renderująca nie przechowuje też danych między wczytaniami stron: dokumentacja wymienia pamięć lokalną przeglądarki, pamięć sesji i pliki cookie. Strona, która pokazuje ofertę dopiero po zapamiętaniu wybranego miasta albo języka, dla robota za każdym razem zaczyna od zera. Rozwiązaniem jest osobny adres dla każdej wersji, z treścią dostępną bez wcześniejszych kroków.
Funkcje, których robot nie obsługuje
Google informuje, że obsługuje ograniczony zestaw interfejsów i funkcji JavaScriptu. Dokumentacja podaje przykłady: robot nie obsługuje technologii WebGL służącej do grafiki trójwymiarowej ani połączeń WebSockets i WebRTC, używanych do stałej wymiany danych z serwerem. Jeśli treść dociera na stronę wyłącznie takim kanałem, potrzebna jest zapasowa droga przez zwykłe żądanie HTTP. Zalecenie ogólne brzmi: kod powinien sprawdzać, czy dana funkcja jest dostępna, i mieć przygotowane rozwiązanie zastępcze.
Błędy w skryptach
Niewykonany skrypt oznacza niezbudowaną treść. Google zaleca rejestrowanie błędów JavaScriptu, które napotykają użytkownicy i robot, za pomocą globalnej obsługi zdarzenia błędu, z zastrzeżeniem, że nie wszystkie rodzaje błędów da się w ten sposób przechwycić.
Jeśli chcą Państwo zamówić SEO techniczne, zachęcamy do kontaktu: tel. 222 500 844 lub mailowo: biuro@pozycjonowaniestron.pl
Jak powinny wyglądać odnośniki i adresy w aplikacji jednostronicowej
Odnośnik musi być elementem a z atrybutem href zawierającym prawdziwy adres, a każda podstrona musi mieć własny adres bez znaku krzyżyka. Tylko wtedy robot odnajdzie kolejne podstrony i potraktuje je jako odrębne dokumenty. Wynika to z zaleceń Google dotyczących linków, według których wyszukiwarka podąża za odnośnikami zapisanymi właśnie w tej postaci. Odnośniki wstawiane skryptem są odczytywane na tych samych zasadach, o ile mają ten sam zapis.
W aplikacjach często spotyka się nawigację zbudowaną z elementów, które wyglądają jak odnośniki, lecz nimi nie są: przycisk lub blok tekstu reagujący na kliknięcie. Użytkownik przejdzie dalej, robot nie. Dokumentacja podaje przykłady zapisów niezalecanych, których Google może próbować użyć, ale nie daje pewności powodzenia, oraz zapisów z adresem zaczynającym się od słowa javascript, które nie są adresami możliwymi do pobrania.
Poprawne:
<a href="/produkty/buty">Buty</a>
<a href="/produkty/buty" onclick="javascript:goTo('buty')">Buty</a>

Niezalecane:
<a routerLink="produkty/buty">Buty</a>
<span href="https://example.com">Buty</span>
<a onclick="goto('https://example.com')">Buty</a>
<a href="javascript:goTo('produkty')">Buty</a>
Adresy z krzyżykiem a History API
Starsze aplikacje rozróżniały widoki fragmentem adresu po znaku krzyżyka, na przykład #/produkty. Dokumentacja Google stwierdza, że robot nie rozpoznaje poprawnie takich adresów, a dawny schemat indeksowania oparty na fragmentach został wycofany. Zalecanym rozwiązaniem jest History API, czyli mechanizm przeglądarki pozwalający zmieniać adres w pasku bez przeładowania strony. Dzięki niemu widok produktów ma zwykły adres kończący się na /produkty, który można wkleić w nowej karcie, przesłać klientowi i zgłosić w mapie witryny.
Z praktyki agencji wynika, że warto przy tym sprawdzić bezpośrednie wejście. Jeżeli wklejony adres podstrony otwiera stronę główną albo komunikat o błędzie, robot również nie dotrze do właściwej treści.
Co dzieje się z kodami odpowiedzi, noindex i adresem kanonicznym
Sygnały techniczne najlepiej wysyłać z serwera w pierwotnej odpowiedzi, ponieważ robot odczytuje je przed renderowaniem i na ich podstawie decyduje, czy w ogóle wykonywać skrypty. W aplikacjach jednostronicowych jest to trudniejsze, bo serwer zwykle odpowiada tak samo na każdy adres, a o treści decyduje skrypt. Stąd biorą się trzy typowe kłopoty.
Pozorne błędy 404
Robot korzysta z kodów stanu HTTP, żeby ustalić, czy podczas pobierania strony coś poszło nie tak. Gdy aplikacja wyświetla komunikat o braku strony, ale serwer odpowiada kodem 200, powstaje tak zwany pozorny błąd 404: nieistniejące adresy wyglądają dla wyszukiwarki jak prawidłowe strony. Google opisuje dwa sposoby zapobiegania temu zjawisku w aplikacjach renderowanych w przeglądarce. Pierwszy to przekierowanie skryptem na adres, dla którego serwer odpowiada kodem 404, na przykład /not-found. Drugi to dodanie skryptem znacznika robots z wartością noindex na stronach błędów. Znaczenie poszczególnych grup kodów wyjaśniamy we wpisie o kodach odpowiedzi HTTP a SEO.
Dyrektywa noindex w pierwotnym kodzie
Gdy robot napotka w znaczniku robots wartość noindex, może pominąć renderowanie i wykonywanie JavaScriptu. Wniosek z dokumentacji jest jednoznaczny: użycie skryptu do zmiany lub usunięcia tej wartości może nie zadziałać, więc strona przeznaczona do indeksowania nie powinna mieć noindex w pierwotnym kodzie. Ryzykowny jest na przykład szablon, w którym noindex jest ustawiony domyślnie na czas ładowania danych, a skrypt zdejmuje go po pobraniu treści. Dla użytkownika nic się nie dzieje, dla wyszukiwarki strona może pozostać wyłączona z indeksu.
Adres kanoniczny ustawiany skryptem
Google zaleca umieszczanie znacznika rel="canonical" w kodzie HTML. Dopuszcza ustawienie go skryptem, ale pod warunkiem, że wartość nie będzie się różnić od tej z pierwotnego kodu. Jeżeli w pierwotnym kodzie nie da się podać właściwego adresu, lepiej pominąć tam znacznik całkowicie i dodać go wyłącznie skryptem, niż podawać dwa sprzeczne. Przykładem błędu jest szablon, który na każdej podstronie wysyła z serwera adres kanoniczny strony głównej, a skrypt próbuje go potem poprawić. Podstawy tego znacznika opisujemy we wpisie o adresie kanonicznym.
Jak sprawdzić, czy strona firmowa jest odczytywana w całości
Najpewniejszą odpowiedź daje narzędzie do sprawdzania adresów URL w Google Search Console, ponieważ pokazuje stronę oczami robota: wyrenderowany kod, zrzut ekranu, pobrane zasoby i komunikaty konsoli JavaScript. Google wskazuje je w dokumentacji, obok testu wyników z elementami rozszerzonymi, jako sposób diagnozowania stron w JavaScripcie. Poniżej opisujemy kolejność czynności zgodną z pomocą Search Console.
- Wpisanie adresu
Pełny adres badanej podstrony należy wpisać w pasku wyszukiwania u góry Search Console. Narzędzie pokaże najpierw dane zapisane w indeksie, w zakładce „Indeks Google”.
- Test wersji opublikowanej
Przycisk uruchamiający sprawdzenie wersji opublikowanej pobiera stronę na żywo. Wynik pojawia się w zakładce „Test wersji opublikowanej”.
- Podgląd przetestowanej strony
Odnośnik otwierający przetestowaną stronę rozwija panel z wyrenderowanym kodem HTML, kartą „Zrzut ekranu” i kartą „Więcej informacji”, w której znajdują się nagłówki HTTP, lista zasobów strony i dane wyjściowe konsoli JavaScript.
- Wyszukanie treści w kodzie
W wyrenderowanym kodzie warto wyszukać kilka charakterystycznych zdań: fragment opisu usługi, cenę, pozycję menu, numer telefonu. Brak zdania w kodzie oznacza, że robot go nie zobaczył.
- Kontrola zasobów i błędów
Lista zasobów pokazuje pliki, których nie udało się pobrać, a konsola błędy skryptów. Zasób zablokowany w robots.txt lub błąd w głównym skrypcie zwykle tłumaczy brakującą treść.
Pomoc Search Console zaznacza, że zrzut ekranu jest dostępny tylko przy udanym teście, pozytywny wynik nie gwarantuje wyświetlania strony w wynikach, a liczba testów w ciągu doby jest ograniczona. Samo narzędzie omawiamy we wpisie o sprawdzaniu adresu URL w Search Console.
Nie warto ograniczać kontroli do strony głównej. Rozsądny zestaw to po jednej podstronie każdego rodzaju: strona główna, strona usługi lub kategorii, karta produktu, wpis oraz adres, który nie istnieje. Ten ostatni pozwala ustalić, czy serwis nie tworzy pozornych błędów 404.
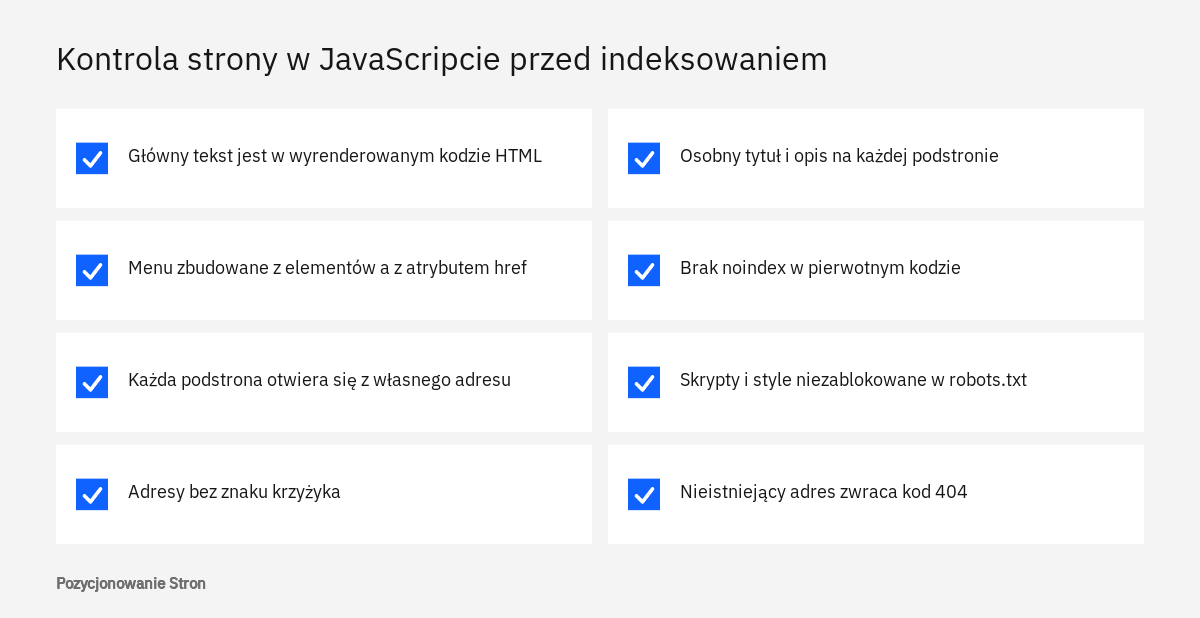
- Główny tekst podstrony znajduje się w wyrenderowanym kodzie HTML.
- Menu i odnośniki w treści są elementami a z atrybutem href i prawdziwym adresem.
- Każda podstrona otwiera się po wklejeniu jej adresu w nowej karcie.
- Tytuł, opis i adres kanoniczny są inne na każdej podstronie i zgodne z jej treścią.
- W pierwotnym kodzie nie ma dyrektywy noindex na stronach przeznaczonych do indeksowania.
- Lista zasobów nie zawiera zablokowanych plików JavaScript i CSS potrzebnych do zbudowania treści.
- Nieistniejący adres kończy się kodem 404 albo otrzymuje dyrektywę noindex.
- Żadna istotna treść nie wymaga kliknięcia, przewinięcia, zgody ani zapamiętanego wyboru.
Po wprowadzeniu poprawek Google zaleca ponowne przetestowanie strony. Gdy test wypada poprawnie, na stronie wyniku dostępny jest przycisk zgłaszający prośbę o zindeksowanie. Pomoc Search Console zastrzega, że takie zgłoszenie ma dzienny limit i nie gwarantuje obecności w indeksie, a przy wielu adresach lepiej przesłać mapę witryny. Jeśli mimo poprawnego renderowania strona pozostaje poza indeksem, przyczyn należy szukać gdzie indziej, o czym piszemy we wpisie dlaczego Google nie indeksuje strony.
Gdzie generować treść: na serwerze czy w przeglądarce
Najbezpieczniej jest tak zbudować serwis, aby główna treść przychodziła z serwera w gotowym kodzie HTML, a JavaScript dodawał do niej interakcję. Google pisze w dokumentacji, że renderowanie po stronie serwera lub renderowanie wstępne nadal jest dobrym rozwiązaniem, ponieważ przyspiesza działanie witryny dla użytkowników i robotów, a nie wszystkie roboty potrafią uruchamiać JavaScript.
Tekst o renderowaniu w internecie w serwisie web.dev porządkuje dostępne podejścia. Przy renderowaniu po stronie serwera pełny kod HTML powstaje na serwerze dla każdego żądania, co sprawdza się przy treściach zmiennych, lecz może wydłużać czas odpowiedzi serwera. Przy renderowaniu statycznym kod HTML każdej podstrony powstaje wcześniej, podczas budowania serwisu, co daje stabilnie krótki czas odpowiedzi, ale jest trudne przy bardzo dużej albo nieprzewidywalnej liczbie adresów. Przy renderowaniu po stronie klienta całość powstaje w przeglądarce, a wraz z rozrostem aplikacji rośnie ilość skryptów i trudniej utrzymać sprawne działanie na telefonach. Hydracja łączy oba światy: serwer wysyła gotowy HTML, a skrypt w przeglądarce dodaje do niego obsługę interakcji, co bywa kosztowne dla szybkości reakcji strony.
W naszej ocenie dla strony firmowej z ofertą, cennikiem i blogiem renderowanie statyczne lub po stronie serwera jest zazwyczaj wyborem naturalnym, bo treść jest taka sama dla każdego odwiedzającego. Renderowanie wyłącznie w przeglądarce ma uzasadnienie w panelach klienta i narzędziach po zalogowaniu, czyli tam, gdzie widoczność w wyszukiwarce nie jest celem. Decyzja zapada na etapie projektu, dlatego przy tworzeniu stron warto zapytać wykonawcę wprost, skąd bierze się kod HTML każdej podstrony.
Renderowanie dynamiczne jako rozwiązanie przejściowe
Renderowanie dynamiczne polega na tym, że serwer rozpoznaje roboty i wysyła im wersję wyrenderowaną na serwerze, a zwykłym użytkownikom wersję budowaną w przeglądarce. Google opisuje je jako obejście problemu i rozwiązanie tymczasowe, którego nie zaleca, ponieważ zwiększa złożoność i wymaga dodatkowych zasobów. W zamian wskazuje renderowanie po stronie serwera, renderowanie statyczne lub hydrację. Jednocześnie wyjaśnia, że samo w sobie nie jest to maskowanie treści, o ile obie wersje pokazują zbliżoną zawartość. Maskowaniem jest dopiero pokazywanie robotom czegoś istotnie innego niż ludziom.
Typowe pomyłki i sytuacje, w których potrzebna jest pomoc
Najczęstsza pomyłka to ocenianie strony wyłącznie na podstawie tego, co widać w przeglądarce. Strona, która działa bez zarzutu dla człowieka, może być dla robota niepełna, ponieważ robot nie klika, nie przewija, nie pamięta poprzedniej wizyty i ma do dyspozycji ograniczony zestaw funkcji. Druga pomyłka jest odwrotna: przekonanie, że Google w ogóle nie czyta JavaScriptu. Czyta, lecz w osobnej fazie i na opisanych wyżej warunkach.
Z praktyki agencji wynika, że kłopoty pojawiają się zwykle w kilku powtarzalnych momentach. Po przebudowie serwisu na nową technologię znika część treści, która wcześniej była w kodzie HTML. Katalog ze skryptami zostaje zablokowany w robots.txt jako rzekomo nieistotny dla wyszukiwarki. Menu powstaje z elementów reagujących na kliknięcie, bez adresów w atrybucie href. Szablon wysyła ten sam tytuł, opis i adres kanoniczny dla wszystkich podstron. Każdy z tych przypadków da się wykryć opisanym wcześniej testem, zanim przełoży się na widoczność.
Samodzielna kontrola wystarcza, gdy serwis jest niewielki, a wynik testu jednoznaczny. Wsparcie specjalisty jest uzasadnione, gdy planowana jest zmiana technologii lub migracja strony, gdy po wdrożeniu nowej wersji spada liczba zaindeksowanych podstron albo gdy test pokazuje pustą lub częściową treść, a przyczyna nie jest oczywista. W takich sytuacjach wykonujemy audyt SEO obejmujący porównanie pierwotnego i wyrenderowanego kodu, a zalecenia dla programistów przygotowujemy w ramach usługi SEO techniczne. Nie obiecujemy przy tym określonych pozycji, ponieważ poprawne odczytanie strony jest dopiero warunkiem wstępnym dalszej pracy.
Jeśli chcą Państwo zamówić SEO techniczne, zachęcamy do kontaktu: tel. 222 500 844 lub mailowo: biuro@pozycjonowaniestron.pl
Najczęstsze pytania
Czy Google indeksuje treść generowaną przez JavaScript?
Tak. Google renderuje strony w przeglądarce Chromium bez interfejsu graficznego i do indeksowania używa wyrenderowanego kodu HTML. Warunkiem jest, aby treść pojawiła się w tym kodzie bez udziału użytkownika i bez funkcji, których robot nie obsługuje.
Ile trwa oczekiwanie w kolejce renderowania?
Dokumentacja Google podaje, że strona może pozostawać w kolejce kilka sekund albo dłużej, i nie wskazuje górnej granicy. Renderowanie następuje, gdy pozwalają na to zasoby Google. Dlatego treść z pierwotnego kodu HTML jest dostępna dla robota wcześniej niż treść dodawana skryptem.
Czy strona na WordPressie jest stroną w JavaScripcie?
Zazwyczaj nie w omawianym tu znaczeniu. Typowa strona na WordPressie wysyła teksty w gotowym kodzie HTML, a skrypty obsługują dodatki, takie jak menu czy formularze. Ryzyko pojawia się wtedy, gdy wtyczka lub motyw dociąga skryptem istotną treść, na przykład listę produktów lub opinie.
Czy wolno blokować pliki JavaScript w robots.txt?
Nie w przypadku plików potrzebnych do zbudowania treści. Google nie renderuje kodu JavaScript z zablokowanych plików, więc taka blokada może pozostawić robota z pustą stroną. Stan faktyczny pokazuje lista zasobów w narzędziu do sprawdzania adresów URL.
Czy inne wyszukiwarki i roboty AI też wykonują JavaScript?
Google zaznacza w dokumentacji, że nie wszystkie roboty potrafią uruchamiać JavaScript, i z tego powodu nadal poleca renderowanie po stronie serwera lub wstępne. Możliwości konkretnych robotów warto sprawdzać w dokumentacji ich operatorów. Treść obecna w pierwotnym kodzie HTML jest rozwiązaniem najbezpieczniejszym dla wszystkich.
Co zrobić, gdy test pokazuje pustą stronę?
Warto zacząć od karty „Więcej informacji” w wyniku testu wersji opublikowanej: listy zasobów, których nie udało się pobrać, oraz komunikatów konsoli JavaScript. Mogą one wskazać zablokowany plik albo błąd w głównym skrypcie. Po poprawce test należy powtórzyć.
Źródła
- JavaScript a SEO - podstawy, Centrum wyszukiwarki Google
- Rozwiązywanie problemów z JavaScriptem związanych z wyszukiwarką, Centrum wyszukiwarki Google
- Renderowanie dynamiczne jako obejście problemu, Centrum wyszukiwarki Google
- Naprawianie leniwie ładującej się zawartości witryny, Centrum wyszukiwarki Google
- Sprawdzone metody dotyczące linków i SEO, Centrum wyszukiwarki Google
- Jak działa wyszukiwarka Google, Centrum wyszukiwarki Google
- Co to jest Googlebot, Centrum wyszukiwarki Google
- Narzędzie do sprawdzania adresów URL, Search Console - pomoc
- Renderowanie w internecie, web.dev
Funkcje wyszukiwarek i asystentów AI zmieniają się szybko, dlatego wpis aktualizujemy po większych zmianach.