Maskowanie treści, po angielsku cloaking, to pokazywanie wyszukiwarce innej zawartości niż ta, którą otrzymuje człowiek, po to, by wpłynąć na pozycje i wprowadzić odbiorcę w błąd. Google zalicza je do praktyk spamerskich, ale nie każda różnica między wersją dla robota a wersją dla użytkownika jest naruszeniem. Poniżej wyjaśniamy, gdzie przebiega granica, jak ocenić treści za logowaniem i płatnym dostępem oraz jak obejrzeć własną stronę tak, jak pobiera ją robot Google.
Czym jest maskowanie treści według zasad Google
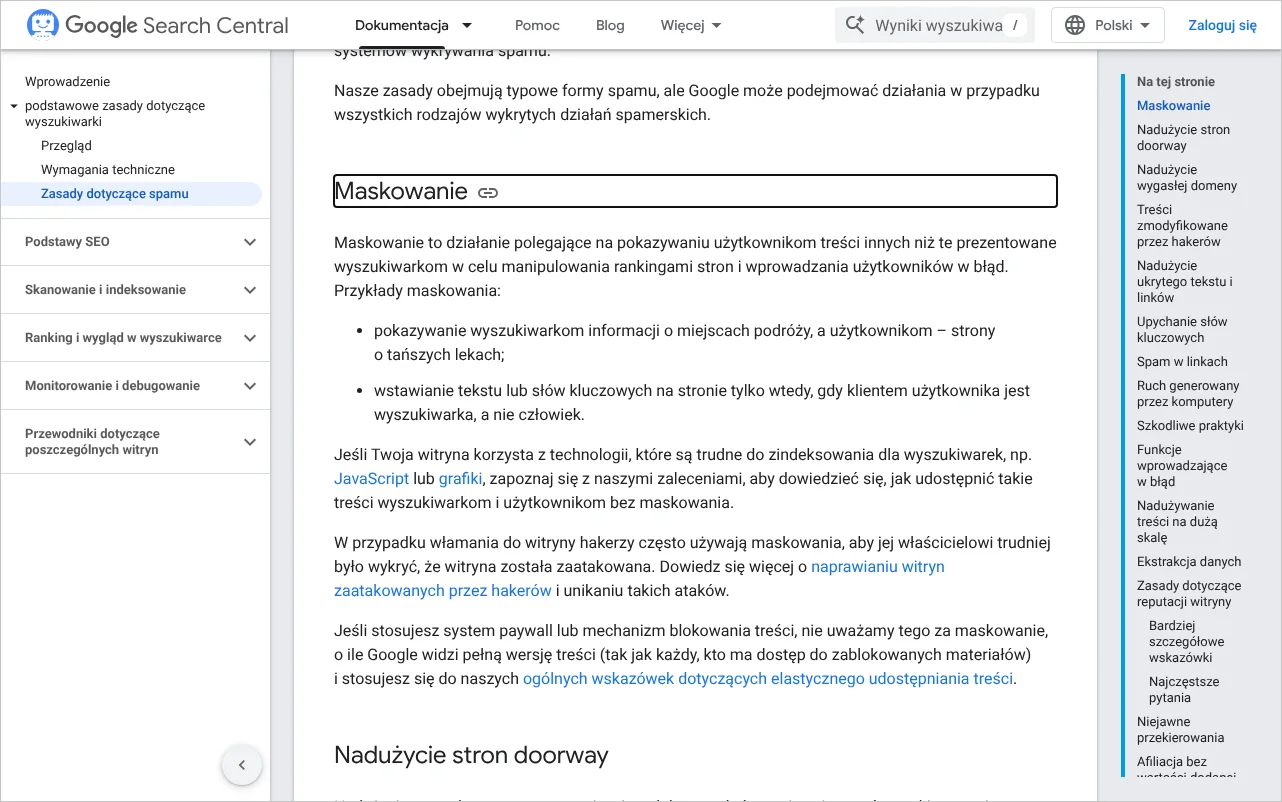
Maskowanie to według Google działanie polegające na pokazywaniu użytkownikom treści innych niż te prezentowane wyszukiwarkom, którego celem jest manipulowanie rankingiem i wprowadzanie użytkowników w błąd. Taka definicja znajduje się w dokumencie Zasady dotyczące spamu w wyszukiwarce Google. Dokument podaje dwa przykłady. W pierwszym wyszukiwarka otrzymuje stronę o miejscach podróży, a człowiek stronę o tańszych lekach. W drugim tekst lub słowa kluczowe pojawiają się w kodzie tylko wtedy, gdy stronę odwiedza robot wyszukiwarki, a znikają, gdy otwiera ją człowiek.
W obu przykładach powtarza się ten sam schemat. Serwer rozpoznaje, kto prosi o stronę, i na tej podstawie decyduje, jaką treść wysłać. Wyszukiwarka ocenia więc dokument, którego użytkownik nigdy nie przeczyta, a użytkownik trafia na stronę, której wyszukiwarka nie oceniała. Wynik w Google obiecuje jedno, a po kliknięciu pojawia się drugie.
Celowe podawanie robotowi wyszukiwarki innej treści niż użytkownikowi, aby uzyskać pozycję, której strona w wersji dla ludzi by nie uzyskała.
Istotne jest słowo "celowe". Definicja Google nie zakazuje każdej różnicy w kodzie, lecz różnicy, która służy manipulacji. Większość pytań właścicieli stron dotyczy właśnie sytuacji granicznych: personalizacji, wersji językowych, treści dla zalogowanych czy stron budowanych skryptami.
Co grozi za maskowanie
Ten sam dokument opisuje skutki. Witryny naruszające zasady mogą mieć niższą pozycję albo w ogóle nie pojawiać się w wynikach wyszukiwania. Naruszenia wykrywają zarówno systemy automatyczne, jak i weryfikatorzy, czyli pracownicy Google oceniający strony. W tym drugim przypadku mówimy o ręcznym działaniu, o którym właściciel dowiaduje się z Search Console. Pozostałe praktyki z tego dokumentu omawia osobny wpis o zasadach Google dotyczących spamu, dlatego tutaj zajmujemy się wyłącznie maskowaniem i tematami, które z nim sąsiadują.
Jak maskowanie wygląda w praktyce
Maskowanie zawsze opiera się na rozpoznaniu odwiedzającego i podmianie odpowiedzi. Różni się tylko sygnał, po którym serwer lub skrypt odróżnia robota od człowieka. Znajomość tych sygnałów jest potrzebna po to, by wiedzieć, czego szukać na własnej stronie, gdy coś budzi niepokój.
Najprostszym sygnałem jest nagłówek identyfikujący program, który pobiera stronę (po angielsku user-agent). Googlebot przedstawia się w nim własną nazwą, więc reguła na serwerze może wysyłać mu inny plik niż przeglądarce. Drugim sygnałem jest adres IP, trzecim strona odsyłająca, czyli informacja, skąd użytkownik przyszedł, a czwartym rodzaj urządzenia. Dokumentacja Google w części o treściach zmodyfikowanych przez hakerów opisuje taki przypadek: kliknięcie adresu w wynikach Google kończy się przekierowaniem na niebezpieczną stronę, a wpisanie tego samego adresu wprost w pasku przeglądarki otwiera zwykłą witrynę.
Z maskowaniem sąsiadują inne praktyki z tych samych zasad. Ukryty tekst i linki to treść, która jest w kodzie, ale człowiek jej nie zauważy: biały tekst na białym tle, tekst schowany za obrazem, przesunięty poza ekran, zapisany czcionką o rozmiarze zero albo całkowicie przezroczysty, a także link podpięty pod jeden mały znak w środku akapitu. Niejawne przekierowania to wysyłanie użytkownika na zupełnie inną stronę niż ta, którą otrzymała wyszukiwarka, na przykład przenoszenie osób korzystających z telefonów na obcą domenę ze spamem.
| Praktyka | Na czym polega | Hipotetyczny przykład |
|---|---|---|
| Maskowanie | Robot dostaje inną treść niż człowiek | Strona warsztatu z Łodzi wysyła Googlebotowi długi tekst o naprawach, a klientom sam formularz |
| Ukryty tekst i linki | Treść jest w kodzie, ale niewidoczna dla odwiedzającego | Lista nazw miast zapisana kolorem tła w stopce strony hydraulika |
| Niejawne przekierowania | Użytkownik ląduje na innej stronie niż ta oceniona przez wyszukiwarkę | Wejście z telefonu na stronę kancelarii kończy się na obcej domenie |
| Maskowane grafiki | W wynikach widać inny obraz niż na stronie | Sklep pokazuje wyszukiwarce zdjęcie produktu, a klientowi baner zasłaniający to zdjęcie |
W pomocy Search Console ręczne działania mają własne nazwy i kilka z nich odnosi się wprost do omawianego tematu: "Maskowanie i niejawne przekierowania", "Maskowane grafiki", "Ukryty tekst lub upychanie słów kluczowych", "Niejawne przekierowania na urządzeniach mobilnych" oraz "Niezgodność treści AMP", dotycząca przyspieszonych stron mobilnych, których treść odbiega od wersji podstawowej.
Co nie jest maskowaniem: personalizacja, układ strony i wersje językowe
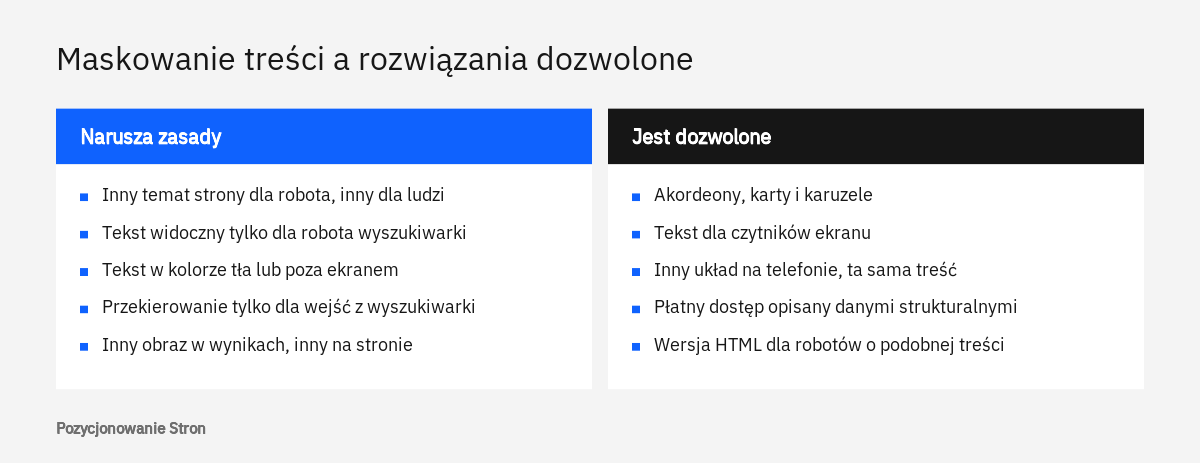
Maskowaniem nie jest różnica, która służy wygodzie odwiedzającego i nie zmienia tego, o czym jest strona. Wspólny mianownik dozwolonych rozwiązań jest prosty: robot ma dostęp do tej samej treści co człowiek, nawet jeśli człowiek musi coś kliknąć, żeby ją rozwinąć.
W części o ukrytym tekście Google podaje listę rozwiązań, które zasad nie naruszają. Są to akordeony i karty pokazujące oraz chowające dodatkowe informacje, pokazy slajdów i karuzele, etykietki z dodatkowym tekstem pojawiające się po działaniu użytkownika oraz tekst przeznaczony wyłącznie dla czytników ekranu, z których korzystają osoby niewidome i słabowidzące. Zwijany opis kategorii w sklepie czy zakładki na karcie produktu mieszczą się więc w zasadach.
Wersja na telefon i wersja na komputer
Inny układ na telefonie i na komputerze nie jest maskowaniem, ale treść powinna być ta sama. Google indeksuje strony na podstawie wersji mobilnej. W sprawdzonych metodach dotyczących indeksowania mobilnego zaleca, by wersja mobilna zawierała te same treści co komputerowa, a zamiast je usuwać, przenosić je do akordeonów lub kart. Treść wycięta z wersji na telefon po prostu nie będzie brana pod uwagę. Szerzej opisujemy to we wpisie o indeksowaniu mobilnym.
Personalizacja, język i kraj odwiedzającego
Personalizacja jest dopuszczalna, gdy robot jest traktowany tak samo jak zwykły odwiedzający w tej samej sytuacji. Sklep, który osobie z Poznania pokazuje najbliższy punkt odbioru, a stałemu klientowi ostatnio oglądane produkty, nie wprowadza nikogo w błąd: temat strony i jej główna treść pozostają takie same. Zasady dotyczące spamu nie zawierają osobnego akapitu o personalizacji, dlatego opieramy się tu na samej definicji maskowania oraz na dokumentacji stron zależnych od języka i regionu.
Ta dokumentacja, zatytułowana Jak Google indeksuje strony o treści zależnej od języka, zawiera dwie ważne informacje. Domyślne adresy IP Googlebota wyglądają na zlokalizowane w Stanach Zjednoczonych, a robot nie wysyła nagłówka z preferowanym językiem, więc strona dobierająca treść wyłącznie po kraju lub języku przeglądarki może pokazać mu tylko jedną wersję. Zalecane są osobne adresy URL dla każdej wersji językowej, powiązane adnotacjami hreflang. Ponadto Googlebota przychodzącego z adresu przypisanego do danego kraju należy traktować tak jak każdego użytkownika z tego kraju. Wyjątek zrobiony specjalnie dla robota to już krok w stronę maskowania.
Strony budowane skryptami i renderowanie dynamiczne
Podawanie robotom gotowego kodu HTML, a użytkownikom wersji budowanej w przeglądarce, nie jest maskowaniem, o ile treść jest podobna. Takie rozwiązanie nazywa się renderowaniem dynamicznym. Google opisuje je na stronie Renderowanie dynamiczne jako obejście problemu i podaje obrazowy przykład granicy: witryna, która użytkownikom wyświetla stronę o kotach, a robotom stronę o psach, stosuje maskowanie. Ta sama strona zaznacza, że jest to rozwiązanie tymczasowe, a nie metoda zalecana. W praktyce właśnie tutaj najłatwiej o niezamierzone rozbieżności: wersja dla robotów jest generowana osobno i po kilku zmianach przestaje odpowiadać temu, co widzą klienci.
Treści za logowaniem i płatnym dostępem
Płatny dostęp i inne mechanizmy blokowania treści nie są uznawane za maskowanie pod dwoma warunkami: Google widzi pełną treść tak samo jak osoba, która ma dostęp do zablokowanych materiałów, a wydawca stosuje się do wskazówek dotyczących elastycznego udostępniania treści. Tak stanowią zasady dotyczące spamu. Formalnie robot otrzymuje tu więcej niż niezalogowany czytelnik, ale wydawca niczego nie udaje: treść naprawdę istnieje i jest dostępna dla subskrybentów.
Wskazówki na temat elastycznego udostępniania treści opisują dwie metody. Pierwsza to limit: osoba bez subskrypcji może przeczytać określoną liczbę materiałów, a potem widzi informację o płatnym dostępie. Dla większości wydawców wiadomości codziennych Google wskazuje od 6 do 10 artykułów w miesiącu na użytkownika. Druga metoda to wstęp: czytelnik widzi kilka pierwszych zdań, a reszta jest zablokowana. Dokument ostrzega, że zbyt restrykcyjne ograniczenia mogą obniżyć pozycje artykułów.
Jak oznaczyć treść płatną w kodzie strony
Żeby Google odróżniło płatny dostęp od maskowania, zablokowaną część strony należy opisać danymi strukturalnymi. Wyjaśnia to dokumentacja znaczników dotyczących subskrypcji i treści płatnych. Każda płatna sekcja dostaje własną klasę CSS, a w opisie artykułu pojawiają się dwie właściwości. Pierwsza, wymagana, informuje, czy materiał jest dostępny bez opłat. Druga, zalecana, wskazuje fragment objęty blokadą za pomocą nazwy klasy.
<script type="application/ld+json">
{
  "@context": "https://schema.org",
  "@type": "NewsArticle",
  "headline": "Tytuł artykułu",
  "isAccessibleForFree": false,
  "hasPart": {
    "@type": "WebPageElement",
    "isAccessibleForFree": false,
    "cssSelector": ".platna-czesc"
  }
}
</script>
Jeśli na stronie jest kilka zablokowanych fragmentów, w polu hasPart podaje się listę obiektów, po jednym na każdą klasę. Dokumentacja dodaje zastrzeżenie: znaczniki dotyczą tylko treści, które mają być indeksowane. Jeżeli płatne materiały nie mają pojawiać się w Google, oznaczać ich nie trzeba.
Panel klienta, hurtownia po zalogowaniu, materiały po rejestracji
Treść dostępna dopiero po zalogowaniu, której robot nie otrzymuje, w ogóle nie jest maskowaniem, ponieważ robot i niezalogowany człowiek widzą to samo: formularz logowania. Dotyczy to panelu klienta, cennika hurtowego dla zarejestrowanych kontrahentów czy platformy szkoleniowej. Skutek jest inny: takich stron Google nie zindeksuje. Problem zaczyna się wtedy, gdy ktoś wpuszcza robota do pełnego cennika, a ludziom pokazuje samo logowanie, i nie opisuje tego danymi strukturalnymi. Wymagana właściwość ze wspomnianej dokumentacji obejmuje także materiały dostępne po rejestracji, więc poprawne oznaczenie jest możliwe również w takim przypadku.
Jeśli chcą Państwo zamówić audyt SEO, zachęcamy do kontaktu: tel. 222 500 844 lub mailowo: biuro@pozycjonowaniestron.pl
Maskowanie, o którym właściciel nie wie: skutki włamania
Maskowanie na stronie uczciwej firmy najczęściej nie jest jej dziełem, lecz śladem po włamaniu. Zasady Google mówią o tym wprost: hakerzy często stosują maskowanie, aby właścicielowi trudniej było wykryć atak. Wstrzyknięty kod pokazuje spam robotowi i osobom przychodzącym z wyszukiwarki, a właścicielowi, który otwiera stronę z zakładki lub wpisuje adres ręcznie, podaje nienaruszoną witrynę.
Dokument wymienia kilka postaci takiego ataku: wstrzyknięcie złośliwego kodu do istniejących stron, utworzenie nowych podstron ze spamem, dodanie ukrytych linków lub tekstu oraz przekierowania zależne od strony odsyłającej, programu pobierającego stronę lub urządzenia. Dla zobrazowania przyjmijmy hipotetyczną sytuację: gabinet stomatologiczny z Bydgoszczy od tygodni nie zmieniał nic na stronie, a w wynikach Google pod jego adresem pojawiają się tytuły w obcym języku z nazwami leków. Recepcja otwiera stronę i widzi wszystko w porządku. To typowy obraz maskowania po włamaniu, a nie błąd wyszukiwarki.
Sygnały ostrzegawcze to wyniki z nieznanymi tytułami pod własną domeną, zapytania w raporcie Skuteczność niezwiązane z działalnością firmy, skargi klientów, że po kliknięciu wyniku trafiają na inną witrynę, oraz wiadomość w Search Console. Stan zabezpieczeń pokazuje raport "Problemy dotyczące bezpieczeństwa". Według pomocy Search Console obejmuje on treści zmodyfikowane przez hakerów, złośliwe i niechciane oprogramowanie oraz inżynierię społeczną, czyli treści podstępem nakłaniające do niebezpiecznych działań. Lista przykładowych adresów w raporcie może być niepełna, dlatego naprawę prowadzi się w całej witrynie.
Jak obejrzeć stronę oczami robota Google
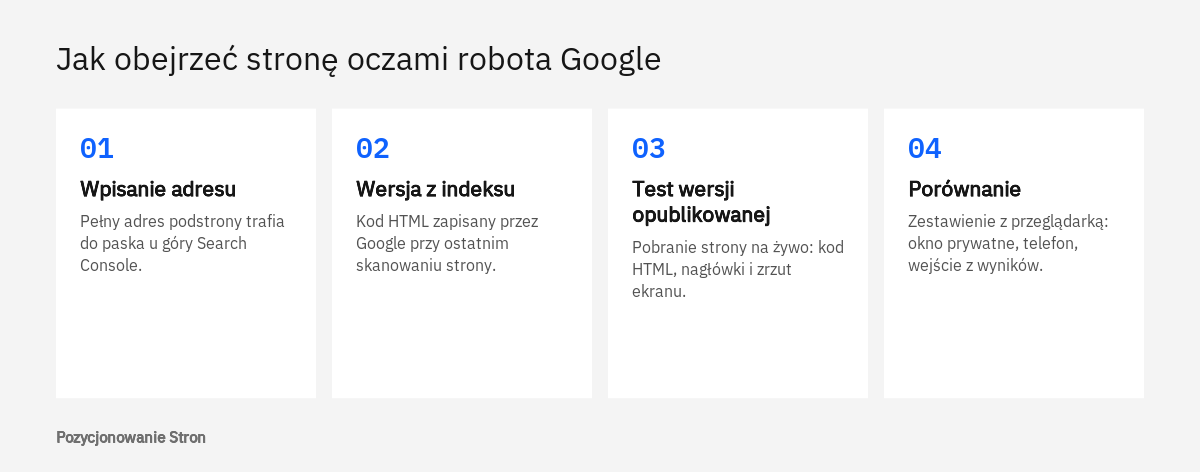
Stronę w wersji pobranej przez Google pokazuje narzędzie do sprawdzania adresów URL w Search Console. To metoda, w której żądanie naprawdę wychodzi z infrastruktury Google, więc ujawnia także maskowanie oparte na adresie IP robota. Sprawdzany adres musi należeć do usługi otwartej w danej chwili w panelu.
- Wpisanie adresu
Pełny adres podstrony wpisuje się w pasku wyszukiwania widocznym u góry każdego ekranu Search Console. W większości raportów to samo narzędzie otwiera przycisk sprawdzania obok adresu strony, widoczny czasem dopiero po najechaniu kursorem.
- Odczyt wersji z indeksu
Pierwszy ekran pokazuje dane z ostatniego skanowania, a nie stan bieżący. Przycisk otwierający zindeksowaną stronę pokazuje kod HTML zapisany przez Google, nagłówki odpowiedzi serwera i komunikaty skryptów, a pozycja "Więcej informacji" listę załadowanych zasobów.
- Test wersji opublikowanej
Przycisk testu wersji opublikowanej zleca pobranie strony w czasie rzeczywistym. Po zakończeniu przycisk otwierający przetestowaną stronę udostępnia kod HTML, nagłówki, komunikaty skryptów oraz kartę "Zrzut ekranu".
- Porównanie z wersją dla ludzi
Kod i zrzut z testu zestawia się z tym, co pokazuje zwykła przeglądarka, najlepiej w oknie prywatnym i na telefonie, przy wejściu zarówno z wyników Google, jak i przez wpisanie adresu.
Pomoc narzędzia opisuje też jego ograniczenia. Zrzut ekranu jest dostępny wyłącznie w teście wersji opublikowanej zakończonym powodzeniem. Wynik testu na żywo może różnić się od wersji z indeksu, na przykład po niedawnej zmianie na stronie. Przy przekierowaniu test bada stronę docelową, ale nie informuje, że przekierowanie nastąpiło. Test nie sprawdza ręcznych działań ani problemów z bezpieczeństwem, a liczba sprawdzeń w ciągu dnia jest ograniczona. Z tych powodów warto zacząć od kilku reprezentatywnych adresów: strony głównej, jednej kategorii lub usługi, jednego wpisu i podstrony, która budzi podejrzenia.
Na co patrzeć w kodzie i na zrzucie
W kodzie HTML z testu szuka się przede wszystkim treści, której nie ma w wersji dla ludzi. Uwagę powinny zwrócić bloki tekstu w obcym języku, długie listy odnośników do nieznanych domen, tytuł strony inny niż ustawiony w systemie zarządzania treścią oraz elementy ukryte stylami. Na zrzucie ekranu ocenia się, czy robot otrzymał główną treść, czy na przykład samą nakładkę z komunikatem albo pustą stronę.
Dodatkowe sposoby kontroli
Uzupełnieniem jest raport "Indeksowanie stron". Wśród stanów opisanych w pomocy tego raportu znajduje się "Strona zindeksowana bez zawartości": Google nie odczytało treści strony, a jako możliwe przyczyny pomoc wymienia maskowanie treści albo format, którego Google nie obsługuje. Adresy z tym stanem warto przejrzeć w pierwszej kolejności.
Z praktyki agencji dodajemy sprawdzian, którego nie opisuje dokumentacja: wejście na stronę z wyników wyszukiwania na telefonie, bez zalogowania do panelu witryny, ponieważ złośliwy kod często pomija zalogowanych administratorów. Zmiana nazwy przeglądarki na nazwę Googlebota w narzędziach dla programistów wykryje tylko najprostsze reguły, oparte na samym nagłówku. Nie wykryje reguł sprawdzających adres IP, bo żądanie nadal wychodzi z komputera użytkownika. Google zaleca potwierdzanie tożsamości robota przez odwrotne wyszukiwanie DNS lub porównanie z publikowanymi listami adresów, co opisuje strona Weryfikowanie żądań od robotów i modułów pobierania Google. Tę technikę omawiamy we wpisie o weryfikacji adresów IP robotów.
Jak ocenić znalezione różnice i co naprawić
Nie każda różnica między wersją dla robota a wersją dla człowieka wymaga naprawy. Liczy się to, czy różni się treść i jej temat, czy tylko sposób podania. Brak baneru z informacją o plikach cookie na zrzucie, inny układ kolumn, nierozwinięty akordeon albo brak okna czatu nie zmieniają znaczenia strony. Dodatkowy tekst widoczny tylko w kodzie dla robota, inne nagłówki, obce linki albo przekierowanie w nieoczekiwane miejsce to różnice merytoryczne i te trzeba wyjaśnić do końca.
Pomoc Search Console w opisie działania "Maskowanie i niejawne przekierowania" wskazuje kolejność postępowania. Najpierw porównanie wersji pobranej przez Google z wersją widoczną dla użytkownika. Jeśli się różnią, należy odnaleźć w kodzie serwera fragment odpowiedzialny za różnicę i go usunąć. Osobno szuka się przekierowań warunkowych, czyli działających tylko dla wejść z wyszukiwarki albo tylko z określonych adresów IP. Pomoc wymienia trzy miejsca, w których zwykle się kryją: skrypty JavaScript, plik .htaccess oraz wtyczki systemu zarządzania treścią.
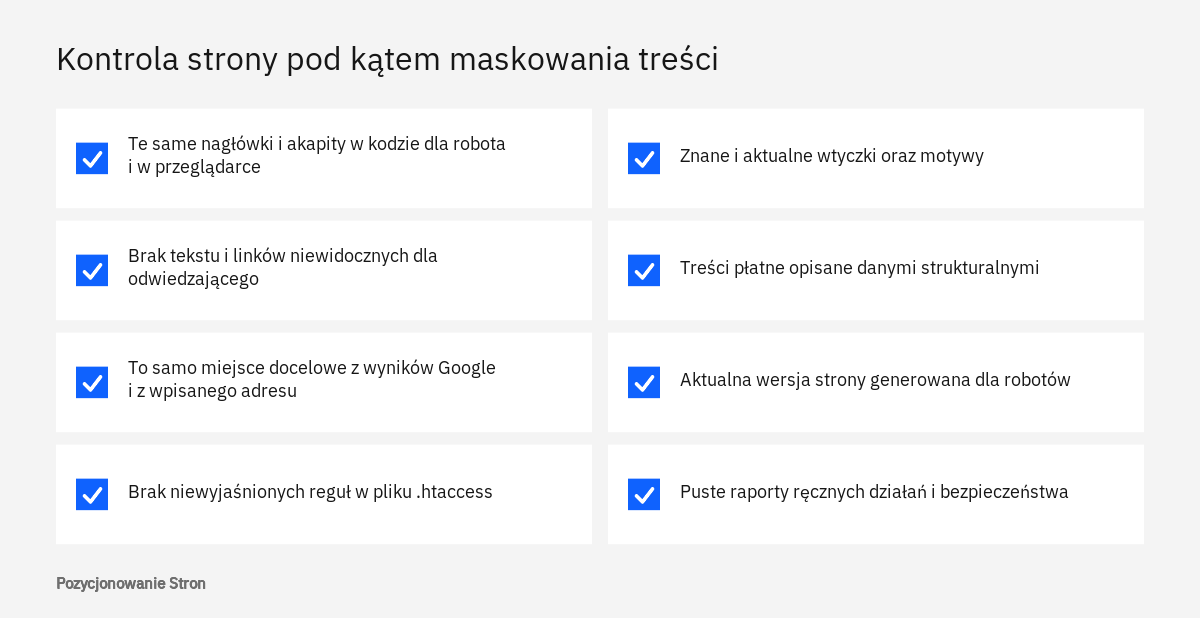
- Kod HTML z testu wersji opublikowanej zawiera te same nagłówki i akapity co strona w przeglądarce.
- W kodzie nie ma tekstu ani linków, których odwiedzający nie jest w stanie zauważyć.
- Wejście z wyników Google i wejście przez wpisanie adresu prowadzą na tę samą stronę, także na telefonie.
- Plik .htaccess nie zawiera reguł zależnych od nazwy robota, adresu IP lub strony odsyłającej, których nikt w firmie nie potrafi wyjaśnić.
- Wtyczki i motywy są znanego pochodzenia i aktualne.
- Treści płatne, które robot otrzymuje w całości, są opisane danymi strukturalnymi.
- Raporty "Ręczne działania" oraz "Problemy dotyczące bezpieczeństwa" nie pokazują zgłoszeń.
Gdy źródłem różnicy jest włamanie, samo usunięcie widocznego spamu nie wystarcza. Trzeba znaleźć drogę, którą kod trafił na serwer, zmienić hasła, zaktualizować oprogramowanie, usunąć dodane konta i pliki, a potem ponownie sprawdzić kilka adresów w Search Console. Gdy różnica wynika z błędu wdrożenia, na przykład z nieaktualnej wersji dla robotów, naprawa polega na ujednoliceniu obu wersji. Takie prace wchodzą w zakres SEO technicznego.
Ręczne działanie za maskowanie: gdzie je sprawdzić i jak wrócić do wyników
Informacja o karze nałożonej przez pracownika Google znajduje się w raporcie "Ręczne działania" w Search Console oraz w wiadomości wysłanej do właściciela usługi. Według pomocy tego raportu ręczne działanie oznacza, że weryfikator uznał strony witryny za niezgodne z zasadami dotyczącymi spamu, a skutkiem jest pominięcie całej witryny lub jej części w wynikach wyszukiwania. Jak czytać ten raport, opisujemy we wpisie o działaniach ręcznych w Search Console.
Pusty raport nie przesądza, że strona jest wolna od problemu. Zasady dotyczące spamu są egzekwowane także przez systemy automatyczne, a te nie zostawiają w tym raporcie komunikatu. Różnice wyjaśnia wpis kara ręczna a spadek algorytmiczny.
Powrót do wyników po ręcznym działaniu wymaga trzech rzeczy. Problem trzeba usunąć ze wszystkich stron, których dotyczy, ponieważ naprawa częściowa nie wystarcza. Google musi mieć dostęp do poprawionych stron, więc nie mogą one wymagać logowania ani być zablokowane plikiem robots.txt lub znacznikiem noindex. Na końcu w raporcie składa się prośbę o sprawdzenie z opisem problemu, wykonanych napraw i ich efektów. Pomoc podaje, że rozpatrzenie trwa w większości przypadków od kilku dni do kilku tygodni i że kolejnej prośby nie należy wysyłać przed otrzymaniem decyzji. Treść samego wniosku omawiamy we wpisie o prośbie o ponowne rozpatrzenie.
Typowe pomyłki i sytuacje, w których potrzebna jest pomoc
Najczęstsza pomyłka to szukanie maskowania tam, gdzie go nie ma, i przeoczenie go tam, gdzie jest. Właściciele stron niepokoją się zwijanymi opisami i zakładkami, które Google wprost dopuszcza, a nie zaglądają do raportu bezpieczeństwa ani nie porównują kodu pobranego przez robota z własną stroną.
Druga pomyłka to ocenianie strony wyłącznie z własnego komputera. Osoba zalogowana do panelu witryny i wchodząca zawsze z zakładki jest dokładnie tym odwiedzającym, przed którym złośliwy kod się ukrywa. Trzecia dotyczy tekstów dopisywanych do strony tak, by nikomu nie przeszkadzały: jeśli tekst jest potrzebny, powinien być widoczny i czytelny. Dobrze przygotowane treści SEO nie wymagają chowania. Kolejne pomyłki to automatyczne przenoszenie każdego odwiedzającego na wersję językową dobraną po adresie IP, pozostawienie wersji dla robotów bez opieki po zmianie szablonu oraz dopuszczenie robota do treści płatnej bez opisania jej danymi strukturalnymi.
Pomoc specjalisty jest potrzebna, gdy różnice w kodzie wracają po usunięciu, gdy w raportach pojawiło się ręczne działanie lub zgłoszenie bezpieczeństwa, gdy strona korzysta z osobnej wersji dla robotów albo z płatnego dostępu, a także wtedy, gdy witrynę przejęto po poprzednim wykonawcy i nie wiadomo, jakie reguły zostawił na serwerze. W ramach audytu SEO porównujemy wersję dla robota z wersją dla użytkownika na wybranych typach podstron, przeglądamy reguły serwera i przekierowania oraz wskazujemy, co wymaga naprawy, a co jest dopuszczalną różnicą.
Jeśli chcą Państwo zamówić audyt SEO, zachęcamy do kontaktu: tel. 222 500 844 lub mailowo: biuro@pozycjonowaniestron.pl
Najczęstsze pytania
Czy zwijany opis kategorii albo sekcja pytań i odpowiedzi to maskowanie?
Nie. Zasady Google wymieniają akordeony i karty wśród rozwiązań nienaruszających zasad. Warunkiem jest to, by użytkownik mógł tę treść rozwinąć i przeczytać.
Czy inna treść dla zalogowanych klientów narusza zasady?
Nie, o ile robot Google jest traktowany jak niezalogowany odwiedzający i widzi to samo co on. Jeśli robot ma otrzymywać pełną treść zablokowaną dla pozostałych, należy ją opisać danymi strukturalnymi.
Czy płatny dostęp do artykułów można pogodzić z obecnością w Google?
Tak. Google nie uznaje płatnego dostępu za maskowanie, jeśli widzi pełną treść tak jak osoba z dostępem, a wydawca stosuje wskazówki dotyczące elastycznego udostępniania treści. Zablokowane fragmenty oznacza się w danych strukturalnych artykułu.
Skąd wiadomo, że strona padła ofiarą maskowania po włamaniu?
Typowe objawy to obce tytuły w wynikach Google pod własną domeną oraz przekierowania po kliknięciu wyniku. Potwierdzenie daje test wersji opublikowanej w narzędziu do sprawdzania adresów URL oraz raport "Problemy dotyczące bezpieczeństwa".
Czy podgląd strony z nazwą Googlebota ustawioną w przeglądarce wystarczy?
Tylko częściowo. Taki podgląd wykrywa reguły oparte na samym nagłówku z nazwą programu, ale nie te, które sprawdzają adres IP. Pewny wynik daje narzędzie w Search Console, ponieważ tam stronę pobiera Google.
Ile trwa zdjęcie ręcznego działania za maskowanie?
Pomoc Search Console podaje, że rozpatrzenie prośby trwa w większości przypadków od kilku dni do kilku tygodni. Warunkiem jest usunięcie problemu ze wszystkich stron, których dotyczy działanie. Zdjęcie działania nie oznacza powrotu na wcześniejsze pozycje.
Źródła
- Zasady dotyczące spamu w wyszukiwarce Google, Centrum wyszukiwarki Google
- Znaczniki dotyczące subskrypcji i treści płatnych, Centrum wyszukiwarki Google
- Wskazówki na temat elastycznego udostępniania treści, Centrum wyszukiwarki Google
- Renderowanie dynamiczne jako obejście problemu, Centrum wyszukiwarki Google
- Jak Google indeksuje strony o treści zależnej od języka, Centrum wyszukiwarki Google
- Sprawdzone metody dotyczące indeksowania zoptymalizowanego pod kątem urządzeń mobilnych, Centrum wyszukiwarki Google
- Weryfikowanie żądań od robotów i modułów pobierania Google, Google for Developers
- Narzędzie do sprawdzania adresów URL, Search Console - pomoc
- Raport Ręczne działania, Search Console - pomoc
- Raport Problemy dotyczące bezpieczeństwa, Search Console - pomoc
- Raport Indeksowanie stron, Search Console - pomoc
Funkcje wyszukiwarek i asystentów AI zmieniają się szybko, dlatego wpis aktualizujemy po większych zmianach.