Strony wyników wewnętrznej wyszukiwarki sklepu nie powinny trafiać do indeksu Google, ponieważ powstają w nieograniczonej liczbie, powielają listy z kategorii i nie mają stałej treści. Te same zapytania, wpisywane przez klientów w pole wyszukiwania, są natomiast jednym z najcenniejszych źródeł wiedzy o tym, czego w sklepie brakuje. Poniżej opisujemy, jak zabezpieczyć strony wyników i jak czytać wyszukiwane hasła w Google Analytics.
Czym są strony wyników wewnętrznej wyszukiwarki i skąd Google o nich wie
Strona wyników wewnętrznej wyszukiwarki to lista produktów, którą sklep buduje w chwili, gdy klient wpisze hasło w pole wyszukiwania. Nie istnieje ona wcześniej jako przygotowana podstrona - powstaje na żądanie, a jej adres zawiera wpisane hasło, najczęściej w postaci parametru zapytania po znaku zapytania.
W sklepach opartych na WordPressie i WooCommerce adres wygląda zwykle tak, jak w przykładzie poniżej, z parametrem o nazwie s. W innych systemach spotykamy w praktyce parametry q, search, query albo osobny katalog w ścieżce, na przykład /szukaj/. Dokładną postać adresu najłatwiej ustalić, wpisując dowolne hasło w wyszukiwarkę własnego sklepu i odczytując pasek adresu przeglądarki.
https://sklep.example/?s=buty+trekkingowe&post_type=product
https://sklep.example/szukaj?q=buty+trekkingowe
https://sklep.example/search?query=buty%20trekkingowe&page=3Fragment adresu po znaku zapytania, zapisany w postaci klucz=wartość. W wyszukiwarce sklepu kluczem jest nazwa parametru, a wartością hasło wpisane przez klienta.
Jak robot trafia na takie adresy
Robot Google nie wpisuje haseł w pole wyszukiwania, ale podąża za odnośnikami. Adresy stron wyników trafiają do niego wtedy, gdy ktoś do nich linkuje: sklep w sekcji popularnych wyszukiwań albo w podpowiedziach pod polem, autor wpisu na forum, który wkleił adres z wynikami, serwis porównujący oferty, a czasem także sam właściciel w wiadomości do klientów lub w kampanii reklamowej. Zdarza się również, że adresy z wynikami są wpisane do mapy witryny przez źle skonfigurowaną wtyczkę.
Drugim źródłem bywają osoby trzecie działające w złej wierze. Skoro sklep wyświetla na stronie wyników wpisane hasło, wystarczy opublikować w sieci wiele odnośników do adresów z dowolną treścią w parametrze, aby robot zaczął je odwiedzać. To obserwacja z praktyki agencji: w niezabezpieczonych sklepach widujemy w indeksie strony wyników z hasłami, które z asortymentem nie mają nic wspólnego. Właściciel dowiaduje się o tym zwykle dopiero z raportów Search Console.
Dlaczego strony wyników nie powinny trafiać do indeksu
Strony wyników nie powinny trafiać do indeksu z trzech powodów: jest ich nieskończenie wiele, powtarzają treść kategorii i nie mają trwałej zawartości. Każdy z tych powodów osobno obniża jakość tego, co Google widzi w sklepie, a razem potrafią przesłonić strony naprawdę ważne dla sprzedaży.
Nieograniczona liczba adresów
Kategorii i produktów jest w sklepie tyle, ile wprowadził właściciel. Stron wyników jest tyle, ile różnych ciągów znaków da się wpisać w pole, pomnożone przez kolejne strony listy i ustawienia sortowania. Google w zaleceniach dotyczących struktury adresów w sklepach internetowych ostrzega, że adresy ze zmieniającymi się wartościami mogą sprawić, że robot uzna witrynę za zbiór nieskończenie wielu stron, co wydłuża czas potrzebny na znalezienie wartościowych treści. W tym samym dokumencie znajduje się zalecenie, aby nie linkować do stron bez przydatnych treści, a jeśli muszą istnieć, oznaczać je regułą noindex.
Ten sam mechanizm Google opisuje przy filtrach. W dokumentacji o nawigacji fasetowej czytamy, że robot nie wie, czy dany adres jest przydatny, dopóki go nie odwiedzi, więc pobiera bardzo dużą ich liczbę, a czas poświęcony na bezużyteczne adresy skraca czas na odkrywanie nowych stron. Wyszukiwarka wewnętrzna działa tu identycznie jak filtry, o których piszemy osobno we wpisie o tym, które kombinacje filtrów pokazać Google.
Powielona i niestała treść
Lista produktów dla hasła „buty trekkingowe” jest zwykle niemal taka sama jak zawartość kategorii o tej nazwie. Sklep ma wtedy dwie strony na jedno zapytanie: starannie opisaną kategorię oraz stronę wyników bez opisu, bez stałego tytułu i bez miejsca w strukturze. Google musi wybrać jedną z nich i nie zawsze wybierze tę, na której zależy właścicielowi. Dodatkowo zawartość strony wyników zmienia się wraz ze stanem magazynu, a przy hasłach, dla których nic nie znaleziono, strona jest po prostu pusta.
Pusta strona, która odpowiada kodem powodzenia, to typowy przypadek pozornego błędu 404. Pomoc Search Console opisuje go jako stronę z komunikatem o braku treści, która zwraca kod 200 zamiast 404. W dużym sklepie takie adresy potrafią stanowić znaczną część wszystkiego, co robot pobiera.
Podobieństwo do stron tworzonych pod wyszukiwarki
Jest jeszcze powód związany z zasadami Google. Wśród przykładów nadużyć polegających na tworzeniu stron przejściowych zasady dotyczące spamu wymieniają tworzenie bardzo podobnych stron, które przypominają wyniki wyszukiwania i nie mają jasno określonej hierarchii. Sama wyszukiwarka w sklepie nie jest oczywiście nadużyciem. Kłopot zaczyna się wtedy, gdy tysiące jej wyników zostają celowo wystawione do indeksu jako zamiennik kategorii. Bezpieczniejszą drogą jest zbudowanie prawdziwej kategorii lub strony z treścią dla haseł, które na to zasługują, i pozostawienie reszty poza indeksem.
Noindex czy robots.txt: czym różnią się obie metody
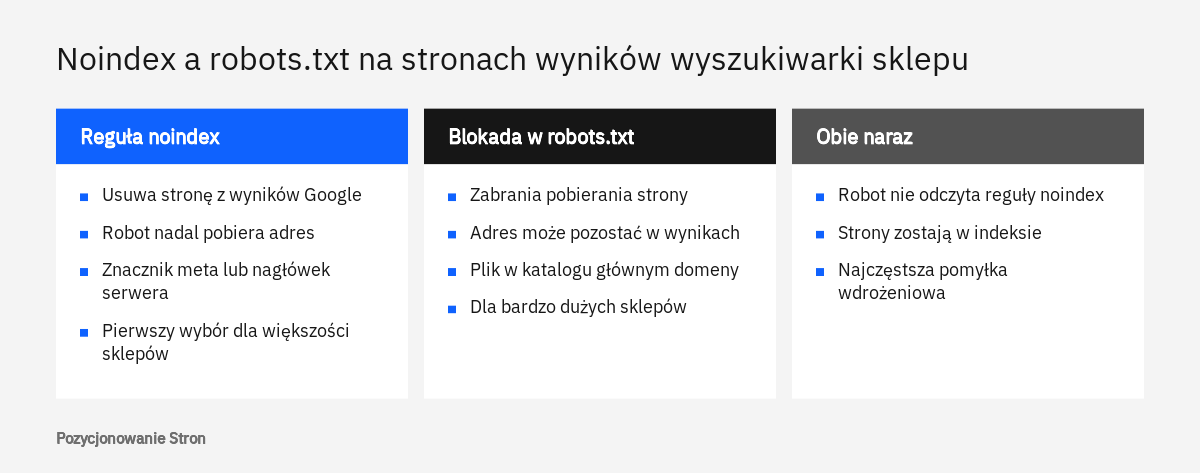
Reguła noindex decyduje o tym, czy strona może pojawić się w wynikach Google, a plik robots.txt o tym, czy robot może ją w ogóle pobrać. Do usunięcia stron wyników z indeksu służy noindex, do ograniczenia liczby pobrań - robots.txt. Obie metody wykluczają się na tym samym adresie, dlatego wybór zależy od tego, jaki problem sklep faktycznie ma.
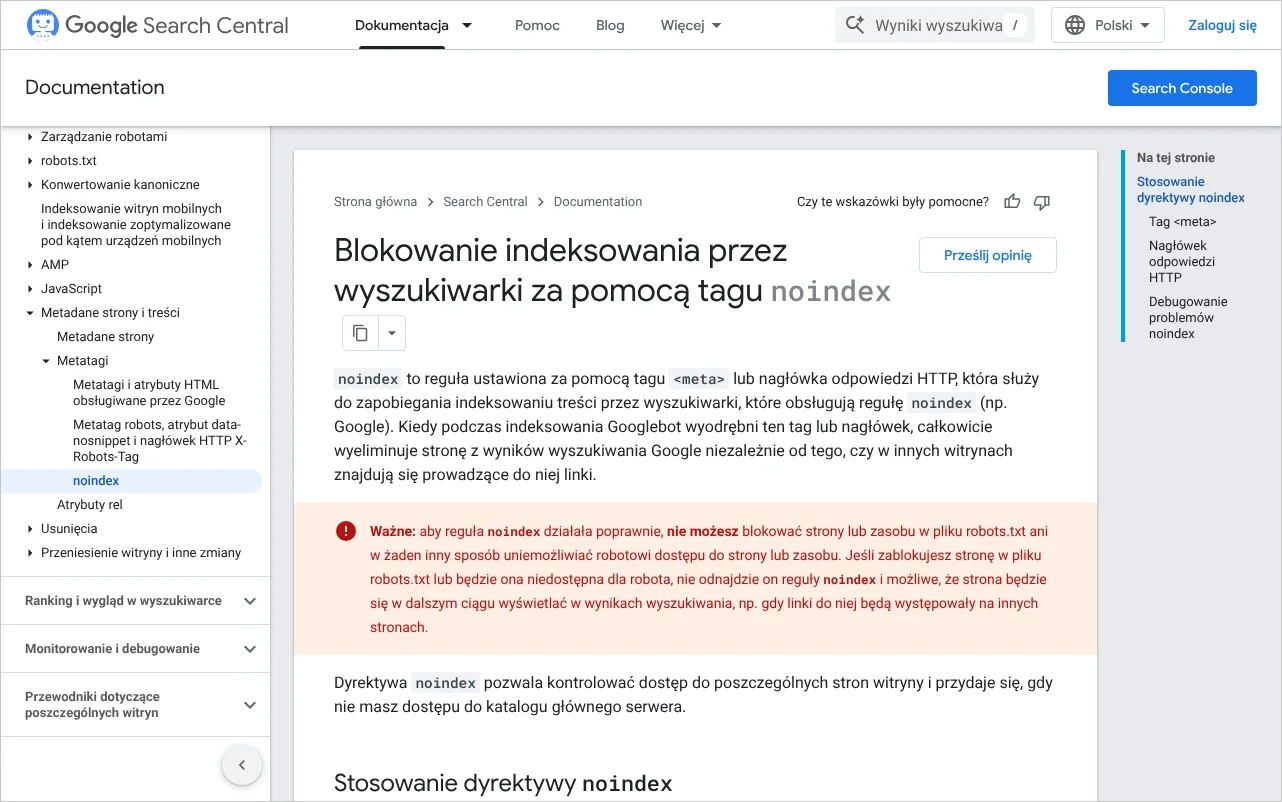
Dokumentacja Google o blokowaniu indeksowania za pomocą tagu noindex wyjaśnia, że regułę można podać na dwa równoważne sposoby: jako znacznik meta w sekcji head albo jako nagłówek odpowiedzi serwera X-Robots-Tag. Gdy robot odczyta tę regułę, strona zostaje usunięta z wyników, nawet jeśli linkują do niej inne witryny. Ta sama strona zawiera kluczowe zastrzeżenie: adres nie może być zablokowany w pliku robots.txt, ponieważ robot nie pobierze wtedy strony i nie zobaczy reguły noindex. Google przypomina też, że reguła noindex wpisana do pliku robots.txt nie jest obsługiwana.
Plik robots.txt działa odwrotnie. Zabrania pobierania, ale nie gwarantuje nieobecności w wynikach. Pomoc Search Console opisuje osobny stan „Strona zindeksowana, ale zablokowana przez plik robots.txt”: adres trafił do indeksu mimo blokady, zwykle dzięki linkom z innych witryn, a jego opis w wynikach jest bardzo ograniczony.
| Cecha | Reguła noindex | Blokada w robots.txt |
|---|---|---|
| Co robi | Usuwa stronę z wyników wyszukiwania | Zabrania robotowi pobierania strony |
| Czy robot odwiedza adres | Tak, musi pobrać stronę, aby odczytać regułę | Nie |
| Czy adres może być w wynikach | Nie, po ponownym odczytaniu strony przez robota | Tak, jeśli prowadzą do niego linki |
| Gdzie się ją ustawia | Znacznik meta w kodzie strony albo nagłówek X-Robots-Tag | Plik robots.txt w katalogu głównym domeny |
| Najlepsze zastosowanie | Sklep, w którym wyniki wyszukiwania już są w indeksie | Bardzo duży sklep, w którym robot traci czas na pobieranie wyników |
Którą metodę wybrać
W małym i średnim sklepie pierwszym wyborem jest noindex. Rozwiązuje on problem widoczny dla właściciela, czyli obecność stron wyników w Google. Koszt jest taki, że robot nadal odwiedza te adresy, aby regułę odczytać.
W bardzo dużych serwisach rachunek wygląda inaczej. W opracowaniu o zarządzaniu budżetem indeksowania Google wskazuje, że temat dotyczy przede wszystkim witryn mających ponad milion stron albo ponad 10 tys. stron z treścią zmienianą codziennie, i zastrzega, że są to wartości szacunkowe. Do ograniczania pobrań zaleca tam plik robots.txt, a odradza noindex, ponieważ robot i tak wysyła żądanie do strony, co zużywa czas przeznaczony na witrynę. Szerzej omawiamy to we wpisie o tym, których serwisów dotyczy budżet indeksowania.
Z obu dokumentów wynika rozsądna kolejność dla sklepu, który ma już wyniki wyszukiwania w indeksie: najpierw noindex i oczekiwanie, aż adresy znikną z wyników, a dopiero potem, jeśli skala tego wymaga, blokada w robots.txt. Odwrócenie kolejności utrwala problem, bo zablokowany robot nigdy nie odczyta reguły.
Jak wdrożyć zabezpieczenie stron wyników w sklepie
Zabezpieczenie polega na tym, aby każda strona wyników wyszukiwania, także pusta i także kolejne strony listy, zwracała regułę noindex, a sklep sam nie zachęcał robota do odwiedzania takich adresów. Pracę warto zacząć od ustalenia stanu obecnego, bo część systemów robi to bez udziału właściciela.
WordPress, WooCommerce i inne systemy
WordPress ma to zachowanie wbudowane. Dokumentacja dla programistów opisuje funkcję wp_robots_noindex_search, dostępną od wersji 5.7.0, która w trakcie wyszukiwania dopisuje do znacznika robots regułę noindex. Sklep na WooCommerce korzysta z tego mechanizmu, o ile motyw lub wtyczka nie usuwa standardowego znacznika i o ile wyszukiwarka nie została zastąpiona zewnętrznym rozwiązaniem działającym pod innym adresem. W sklepach na PrestaShop, Shopify i w systemach pisanych na zamówienie zachowanie zależy od szablonu i konfiguracji, dlatego nie należy niczego zakładać z góry.
Weryfikacja jest prosta: wystarczy wyszukać dowolne hasło w sklepie, otworzyć źródło strony w przeglądarce i odszukać znacznik meta o nazwie robots. Powinien wyglądać jak w pierwszym przykładzie poniżej. Jeśli znacznika nie ma albo zawiera wartość index, zmianę trzeba wprowadzić w szablonie strony wyników lub po stronie serwera.
<meta name="robots" content="noindex">

HTTP/1.1 200 OK
X-Robots-Tag: noindex
Blokada w robots.txt dla dużych sklepów
Jeżeli sklep jest duży, a strony wyników nie znajdują się już w indeksie, pobieranie można ograniczyć w pliku robots.txt. Zgodnie z opisem tego, jak Google interpretuje plik robots.txt, reguła dopasowuje adresy od początku ścieżki, gwiazdka oznacza dowolny ciąg znaków, a w ścieżkach wielkość liter ma znaczenie. Poniższy przykład blokuje katalog z wynikami oraz adresy z parametrem s i q; nazwy trzeba dostosować do własnego sklepu, a przed publikacją upewnić się na prawdziwych adresach, że wzorzec nie obejmuje stronicowania kategorii ani filtrów przeznaczonych do indeksowania.
User-agent: *
Disallow: /szukaj
Disallow: /*?s=
Disallow: /*&s=
Disallow: /*?q=
Disallow: /*&q=
Porządki wokół wyszukiwarki
Samo oznaczenie stron nie wystarczy, jeśli sklep nadal kieruje na nie robota. Adresy wyników nie powinny znajdować się w mapie witryny ani w stałych elementach nawigacji. Sekcję popularnych wyszukiwań lepiej zamienić na odnośniki do kategorii. Puste wyniki powinny mieć regułę noindex jak wszystkie pozostałe; dla kombinacji filtrów bez wyników Google zaleca kod 404 i takie samo rozwiązanie można rozważyć dla pustych wyników wyszukiwania. Podobne zasady dotyczą sortowania, co opisujemy we wpisie o parametrach w adresach sklepu.
Jak ustalić w Search Console, czy wyniki wyszukiwania są w indeksie
Odpowiedź daje raport „Indeksowanie stron” w Search Console, dostępny w menu po lewej stronie w grupie Indeksowanie pod pozycją Strony. Raport dzieli adresy na zindeksowane i niezindeksowane, a przy tych drugich podaje przyczynę. Wystarczy otworzyć listę zindeksowanych stron oraz kolejne przyczyny i poszukać w przykładowych adresach parametru wyszukiwarki sklepu.
Znaczenie poszczególnych stanów opisuje pomoc Google dotycząca raportu Indeksowanie stron. Dla wyszukiwarki wewnętrznej najważniejsze są cztery z nich.
| Stan w raporcie | Co oznacza dla stron wyników | Co z tym zrobić |
|---|---|---|
| URL zawiera tag „noindex” | Robot odczytał regułę i nie zindeksował strony | Nic, to stan pożądany |
| URL zablokowany przez plik robots.txt | Robot nie pobiera strony, ale adres nadal może trafić do indeksu | Obserwować, czy adresy nie pojawiają się w kolejnym stanie |
| Strona zindeksowana, ale zablokowana przez plik robots.txt | Adres jest w wynikach mimo blokady, z ograniczonym opisem | Zdjąć blokadę, wdrożyć noindex, poczekać na usunięcie |
| Pozorny błąd 404 | Puste wyniki zwracają kod 200 | Wdrożyć noindex lub kod 404 dla pustych wyników |
Drugim miejscem jest raport Skuteczność. Po dodaniu filtra strony z warunkiem, że adres zawiera parametr wyszukiwarki, widać, czy strony wyników zbierają wyświetlenia i kliknięcia z Google. Pojedynczy adres najwygodniej zbadać narzędziem do sprawdzania adresów URL, które pokazuje kod pobrany przez robota i pozwala potwierdzić, że reguła noindex jest w nim obecna; opisujemy je we wpisie o tym, jak czytać wynik sprawdzania adresu URL.
Po wdrożeniu reguły potrzebna jest cierpliwość. Google zaznacza, że robot musi ponownie pobrać stronę, aby zobaczyć nową regułę, i że w zależności od znaczenia strony może to potrwać nawet kilka miesięcy. Gdy pojedyncza strona musi zniknąć szybciej, pomocne są metody opisane we wpisie o usuwaniu strony z wyników Google.
Jeśli chcą Państwo zamówić pozycjonowanie sklepu internetowego, zachęcamy do kontaktu: tel. 222 500 844 lub mailowo: biuro@pozycjonowaniestron.pl
Jak mierzyć wyszukiwane hasła w Google Analytics
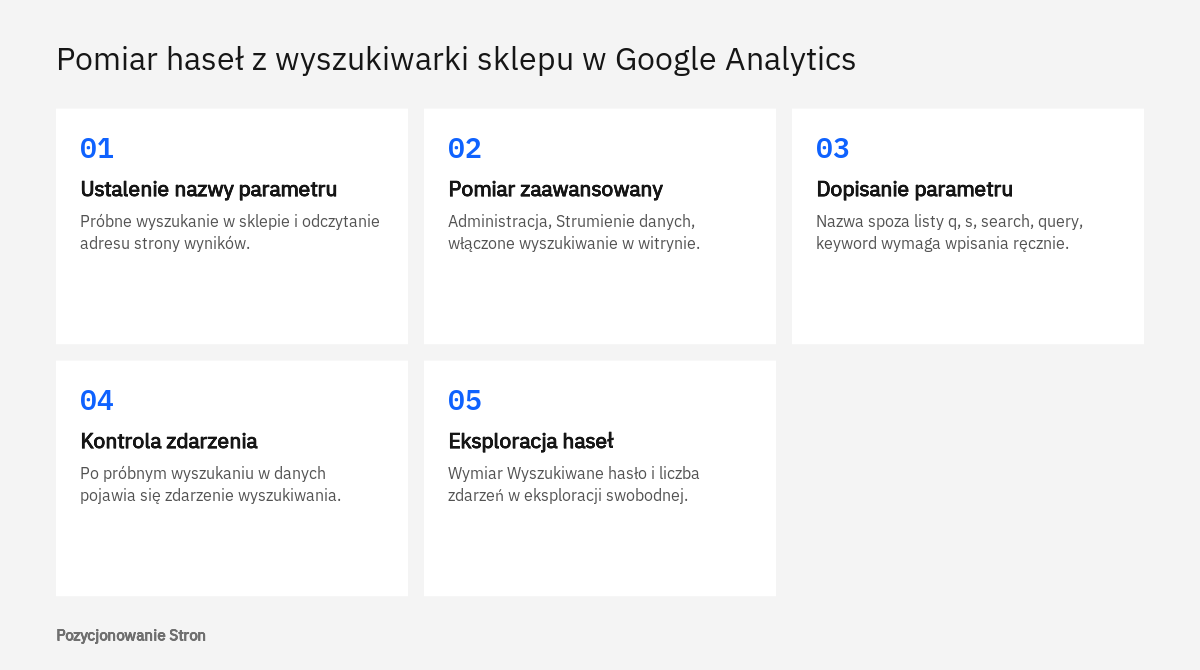
Google Analytics zapisuje wyszukiwania w sklepie jako zdarzenie view_search_results, a wpisane hasło jako parametr search_term, który zasila wymiar „Wyszukiwane hasło”. Dzieje się to bez dodatkowego kodu, pod warunkiem że włączony jest pomiar zaawansowany, a adres strony wyników zawiera parametr zapytania, który narzędzie potrafi rozpoznać.
Włączenie pomiaru zaawansowanego
Ustawienie znajduje się w panelu Administracja, w części „Zbieranie i modyfikowanie danych”, pod pozycją Strumienie danych. Po kliknięciu nazwy strumienia sklepu widać sekcję „Pomiar zaawansowany” z przełącznikiem, a ikona koła zębatego otwiera listę poszczególnych zdarzeń, w tym wyszukiwania w witrynie.
Zgodnie z pomocą Google o zdarzeniach objętych pomiarem zaawansowanym zdarzenie jest wysyłane za każdym razem, gdy użytkownik zobaczy stronę wyników, a rozpoznanie opiera się na obecności parametru zapytania w adresie. Domyślnie narzędzie szuka pięciu nazw: q, s, search, query i keyword. Sklep na WooCommerce, który używa parametru s, jest więc mierzony od razu. Jeżeli sklep stosuje inną nazwę, na przykład szukaj albo fraza, trzeba ją dopisać w ustawieniach zaawansowanych wyszukiwania w witrynie.
Wyszukiwarka, która nie zmienia adresu
Pomiar zaawansowany nie zadziała, gdy hasło nie pojawia się w adresie jako parametr: przy wynikach w wysuwanej warstwie albo przy adresach w rodzaju /szukaj/buty-trekkingowe/. Wtedy zdarzenie trzeba wysłać samodzielnie. Google przewiduje do tego zalecane zdarzenie search z wymaganym parametrem search_term, opisane w dokumentacji zalecanych zdarzeń. Wymiar „Wyszukiwane hasło” wypełnia się z obu zdarzeń tak samo.
gtag("event", "search", {
  search_term: "buty trekkingowe"
});
Gdzie odczytać hasła
Najwygodniej zrobić to w module Eksploruj. W nowej eksploracji swobodnej należy zaimportować wymiar „Wyszukiwane hasło”, który lista wymiarów i danych Analytics opisuje jako hasło użyte do wyszukiwania w witrynie lub aplikacji, oraz dane Liczba zdarzeń i Łączna liczba użytkowników. Wymiar trafia do wierszy, dane do wartości. Powstaje tabela haseł uporządkowana od najczęściej wpisywanych.
Standardowy pomiar nie mówi, czy klient cokolwiek znalazł. Aby odróżnić hasła z wynikami od haseł bez wyników, sklep musi sam przekazać liczbę znalezionych produktów jako dodatkowy parametr zdarzenia. W naszej praktyce właśnie lista haseł bez wyników okazuje się najbardziej przydatna.
Jak zamienić wyszukiwane hasła w kategorie, synonimy i treści
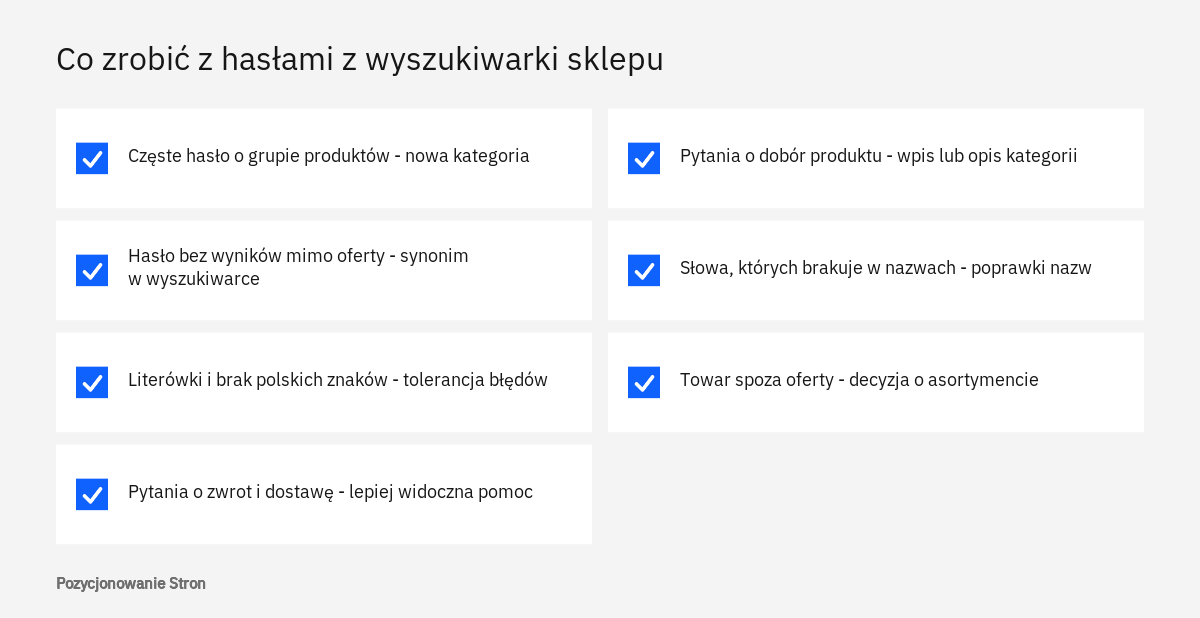
Lista haseł z wyszukiwarki sklepu to zapis tego, jak klienci nazywają produkty i czego nie potrafili znaleźć w menu. Każde często powtarzające się hasło można przypisać do jednej z czterech decyzji: nowa kategoria, nowy synonim w wyszukiwarce, nowa treść albo poprawka nazwy produktu. Przegląd warto robić regularnie, na przykład raz w miesiącu, na liście kilkudziesięciu najczęstszych haseł.
Hasła, które zasługują na kategorię
Jeżeli wiele osób wpisuje „prezent dla dziadka”, „buty do wody” albo „lampy do łazienki z czujnikiem”, a sklep ma pasujące produkty rozrzucone po kilku działach, jest to gotowy pomysł na kategorię lub stronę z wybranym filtrem. Taka strona ma stały adres, tytuł, opis i miejsce w nawigacji, a więc wszystko, czego brakuje stronie wyników. Sklep z wyposażeniem wnętrz z Poznania może w ten sposób odkryć, że klienci szukają produktów według pomieszczenia, podczas gdy menu układa je według rodzaju. Przed utworzeniem kategorii dobrze jest ustalić, czy podobne zapytania padają także w Google; pomaga w tym opisany przez nas dobór fraz dla sklepu internetowego, a o samej budowie strony piszemy we wpisie o opisie kategorii w sklepie.
Synonimy, odmiany i literówki
Druga grupa to hasła, dla których sklep ma produkty, ale wyszukiwarka ich nie pokazuje. Klient wpisuje „kanapa”, a w ofercie są wyłącznie „sofy”; wpisuje „adidasy”, a produkty nazywają się „obuwie sportowe”; pisze nazwę marki z błędem albo bez polskich znaków. Większość systemów sklepowych i wtyczek wyszukiwania pozwala zdefiniować pary synonimów oraz przekierować wybrane hasło prosto do kategorii.
Pytania, które wymagają treści
W wyszukiwarce sklepu padają też hasła, które nie dotyczą produktów: „zwrot”, „reklamacja”, „tabela rozmiarów”, „czas dostawy”, „jak dobrać długość kijków”. Pierwsze oznaczają, że informacje o obsłudze zamówienia są trudne do znalezienia i powinny być lepiej wyeksponowane. Ostatnie to tematy na strony pomocy i wpisy, które odpowiadają na pytania zadawane przed zakupem.
Poprawki nazw produktów
Hasła klientów pokazują wreszcie, jakich słów brakuje w nazwach. Jeśli kupujący dopisują do zapytań przeznaczenie, materiał albo rozmiar, a nazwy produktów składają się z symbolu producenta i kodu, sklep traci zarówno w wyszukiwarce wewnętrznej, jak i w Google. Zasady układania nazw opisujemy we wpisie o tym, jak ułożyć nazwę produktu pod zapytania kupujących. Powtarzające się zapytania o towar, którego sklep nie prowadzi, to z kolei argument w rozmowie o poszerzeniu asortymentu.
Dane z wyszukiwarki wewnętrznej należy czytać z umiarem. Pochodzą od osób, które już są w sklepie, więc nie pokazują popytu w całym internecie, a w małym sklepie liczby bywają zbyt niskie, aby wyciągać z nich pewne wnioski. Najlepiej zestawiać je z zapytaniami z raportu Skuteczność w Search Console, co jest stałym elementem naszej pracy przy pozycjonowaniu sklepów oraz przy analityce i raportowaniu SEO.
Typowe pomyłki i sytuacje, w których potrzebna jest pomoc
Najczęstszą pomyłką jest jednoczesne zastosowanie reguły noindex i blokady w robots.txt, przez co robot nie może odczytać reguły, a adresy pozostają w wynikach. Drugą jest uznanie, że skoro właściciel nie linkuje do wyników wyszukiwania, to Google ich nie zna. Pozostałe błędy dotyczą zwykle szczegółów wdrożenia i pomiaru.
Spotykamy regułę noindex ustawioną tylko na pierwszej stronie wyników, z pominięciem kolejnych stron listy, oraz mapy witryny zawierające adresy z hasłami. Po zmianie szablonu lub wtyczki wyszukiwania zabezpieczenie potrafi zniknąć bez ostrzeżenia, dlatego warto wracać do niego po każdej większej aktualizacji sklepu. Po stronie pomiaru typowe jest to, że parametr ma nazwę spoza domyślnej listy i nikt go nie dopisał, albo że dane są zbierane, lecz nikt ich nie przegląda.
- Każda strona wyników, także pusta i kolejne strony listy, zawiera regułę noindex.
- Adresy wyników nie są zablokowane w robots.txt, dopóki znajdują się w indeksie.
- Mapa witryny i stała nawigacja nie zawierają adresów z hasłami.
- Raport Indeksowanie stron nie pokazuje stron wyników wśród zindeksowanych.
- W strumieniu danych Analytics włączone jest wyszukiwanie w witrynie z właściwą nazwą parametru.
- Zdarzenie wyszukiwania pojawia się w danych po próbnym wyszukaniu.
- Hasła są przeglądane regularnie i przypisywane do konkretnych działań.
Samodzielnie da się zwykle ustalić stan obecny i włączyć pomiar. Wsparcie specjalisty przydaje się wtedy, gdy w indeksie są już tysiące stron wyników, gdy sklep działa na niestandardowym silniku, gdy reguły robots.txt mają objąć jednocześnie wyszukiwarkę, filtry i sortowanie, albo gdy w wynikach Google pojawiły się adresy z obcymi treściami. W takich przypadkach zaczynamy od audytu SEO, a zmiany w kodzie i konfiguracji serwera prowadzimy w ramach SEO technicznego. Nie obiecujemy przy tym określonych pozycji - porządek w indeksie usuwa przeszkody, ale o widoczności decyduje wiele czynników naraz.
Jeśli chcą Państwo zamówić pozycjonowanie sklepu internetowego, zachęcamy do kontaktu: tel. 222 500 844 lub mailowo: biuro@pozycjonowaniestron.pl
Najczęstsze pytania
Czy strony wyników wyszukiwania w sklepie mogą zaszkodzić widoczności w Google?
Mogą ją osłabiać pośrednio. Robot poświęca czas na adresy bez wartości, a strony wyników konkurują z kategoriami o te same zapytania. W małym sklepie skutki bywają niewielkie, w dużym potrafią być wyraźne.
Czy WordPress sam ustawia noindex na wynikach wyszukiwania?
Tak, od wersji 5.7.0 WordPress dopisuje regułę noindex do znacznika robots w trakcie wyszukiwania. Warto jednak potwierdzić to w źródle strony, ponieważ motyw, wtyczka lub zewnętrzna wyszukiwarka mogą zmienić to zachowanie.
Czy można zastosować jednocześnie noindex i blokadę w robots.txt?
Nie na tym samym adresie. Google wyjaśnia, że robot zablokowany w robots.txt nie pobierze strony i nie odczyta reguły noindex, więc adres może pozostać w wynikach. Najpierw stosuje się noindex, a blokadę ewentualnie dopiero po usunięciu stron z indeksu.
Jak długo strony wyników znikają z Google po wdrożeniu noindex?
Zależy to od tego, jak często robot wraca do danego adresu. Google podaje, że w zależności od znaczenia strony może to potrwać nawet kilka miesięcy. Postęp widać w raporcie Indeksowanie stron w Search Console.
Dlaczego w Google Analytics nie widać wyszukiwanych haseł?
Najczęściej dlatego, że adres strony wyników nie zawiera parametru z domyślnej listy albo wyszukiwarka nie zmienia adresu wcale. W pierwszym przypadku wystarczy dopisać nazwę parametru w ustawieniach pomiaru zaawansowanego, w drugim trzeba wysyłać zdarzenie search z parametrem search_term.
Czy z popularnego hasła warto zrobić stronę dostępną dla Google?
Tak, ale jako prawdziwą kategorię lub stronę z treścią, a nie przez odblokowanie strony wyników. Kategoria ma stały adres, opis i miejsce w nawigacji, czego stronie wyników brakuje.
Źródła
- Blokowanie indeksowania przez wyszukiwarki za pomocą tagu noindex, Centrum wyszukiwarki Google
- Jak Google interpretuje specyfikację pliku robots.txt, Google for Developers
- Sprawdzone metody projektowania struktury adresów URL na potrzeby witryn e-commerce, Centrum wyszukiwarki Google
- Zarządzanie indeksowaniem adresów URL nawigacji fasetowej, Google for Developers
- Zarządzanie budżetem indeksowania, Google for Developers
- Zasady dotyczące spamu w wyszukiwarce Google, Centrum wyszukiwarki Google
- Raport Indeksowanie stron, Pomoc Search Console
- Zdarzenia objęte pomiarem zaawansowanym, Pomoc Analytics
- Wymiary i dane Analytics, Pomoc Analytics
- Zalecane zdarzenia, Google for Developers
- Jak unikać przesyłania informacji umożliwiających identyfikację użytkowników, Pomoc Analytics
- wp_robots_noindex_search(), Developer.WordPress.org
Funkcje wyszukiwarek i asystentów AI zmieniają się szybko, dlatego wpis aktualizujemy po większych zmianach.