Parametry w adresie URL to dopiski po znaku zapytania, które jedne systemy wykorzystują do zmiany treści strony, a inne wyłącznie do pomiaru ruchu lub rozpoznania odwiedzającego. Każda kombinacja takich dopisków jest dla robota wyszukiwarki osobnym adresem, dlatego jedna podstrona potrafi mieć dziesiątki kopii. Poniżej opisujemy, jak rozpoznać rodzaje parametrów, gdzie sprawdzić skalę zjawiska i jakimi metodami doprowadzić adresy do porządku.
Czym są parametry w adresie URL i jak się je zapisuje
Parametr to para klucz i wartość dopisana do adresu po znaku zapytania. Wszystko, co stoi przed znakiem zapytania, wskazuje dokument na serwerze, a to, co po nim, przekazuje temu dokumentowi dodatkowe informacje: czego szuka odwiedzający, z jakiej kampanii przyszedł, w jakiej kolejności ustawić listę albo kim jest w rozumieniu systemu.
Część adresu od znaku zapytania do końca albo do znaku kratki. Składa się z par klucz=wartość połączonych znakiem &.
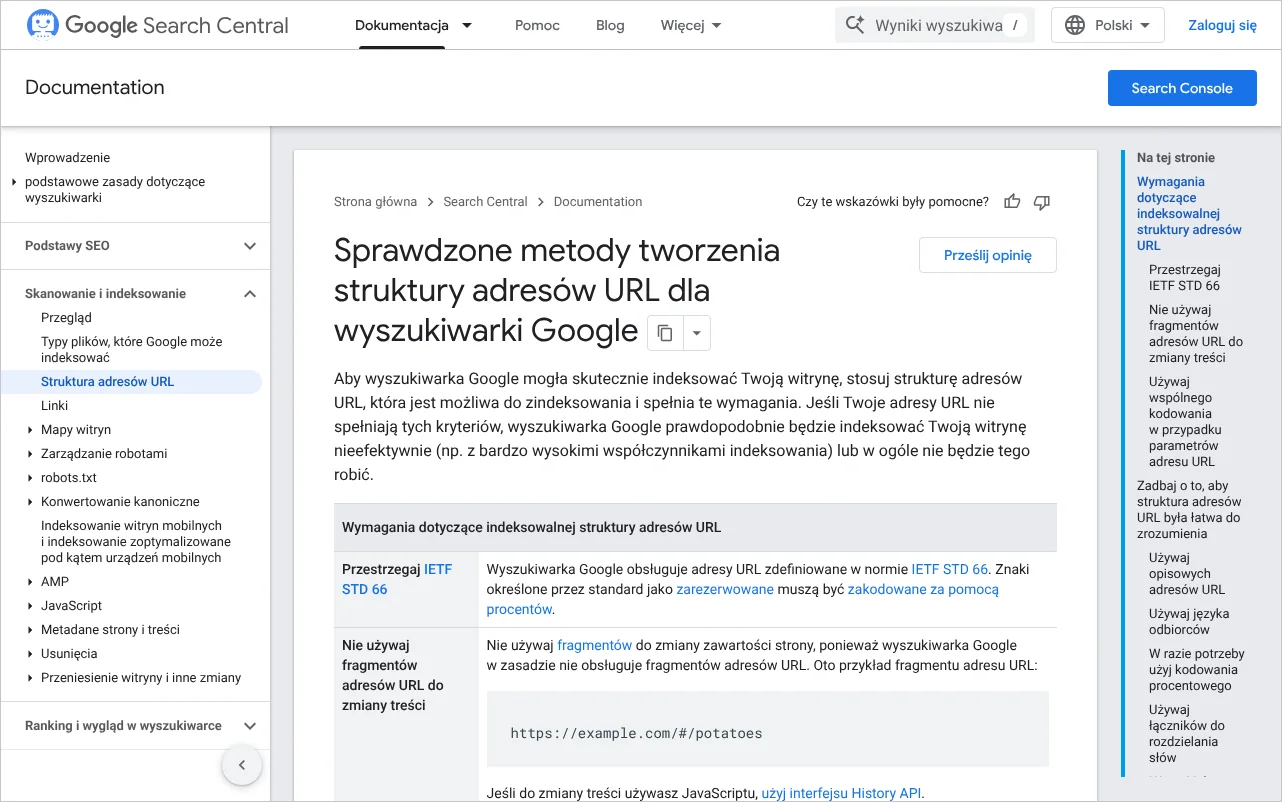
Google opisuje zalecany zapis w dokumencie o strukturze adresów URL. Znak równości oddziela klucz od wartości, znak & dodaje kolejny parametr, a kilka wartości jednego klucza wymienia się po przecinku. Zapisy niestandardowe, na przykład z dwukropkami i nawiasami kwadratowymi, dokumentacja wskazuje jako niezalecane. W wytycznych dotyczących filtrów Google dodaje, że przecinki, średniki i nawiasy często nie są rozpoznawane jako separatory parametrów.
Zalecany:
https://example.com/oferta?kategoria=sukienki&kolor=fioletowy,rozowy&sort=cena-rosnaco

Niezalecany:
https://example.com/oferta?[kategoria:sukienki][sort:cena-rosnaco]
Trzy cechy adresów mają tu praktyczne znaczenie. Wielkość liter jest rozróżniana, więc adres z wartością zapisaną wielką literą i ten sam adres z małą to dwa różne adresy. Część po znaku kratki, czyli fragment, nie służy do zmiany treści: Google co do zasady nie bierze fragmentów pod uwagę przy skanowaniu i indeksowaniu. Wreszcie dokumentacja zaleca skracanie adresów przez usuwanie parametrów, które niczego w treści nie zmieniają. Szersze zasady budowy ścieżek opisaliśmy we wpisie o strukturze adresów URL, tutaj zajmujemy się wyłącznie tym, co stoi po znaku zapytania.
Parametry nie są błędem samym w sobie. Kłopot zaczyna się wtedy, gdy nikt w firmie nie wie, jakie parametry serwis przyjmuje, kto je dopisuje i które z nich powinny być widoczne dla wyszukiwarki.
Parametry zmieniające treść i niezmieniające jej
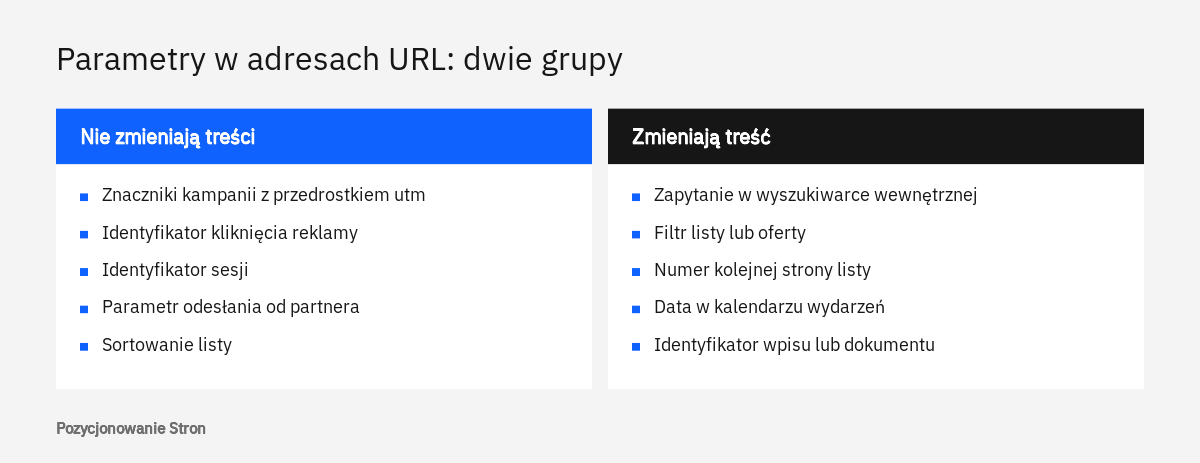
Najważniejszy podział jest prosty: parametr albo zmienia to, co odwiedzający widzi na stronie, albo nie zmienia niczego i służy wyłącznie systemom w tle. Od odpowiedzi na to pytanie zależy cała dalsza decyzja, bo dla parametrów bez wpływu na treść istnieje dokładnie jedna poprawna wersja strony, a dla parametrów zmieniających treść trzeba dopiero ustalić, czy powstała strona jest komukolwiek potrzebna w wynikach wyszukiwania.
Do grupy niezmieniającej treści należą znaczniki kampanii, identyfikatory kliknięć dopisywane przez systemy reklamowe, identyfikatory sesji i parametry odesłania. Dokumentacja Google wymienia jako przykłady parametrów nieistotnych między innymi klucze click, referrerid i ref, a także identyfikatory sesji i sortowanie. Do grupy zmieniającej treść należą zapytanie w wyszukiwarce wewnętrznej, filtr, numer strony listy, data w kalendarzu oraz identyfikator konkretnego wpisu w starszych systemach, w których cała treść serwisu jest wywoływana parametrem.
| Rodzaj parametru | Przykład | Czy zmienia treść | Typowe postępowanie |
|---|---|---|---|
| Kampanii | utm_source, utm_medium, utm_campaign | Nie | Adres kanoniczny do wersji bez parametrów, brak parametrów w linkach wewnętrznych |
| Identyfikator kliknięcia | gclid | Nie | Serwis musi go przyjąć i przekazać dalej, adres kanoniczny bez zmian |
| Sesji | sessionid, sid | Nie | Przeniesienie do plików cookie |
| Odesłania | ref, referrerid | Nie | Adres kanoniczny albo rezygnacja z parametru |
| Sortowania | sort, order | Tylko kolejność | Adres kanoniczny lub blokada skanowania przy dużej skali |
| Wyszukiwania wewnętrznego | q, szukaj | Tak | Blokada skanowania wyników |
| Kalendarza | d, m, y | Tak | Blokada skanowania lub ograniczenie zakresu dat |
| Identyfikator treści | id, p | Tak | Pozostawić albo zastąpić czytelną ścieżką i przekierować |
Sortowanie stoi pośrodku: zmienia kolejność elementów, ale nie ich zestaw, dlatego Google zalicza je do parametrów nieistotnych. W sklepach temat ma własną specyfikę, którą omówiliśmy osobno we wpisie o sortowaniu i parametrach w adresach sklepu. Zasady opisane niżej dotyczą każdej strony: wizytówki firmy usługowej, bloga, portalu czy serwisu z kalendarzem wydarzeń.
Jak parametry kampanii, sesji i wyszukiwarki tworzą duplikaty
Duplikat powstaje za każdym razem, gdy ta sama treść staje się dostępna pod kolejnym adresem, a robot ten adres pozna. Google wyjaśnia, że robot nie potrafi ocenić przydatności nowego adresu bez jego pobrania, więc najpierw odwiedza kolejne warianty, a dopiero potem stwierdza, że nic nowego w nich nie ma. Im więcej źródeł dopisków, tym więcej takich pustych odwiedzin.
Parametry kampanii i identyfikatory kliknięć
Parametry kampanii to znaczniki z przedrostkiem utm, które informują Google Analytics, skąd przyszedł odwiedzający. Pomoc Analytics wskazuje trzy, które należy podawać zawsze: utm_source (źródło), utm_medium (medium) i utm_campaign (nazwa kampanii). Pozostałe, w tym utm_id, utm_term i utm_content, są zalecane lub opcjonalne. Kolejność tych parametrów jest dla Analytics dowolna, natomiast wartości rozróżniają wielkość liter, dlatego pomoc zaleca małe litery i spójne nazewnictwo.
https://example.com/cennik/
https://example.com/cennik/?utm_source=newsletter&utm_medium=email&utm_campaign=wiosna
https://example.com/cennik/?gclid=123xyz
https://example.com/cennik/?ref=partner&sessionid=6EE2BF1AF6A3D705
Drugim źródłem są identyfikatory kliknięć. W Google Ads odpowiada za nie automatyczne tagowanie: po kliknięciu reklamy do adresu docelowego dopisywany jest parametr gclid, czyli identyfikator kliknięcia Google. Zgodnie z pomocą Google Ads funkcję włącza się w ustawieniach konta, w sekcji Automatyczne tagowanie, a strona docelowa musi przyjmować dowolne parametry i przy przekierowaniach przekazywać gclid do końcowego adresu. Z praktyki agencji wynika, że podobne identyfikatory dopisują także inne platformy reklamowe, serwisy społecznościowe i systemy do wysyłki wiadomości, często bez wiedzy właściciela strony.
Te adresy trafiają do wyszukiwarki różnymi drogami. Wystarczy, że ktoś skopiuje link z wiadomości i wklei go na forum, w mediach społecznościowych albo na własnej stronie. Weźmy hipotetyczną kancelarię z Krakowa, która co miesiąc wysyła klientom wiadomość z linkiem do aktualności. Każde wydanie ma inną nazwę kampanii, więc po roku w obiegu krąży kilkanaście wariantów adresu tej samej podstrony.
Identyfikatory sesji
Identyfikator sesji w adresie to rozwiązanie znane ze starszych systemów: serwer rozpoznaje odwiedzającego po długim ciągu znaków dopisanym do każdego linku. Dla robota oznacza to, że każda wizyta otwiera cały serwis od nowa pod świeżym zestawem adresów. Dokumentacja Google podaje ten przypadek jako typową przyczynę nadmiaru adresów i zaleca, by tam, gdzie to możliwe, zrezygnować z identyfikatorów sesji w adresie i zastąpić je plikami cookie.
Wyszukiwarka wewnętrzna i kalendarze
Wyszukiwarka wewnętrzna i kalendarz tworzą zbiory adresów bez końca, ponieważ liczba możliwych zapytań i dat jest nieograniczona. Każde słowo wpisane w pole wyszukiwania daje nowy adres, a kalendarz z linkiem do następnego miesiąca prowadzi robota w przyszłość bez żadnej granicy. Google opisuje dynamiczny kalendarz z parametrami dnia, miesiąca i roku jako źródło nieskończonej liczby linków i zaleca dodanie atrybutu nofollow do jego odnośników oraz blokowanie w pliku robots.txt adresów z wynikami wyszukiwania i innych nieskończonych przestrzeni. O stronach wyników w handlu internetowym piszemy we wpisie o wyszukiwarce w sklepie.
Dla hipotetycznego hydraulika z Łodzi z kilkunastoma podstronami skutki będą niewielkie: kilka zbędnych adresów w raportach. W serwisie z tysiącami podstron, kalendarzem szkoleń i wyszukiwarką te same mechanizmy potrafią wytworzyć więcej adresów z parametrami niż jest prawdziwych stron. Google podaje w wytycznych o budżecie indeksowania, że zagadnienie dotyczy głównie witryn bardzo dużych lub średnich z codziennie zmienianą treścią. Szerzej opisujemy to we wpisie o budżecie indeksowania.
Jak porządkować parametry po wycofaniu narzędzia z Search Console
Po wycofaniu narzędzia Parametry w URL-ach nie ma już w Search Console miejsca, w którym można by powiedzieć Google, co oznacza dany parametr. Wycofanie ogłoszono na blogu Centrum wyszukiwarki Google we wpisie o wiosennych porządkach. Dla właściciela strony oznacza to jedno: wyszukiwarka sama ocenia, które parametry mają znaczenie, a jedynym sposobem wpływania na tę ocenę są sygnały umieszczone w samym serwisie.
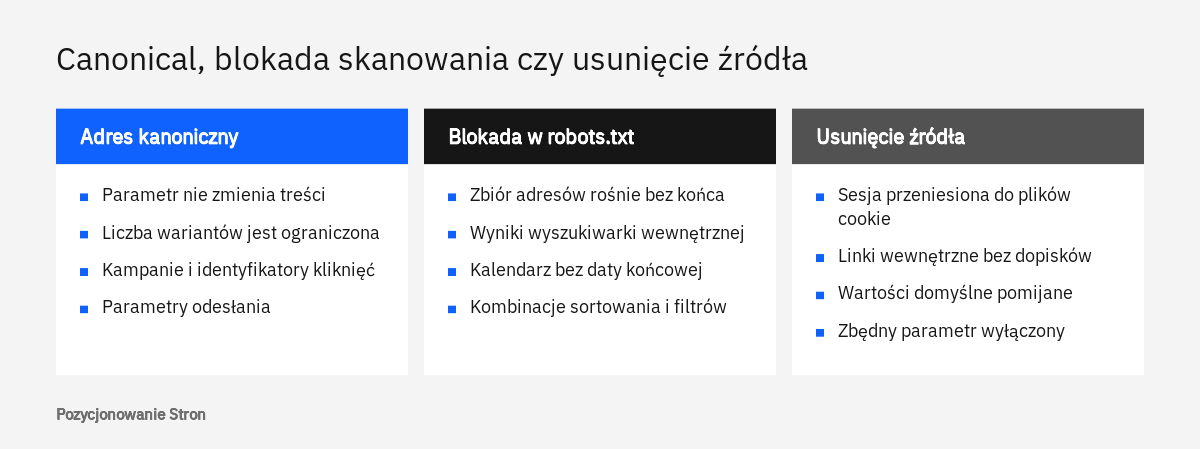
Tych sygnałów jest kilka i każdy działa inaczej. Dokumentacja Google dotycząca określania adresu kanonicznego porządkuje je według siły. Przekierowanie jest wyraźnym sygnałem, ale należy go używać tylko wtedy, gdy duplikat ma zostać wycofany. Znacznik rel=canonical, czyli wskazanie wersji podstawowej w kodzie strony lub w nagłówku HTTP, również jest wyraźnym sygnałem i nie zmienia niczego dla odwiedzającego. Mapa witryny jest sygnałem słabym: adresy w niej zawarte są jedynie propozycją. Osobną kategorią jest plik robots.txt, który nie wybiera wersji kanonicznej, tylko zamyka robotowi dostęp.
Najtrwalszy efekt daje jednak usunięcie źródła. Parametr, który nie jest potrzebny, najlepiej po prostu przestać generować, identyfikator sesji przenieść do plików cookie, a linki wewnętrzne poprowadzić wyłącznie do czystych adresów. Znaczniki i blokady służą do opanowania tego, czego usunąć się nie da.
Kiedy wystarczy canonical
Adres kanoniczny wystarcza wtedy, gdy parametr nie zmienia treści, a liczba wariantów jest ograniczona. Tak jest z parametrami kampanii, identyfikatorami kliknięć i parametrami odesłania: stron jest tyle samo co bez nich, przybywa jedynie wersji adresu. Wersja z dopiskiem powinna wskazywać w znaczniku rel=canonical wersję czystą i na tym zadanie się kończy.
Adres otwarty przez odwiedzającego:
https://example.com/cennik/?utm_source=newsletter&utm_medium=email&utm_campaign=wiosna

Znacznik w kodzie tej strony:
<link rel="canonical" href="https://example.com/cennik/">
Dokumentacja Google podaje kilka warunków poprawnego wdrożenia. Adres w znaczniku powinien być pełny, z protokołem i domeną. Nie należy wskazywać adresu z fragmentem po znaku kratki. Dla plików innych niż strony HTML, na przykład dokumentów PDF, to samo wskazanie można wysłać w nagłówku HTTP o nazwie Link. Linki wewnętrzne warto kierować do adresu uznanego za kanoniczny, bo spójność ułatwia wyszukiwarce odczytanie intencji. Szczegóły wdrożenia opisaliśmy we wpisie o adresie kanonicznym.
Najczęstsza usterka polega na tym, że system buduje znacznik z bieżącego adresu razem z ciągiem zapytania. Strona otwarta z parametrem kampanii wskazuje wtedy samą siebie jako wersję podstawową i każda kampania tworzy pełnoprawny duplikat. Kontrola zajmuje minutę: wystarczy otworzyć dowolną podstronę z dopisanym na końcu zmyślonym parametrem, wyświetlić źródło strony i odszukać wiersz z rel=canonical. Poprawny wynik to adres bez dopisku.
Dlaczego nie przekierowanie? Usunięcie parametrów kampanii przekierowaniem wyglądałoby schludnie, ale odebrałoby sens ich stosowania. Pomoc Google Ads wymaga, by gclid docierał do końcowej strony docelowej, a znaczniki kampanii muszą pozostać w adresie, pod którym strona została otwarta. Jeżeli w Państwa firmie pomiar kampanii przestał się zgadzać po zmianach na serwerze, od tego warto zacząć diagnozę. Zagadnienie od strony reklamowej omawiamy we wpisie o śledzeniu konwersji w Google Ads.
Canonical ma też granice. W wytycznych o filtrach Google zalicza go do sygnałów słabszych niż blokada: z czasem może ograniczyć skanowanie wariantów niekanonicznych, ale robot musi każdy z nich najpierw pobrać, żeby znacznik odczytać. Przy zbiorze, który rośnie bez końca, potrzebne jest inne narzędzie.
Jeśli chcą Państwo zamówić SEO techniczne, zachęcamy do kontaktu: tel. 222 500 844 lub mailowo: biuro@pozycjonowaniestron.pl
Kiedy potrzebna jest blokada skanowania
Blokada w pliku robots.txt jest potrzebna wtedy, gdy parametry tworzą zbiór adresów zbyt duży, by robot miał je w ogóle odwiedzać: wyniki wyszukiwarki wewnętrznej, kalendarz bez daty końcowej, kombinacje sortowania i filtrów. Dokumentacja o strukturze adresów wymienia dokładnie te przypadki jako nadające się do zablokowania. Blokada nie porządkuje duplikatów, tylko oszczędza robotowi i serwerowi pracy, której wynik i tak byłby bezużyteczny.
User-agent: *
Disallow: /*?*szukaj=
Disallow: /*?*sort=
Disallow: /kalendarz/*?*m=
Zapis opiera się na dwóch symbolach opisanych w dokumencie o tym, jak Google interpretuje plik robots.txt. Gwiazdka zastępuje dowolny ciąg znaków, a znak dolara oznacza koniec adresu. Wzorzec z gwiazdką przed i po znaku zapytania, taki sam jak w przykładzie Google dla filtrów, obejmuje parametr niezależnie od tego, czy stoi w adresie jako pierwszy, czy jako kolejny. Wielkość liter w ścieżkach ma znaczenie, a gdy reguły są sprzeczne, wygrywa ta o dłuższej ścieżce. Zasady pisania całego pliku zebraliśmy we wpisie o pliku robots.txt.
Blokada ma trzy skutki uboczne. Po pierwsze, robot nie zobaczy na zablokowanej stronie żadnego znacznika, więc łączenie blokady z rel=canonical albo noindex na tym samym adresie nie ma sensu. Po drugie, Google zastrzega, że zablokowany adres może mimo wszystko trafić do indeksu, bez treści, jeśli prowadzą do niego linki. Po trzecie, według wytycznych o budżecie indeksowania zwolniony czas robota nie przechodzi automatycznie na inne podstrony, chyba że witryna osiągnęła już granicę wydajności serwera.
Z tych samych wytycznych wynika, dlaczego noindex nie zastępuje blokady: robot nadal pobiera stronę z takim znacznikiem, po czym pomija ją w indeksie. Różnice między trzema mechanizmami rozpisaliśmy we wpisie canonical, noindex i robots.txt.
Zasady stałej kolejności parametrów
Stała kolejność oznacza, że serwis zawsze buduje adres z parametrami w tym samym porządku, bez względu na to, w jakiej kolejności odwiedzający klikał opcje. Dla serwera adres z kolorem przed rozmiarem i adres z rozmiarem przed kolorem to zwykle ta sama strona, ale jako ciągi znaków są to dwa różne adresy i robot pozna oba. Przy trzech parametrach możliwych ustawień jest sześć, przy czterech już dwadzieścia cztery, a treść pozostaje jedna.
Google formułuje tę zasadę wprost dla filtrów zapisanych w ścieżce: kolejność ma być zawsze taka sama, a ten sam filtr nie może się powtarzać. Rozciągnięcie jej na parametry po znaku zapytania jest naszą praktyką wdrożeniową i konsekwencją tego, że adresy różniące się choćby jednym znakiem są odrębne.
Porządek uzyskuje się na dwóch poziomach. Szablon generujący linki powinien układać parametry według ustalonej reguły, najprościej alfabetycznie według klucza. Serwer, który otrzyma adres w innej kolejności, powinien odpowiedzieć stroną ze znacznikiem kanonicznym wskazującym wersję uporządkowaną. Do tego dochodzą szczegóły, które mnożą adresy równie skutecznie jak kolejność.
- Parametry zawsze w tej samej kolejności, niezależnie od kolejności kliknięć.
- Klucze i wartości małymi literami, bez wariantów z wielką literą.
- Brak pustych parametrów, czyli klucza bez wartości na końcu adresu.
- Brak powtórzeń tego samego klucza w jednym adresie.
- Wartość domyślna pomijana: pierwsza strona listy i domyślne sortowanie nie potrzebują parametru.
- Jeden separator, znak &, we wszystkich częściach serwisu.
- Kod 404 dla kombinacji, które nie dają żadnych wyników, zamiast pustej strony z kodem 200.
Ostatni punkt pochodzi z wytycznych Google o filtrach: pusta lub nielogiczna kombinacja powinna zwracać stronę błędu pod tym samym adresem, bez przekierowania na ogólną stronę z komunikatem.
Jak sprawdzić, ile adresów z parametrami zna Google
Skalę zjawiska najszybciej pokazuje raport Indeksowanie stron w Search Console, uzupełniony o spis parametrów zebrany w samym serwisie. Raport pokazuje, które adresy Google zeskanował i zindeksował oraz z jakiego powodu pominął pozostałe. Adresy z parametrami gromadzą się zwykle w kilku przyczynach opisanych w pomocy Search Console.
Pierwsza z nich to Alternatywna strona zawierająca prawidłowy tag strony kanonicznej. Taki status oznacza, że adres poprawnie wskazuje wersję podstawową i ta wersja jest w indeksie, więc działania zwykle nie są potrzebne. Druga to Duplikat, użytkownik nie oznaczył strony kanonicznej: Google sam rozpoznał kopię i wybrał inną wersję, co jest sygnałem, że w serwisie brakuje znacznika. Trzecia, Duplikat, wyszukiwarka Google wybrała inną stronę kanoniczną niż użytkownik, wymaga uwagi, bo wyszukiwarka nie zgodziła się ze wskazaniem. Czwarta to URL zablokowany przez plik robots.txt. Osobno, w tabeli ostrzeżeń, może się pojawić pozycja Strona zindeksowana, ale zablokowana przez plik robots.txt, czyli przypadek, w którym zablokowany adres trafił do indeksu dzięki linkom.
- Przegląd przyczyn w raporcie
Po otwarciu raportu Indeksowanie stron warto wejść kolejno w każdą z wymienionych przyczyn i przejrzeć listę przykładowych adresów pod kątem znaku zapytania.
- Spis kluczy
Z przejrzanych adresów należy wypisać wszystkie klucze parametrów. To zwykle krótka lista, na której obok znanych pozycji pojawiają się takie, o których nikt w firmie nie słyszał.
- Ustalenie źródła
Przy każdym kluczu warto zanotować, kto go dopisuje: system reklamowy, narzędzie do wysyłki wiadomości, wtyczka, szablon czy własny kod serwisu.
- Test zmiany treści
Każdy klucz przechodzi prosty test: czy strona z parametrem różni się od strony bez niego. Wynik przypisuje parametr do jednej z dwóch grup.
- Kontrola pojedynczych adresów
Wybrane adresy warto wkleić w narzędzie do sprawdzania adresów URL, które pokazuje wersję kanoniczną zadeklarowaną przez serwis i wybraną przez Google.
Sposób czytania wyniku tej ostatniej kontroli opisujemy we wpisie o sprawdzaniu adresu URL w Search Console.
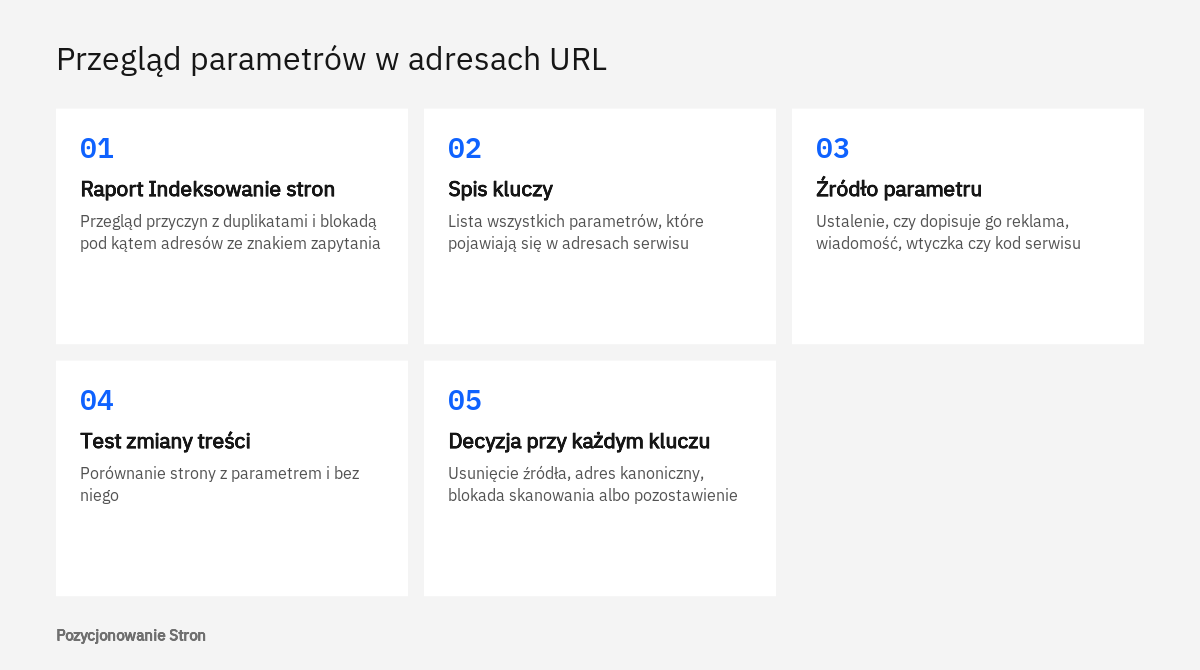
Gotowy spis jest podstawą decyzji. Przy każdym kluczu zapisuje się jedno z czterech rozstrzygnięć: usunąć źródło, wskazać wersję kanoniczną, zablokować skanowanie albo pozostawić jako pełnoprawną stronę. W ramach audytu SEO przygotowujemy taki spis jako osobną tabelę z zaleceniem dla programisty przy każdej pozycji.
Typowe pomyłki przy porządkowaniu parametrów
Większość kłopotów z parametrami bierze się z zastosowania dobrego narzędzia w złym miejscu. Poniżej zebraliśmy błędy, które najczęściej spotykamy podczas prac nad serwisami, razem z wyjaśnieniem, dlaczego szkodzą.
Pierwszym jest blokowanie wszystkich adresów ze znakiem zapytania jedną regułą. Zamyka ona robotowi drogę także do stron, które istnieją wyłącznie pod adresem z parametrem, oraz do wersji z dopiskami kampanii, na których stoi poprawny znacznik kanoniczny. Reguły powinny wymieniać konkretne klucze.
Drugim jest łączenie metod, które się wykluczają: blokada skanowania i znacznik na tej samej stronie albo mapa witryny zawierająca adresy z parametrami, podczas gdy znaczniki wskazują wersje czyste. Dokumentacja Google wprost odradza podawanie różnych adresów tej samej strony w różnych miejscach, a także używanie robots.txt, noindex i narzędzia do usuwania adresów jako sposobów wyboru wersji kanonicznej.
Trzecim są znaczniki kampanii w linkach wewnętrznych, na przykład na banerze na stronie głównej. Z naszej praktyki wynika, że taki zabieg zaburza obraz źródeł ruchu w analityce, a przy okazji podsuwa robotowi adres z parametrem na każdej odsłonie strony. Parametry kampanii są przeznaczone dla linków prowadzących do serwisu z zewnątrz. Konfigurację pomiaru prowadzimy w ramach usługi analityki i raportowania SEO.
Czwartym jest serwer, który odrzuca nieznane parametry stroną błędu albo gubi je przy przekierowaniu. Pomoc Google Ads opisuje ten przypadek jako powód, dla którego automatyczne tagowanie nie działa, i zaleca kontrolę przez kliknięcie własnej reklamy lub rozmowę z programistą. Firmy prowadzące kampanie Google Ads powinny testować to po każdej zmianie reguł przekierowań.
Kiedy potrzebna jest pomoc? Wtedy, gdy parametry generuje sam system i nie da się ich wyłączyć w ustawieniach, gdy raport pokazuje tysiące adresów z dopiskami, gdy serwis czeka migracja albo gdy po zmianach na serwerze przestał działać pomiar reklam. Kolejność wdrożeń ma wtedy znaczenie: najpierw znaczniki i linki wewnętrzne, dopiero potem ewentualne blokady. Tym zajmuje się nasz zespół w ramach usługi SEO technicznego.
Jeśli chcą Państwo zamówić SEO techniczne, zachęcamy do kontaktu: tel. 222 500 844 lub mailowo: biuro@pozycjonowaniestron.pl
Najczęstsze pytania
Czy parametry utm szkodzą pozycjom strony w Google?
Same w sobie nie, o ile strona otwarta z takim parametrem wskazuje w znaczniku kanonicznym wersję bez dopisków. Kłopot pojawia się wtedy, gdy znacznik powtarza pełny adres z parametrami albo gdy znaczniki kampanii stoją w linkach wewnętrznych.
Czy da się jeszcze ustawić znaczenie parametrów w Search Console?
Nie, narzędzie Parametry w URL-ach zostało wycofane. Obecnie Google sam ocenia rolę parametrów, a właściciel strony wpływa na tę ocenę znacznikami kanonicznymi, linkowaniem wewnętrznym, mapą witryny i regułami w pliku robots.txt.
Czy przekierować adresy z gclid na wersję bez parametru?
Nie jest to dobre rozwiązanie. Pomoc Google Ads wymaga, by identyfikator kliknięcia docierał do końcowej strony docelowej, więc przekierowanie obcinające parametr psuje pomiar konwersji. Wystarczy znacznik kanoniczny wskazujący czysty adres.
Kolejność parametrów w adresie ma znaczenie dla wyszukiwarki?
Dla serwera zazwyczaj nie, dla robota tak, ponieważ adresy różniące się kolejnością są odrębnymi ciągami znaków. Dlatego serwis powinien zawsze generować parametry w tym samym porządku. Dla znaczników kampanii w Analytics kolejność jest dowolna.
Co zrobić z identyfikatorem sesji w adresie?
Google zaleca, by w miarę możliwości zrezygnować z identyfikatorów sesji w adresach i zastąpić je plikami cookie. Jest to zmiana po stronie systemu, którą powinien przeprowadzić programista. Do czasu jej wdrożenia pomocny będzie znacznik kanoniczny wskazujący adres bez identyfikatora.
Czy mała strona firmowa musi się tym zajmować?
W ograniczonym zakresie. Przy kilkunastu podstronach wystarczy upewnić się, że znacznik kanoniczny nie powiela parametrów i że serwer nie gubi identyfikatorów reklamowych. Pełny przegląd ma sens, gdy serwis ma wyszukiwarkę, kalendarz albo rozbudowane listy.
Źródła
- Sprawdzone metody tworzenia struktury adresów URL dla wyszukiwarki Google, Centrum wyszukiwarki Google
- Jak określić kanoniczny URL za pomocą rel="canonical" i innych metod, Centrum wyszukiwarki Google
- Zarządzanie indeksowaniem adresów URL nawigacji fasetowej, Google for Developers
- Jak Google interpretuje specyfikację pliku robots.txt, Google for Developers
- Zarządzanie budżetem indeksowania, Google for Developers
- Wiosenne porządki: narzędzie Parametry w URL-ach, blog Centrum wyszukiwarki Google
- Kreatory adresów URL: zbieranie danych kampanii za pomocą niestandardowych adresów URL, Analytics - Pomoc
- Informacje o automatycznym tagowaniu, Google Ads - Pomoc
- Raport Indeksowanie stron, Search Console - pomoc
Funkcje wyszukiwarek i asystentów AI zmieniają się szybko, dlatego wpis aktualizujemy po większych zmianach.