Status „Strona zeskanowana, ale jeszcze niezindeksowana” oznacza, że Googlebot pobrał podstronę, a mimo to Google nie umieścił jej w indeksie. Nie jest to blokada techniczna, lecz wynik oceny: strona została obejrzana i na razie odłożona. Poniżej opisujemy, skąd bierze się taka decyzja, w jakiej kolejności szukać przyczyny i po jakim czasie można realnie oczekiwać zmiany.
Co dokładnie oznacza ten status
Status informuje o jednym: Google przeskanował stronę, ale jeszcze jej nie zindeksował. Pomoc Search Console dopowiada, że strona może trafić do indeksu później i że ponowne zgłaszanie adresu do skanowania nie jest potrzebne. To krótka definicja, ale wynika z niej więcej, niż widać na pierwszy rzut oka.
Po pierwsze, robot dotarł do adresu i pobrał jego zawartość. Odpadają więc przyczyny związane z dostępem: blokada w pliku robots.txt, błąd serwera czy brak jakiegokolwiek odnośnika, po którym Google mógłby trafić na stronę. Po drugie, strona nie została odrzucona z powodu wyraźnej instrukcji. Gdyby w kodzie znajdowała się dyrektywa noindex, raport pokazałby osobny status. Gdyby Google uznał stronę za kopię innej, również nazwałby to inaczej. Zostaje więc sytuacja, w której Google miał wszystko, czego potrzebował, i nie zdecydował się na dodanie strony.
Żeby zrozumieć, dlaczego to w ogóle możliwe, warto wiedzieć, jak wygląda droga strony do wyników. W dokumencie Jak działa wyszukiwarka Google opisane są trzy etapy: skanowanie, czyli pobranie strony, indeksowanie, czyli analiza treści i zapisanie informacji w indeksie, oraz wyświetlanie wyników. Między pobraniem a zapisaniem Google renderuje stronę, czyli uruchamia jej kod w aktualnej wersji przeglądarki Chrome, podobnie jak robi to zwykła przeglądarka. Dokument stwierdza przy tym jednoznacznie, że indeksowanie nie jest gwarantowane. Wśród możliwych powodów wymienia niską jakość treści, reguły w znaczniku meta robots zabraniające indeksowania oraz projekt strony, który indeksowanie utrudnia.
Etap, w którym Google analizuje pobraną stronę (tekst, tytuł, opisy obrazów, filmy) i zapisuje informacje o niej w swojej bazie. Dopiero strona zapisana w indeksie może pojawić się w wynikach wyszukiwania.
W dokumentacji dla dużych serwisów Google ujmuje to jeszcze krócej: nie wszystko, co zostało zeskanowane, trafi do indeksu, ponieważ po skanowaniu każda strona musi zostać oceniona, skonsolidowana i sprawdzona pod kątem przydatności. Omawiany status jest właśnie śladem tej oceny. Jeśli interesują Państwa pozostałe komunikaty z tego samego raportu, opisaliśmy je zbiorczo we wpisie o tym, dlaczego Google nie indeksuje strony. Tutaj zajmujemy się wyłącznie tym jednym.
Gdzie w Search Console znaleźć ten status i listę adresów
Status znajduje się w Google Search Console, w raporcie „Indeksowanie stron”, dostępnym w menu bocznym w grupie „Indeksowanie”, pod pozycją „Strony”. Strona podsumowania raportu pokazuje wykres oraz liczbę stron zindeksowanych i niezindeksowanych, a pod nim tabelę zatytułowaną „Dlaczego strony nie są indeksowane”. Każdy wiersz tej tabeli to jedna przyczyna. Wystarczy odszukać wiersz z nazwą omawianego statusu i go otworzyć.
Tabela ma kilka kolumn, które warto przeczytać uważnie. Kolumna „Przyczyna” to nazwa statusu. Kolumna „Źródło” wskazuje, czy problem leży po stronie Google, czy witryny. Kolumna „Weryfikacja” pokazuje, czy wcześniej poproszono o sprawdzenie poprawki i na jakim etapie jest ten proces. Przy wierszu widać także mały wykres, z którego da się odczytać, czy liczba adresów rośnie, czy maleje.
Po otwarciu wiersza pojawia się strona ze szczegółami: wykres liczby adresów z tym statusem w czasie oraz tabela przykładowych adresów. Tę listę warto czytać z jednym zastrzeżeniem. Według pomocy Search Console lista przykładów ma najwyżej 1000 wierszy, więc w większym serwisie nie pokaże wszystkich adresów. To próbka, a nie pełny spis.
Nad raportem znajduje się filtr map witryn. Domyślnie ustawiony jest na wszystkie znane strony, ale można przełączyć go na wszystkie przesłane strony, na strony nieprzesłane albo na jedną konkretną mapę. To bardzo przydatne ustawienie. Jeśli w mapie witryny znajdują się wyłącznie adresy, na których firmie zależy, widok ograniczony do przesłanych stron od razu oddziela ważne podstrony od przypadkowych adresów technicznych. Jak przygotować taki plik, opisaliśmy we wpisie o tym, co umieścić w mapie witryny XML.
Drugim miejscem jest narzędzie do sprawdzania adresów URL, czyli pasek wyszukiwania u góry Search Console. Po wpisaniu pełnego adresu podstrony pojawia się wynik z sekcją „Indeksowanie stron”. Znajdują się w niej informacje o tym, skąd Google zna adres (mapy witryn i strona odsyłająca), kiedy odbyło się ostatnie skanowanie, jakim robotem, czy skanowanie i indeksowanie są dozwolone, czy pobranie się powiodło oraz jaki adres kanoniczny zadeklarował właściciel, a jaki wskazał Google. Do tych pól wrócimy przy kolejności sprawdzania. Samo narzędzie omówiliśmy szerzej we wpisie o tym, jak czytać wynik sprawdzania adresu URL.
Czym ten status różni się od podobnie brzmiących komunikatów
Od pozostałych komunikatów odróżnia go to, że Google stronę faktycznie pobrał i nie podał konkretnego powodu odrzucenia. Najłatwiej pomylić go ze statusem „Strona wykryta - obecnie niezindeksowana”, a to zupełnie inna sytuacja, która wymaga innych działań.
| Status w raporcie | Co się wydarzyło | Gdzie szukać przyczyny |
|---|---|---|
| Strona zeskanowana, ale jeszcze niezindeksowana | Google pobrał stronę i jej nie zindeksował | Treść, podobieństwo do innych podstron, linkowanie wewnętrzne, obraz strony po wyrenderowaniu |
| Strona wykryta - obecnie niezindeksowana | Google zna adres, ale jeszcze go nie pobrał, często dlatego, że odłożył skanowanie, aby nie przeciążać witryny | Wydajność serwera, liczba adresów w serwisie, kolejność skanowania |
| Duplikat, użytkownik nie oznaczył strony kanonicznej | Google uznał stronę za kopię innej i sam wskazał wersję główną | Adresy kanoniczne, przekierowania, zróżnicowanie treści |
| Pozorny błąd 404 | Strona wygląda jak informacja o braku treści, ale serwer nie zwraca kodu 404 | Puste strony, kody odpowiedzi serwera |
Rozróżnienie ma znaczenie praktyczne. Przy statusie „wykryta” praca dotyczy głównie tego, czy robot ma czas i możliwość pobrania adresów, o czym piszemy we wpisie o budżecie indeksowania. Przy statusie „zeskanowana” robot już był, więc przyspieszanie skanowania niczego nie zmieni. Trzeba zająć się tym, co zastał.
Dlaczego Google pobrał stronę i nie dodał jej do indeksu
Google nie podaje przy tym statusie konkretnego powodu, dlatego przyczynę trzeba ustalić samodzielnie. Z dokumentacji wynikają cztery obszary, które warto zbadać: podobieństwo treści do innych stron, wartość samej treści, miejsce podstrony w strukturze serwisu oraz to, co Google widzi po wyrenderowaniu.
Treść zbyt podobna do innych podstron
Google grupuje strony o podobnej treści i z każdej grupy wskazuje jedną, najbardziej reprezentatywną, którą nazywa kanoniczną. To ona może pojawiać się w wynikach, a pozostałe traktowane są jako wersje alternatywne. Gdy podobieństwo jest oczywiste, raport pokazuje jeden ze statusów z duplikatem w nazwie. Z naszej praktyki wynika jednak, że podstrony różniące się tylko drobnym fragmentem często trafiają właśnie do omawianego statusu: nie są dosłowną kopią, ale nie wnoszą też nic, czego nie byłoby pod sąsiednim adresem.
Dla ilustracji: hipotetyczny sklep z Poznania sprzedaje ten sam model butów w dwunastu kolorach i każdy kolor ma osobną kartę z identycznym opisem, w którym zmienia się jedno słowo. Inny hipotetyczny przykład to hydraulik z Łodzi, który przygotował po jednej podstronie dla każdej dzielnicy, kopiując ten sam tekst i podmieniając nazwę. W obu przypadkach Google otrzymuje wiele adresów o niemal jednakowej zawartości. Skąd biorą się takie powtórzenia, opisujemy we wpisie o duplikacji treści w serwisie.
Mała wartość treści
Dokumentacja Google wymienia niską jakość treści jako jeden z powodów, dla których strona może nie zostać zindeksowana. Trudno to zmierzyć jedną liczbą, ale Google podaje pytania pomocnicze w dokumencie Tworzenie treści przydatnych, rzetelnych i ukierunkowanych na użytkowników. Warto zadać je sobie przy każdej podstronie z listy: czy zawiera oryginalne informacje lub analizy, czy opisuje temat w sposób pełny, czy wnosi coś szczególnego w porównaniu z innymi stronami w wynikach, czy nie powstała seryjnie i czy nie służy głównie przyciąganiu wizyt z wyszukiwarki.
W praktyce do tej grupy należą karty produktów z dwoma zdaniami opisu przepisanymi od producenta, strony tagów zawierające jeden wpis, puste kategorie oraz podstrony usług złożone z nagłówka i formularza. Żadna z nich nie jest błędna technicznie. Trudno jednak wskazać pytanie, na które właśnie ta strona odpowiada lepiej niż inne.
Słabe linkowanie wewnętrzne
Google zaleca, aby każda strona, na której właścicielowi zależy, miała prowadzący do niej link z co najmniej jednej innej strony w tej samej witrynie. Dokument Sprawdzone metody dotyczące linków dodaje, że linki wewnętrzne pomagają zrozumieć strukturę witryny.
Podstrona, o której Google wie wyłącznie z mapy witryny, została pobrana, ale serwis w żaden sposób nie pokazuje, że jest ważna. Z naszych obserwacji wynika, że adresy bez odnośników z menu, kategorii i treści innych podstron trafiają do tego statusu częściej niż strony dobrze osadzone w strukturze. Zaznaczamy, że to obserwacja z praktyki, a nie reguła zapisana w dokumentacji.
Osobną sprawą jest forma odnośników. Google rozpoznaje link tylko wtedy, gdy jest on elementem a z atrybutem href zawierającym prawdziwy adres. Odnośnik działający wyłącznie dzięki skryptowi może zostać pominięty.
<!-- poprawnie: element a z adresem w atrybucie href -->
<a href="/uslugi/udraznianie-rur/">Udrażnianie rur</a>

<!-- ryzykownie: brak adresu, przejście obsługuje wyłącznie skrypt -->
<span onclick="przejdz('udraznianie-rur')">Udrażnianie rur</span>
Problemy z renderowaniem
Jeśli treść nie jest widoczna w wyrenderowanym kodzie HTML, Google nie może jej zindeksować. Tak stanowi dokument JavaScript a SEO - podstawy. Strona, która w przeglądarce klienta wygląda na kompletną, dla Google może być niemal pusta, jeżeli opisy, listy produktów lub opinie dociągane są skryptem, który się nie wykonał.
Google nie renderuje kodu JavaScript z plików zablokowanych w robots.txt, więc zablokowanie katalogu ze skryptami może odebrać stronie całą treść. Ta sama dokumentacja przypomina, że renderowanie po stronie serwera nadal jest bardzo użyteczne, ponieważ przyspiesza stronę i nie każdy robot potrafi wykonać JavaScript. Cały proces opisaliśmy we wpisie o tym, jak Google skanuje i renderuje strony w JavaScripcie.
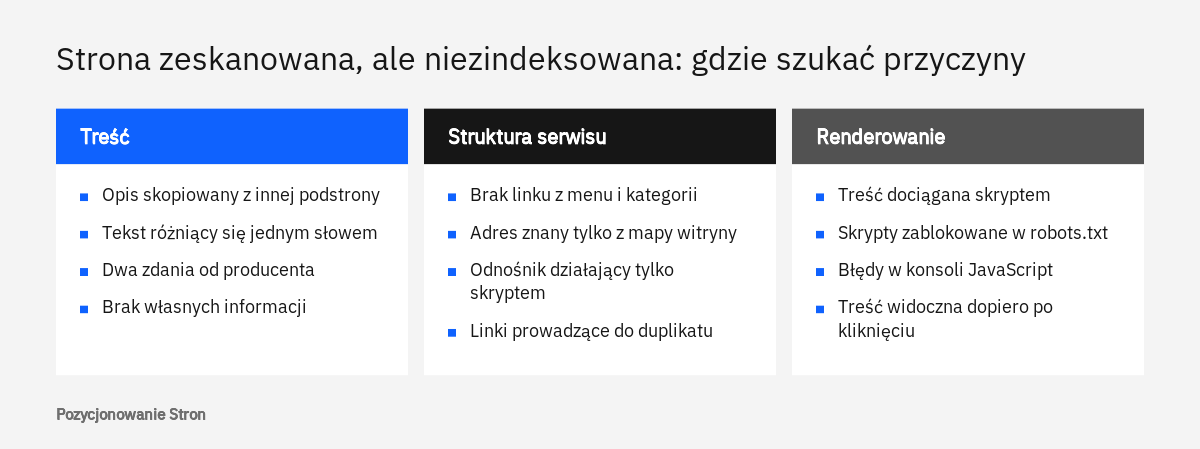
Trzy pierwsze obszary dotyczą decyzji redakcyjnych i struktury serwisu, a tylko czwarty jest ściśle techniczny. Dlatego sama poprawka w kodzie rzadko wystarcza, jeśli strona pozostaje podobna do dziesięciu innych.
Kiedy ten status nie jest problemem
Status nie jest problemem wtedy, gdy dotyczy adresów, których i tak nikt nie powinien szukać w Google. Pomoc Search Console mówi o tym wprost: celem nie jest zindeksowanie wszystkich adresów, lecz kanonicznych wersji ważnych stron. Duplikaty i strony o niewielkiej wartości mogą pozostać poza indeksem.
Z naszej praktyki wynika, że na liście przykładów często znajdują się adresy kanałów RSS, wyniki wewnętrznej wyszukiwarki, kolejne strony archiwów, adresy z parametrami sortowania i filtrowania oraz dawno wyprzedane produkty. Ich obecność pod tym statusem nie wymaga reakcji, o ile nie są to adresy, na które firma liczy. Gdy jest ich bardzo dużo, warto zastanowić się, czy serwis nie tworzy ich bez potrzeby, o czym piszemy we wpisach o parametrach w adresach URL i o nawigacji fasetowej w sklepie.
Druga sytuacja to świeżo opublikowane strony. Sam status zawiera słowo „jeszcze”, a pomoc Search Console dopuszcza, że strona zostanie zindeksowana później. Nowy wpis czy nowa karta produktu mogą przez pewien czas widnieć na tej liście i zniknąć z niej bez żadnego działania.
Powód do pracy pojawia się w trzech przypadkach: gdy pod statusem znajdują się strony przynoszące zapytania lub sprzedaż, gdy liczba adresów na wykresie rośnie z tygodnia na tydzień albo gdy status obejmuje całą grupę podstron tego samego typu. Ocenę warto zaczynać od pytania, które adresy są na liście, a nie ile ich jest: pięć niezindeksowanych podstron ofertowych to poważniejsza sprawa niż pięćset adresów kanałów RSS.
Jeśli chcą Państwo zamówić audyt SEO, zachęcamy do kontaktu: tel. 222 500 844 lub mailowo: biuro@pozycjonowaniestron.pl
W jakiej kolejności szukać przyczyny
Najrozsądniej zacząć od tego, co da się sprawdzić w kilka minut i co wyklucza całe grupy przyczyn, a dopiero potem przejść do oceny treści, która wymaga więcej czasu.
- Podział listy adresów na ważne i zbędne
Pomaga w tym filtr map witryn ustawiony na przesłane strony. Adresy techniczne, które nie muszą być w Google, odkłada się na bok. Dalsza praca dotyczy tylko podstron, na których firmie zależy.
- Szukanie wzoru
Warto pogrupować pozostałe adresy według typu: karty produktów, kategorie, wpisy, podstrony usług, podstrony miast. Jeśli status dotyczy głównie jednej grupy, przyczyna prawdopodobnie tkwi w jej szablonie lub w sposobie przygotowania tekstów.
- Odczytanie wyniku w narzędziu do sprawdzania adresów URL
Dla dwóch lub trzech adresów z każdej grupy należy odczytać datę ostatniego skanowania, informację o stronie odsyłającej i mapach witryn oraz oba adresy kanoniczne. Stara data skanowania oznacza, że Google oceniał wersję sprzed ewentualnych zmian. Adres kanoniczny wskazany przez Google inny niż zadeklarowany sugeruje podobieństwo do innej podstrony.
- Test wersji opublikowanej
W tym samym narzędziu dostępny jest test, który pobiera stronę na bieżąco. Po jego zakończeniu można otworzyć podgląd przetestowanej strony: zwrócony kod HTML, zrzut ekranu, listę załadowanych zasobów i komunikaty konsoli JavaScript. Trzeba sprawdzić, czy w kodzie znajduje się właściwa treść strony oraz czy żaden ważny zasób nie został zablokowany.
- Porównanie treści z sąsiednimi podstronami
Na końcu pozostaje ocena, której nie wykona żadne narzędzie: zestawienie niezindeksowanej podstrony z podobną, zindeksowaną stroną z tego samego serwisu. Pytanie brzmi, co ta strona daje czytelnikowi ponad to, co już jest dostępne.
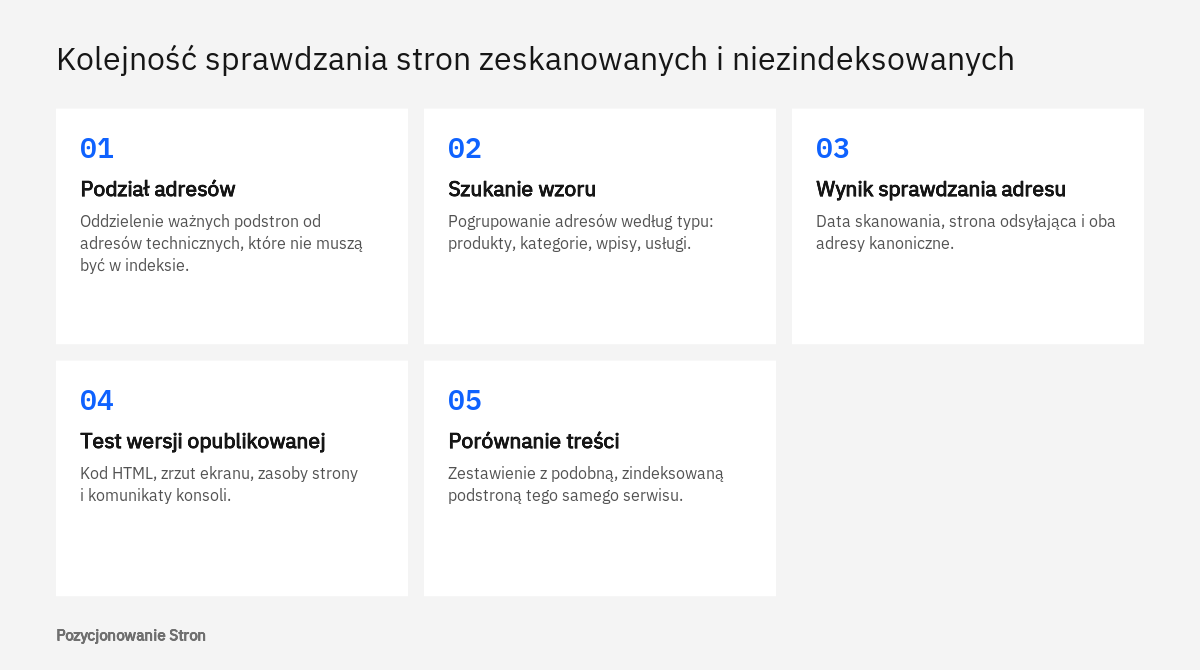
Przyczyny techniczne warto wykluczyć przed pracą nad tekstami, bo przepisywanie treści, której Google nie widzi po wyrenderowaniu, byłoby stratą czasu. Pomoc Search Console zastrzega przy tym, że test wersji opublikowanej nie pokazuje wszystkich możliwych problemów i nie daje gwarancji zindeksowania.
Plan naprawy zależnie od ustalonej przyczyny
Naprawę dobiera się do przyczyny, a nie do statusu, dlatego nie istnieje jedna czynność, która zadziała zawsze.
Gdy podstrony są do siebie zbyt podobne
Są dwie drogi i wybór między nimi zależy od tego, czy osobne adresy są klientom potrzebne. Jeśli nie są, podstrony warto połączyć w jedną, pełniejszą. Google opisuje metody wskazywania wersji głównej w dokumencie o określaniu kanonicznego adresu URL: najsilniejszym sygnałem jest przekierowanie, silnym element rel="canonical", a słabym obecność adresu w mapie witryny. Ten sam dokument zaleca, aby linki wewnętrzne prowadziły do adresu kanonicznego, a nie do duplikatu, oraz odradza używanie do tego celu pliku robots.txt i dyrektywy noindex. Szczegóły wdrożenia opisaliśmy we wpisie o adresie kanonicznym.
Jeśli osobne adresy są potrzebne, każda podstrona musi dostać własną treść. W hipotetycznym przykładzie hydraulika z Łodzi oznaczałoby to opisanie tego, co daną dzielnicę rzeczywiście wyróżnia: rodzaju zabudowy i typowych instalacji, czasu dojazdu, zakresu prac. Jeżeli takich różnic nie da się uczciwie wskazać, lepsza jest jedna dobra podstrona usługi z listą obsługiwanych dzielnic.
Gdy treść wnosi zbyt mało
Możliwe są trzy decyzje: rozbudowa, połączenie albo usunięcie. Rozbudowa ma sens, gdy strona odpowiada na realne pytanie klientów, tylko robi to zbyt pobieżnie. Karta produktu zyskuje na własnym opisie, parametrach i odpowiedziach na pytania kupujących, a podstrona usługi na opisie przebiegu i zakresu prac. Strony bez żadnej roli, jak puste tagi, można usunąć. Przygotowaniem tekstów zajmujemy się w ramach usługi treści SEO.
Gdy do podstrony nie prowadzą linki
Ważna podstrona powinna być osiągalna z nawigacji lub ze strony kategorii, a oprócz tego mieć odnośniki z treści powiązanych tematycznie podstron. Dla hipotetycznej kancelarii z Krakowa, która opublikowała nową podstronę o konkretnej specjalizacji, byłoby to dopisanie jej do menu usług i podlinkowanie z powiązanych wpisów na blogu.
Gdy Google nie widzi treści po wyrenderowaniu
Zakres prac zależy od tego, co pokazał test wersji opublikowanej. Zablokowane zasoby wymagają poprawienia pliku robots.txt, o czym piszemy we wpisie o tym, jak napisać plik robots.txt. Błędy w konsoli JavaScript trzeba przekazać programiście. Jeśli najważniejsza treść jest dociągana dopiero po działaniu użytkownika, warto przenieść ją do kodu zwracanego przez serwer. Takie prace wykonujemy w ramach SEO technicznego.
- Ważne podstrony są oddzielone od adresów technicznych, które nie muszą być w indeksie.
- Każda ważna podstrona ma własną treść, której nie ma pod innym adresem serwisu.
- Do każdej ważnej podstrony prowadzi co najmniej jeden zwykły link z innej strony witryny.
- Adres kanoniczny zadeklarowany na stronie zgadza się z adresem w mapie witryny i w linkach wewnętrznych.
- W kodzie HTML z testu wersji opublikowanej widać pełną treść strony.
Ile trwa poprawa i jak zgłosić zmiany do Google
Na efekt trzeba poczekać od kilku dni do kilku tygodni od wprowadzenia zmian. Taki przedział podaje Google w dokumencie Zgłaszanie do Google prośby o ponowne zindeksowanie adresów URL. Ten sam dokument zastrzega, że prośba nie gwarantuje dodania strony do indeksu oraz że systemy Google najszybciej uwzględniają treści wysokiej jakości, przydatne dla użytkowników.
Zmiany można zgłosić na trzy sposoby. Pierwszy to prośba o zindeksowanie pojedynczego adresu w narzędziu do sprawdzania adresów URL. Obowiązuje w nim dzienny limit zgłoszeń, dlatego nadaje się do kilku najważniejszych podstron. Drugi to mapa witryny, zalecana przy większej liczbie adresów. Google regularnie ją odczytuje, a przy zaktualizowanych stronach radzi podawać datę ostatniej modyfikacji w znaczniku lastmod. Trzeci to weryfikacja poprawki w samym raporcie „Indeksowanie stron”, uruchamiana przyciskiem na stronie szczegółów statusu.
Weryfikacja przebiega etapami. Search Console najpierw sprawdza kilka stron. Jeśli problem nadal na nich występuje, proces kończy się niepowodzeniem. W przeciwnym razie sprawdzane są kolejne znane adresy, a każdy otrzymuje stan „Oczekuje”, „Powodzenie”, „Niepowodzenie” lub „Inne”. Według pomocy Search Console trwa to zwykle do około dwóch tygodni, czasem dłużej, a w trakcie nie należy uruchamiać weryfikacji ponownie. Rozpoczęcie jej ma sens dopiero po poprawieniu wszystkich adresów z danej grupy.
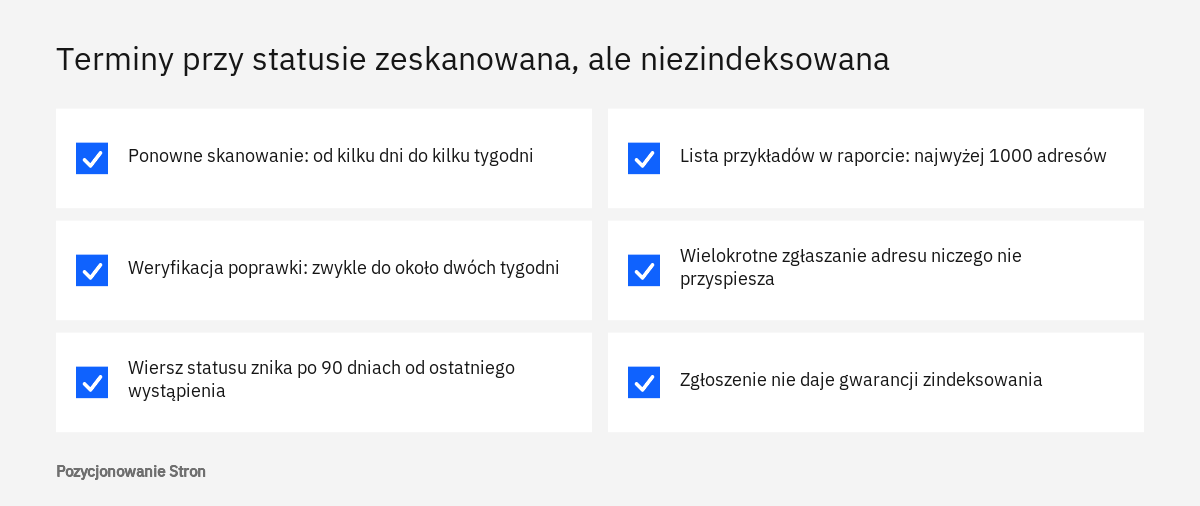
Warto też wiedzieć, jak zachowuje się sam raport. Liczba adresów pod statusem aktualizuje się wtedy, gdy Google ponownie przetworzy daną stronę, więc wykres nie zmienia się z dnia na dzień. Wiersz statusu pozostaje w tabeli jeszcze przez 90 dni od usunięcia ostatniego wystąpienia, dlatego jego obecność z zerową liczbą stron nie oznacza, że problem wrócił.
Przy dużych grupach adresów rozsądnie jest oceniać kierunek zmian na wykresie po kilku tygodniach, a nie stan pojedynczych stron po kilku dniach. Nie potrafimy podać terminu, po którym poprawa jest pewna: decyzja o indeksowaniu należy do Google.
Typowe pomyłki i sytuacje, w których potrzebna jest pomoc
Najczęstszą pomyłką jest wielokrotne zgłaszanie tego samego adresu do indeksowania bez wprowadzenia jakiejkolwiek zmiany. Google pisze wprost, że przesłanie wielu próśb dotyczących jednego adresu nie przyspiesza indeksowania. Skoro strona została już pobrana i oceniona, kolejne pobranie tej samej zawartości trudno uznać za powód do innej oceny.
Druga pomyłka to nakładanie dyrektywy noindex lub blokady w robots.txt na adresy z listy tylko po to, aby „wyczyścić” raport. Adresy znikną z tego wiersza, ale pojawią się pod innym statusem, a sytuacja serwisu się nie zmieni. Różnice między tymi mechanizmami wyjaśniamy we wpisie o tym, czym różnią się canonical, noindex i robots.txt.
Trzecia pomyłka to dopisywanie tekstu dla samej długości. Akapit ogólników doklejony do stu kart produktów nie czyni ich mniej podobnymi do siebie, a wręcz zwiększa wspólną część. Kolejne to ocenianie strony wyłącznie w przeglądarce, bez porównania z kodem z testu wersji opublikowanej, oraz traktowanie każdego adresu z listy jako awarii i poświęcanie czasu stronom, które w indeksie być nie muszą.
Pomoc z zewnątrz jest uzasadniona, gdy status obejmuje całe grupy stron sprzedażowych, gdy liczba adresów rośnie mimo wprowadzonych zmian, gdy problem pojawił się po przebudowie lub migracji serwisu albo gdy przyczyna leży w szablonie i jej usunięcie wymaga pracy programisty. Rozsądnym początkiem jest wtedy audyt SEO, który obejmuje jednocześnie technikę, strukturę i treść. Zaznaczamy przy tym uczciwie, że audyt wskazuje przyczyny i kolejność prac, ale nie daje gwarancji zindeksowania konkretnego adresu.
Jeśli chcą Państwo zamówić audyt SEO, zachęcamy do kontaktu: tel. 222 500 844 lub mailowo: biuro@pozycjonowaniestron.pl
Najczęstsze pytania
Czy status „Strona zeskanowana, ale jeszcze niezindeksowana” to kara od Google?
Nie. To informacja o stanie konkretnego adresu: Google go pobrał i na razie nie dodał do indeksu. Pomoc Search Console zaznacza, że większość witryn ma pewną liczbę niezindeksowanych stron.
Czy prośba o zindeksowanie w Search Console rozwiąże problem?
Sama prośba zwykle nie wystarcza, jeśli strona nie została zmieniona. Google wskazuje, że zgłoszenie nie gwarantuje indeksowania, a wielokrotne zgłaszanie tego samego adresu niczego nie przyspiesza. Prośba ma sens po wprowadzeniu poprawek.
Jak długo strona może pozostawać pod tym statusem?
Google nie podaje żadnego terminu. Nowe strony często znikają z listy samoistnie, natomiast adresy o treści zbliżonej do innych podstron mogą pozostawać na niej do czasu wprowadzenia zmian. Po poprawkach ponowne skanowanie trwa według Google od kilku dni do kilku tygodni.
Czy strona z tym statusem może pojawić się w wynikach wyszukiwania?
Nie, dopóki nie zostanie zindeksowana. W wynikach mogą pojawiać się wyłącznie strony zapisane w indeksie. Dlatego w pierwszej kolejności warto ustalić, czy pod statusem nie znajdują się podstrony ofertowe.
Czy trzeba usuwać strony, których Google nie zindeksował?
Nie zawsze. Jeśli strona jest potrzebna klientom, lepiej ją rozbudować albo połączyć z podobną. Usunięcie ma sens tylko w przypadku stron, które nie pełnią żadnej roli, takich jak puste tagi czy kategorie bez produktów.
Skąd wiadomo, czy przyczyną jest renderowanie?
Odpowiedź daje test wersji opublikowanej w narzędziu do sprawdzania adresów URL. Jeśli w zwróconym kodzie HTML i na zrzucie ekranu brakuje głównej treści, a na liście zasobów są pozycje zablokowane lub niepobrane, przyczyna jest techniczna. Jeśli treść jest kompletna, należy szukać przyczyny w pozostałych obszarach.
Źródła
- Raport Indeksowanie stron, Search Console - pomoc
- Narzędzie do sprawdzania adresów URL, Search Console - pomoc
- Jak działa wyszukiwarka Google, Centrum wyszukiwarki Google
- Zgłaszanie do Google prośby o ponowne zindeksowanie adresów URL, Centrum wyszukiwarki Google
- Jak określić kanoniczny URL za pomocą rel="canonical" i innych metod, Centrum wyszukiwarki Google
- JavaScript a SEO - podstawy, Centrum wyszukiwarki Google
- Sprawdzone metody dotyczące linków w Google, Centrum wyszukiwarki Google
- Tworzenie treści przydatnych, rzetelnych i ukierunkowanych na użytkowników, Centrum wyszukiwarki Google
- Optymalizacja budżetu indeksowania, Google for Developers
Funkcje wyszukiwarek i asystentów AI zmieniają się szybko, dlatego wpis aktualizujemy po większych zmianach.